Ich betreibe WPPoland allein und veröffentliche die Website in sechs Sprachen, mit KI als Schreibhilfe. Jeder Text läuft bei mir durch den Skill humanizer, polnische Texte zusätzlich durch miodkuj, danach durch deterministische Prüfskripte im Repository. Wer Dokumentation, READMEs, Release Notes oder einen Firmenblog mit Claude Code, Codex oder Cursor schreibt, steht vor denselben Fragen: Welcher Skill macht was, was beweisen seine Tests, und was prüft überhaupt deutschen Text? Hier steht, wie ich das eingerichtet habe, mit Zahlen aus den Quellen und aus meinen eigenen Läufen.
Welche Anti-Slop-Skills gibt es, und was leisten sie?
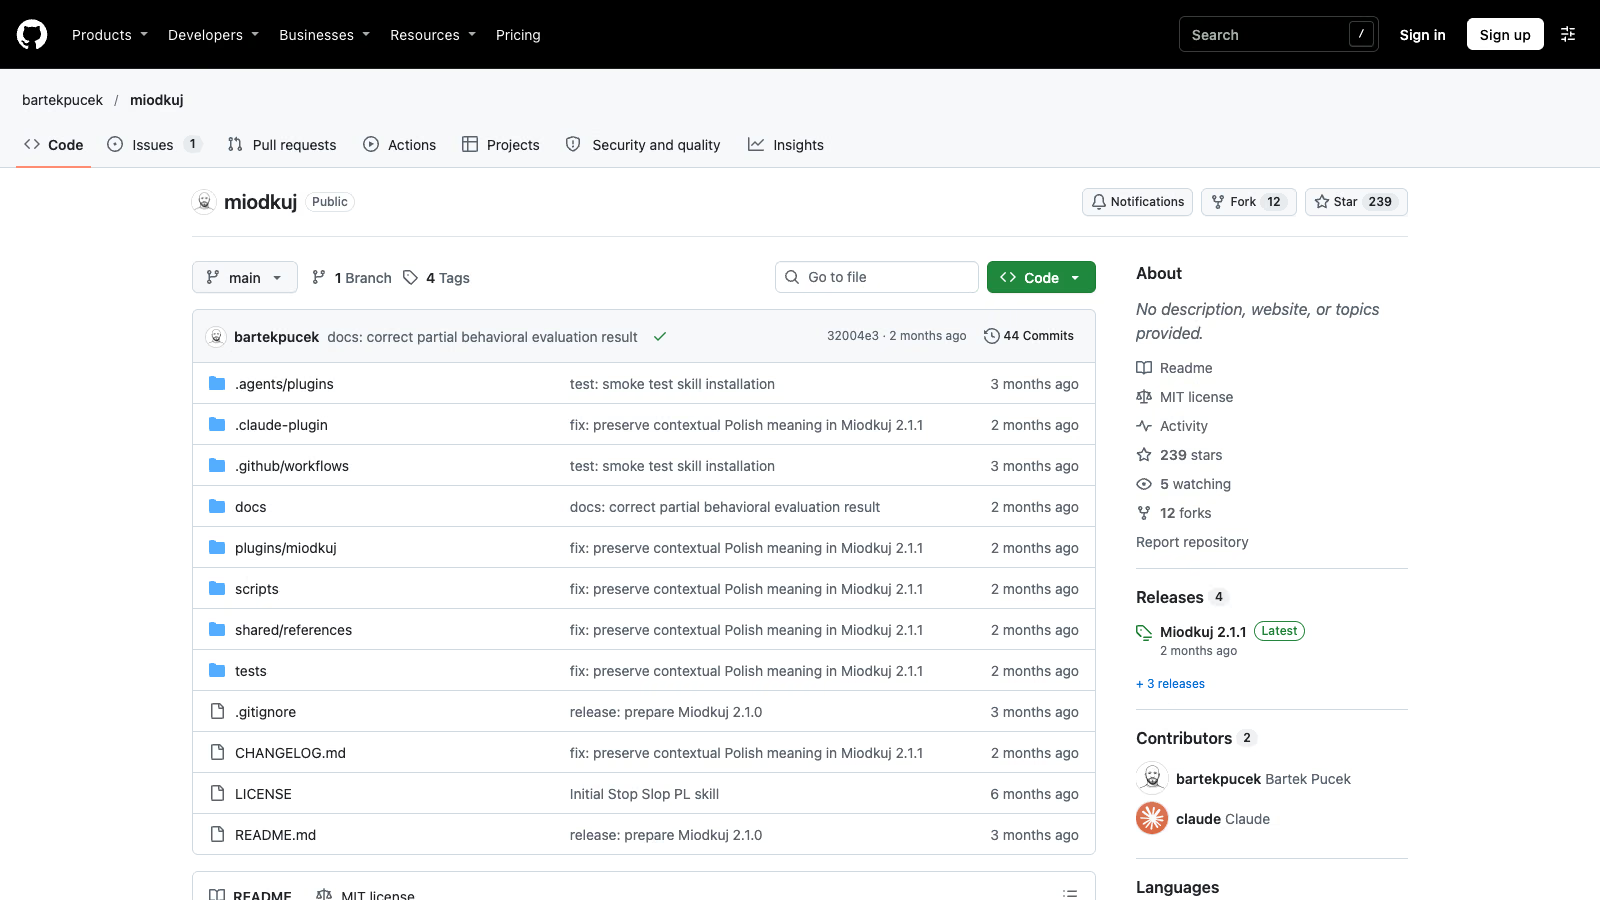
Drei Skills habe ich an der Quelle gelesen, also im GitHub-Repository und nicht in Zusammenfassungen. Sternzahlen und Versionen stammen vom 6. November 2026.
| Skill | Was er tut | Belege | Wann ich ihn nutze |
|---|---|---|---|
| humanizer (v3.1.0, MIT, 65.532 Sterne) | Überarbeitet Text nach 26 Mustern in sechs Gruppen: Inszenierung, Rhythmus, Aufblähung, Formatierung, Chat-Reste, falscher Leser | Keine Evaluierungssuite im Repository; ein Blindtest aus einem Nutzer-Issue | Als letzter Durchgang über jeden Text, den ein Mensch liest |
| unslop (2.3.0, 949 Sterne) | Vier Befehle: teach, cleanup, rewrite, mimic; dazu Python-Scanner mit JSON-Ausgabe | Eigene Evaluierung, letztes unabhängiges Ergebnis: No-Ship | Für englische Dokumentation, die Scanner auch in CI |
| miodkuj (v2.1.1, MIT, 239 Sterne) | Minimale Korrektur polnischer Texte: Amtsdeutsch auf Polnisch, Nominalketten, Behauptungen ohne Beleg | Eigener Verhaltenstest: 12 von 13 Fällen bestanden, 1 teilweise | Nur für Polnisch |
Für Deutsch gibt es in dieser Liste keinen eigenen Skill. Ich habe keinen geprüften deutschsprachigen Anti-Slop-Skill gefunden und erfinde hier auch keinen.
Die SKILL.md von humanizer ist 32.348 Byte groß. Das zählt, weil der gesamte Text bei jedem Aufruf in den Kontext des Modells geladen wird. Die SKILL.md von miodkuj hat 6.793 Byte, die von unslop 6.767 Byte. Zwei weitere bekannte Sammlungen, hardikpandya/stop-slop (18.689 Sterne) und petergyang/no-ai-slop (13.178 Sterne), stehen ebenfalls unter MIT. Aus no-ai-slop stammen laut Kommentar im Quelltext die Muster meines Rhetorik-Skripts, dazu unten mehr.
Was beweisen die Evaluierungen von unslop, humanizer und miodkuj?
Am meisten Material liefert unslop, und es fällt gegen das Projekt aus. Das README teilt die Ergebnisse in drei Tabellen: Kernprodukt, Stimme und Technik. Dort steht, dass nur die Kerntabelle zeigen kann, ob die Spezifikation das Schreiben verbessert (eigene Übersetzung). Zeile 26 des README meldet als neuestes unabhängiges öffentliches Ergebnis ein No-Ship. Die Datei evals/CORE-RESULTS.md trägt in der Kopfzeile den Status BETA; COMPARATIVE CLAIM NOT YET REVALIDATED.
Getestet wurde auf einem eingefrorenen öffentlichen Holdout (v9) mit 3 fehlerhaften und 1 sauberen Dokument und 31 annotierten Problemen. Beide Arme liefen auf demselben Modell, bewertet hat ein verblindeter Prüfer:
| Kennzahl | Modell mit unslop | Modell ohne Skill | Ziel |
|---|---|---|---|
| Präzision der Erkennung | 81,25 % | 83,33 % | mind. 90 % |
| Trefferquote der Erkennung | 83,87 % | 32,26 % | mind. 90 % |
| Erfolgreiche Reparatur | 87,10 % | 58,06 % | mind. 90 % |
| Erhalt des Inhalts | 100 % | 100 % | 100 % |
| Schadensrate | 11,11 % | 0 % | 0 % |
| Sicher verbesserte Dokumente | 0 von 3 | 0 von 3 | mind. 80 % |
Quelle: CORE-RESULTS.md im Commit 17ed39c. Der Skill findet deutlich mehr Probleme als das Modell allein. Er beschädigt aber auch 11 Prozent der Stellen, und kein einziges Dokument kam sicher verbessert heraus. Das README schreibt daraus selbst die Konsequenz, dass die aktuelle Beta keinen bestätigten Vorteil im Vergleich beansprucht.
humanizer hat kein Verzeichnis mit Evaluierungen. Das Skript scripts/validate-package.py prüft nur Manifeste, README und CHANGELOG. Das README verweist auf einen Blindtest, in dem Juroren die Überarbeitung 16 von 16 Mal dem KI-Original vorzogen. Der Test steht in Issue 229, eröffnet von einem Nutzer und nicht vom Maintainer. Das Issue nennt seine Grenzen selbst: Alle Juroren sind Sprachmodelle aus einer Familie, und von 144 geplanten paarweisen Vergleichen liefen nach Infrastrukturfehlern 77. Die Erkennungsrate von KI-Detektoren sank dabei von 100 auf 97,8 Prozent. Das README sagt dazu, dass das Umgehen von KI-Detektoren kein Ziel ist und Detektoren den Großteil der Ausgabe weiterhin markieren (eigene Übersetzung).
miodkuj legt seinen Test offen. Der Verhaltenstest zu v2.1.1 verglich 2.1.0 und 2.1.1, jeweils ein Lauf mit einem frischen Subagenten. Version 2.1.1 bestand 12 von 13 Fällen, ein Fall war teilweise erfüllt. Diesen Fall hatte der Autor zuerst als bestanden gemeldet und am selben Tag korrigiert. Im Abschnitt zu den Grenzen steht, dass die Ergebnisse keine allgemeine Zuverlässigkeitsrate und keine Verbesserung über Modelle hinweg belegen (eigene Übersetzung).
Für ein Team heißt das: Keiner der drei Skills hat einen belastbaren Nachweis, dass er Texte messbar besser macht. Ich nutze humanizer und miodkuj trotzdem, als Prüfliste für das Modell und für mich, und lese das Ergebnis danach selbst.
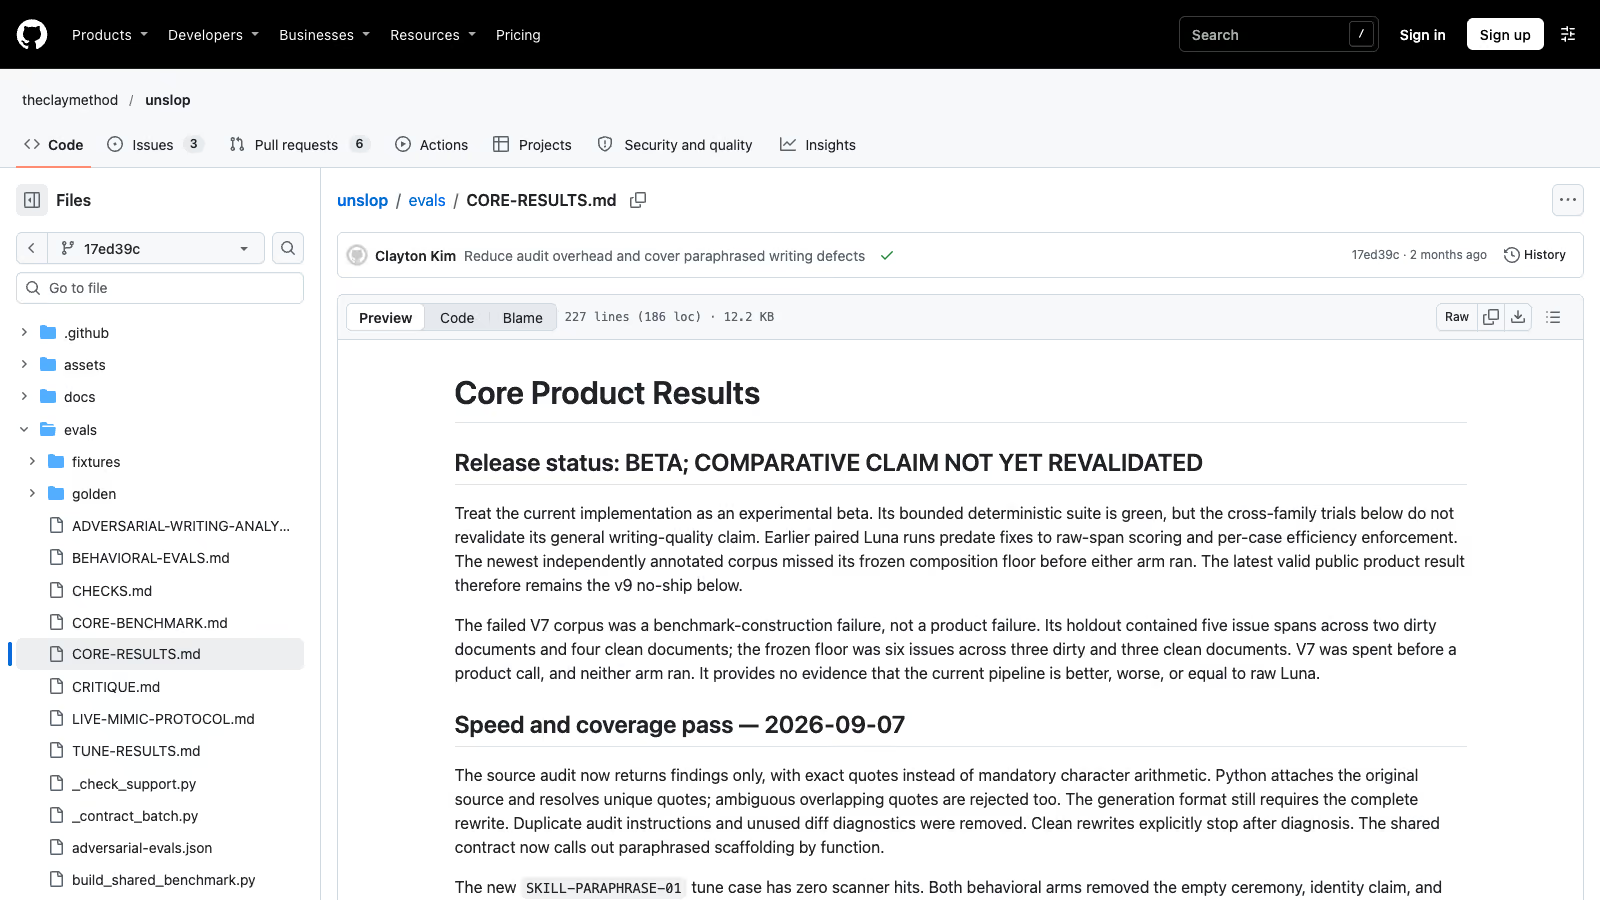 Die Eval-Seite von unslop im Commit 17ed39c: Beta, der Vergleichsanspruch ist nicht erneut bestätigt (Screenshot vom 6. November 2026).
Warum prüft unslop deutsche Texte nicht?
Alle drei Scanner von unslop rufen is_probably_english() aus scripts/_lang.py auf. Die Funktion misst den Anteil englischer Funktionswörter; ab 0,10 gilt ein Text als Englisch, und Eingaben unter 15 Token gelten immer als Englisch. Fällt ein Text durch diesen Test und hat der Scanner nichts gefunden, gibt er {"non_english": true, ...} aus, schreibt einen Hinweis nach stderr und endet mit Exit-Code 0. Das README sagt es offen: nur Englisch, nicht-englische Eingaben werden günstig erkannt und klar abgelehnt (eigene Übersetzung).
Für eine deutsche Release Note in CI bedeutet das einen grünen Haken für einen Text, den niemand geprüft hat. Wer unslop in eine Pipeline für mehrsprachige Dokumentation einbaut, muss non_english ausdrücklich auswerten und als “nicht geprüft” melden. Dasselbe gilt sinngemäß für humanizer: Seine 26 Muster sind an englischen Beispielen beschrieben. Das Modell überträgt sie zwar auf Deutsch, aber dafür gibt es keinen Test.
Was prüfe ich in meinem Repository auf deutschen Texten?
Weil kein Skill Deutsch abdeckt, laufen bei mir eigene Node-Skripte über die Inhalte. Die Zahlen stammen direkt aus dem Quelltext.
| Skript | Was es auf Deutsch prüft | Umfang laut Quelltext | Blockiert? |
|---|---|---|---|
check-reader-address.mjs | Duzen in deutschen Texten (Pronomen wie dein oder dich) außerhalb von Code und Zitaten | 9 Pronomenformen für Deutsch | Ja, über ein Budget je Sprache |
check-diacritic-wordlist.mjs | Wörter, in denen die Umlaute fehlen, etwa ein ü als u geschrieben | 104 Verbotspaare für Deutsch, 10 mehrdeutige Fälle nur als Warnung | Ja, mit --check |
check-loanword-density.mjs | Englischer Agenturjargon in nicht-englischen Texten | 29 Begriffe, Fehler ab 12 Treffern und 5 pro 1000 Wörter | Ja, für geänderte Dateien |
check-slop-rhetoric.mjs | Satzformen wie Wichtigkeitsfloskeln, Zusammenfassungen am Schluss, Gegenüberstellungen | 12 Muster, eines davon nur auf Wunsch; mehrere mit deutschen Varianten | Ja, mit Budget 0 |
check-voice-rules.mjs | Lange Gedankenstriche, Platzhalternamen, Füllverben, Title Case | 42 Regeln, eine davon nur für Deutsch | Ja, mit --fail-on-findings |
Drei Details zeigen, wo solche Listen auf den deutschsprachigen Raum zugeschnitten sein müssen. Die Umlautliste führt “grosse” und “grosser” ausdrücklich als mehrdeutig, weil die Schweizer Rechtschreibung kein ß kennt und diese Schreibung dort richtig ist. Ein Skript, das sie als Fehler meldet, würde Leser in Zürich falsch korrigieren. Ebenso stehen “ware” und “zahlt” in der Warnliste, weil “Ware” im Onlinehandel ein normales Wort ist.
Die Prüfung der Anrede hat für Deutsch ein Budget von 13 in package.json. Mein Lauf am 6. November 2026 ergab genau 13 Treffer im ganzen Bestand. Das Budget entspricht also der bekannten Altlast und wird gesenkt, sobald ich Texte korrigiere. Neue Duz-Stellen lassen das Skript sofort rot werden.
Das Rhetorik-Skript kennt deutsche Formulierungen. Seine Muster enthalten die Floskel von der zentralen oder entscheidenden Rolle, das Unterstreichen einer Bedeutung, das einleitende Wort für eine Zusammenfassung am Schluss und die Gegenüberstellung, die erst verneint und dann mit “sondern” korrigiert. Ich zitiere sie hier umschrieben, weil das Skript sonst diesen Artikel selbst meldet. Damit liest es Deutsch, im Gegensatz zu unslop.
Am 6. November 2026 habe ich alle vier inhaltlichen Skripte auf meinen deutschen Artikel zur Bereinigung von KI-Slop in WordPress laufen lassen:
$ node scripts/check-voice-rules.mjs --targets=src/content/blog/ai-slop-inhaltsbereinigung-wordpress.de.md
Scope: targets = ... | files scanned = 1 | rules = 42
OK: 0 voice-rule violations.

$ node scripts/check-loanword-density.mjs --files=...
OK: zargon ponizej progu w kazdym zmienionym pliku

$ node scripts/check-slop-rhetoric.mjs --files=...
razem: 0

$ node scripts/check-diacritic-wordlist.mjs --path=... --locale=de
check:diacritic-wordlist: ok (1 localised files scanned, 0 known-wrong unaccented spellings)
Alle drei blieben grün, und das sagt mir nur, dass im Text keine Einträge der Verbotslisten stehen. Ob der Text gut ist, sagt es nicht. Ein regulärer Ausdruck sieht Wörter und Satzformen, die Funktion eines Absatzes beurteilen ein Skill-Durchgang und ich beim Lesen.
Warum findet ein Scanner nur Kandidaten und keine Fehler?
Wikipedia führt eine lange Liste typischer Merkmale von KI-Texten, die Seite Signs of AI writing (Kurzform WP:AISIGNS). Gleich dazu steht die Warnung: “Bitte behandeln Sie diese Anzeichen nicht bloß als die zu behebenden Probleme; das könnte die Erkennung nur erschweren.” (eigene Übersetzung, Revision vom 4. November 2026). An anderer Stelle heißt es, die aufgeführten Muster seien nur mögliche Anzeichen eines Problems und nicht das Problem selbst.
unslop formuliert dasselbe für seine Werkzeuge in Zeile 13 des README: “Scanner schlagen Kandidaten vor; der Agent prüft jede Verwendung im Kontext.” Und weiter: “Weder ein sauberer Scan noch eine vertraute Formulierung beweist, wer den Text geschrieben hat, und die Prüfungen können nicht garantieren, dass jeder Fehler beseitigt ist.” (beides eigene Übersetzung)
In der Praxis heißt das: Wer nur die gemeldeten Wörter austauscht, bekommt einen Text, der denselben Leerlauf mit anderen Wörtern enthält. Genau das ist bei mir passiert, als ein Füllabsatz mit neuem Wortlaut zurückkam und die Wortliste grün blieb. Ich behandle jeden Treffer deshalb als Frage an den Absatz: Was sagt er, und braucht der Leser das?
 Das Repository blader/humanizer: MIT-Lizenz, Release v3.1.0 (Screenshot vom 6. November 2026).
Wie baue ich die Prüfung in CI ein, ohne bei weichen Funden zu blockieren?
Die Scanner von unslop geben JSON aus. banned_phrase_scan.py liefert total_violations, by_severity mit hard und soft, by_category und eine Liste violations mit Phrase, Zeile, Spalte und Vorschlag. Im Quelltext stehen 38 Einträge mit Schwere hard und 14 mit soft.
Der Exit-Code trennt diese beiden aber nicht. Der Scanner endet bei jedem Fund mit 1. structure_scan.py und silhouette_scan.py erzeugen in ihrer Hilfsfunktion ausschließlich weiche Funde und enden trotzdem mit 1, sobald es einen Fund gibt. Wer in CI einfach auf den Exit-Code reagiert, blockiert also auch bei weichen Hinweisen. Ein Workflow muss das JSON lesen.
Der folgende GitHub-Actions-Job blockiert nur bei harten Funden, meldet weiche Funde als Warnung und markiert nicht-englische Dateien als ungeprüft. Er setzt voraus, dass die Scanner unter tools/unslop/scripts/ liegen; zur Lizenzfrage siehe unten.
name: prose-gate
on:
  pull_request:
    paths: ["docs/**/*.md", "README.md", "CHANGELOG.md"]

jobs:
  unslop-hard-findings:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
      - uses: actions/setup-python@v5
        with:
          python-version: "3.11"
      - name: Scan changed Markdown, block on hard findings only
        run: |
          set +e
          fail=0
          files=$(git diff --name-only --diff-filter=AM origin/${{ github.base_ref }}...HEAD -- '*.md')
          for f in $files; do
            python3 tools/unslop/scripts/banned_phrase_scan.py "$f" > scan.json 2>/dev/null
            python3 - "$f" <<'PY' || fail=1
          import json, sys
          path = sys.argv[1]
          data = json.load(open("scan.json"))
          if data.get("non_english"):
              print(f"::warning file={path}::not checked (unslop is English-only)")
              sys.exit(0)
          sev = data.get("by_severity", {})
          count = lambda v: len(v) if isinstance(v, list) else int(v or 0)
          hard, soft = count(sev.get("hard")), count(sev.get("soft"))
          if soft:
              print(f"::warning file={path}::{soft} soft finding(s), review by hand")
          if hard:
              for v in data.get("violations", []):
                  if v.get("severity") == "hard":
                      print(f"::error file={path},line={v.get('line_number')}::{v.get('phrase')}: {v.get('suggestion')}")
              sys.exit(1)
          PY
          done
          exit $fail
Zwei Punkte in diesem Job sind Absicht. set +e verhindert, dass der Exit-Code 1 eines weichen Fundes den Schritt abbricht, bevor das JSON gelesen ist. Und non_english erzeugt eine sichtbare Warnung statt eines stillen Erfolgs. Strukturscanner und Silhouetten-Scanner nehme ich bewusst nicht in den blockierenden Schritt, weil sie nur weiche Funde kennen. Für Dokumentation hat structure_scan.py die Option --genre docs, die laut README die fett beschrifteten Listen erlaubt, die Referenzdokumentation tatsächlich braucht.
Für deutsche Texte bringt dieser Job nichts außer der Warnung. Dort laufen bei mir die eigenen Skripte aus der Tabelle oben, in derselben Logik: Ein Skript blockiert, wenn es eindeutige Fehler findet, und meldet nur, wo die Entscheidung beim Menschen liegt.
Wie prüfe ich, ob eine Überarbeitung die Fakten behalten hat?
Ein Skill, der Text umschreibt, kann Zahlen, Verneinungen oder Bedingungen verlieren. unslop bringt dafür validate_preservation.py mit. Es vergleicht Original und Überarbeitung und gibt passed, preserved, missing und warnings als JSON aus.
# --strict muss das ERSTE Argument sein, sonst wird es als Dateiname gelesen
python3 tools/unslop/scripts/validate_preservation.py --strict original.md rewritten.md
echo "exit: $?"   # 0 = bestanden, 1 = Fakten fehlen oder Bedeutung verschoben, 2 = Datei unlesbar

# optional: eigene Pflichtbegriffe als dritte Datei
python3 tools/unslop/scripts/validate_preservation.py --strict original.md rewritten.md constraints.json
Die Reihenfolge ist eine echte Falle. Im Quelltext wird --strict nur erkannt, wenn es an erster Stelle steht (if args and args[0] == "--strict"). Steht es weiter hinten, liest das Skript es als Dateinamen. Mit --strict werden Warnungen zu inhaltlicher Verschiebung, etwa bei Verneinungen, Geltungsbereich und Bedingungen, zum Fehler. Ohne die Option bestehen solche Fälle.
Auch dieses Skript ist englischsprachig gedacht. Für deutsche Texte nutze ich den Vergleich vor und nach dem Durchgang per git diff und lese jede geänderte Zahl, jedes “nicht” und jedes “nur” nach. Das kostet bei einem Artikel dieser Länge einige Minuten.
Aktualisierung, . Ein Überarbeitungsdurchgang vergleicht den neuen Text mit dem Entwurf und übernimmt eine falsche Zahl deshalb genauso treu wie eine richtige. Stammt die Zahl von einem KI-Assistenten, folgen Sie seiner Quellenangabe bis zu der Studie, die sie erhoben hat. Trakkr, ein Anbieter von Monitoring für die Sichtbarkeit von Marken in der KI-Suche, hat am 28. Oktober 2026 die Auswertung Zombie stats veröffentlicht. ChatGPT, Perplexity, Gemini, Claude und Google AI Overviews bekamen 200 Fragen, deren Antwort eine Zahl ist, und Trakkr verfolgte 1.285 zitierte Statistiken bis zu fünf Seiten tief. 40 % endeten bei einer Studie mit derselben Aussage, 8 % bei der Studie mit veränderter Zahl oder anderem Zusammenhang, 40 % bei einer Quelle, die sich nicht prüfen ließ, und 11 % führten ins Leere. Ein Beispiel daraus: Der MIT-NANDA-Bericht von 2025 stellt fest, dass 95 % der Organisationen mit generativer KI keinen Ertrag erzielt haben, und die Assistenten machen daraus 95 % gescheiterte Pilotprojekte. Endet die Spur bei einer Seite ohne prüfbare Quelle, streichen Sie die Zahl oder schreiben Sie im Text dazu, dass Sie sie nicht bestätigen konnten.
Wie teile ich einen Skill zwischen Claude Code, Codex und Cursor?
Claude Code sucht Skills an drei Orten. Persönliche Skills liegen in ~/.claude/skills/<name>/SKILL.md und gelten für alle Projekte auf dem Rechner, laut Dokumentation aber nicht in Cowork- oder Cloud-Sitzungen. Projekt-Skills liegen in .claude/skills/<name>/SKILL.md und kommen mit einem Commit zum ganzen Team. Plugin-Skills liegen in <plugin>/skills/<name>/SKILL.md und werden als /plugin-name:skill-name aufgerufen.
Die Dokumentation zu Skills bestätigt, dass ein Eintrag im persönlichen oder Projektverzeichnis ein Symlink auf ein anderes Verzeichnis sein darf. Claude Code liest die SKILL.md am Ziel und lädt den Skill nur einmal, auch wenn mehrere Orte darauf zeigen. Plugins behandeln Symlinks anders: Nach der Marketplace-Dokumentation bleibt ein Symlink innerhalb des Plugin-Verzeichnisses relativ erhalten, einer an anderer Stelle im selben Marketplace wird aufgelöst und kopiert, und einer außerhalb des Marketplace wird aus Sicherheitsgründen übersprungen.
Kris Geusebroek beschreibt bei Xebia dasselbe Muster für Plugins: ein gemeinsames Verzeichnis skills und relative Symlinks darauf. In meinem Repository liegen unter .cursor/skills/ sechs solche Links auf ../../.claude/skills/<name>. So pflegt Cursor keine eigene Kopie.
# Skill einmal im Projekt ablegen, für Cursor relativ verlinken
mkdir -p .claude/skills .cursor/skills
ln -s ../../.claude/skills/release-notes .cursor/skills/release-notes

# prüfen, dass Git einen Symlink speichert und keine Kopie
git ls-files --stage .cursor/skills
# 120000 <hash> 0   .cursor/skills/release-notes
Der Modus 120000 ist laut Xebia die Art, wie Git einen Symlink kennzeichnet. Steht dort 100644, hat jemand den Ordner kopiert. Der Link muss relativ sein, ein absoluter Pfad zeigt auf dem Rechner der Kollegin ins Leere. Unter Windows braucht das Anlegen von Symlinks den Entwicklermodus oder erhöhte Rechte, etwa mklink /D in einer Eingabeaufforderung mit Administratorrechten. Das gehört ins README des Projekts, sonst landet bei Windows-Nutzern eine Textdatei mit dem Pfad statt des Links im Checkout.
humanizer installieren Sie laut README so:
# Claude Code ab 2.1.142, Aufruf dann als /humanizer:humanizer
/plugin marketplace add blader/humanizer
/plugin install humanizer@humanizer

# Codex
npx skills add blader/humanizer --global --agent codex

# ältere Claude-Code-Versionen
npx skills add blader/humanizer --global --agent claude-code
Über das Plugin heißt der Befehl /humanizer:humanizer, weil Claude Code den Plugin-Namen voranstellt. Ich habe humanizer und miodkuj von Hand als Verzeichnis in ~/.claude/skills/ abgelegt, deshalb heißen sie bei mir kurz /humanizer und /miodkuj. Dieser Ordner ist bei mir selbst ein Symlink in einen synchronisierten Ordner, damit jeder Rechner dieselbe Fassung nutzt.
Was muss ich vor der Installation zur Lizenz wissen?
humanizer und miodkuj stehen unter MIT, mit LICENSE-Datei im Repository. Bei unslop steht license: MIT in der Kopfzeile der SKILL.md, das Repository enthält aber keine LICENSE-Datei, und die GitHub-API liefert für die Lizenz einen 404. Ein Vermerk in einer Skill-Datei ist keine Lizenzdatei. Wenn Sie die Scanner in ein Firmenrepository übernehmen wollen, wie im CI-Beispiel oben, klären Sie das vorher mit dem Autor oder mit der Person, die bei Ihnen über Lizenzen entscheidet.
Laut README braucht unslop Python 3.8 oder neuer und nur die Standardbibliothek. Die CI des Projekts testet mit Python 3.8 und 3.11. Ich habe den Code nur gelesen und nicht ausgeführt.
Welche Prompts kann ich für Claude Code oder Codex kopieren?
Diese drei Anweisungen nutze ich in ähnlicher Form. Sie verlangen von Anfang an, dass das Modell keine Fakten ergänzt, denn genau das ist der häufigste Schaden einer Überarbeitung.
Run the humanizer skill in file mode on docs/release-notes-2026-11.de.md.
Keep frontmatter, code blocks, URLs, numbers and product names unchanged.
Do not add facts, examples, customers or figures that are not in the file.
The text is German and addresses the reader with "Sie"; keep that.
List every sentence you removed and say why.
Review this German README section as an editor. For each paragraph, say in one
sentence what the reader learns from it. Mark paragraphs where you cannot name
anything. Do not rewrite yet.Compare original.md and rewritten.md. List every number, negation ("nicht",
"kein", "nur"), condition ("wenn", "sofern") and named entity that changed or
disappeared. Output a table: original sentence, new sentence, what changed.Der zweite Prompt ist der nützlichste. Er zwingt zur Frage, wozu ein Absatz da ist, bevor jemand an Wörtern feilt, und passt damit zur Warnung von Wikipedia. miodkuj nennt dasselbe Prinzip einen Portabilitätstest: Ein Satz, der unverändert zu einer anderen Firma, einem anderen Produkt oder einer anderen Person passen würde, ist vermutlich Füllstoff (eigene Übersetzung). Der Test funktioniert in jeder Sprache, auch ohne Skill.
Wie richte ich das in meinem Team ein?
Ich würde in dieser Reihenfolge vorgehen. Zuerst legen Sie einen Skill als Projekt-Skill in .claude/skills/ ab und verlinken ihn relativ für die anderen Agenten. Dann bauen Sie eine Prüfung in CI ein, die nur eindeutige Fehler blockiert und bei nicht geprüften Sprachen warnt. Danach ergänzen Sie für Deutsch eigene Listen, angefangen bei der Anrede und den Umlauten, weil diese Fehler maschinell sicher erkennbar sind. Den letzten Durchgang liest ein Mensch.
Wie ich Werkzeuge in diesem Bereich bewerte und welche ich gerade einsetze, steht im Tech-Radar. Wenn Sie so einen Ablauf für Ihre Dokumentation oder Ihren Blog einrichten wollen, mit Skills, Prüfskripten und Pipeline, beschreibe ich auf der Seite zur KI-Implementierung, wie ich dabei vorgehe. Schicken Sie mir dort eine kurze Beschreibung Ihres Repositorys und Ihrer Sprachen, dann antworte ich schriftlich mit einem Vorschlag für die erste Prüfung.