Migration von WordPress zu Astro in Nürnberg
Viele Unternehmen in Nürnberg nutzen WordPress, stoßen aber an Grenzen bei Performance, Sicherheit und Hosting-Kosten. Astro löst diese Probleme mit statischem HTML, null JavaScript und Edge-Deployment. Ich migriere bestehende WordPress-Seiten zu Astro mit vollständiger SEO-Erhaltung, URL-Mapping und 301-Weiterleitungen.
- PageSpeed 95-100
Statisches HTML ohne JavaScript. Schneller als jede WordPress-Lösung.
- SEO-sichere Migration
URL-Mapping, 301-Weiterleitungen, Google-Rankings erhalten.
- Hosting auf Cloudflare Pages
Globales CDN, kostenloses SSL, sofortige Deployments. Hosting-Kosten nahe null.
Ich bin Mariusz Szatkowski, arbeite seit 2006 mit WordPress und baue heute Websites mit Astro. Ich sitze in Gdynia in Polen und arbeite vollständig remote und schriftlich, als einzelner Entwickler. Diese Seite hat ein Thema: Ihre Inhalte oder Produktdaten liegen in einem System (Headless-CMS, WordPress, PIM oder ERP-Export), und die Astro-Seite soll sie lesen, ohne dass jemand Dateien kopiert. Es geht um den Weg der Daten, den Neuaufbau beim Veröffentlichen und die Frage, ab welcher Größe die Buildzeit zum Problem wird.
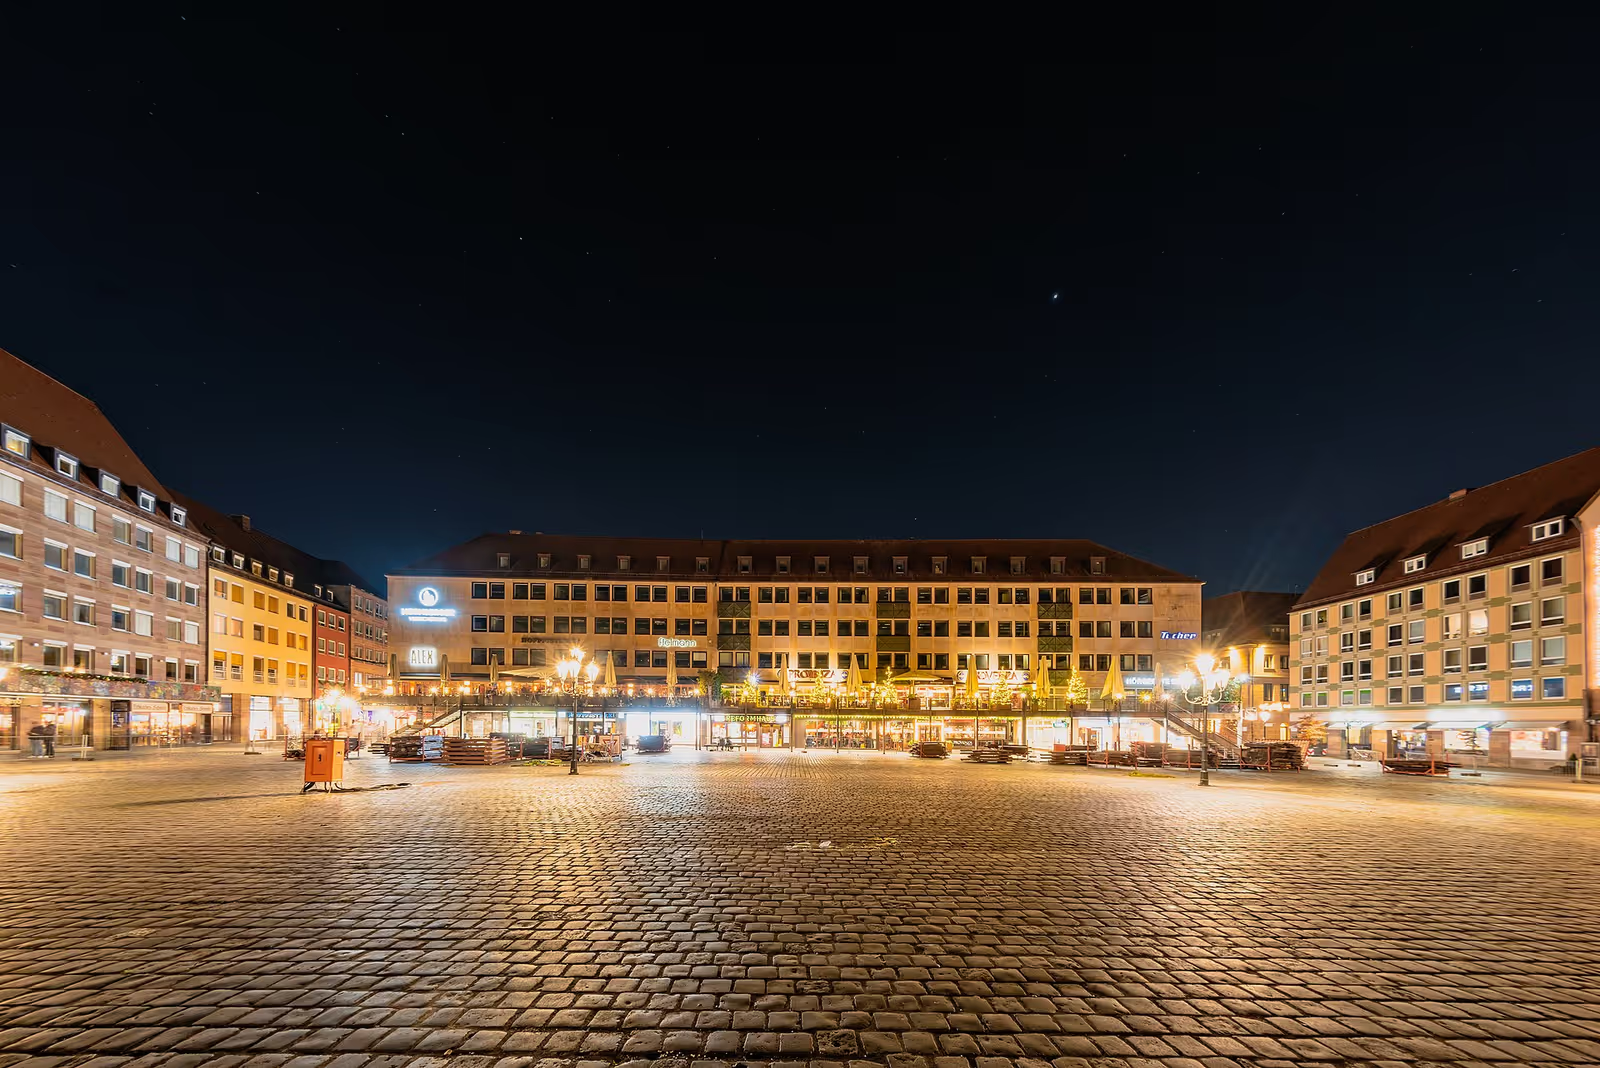
Foto: Flocci Nivis, CC BY 4.0, Wikimedia Commons.
Woher die Daten kommen und wer sie pflegt
Die Wirtschaftsförderung Nürnberg führt auf nuernberg.de neun Serviceschwerpunkte, darunter Cluster und Netzwerke sowie Einzelhandel und Nahversorgung (Stand 11. November 2026). Für Ihre Website zählt etwas Konkreteres: In welchem System entsteht der Inhalt, den Ihre Kundschaft sehen soll? Bei Herstellern mit Katalog ist es oft ein ERP oder PIM, bei Dienstleistern ein Redaktionssystem, bei beiden manchmal WordPress.
Die Astro-Dokumentation zu CMS führt Guides für 45 Systeme, darunter Contentful, Sanity, Storyblok, Strapi, Directus, Payload CMS und WordPress. Für ein PIM oder ERP gibt es keinen solchen Guide, dort liest Astro einen Export oder eine Schnittstelle, die Sie bereitstellen. Technisch ist das derselbe Weg: ein Loader holt die Daten, ein Schema prüft sie, die Seiten entstehen daraus.
Der Loader: Daten holen, prüfen, ablegen
Laut Loader-Referenz gibt es zwei Formen. Ein Loader als Funktion gibt ein Array von Einträgen mit eindeutiger id zurück. Bei jedem Build leert Astro dafür den Datenspeicher der Collection und lädt alles neu. Das ist einfach und richtig, solange der Abruf schnell ist.
Der Loader als Objekt hat eine load()-Methode und bekommt unter anderem store, meta, parseData und generateDigest. Zwei Eigenschaften sind für Kataloge wichtig:
metaist laut Dokumentation ein Schlüssel-Wert-Speicher je Collection, gedacht für Sync-Tokens und Änderungszeiten. Er bleibt zwischen Builds erhalten.digestist optional. Ein Eintrag wird nur aktualisiert, wenn sich sein Digest vom vorhandenen Eintrag mit derselben ID unterscheidet.set()gibtfalsezurück, wenn nichts zu tun war.
Ein Muster für einen Produktexport, der nur Änderungen seit dem letzten Lauf liefert:
import type { Loader } from 'astro/loaders';

export function produktLoader(): Loader {
  return {
    name: 'produkt-export',
    load: async ({ store, meta, parseData, generateDigest, logger }) => {
      const seit = meta.get('stand');
      const url = new URL('https://export.example.com/produkte');
      if (seit) url.searchParams.set('geaendert_seit', seit);

      const antwort = await fetch(url);
      if (!antwort.ok) throw new Error(`Produktexport: ${antwort.status}`);
      const { stand, produkte } = await antwort.json();

      for (const p of produkte) {
        const data = await parseData({ id: p.artikelnummer, data: p });
        store.set({ id: p.artikelnummer, data, digest: generateDigest(p) });
      }
      meta.set('stand', stand);
      logger.info(`${produkte.length} Produkte aktualisiert`);
    },
  };
}
Der Export in diesem Beispiel ist erfunden, export.example.com gibt es nicht. Wichtig ist die Form: meta merkt sich den Stand, parseData prüft jeden Eintrag gegen das Schema, ein fehlerhafter Datensatz bricht den Build mit einer lesbaren Meldung ab. Gelöschte Produkte kommen bei einem Änderungsexport nicht von selbst an: Dafür braucht der Export eine Liste entfernter Artikelnummern, die ich mit store.delete(id) einarbeite. Sonst bleibt ein Produkt online, das es nicht mehr gibt.
Ob der Datenspeicher zwischen zwei Builds auf Ihrem Hosting erhalten bleibt, prüfe ich im Projekt. Die Dokumentation sagt, Build-Time-Daten könnten zwischen Builds gecacht werden. Fehlt der Cache, holt der Loader alles neu, und genau diese Zeit messe ich vor der Zusage.
Neuaufbau beim Veröffentlichen: Webhook und Deploy-Hook
Eine statische Astro-Seite zeigt den Stand des letzten Builds. Die Guides von Storyblok und Contentful sagen es gleich: Für statische Seiten brauchen Sie einen Webhook, der beim Ändern der Inhalte einen neuen Build auslöst. Bei Storyblok wird danach bei jedem veröffentlichten Beitrag ein Build angestoßen.
Wenn die Seite auf Cloudflare Pages liegt, ist der Gegenpart der Deploy-Hook. Er entsteht unter Einstellungen, Builds, mit Namen und Branch und bekommt eine eigene URL. Jede POST-Anfrage an diese URL startet einen Build. Drei Punkte aus der Cloudflare-Dokumentation, die ich im Umfang festhalte:
- Die URL ist das Geheimnis. Der Hook verlangt keine weitere Authentifizierung. Bei Verdacht auf Missbrauch löschen Sie ihn und erzeugen einen neuen.
- Filtern Sie die Ereignisse. Contentful löst standardmäßig bei jeder Aktivität im Projekt einen Build aus, Sanity bei allen Datasets des Projekts. Ich beschränke den Webhook auf veröffentlichte Einträge, bei Sanity auf das Produktiv-Dataset.
- Builds sind begrenzt. Laut Limits-Seite erlaubt der Free-Tarif 500 Builds im Monat. Eine Redaktion, die zwanzigmal am Tag speichert, erreicht das schnell, wenn jeder Speichervorgang baut.
Auf anderen Hostern gilt das Prinzip, aber nicht diese Zahlen. Die Deploy-Hook-Dokumentation des gewählten Hosts lese ich vor der Einrichtung.
Wenn der Katalog groß wird: Buildzeit und Dateizahl
Die Astro-Dokumentation nennt Build-Time-Collections geeignet für zehntausende Einträge. Die Grenzen liegen daher eher beim Hosting. Cloudflare Pages beendet Builds nach 20 Minuten, erlaubt im Free-Tarif 20.000 Dateien je Site und eine Datei bis 25 MiB; bezahlte Tarife erlauben 100.000 Dateien, nach einer Einstellung im Projekt. Der Free-Tarif baut einen Build gleichzeitig.
Eine Rechnung, die Sie vor dem Projekt selbst machen können:
| Größe | Beispiel (angenommen) | Prüfen |
|---|---|---|
| Seiten | 3.000 Produkte in zwei Sprachen sind 6.000 Seiten | Passt die Zahl unter die Dateigrenze, mit Bildern und Datenblättern? |
| Bilder | jedes Produkt mit mehreren Bildgrößen | Bilder zählen als Dateien |
| Abruf | Export in Seiten von einigen hundert Einträgen | Dauert der Voll-Abruf Minuten? |
| Rendern | Seiten mit Datenblatt und Verweisen | Messen, nicht schätzen |
Die Zahlen in der Tabelle sind ein Rechenbeispiel, keine Messung eines Projekts. Reicht die Buildzeit nicht, gibt es drei Hebel, die ich in dieser Reihenfolge prüfe. Erstens weniger Seiten bauen: Produkte, die niemand sucht, brauchen keine eigene Seite. Zweitens den Loader auf Änderungen umstellen, wie oben. Drittens bei Markdown-Dateien die Optionen des glob()-Loaders: deferRender: true (seit Astro 7.1.0) hält laut Dokumentation den Speicherbedarf beim Build begrenzt, weil das gerenderte HTML nicht mehr im Datenspeicher liegt, und retainBody: false (seit Astro 5.17.0) verkleinert den Datenspeicher. Beide gelten für Dateien, nicht für Daten aus einer Schnittstelle. Als Schwellen für die fertige Seite gelten die offiziellen Werte der Core Web Vitals: LCP bis 2,5 s, INP bis 200 ms, CLS bis 0,1.
Live-Collections für Bestand und Vorschau
Live-Collections laden laut Dokumentation bei jeder Anfrage, definiert in src/live.config.ts mit defineLiveCollection(), abgefragt mit getLiveCollection() und getLiveEntry(). Sie brauchen einen Adapter, speichern nichts im Datenspeicher und kosten laut Dokumentation Antwortzeit, weil jede Anfrage an der Quelle hängt. Fehler kommen als LiveCollectionError, und Loader können einen cacheHint mitgeben, mit dem das Caching der Route gesteuert wird.
Die Dokumentation empfiehlt, Build-Time-Collections zu nehmen, wo es geht. Ich teile deshalb nach Änderungsrhythmus:
| Datum | Wie oft ändert es sich | Weg |
|---|---|---|
| Produktbeschreibung, Datenblatt | selten, redaktionell | Build-Time, Neuaufbau per Webhook |
| Preisliste im ERP | täglich | Build-Time mit Zeitplan, oder Live |
| Lagerbestand, Verfügbarkeit | laufend | Live-Collection |
| Entwurf im CMS | bei jedem Speichern | Vorschau mit Live-Collection oder Vorschau-Token |
Bei Contentful nutzt der Guide im Entwicklungsmodus die Preview-API für unveröffentlichte Inhalte, beim Build die Delivery-API mit nur veröffentlichten Inhalten. Dieselbe Trennung brauchen Sie bei jedem System: Entwürfe dürfen den Produktiv-Build nie erreichen.
Datenschutz: wohin die Daten fließen
Das Bayerische Landesamt für Datenschutzaufsicht (BayLDA) ist die Aufsichtsbehörde für nicht-öffentliche Stellen in Bayern. Es verlinkt zum Thema Online-Shops einen Praxisratgeber zu den DS-GVO-Anforderungen und ein Muster für das Verzeichnis der Verarbeitungstätigkeiten. Für Ihre Datenkette heißt das: Schreiben Sie auf, welche Systeme Daten bekommen. Ein Build-Server, ein CMS und ein ERP-Export sind Stationen, und sobald eine davon personenbezogene Daten in Ihrem Auftrag verarbeitet, verlangt Art. 28 DSGVO einen Vertrag (Text bei EUR-Lex). Ein reiner Produktkatalog enthält meist keine personenbezogenen Daten, Redakteurskonten im CMS dagegen schon. Bei Storyblok ist laut Guide die Region eu die Voreinstellung, ein Space in den USA muss ausdrücklich us setzen. Die rechtliche Bewertung gehört in Ihre Rechtsberatung, ich liefere die technische Liste der beteiligten Dienste.
So läuft ein Projekt mit mir
Die Abstimmung läuft in Mails und Dokumenten, ohne Termine und ohne Anrufe.
- Briefing. Sie schicken mir die URL, das Ziel, den Termin, das System mit den Daten und ein Beispiel des Exports oder der API-Antwort.
- Datenmodell. Ich schreibe pro Inhaltstyp die Felder auf und frage schriftlich nach, was unklar ist. Erst wenn Sie das Modell bestätigt haben, beginne ich mit dem Loader.
- Umfang und Annahmen. Ich halte fest, was dazugehört, was nicht, welche Ereignisse einen Build auslösen und welche Daten live kommen. Layout und Grafik bringen Sie mit, ich setze sie technisch um.
- Aufbau auf einer Testumgebung. Der Loader läuft zuerst gegen Testdaten, dann gegen eine Kopie des Exports. Ich messe die Buildzeit mit der vollen Datenmenge.
- Abnahme. Sie prüfen den Stand gegen den Umfang, auch einen veröffentlichten Testeintrag im CMS, der als Seite erscheinen muss. Was darüber hinausgeht, wird gesondert angeboten.
- Start und Wartung. Ich lege den Deploy-Hook an und schalte die Domain um. Auf Wunsch pflege ich Updates im Rahmen der Wartung in Nürnberg; ungenutzte Stunden eines Monats gehen nicht in den nächsten über.
Kommt die Seite heute von Next.js, hilft die Seite Migration von Next.js zu Astro in Nürnberg. Liegt der Inhalt in WordPress, steht die Einordnung auf der Seite WordPress-Entwickler in Nürnberg. Zu Headless-Setups allgemein gibt es die Seite Headless-CMS-Entwickler.
Checkliste vor dem Start (auch ohne mich nutzbar)
| Frage | Warum sie zählt |
|---|---|
| Wo entsteht der Inhalt, und gibt es Export oder Schnittstelle? | Bestimmt den Loader |
| Wie viele Einträge, in wie vielen Sprachen? | Seitenzahl gegen Dateigrenze und Buildzeit |
| Wer veröffentlicht, wie oft am Tag? | Zahl der Builds im Monat |
| Welche Daten müssen live sein? | Live-Collection und Adapter |
| Gibt es eine Liste entfernter Einträge? | Sonst bleiben Produkte online, die es nicht mehr gibt |
| Wer sieht personenbezogene Daten im System? | Auftragsverarbeitung und Datenschutzerklärung |
| Wer liefert Layout und Texte, bis wann? | Ohne Layout kein Start |
Häufige Fragen
Wann erscheint eine Änderung im CMS auf der Website?
Bei einer statischen Astro-Seite nach dem nächsten Build. Die Dokumentation von Storyblok und Contentful verlangt dafür einen Webhook, der beim Veröffentlichen einen neuen Build anstößt. Wie lange das dauert, hängt an der Buildzeit der Seite, nicht am Webhook.
Kann ein Webhook jeden Klick im CMS zu einem Build machen?
Ja, wenn er nicht gefiltert wird. Cloudflare weist darauf hin, dass Contentful standardmäßig bei jeder Aktivität im Projekt einen Build auslöst und Sanity bei allen Datasets. Ich filtere auf veröffentlichte Einträge im Produktiv-Dataset.
Reicht Astro für einen Katalog mit tausenden Produkten?
Die Dokumentation nennt Build-Time-Collections für zehntausende Einträge geeignet. Grenzen setzen dann die Buildzeit (bei Cloudflare Pages 20 Minuten) und die Dateizahl (im Free-Tarif 20.000 je Site), nicht Astro selbst.
Wann lohnt sich eine Live-Collection statt eines Neuaufbaus?
Für Daten, die sich ständig ändern und bei jedem Aufruf aktuell sein müssen, etwa Lagerbestand. Jede Anfrage hängt dann an der Quelle und braucht einen Adapter. Produkttexte bleiben besser Build-Time-Collection.
Muss ich den Zugriff meines ERP oder PIM freigeben?
Nicht ins Netz. Ich arbeite mit einem Export oder einer lesenden Schnittstelle, die Sie bereitstellen. Welche Felder fließen, steht im schriftlichen Umfang, ebenso welche Dienste personenbezogene Daten sehen.
Wer liefert Layout und Grafik?
Sie. Layout, Mockups und Grafik kommen vom Auftraggeber, zum Beispiel als markierte Tabelle mit den Elementen je Ansicht. Ich setze sie technisch um.
Schreiben Sie mir
Schicken Sie mir über das Kontaktformular die URL Ihrer Website, Ihr Ziel, Ihren Termin, das System, in dem Ihre Inhalte oder Produktdaten liegen, und ein Beispiel des Exports. Ich lese Ihre Angaben und antworte schriftlich an Werktagen, mit Rückfragen zum Datenmodell. Die erste schriftliche Einschätzung zu Datenmodell, Umfang und Buildzeit ist unentgeltlich. Wenn Astro für Ihre Daten nicht die richtige Wahl ist, etwa bei einem Shop mit laufenden Bestandsänderungen, sage ich das und nenne die Alternative.
Ausgewählte Projekte
Beispiele aus meiner Arbeit.
Tech Platform: fermentum-mobile.pl
Die Website fermentum-mobile.pl ist eine dedizierte Plattform, die für Fermentationsliebhaber entwickelt wurde, die die Geheimnisse traditioneller Verarbeitu...
Tech Platform: sportostroda.pl
Sportostroda.pl ist eines der interessanten Projekte in meinem Portfolio als WordPress-Entwickler. Es wurde als lokales Sportportal realisiert, das sich an d...
Tech Platform: strefapremium.pl
Die Website strefapremium.pl wurde als modernes Premium-Portal entworfen, das sich an Nutzer richtet, die exklusive Inhalte und Dienstleistungen suchen. Die ...
WordPress Support & Entwicklung in Nürnberg
Brauchen Sie die Leistung: Astro-Entwickler in Nürnberg?
Beschreiben Sie Ihr Projekt per E-Mail. Antwort innerhalb von 48 Stunden.
Projekt beschreibenWeitere WordPress-Dienste und Wissensbasis entdecken
Headless WordPress, Sanity, Strapi und Contentful mit Astro oder Next.js.
Astro, MDX, Edge Delivery und an echtem Traffic gemessene Core Web Vitals.
Migration zu Astro, Next.js und Headless WordPress.
Individuelle WordPress-Entwicklung und Architektur.
Core Web Vitals, Caching und schnellere Auslieferung.
Sichtbarkeit in Google und KI-Antwortsystemen.
Verwandte Kategorien
Unterstützende Artikel
Von unserer Original-Liste 2008 bis zur Landschaft 2026. Vergleich von WordPress, Drupal, Joomla, Ghost, Strapi, Payload, Directus, Sanity, Contentful und Astro - mit deutscher Praxis zu BITV, Behörden und WooCommerce.
Architekturleitfaden für entkoppeltes WordPress 2026. Astro 7 Islands, Next.js 16, WPGraphQL, Vorschau, Edge-Cache-Tags und C5/TR-03183 an der Origin. Kosten liegen im TCO-Leitfaden.

Umfassende 4-Jahres-TCO-Analyse (Total Cost of Ownership), reale Core-Web-Vitals-Benchmarks, Astro 7 GraphQL APQ-Architektur und eine 10-Punkte-Entscheidungsmatrix für Enterprise-Entscheider zwischen entkoppeltem und traditionellem WordPress.