Nein, Cloudflare blockiert den Googlebot nicht standardmäßig. Seit dem 15. September 2026 macht eine Option in den KI-Bot-Einstellungen allerdings etwas, womit viele nicht rechnen: “Block” hält den Googlebot schon am Eingang auf, und zwar samt Suche, nicht nur beim KI-Training. Wenn Ihre WordPress-Website hinter Cloudflare läuft und in den letzten Wochen jemand “die KI abgeschaltet” hat, sollten Sie das heute prüfen.
Am 7. Oktober 2026 tauchte in der Tageszusammenfassung von Search Engine Roundtable ein Satz aus einem Beitrag auf X auf: “Cloudflare ist am 15.9. dazu übergegangen, Google standardmäßig zu blockieren” (Search Engine Roundtable, 7. Oktober 2026, eigene Übersetzung). Der Beitrag auf X selbst ließ sich ohne Anmeldung nicht öffnen, deshalb stütze ich mich im Folgenden ausschließlich auf Quellen von Cloudflare. Alle Zitate habe ich am 8. Oktober 2026 geprüft.
Was hat Cloudflare am 15. September 2026 geändert
Bisher gab es einen einzigen Schalter “Block AI bots”. Jetzt gibt es drei Kategorien mit jeweils eigener Einstellung. Cloudflare definiert sie so:
- Search: “Crawlen zum Aufbau eines Suchindex.” (eigene Übersetzung)
- Training: “Crawlen zum Trainieren oder Feinabstimmen eines Modells.” (eigene Übersetzung)
- Agent: “vom Nutzer gesteuerte Agenten, die eine Seite im Auftrag eines Menschen besuchen, etwa Chat-Fetch-Bots und Browser-Use-Agenten.” (eigene Übersetzung)
Quelle der Definitionen: Cloudflare Blog, 15. September 2026.
Zur Auswahl stehen vier Optionen: Allow, Disallow AI Training, Block on pages with ads und Block. Disallow AI Training gibt es nur in der Kategorie Training. Laut Cloudflare stehen die neuen Einstellungen “allen Kunden, in allen Tarifen” (eigene Übersetzung) zur Verfügung, also auch im kostenlosen Tarif.
Warum blockiert die Option Block den Googlebot
Weil der Googlebot ein Mixed-Use-Crawler ist. So nennt Cloudflare einen Bot, der mit einem einzigen User Agent sowohl die Suche als auch das Training bedient:
“Ein Mixed-Use-Crawler ist ein einzelner Crawler, der sowohl Search als auch Training erledigt.”
Cloudflare Blog, 15. September 2026, eigene Übersetzung
Cloudflare nennt drei solche Crawler: Applebot, Bingbot und Googlebot. Da sich nicht “nur der Teil des Googlebots, der trainiert” aufhalten lässt, trifft die Sperre den ganzen Bot. Cloudflare schreibt das ausdrücklich:
“Er hält Applebot, Bingbot und Googlebot davon ab, Ihre Website zu erreichen […] die Suche eingeschlossen.”
Cloudflare Blog, 15. September 2026, eigene Übersetzung
Dasselbe gilt für die Option Block on pages with ads, nur in engerem Umfang: Laut Cloudflare werden Crawler, auch die Mixed-Use-Crawler, dann auf den Seiten blockiert, auf denen Werbung erkannt wurde. Für einen WordPress-Blog mit AdSense kann das bedeuten, dass Google genau die Beiträge nicht mehr sieht, die Geld einbringen.
Sicher für die Suche ist die Option Disallow AI Training. Sie veröffentlicht lediglich eine Präferenz in der robots.txt, und Cloudflare betont, dass der Googlebot “Ihre Website weiterhin für die Suche crawlen kann” (eigene Übersetzung). Den Verzicht auf das Training von Google-Modellen regelt das separate Token Google-Extended, das ich im Beitrag über die drei KI-Schalter bei Google beschrieben habe.
Was ist mit dem alten Schalter Block AI bots passiert
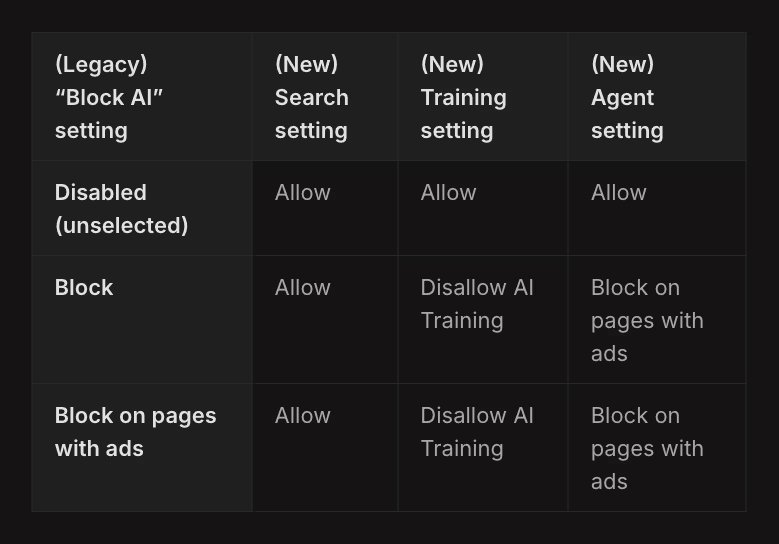
Cloudflare schafft ihn ab und stellt bestehende Zonen auf die neuen Einstellungen um. Die Migrationstabelle aus dem Blogbeitrag sieht so aus:
| Altes “Block AI” | Search | Training | Agent |
|---|---|---|---|
| Ausgeschaltet | Allow | Allow | Allow |
| Block | Allow | Disallow AI Training | Block on pages with ads |
| Block on pages with ads | Allow | Disallow AI Training | Block on pages with ads |
Laut dieser Tabelle hat niemand, der den alten Schalter genutzt hat, automatisch eine Googlebot-Sperre bekommen. Search wird immer zu Allow, Training zu Disallow AI Training, also zur Variante auf Basis der robots.txt.
Neue Domains, die seit dem 15. September hinzugefügt werden, erhalten bei der Einrichtung eines von zwei Sets. Website ohne Werbung: alles auf Allow. Website mit Werbung: Search Allow, Training Disallow AI Training, Agent Block on pages with ads. In beiden Sets ist Preference Sync aktiviert, das laut Cloudflare “die jeweils geltende No-Training-Präferenz in der robots.txt veröffentlicht” (eigene Übersetzung) und das bisherige Managed Robots.txt ersetzt.
Blockiert Cloudflare den Googlebot, wenn KI-Training blockiert ist
Die Dokumentationsseite zum Blockieren von KI-Bots enthält einen Satz, der nicht zur Tabelle passt:
“Mixed-Purpose-Crawler, die Search und Training kombinieren, werden ebenfalls von allen Konfigurationen blockiert, die KI-Training blockieren”
Cloudflare Docs, Block AI bots, eigene Übersetzung
Wörtlich genommen blockiert also jede Konfiguration, die das Training sperrt, einschließlich des alten Schalters, auch den Googlebot. Die Migrationstabelle sagt das Gegenteil. Welche Version beschreibt, was der Cloudflare-Server tatsächlich mit Ihrem Datenverkehr macht, entscheiden nur Ihre eigene Zone und Ihre eigenen Logs, keiner der beiden Texte.
Die Dokumentation gibt außerdem an, dass der alte Schalter “ab 15. September 2026 abgekündigt” (eigene Übersetzung) ist und dass für neue Domains “Search bleibt erlaubt” (eigene Übersetzung) gilt. Weder der Beitrag noch die Dokumentation erwähnen Cloudflare Pages.
Warum Cloudflare GPTBot ohne Folgen für die Suche blockieren kann, Googlebot aber nicht
Derselbe Beitrag erklärt, warum Google, Apple und Microsoft anders behandelt werden als andere KI-Firmen. Cloudflare hat für Crawler-Betreiber die Kennzeichnung “Accountable” eingeführt. Dafür muss ein Betreiber vier Anforderungen erfüllen oder sich verpflichten, sie zu erfüllen: eine Möglichkeit, dem KI-Training zu widersprechen (über robots.txt oder einen ähnlichen Standard), eine Möglichkeit, KI-Zusammenfassungen abzulehnen, Einblick auf URL-Ebene, welche Seiten für das Training bereitgestellt wurden, und die Zusicherung, dass ein Widerspruch gegen das Training die normalen Suchergebnisse nicht beeinflusst (Cloudflare Blog, 15. September 2026).
Cloudflare führt Applebot, Googlebot und Bingbot als gemischte Crawler mit der Kennzeichnung Accountable. Die Trainings-Crawler von Amazon, Anthropic, Meta und OpenAI sind anders eingestuft: Diese Firmen betreiben getrennte Crawler für Suche und Training, also kann Cloudflare den Trainings-Bot blockieren und den Such-Bot durchlassen. Genau deshalb verhält sich Disallow AI Training so, wie es sich verhält. Reine Trainings-Crawler werden blockiert, gemischte Crawler mit Kennzeichnung Accountable bleiben für die Suche erlaubt und bekommen den Widerspruch gegen das Training über robots.txt.
Der Widerspruch wirkt nur, wenn der Betreiber ihn liest. Google beachtet ein Disallow für das Token Google-Extended, Apple eines für Applebot-Extended. Bei Microsoft ist es anders: Laut demselben Beitrag baut Bing die Unterstützung für einen Trainingswiderspruch in robots.txt auf Domain-Ebene noch auf, angepeilt für Anfang 2027, und bis dahin gibt Disallow AI Training diesen Wunsch nicht automatisch an Bing weiter. Für die Zwischenzeit verweist Cloudflare auf das Meta-Tag NOARCHIVE und das Tool Block URLs von Bing.
Wie prüfe ich, ob der Googlebot meine WordPress-Website erreicht
Drei Schritte, etwa drei Minuten, wenn Sie Zugriff auf die Search Console und auf das Cloudflare-Konto haben.
- URL-Prüfung in der Search Console. Fügen Sie die Adresse der Startseite ein und klicken Sie auf “Live-URL testen”. Sie suchen einen erfolgreichen Seitenabruf und ein Datum des letzten Crawlings nach dem 15. September. Wiederholen Sie das für einen Beitrag mit Werbung, falls Sie Anzeigen schalten, denn dort greift die Variante Block on pages with ads.
- Crawling-Statistiken. Öffnen Sie in den Einstellungen der Search Console die Crawling-Statistiken und die Aufschlüsselung nach Antwort. Ein plötzlicher Anstieg von 403-Antworten seit Mitte September ist ein Signal, dass etwas am Netzwerkrand den Googlebot aufhält.
- Zoneneinstellungen in Cloudflare. Cloudflare schreibt, dass die neuen Steuerelemente “in den Security Settings der Domain (Zone) konfiguriert werden können” (eigene Übersetzung). Prüfen Sie, was bei Search, Training und Agent eingestellt ist. Wenn Sie bei Training oder Search Block sehen, aber in Google bleiben wollen, ändern Sie das auf Disallow AI Training oder Allow.
Werfen Sie dabei auch einen Blick in die robots.txt. Wenn Preference Sync aktiv ist, ergänzt Cloudflare dort seine Präferenz. Unter WordPress erzeugt oft zusätzlich ein SEO-Plugin die robots.txt, prüfen Sie also die fertige Datei unter /robots.txt und nicht nur die Plugin-Einstellungen. Unsere eigene Content-Signal-Zeile zeigt, wie leicht die robots.txt von dem abweicht, was man annimmt.
Entfernt Google-Extended in robots.txt eine Website aus der Google-Suche
Nein. Googles Dokumentation zu den allgemeinen Crawlern sagt, dass Google-Extended keinen eigenen User-Agent-String in HTTP-Anfragen hat. Gecrawlt wird mit den bestehenden Google-User-Agents, das Token dient nur als Steuerung in robots.txt. Laut Google beeinflusst es weder die Aufnahme einer Website in die Google-Suche noch dient es als Ranking-Signal. Es steuert nur, ob gecrawlte Inhalte für das Training künftiger Gemini-Modelle und für Grounding in Gemini-Apps und Vertex AI genutzt werden dürfen (Google Search Central, allgemeine Crawler von Google).
Dieselbe Seite erklärt ein Detail, das beim Testen zählt. Der Live-Test in der Search Console und der Test für Rich-Suchergebnisse rufen die Seite als Google-InspectionTool ab, einen Crawler der Testwerkzeuge, der keine Auswirkung auf die Google-Suche hat. Ein erfolgreicher Live-Test zeigt also, dass die Zone gerade einen Google-Crawler durchlässt. Wie der Googlebot selbst in den letzten Wochen behandelt wurde, zeigt der Bericht Crawling-Statistiken, deshalb nutzt die Prüfung oben beides.
Was passiert mit indexierten Seiten, wenn der Googlebot ein 403 bekommt
Eine Sperre in Cloudflare beantwortet den Googlebot mit einer Fehlerseite statt mit Ihrem Inhalt, deshalb sucht die Prüfung oben nach 403-Antworten. Google beschreibt, wie seine Crawler darauf reagieren. Alle 4xx-Statuscodes außer 429 werden gleich behandelt, sie haben keinen Einfluss auf die Crawling-Frequenz, und in der Google-Suche entfernt die Indexierung eine URL aus dem Index, wenn sie zuvor indexiert war (Google Search Central, HTTP-Statuscodes und Netzwerkfehler).
Eine Sperre pausiert also nicht nur das neue Crawling. Seiten, die bereits ranken, können für die Dauer der Sperre aus dem Index fallen. Dieselbe Seite warnt davor, 401 und 403 zur Begrenzung der Crawling-Frequenz einzusetzen. Wenn es eigentlich darum geht, einen WordPress-Server zu entlasten, sind 429 und 5xx die Codes, die Google als Signal zum Bremsen versteht: Die Crawler werden dann vorübergehend langsamer, statt URLs zu entfernen.
Wie prüfe ich, ob eine Anfrage im Log wirklich vom Googlebot stammt
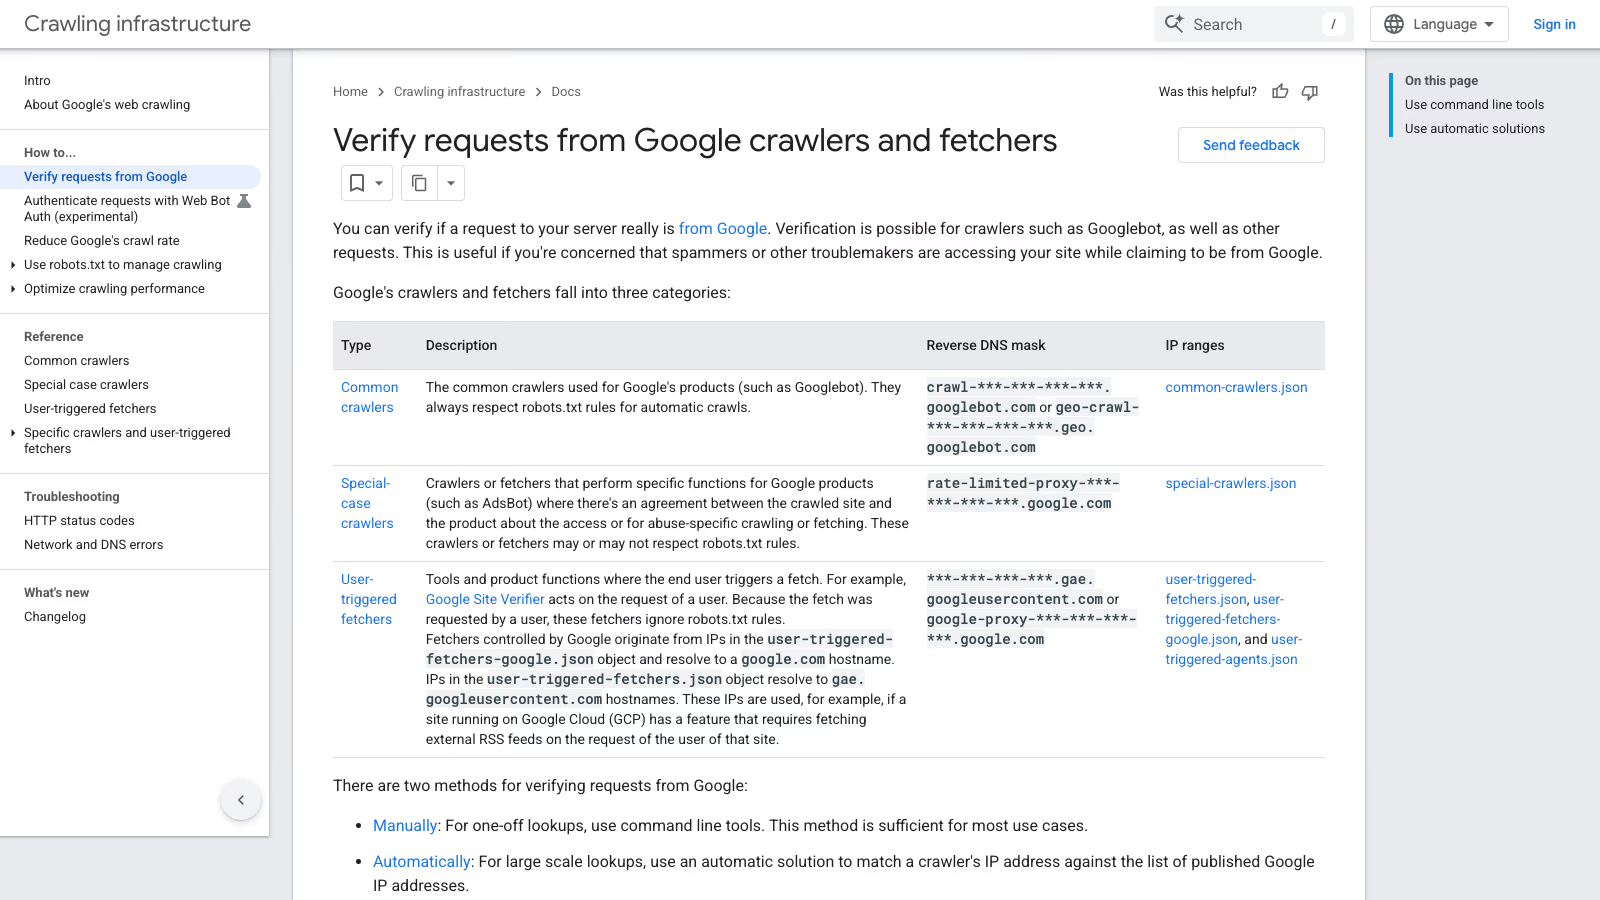
Jeder kann eine Anfrage mit “Googlebot” im User-Agent senden, eine Log-Zeile allein beweist also nichts. Googles Methode ist eine DNS-Prüfung in beide Richtungen: Führen Sie mit dem Befehl host einen Reverse-DNS-Lookup für die IP-Adresse aus dem Log aus, prüfen Sie, dass der Hostname auf googlebot.com, google.com oder googleusercontent.com endet, und führen Sie dann einen Forward-Lookup für diesen Hostnamen aus, der dieselbe IP liefern muss. Google veröffentlicht die IP-Bereiche seiner Crawler außerdem als JSON-Dateien, getrennt nach allgemeinen Crawlern, Spezial-Crawlern, von Nutzern ausgelösten Fetchern und von Nutzern ausgelösten Agents (Google Search Central, Googlebot überprüfen).
Der Hostname verrät auch, welche Art Crawler Sie vor sich haben. Googlebot und andere allgemeine Crawler lösen auf crawl-***-***-***-***.googlebot.com (oder eine Variante unter geo.googlebot.com) auf und beachten bei automatischem Crawling immer robots.txt. Von Nutzern ausgelöste Fetcher lösen unter gae.googleusercontent.com oder google-proxy-***.google.com auf und ignorieren robots.txt, weil ein Mensch den Abruf angefordert hat.
Cloudflare prüft auf seiner Seite ähnlich. Verifizierte Bots sind Bots, deren Identität Cloudflare über eine kryptografische Web-Bot-Auth-Signatur, eine veröffentlichte IP-Liste mit stabilem User-Agent oder Reverse DNS bestätigt hat, und laut Dokumentation waren sie bisher in allen Tarifen von den Standard-Bot-Konfigurationen ausgenommen (Cloudflare Docs, Verified bots). In einer WAF-Regel zeigt das Feld cf.client.bot, ob eine Anfrage von einem bekannten, guten Bot oder Crawler stammt (Cloudflare Docs, cf.client.bot). Eine Falle im Free-Tarif: Bot Fight Mode läuft in einer eigenen Pipeline, und Cloudflare schreibt, dass er sich weder mit WAF-Regeln noch mit Page Rules umgehen oder überspringen lässt (Cloudflare Docs, Bot Fight Mode). Eine Skip-Regel “zum Schutz des Googlebots” ändert nichts an dem, was Bot Fight Mode tut.
Welche Einstellung für eine WordPress-Firmenwebsite
Für eine Website, die von Anfragen aus Google lebt, sieht eine vernünftige Konfiguration so aus:
| Kategorie | Einstellung | Warum |
|---|---|---|
| Search | Allow | Das ist der Suchverkehr, den Sie wollen |
| Training | Allow oder Disallow AI Training | Disallow AI Training drückt den Widerspruch über die robots.txt aus, ohne den Googlebot zu blockieren |
| Agent | Allow | KI-Agenten besuchen die Website im Auftrag eines konkreten Menschen, oft eines potenziellen Kunden |
Block heben Sie sich für Fälle auf, in denen Sie wirklich aus den Suchmaschinen verschwinden wollen, etwa für ein Staging oder ein Panel, das nicht indexiert werden soll. Dafür eignen sich noindex und ein Passwortschutz ohnehin besser.
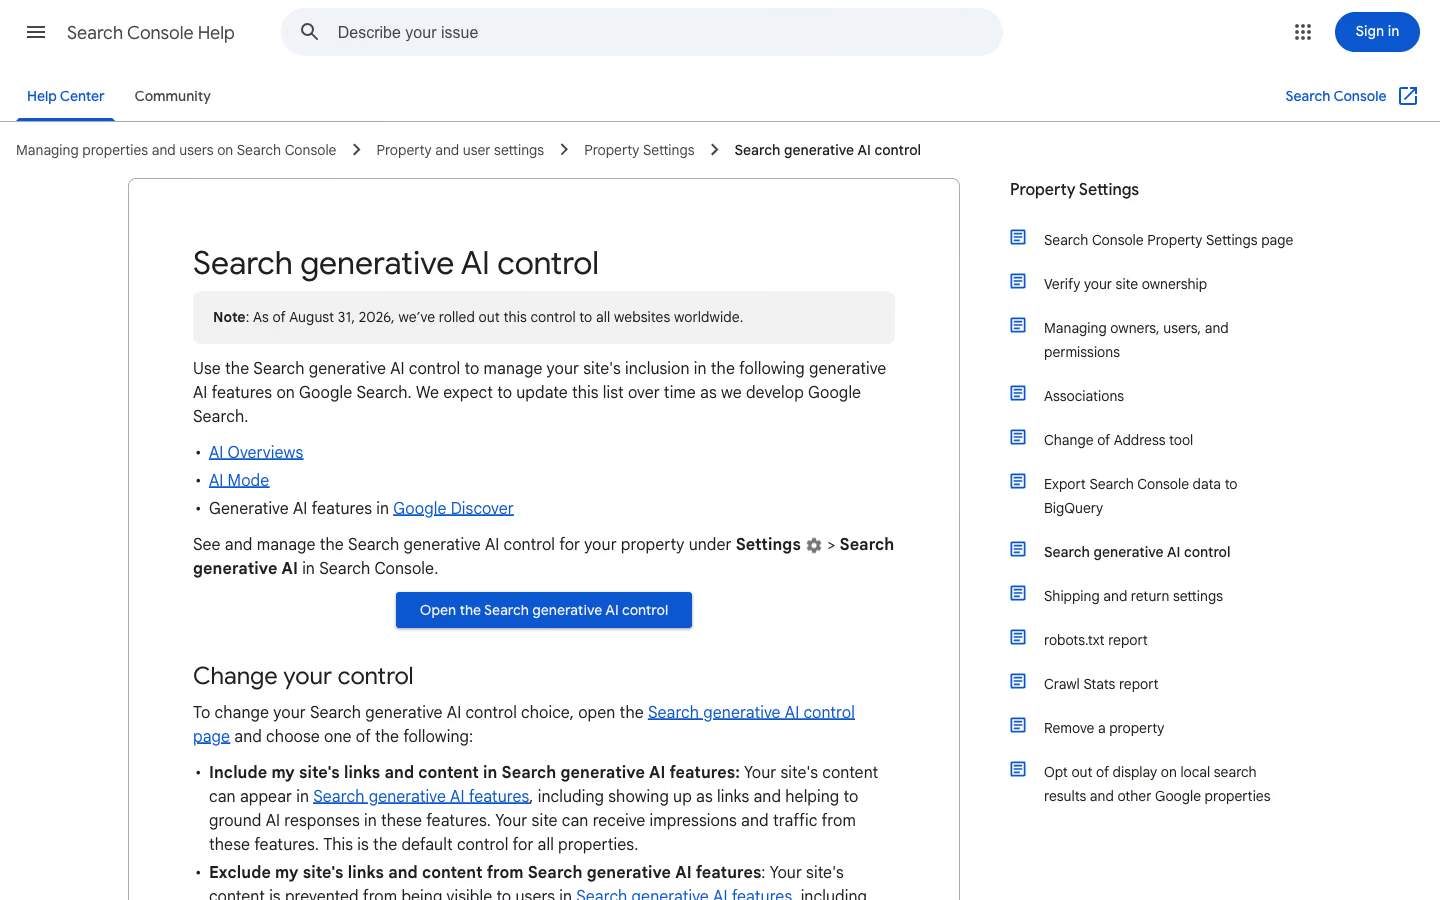
Wenn Sie lieber nicht möchten, dass Ihre Inhalte in KI-Antworten landen, ist das eine separate Entscheidung. Dafür gibt es bei Google eigene Werkzeuge, die ich im Rahmen der GEO- und LLMO-Optimierung bespreche. Eine Sperre am Netzwerkrand in Cloudflare ist dafür nicht gedacht, denn sie schneidet zusammen mit der KI auch die Suche ab.
Bevor Sie einen Crawler sperren, zählen Sie, wie viele Requests er pro vermitteltem Besucher erzeugt. Nick Gray hat am 7. August 2026 seine Website PatronView mit 1,5 Millionen Seiten beschrieben: An einem Tag kamen 3,6 Millionen Requests von chinesischen Bots, Google crawlte 46-mal pro vermitteltem Besucher, und Bingbot schickte 158.610 Requests für 680 Besucher. Die Skip-Regel für verifizierte Bots, (cf.client.bot), steht bei ihm nach den Sperrregeln und vor den Challenge-Regeln, sodass ein gesperrter Bot gesperrt bleibt, der Googlebot aber nie eine Challenge sieht. Nur 0,24 % seiner Challenges werden gelöst, was er als Zeichen liest, dass sie fast nur Bots treffen.
Die rechtliche Seite ist weiter offen. Im Juni 2025 veröffentlichte Brian Williamson von Communications Chambers den Bericht AI, Copyright and the Public Good, laut eigenem Hinweis unabhängig und von Google finanziert. Er schlägt vor, KI-Training mit urheberrechtlich geschützten Werken als Fair Use einzustufen, hält Opt-out-Verfahren und Transparenzpflichten für kostspielig und will das Urheberrecht darauf konzentrieren, ob KI-Ausgaben Rechte verletzen. Das ist ein politischer Vorschlag, kein geltendes Recht. Bis sich die Rechtslage ändert, liegt Ihre tatsächliche Kontrolle in den Bot-Einstellungen am Netzwerkrand, also stellen Sie diese so ein, dass Googlebot nicht zusammen mit den KI-Crawlern ausgesperrt wird.
Beispiel für KI-Bot-Einstellungen in Cloudflare auf einer echten Website
wppoland.com läuft auf Cloudflare, also habe ich es am 8. Oktober 2026 an der eigenen Website geprüft. Die Cloudflare-API liefert für unsere Zone ai_training, ai_search und ai_user mit dem Wert disabled, und auch der alte Schalter ai_bots_protection steht auf disabled. Keine KI-Bot-Sperre ist aktiv.
Die Search Console bestätigt das von der anderen Seite: Die URL-Prüfung für /pl/ zeigt das letzte Crawling am 8. Oktober 2026 um 12:12 Uhr, einen erfolgreichen Seitenabruf und eine robots.txt, die den Zugriff erlaubt. Das ist eine Zone mit einer Einstellung, und das ganze Problem besteht gerade darin, dass sich die Einstellungen von Zone zu Zone unterscheiden.
Checkliste für KI-Bot-Einstellungen in Cloudflare
- Starten Sie in der Search Console den Live-Test für die Startseite und einen Beitrag mit Werbung.
- Durchsuchen Sie die Crawling-Statistiken nach 403-Antworten seit dem 15. September 2026.
- Öffnen Sie die Security Settings der Zone in Cloudflare und prüfen Sie Search, Training und Agent.
- Verwenden Sie Block nicht, wenn Sie in Google bleiben wollen. Für den Widerspruch gegen das Training ist Disallow AI Training da.
- Prüfen Sie die fertige Datei
/robots.txt, denn sowohl Cloudflare als auch das SEO-Plugin schreiben hinein. - Wenn Ihre Domain nach dem 15. September zu Cloudflare hinzugefügt wurde, prüfen Sie, welches Standardset bei der Einrichtung gewählt wurde.