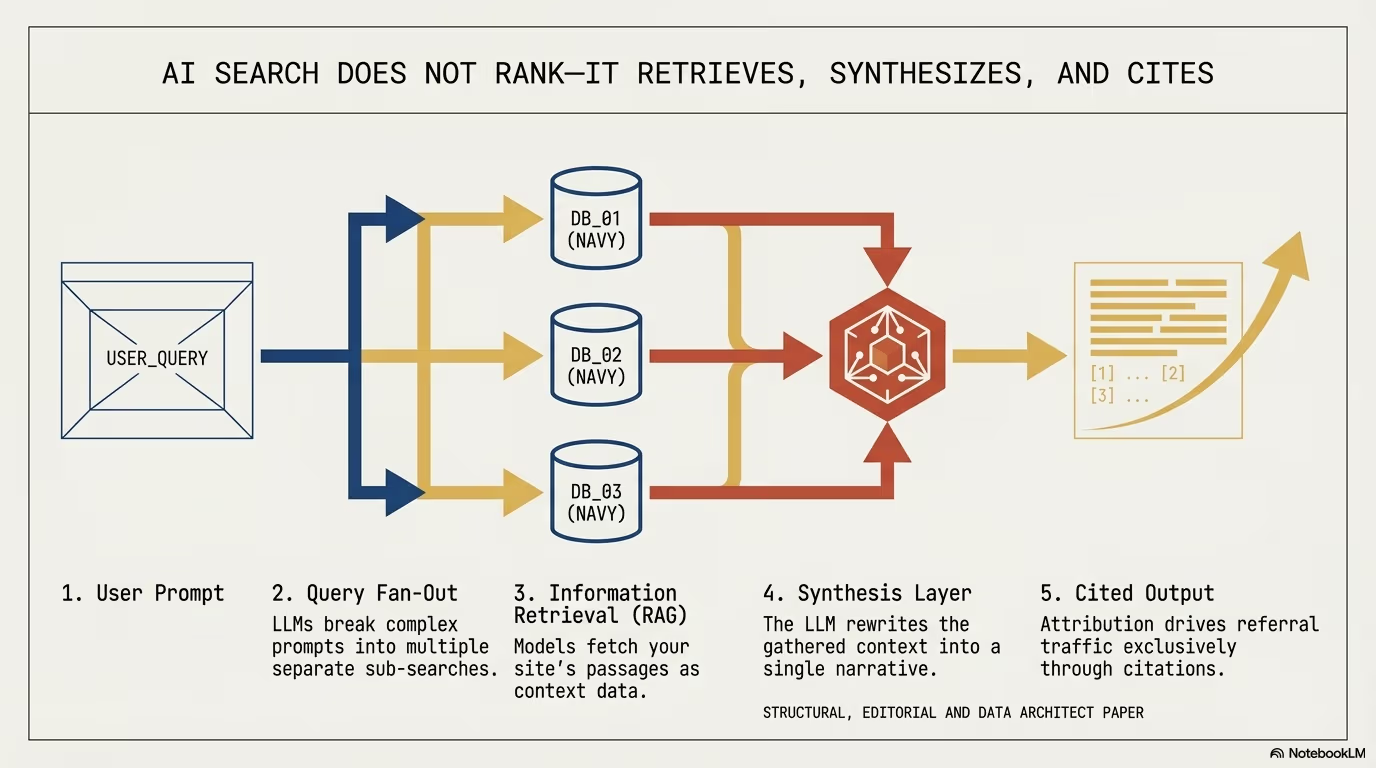
Bis 2026 beantworten generative Systeme einen wachsenden Teil der Fragen, die früher auf einer Ergebnisseite landeten. Gartner prognostizierte einen Rückgang des traditionellen Suchvolumens um 25%, und die Zahlen zum Wachstum KI-vermittelten Traffics kursieren meist ohne benannte Quelle, weshalb dieser Text keine davon übernimmt. Was sich dagegen prüfen lässt, ist die rechtliche und technische Mechanik dahinter: wer Ihre Seiten abruft, unter welcher Erlaubnis, und welche Ihrer Erklärungen dazu bloß eine Bitte ist und welche in der EU eine rechtliche Wirkung entfaltet. Dieser Artikel führt die sieben Beobachtungen entlang dieser Achse: Rechtevorbehalt, robots.txt, Content Signals, und die Lücke zwischen dem, was Sie deklarieren, und dem, was jemand durchsetzen kann.
Von der Rangliste zur Zitation, und warum das eine Rechtsfrage ist

Solange Sichtbarkeit bedeutete, in einer Ergebnisliste weit oben zu stehen, war die Rechtslage unspektakulär. Ein Crawler holte die Seite, ein Index speicherte eine Repräsentation, ein Nutzer klickte, und die Seite lieferte sich selbst aus. Der Kompromiss war stillschweigend und für beide Seiten sichtbar: Zugriff gegen Besuch.
Generative Systeme brechen diesen Handel an einer bestimmten Stelle auf. Der Abruf findet weiterhin statt, der Besuch entfällt, und der Inhalt erscheint in einer Antwort, die das Modell formuliert. Damit werden zwei Fragen, die im klassischen SEO nie gestellt werden mussten, plötzlich operativ relevant. Erstens: Für welchen Zweck wurde die Seite abgerufen, für das Training eines Modells oder für die Beantwortung einer konkreten Nutzerfrage im Moment der Anfrage. Zweitens: Auf welcher Rechtsgrundlage, und was haben Sie selbst dazu erklärt.
Der Unterschied ist keine Spitzfindigkeit, er ist der Kern der europäischen Regelung. Artikel 4 der Richtlinie (EU) 2019/790, in Deutschland umgesetzt als § 44b UrhG, erlaubt Text- und Data-Mining an öffentlich zugänglichen Werken, aber nur, solange der Rechteinhaber sich die Nutzung nicht vorbehalten hat. Für online zugängliche Inhalte muss dieser Vorbehalt in maschinenlesbarer Form erklärt werden. Das ist die Stelle, an der eine Datei im Wurzelverzeichnis Ihrer Domain aufhört, eine Höflichkeitsform zu sein, und Teil einer Rechtsposition wird.
Für den zweiten Fall, den Abruf zur Laufzeit einer Nutzerfrage, greift diese Norm nicht gleichermaßen. Hier wird nichts zum Zweck der Mustererkennung ausgewertet, sondern eine Seite geholt, gelesen und ihr Inhalt in einer Antwort wiedergegeben. Wer nur den Trainings-Crawler aussperrt, hat diesen zweiten Kanal unberührt gelassen, und in der Praxis ist es der zweite Kanal, der die Zitate in ChatGPT, Gemini und Perplexity erzeugt. Beide Vorgänge treffen über dasselbe Protokoll auf Ihren Server, sie sehen im Log fast identisch aus, und sie unterliegen unterschiedlichen Regeln.
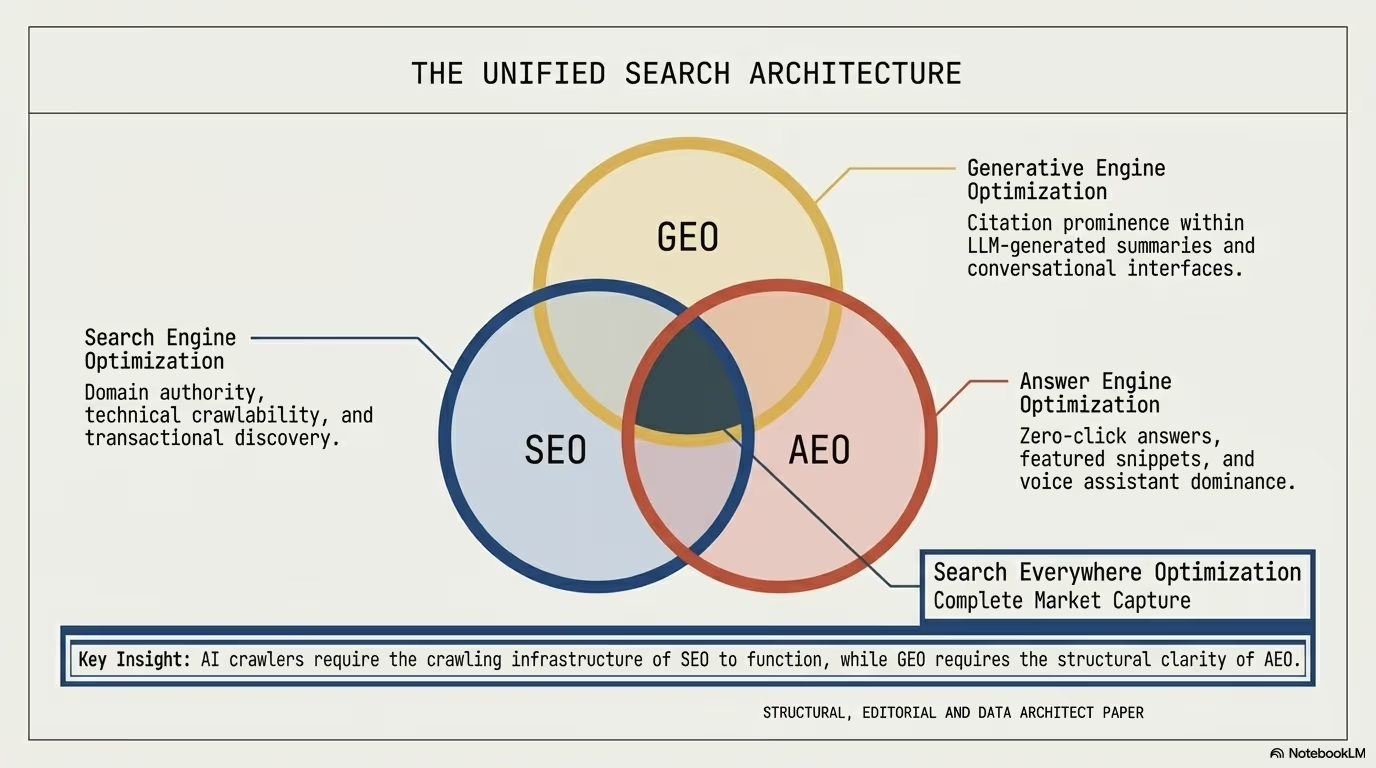
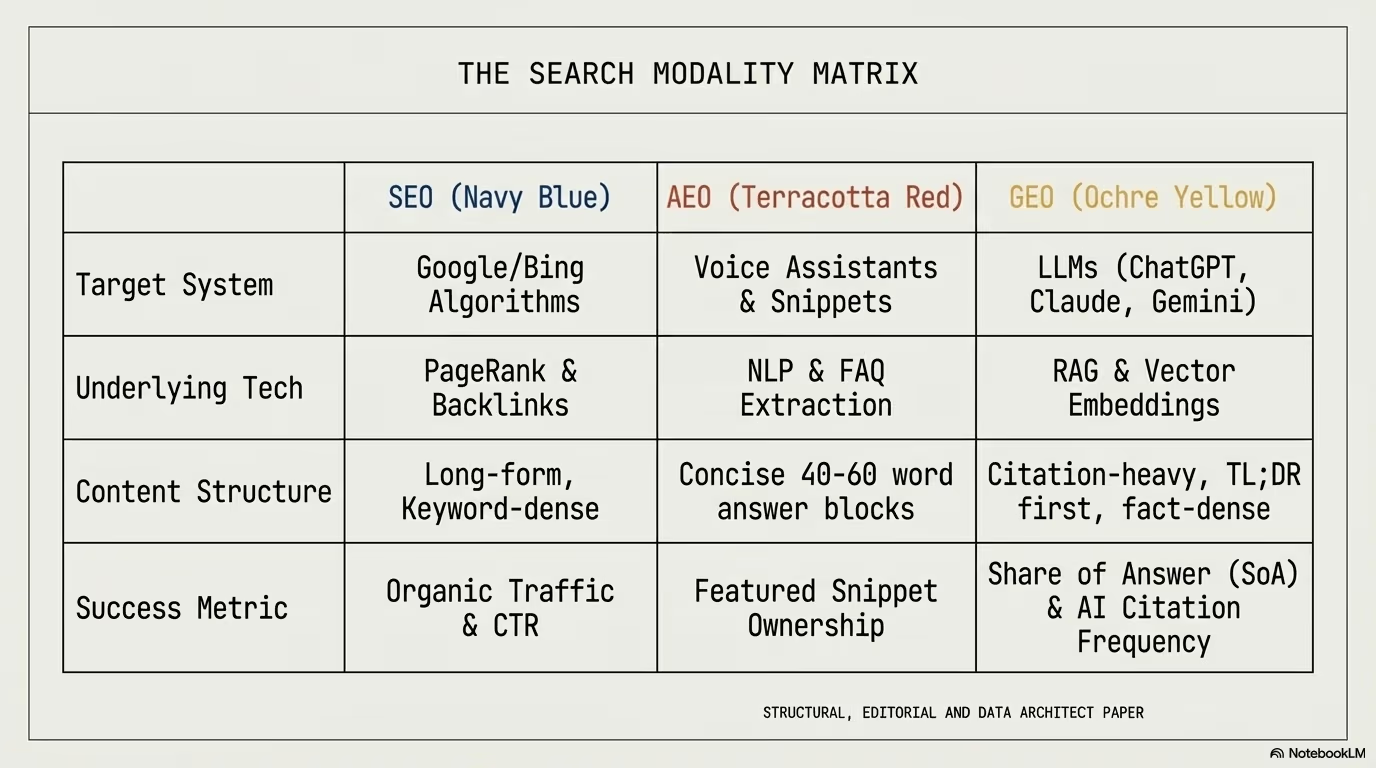
Für das operative Geschäft heißt das: GEO ist nicht bloß SEO mit anderen Signalen. Es ist eine Entscheidung darüber, welchen Bots Sie welchen Zweck erlauben, gefolgt von der Arbeit, für den erlaubten Zweck auch zitierfähig zu sein.
Die Messung, für die wir geradestehen können, ist unsere eigene. Über 23 Stunden im August 2026 trugen 72,4% der Anfragen an diese Website einen unbekannten User Agent, gegenüber 19,7% aus Chrome, und benannte Suchmaschinen-Crawler kamen zusammen auf 3,5%. Methode und vollständige Zahlen stehen in Bot-Traffic auf einer kleinen Website gemessen. Der für dieses Kapitel entscheidende Teil dieser Messung ist nicht der Anteil, sondern die Kategorie: Der größte Block ließ sich keiner deklarierten Kennung zuordnen. Eine Regel in der robots.txt adressiert Kennungen. Was sich nicht als etwas ausgibt, wird von einer Regel für Kennungen auch nicht erfasst.
1. Zitate entstehen früh im Dokument, weil die Abrufschicht früh abbricht
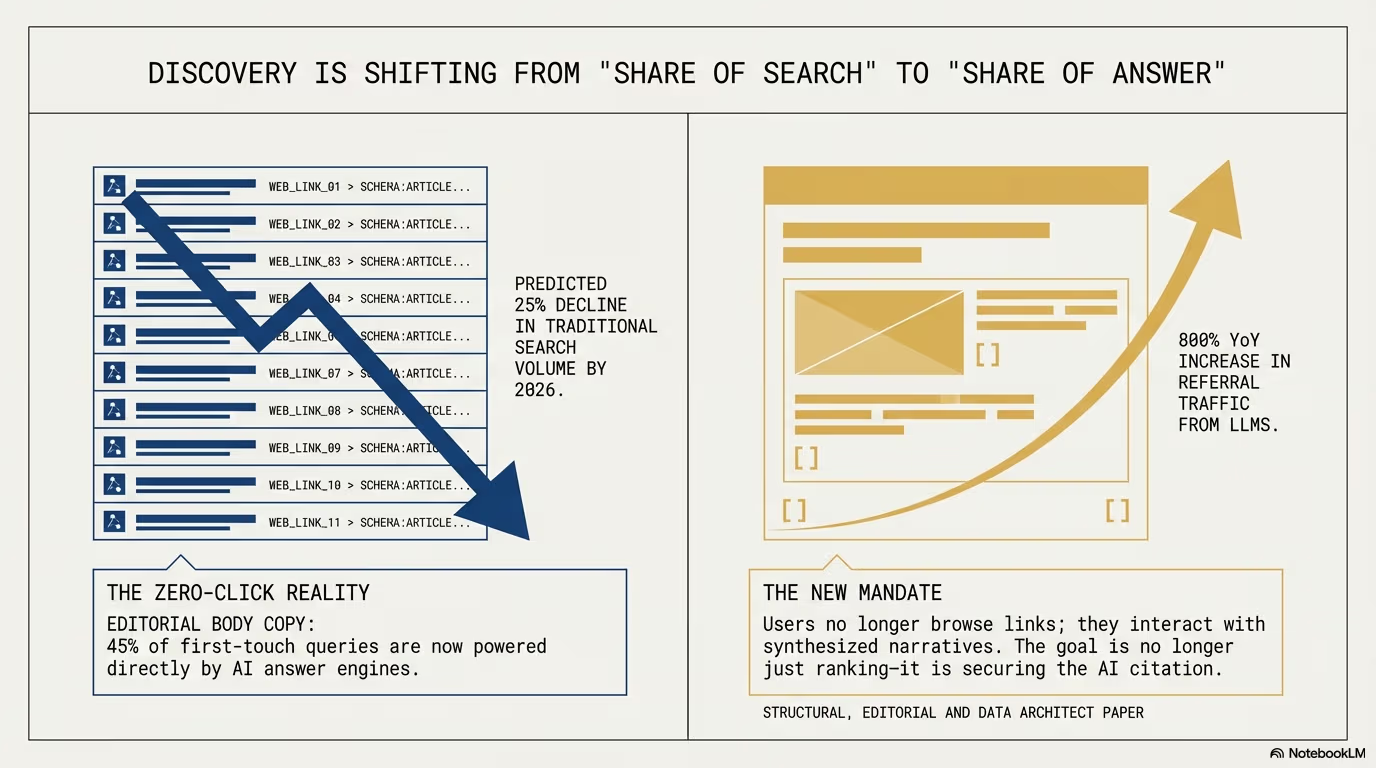
Moderne Antwortsysteme arbeiten mit Retrieval-Augmented Generation. Sie holen Dokumente, zerlegen sie in Passagen, wählen einige wenige aus und geben nur diese dem Modell als Kontext. Die Auswahl ist ein Kostenproblem: Kontextfenster sind begrenzt, jede zusätzliche Passage kostet Latenz und Rechenzeit, also greift die Auswahl bevorzugt auf das zu, was früh und dicht steht.
Kevin Indig hat für seine Auswertung 1,2 Millionen ChatGPT-Antworten untersucht und kommt darauf, dass 44,2% der verifizierten LLM-Zitate aus den ersten 30% einer Seite stammen. Die Zahl ist als Richtungsangabe nützlich und als Naturkonstante wertlos, denn sie hängt an einem Anbieter, einem Zeitraum und einer Definition von “verifiziert”. Was sie belastbar zeigt, ist die Wirkungsrichtung: Der obere Teil des Dokuments wird überproportional oft zur zitierten Stelle.
Praktisch bedeutet das eine Umkehr der Dramaturgie. Die direkte Antwort steht oben, kurz, in vollständigen Sätzen, und ohne Vorlauf. Danach folgen Beleg, Einschränkung und Kontext. Ein Satz, der erst im dritten Absatz sagt, worum es geht, wird vom Abrufsystem oft gar nicht mehr gesehen.
Es gibt einen Grund, das nicht zu übertreiben. Wenn der obere Abschnitt eine vollständige, für sich stehende Antwort ist, dann liefert die Seite genau das Material, das eine Antwort ohne Klick möglich macht. Das ist kein Argument gegen die Struktur, aber es ist ein Argument dafür, die Struktur mit einer Rechtsentscheidung zu koppeln: Wenn Sie für bestimmte Inhalte keine Verwertung in Antworten wollen, gehört das in den Vorbehalt und nicht in eine absichtlich unklare Einleitung. Inhalte zu verstecken ist eine schlechte Durchsetzungsstrategie, weil sie zuerst gegen Ihre Leser wirkt.
“Beantworten Sie zuerst die Frage, dann erklären Sie die Nuancen. So sollten Sie das Schreiben für KI-Suche generell angehen: Klarheit zuerst, Tiefe zweitens.”
Der obere Abschnitt einer Seite verdient deshalb dieselbe Sorgfalt wie eine Pressemitteilung: eine überprüfbare Aussage, eine benannte Quelle, ein Datum. Genau diese drei Elemente sind es, die eine Passage für ein Modell zitierfähig machen, und sie sind zugleich das, was Sie später brauchen, wenn Sie eine falsch wiedergegebene Aussage beanstanden wollen.
2. Die meisten KI-Zitate stammen von außerhalb der organischen Top 10
Digital Applied hat zwischen Oktober 2025 und Februar 2026 863.412 Suchanfragen ausgewertet und festgestellt, dass 62% der AI-Overview-Zitate von Seiten auf Position elf oder tiefer stammen, oder von Seiten ganz außerhalb der Top 100. Die Auswertung stammt von einem Anbieter mit eigenem Produktinteresse an dem Ergebnis, was sie nicht falsch macht, aber es gehört dazugesagt.
Der Mechanismus hinter der Entkopplung ist nachvollziehbar, ohne eine zweite Studie zu bemühen. Die organische Rangliste ordnet Dokumente nach ihrer erwarteten Eignung, eine Anfrage als Ganzes zu bedienen. Die Passagenauswahl eines Antwortsystems sucht etwas anderes: einen Textausschnitt, der eine Teilfrage sauber beantwortet und sich zitieren lässt, ohne Kontext mitzuschleppen. Eine schwach verlinkte Seite mit einer klar formulierten, datierten Aussage kann diese zweite Aufgabe besser erfüllen als ein stark verlinkter Übersichtstext, in dem dieselbe Aussage über vier Absätze verteilt ist.
Rechtlich hat diese Entkopplung eine unangenehme Nebenwirkung. Die Werkzeuge, mit denen Sie Ihre Sichtbarkeit in der klassischen Suche steuern, greifen hier nur teilweise. Ein noindex entfernt eine Seite aus dem Suchindex. Ob damit auch jede Verwendung in einer generierten Antwort endet, hängt davon ab, welcher Bestand das Antwortsystem tatsächlich abfragt und ob er mit dem Suchindex identisch ist. Bei AI Overviews von Google speist sich die Antwort aus demselben Index, den Googlebot befüllt, weshalb der Trainings-Bot Google-Extended daran nichts ändert. Wer beides steuern will, muss beides adressieren, und das sind zwei verschiedene Kennungen mit zwei verschiedenen Wirkungen.
Daraus folgt eine unbequeme Arbeitsteilung. Für die Sichtbarkeit bauen Sie strukturelle Klarheit, datierte Aussagen und Entity-Markup auf. Für die Kontrolle pflegen Sie eine Liste von Kennungen und deren Zweck. Die erste Aufgabe gehört der Redaktion, die zweite gehört in die Betriebsdokumentation, und wenn niemand die zweite besitzt, bleibt sie ungepflegt, bis ein Vorfall sie zum Thema macht.
3. Autorität ist ein Netz, keine Seite
Yext hat 6,8 Millionen KI-Zitate ausgewertet und festgestellt, dass 86% der Zitate von Websites mit fünf oder mehr vernetzten Seiten zu einem bestimmten Thema stammen. Wir haben keine veröffentlichte Studie gefunden, die den Wert einer Pillar-Cluster-Architektur auf einen einzigen Multiplikator bringt, also nennen wir auch keinen. Der Datensatz trägt eine Richtung, keinen Koeffizienten.
Der Mechanismus dahinter ist Verifikation. Ein Modell, das eine Antwort formuliert, muss entscheiden, ob die Quelle, die es gleich nennt, das Thema wirklich beherrscht oder nur für eine Phrase rankt. Eine einzelne Seite liefert einen Datenpunkt und keine Möglichkeit, ihn zu prüfen. Eine Pillar-Seite mit acht Unterseiten, von denen jede einen anderen Ausschnitt des Themas abdeckt und jede zurückverlinkt, liefert einen Graphen, den das System durchlaufen kann, bevor es Ihren Markennamen in eine Antwort setzt, die es nicht zurücknehmen kann. Ohne diesen Graphen bleibt eine Seite verwaist: technisch indexiert, in dem Sinne unprüfbar, auf den es ankommt.
In der Praxis heißt das, Inhalts-Ökosysteme zu bauen statt einzelner Artikel. Eine Website, die “WordPress-Sicherheit” als Pillar abdeckt, braucht vernetzte Cluster-Seiten zu Firewall-Konfiguration, Malware-Erkennung, Login-Härtung, TLS-Konfiguration, Plugin-Schwachstellenscanning und Incident Response. Jede verlinkt auf die anderen mit beschreibendem Ankertext, und der Ankertext benennt das Thema, nicht die Position im Menü.
Für die Achse dieses Artikels ist ein Nebeneffekt wichtig, der selten erwähnt wird. Ein dichtes internes Netz erhöht die Zahl der Abrufe pro Sitzung eines Agenten. Ein Agent, der einer Antwort auf den Grund geht, folgt Links und holt sich drei, fünf, zehn weitere Dokumente. Das ist erwünscht, solange der Zweck erlaubt ist, und es ist die Erklärung dafür, warum die Serverlast durch Agenten schneller wächst als die Zahl der Nutzerfragen. Wenn Sie den Zugriff später einschränken, schränken Sie genau diese Traversierung ein, und Ihre Sichtbarkeit in Antworten fällt nicht linear, sondern entlang des Graphen.
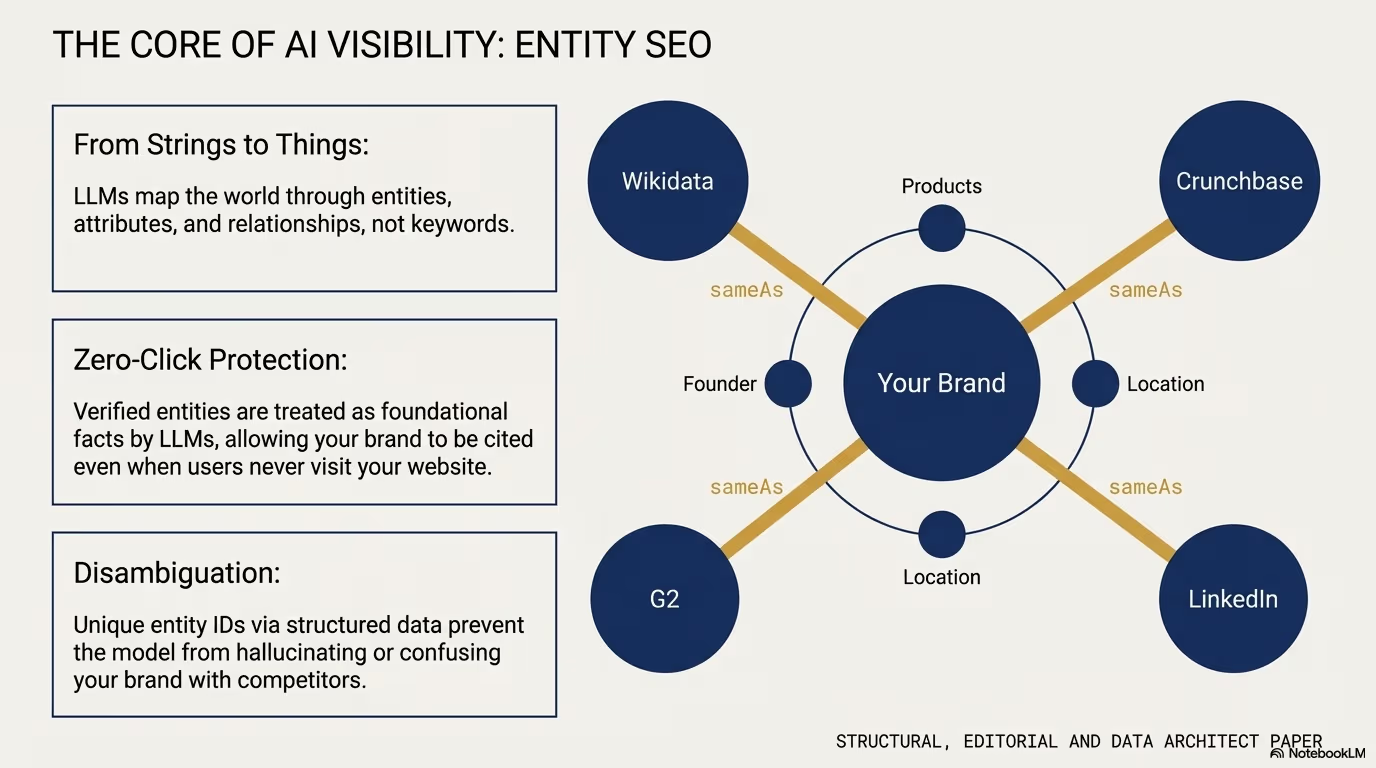
Der Entity-First-Ansatz geht noch einen Schritt weiter. Jedes Schlüsselkonzept sollte mit der entsprechenden Wikidata-Entität verknüpft sein, und die strukturierten Daten sollten Entity-Beziehungen ausdrücken statt sie anzudeuten. Ein System, das einen klaren Entity-Graphen durch Ihre Inhalte verfolgen kann, behandelt die Website als Wissensbestand und nicht als Sammlung unzusammenhängender Texte.
4. Die 90-Tage-Frische-Klippe
Die Auswertung von Seer Interactive zur Wirkung der Inhaltsaktualität auf KI-Sichtbarkeit kommt darauf, dass innerhalb von 90 Tagen aktualisierte Inhalte etwa doppelt so hohe Zitationsraten erzielen wie älteres Material. Der Grund liegt weniger in einer Vorliebe für neue Dateien als in der Risikoabwägung des Anbieters: Eine veraltete Angabe, die als Zitat in einer Antwort erscheint, ist ein Fehler, der dem Antwortsystem zugerechnet wird, nicht Ihnen.
Deshalb ist das Datum allein wertlos. Ein Änderungsdatum, das sich bewegt, ohne dass sich der Text bewegt, ist im besten Fall wirkungslos und im schlechteren Fall ein Signal für Manipulation. Eine echte Aktualisierung tauscht eine Zahl gegen eine neuere mit benannter Quelle, streicht eine Empfehlung, die nicht mehr gilt, oder ergänzt einen Abschnitt zu einer Entwicklung, die es beim Schreiben noch nicht gab.
Auf der Rechtsachse hat die Frische-Frage eine eigene Konsequenz, und sie betrifft den Vorbehalt. Ein Rechtevorbehalt wirkt für die Zukunft. Was ein Modell bereits aufgenommen hat, verschwindet nicht dadurch, dass Sie heute eine Zeile in die robots.txt schreiben. Ein Modell mit festem Wissensstand kann Ihre alte Fassung noch Monate nach der Korrektur wiedergeben, ohne je wieder bei Ihnen anzuklopfen. Die einzige Abhilfe, die verlässlich greift, ist der andere Kanal: Wenn die Live-Abrufe erlaubt bleiben, wird die aktuelle Fassung geholt und überschreibt im Kontext das ältere Wissen. Wer alles blockiert, friert damit auch den Stand ein, mit dem über ihn gesprochen wird.
Praktisch heißt das: Vierteljährlich Statistiken und Datenpunkte prüfen, Abschnitte zu neuen Unterthemen ergänzen, Veröffentlichungs- und Änderungsdaten nur bei echten inhaltlichen Änderungen anfassen, externe Links auf Erreichbarkeit prüfen und Empfehlungen überarbeiten, die sich seit dem letzten Durchgang geändert haben. Die Kosten der Pflege gehören ab jetzt in dieselbe Rechnung wie die Kosten der Erstellung.
5. Die Legitimitätsschicht, und was sie mit Ihrem Vorbehalt anstellt
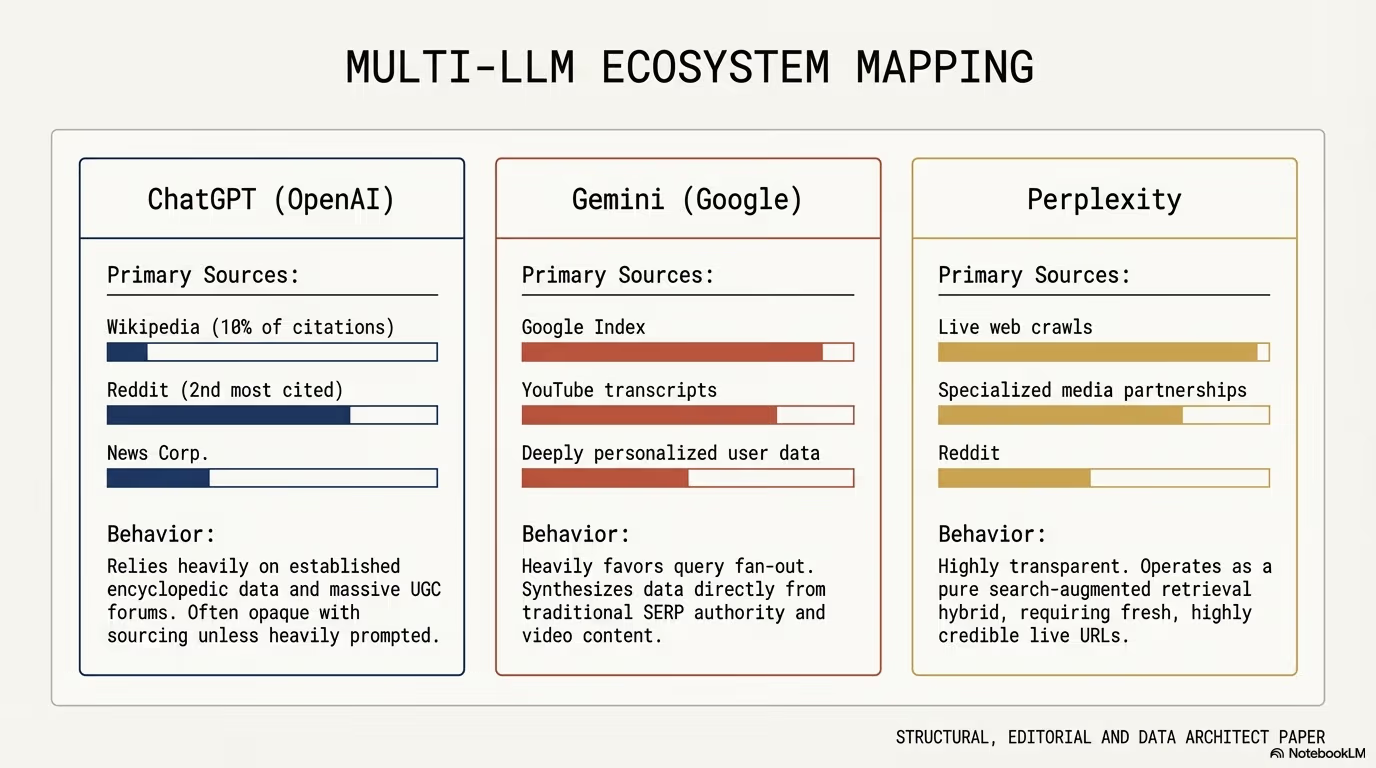
Profound hat Zitationsmuster über mehrere KI-Plattformen ausgewertet und kommt darauf, dass Wikipedia 7,8% aller ChatGPT-Zitate ausmacht. Die zweithäufigst zitierte Quelle, Reddit, liegt dahinter, repräsentiert aber weiterhin einen erheblichen Anteil.
“Wikipedia führt die ChatGPT-Zitate an mit einem Anteil von 7,8%, während die zweithäufigst zitierte Quelle, Reddit, weit abgeschlagen ist… es dient als ‘Legitimitätsschicht’ für Unternehmen.”
Der Mechanismus ist eine Vertrauensabkürzung. Ein Antwortsystem kann die Richtigkeit einer Aussage nicht selbst prüfen, also prüft es die Umgebung: Wird diese Marke, dieses Produkt, diese Person auch dort erwähnt, wo redaktionelle oder gemeinschaftliche Kontrolle stattfindet. Fällt die Antwort positiv aus, sinkt die Hemmschwelle, auch die eigene Domain der Marke zu zitieren.
Für die Rechtsachse hat dieser Mechanismus eine Pointe, die viele Rechtevorbehalte entwertet. Ihr Vorbehalt gilt für Ihre Hosts und Ihre Pfade. Er gilt nicht für ein Forum, in dem jemand Ihren Ratgeber zusammenfasst, nicht für einen Enzyklopädie-Artikel, der Ihre Angaben referenziert, und nicht für einen Presseartikel, der Sie zitiert. Ein Modell, das Sie auf Ihrer Domain nicht lesen darf, kann Sie über die dritte Quelle trotzdem wiedergeben, und zwar in der Fassung dieser dritten Quelle, mit deren Auslassungen und deren Fehlern.
Daraus folgt eine unangenehme Wahl, die man sich bewusst treffen sollte statt sie zu erben. Entweder Sie halten Ihre Inhalte zugänglich und sorgen dafür, dass die Primärfassung die genaueste und aktuellste ist, die ein System finden kann. Oder Sie sperren zu und akzeptieren, dass über Sie aus zweiter Hand gesprochen wird. Eine dritte Möglichkeit, in Antworten unsichtbar zu sein, gibt es nur, solange niemand außerhalb Ihrer Domain über Sie schreibt.
Digitale PR, Community-Arbeit und Fachbeiträge auf Drittplattformen sind unter dieser Logik keine Markenpflege mehr, sondern die Kontrolle über die Fassung, in der Sie weitergegeben werden. Wer dort präsent ist, korrigiert dort auch. Wer dort nicht präsent ist, erfährt von der Fassung erst, wenn ein Kunde sie vorliest.
Rechtevorbehalt, Content Signals und die Grenze der Durchsetzbarkeit
An dieser Stelle lohnt es sich, die Werkzeuge sauber zu trennen, weil sie im Alltag ständig verwechselt werden.
Die robots.txt ist im Robots Exclusion Protocol als RFC 9309 standardisiert. Sie ist eine Datei am Hostwurzelpfad, die Pfadregeln je User-Agent-Kennung enthält. Technisch geschieht bei einem Verstoß nichts: Der Server liefert die Seite weiterhin aus, denn die Datei ist eine Bitte, keine Zugangskontrolle. Ihre Wirkung beruht auf freiwilliger Befolgung durch seriöse Betreiber. Wer sie ignoriert, wird davon nicht gebremst.
Die Kennungen sind die eigentliche Arbeit, und sie sind pro Anbieter nach Zweck getrennt. Bei OpenAI holt GPTBot Material für das Training, OAI-SearchBot baut den Suchbestand auf, und ChatGPT-User ruft eine Seite ab, weil ein Mensch gerade danach gefragt hat. Anthropic trennt analog zwischen ClaudeBot, Claude-SearchBot und Claude-User, Perplexity zwischen PerplexityBot und dem nutzerausgelösten Abruf, Google zwischen Googlebot und Google-Extended. Eine Zeile, die pauschal alles sperrt, was “AI” im Namen trägt, trifft diese Zwecke wahllos und führt regelmäßig zum schlechtesten Ergebnis: Das Training bleibt unberührt, weil die Kennung anders heißt, und die Live-Abrufe verschwinden, mit ihnen die Zitate.
Die Content Signals Policy, von Cloudflare eingeführt, setzt genau hier an. Sie erweitert die robots.txt um eine maschinenlesbare Zweckangabe statt um noch eine Kennung: ob die Inhalte für die Suche, für die Verwendung als Eingabe in eine generierte Antwort und für das Modelltraining genutzt werden dürfen, jeweils mit einer ausdrücklichen Zustimmung oder Ablehnung. Der Vorzug dieser Form ist, dass sie den Zweck benennt statt den Anbieter, und damit auch für Kennungen gilt, die es beim Schreiben der Datei noch nicht gab. Die Policy selbst stellt klar, dass eine solche Angabe eine Willenserklärung ist und keine technische Sperre. Was sie leistet, ist Beweisbarkeit: Sie können später zeigen, was auf Ihrer Domain zu welchem Zeitpunkt maschinenlesbar erklärt war.
Genau diese Beweisbarkeit ist der Anschluss an das europäische Recht. Der Vorbehalt nach Artikel 4 der Richtlinie (EU) 2019/790 und § 44b UrhG muss für online zugängliche Inhalte maschinenlesbar erklärt sein. Eine Zweckangabe in der robots.txt ist dafür der naheliegendste Ort, ergänzt um eine Klausel in den Nutzungsbedingungen, die dasselbe in Prosa sagt. Das Landgericht Hamburg hat in der Entscheidung Kneschke gegen LAION angenommen, dass ein in natürlicher Sprache formulierter Vorbehalt in den Nutzungsbedingungen die Anforderung an die Maschinenlesbarkeit erfüllen kann, was für die Praxis bedeutet: beides schreiben, nicht eines von beidem.
Auf der Seite der Anbieter zieht die KI-Verordnung, Verordnung (EU) 2024/1689, die Gegenlinie. Anbieter von KI-Modellen mit allgemeinem Verwendungszweck müssen eine Strategie zur Einhaltung des Urheberrechts der Union vorhalten, einschließlich der Identifizierung und Beachtung erklärter Nutzungsvorbehalte, und eine hinreichend detaillierte Zusammenfassung der für das Training verwendeten Inhalte veröffentlichen. Das verwandelt Ihre robots.txt von einer Bitte in etwas, dessen Missachtung der Gegenseite zugerechnet werden kann.
Die Grenze bleibt trotzdem nüchtern zu benennen. Eine Deklaration erzeugt keinen Zugriffsschutz. Sie wirkt nur für die Zukunft, nur für Ihre Hosts, und nur gegenüber Akteuren, die sich identifizieren. Wer wirklich sperren will, arbeitet auf der Netzwerkebene: Verifikation der Kennung über die veröffentlichten IP-Bereiche und Reverse-DNS-Einträge des jeweiligen Anbieters, Ratenbegrenzung, und eine Blockregel, die den Abruf beendet statt ihn zu missbilligen. Erst dann ist aus der Erklärung eine Durchsetzung geworden.
Das Gegenstück auf der Angebotsseite ist die Datei /llms.txt. Sie steuert nichts und verbietet nichts, sie liefert ein kuratiertes, in Markdown formatiertes Verzeichnis für den Abruf zur Laufzeit. Der Zweck ist praktisch: Ein Agent mit begrenztem Kontextfenster kämpft mit verschachteltem HTML, Navigationsblöcken und nachgeladenen Inhalten, und eine saubere Zusammenfassung erspart ihm diese Arbeit. Wer den Trainingszugriff vorbehält, den Live-Abruf aber erlaubt, kann mit dieser Datei sehr genau bestimmen, welche Fassung seiner Aussagen ein Agent zuerst findet.
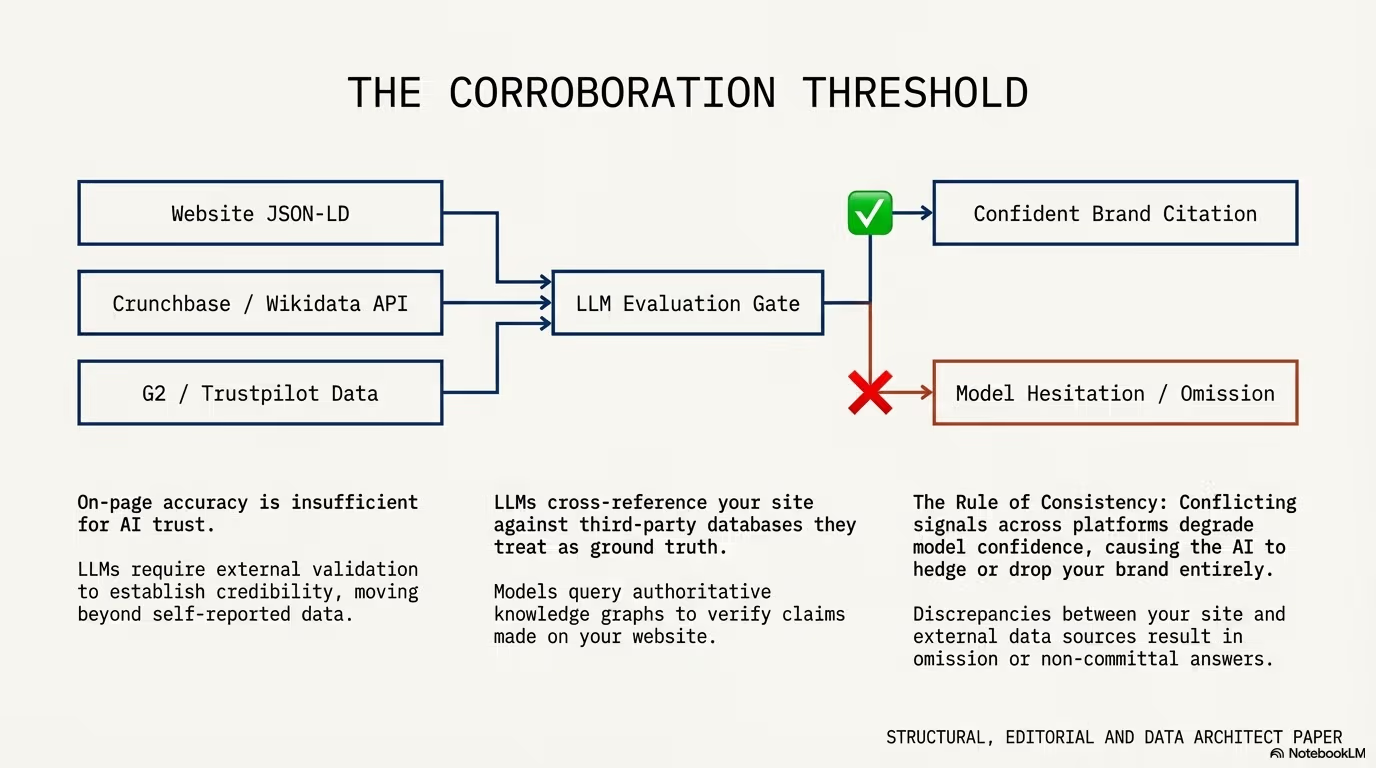
Die Umsetzung ist überschaubar. Eine Markdown-Datei im Wurzelverzeichnis beschreibt die Kompetenzbereiche der Website, listet die wichtigsten Seiten mit kurzen Zusammenfassungen und stellt klare, datierte Tatsachenbehauptungen bereit. Sie wird aktualisiert, wenn wesentliche Inhalte hinzukommen. Wichtig ist nur, sie nicht mit einer Rechtsposition zu verwechseln: Sie ist ein Angebot, kein Vorbehalt, und sie ersetzt die Zweckangabe in der robots.txt nicht.
So prüfen Sie den tatsächlichen Zustand statt der Annahme. Die Zugriffslogs nach User Agent gruppieren, die deklarierten Kennungen den veröffentlichten IP-Bereichen gegenüberstellen, und den Anteil notieren, der sich keiner Kennung zuordnen lässt. In unserer eigenen Messung war genau dieser Anteil der größte, was die Reihenfolge der Maßnahmen vorgibt: erst wissen, wer kommt, dann erklären, wer was darf, und erst dann diskutieren, ob eine Regel wirkt.
6. Absicht über Präzision: die Kraft des Query Fan-out
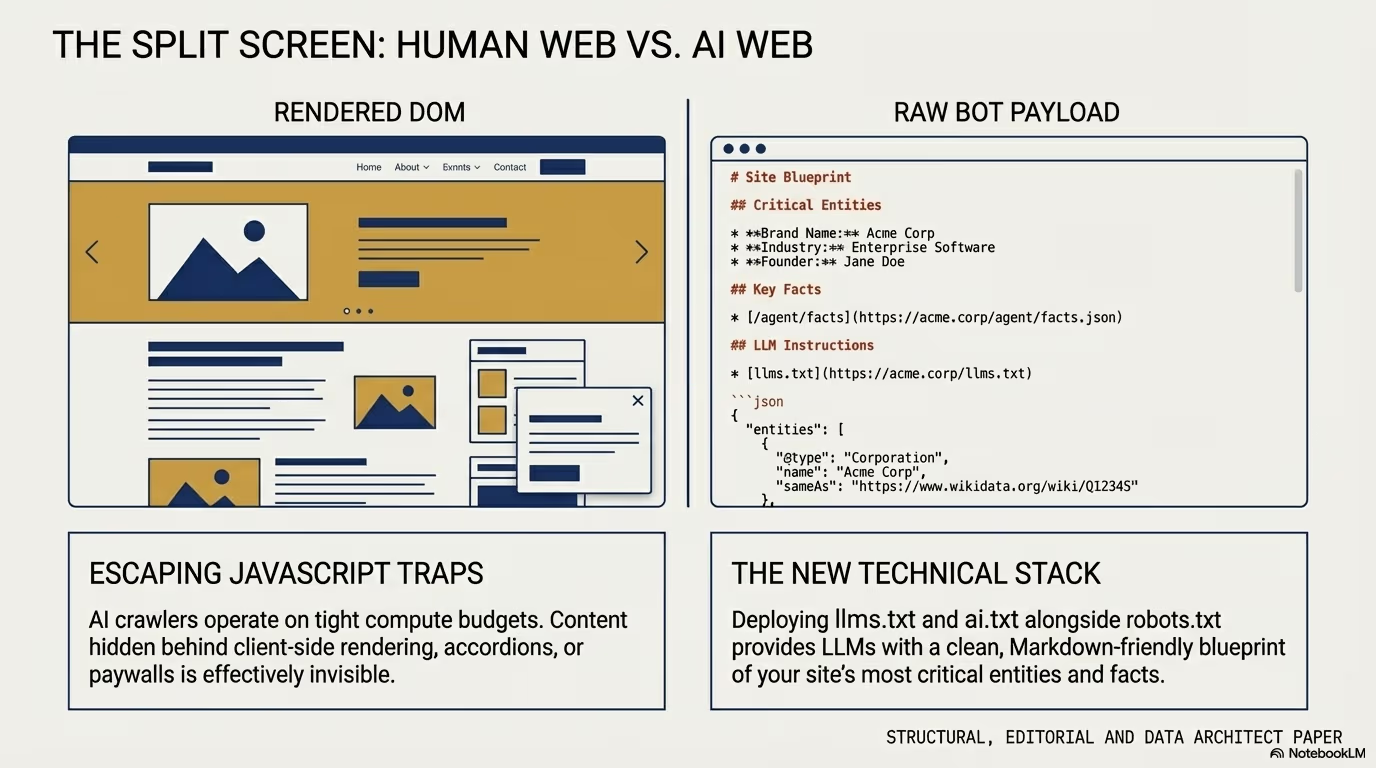
Der SOCi Visibility Index beziffert die durchschnittliche Länge einer getippten Suchanfrage auf 4 Wörter und die einer KI-Anfrage auf 23 Wörter. Der Unterschied ist nicht bloß Länge, sondern Inhalt: In den zusätzlichen Wörtern steht der Kontext, den ein Suchfeld nie bekommen hat.
Statt “beste WordPress Sicherheits-Plugins 2026” schreibt derselbe Nutzer: “Ich betreibe einen WooCommerce-Shop auf Shared Hosting und mache mir Sorgen um die Sicherheit. Welche Plugins sollte ich installieren, um mich gegen die häufigsten Angriffe zu schützen, ohne meine Seite zu verlangsamen?” Das System zerlegt diese Frage in Teilanfragen, sucht zu jeder Teilanfrage eigene Belege und setzt die Antwort daraus zusammen. Dieser Vorgang heißt Query Fan-out, und er erklärt, warum eine einzige Nutzerfrage mehrere Abrufe auf Ihrem Server auslöst.
Für die Redaktion folgt daraus, an Situationen entlang zu schreiben statt an Stichwörtern. Ein Abschnitt, der mit “Wenn Sie auf Shared Hosting arbeiten und kein eigenes WAF betreiben können” beginnt, passt auf eine Teilanfrage. Ein Abschnitt, der mit “Die besten Plugins” beginnt, passt auf keine. Inhalte nach dem Muster “Wenn Situation X, dann Ansatz Y, weil Z” werden häufiger zitiert als reine Empfehlungslisten, weil sie die Einschränkung mitliefern, die das System für seine Antwort braucht.
Der Fan-out hat außerdem eine Betriebsseite, die in diese Achse gehört. Mehrere Abrufe pro Frage bedeuten, dass die Last durch Agenten nicht mit der Zahl der Fragen skaliert, sondern mit deren Komplexität. Wer deshalb zur Ratenbegrenzung greift, trifft eine Entscheidung mit zwei Wirkungen: Sie senkt die Serverkosten, und sie senkt die Wahrscheinlichkeit, in Antworten vorzukommen, deren Recherche abgebrochen wurde. Diese Abwägung gehört dokumentiert, damit sie nicht ein halbes Jahr später als unerklärlicher Sichtbarkeitsverlust wieder auftaucht.
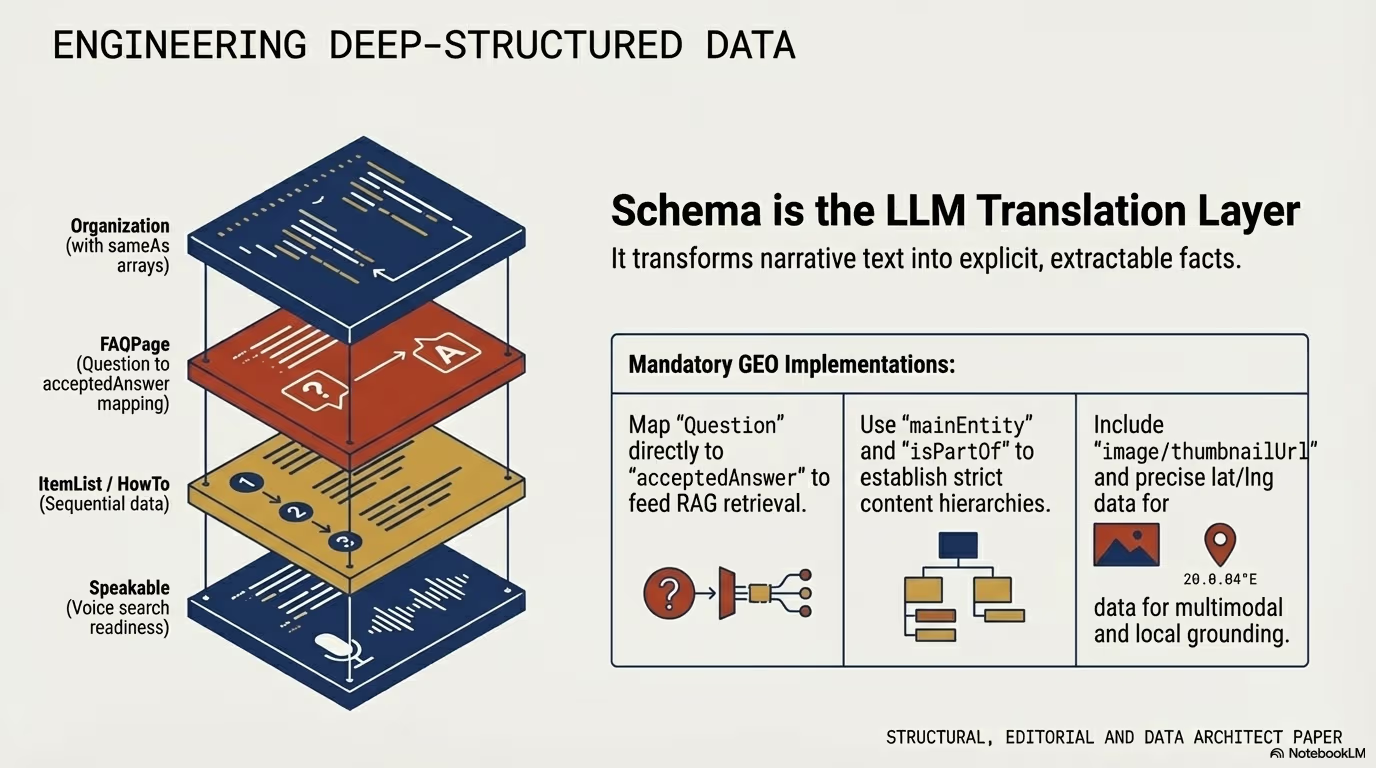
Long-Tail- und fragenbasierte Inhalte gewinnen unter dieser Mechanik an Wert. FAQ-Abschnitte, detaillierte Anleitungen und szenariospezifische Empfehlungen liefern genau die kleinteiligen, kontextbewussten Bausteine, aus denen ein Fan-out seine Antwort zusammensetzt.
7. Messen Sie, was ankommt, nicht was Sie erklärt haben
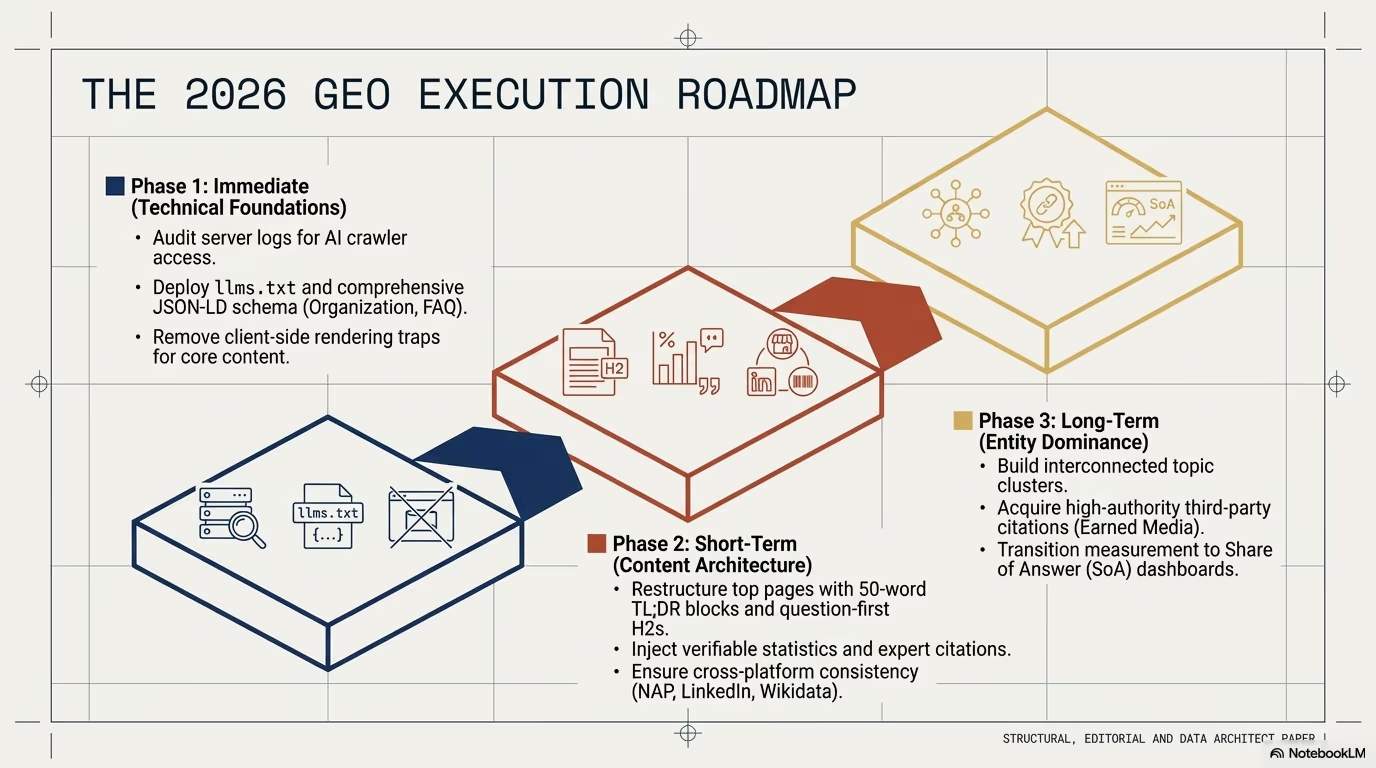
Die siebte Beobachtung ist die unbequemste, weil sie alle vorherigen auf die Probe stellt. Eine Regel in der robots.txt, eine Zweckangabe in den Content Signals und eine Klausel in den Nutzungsbedingungen sind drei Erklärungen. Keine davon ist ein Messwert. Ob sie wirken, steht in den Zugriffslogs, und zwar in der Differenz zwischen dem Zeitraum davor und danach.
Die Prüfung ist unspektakulär und dauert eine Stunde. Zugriffe nach Kennung gruppieren, die Treffer der bekannten Anbieter-Bots gegen deren veröffentlichte IP-Bereiche und Reverse-DNS-Namen verifizieren, den unzuordenbaren Rest getrennt ausweisen, und das Ganze für die Woche vor und die Woche nach der Änderung nebeneinanderlegen. Bleibt eine gesperrte Kennung im Log, wurde die Regel nicht befolgt oder sie greift nicht für den Pfad, den der Bot benutzt. Verschwindet dagegen eine Kennung, die Sie erlauben wollten, haben Sie zu breit gesperrt.
Die zweite Messung betrifft die Wirkung statt der Befolgung. Erscheint die Marke in generierten Antworten auf die Fragen, die für das Geschäft zählen, wird sie mit der aktuellen Fassung wiedergegeben, und stammt das Zitat von der eigenen Domain oder von einer dritten Quelle. Diese Prüfung ist Handarbeit und muss stichprobenartig wiederholt werden, weil es dafür keinen vollständigen Bericht gibt, den jemand für Sie führt.
Und die dritte Messung ist die, auf die niemand gerne schaut: die Serverlast, die Agenten erzeugen, aufgeschlüsselt nach Kennung. Sie ist die Rechnung, die Sie für Sichtbarkeit in Antworten bezahlen, und sie ist der einzige belastbare Ausgangspunkt für die Entscheidung, wo eine Grenze sinnvoll ist. Wer diese drei Zahlen kennt, führt die Diskussion über Rechtevorbehalte mit Belegen. Wer sie nicht kennt, führt sie mit Vermutungen.
Was dabei sichtbar wird, ist in der Regel unbequemer als die Erwartung. In unserer eigenen Auswertung ließ sich der größte Anteil der Anfragen keiner deklarierten Kennung zuordnen, womit sich ein erheblicher Teil des Traffics jeder regelbasierten Steuerung entzieht. Das ist kein Argument gegen die Erklärung, denn die Erklärung wirkt gegenüber denen, die sich zu erkennen geben, und das sind die Anbieter, gegen die eine Rechtsposition überhaupt etwas wert ist. Es ist ein Argument dagegen, die Erklärung für erledigt zu halten.
Die Antwort werden, ohne die Rechte abzugeben
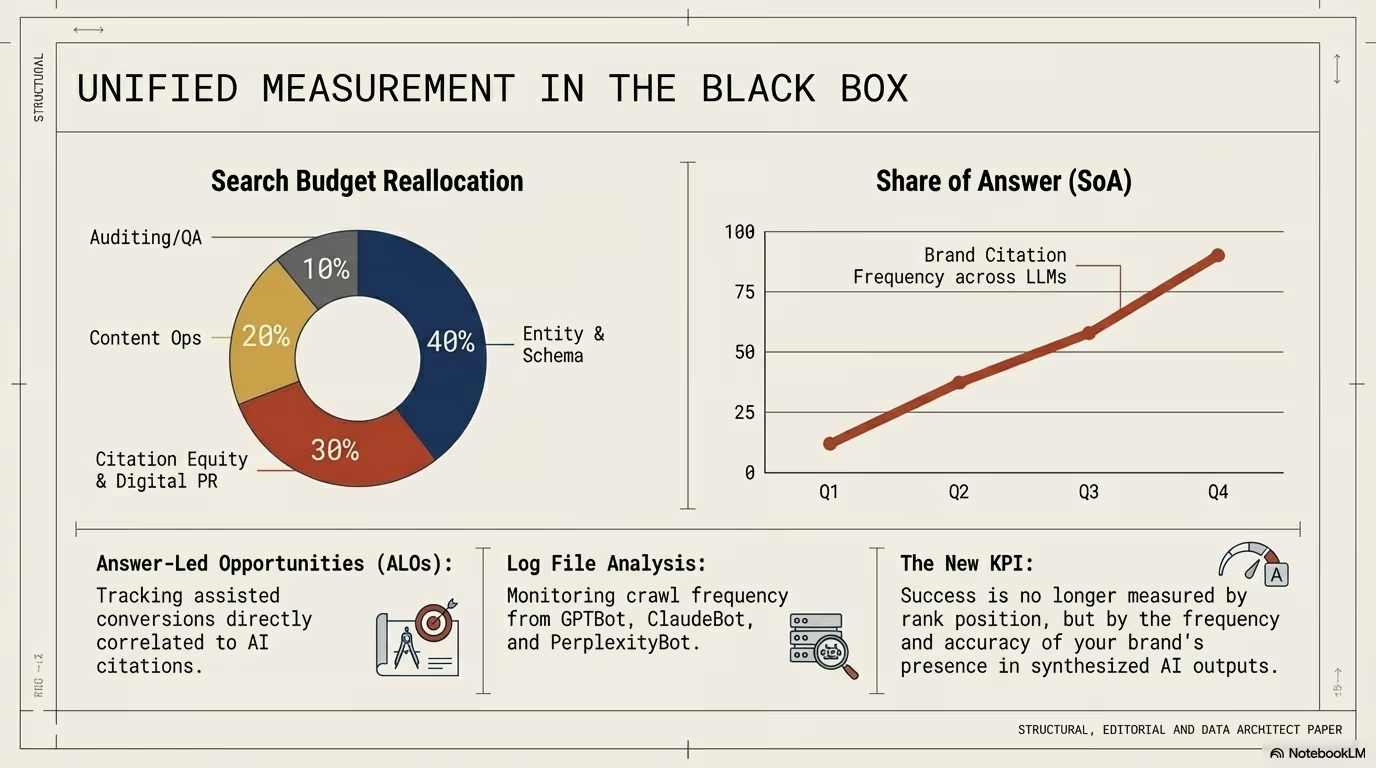
Sichtbarkeit im Jahr 2026 heißt, die Fassung zu liefern, auf die sich ein Antwortsystem stützt, und zugleich zu kontrollieren, zu welchem Zweck es das darf. Die beiden Ziele stehen nicht im Widerspruch, aber sie werden von unterschiedlichen Werkzeugen bedient, und die Verwechslung der beiden ist der häufigste Fehler in diesem Feld.
Die sieben Beobachtungen ergeben eine Arbeitsliste mit klarer Reihenfolge:
- Zuerst messen, wer tatsächlich abruft: Zugriffslogs nach Kennung gruppieren, die deklarierten Kennungen gegen veröffentlichte IP-Bereiche verifizieren und den unzuordenbaren Rest getrennt ausweisen.
- Den Zweck erklären, nicht den Anbieter: eine Zweckangabe nach der Content Signals Policy in der robots.txt, ergänzt um einen Nutzungsvorbehalt in den Nutzungsbedingungen, damit maschinenlesbare und sprachliche Form zusammenpassen.
- Die Kennungen nach Zweck unterscheiden: Trainings-Bot, Such-Bot und nutzerausgelöster Abruf sind drei Entscheidungen und nicht eine.
- Für die Extraktion strukturieren: die belastbarste Aussage mit Quelle und Datum nach oben, Beleg und Einschränkung darunter.
- Autorität als Netz bauen: mindestens fünf verknüpfte Seiten je Thema, wechselseitig verlinkt, mit beschreibendem Ankertext und Entity-Markup.
- Frisch halten, weil das Alternativszenario schlechter ist: ein blockierter Live-Abruf friert die Fassung ein, mit der über Sie gesprochen wird.
- Auf Drittplattformen präsent bleiben: Ihr Vorbehalt endet an Ihrer Domain, die Wiedergabe Ihrer Inhalte nicht.
- Durchsetzen statt bitten, wo es darauf ankommt: eine Blockregel auf Netzwerkebene, sonst bleibt es bei einer Erklärung.
Bleibt die Frage, die kein Werkzeug beantwortet. Wenn ein Nutzer nie auf die Website klickt, aber die richtige Antwort Ihrer Marke von einem Modell erhält, haben Sie gewonnen oder verloren. Die ehrliche Antwort hängt vom Geschäftsmodell ab: Wer von Reichweite lebt, verliert, wer von Aufträgen lebt, gewinnt möglicherweise, und wer Inhalte verkauft, muss den Vorbehalt ernster nehmen als die Sichtbarkeit. Diese Entscheidung lässt sich nicht an ein Tool delegieren, aber sie lässt sich informiert treffen, sobald die drei Messungen aus dem vorigen Abschnitt vorliegen.