Eine Anfrage, deren User-Agent Googlebot lautet, beweist nur eines: Jemand hat das Wort Googlebot in einen Header geschrieben. Entscheidend ist die IP-Adresse. Sie muss in der Liste stehen, die Google veröffentlicht, oder eine Reverse-DNS-Abfrage mit anschließender Forward-Abfrage bestehen. Dieser Leitfaden führt von einem einzeiligen grep auf Ihr Access-Log bis zu einer Firewall-Regel, die Fälschungen sperrt und den echten Crawler durchlässt.
Anlass ist ein Bericht von Search Engine Roundtable vom 30. Oktober 2026 über ein Interview mit Gary Illyes von Google im Odys Podcast. Illyes bringt darin die Zunahme vorgetäuschter Bots mit KI in Verbindung. Liegt Ihre WordPress-Website hinter Cloudflare, lesen Sie auch meinen Beitrag Blockiert Cloudflare den Googlebot?. Dort geht es um die KI-Bot-Einstellungen, den Bot Fight Mode und darum, was eine 403-Antwort mit indexierten Seiten macht. Hier geht es um den Schritt davor: zu wissen, wer überhaupt anklopft.
Alle Befehle und Konfigurationen in diesem Beitrag habe ich am 30. Oktober 2026 gegen die aktuellen Dateien von Google laufen lassen, mit nginx 1.27.2 und Apache 2.4.63 auf einer Testmaschine. Was ich nicht auf einem Produktivserver prüfen konnte, kennzeichne ich.
Warum gibt es plötzlich so viele gefälschte Googlebots?
Barry Schwartz von Search Engine Roundtable hat das Gespräch zwischen Illyes und der Gastgeberin des Podcasts, Aneta Samkoff, zusammengefasst. Auf die Frage, warum das Vortäuschen von Bots zu so einem Problem geworden ist, antwortete Illyes:
“Ich glaube, es ist KI.”
Gary Illyes, zitiert von Search Engine Roundtable, 30. Oktober 2026, eigene Übersetzung; die Folge auf YouTube, Odys Podcast
Seine Begründung laut dem Bericht: Firmen suchen Inhalte, um Modelle zu trainieren. Firewalls und CDNs erkennen Crawler inzwischen besser, aber nicht fehlerfrei. Eine kleine KI-Suchmaschine oder ein Scraper, der sich als Googlebot ausgibt, wird deshalb oft durchgelassen, wo er sonst hängen bliebe. Ebenfalls laut Search Engine Roundtable betreibt Illyes Honeypots, also Fallen für Crawler, und hat dort Anfragen gesehen, die sich als Googlebot ausgaben und von IP-Adressen ohne jeden Bezug zu Google kamen. Der Titel der Folge beziffert den Aufwand für so eine Fälschung auf etwa 30 Sekunden. Das deckt sich mit der Praxis: Den User-Agent setzt der Client selbst.
Ein Transkript der Folge habe ich nicht gefunden. Alles, was ich hier Illyes zuschreibe, stammt deshalb aus dem Bericht von Search Engine Roundtable.
Die Logik des Fälschers ist schlicht. Wer Scraper aussperrt, macht fast immer eine Ausnahme für den Googlebot, weil niemand aus der Google-Suche fallen will. Jede Regel nach dem Muster “Googlebot darf rein”, die die IP nicht prüft, ist damit eine offene Tür mit Hinweisschild. Die Search-Console-Hilfe von Google sagt das in einem anderen Zusammenhang selbst: Wer dem Googlebot den Zugang ohne Anmeldung erlaubt, hebt den Schutz der Seite praktisch auf, weil der Googlebot gefälscht werden kann (Search Console-Hilfe, Bericht “Crawling-Statistik”).
Ich habe nur Shared Hosting. Was kann ich ohne Serverzugang tun?
Ein großer Teil der kleinen WordPress-Websites in Deutschland, Österreich und der Schweiz läuft auf Shared Hosting. Die nginx-Konfiguration können Sie dort nicht anfassen, SSH gibt es je nach Tarif nicht, und das Access-Log laden Sie als Datei aus dem Kundenbereich Ihres Hosters herunter. Für die Diagnose reicht das. Alle Analysebefehle unten laufen auch auf Ihrem eigenen Rechner, mit dem heruntergeladenen Log statt /var/log/nginx/access.log. Unter macOS und Linux sind grep, awk und host vorhanden, unter Windows nutzen Sie das Linux-Subsystem (WSL).
Für die Sperre bleiben Ihnen auf Shared Hosting drei realistische Ebenen:
.htaccess, sofern der Hoster Apache oder einen kompatiblen Server einsetzt und die nötigen Overrides erlaubt. Die getestete Variante steht weiter unten.- Cloudflare oder ein anderes CDN vor der Website. Dort wird die Bot-Prüfung bereits erledigt, und Sie schreiben nur noch eine Regel.
- Ein Sicherheits-Plugin, wenn es die IP prüft und nicht nur den User-Agent. Welche Einstellung bei Wordfence den Unterschied macht, beschreibe ich unten.
Prüfen Sie aber zuerst, ob es überhaupt ein Problem gibt. Ein Dutzend gefälschter Zugriffe am Tag auf eine Firmenwebsite rechtfertigt keine Sperre. Mehrere tausend Anfragen an die interne WordPress-Suche von einem “Googlebot” aus einem Rechenzentrum, das nicht zu Google gehört, sehr wohl, weil jede ungecachte Suchanfrage PHP und die Datenbank belastet.
Wie finde ich Anfragen im Access-Log, die sich als Googlebot ausgeben?
Fangen Sie mit Zahlen an. Auf einem nginx-Server mit dem üblichen Combined-Log-Format listet dieser Befehl die IP-Adressen, die einen Googlebot-User-Agent geschickt haben, die aktivsten zuerst:
grep -i 'googlebot' /var/log/nginx/access.log | awk '{print $1}' | sort | uniq -c | sort -rn | head -20Unter Apache liegt die Datei meist unter /var/log/apache2/access.log (Debian, Ubuntu) oder /var/log/httpd/access_log (RHEL und Verwandte). Bei Shared Hosting setzen Sie den Pfad zur heruntergeladenen Datei ein. Das Format ist fast immer dasselbe Combined-Format.
Um zu sehen, was jede dieser Adressen angefragt hat, geben Sie die IP neben der Anfragezeile aus:
awk -F'"' 'tolower($6) ~ /googlebot/ {split($1,a," "); print a[1], $2}' /var/log/nginx/access.log | head -50Das folgende Beispiel ist konstruiert, mit Dokumentationsadressen aus RFC 5737 statt echtem Verkehr, zeigt aber das Muster, nach dem Sie suchen:
66.249.66.1 GET / HTTP/1.1
203.0.113.7 GET /wp-login.php HTTP/1.1
203.0.113.7 GET /?s=test HTTP/1.1
Der echte Googlebot hat selten einen Grund, wp-login.php, xmlrpc.php oder eine endlose Reihe interner Suchadressen abzurufen. Ein “Googlebot”, der genau das tut, kommt zuerst auf die Prüfliste. Das URL-Muster sagt Ihnen nur, wo Sie anfangen. Entscheiden tut die IP.
Zach Chahalis macht denselben Punkt in seinem Leitfaden zur Logauswertung für die KI-Suche bei Moz vom 29. Oktober 2026: Ein User-Agent sei ein Name, den sich der Anfragende selbst gibt, Scraper könnten die Zahlen aufblähen, und Sicherheitsregeln gegen gefälschte Bots könnten versehentlich auch echte treffen (Moz, How To Analyze Server Logs for AI Search). Er empfiehlt, die Bot-Prüfung schon beim Import der Logs einzuschalten, etwa die Option Verify Bots When Importing Logs im Log File Analyser von Screaming Frog. Dann tauchen Fälschungen gar nicht erst in Ihren Diagrammen auf.
Wie prüfe ich eine Googlebot-IP mit host oder dig?
Google beschreibt eine manuelle Prüfung in vier Schritten (Google, Verify requests from Google crawlers and fetchers):
- Machen Sie mit
hosteine Reverse-DNS-Abfrage auf die IP aus Ihrem Log. - Prüfen Sie, ob der Hostname auf
googlebot.com,google.comodergoogleusercontent.comendet. - Machen Sie eine Forward-DNS-Abfrage auf diesen Hostnamen.
- Prüfen Sie, ob sie die ursprüngliche IP zurückliefert.
So sah das am 30. Oktober 2026 für eine der Beispieladressen von Google aus:
$ host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.
$ host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Der Forward-Schritt ist Pflicht. Wer einen IP-Block kontrolliert, kann dessen Reverse-DNS-Eintrag auf jeden beliebigen Namen setzen, auch auf crawl-1-2-3-4.googlebot.com. Die DNS-Server von Google dazu bringen, auf die Frage nach diesem Namen seine Adresse zu nennen, kann er nicht. dig +short -x 66.249.66.1 und dig +short crawl-66-249-66-1.googlebot.com liefern dieselben Antworten in kürzerer Form.
Bei mehr als einer Handvoll Adressen lohnt sich eine Schleife. Dieses Skript akzeptiert Hostnamen von Google und Bing. Ich habe es am 30. Oktober 2026 mit Adressen von Google, Bing und zwei Adressen ohne Crawler-Bezug getestet:
#!/usr/bin/env bash
# Two-way DNS check for an IP that claims to be Googlebot or Bingbot.
# Usage: ./verify_dns.sh 66.249.66.1 [more IPs]
for ip in "$@"; do
  name=$(host "$ip" | awk '/domain name pointer/ {print $NF; exit}')
  name=${name%.}
  case "$name" in
    *.googlebot.com|*.google.com|*.googleusercontent.com|*.search.msn.com) ;;
    *) echo "$ip FAKE: PTR is '${name:-none}'"; continue ;;
  esac
  if host "$name" | grep -qwF -- "$ip"; then
    echo "$ip OK: $name"
  else
    echo "$ip FAKE: $name does not resolve back to $ip"
  fi
done
Die Ausgabe an diesem Tag: 66.249.66.1 OK: crawl-66-249-66-1.googlebot.com, 157.55.39.1 OK: msnbot-157-55-39-1.search.msn.com, 8.8.8.8 FAKE: PTR is 'dns.google'. Drei Einschränkungen gelten. host kommt unter Debian und Ubuntu aus dem Paket dnsutils, bei RHEL und Verwandten aus bind-utils. “FAKE” heißt nur “weder Google noch Bing”, lassen Sie das Skript also nur auf Adressen los, die sich als Crawler ausgegeben haben, nicht auf das ganze Log. Und IPv6-Adressen lassen sich in mehreren gültigen Schreibweisen darstellen, der Textvergleich kann daher einen Treffer übersehen. Für IPv6 nehmen Sie die Listenmethode weiter unten.
Welcher Hostname gehört zu welcher Art von Google-Crawler?
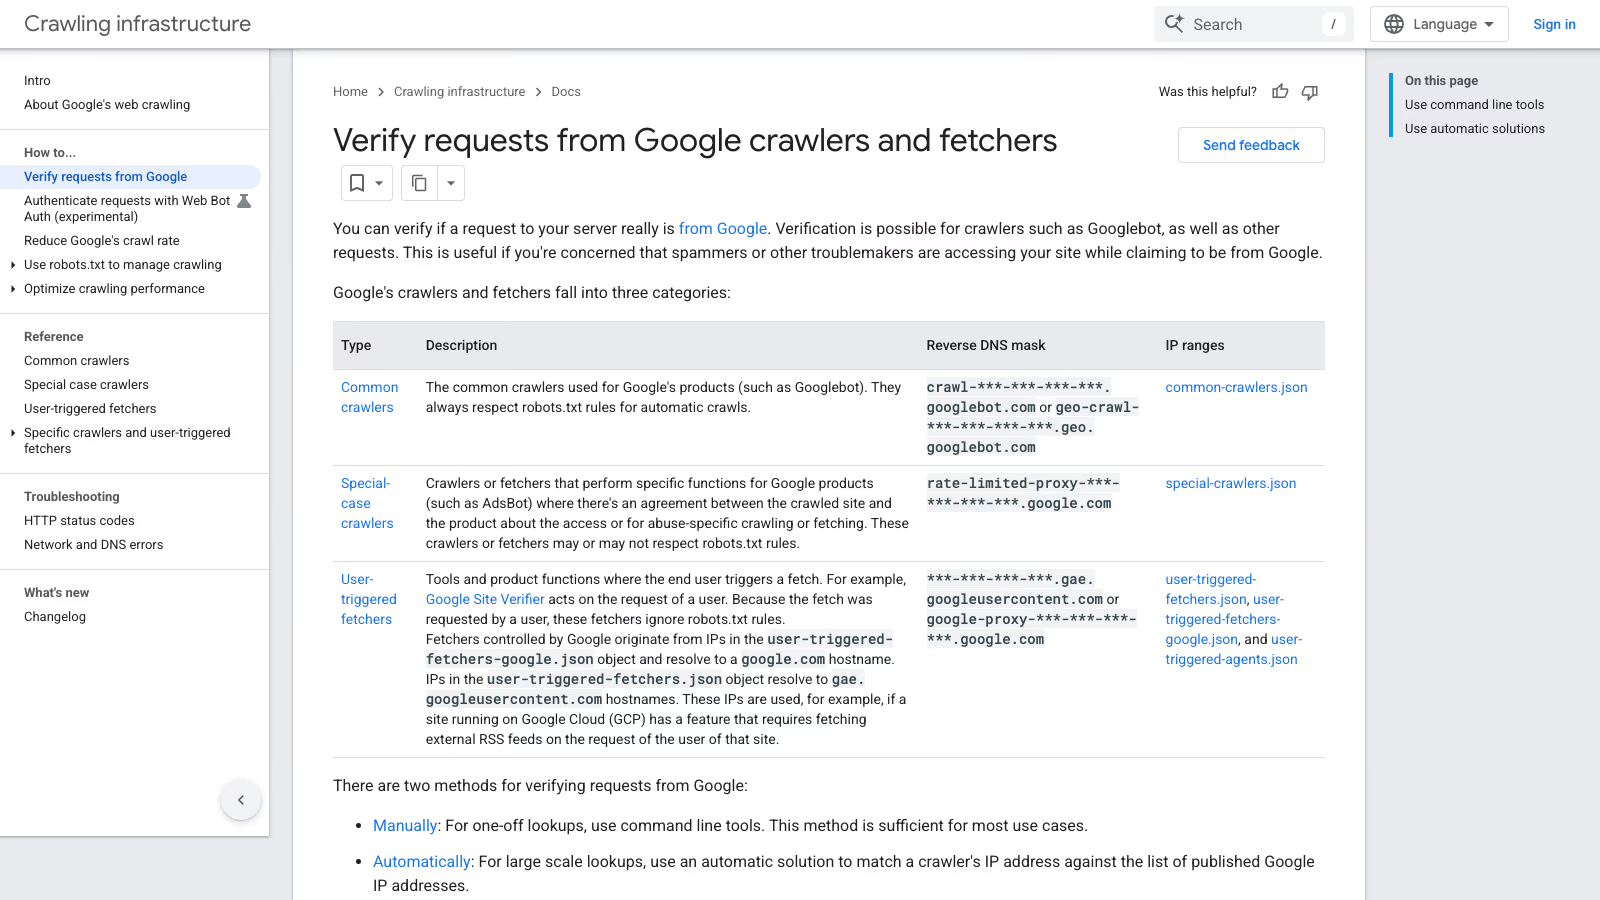
Google teilt seinen Verkehr in drei Gruppen, jede mit eigenem Hostnamen-Muster und eigener IP-Datei (Google, Verify requests):
| Gruppe | Beispiele | robots.txt | Reverse-DNS | IP-Datei |
|---|---|---|---|---|
| Gewöhnliche Crawler | Googlebot, Googlebot-Image, Google-InspectionTool | Bei automatischem Crawling immer beachtet | crawl-***-***-***-***.googlebot.com oder geo-crawl-***-***-***-***.geo.googlebot.com | common-crawlers.json |
| Spezial-Crawler | AdsBot | Wird beachtet oder nicht, je nach Crawler | rate-limited-proxy-***-***-***-***.google.com | special-crawlers.json |
| Vom Nutzer ausgelöste Fetcher | Google Site Verifier, Feedfetcher, Google-Agent | Ignoriert, weil ein Mensch den Abruf ausgelöst hat | ***-***-***-***.gae.googleusercontent.com oder google-proxy-***-***-***-***.google.com | user-triggered-fetchers.json, user-triggered-fetchers-google.json, user-triggered-agents.json |
Praktisch zählt an dieser Tabelle vor allem eines: Eine Anfrage mit Googlebot-User-Agent sollte aus der ersten Zeile stammen. Löst sie auf gae.googleusercontent.com auf, hat sie Schritt 2 der manuellen Prüfung bestanden und ist trotzdem nicht der Googlebot. Google erklärt, dass die IPs aus user-triggered-fetchers.json auf gae.googleusercontent.com auflösen und zum Beispiel genutzt werden, wenn eine Website auf Google Cloud im Auftrag eines ihrer Nutzer einen fremden RSS-Feed abruft. Ein legitimer Abruf, aber eben nicht der Such-Crawler.
Welche IP-Liste von Google ist die richtige, und wo ist googlebot.json hin?
Google veröffentlicht fünf JSON-Dateien im CIDR-Format unter https://developers.google.com/static/crawling/ipranges/. Am 30. Oktober 2026 enthielten sie so viele Präfixe (die Zahlen ändern sich, nehmen Sie sie als Momentaufnahme):
| Datei | Präfixe am 30.10.2026 | Wofür |
|---|---|---|
common-crawlers.json | 317 | Googlebot und die übrigen gewöhnlichen Crawler |
special-crawlers.json | 272 | AdsBot und andere Spezial-Crawler |
user-triggered-fetchers.json | 1068 | Abrufe im Auftrag von Nutzern von Google-Cloud-Websites |
user-triggered-fetchers-google.json | 504 | Vom Nutzer ausgelöste Fetcher, die Google selbst betreibt |
user-triggered-agents.json | 20 | Google-Agent und ähnliche Agenten |
Haben Sie vor ein paar Jahren ein Skript geschrieben, lädt es vermutlich googlebot.json. Am 30. Oktober 2026 lieferte die alte Adresse https://developers.google.com/search/apis/ipranges/googlebot.json eine 301-Weiterleitung auf common-crawlers.json, während https://developers.google.com/static/crawling/ipranges/googlebot.json mit 404 antwortete. Ein Skript, das Weiterleitungen folgt, funktioniert weiter. Eines, das auf den neueren Pfad festgelegt ist oder jede Antwort außer 200 als leere Liste behandelt, nicht. Prüfen Sie Ihres. Aus einer leeren Erlaubnisliste wird aus “gefälschten Googlebot sperren” schnell “Googlebot sperren”.
Für andere Google-Dienste, die Ihre Website aufrufen könnten, etwa Apps Script, verweist Google auf die allgemeine Liste unter https://www.gstatic.com/ipranges/goog.json.
Bing und OpenAI veröffentlichen Dateien im selben Aufbau: ein Feld creationTime und ein Array prefixes mit Einträgen ipv4Prefix oder ipv6Prefix. Ein einziges Skript kann deshalb alle prüfen. Dieses kommt mit der Python-Standardbibliothek aus:
#!/usr/bin/env python3
"""Check IPs against the crawler IP lists Google, Bing and OpenAI publish.

Usage: python3 verify_bot_ip.py 66.249.66.1 157.55.39.1 1.2.3.4
       awk '{print $1}' access.log | sort -u | python3 verify_bot_ip.py -
"""
import ipaddress
import json
import sys
import urllib.request

LISTS = {
    "google-common": "https://developers.google.com/static/crawling/ipranges/common-crawlers.json",
    "google-special": "https://developers.google.com/static/crawling/ipranges/special-crawlers.json",
    "google-user-fetchers": "https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers.json",
    "google-user-fetchers-google": "https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers-google.json",
    "google-user-agents": "https://developers.google.com/static/crawling/ipranges/user-triggered-agents.json",
    "bingbot": "https://www.bing.com/toolbox/bingbot.json",
    "openai-gptbot": "https://openai.com/gptbot.json",
    "openai-searchbot": "https://openai.com/searchbot.json",
    "openai-chatgpt-user": "https://openai.com/chatgpt-user.json",
}


def load(url):
    with urllib.request.urlopen(url, timeout=20) as r:
        data = json.load(r)
    return [
        ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix"))
        for p in data["prefixes"]
    ]


def main(args):
    ips = [l.strip() for l in sys.stdin] if args == ["-"] else args
    nets = {name: load(url) for name, url in LISTS.items()}
    for raw in filter(None, ips):
        try:
            ip = ipaddress.ip_address(raw)
        except ValueError:
            print(f"{raw}\tnot an IP")
            continue
        hits = [n for n, ranges in nets.items() if any(ip in net for net in ranges)]
        print(f"{ip}\t{', '.join(hits) or 'NOT IN ANY LIST'}")


if __name__ == "__main__":
    main(sys.argv[1:])
Geben Sie ihm jede IP, die sich als Googlebot ausgegeben hat:
grep -i 'googlebot' /var/log/nginx/access.log | awk '{print $1}' | sort -u | python3 verify_bot_ip.py -Am 30. Oktober 2026 lautete die Antwort 66.249.66.1 google-common, 66.249.90.77 google-special, 157.55.39.1 bingbot und 8.8.8.8 NOT IN ANY LIST. Auch IPv6 klappte (2001:4860:4801:10::1 google-common). Das Skript lädt bei jedem Lauf neun Dateien herunter. Starten Sie es von Hand oder per Cron, niemals pro Anfrage.
Warum besteht eine echte Googlebot-IP manchmal die Hostnamen-Prüfung nicht?
Beim Testen habe ich auch das zweite Beispiel von Google geprüft, 35.247.243.240. Laut Google löst es auf geo-crawl-35-247-243-240.geo.googlebot.com auf. Am 30. Oktober 2026 lieferten sowohl mein System-Resolver als auch der öffentliche Resolver 8.8.8.8 stattdessen 240.243.247.35.bc.googleusercontent.com. Die Nachbaradresse 35.247.243.241 lieferte den dokumentierten Namen geo-crawl-35-247-243-241.geo.googlebot.com, und 35.247.243.240 liegt im Bereich 35.247.243.240/28 aus common-crawlers.json.
Warum genau diese eine Adresse einen anderen PTR-Eintrag hat, weiß ich nicht, und es ist eine einzelne Beobachtung. Eine Regel, die nur *.googlebot.com akzeptiert, hätte eine IP abgewiesen, die Google selbst als gewöhnlichen Crawler führt. Eine Regel, die jeden googleusercontent.com-Namen akzeptiert, ließe vom Nutzer ausgelöste Fetcher durch, die kein Googlebot sind. Für eine Anfrage mit Googlebot-User-Agent ist die Mitgliedschaft in common-crawlers.json der entscheidende Test. Die DNS-Methode bleibt für Einzelprüfungen, so beschreibt Google sie auch selbst: für die meisten Fälle ausreichend, mit den IP-Listen als Empfehlung für die Prüfung in großem Umfang.
Wie sperre ich gefälschte Googlebots in nginx?
Der Ansatz: Aus common-crawlers.json eine Include-Datei erzeugen, Anfragen markieren, deren User-Agent “googlebot” enthält, und 403 nur dann zurückgeben, wenn der User-Agent Googlebot behauptet und die IP nicht auf der Liste steht. Zuerst der Generator:
#!/usr/bin/env python3
# Builds allow lists from Google's common-crawlers.json (Googlebot and friends).
# Usage: python3 make_googlebot_ranges.py nginx  > /etc/nginx/googlebot-ranges.conf
#        python3 make_googlebot_ranges.py apache > /etc/apache2/googlebot-ranges.conf
import json, sys, urllib.request

URL = "https://developers.google.com/static/crawling/ipranges/common-crawlers.json"
with urllib.request.urlopen(URL, timeout=20) as r:
    nets = [p.get("ipv4Prefix") or p.get("ipv6Prefix") for p in json.load(r)["prefixes"]]
if not nets:
    sys.exit("empty list from Google, refusing to write")

if sys.argv[1:] == ["nginx"]:
    print("\n".join(f"{n} 1;" for n in nets))
elif sys.argv[1:] == ["apache"]:
    for i in range(0, len(nets), 20):
        print("Require ip " + " ".join(nets[i:i + 20]))
else:
    sys.exit("usage: make_googlebot_ranges.py nginx|apache")
Am Testtag erzeugte er 317 Zeilen für nginx und 16 Zeilen für Apache. Bei einem falschen Argument bricht er mit Fehlercode ab und schreibt nichts.
Dann der nginx-Teil. Die Blöcke geo und map gehören in den http-Kontext, das if in den server-Block Ihrer WordPress-Website:
# http { ... }
geo $googlebot_ip {
    default 0;
    include /etc/nginx/googlebot-ranges.conf;
}
map $http_user_agent $claims_googlebot {
    default 0;
    ~*googlebot 1;
}
map "$claims_googlebot:$googlebot_ip" $fake_googlebot {
    default 0;
    "1:0"   1;
}

# server { ... }
if ($fake_googlebot) {
    return 403;
}
Ich habe genau diesen Block getestet: Eine normale Browser-Anfrage bekam 200, eine Anfrage mit Googlebot-User-Agent von einer Nicht-Google-IP bekam 403, ein Bingbot-User-Agent bekam 200, und nachdem ich die Adresse der Testmaschine in die Include-Datei eingetragen hatte, bekam dieselbe Googlebot-Anfrage 200. Den letzten Schritt sollten Sie auf Ihrem Server mit einer echten Googlebot-IP aus Ihren Logs wiederholen, bevor Sie der Regel trauen.
Aktualisieren Sie die Liste per Cron und schreiben Sie dabei zuerst in eine temporäre Datei, damit ein fehlgeschlagener Download nginx nie mit einer leeren Include-Datei zurücklässt:
python3 make_googlebot_ranges.py nginx > /tmp/googlebot-ranges.conf \
  && mv /tmp/googlebot-ranges.conf /etc/nginx/googlebot-ranges.conf \
  && nginx -t && systemctl reload nginx
Den Generator und nginx -t habe ich laufen lassen, die Zeile mit mv und reload als Ganzes nicht auf einem Produktivserver. Prüfen Sie beim ersten Einsatz, ob der Cron-Benutzer die Rechte für beide Schritte hat.
Die Falle, die diese Regel gegen Sie wendet, ist ein Reverse Proxy vor nginx. Hinter Cloudflare, einem Load Balancer oder dem Proxy eines Hosters ist $remote_addr die Adresse des Proxys, nie die von Google, und jeder echte Googlebot bekommt 403. Richten Sie zuerst das realip-Modul ein (set_real_ip_from für jeden Proxy-Bereich und real_ip_header CF-Connecting-IP; für Cloudflare) und kontrollieren Sie im Access-Log, dass dort Besucher-IPs stehen und keine Proxy-IPs, bevor Sie die Sperre aktivieren.
Wie sperre ich gefälschte Googlebots in Apache oder per .htaccess?
Apache 2.4 schafft dasselbe mit mod_setenvif und mod_authz_host. Im Virtual Host oder in einem <Directory>-Block:
SetEnvIfNoCase User-Agent "googlebot" claims_googlebot
<RequireAny>
    <RequireAll>
        Require all granted
        Require not env claims_googlebot
    </RequireAll>
    Include /etc/apache2/googlebot-ranges.conf
</RequireAny>
Gelesen heißt das: Herein darf jeder, der nicht behauptet, Googlebot zu sein, und dazu jeder von einer gelisteten IP. Mein Test brachte dieselben Ergebnisse wie bei nginx: 200 für den Browser, 403 für den gefälschten Googlebot, 200 für einen Googlebot-User-Agent von einer Adresse, die ich in die Include-Datei eingetragen hatte.
Auf Shared Hosting landet die Regel in der .htaccess, und dort ist Include nicht erlaubt (das Ergebnis wäre ein Fehler 500). Fügen Sie stattdessen die Require ip-Zeilen, die der Generator aus dem nginx-Abschnitt ausgibt, direkt in den Block ein. Am 30. Oktober 2026 waren es 16 Zeilen mit je 20 Bereichen:
SetEnvIfNoCase User-Agent "googlebot" claims_googlebot
<RequireAny>
    <RequireAll>
        Require all granted
        Require not env claims_googlebot
    </RequireAll>
    # Hier die "Require ip ..."-Zeilen einfügen, die
    # python3 make_googlebot_ranges.py apache ausgibt.
    # Ohne sie bekommt jeder echte Googlebot 403.
</RequireAny>
Auch diese .htaccess-Variante habe ich getestet, mit denselben drei Ergebnissen. Der Hoster muss dafür die Overrides AuthConfig und FileInfo erlauben. Mit AuthConfig allein beantwortete mein Testserver jede Anfrage mit einem Fehler 500 und schrieb SetEnvIfNoCase not allowed here ins Fehlerlog. Rufen Sie deshalb gleich nach dem Hochladen die Startseite im Browser auf. Viele Shared-Hosting-Angebote laufen auf LiteSpeed statt Apache. LiteSpeed liest die meisten .htaccess-Direktiven, aber diesen Block habe ich darauf nicht getestet. Prüfen Sie das Ergebnis von Ihrem eigenen Rechner aus mit einem gefälschten User-Agent:
curl -s -o /dev/null -w "%{http_code}\n" -A "Googlebot/2.1 (+http://www.google.com/bot.html)" https://ihre-domain.de/Sie sollten 403 sehen und ohne die Option -A ein normales 200. Bekommen Sie in beiden Fällen 403, sperrt die Regel alle Besucher und muss sofort wieder raus.
Für Apache gilt dieselbe Proxy-Falle wie für nginx. Hinter Cloudflare braucht es mod_remoteip mit RemoteIPHeader CF-Connecting-IP und den Cloudflare-Bereichen als vertrauenswürdigen Proxys, sonst sperrt die Regel den echten Crawler. Auf Shared Hosting haben Sie darauf meist keinen Einfluss. Steht Ihre Website hinter Cloudflare und Sie können mod_remoteip nicht selbst einrichten, gehört die Regel an den Rand des Netzes, also in den nächsten Abschnitt.
Wie sperre ich gefälschte Googlebots in Cloudflare?
Liegt die Website hinter Cloudflare, ist der Rand des Netzes der bessere Ort, weil Cloudflare die Bots bereits für Sie prüft. Das Feld cf.client.bot gibt laut Dokumentation an, ob die Anfrage von einem bekannten guten Bot oder Crawler stammt (Cloudflare Docs, cf.client.bot). Als verifiziert gilt ein Bot bei Cloudflare, wenn er sich über eine Web-Bot-Auth-Signatur, eine veröffentlichte IP-Liste mit stabilem User-Agent oder Reverse-DNS ausweist und sich dabei maßvoll verhält, also etwa die robots.txt beachtet und die Website nicht mit Anfragen überhäuft (Cloudflare Docs, Verified bots).
Eine benutzerdefinierte Regel gegen gefälschte Googlebots:
(lower(http.user_agent) contains "googlebot" and not cf.client.bot)lower() steht dort, weil Zeichenkettenvergleiche in der Regelsprache von Cloudflare zwischen Groß- und Kleinschreibung unterscheiden (Cloudflare Docs, Functions). Das Beispiel von Cloudflare selbst kombiniert einen Länderfilter mit not cf.client.bot und einer Managed Challenge (Cloudflare Docs, Allow traffic from search engine bots).
Diesen Ausdruck habe ich nicht auf einer Produktivzone eingesetzt, nehmen Sie ihn also als Ausgangspunkt. Bevor Sie Block wählen, lassen Sie den Ausdruck als Filter in Security Analytics laufen oder starten Sie mit Managed Challenge, und vergewissern Sie sich, dass keine Anfrage von einer IP aus common-crawlers.json darunter fällt. Erkennt Cloudflare einen echten Googlebot einmal nicht und Ihre Regel sagt Block, bekommt Google eine 403. Laut Google werden URLs, die einen 4xx-Code außer 429 liefern, aus dem Index entfernt, sofern sie indexiert waren (Google, HTTP status codes).
Cloudflare stellt außerdem cf.verified_bot_category bereit, eine Zeichenkette mit dem Zweck eines verifizierten Bots. Ältere Werte wie Search Engine Crawler und AI Crawler funktionieren in benutzerdefinierten Regeln weiterhin. In welchen Tarifen das Feld zur Verfügung steht, sagt die Feldreferenz nicht. Schauen Sie also in Ihrem Regel-Editor nach, bevor Sie darauf aufbauen. Benutzerdefinierte Regeln laufen vor dem Super Bot Fight Mode (Cloudflare Docs, Challenge bad bots). Wie der kostenlose Bot Fight Mode und die KI-Bot-Kategorien mit dem Googlebot zusammenspielen, steht im Beitrag über Cloudflare.
Sperren WordPress-Sicherheits-Plugins gefälschte Googlebots richtig?
Manche ja, wenn die richtige Einstellung gewählt ist. Wordfence ist ein gutes Beispiel, weil die Dokumentation beide Seiten offenlegt. In den Optionen zur Ratenbegrenzung prüft Verified Google crawlers have unlimited access to this site per Reverse-DNS, und ein Besucher mit gefälschtem Googlebot-Header fällt laut Wordfence bei der PTR-Prüfung durch. Die Alternative Anyone claiming to be Google has unlimited access tut, was der Name sagt: Auch ein gefälschter Googlebot bekommt unbegrenzten Zugang (Wordfence Help, Rate limiting). Wenn Sie die Ratenbegrenzung von Wordfence nutzen, schauen Sie nach, welche der beiden Optionen aktiv ist.
Für jedes Plugin und jede eigene Regel trennen drei Fragen das Brauchbare vom Riskanten:
- Prüft es die IP oder nur den User-Agent? Eine Regel, die allein nach User-Agent sperrt oder durchlässt, ist genau das, worauf Fälscher setzen.
- Nutzt es eine aktuelle Liste oder eine DNS-Prüfung in Echtzeit? Eine fest eingetragene IP-Liste, 2019 aus einem Forum kopiert, kennt die neueren Bereiche von Google nicht und sperrt den echten Crawler.
- Läuft es vor oder nach dem Seiten-Cache? Ein PHP-Plugin sieht nur Anfragen, die bis zu PHP kommen. Liefert Ihr Hoster oder ein Cache-Plugin fertiges HTML direkt aus, begegnet ein gefälschter Googlebot, der gecachte Seiten liest, dem Plugin nie. Beim Schutz vor Scraping zählt diese Ebene, bei Brute-Force-Versuchen auf
wp-login.phpweniger, weil diese Adresse nicht gecacht wird.
Regeln, die Bots in der .htaccess über eine Liste von User-Agents “aussperren”, haben das umgekehrte Problem: Sie halten ehrliche Crawler auf, die sich zu erkennen geben, und lassen jeden Lügner durch. Finde ich so eine Liste bei einer Website, die ich im Rahmen der WordPress-Wartung betreue, ersetze ich sie durch eine IP-basierte Regel oder verlege die Entscheidung an den Rand des Netzes. Muss die Sperrlogik in der Anwendung selbst leben, etwa in einem eigenen Plugin bei einem Hoster ohne Serverzugang, ist das Arbeit für die WordPress-Entwicklung und bekommt dieselbe IP-Liste als Quelle.
Wie prüfe ich Bingbot und die Crawler von OpenAI?
Bingbot. Microsoft setzt auf dieselbe DNS-Prüfung in beide Richtungen: Die Reverse-Abfrage muss auf search.msn.com enden, und die Forward-Abfrage dieses Namens muss dieselbe IP liefern (Bing Webmaster Blog, How to Verify that Bingbot is Bingbot). Am 30. Oktober 2026:
$ host 157.55.39.1
1.39.55.157.in-addr.arpa domain name pointer msnbot-157-55-39-1.search.msn.com.
$ host msnbot-157-55-39-1.search.msn.com
msnbot-157-55-39-1.search.msn.com has address 157.55.39.1
Bing bietet außerdem ein öffentliches Prüfwerkzeug unter bing.com/toolbox/verify-bingbot und dasselbe Werkzeug in den Bing Webmaster Tools. Die IP-Liste bing.com/toolbox/bingbot.json trug beim Abruf eine creationTime vom 3. Januar 2024. Eine Liste, die seit fast drei Jahren nicht neu erzeugt wurde, kann trotzdem stimmen, aber eine harte Sperre würde ich darauf nicht bauen. Deshalb decken die nginx- und Apache-Regeln oben nur den Googlebot ab. Bei Bing prüfen Sie die Adressen aus Ihrem eigenen Log zuerst mit dem DNS-Skript und entscheiden erst dann.
OpenAI. OpenAI dokumentiert vier Crawler, jeden mit eigener IP-Datei (OpenAI, Overview of OpenAI crawlers):
| User-Agent | Zweck | IP-Liste |
|---|---|---|
OAI-SearchBot | Zeigt Websites in den Suchantworten von ChatGPT | openai.com/searchbot.json |
GPTBot | Crawlt Inhalte, die für das Training von Modellen genutzt werden können | openai.com/gptbot.json |
ChatGPT-User | Ruft eine Seite ab, wenn ein Nutzer danach fragt; laut OpenAI gelten die Regeln der robots.txt dabei unter Umständen nicht | openai.com/chatgpt-user.json |
OAI-AdsBot | Prüft Zielseiten, die als Anzeigen in ChatGPT eingereicht wurden | openai.com/adsbot.json |
Das Python-Skript oben prüft die ersten drei Listen bereits mit. Dasselbe nginx-Muster funktioniert auch für diese Crawler, wenn Sie es brauchen: eine eigene geo-Include-Datei aus der passenden Liste und ein User-Agent-Abgleich auf den passenden Namen.
Was sollte ich beim Aufräumen des Bot-Verkehrs nie sperren?
Ein übereifriges Aufräumen kann mehr kosten als die Fälschungen selbst, weil dann die echten Crawler draußen bleiben. Diese gehören in keine Sperrregel:
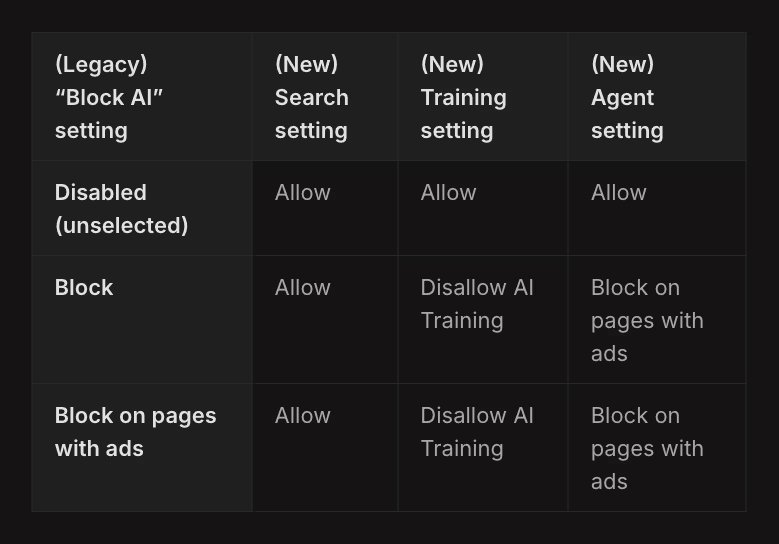
- Google-Extended. Ein Token für die robots.txt, kein Crawler. Laut Google gibt es keinen eigenen User-Agent-String. Gecrawlt wird mit den bestehenden Google-User-Agents, und das Token steuert nur, ob Inhalte für das Training und das Grounding von Gemini genutzt werden dürfen. Auf die Aufnahme einer Website in die Google-Suche hat es keinen Einfluss, und es ist auch kein Ranking-Signal (Google, common crawlers). Eine Serverregel, die im User-Agent nach Google-Extended sucht, kann nur Fälschungen treffen. Wer aus dem Gemini-Training heraus will, nimmt eine Disallow-Zeile in der robots.txt. Die verschiedenen Schalter von Google habe ich in Googles drei KI-Schalter im Vergleich gegenübergestellt.
- Vom Nutzer ausgelöste Fetcher. Google Site Verifier ruft Ihr Bestätigungs-Token für die Search Console ab, Feedfetcher liest Ihren RSS-Feed, Google Read Aloud liest Nutzern Seiten vor, GoogleMessages baut Linkvorschauen. Sie ignorieren die robots.txt absichtlich, weil ein Mensch sie angefordert hat (Google, user-triggered fetchers). Wer sie sperrt, legt die Bestätigung und die Vorschauen lahm, nicht das Crawling.
- Google-InspectionTool. Die URL-Prüfung der Search Console und der Test für Rich-Suchergebnisse nutzen ihn. Seine IPs stehen in der Liste der gewöhnlichen Crawler, sein User-Agent enthält aber nicht “Googlebot”, die Regeln oben lassen ihn also in Ruhe.
- Google-Agent. Die Agenten von Google, die im Auftrag eines Nutzers handeln, verwenden ihn, mit IPs aus
user-triggered-agents.json. Google experimentiert für einen Teil dieser Anfragen mit Web Bot Auth unter der Identitäthttps://agent.bot.goog. Die eigene Dokumentation sagt, dass nicht jede Anfrage signiert wird und die Prüfung auf IP-Adressen, Reverse-DNS und User-Agent zurückfallen soll (Google, Web Bot Auth). Signierte Anfragen tragen den HeaderSignature-Agent: g="https://agent.bot.goog"und werden gegen die Schlüssel unteragent.bot.goog/.well-known/http-message-signatures-directorynach RFC 9421 geprüft. Für eine WordPress-Website heißt das praktisch: Überlassen Sie diese Prüfung Ihrem CDN, wenn es sie beherrscht, und sperren Sie nicht, was es noch nicht prüfen kann.
Den Googlebot selbst beschreibt Google nicht als signierenden Crawler. Für ihn bleibt es bei IP-Liste und DNS.
Die robots.txt hat in dieser Werkzeugkiste gegen Fälscher nichts verloren. Illyes nannte sie laut der Zusammenfassung von Search Engine Roundtable eine Bitte und keine durchsetzbare Beschränkung. Ehrliche Crawler lesen sie. Ein gefälschter Googlebot ignoriert sie oder liest den Googlebot-Abschnitt und nimmt ihn als Erlaubnis.
Ändert das Sperren gefälschter Googlebots die Crawling-Statistik in der Search Console?
Das sollte es nicht, und genau deshalb taugt der Bericht als Kontrolle. Der Bericht zur Crawling-Statistik zeigt laut Google die Crawling-Historie von Google auf Ihrer Website (Search Console-Hilfe, Bericht “Crawling-Statistik”). Anfragen von Fälschern tauchen darin nie auf, weil Google sie nie gestellt hat. Google ergänzt, dass der Bericht derzeit die meisten Crawling-Anfragen erfasst, aber nicht alle. Kleine Abweichungen gegenüber Ihren Logs sind also normal.
Daraus ergibt sich eine grobe Prüfung. Zeigt Ihr Log für dieselben Tage deutlich mehr “Googlebot”-Anfragen als die Crawling-Statistik, ist der Überschuss ein Kandidat für Fälschungen, und das IP-Skript liefert die Gewissheit. Das ist meine Schlussfolgerung, keine Aussage von Google. Für den umgekehrten Fall gibt es eine offizielle Erklärung: Zeigt die Crawling-Statistik viel mehr als Ihre Logs, kann das laut Google passieren, wenn die robots.txt zu lange nicht erreichbar war und Google die Crawls mitzählt, die es gemacht hätte.
Nach dem Aktivieren einer Sperre beobachten Sie ein bis zwei Wochen lang zwei Dinge in der Crawling-Statistik. Die Gesamtzahl der Crawling-Anfragen sollte stabil bleiben, und die Aufschlüsselung nach Antwortcode sollte keine neuen 403 zeigen. Steigen die 403-Antworten direkt nach einer Regeländerung, trifft die Regel den echten Googlebot. Google stellt klar, dass 401 und 403 nicht zur Begrenzung der Crawling-Frequenz verwendet werden sollen (Google, HTTP status codes). Ist echtes Crawling das Lastproblem, bremsen 429 oder 503 Google vorübergehend, ohne dass URLs sofort herausfallen.
Fehlersuche: Was bedeutet welches Ergebnis?
| Was Sie sehen | Was es bedeutet | Was zu tun ist |
|---|---|---|
| Googlebot-User-Agent, IP in keiner Liste, PTR fehlt oder ist fremd | Fälschung | Am Rand des Netzes oder auf dem Server sperren, kein SEO-Risiko |
PTR endet auf googlebot.com, Forward-Abfrage liefert eine andere IP | Jemand hat einen falschen PTR-Eintrag gesetzt | Als Fälschung behandeln, genau dafür gibt es den Forward-Schritt |
Googlebot-User-Agent, PTR unter gae.googleusercontent.com | Vom Nutzer ausgelöster Abruf, nicht der Such-Crawler | In user-triggered-fetchers.json nachsehen, nicht als Googlebot zählen |
IP in common-crawlers.json, PTR außerhalb des dokumentierten Musters | Echter Google-Crawler mit ungewöhnlichem PTR (am 30.10.2026 einmal gesehen) | Der Liste vertrauen |
| Log zeigt viel mehr Googlebot-Zugriffe als die Crawling-Statistik | Wahrscheinlich Fälschungen im Log | IP-Skript auf diese Adressen anwenden |
| Crawling-Statistik zeigt viel mehr Anfragen als das Log | Laut Google war die robots.txt zu lange nicht erreichbar | Abrufstatus der robots.txt in der Search Console prüfen |
| 403-Antworten in der Crawling-Statistik steigen nach einer neuen Regel | Die Regel trifft den echten Googlebot | Umgang mit Proxy-IPs, Aktualität der Liste und Reihenfolge der Regeln prüfen |
| Ihr eigener SEO-Crawler mit Googlebot-User-Agent bekommt 403 | Die Regel funktioniert: Ihre IP gehört nicht Google | Für Audits einen anderen User-Agent nehmen oder die eigene IP ausdrücklich erlauben |
| Regel sperrt nicht einmal eine offensichtliche Fälschung | Server sieht die Proxy-IP statt der Besucher-IP, oder der Seiten-Cache hat zuerst geantwortet | realip oder remoteip richtig einrichten oder die Regel ins CDN verlegen |
Checkliste für eine WordPress-Website
- Zählen Sie die IPs, die sich in der letzten Woche im Access-Log als Googlebot ausgegeben haben.
- Lassen Sie das IP-Skript darüber laufen und notieren Sie, wie viele
NOT IN ANY LISTsind. - Vergleichen Sie die Summe aus dem Log mit der Crawling-Statistik für dieselben Tage.
- Wenn Sie sperren, dann nach IP plus User-Agent, nie nach User-Agent allein.
- Prüfen Sie hinter einem Proxy oder CDN, dass der Server Besucher-IPs protokolliert, bevor Sie eine IP-Regel aktivieren.
- Erzeugen Sie Erlaubnislisten aus
common-crawlers.jsonund aktualisieren Sie sie per Cron mit einer Sicherung gegen leere Downloads. - Lassen Sie Google-Extended, die vom Nutzer ausgelösten Fetcher, Google-InspectionTool und Google-Agent aus jeder Sperrregel heraus.
- Beobachten Sie die 403-Antworten in der Crawling-Statistik zwei Wochen lang nach jeder Änderung.
Zeigen Ihre Logs viele gefälschte Zugriffe auf wp-login.php und xmlrpc.php, ist der falsche Googlebot meist das kleinste Problem auf dem Server. Ein WordPress-Sicherheitsaudit beginnt bei denselben Access-Logs und schaut sich an, was diese Anfragen eigentlich erreichen wollten.