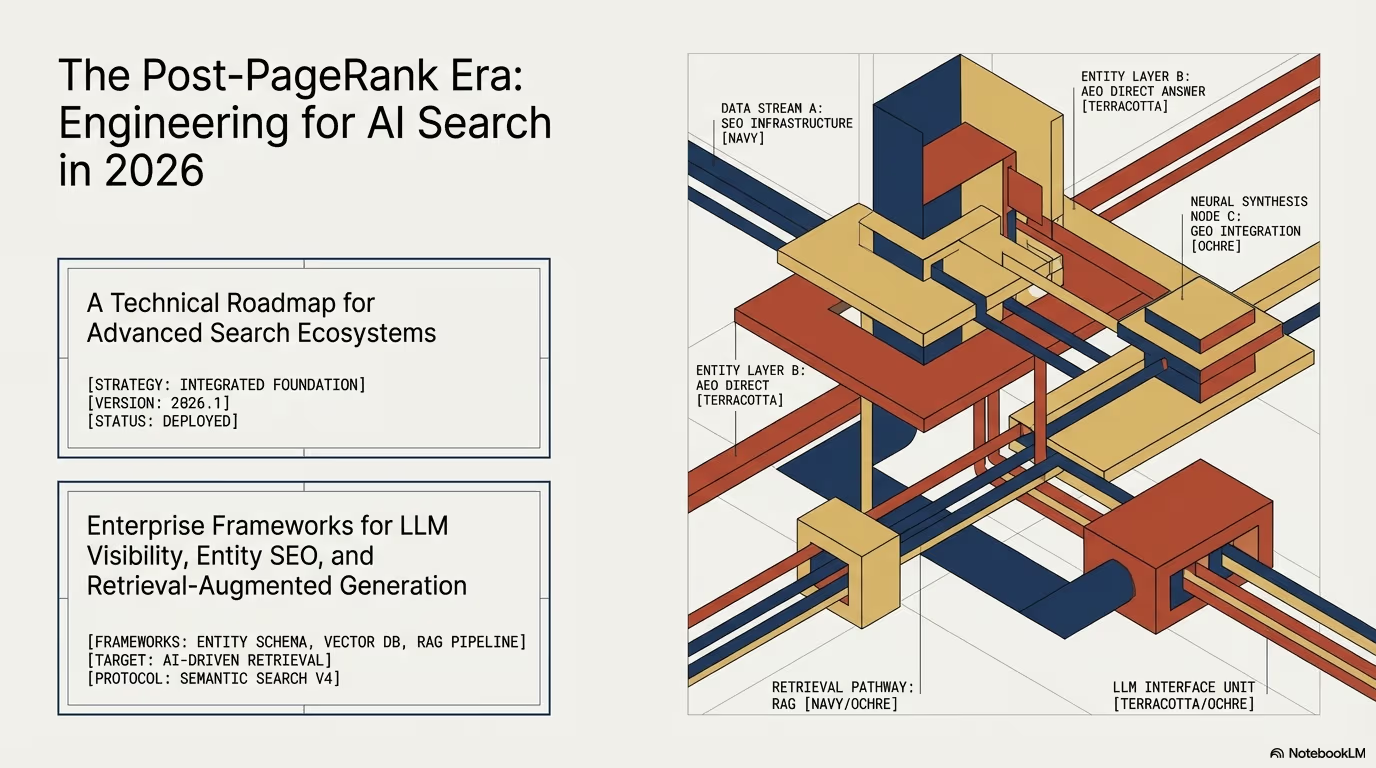
GEO (Generative Engine Optimization) ist keine magische Schicht auf altem WordPress. Es ist eine Folge von Entscheidungen, wie Entity, Leistungen und Belege in Indizes landen, aus denen Google AI Overviews, Perplexity, ChatGPT mit Browsing und interne Firmen-Agenten schöpfen. 2026 hören wir in Gesprächen mit WooCommerce-Inhabern und Agentur-Marketing dieselben fünf Mythen: llms.txt allein reicht, Markdown ersetzt HTML, FAQ-Schema „schaltet“ Zitate ein, Rankings spielen keine Rolle mehr, klassisches SEO kann warten. Im Folgenden entkräften wir das anhand dessen, was wir auf wppoland.com ausliefern und was in der Google Search Console sichtbar ist, ohne erfundene Prozentzahlen aus Webinaren.
Worin sich GEO von LinkedIn-Gebetsmühlen unterscheidet
GEO in der Praxis ist Zitierbarkeit plus Retrieval, kein neues Plugin-Bündel. Ein Modell oder eine generative Suche muss: (1) wissen, dass ihr als Entity existiert, (2) eine URL mit zitierbaren Sätzen haben, (3) diese URL gegenüber Wettbewerbern als glaubwürdig einstufen. Ein LinkedIn-Post „wir haben für KI optimiert“ ohne Landing-Änderungen, ohne lastVerified, ohne konsistenten Text in llms.txt und ohne Tabellen, die ein Extractor hebt, erfüllt keine dieser Bedingungen.
Für WordPress-Agenturen verdoppelt sich das Problem. Der Kunde hat hunderte URLs (Portfolio, Städte, Plugins), während ein KI-Assistent pro Antwort wenige Quellen zitiert. Sinnvolles GEO konzentriert sich deshalb auf Angebots-Pillars und Fachartikel, nicht auf massenhaftes llmCard auf jeder Stadtseite von 2019. Auf wppoland.com bündeln wir Aufwand um WordPress-Entwickler, WooCommerce, Wartung, Headless-Migration, MCP und LLMO-Inhalte. Der Rest der Site lebt weiter von klassischem SEO und Indexierung.
Auf der WordCamp Europe 2026 in Wien lief im Hallway-Track dasselbe Muster wie in Joe Halls Thread Ende September: Hype überholt Infrastruktur. Unternehmen kaufen GEO-Audits, bevor kanonische URLs und der erste Absatz auf der Seite stehen, für die sie Ads bezahlen. In Deutschland sehen wir dasselbe, wenn eine Agentur ein „AI SEO“-Plugin auf Elementor mit LCP über 4 s setzt und ChatGPT-Zitate erwartet.
Mythos 1: llms.txt hebt euch in ChatGPT wie eine Sitemap in Google
Mythos: Eine Community-/llms.txt reicht, damit das Modell eure Marke statt der Konkurrenz wählt.
Fakt: llms.txt ist ein Orientierungsdokument für Crawler und Agenten (Leistungsliste, Kontakt, Zitierregeln). Kein W3C-Standard, kein garantierter Parser in jedem OpenAI- oder Google-Produkt. Google Search Central spricht weiter über HTML, interne Links und Structured Data, nicht über llms.txt als Ranking-Signal.
Was wir tun: /llms.txt mit einem Entity-Absatz (Senior WordPress Engineering, Headless Astro/Next.js, WooCommerce, MCP, GEO/LLMO) und Services (English canonical URLs) zu Pillars, die Agenten ohne Menü-Raten finden. Update 2026-10-02 ergänzte Headless, MCP und GEO/LLMO.
Praxisbericht: SaaS-Kunde wollte „nur llms.txt“, ohne /pricing/ anzufassen. Datei zeigte auf Preise, Landing startete mit Firmenchronik 2014. Perplexity zitierte Konkurrenz-Docs mit Plantabelle. Nach BLUF und Tabelle im HTML verbesserten sich Paraphrase-Zitate, nicht durch llms.txt-Ranking in Google.
| Erwartung | Realität |
|---|---|
| llms.txt = Ranking-Boost | Kein Beleg für organisches Google |
| Eine Datei ersetzt Text | Der Bot lädt HTML der Ziel-URL |
| Einmal hochladen reicht | Datei muss nach jeder Leistungsänderung passen |
Mythos 2: Markdown für Bots statt HTML für Menschen
Mythos: /ai/ oder content.md in Markdown, die Menschenseite bleibt im Divi-Slider.
Fakt: In den meisten Retrieval-Pipelines kommt indexiertes HTML zuerst. Separates Markdown ohne kanonisches link rel="canonical" und ohne Parität zu MDX oder WordPress erzeugt zwei Wahrheitsquellen. Eine Woche später sind Preise in MD alt, HTML neu. Das Modell zitiert falsche Zahlen oder überspringt die Seite.
Besseres Muster auf Astro oder Headless-WordPress: ein Content-Strom, semantisches HTML, Frontmatter mit llmCard.facts und FAQ in YAML, gerendert in JSON-LD und sichtbarem FAQ. Markdown als Autorenformat im Repo (.mdx) ist in Ordnung. Markdown als eigene Bot-Publikation lohnt selten.
Auf wppoland.com-MDX-Pillars halten wir speakable, howTo wo passend, kein /raw.md-Duplikat. Für MCP-Agenten gibt es APIs (agent.json, MCP-Tools): Fähigkeitsindex, kein Blog-Klon.
Praxis DE: Viele Mittelstand-Shops diskutieren DSGVO und Trainingsdaten, bevor sie überhaupt lastVerified setzen. Rechtliche Sorge ist berechtigt, ersetzt aber nicht crawl-fähige Leistungsseiten mit klaren Entity-Sätzen. Barry Schwartz beschrieb 2026 auf Search Engine Roundtable, wie AI Overviews mehr AI-Mode-Antworten nach vorne schiebt. Der Traffic-Pfad bleibt HTML-URL im Google-Index, nicht eine Schatten-Markdown-Subdomain ohne interne Links.
Mythos 3: FAQPage-Schema ist ein KI-Zitat-Schalter
Mythos: Plugin injiziert FAQ-Schema, Google AI und ChatGPT zitieren jede Frage.
Fakt: FAQPage hilft bei Q&A-Struktur. Garantiert nicht: (a) URL-Indexierung, (b) Aufnahme in Overview-Quellen, (c) Modellwahl im Chat ohne Browsing. Google dokumentiert FAQ-Rich-Results für berechtigte Typen; 2026 sehen wir valides JSON-LD ohne sichtbare FAQ-Erweiterung.
Was neben Schema wirkt:
- Fragen in Suchsprache („Was kostet WooCommerce-Headless-Migration“), nicht Konzern-Deutsch.
- Antworten kurz mit Fakt (Datum, Scope). Gleicher Text in
<div class="faq-answer">wie in JSON-LD. - lastVerified und Quellen in
llmCard.sourcesbei YMYL-Guides.
Unser Generative-Eligibility-Audit (Oktober 2026) prüft FAQ oder llmCard plus Credibility. Fail auf EN-Headless bis explizites lastUpdated in Astro. Schema ohne Datum bestand den Validator, nicht unseren credibility_signals-Check.
Praxis DE: In Agentur-Calls aus NRW und Bayern sehen wir dasselbe Muster wie bei US-Shops: Yoast oder SEOPress erzeugt sauberes FAQ-JSON-LD, aber die sichtbare FAQ fehlt oder wiederholt nur den H1. Google Rich Results Test grün, Search Console ohne Klickgewinn, Perplexity zitiert weiter die WooCommerce-Dokumentation. Nach dem Nachziehen von <div class="faq-answer"> mit demselben Wortlaut wie im Frontmatter und einem lastVerified-Datum im sichtbaren Abschnitt verbesserte sich bei einem B2B-Portal in Frankfurt die Paraphrase in manuellen Prompt-Tests, nicht weil „Schema eingeschaltet“ wurde, sondern weil Extractor und Mensch dieselbe Antwort sahen. Für YMYL-Leistungen (Migration, Sicherheitsaudit) erwarten wir zusätzlich Wikidata-about-Links und mindestens zwei externe Quellen in llmCard.sources, nicht nur Plugin-Metadaten.
Mythos 4: Google-Rankings spielen keine Rolle mehr
Mythos: Weil KI auf der SERP antwortet, sind Positionen 1-3 egal.
Fakt: Retrieval hängt weiter an Index und Qualität, erweiterte AI Overviews fressen Klicks, nicht immer Zitate. In unserem AI-Overviews-Artikel dokumentieren wir Search-Console-Zeilen: Position 1,7 bei Preis-Query, null Klicks, Antwort über dem Link. Ranking ist nicht irrelevant. Spitzenplatz ohne zitierbaren Text bedeutet Sichtbarkeit ohne Besuch.
Für WordPress-Agenturen:
- Informational Long Tail liefert weiter Klicks.
- Kommerzielle Köpfe (Preise, „WooCommerce-Entwickler“) brauchen BLUF, Tabellen, Entity in Satz eins.
- Kein Rank heißt oft: Browsing-Modelle haben keine URL zum Ziehen.
GEO ohne SEO versucht, eine Seite zu zitieren, die Google für Geld-Queries nicht promoted.
Messung DACH: Nutzt für deutschsprachige Auswertungen die Search-Console-Property https://wppoland.com/de/, nicht einen /de/-Seitenfilter auf der Root-Domain. Wir haben dort Zeilen wie „wordpress entwickler stundensatz“ mit Position im oberen Feld und CTR nahe null, während AI Overviews den Preiskontext oben auf der SERP beantworten. Das ist kein Signal, SEO einzustellen, sondern BLUF und Tabellen auf der Preis- und Leistungs-Landing nachzuziehen. Informational-Queries („headless wordpress vorteile“) liefern weiter Klicks, wenn der Snippet-Text eine konkrete Zahl oder einen Scope nennt. Ohne Index-Eintrag für die Pillar-URL finden Browsing-Assistenten oft schlicht keine zitierbare Quelle, egal wie oft llms.txt eure Marke nennt.
Mythos 5: SEO pausieren und nur GEO machen
Mythos: „GEO-Spezialist“ einstellen, SEO seit 2018 einfrieren.
Fakt: GEO überlappt technisches SEO und Content. SEO abschalten heißt: Staging-noindex in Produktion, keine internen Links zu Pillars, keine canonicalUrl-Updates nach Astro-Migration. Dann hilft kein llmCard.
Gemeinsamer Nenner:
| SEO-Schicht | GEO-/LLMO-Entsprechung |
|---|---|
| Crawl, Sitemap, Canonical | Gleiche URLs in llms.txt und llmCard |
| Title / H1 zur Query | BLUF mit Entity in Absatz eins |
| E-E-A-T, Autor | lastVerified, Quellen, AuthorBox |
| Snippet / CTR | Tabellen und FAQ unter AI Overviews |
| Linkaufbau | Konsistente Entity in About, LinkedIn, G2 |
Nur GEO ohne CWV-Audit auf WooCommerce ist PR, nicht Engineering. Shop mit 40 Plugins und „optimized for ChatGPT“ in der Fußzeile: TTFB 1,8 s, kein lastVerified, FAQ 1:1 von Konkurrenz. Zitat blieb Shopify Help Center.
Was wir auf wppoland.com statt Mythen liefern
Checkliste Oktober 2026:
public/llms.txt- Entity plus kanonische EN-Service-URLs (Headless, MCP, GEO/LLMO in dieser Orchestrations-Runde).npm run audit:generative-eligibility-pillars- sechs Checks (BLUF, Titel, Query-Abdeckung, ein Seitenziel, Credibility, FAQ/llmCard) auf sechs Pillars;--checkfür CI.- GEO-Frontmatter (
llmCard,faq,speakable,lastVerified) auf Guides und MDX-Pillars, nicht auf tausende Stadtseiten kopiert. - About-Seiten (PL, EN, DE, NB, PT-PT) - Entity-Satz wie llms.txt (Senior Engineering, Headless, MCP, GEO/LLMO).
- LLMO- und AI-Overviews-Artikel - eigene Bildungslinie. Dieser Text entlarvt Mythen, kein Bot-Tutorial.
Keine Versprechen „#1 in ChatGPT in 30 Tagen“, keine Markdown-Nebenseiten, kein Massen-FAQ auf noindex-Stadtseiten.
AI-SEO-Plugins und Label-Wirrwarr im Plugin-Verzeichnis
2026 tauchen dutzende Plugins mit „AI“, „GEO“ oder „LLMO“ im Titel auf. Die meisten wrappen OpenAI-Aufrufe für Meta-Descriptions oder Bulk-FAQ. Keines ersetzt Crawl-Hygiene.
Vor Installation prüfen:
- Schreibt das Plugin sichtbares FAQ-HTML oder nur JSON-LD? Verstecktes Schema ohne Fließtext scheitert an Duplikat- und Credibility-Checks in unserem Audit und hilft Extractors nicht, die sichtbare DOM-Struktur lesen.
- Erzeugt es sechs Locale-Varianten als 1:1-Template? Das Muster triggert unsere AI-Slop-Rhetorik-Gates auf übersetzten Sites und liest sich für KI-Retrieval wie generisches Marketing in allen Sprachen gleichzeitig.
- INP am Checkout messen. Ein Stuttgarter WooCommerce-Händler verlor 0,4 s Mobile-Checkout durch ein zweites jQuery-Bundle eines „AI Schema“-Plugins. Ein Berliner B2B-Shop mit German Market und PayPal-Express sah nach Bulk-FAQ-Generierung zusätzlich doppelte FAQ-Blöcke im DOM, weil Plugin und Theme beide JSON-LD ausspielten.
Lieber ein Pillar-Rewrite als zehn Plugin-Schalter. Wenn ihr ohnehin WP-CLI und Staging habt, testet Plugin-Aktivierung auf einer Kopie mit Lighthouse-Checkout und Rich-Results-Test, bevor Marketing „GEO-ready“ verspricht.
Mehrsprachigkeit: eine Entity, sechs Stimmen
Sechs Locales auf wppoland.com. GEO-Fehler multiplizieren sich, wenn derselbe englische Entity-Satz in jedes llmCard.entity kopiert wird.
Regeln:
- Gleiche wpId, unterschiedliche Praxisbeispiele pro Markt (WordCamp Europe, regionale Steuer-/Versandkontexte auf erlaubten Preisseiten).
- llms.txt EN-first für Service-URLs, menschliche Seiten lokalisiert. Agenten und externe Crawler lösen oft zuerst englische Service-Slugs auf; die deutsche Landing braucht trotzdem BLUF auf Deutsch, regionale Beispiele (WordCamp Europe in Wien, IHK-Verweise bei B2B, Versand nach AT/CH) und konsistente Entity-Namen, nicht wörtlich übersetzte US-Sätze in
llmCard.entity. - hreflang und canonical bleiben SEO-Arbeit. GEO repariert keine PT-Seite mit canonical auf fehlende URL. Nach Astro-Migrationen prüfen wir in CI, ob
canonicalUrlauf gebaute Seiten zeigt; historische Portfolio-Drifts sind Datenmüll, bei Angebots-Pillars ist ein falscher Canonical ein harter Fail.
Make WordPress Slack und die Advanced WordPress Facebook-Gruppe liefern schneller echte Ausfallgeschichten als Vendor-Decks. Wir verlinken die Communities im Onboarding als Erinnerung, dass produktives WordPress selten glatt läuft. Auf deutschsprachigen WordCamps (z. B. WCEU-Hallway oder lokale Meetups in Köln und München) hören wir häufiger konkrete Plugin-Konflikte als in GEO-Sales-Decks.
90-Tage-Plan für Agentur oder WooCommerce-Shop
Tage 1-14: Entity und Pillars
- Ein Satz: wer, B2B/B2C-Zielgruppe, drei kanonische Leistungen.
- Konsistenz: Footer, About, llms.txt, LinkedIn. Gleicher Kern, lokalisierte Beispiele, keine sechs Copy-Paste-Übersetzungen.
- 3-6 Pillar-URLs wählen. Der Rest der Site verlinkt nur dorthin.
Tage 15-45: zitierbarer Text
- Erster Absatz jedes Pillars beantwortet die Query plus Firmenname.
- Eine Vergleichstabelle oder Scope-Spanne ohne Voice-Regeln zu brechen (Preisseite trägt Marktspannen; Pillars nutzen „ab“-Bänder in PLN/EUR je Markt).
- Fünf bis acht FAQ in Kundensprache, gespiegelt in JSON-LD.
Tage 46-70: technisch
- Canonicals, Indexierung, CWV am WooCommerce-Checkout.
lastVerifiedund zwei bis drei externe Quellen (Wikidata, WooCommerce-Docs, WordPress Developer Handbook) inllmCard.sources.- llms.txt nur mit Prozess, der bei jeder neuen Leistung mitzieht.
Tage 71-90: messen
- Search Console: Queries mit Position unter 5 und CTR unter 1 % (Overview-Signal, kein „GEO-Score“).
- Manuelles Prompt-Set (siehe
docs/plans/prompt-sampling-core-2026-q4.json): fünf Wiederholungen, protokollieren ob URL oder Marke erscheint. - Kern-Prompts mid-quarter nicht wechseln.
Liefert ihr nach 90 Tagen nur ein „AI readiness“-PDF ohne HTML-Änderung an Pillars, haben die Mythen gewonnen.
GEO-Audit von Slop unterscheiden
Gutes Deliverable nennt URLs und zeigt Diffs: erster Absatz vorher/nachher, FAQ im Frontmatter, llms.txt-Eintrag. Schlechtes endet mit „AI visibility score“ ohne Search Console, Crawl-Datum und Prüfung, ob der Pillar in der Sitemap liegt.
Fragen an Vendor oder internes Team:
- Welche drei URLs haben kommerzielle Priorität und was änderte sich im HTML?
- Zeigt
canonicalUrlnach Astro-Migration auf eine Seite, die im Build existiert? (Hunderte veraltete Portfolio-Canonicals tragen wir als historische Daten, nicht als Muster für Angebots-Pillars.) - Dupliziert FAQ den Body oder kürzt Frontmatter-Antworten gegenüber längeren MDX-Absätzen? Regel: niemals reicheren Body-Text löschen, nur weil Frontmatter kürzer ist.
- Wurde llms.txt im selben Commit wie MCP- oder Headless-Angebotsänderung aktualisiert?
Ein seriöses Audit liefert Diff-Screenshots oder PR-Links, kein generisches Heatmap-PDF. Vage Antworten bedeuten: Report gekauft, nicht GEO.
WooCommerce-Katalog und Grenzen von GEO
Ein WooCommerce-Shop mit 12 000 SKUs und Facetten-Navigation erzeugt Crawl-Rauschen, das kein llmCard auf einer Stadt-Landing repariert. GEO gehört auf Kategoriegeschichten, Versand- und Rückgabe-Seiten und drei Service-Pillars, nicht auf jede Varianten-URL.
Filter, den wir mit Händlern nutzen:
- URL ist noindex oder nur Long-Tail-SKU-Kombination: kein GEO-Frontmatter, Canonicals fixen.
- URL trägt Geld-Queries in GSC: BLUF, FAQ, vierteljährliches
lastVerified. - Produkt-JSON-LD bleibt für Shopping-Logik. FAQ-Schema auf Produktseiten lohnt selten, es sei denn, Support-Tickets wiederholen dieselben Fragen.
Ein Outdoor-Händler in Österreich bulkte FAQ-Schema auf 400 Produkt-Templates. Antworten lagen in Zendesk, nicht in WordPress. Zitate bewegten sich erst, als fünf Policy-URLs in Klartext mit Datum und Wikidata-about-Links live gingen.
Marken-Prompts und falsche Benchmarks
Vendor-Decks lieben einen einzelnen „GEO visibility score“. Wir tracken enger:
- Fünf Marken-Prompts aus
docs/plans/prompt-sampling-core-2026-q4.json, monatlich fünfmal, mit Datum und Modellversion im Sheet. - Search Console-Query-Zeilen: Position besser als 5, CTR unter 1 %. Das Paar flaggt oft Overview-Absorption.
- Manuelle Perplexity-Checks mit Browsing an versus aus, weil Retrieval-Pfade differieren.
Drittanbieter-„AI-Rank-Tracker“ sind Richtung, keine Wahrheit. Sie rotieren Modelle, Geos und Login-Status. Nutzt sie höchstens für Spikes, immer zusammen mit eigener URL-Liste und Crawl-Daten aus GSC URL Inspection auf https://wppoland.com/de/, nicht gemischte Locale-Filter auf der Root-Property. Zeigt ein Prompt-Set Marke aber nie URL, ist fast immer Pillar-Copy schuld, nicht eine weitere llms.txt-Zeile.
Zusammenfassung
GEO für WordPress ist Entity-Disziplin und Zitierbarkeit auf Pillars, die ohnehin ranken und indexiert bleiben müssen. llms.txt hilft Agenten, die richtigen URLs zu finden. Es ersetzt keinen Fließtext auf Landings. Bot-only-Markdown ohne HTML ist technische Schuld. FAQ-Schema ohne BLUF und Verifikationsdaten ist Validator-Theater, keine Strategie. Rankings entscheiden weiter, ob ihr in den Quellenpool kommt. AI Overviews ändern Klicks, nicht die Notwendigkeit, im Index präsent zu sein. SEO und GEO laufen gemeinsam, sonst bezahlt ihr für ein Buzzword.
Weiterlesen auf wppoland.com: LLMO strategische Zusammenfassung, Google erweitert AI Overviews, Pillar GEO- und LLMO-Optimierung. Audit-Orchestrierung steht in docs/plans/2026-10-02-geo-orchestration.md im Repository.