Drei Einstellungen werden verwechselt, wenn ein Websitebetreiber sagt: “Ich will aus der KI raus.” Eine liegt in der Search Console, eine in der robots.txt unter dem Token Google-Extended, eine in der robots.txt als Content-Signal-Zeile. Sie beantworten unterschiedliche Fragen, und keine ist ein allgemeiner KI-Aus-Schalter.
Googles Seiten ziehen die Grenzen deutlich genug. Das Problem: Die Grenzen verteilen sich auf vier Seiten. Dieser Beitrag stellt sie nebeneinander, zitiert jede Seite an der entscheidenden Stelle und endet mit einer Tabelle zur Auswahl. Alle Zitate wurden am 6. Oktober 2026 gelesen.
wppoland.com ist ein brauchbarer Testfall, gerade weil es unbequem ist: sechs Sprachordner, jeder als eigene URL-Präfix-Property unter einer Domain-Property verifiziert, und eine robots.txt, die schon eine Content-Signal-Zeile enthält. Eine Wirkung dieser Schalter auf den Traffic haben wir nicht gemessen, und nichts im Folgenden behauptet sie.
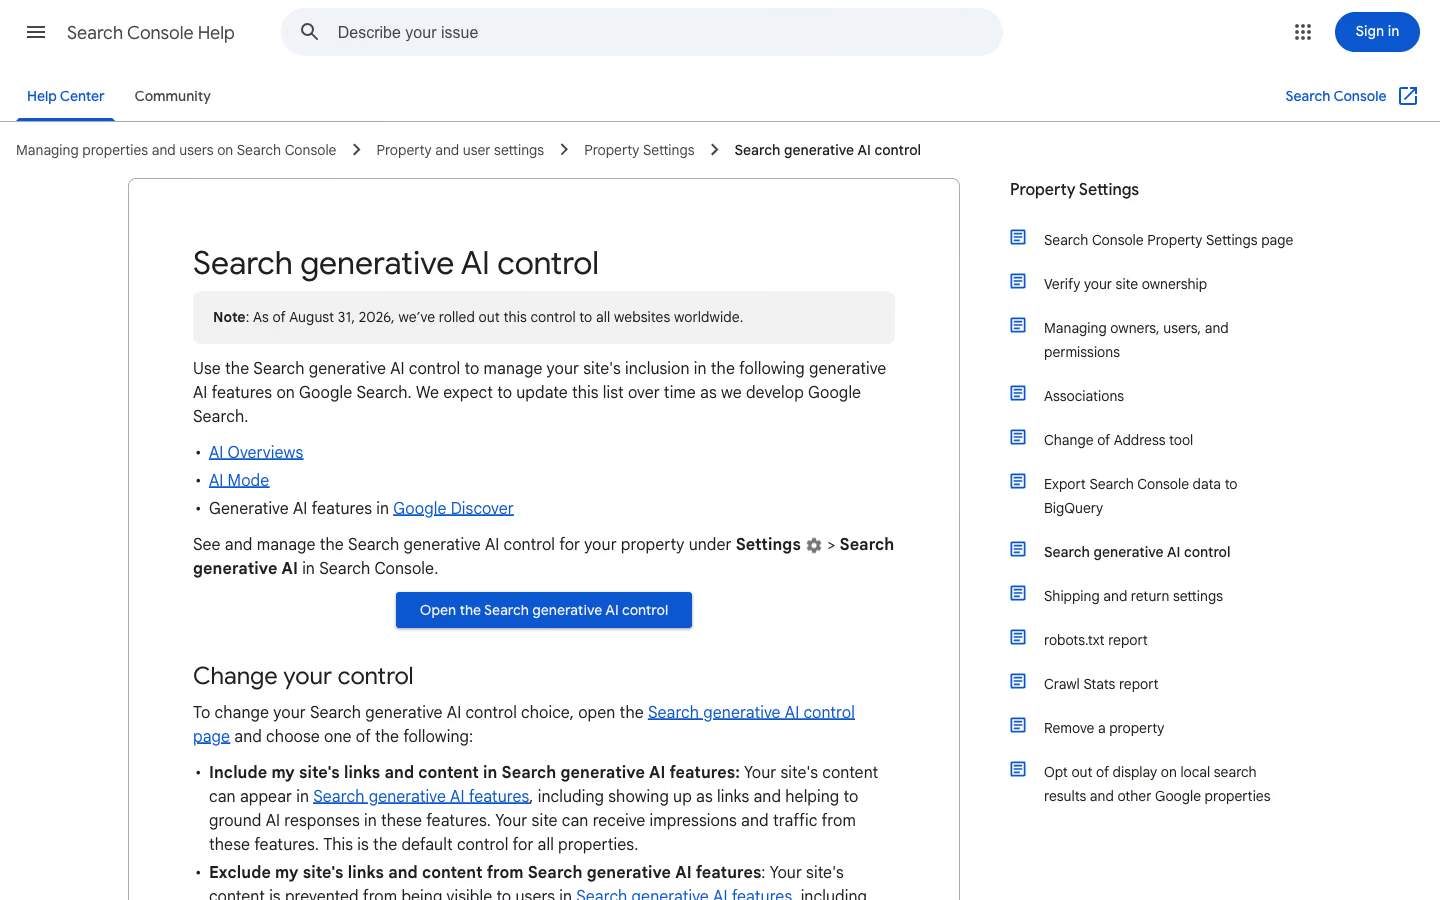
In der deutschsprachigen Search Console heißt die Einstellung “Freigabe von Inhalten für generative KI in der Google Suche managen” und liegt unter Einstellungen > Generative KI in der Google Suche. Die Funktionen heißen “Übersichten mit KI”, “KI-Modus” und “generative KI-Funktionen in Google Discover”. Wer englischsprachige Quellen liest, sucht also unter anderen Namen: AI Overviews, AI Mode, Search generative AI control. Die Zitate aus Googles Hilfeseiten unten stammen aus den deutschen Fassungen.
Welche Google-Einstellung entfernt meine Website aus den Übersichten mit KI und dem KI-Modus
Die Einstellung zur Freigabe von Inhalten für generative KI in der Google Suche in der Search Console. Googles Hilfeseite listet auf, was sie steuert: Übersichten mit KI, KI-Modus und generative KI-Funktionen in Google Discover. Google kündigt an, diese Liste im Zuge der Weiterentwicklung der Suche zu aktualisieren. Zur Verfügbarkeit:
“Seit dem 31. August 2026 ist diese Einstellung für alle Websites weltweit verfügbar.”
Search Console-Hilfe, Freigabe von Inhalten für generative KI in der Google Suche managen
Zur Wahl stehen Berücksichtigen, Ausschließen und Übernehmen von der übergeordneten Property. Berücksichtigen ist die Standardeinstellung für alle Properties, Übernehmen die Standardeinstellung für eine Property mit übergeordneter Property. Was Ausschließen bewirkt:
“Wenn du deine Website ausschließt, werden Links zu deiner Website sowie die Inhalte deiner Website nicht in generativen KI-Funktionen der Google Suche angezeigt. Inhalte von anderen Websites sind in diesen Funktionen weiterhin verfügbar und können deinen Inhalten ähneln. Von deiner Website gecrawlte Inhalte können nicht als Eingabe zum Generieren von KI-Antworten oder -Vorschauen in den generativen KI-Funktionen der Google Suche verwendet werden.”
Search Console-Hilfe, Freigabe von Inhalten für generative KI in der Google Suche managen
Zwei Details zählen. Die Links entfallen ebenfalls, nicht nur der Text; man kann also nicht erwähnt werden, ohne angeklickt zu werden. Und die Fundierung ist mit erfasst: Ausgeschlossene Inhalte fließen nicht in die Antworten dieser Funktionen ein.
Google sagt auch ausdrücklich, was die Einstellung nicht ist:
“Diese Einstellung wirkt sich nur darauf aus, ob deine Inhalte in bestimmten generativen KI-Funktionen der Google Suche angezeigt werden können. Sie wird nicht als Ranking- oder Aufnahmesignal verwendet, das sich auf andere Bereiche der Google Suche auswirkt.”
Search Console-Hilfe, Freigabe von Inhalten für generative KI in der Google Suche managen
“Diese Einstellung hat keinen Einfluss auf das KI-Training. Wenn du das Training der Modelle, die zum Generieren von Antworten in den generativen KI-Funktionen der Google Suche verwendet werden, einschränken möchtest, verwende Google-Extended. Wenn du vollständig verhindern möchtest, dass deine Inhalte in der Google Suche erscheinen, verwende noindex.”
Search Console-Hilfe, Freigabe von Inhalten für generative KI in der Google Suche managen
Zur Dauer: Eine Änderung braucht laut Seite in der Regel einige Tage. Inhalte werden innerhalb von ein bis zwei Tagen nach der Aktivierung ausgeschlossen, bei einigen dauert es wegen Caching und Weitergabe in Google-Systemen länger.
Seit dem 21. Oktober 2026 führt auch die Google-Seite dazu, was Sie mit der Google Suche teilen, diese Einstellung auf, als websiteweite Option, mit der Sie die Aufnahme Ihrer Website in Übersichten mit KI und den KI-Modus steuern. Das Änderungsprotokoll der Search-Central-Dokumentation datiert diese Bearbeitung auf den 21. Oktober und beschreibt sie als Ergänzung bereits bestehender Optionen, die Einstellung selbst ist also unverändert.
Entfernt Google-Extended meine Website aus den Übersichten mit KI
Nein. Google-Extended ist auf der Übersichtsseite zu Googles Crawlern dokumentiert, und die genannten Produktbereiche sind Gemini und Vertex AI, nicht die Suche:
“Google-Extended ist ein eigenständiges Produkt-Token, mit dem Webpublisher steuern können, ob Inhalte, die Google von ihren Websites crawlt, zum Trainieren zukünftiger Gemini-Modelle verwendet werden dürfen, die für Gemini-Apps und die Vertex AI API für Gemini genutzt werden, und für die Fundierung (zum Bereitstellen von Inhalten aus dem Index der Google Suche für das Modell zum Zeitpunkt des Prompts, um Faktizität und Relevanz zu verbessern) in Gemini-Apps und Fundierung mit der Google Suche in Vertex AI.”
“Google-Extended hat keinen Einfluss auf die Aufnahme einer Website in die Google Suche und wird auch nicht als Ranking-Signal in der Google Suche verwendet.”
Zusammen mit dem vorigen Abschnitt gelesen teilen die beiden Seiten die Arbeit auf. Die Einstellung in der Search Console steuert Fundierung und Anzeige innerhalb der Suchfunktionen. Google-Extended steuert das Training und die Fundierung in Gemini-Apps und Vertex AI. Keine Seite behauptet, den Bereich der anderen abzudecken, und die Hilfeseite der Search Console verweist für das Training auf Google-Extended.
Eine praktische Folge ergibt sich aus der Funktionsweise des Tokens:
“Google-Extended hat keinen separaten User-Agent-String für HTTP-Anfragen. Das Crawling erfolgt mit vorhandenen User-Agent-Strings von Google. Das robots.txt-User-Agent-Token wird zur Kontrolle verwendet.”
Unsere Lesart: In den Zugriffsprotokollen gibt es keine Google-Extended-Zeile, nach der sich suchen ließe. Die robots.txt-Gruppe ist der einzige Ort, an dem die Entscheidung existiert.
Was bewirkt Content-Signal in der robots.txt bei Google
Content-Signal ist etwas anderes. Es ist eine von Cloudflare veröffentlichte robots.txt-Direktive mit drei Signalen. Die Website definiert ai-input so:
“Einspeisen von Inhalten in ein oder mehrere KI-Modelle (z. B. Retrieval-Augmented Generation, Grounding oder andere Echtzeitübernahme von Inhalten für generative KI-Suchantworten).”
contentsignals.org (unsere Übersetzung des englischen Originals)
Und ai-train in einer Zeile:
“Training oder Feinabstimmung von KI-Modellen.”
contentsignals.org (unsere Übersetzung des englischen Originals)
Das dritte Signal, search, betrifft den Aufbau eines Suchindex und das Ausliefern von Links und kurzen Auszügen; die Website vermerkt, es umfasse nicht “das Bereitstellen KI-generierter Suchzusammenfassungen” (unsere Übersetzung). Über die Grenzen ist die Website selbst deutlich:
“Die Content-Signal-Direktive funktioniert, indem sie Ihre Präferenz signalisiert, bestimmte Kategorien von KI-Aktionen entweder zu erlauben (yes) oder zu untersagen (no). Nicht alle automatisierten Systeme befolgen robots.txt-Dateien, und manche ignorieren diese Content-Signal-Direktiven möglicherweise.”
contentsignals.org (unsere Übersetzung des englischen Originals)
“robots.txt-Dateien drücken Ihre Präferenzen aus. Sie hindern Crawler-Betreiber jedoch nicht daran, Ihre Inhalte auf technischer Ebene zu übernehmen.”
contentsignals.org (unsere Übersetzung des englischen Originals)
Weder die Hilfeseite der Search Console noch Googles hier zitierte Crawler-Dokumentation erwähnt Content-Signal. Wir haben den Text beider Seiten durchsucht und keine Fundstelle gefunden. Das ist eine Aussage über diese beiden Seiten, nicht darüber, was irgendein Google-System tut. Für die Planung heißt das: Eine Content-Signal-Zeile ist eine Erklärung an alle Crawler und kein Google-Schalter. Wie sich die Zeile innerhalb von robots.txt-Gruppen verhält, behandelt unser Beitrag zum Content-Signal-Scope-Fehler.
Wenn Ihre Website hinter Cloudflare liegt, gibt es einen vierten Schalter, der am Netzwerkrand statt in der robots.txt wirkt. Seit dem 15. September 2026 hält seine Option Block auch den Googlebot auf, wie ich im Beitrag blockiert Cloudflare den Googlebot beschreibe.
Blockieren noindex und nosnippet die Übersichten mit KI
Beide wirken, beide sind grob, und sie sind nicht auf dieselbe Weise grob.
noindex nimmt die Seite aus der Google Suche, und genau das nennt die Hilfeseite der Search Console als Weg dafür. Der Preis liegt auf der Hand: Die Seite verliert auch ihre organischen Ergebnisse.
nosnippet ist enger gefasst, und Googles Dokumentation zum robots meta-Tag sagt, dass die Regel die KI-Funktionen erreicht:
“Kein Text-Snippet und keine Videovorschau in den Suchergebnissen für diese Seite anzeigen. Eine statische Miniaturansicht (falls verfügbar) ist weiterhin sichtbar, wenn dies dem Nutzer einen Mehrwert bietet. Dies gilt für alle Arten von Suchergebnissen (bei Google: Websuche, Google Bilder, Discover, die Übersicht mit KI und KI-Modus). Außerdem wird verhindert, dass die Inhalte als direkte Eingabe für die Übersicht mit KI und den KI-Modus verwendet werden.”
Der Haken steckt im ersten Satz. nosnippet entfernt das Snippet auch aus gewöhnlichen Blue-Link-Ergebnissen und wird pro Seite gesetzt, kann also Klicks kosten, die die Einstellung in der Search Console nicht kosten würde. Dieser zweite Teil ist unsere Schlussfolgerung aus den beiden Seiten, keine Messung.
Es gibt noch eine Falle, die Websites trifft, die Werkzeuge kombinieren. Google schreibt:
“Diese Einstellungen können nur gelesen und befolgt werden, wenn Crawlern Zugriff auf die Seiten gegeben wird, die diese Einstellungen enthalten.”
Ein Disallow in der robots.txt auf einer Seite mit noindex oder nosnippet hebt das Tag auf. Unsere eigene robots.txt enthält genau dazu einen Kommentar für Taxonomie-Archive, weshalb wir sie nicht sperren.
Welche Google-KI-Einstellung für welches Ziel
| Ziel | Schalter | Was er blockiert | Was er nicht blockiert |
|---|---|---|---|
| Raus aus Übersichten mit KI, KI-Modus und generativen Discover-Funktionen, weiter in der Suche | Freigabe von Inhalten für generative KI auf Ausschließen gestellt | Links und Inhalte in diesen Funktionen, Fundierungs-Eingabe für sie, Traffic und Impressionen daraus | KI-Training, den Rest der Suche, Ranking, Teilnahme an Merchant Center und Google Ads |
| Raus aus Gemini-Training und Gemini-Fundierung, weiter in Suche und Übersichten mit KI | Google-Extended mit einem Disallow in der robots.txt | Nutzung gecrawlter Inhalte für das Training künftiger Gemini-Modelle und die Fundierung in Gemini-Apps und Vertex AI | Aufnahme in die Google Suche, Ranking, und was die Einstellung in der Search Console steuert |
| Allen Crawlern die eigene Richtlinie an einer Stelle mitteilen | Content-Signal-Zeile in jeder robots.txt-Gruppe | Technisch nichts | Nichts. Es ist eine Erklärung, und Googles Seiten erwähnen sie nicht |
| Kein KI-Text von bestimmten Seiten, Seite bleibt gelistet | nosnippet | Text-Snippet und Videovorschau überall, auch Übersichten mit KI und KI-Modus als direkte Eingabe | Den Listeneintrag selbst, möglicherweise eine statische Miniaturansicht; kürzt auch gewöhnliche Snippets |
| Ganz raus aus der Google Suche | noindex | Die Seite in den Google-Suchergebnissen | Entfällt, die Seite verschwindet aus den Ergebnissen; der Crawler muss die Seite weiterhin abrufen dürfen, um das Tag zu sehen |
Die beiden Ziele vom Anfang des Beitrags lassen sich so zuordnen. Raus aus den Übersichten mit KI, aber nicht aus der Suche: die Einstellung in der Search Console oder nosnippet auf einzelnen Seiten. Raus aus dem Training, aber nicht aus KI-Antworten: Google-Extended für Google, eine Content-Signal-Zeile für alle anderen, und die Einstellung in der Search Console auf Berücksichtigen belassen.
Was passiert, wenn ein Sprachordner die Domain-Property überschreibt
Bei Websites mit mehreren Properties sorgt die Vererbung für Überraschungen. Googles Regel, sinngemäß: Eine Property übernimmt die Einstellung von der nächstgelegenen übergeordneten Property, die ihre eigene gesetzt hat; ist keine gesetzt, gilt die Einstellung der Top-Level-Domain-Property. Im Wortlaut:
“Wenn bei einer Property keine der übergeordneten Properties manuell so konfiguriert wurde, dass die Übernahme beendet wird, wird für diese Property die Einstellung der Top-Level-Domain-Property übernommen.”
Search Console-Hilfe, Freigabe von Inhalten für generative KI in der Google Suche managen
Für wppoland.com heißt das: Die Domain-Property steht oben, und /pl/, /en/, /de/, /nb/, /pt-pt/ und /es/ sind jeweils untergeordnete Properties. Wird die Domain-Property einmal gesetzt, folgen alle sechs. Weil jeder Ordner eine eigene Property ist, kann auch eine Sprachversion ausgeschlossen bleiben, während die anderen fünf berücksichtigt werden. Google sagt das für untergeordnete Properties ausdrücklich:
“Du kannst diese Einstellung jederzeit überschreiben und für deine Property manuell konfigurieren.”
Search Console-Hilfe, Freigabe von Inhalten für generative KI in der Google Suche managen
Neu ist die Benachrichtigung. Barry Schwartz berichtete am 6. Oktober 2026, Google habe der Hilfeseite einen Satz hinzugefügt, und der lautet:
“Inhaber der Top-Level-Domain-Property sehen auf der Seite der Einstellung für generative KI in der Google Suche eine Benachrichtigung, wenn eine ihrer untergeordneten Properties die übergeordnete Einstellung überschreibt.”
Google Search Console Help, berichtet im Search Engine Roundtable (unsere Übersetzung des englischen Originals)
Das ist hier nützlich, denn so erfährt, wer die Domain-Property besitzt, dass jemand die Einstellung für einen Ordner geändert hat, ohne sechs Seiten zu öffnen. Wir haben die Benachrichtigung noch nicht ausgelöst gesehen. Schwartz schreibt, dass auch er keinen Screenshot dazu hat; sie gilt also als dokumentiert, nicht als beobachtet.
Beispiel einer robots.txt mit Content-Signal und Google-Extended
Die Stern-Gruppe und die Google-Extended-Gruppe in public/robots.txt lauten wörtlich:
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /
Disallow: /cdn-cgi/
# Google-Extended - Gemini grounding + training corpus
User-agent: Google-Extended
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /Zwei Lesarten. Erstens entspricht die Kombination dem, was wir wollen: in der Suche, in KI-Antworten, nicht im Training. Es heißt aber auch, dass die Einstellung in der Search Console und die Datei zusammen bewegt werden müssen. Eine robots.txt mit ai-input=yes und ein Search-Console-Wert Ausschließen würden sich widersprechen.
Zweitens ist die Google-Extended-Gruppe die schwächere Hälfte. Google dokumentiert dieses Token über allow- und disallow-Zeilen, und das eigene Beispiel nutzt beide. Unsere Gruppe sagt Allow: /. Wörtlich gegen Googles Seite gelesen, ist das Token auf unserer Website für Gemini-Training und -Fundierung offen, und das danebenstehende ai-train=no ist eine Aussage, die keine der beiden hier zitierten Google-Seiten erwähnt. Für Google im Besonderen ist unsere Trainingspräferenz also erklärt, aber nicht durch einen Mechanismus getragen, den Google dokumentiert.
Das zu schließen, ist eine eigene Entscheidung. Ein Disallow: / in dieser Gruppe würde auch die Fundierung in Gemini-Apps aufgeben, weil das Token beides abdeckt. Der Kommentar am Dateianfang bezeichnet zudem jede über Content-Signale ausgedrückte Einschränkung als ausdrücklichen Rechtevorbehalt nach Artikel 4 der EU-Urheberrechtsrichtlinie 2019/790. Ob das trägt, ist eine Frage für eine Juristin oder einen Juristen, nicht für die Person, die die robots.txt bearbeitet.
Wie lässt sich die Wirkung messen, bevor eine Einstellung geändert wird
Ein Ergebnis haben wir nicht, und die Reihenfolge zählt. Google verweist dafür auf einen Bericht:
“Wenn du messen möchtest, wie deine Inhalte in generativen KI-Funktionen der Google Suche abschneiden, verwende den Leistungsbericht zu generativen KI-Funktionen. So kannst du besser einschätzen, wie sich eine Änderung der Einstellung auf den Traffic auf deiner Website auswirken könnte.”
Search Console-Hilfe, Freigabe von Inhalten für generative KI in der Google Suche managen
Der Plan ist kurz. Zuerst den Bericht für die Domain-Property festhalten. Eine Property ändern und sonst nichts. Die von Google genannten Tage abwarten. Mit der Ausgangslage vergleichen. Würden Einstellung in der Search Console, Google-Extended und ein nosnippet-Rollout in derselben Woche geändert, bliebe eine Zahl, die niemand zuordnen kann. Dieselbe Disziplin gilt für das Zero-Click-Muster, das unser Beitrag zu den erweiterten Übersichten mit KI behandelt; warum wir überhaupt in Antworten zitiert werden wollen, steht in der LLMO-Kurzstrategie.
Aktualisierung, . Die ersten öffentlichen Daten zu einem Opt-out, die ich kenne, sprechen gegen die übliche Befürchtung. Cyrus Shepard hat auf LinkedIn eine Fallstudie beschrieben, die er selbst als klein bezeichnet: eine einzige Website, aus Googles KI-Funktionen herausgenommen. Den Mechanismus nennt der Beitrag nicht; gegenüber Barry Schwartz beschrieb er ihn als die Opt-out-Einstellung für generative KI in der Suche (Search Engine Roundtable). Die KI-Impressionen fielen auf null. Für diese KI-Impressionen schätzt er eine Klickrate von etwa 0,9 %, berechnet aus der Gesamt-CTR und den Impressionen der Website abzüglich der bekannten KI-Impressionen im Testzeitraum. Schwartz sagte er außerdem, sie hätten etwa 8 % aller Impressionen ausgemacht. Die Überraschung: Während die KI-Funktionen aus waren, gingen auch die normalen organischen Klicks zurück. Shepard deutet das als Halo-Effekt, weil eine Website, die an mehr Stellen der Ergebnisseite auftaucht, eher angeklickt wird. Er schreibt dazu, dass Ergebnisse nicht garantiert sind und jeder seine eigenen Daten testen soll. Die Einschränkungen stammen von ihm und gehören zu den Zahlen: eine Website, keine Daten und keine Testdauer im Beitrag, und die Übersichten mit KI erschienen bei diesen Suchanfragen die ganze Zeit weiter, nur ohne seine Website.
Für eine WordPress-Website heißt das: Eine Website beweist keinen Halo-Effekt, aber sie widerlegt die Annahme, ein Ausschluss aus KI-Funktionen könne Klicks nur schützen. Bei einer mehrsprachigen Website liefert die oben beschriebene Vererbung einen groben Test: eine Sprach-Property ausschließen, die übrigen eingeschlossen lassen und jede mit ihrer eigenen Ausgangslage vergleichen. Grob, weil jede Sprache einen anderen Markt bedient: Suchanfragen aus Deutschland, Österreich und der Schweiz verhalten sich nicht wie polnische. Eine einsprachige Website hat diese Aufteilung nicht, dort gilt die Entscheidung sofort für alles.
Hat Bing eigene Einstellungen für KI-Training und KI-Antworten
Aktualisierung, . Ja, seit heute. Krishna Madhavan von Microsoft Bing hat Präferenzen angekündigt, die KI-Training von KI-Grounding trennen, also von der Nutzung einer Seite zum Erzeugen einer Antwort (Bing-Blog, Your content, your choice). Laut Microsoft ändert keine der beiden Präferenzen etwas an der Berechtigung für die normalen Bing-Suchergebnisse.
KI-Training stellen Sie in der robots.txt ein, für die ganze Website oder einen Pfad, über ein eigenes User-Agent-Token. Standard ist Erlauben; wer drinbleiben will, muss nichts tun. Für den Ausschluss:
User-Agent: __usage_ai-training
Disallow: /
Auf Seitenebene hat ein Meta-Tag oder ein HTTP-Header Vorrang vor der robots.txt:
<meta name="Bingbot" content="ai-training:disallow">
X-Robots-Tag: Bingbot: ai-training:disallow
Grounding gibt es nur auf Seitenebene, ohne robots.txt-Variante. Es gibt drei Werte: Erlauben (Standard), ai-grounding:disallow, womit die Seite nicht für generierte Antworten genutzt wird, und ai-grounding:disallowextended, das Grounding auf Angebote beschränkt, die Microsoft selbst betreibt, darunter Copilot und Microsoft 365, und Grounding-Dienste ausschließt, die Microsoft Dritten bereitstellt, etwa Web IQ und das Grounding der Foundry API. Beide Werte stehen im selben Bingbot-Meta-Tag oder X-Robots-Tag-Header.
Wichtiger als die Syntax sind die Fristen. Die neuen Präferenzen ersetzen die bisherigen Direktiven NoArchive und NoCache. Ab 15. Dezember 2026 bieten die Bing Webmaster Tools vorübergehende Grounding-Einstellungen für Websites an, die an diesem Tag NoArchive oder NoCache verwenden. Ab 1. Februar 2027 berücksichtigt Bing die neuen Präferenzen beim Crawlen. Am 1. März 2027 endet die Frist, Grounding-Präferenzen auf den Seiten zu veröffentlichen oder die vorübergehenden zu hinterlegen; Seiten ohne beides gelten bis zum erneuten Crawlen als für Grounding freigegeben, und NoArchive und NoCache zählen für Training und Grounding nicht mehr. Die vorübergehenden Einstellungen laufen am 30. September 2027 aus, oder früher, wenn Bing beim erneuten Crawlen das neue Tag findet.
| Ziel | Bing | |
|---|---|---|
| Raus aus dem KI-Training, ganze Website | Google-Extended mit Disallow in der robots.txt, was auch das Grounding in Gemini Apps und Vertex AI beendet | __usage_ai-training mit Disallow in der robots.txt, nur Training |
| Raus aus KI-Antworten in der Suche | Einstellung für generative KI je Search-Console-Property oder nosnippet je Seite | ai-grounding:disallow je Seite, Meta-Tag oder Header |
| Nur raus aus Grounding für Dritte | Keine Entsprechung | ai-grounding:disallowextended je Seite |
| Normaler Sucheintrag | Von der Einstellung für generative KI und Google-Extended unberührt | Von beiden Präferenzen unberührt |
Der brauchbare Unterschied: Google koppelt Training und Gemini-Grounding in einem Token, Bing trennt beides. Die Kombination, die unsere robots.txt erklärt (in Antworten, nicht im Training), lässt sich für Bing mit einer Gruppe ausdrücken; bei Google kostet sie zusätzlich das Gemini-Grounding. Dafür wirkt Bings Grounding-Schalter je Seite, Googles wichtigster Schalter je Property.
Was Sie auf einer WordPress-Website jetzt entscheiden sollten:
- Prüfen Sie, ob Ihre Seiten
noarchiveodernocachesenden. Manche SEO-Plugins, etwa Rank Math, bieten noarchive als erweiterte Robots-Meta-Option an. Wenn Sie damit Bings KI-Nutzung begrenzt haben, wirkt das ab 1. März 2027 nicht mehr, sofern Sie es nicht ersetzen. - Training: die Gruppe
__usage_ai-trainingin die robots.txt aufnehmen. WordPress liefert eine virtuelle robots.txt aus; bearbeiten Sie sie im robots.txt-Editor Ihres SEO-Plugins (Yoast und Rank Math haben einen) oder über den Filterrobots_txt. Eine physische robots.txt im Web-Root ersetzt die virtuelle vollständig. - Grounding: Bing liest
<meta name="Bingbot">, nichtname="robots", daher gibt der Core-Filterwp_robotses nicht aus. Geben Sie es über einenwp_head-Hook in einem kleinen Plugin aus oder senden Sie den Header vom Server. Wer in Copilot zitiert werden will, tut nichts: Erlauben ist Standard. - Nach Shepards Zahlen entscheiden Sie über eine Grounding-Sperre je Bereich der Website, etwa nur für kostenpflichtige Inhalte.
In der robots.txt von wppoland.com habe ich die Bing-Gruppe für Training bereits ergänzt, passend zum Signal ai-train=no. Diese Präferenzen je Template auf einer WordPress-Website zu setzen, gehört zu meiner GEO- und LLMO-Optimierung.
Checkliste
- Zuerst das Ziel festlegen: raus aus Suchfunktionen, raus aus dem Training oder beides.
- Den Schalter aus der Tabelle wählen. Ein Ziel, ein Schalter.
- Die Einstellung für generative KI an der Domain-Property setzen, dann jede Sprach-Property auf Überschreibungen prüfen.
- robots.txt und Search Console konsistent halten:
ai-input=yesund eine ausgeschlossene Property widersprechen sich. - Ein robots.txt-
Disallownicht mitnoindexodernosnippetauf derselben Seite kombinieren. - Google-Extended nur einsetzen, wenn akzeptiert ist, dass es auch die Gemini-Fundierung abdeckt.
- Den Leistungsbericht zu generativen KI-Funktionen vor der Änderung als Ausgangslage sichern und immer nur eines auf einmal ändern.
- Wenn die Website Bing über
noarchiveodernocacheeinschränkt, diese vor dem 1. März 2027 durch die neuen Bing-Präferenzen ersetzen.