Die Google Search Console ist das stärkste kostenlose Werkzeug, das Google Website-Betreibern gibt, und trotzdem behandeln die meisten sie wie ein reines Lese-Dashboard. Ein Blick auf die Impressionen, vielleicht ein paar Suchanfragen, Tab zu. 2026 bleibt mit dieser Haltung viel organischer Traffic liegen.
Im Jahr 2012 füllten Sie ein Formular add-url.html aus, um eine Seite zu Google hinzuzufügen. Heute liegt die eigentliche Stärke der GSC tiefer: URL-Prüfung, der Bericht zur Seitenindexierung und die APIs, mit denen Sie Sitemaps einreichen, URLs prüfen und Leistungsdaten per Code abrufen. Bei wppoland.com meldet die gesamte Veröffentlichungs-Pipeline nach jedem Deployment an die Search Console und an IndexNow. Dieser Leitfaden geht jede Schicht dieses Stacks durch, von der Einrichtung bis zur CI/CD-Automatisierung, und zeigt, wo Googles Dokumentation die Grenze dafür zieht, wofür die Indexing API gedacht ist.
Was die Google Search Console und ihre API leisten
Die meisten Betreiber öffnen die Search Console einmal pro Woche, überfliegen das Leistungsdiagramm und schließen sie wieder. Das ist, als kaufe man ein Schweizer Taschenmesser und benutze nur den Flaschenöffner.
Die GSC liefert direkte Signale von Google darüber, wie Ihre Website wahrgenommen wird. Das URL-Prüftool zeigt, was der Googlebot beim Rendern Ihrer Seite sieht, auch ob JavaScript wichtige Inhalte blockiert. Der Bericht zur Seitenindexierung (früher Abdeckung) zeigt, wie viele Ihrer Seiten Google indexiert hat, und vor allem den Grund für jede URL, die nicht indexiert ist. Der Bereich Core Web Vitals zeigt Leistungsdaten echter Nutzer.
Die Search Console API geht weiter: Sie ruft Leistungsdaten per Code ab, speist eigene Dashboards und automatisiert das Monitoring. Zusammen mit dem Einreichen von Sitemaps über die API und, für Stellenanzeigen und Livestreams, der Indexing API hoffen Sie nicht mehr, dass Google Ihre Inhalte findet, sondern melden, was sich geändert hat. Für Agenturen mit Dutzenden WordPress-Properties ist genau dieses Monitoring das, was ein kaputtes Template oder ein verirrtes noindex erkennt, bevor es Wochen an Traffic kostet.
Google Search Console für WordPress einrichten
Bevor Sie zu fortgeschrittenen Werkzeugen greifen, richten Sie die Property so ein, wie Google es erwartet. Google bietet zwei Property-Typen: Domain und URL-Präfix.
Domain-Properties decken alle Subdomains und Protokolle (http, https, www, ohne www) unter einem Dach ab. Für die meisten Websites ist das der empfohlene Weg. Er verlangt eine DNS-Bestätigung, also einen TXT-Eintrag in der DNS-Konfiguration Ihrer Domain. Bei WordPress-Seiten auf Managed Hosting dauert das über das Hosting-Panel meist weniger als fünf Minuten.
URL-Präfix-Properties sind nützlich, wenn Sie ein bestimmtes Unterverzeichnis (etwa example.com/blog/) beobachten wollen oder keinen DNS-Zugang haben. Bestätigt wird per HTML-Datei, Meta-Tag, Google Analytics oder Google Tag Manager.
Nach der Bestätigung folgen diese Schritte:
- Mit GA4 verknüpfen: Verknüpfen Sie in den Einstellungen Ihre Google-Analytics-4-Property. So sehen Sie GSC-Daten direkt in GA4-Berichten und bekommen eine bessere Zuordnung.
- Nutzerrechte vergeben: Fügen Sie Teammitglieder mit passenden Rechten hinzu. Nutzer mit “Vollständig” sehen alle Daten und können Aktionen ausführen, “Eingeschränkt” darf nur lesen. In Agentur-Setups vergeben Sie “Inhaber” vorsichtig, weil Inhaber andere Nutzer entfernen können.
- Haupt-Sitemap einreichen: Unter Sitemaps tragen Sie die URL Ihrer XML-Sitemap ein. Bei WordPress mit Yoast oder RankMath ist das meist
https://ihredomain.de/sitemap_index.xml. - Internationale Ausrichtung prüfen: Bei mehrsprachigen Seiten prüfen Sie
hreflangmit einem Crawler und kontrollieren Stichproben im URL-Prüftool. Google hat den Bericht zur internationalen Ausrichtung 2022 eingestellt, die Search Console listet hreflang-Fehler also nicht mehr auf.
Wer im Team neu in der Search Console ist: Google Search Central hat am 6. Oktober 2026 zwei kuratierte YouTube-Playlists veröffentlicht, vorgestellt von Daniel Waisberg. Search fundamentals for beginners (Grundlagen für Einsteiger) führt durch Crawling, Indexierung, Ausspielung und den Leistungsbericht. Technical SEO fundamentals (technisches SEO) behandelt robots.txt, Crawl-Budget, das URL-Prüftool sowie Bulk-Datenexporte und APIs der Search Console, also genau das Fundament dieses Leitfadens.
Warum Seiten in der Google Search Console nicht indexiert werden
Im Bericht zur Seitenindexierung sehen Sie, ob Google die Seiten, die Ihnen wichtig sind, tatsächlich indexiert. Er teilt jede URL, die Google kennt, in Indexiert und Nicht indexiert und nennt für jede nicht indexierte Gruppe einen Grund. Googles Hilfeseite betont, dass “nicht indexiert” nicht automatisch schlecht ist: Weiterleitungen, Alternativseiten und bewusst auf noindex gesetzte Seiten gehören dorthin.
Die Gründe für den Ausschluss verstehen
Die häufigsten Gründe, zuerst Googles eigene Definition, danach unsere Lesart:
Gefunden - zurzeit nicht indexiert: Google kennt die URL (meist aus einer Sitemap oder einem internen Link), hat sie aber noch nicht gecrawlt. Laut Googles Dokumentation wollte Google die URL in der Regel crawlen, erwartete aber eine Überlastung der Website und hat das Crawling deshalb verschoben, weshalb das Datum des letzten Crawls leer ist. Auf Websites mit Tausenden dünnen oder fast identischen URLs häuft sich dieser Status. Stärken Sie deshalb die interne Verlinkung der wichtigen Seiten und entfernen Sie URLs, die nie hätten entstehen sollen: Seiten, die zu 90% einer anderen gleichen, oder “Waisenseiten” ohne einen einzigen Link.
Gecrawlt - zurzeit nicht indexiert: Google hat die Seite abgerufen, aber nicht in den Index aufgenommen. Google schreibt, sie werde “möglicherweise in Zukunft indexiert, möglicherweise nicht” und ein erneutes Einreichen sei nicht nötig (eigene Übersetzung). Weil Google den Inhalt tatsächlich gesehen hat, prüfen wir zuerst Einzigartigkeit und Tiefe: dünne Seiten und Dubletten anderer Seiten derselben Website sind das Muster, das wir am häufigsten finden.
Soft 404: Die Seite liefert Statuscode 200, verhält sich für Google aber wie eine 404. Das passiert bei leeren Kategorieseiten, Suchergebnisseiten ohne Treffer oder Seiten mit kaum eigenem Inhalt. Ergänzen Sie sinnvollen Inhalt, liefern Sie einen echten 404-Status oder setzen Sie noindex.
Durch robots.txt blockiert: Ihre robots.txt hindert den Googlebot am Crawlen der URL. Prüfen Sie, ob das gewollt ist. In WordPress sind typische Ursachen eine blockierte /wp-admin/admin-ajax.php (das bricht per AJAX geladene Inhalte) oder zu breite Disallow-Regeln.
Alternative Seite mit richtigem kanonischen Tag: Die Seite verweist per Canonical auf eine andere URL. Googles Hilfeseite sagt, die kanonische Seite ist indexiert und es gibt nichts zu tun. Sie sehen den Status bei Parameter-URLs und bei mobilen oder AMP-Alternativen.
Das URL-Prüftool nutzen
Für jede einzelne URL zeigt das URL-Prüftool die indexierte Version: die von Google gewählte kanonische URL, die verweisende Sitemap und den Zeitpunkt des letzten Crawls. Das ist kein Live-Test, sondern die Version, die Google zuletzt gespeichert hat. Mit “Live-URL testen” sehen Sie, was Google jetzt rendert, und so debuggen Sie JavaScript-lastige WordPress-Themes. Zwei Grenzen nennt dieselbe Hilfeseite: Der Live-Test kann nicht vorhersagen, welche kanonische URL Google wählt, und “URL ist auf Google” heißt, die URL kann erscheinen, nicht, dass sie erscheint.
“Indexierung beantragen” im selben Tool ist der offizielle Weg für eine Handvoll normaler Seiten. Googles Anleitung zum erneuten Crawlen sagt, dass Sie dafür Inhaber oder Nutzer mit vollständigen Rechten sein müssen, dass es ein Kontingent für einzelne URLs gibt und dass mehrfaches Anfordern derselben URL das Crawling nicht beschleunigt. Dort steht auch, dass Crawling “einige Tage bis einige Wochen” dauern kann (eigene Übersetzung).
Den Leistungsbericht der Search Console nutzen
Der Leistungsbericht hat vier Kernmetriken: Impressionen, Klicks, durchschnittliche CTR und durchschnittliche Position. Der Wert entsteht beim Filtern und Verknüpfen dieser Dimensionen.
Keywords auf Position 5 bis 20 finden
Filtern Sie die Suchanfragen auf eine durchschnittliche Position zwischen 5 und 20. Bei diesen Begriffen sind Sie schon sichtbar, holen aber noch kaum Klicks. Sortieren Sie nach Impressionen, um die volumenstärksten Chancen zu finden. Für jede davon:
- Prüfen Sie, welche Zielseite Google der Suchanfrage zuordnet (Filter Seiten).
- Bewerten Sie, ob Title-Tag und Meta-Beschreibung zu genau dieser Suchanfrage passen.
- Sehen Sie sich die inhaltliche Tiefe an. Position 8 bis 15 heißt oft, dass Google den Inhalt für relevant, aber nicht für vollständig hält.
- Ergänzen Sie fehlende Unterthemen, aktualisieren Sie veraltete Angaben und verbessern Sie die interne Verlinkung von thematisch verwandten Seiten.
Nach Gerät und Land auswerten
Filtern Sie nach Gerät, um Seiten zu finden, die auf dem Desktop gut und auf dem Smartphone schlecht ranken oder umgekehrt. Das deutet oft auf Rendering- oder UX-Probleme einer Plattform hin. Filtern Sie nach Land, um unerwarteten internationalen Traffic zu entdecken, den Sie mit gezielten Inhalten oder einer hreflang-Umsetzung nutzen können.
Seit Oktober 2026 nimmt der Filter Land mehrere Länder gleichzeitig an. Google hat das auf LinkedIn angekündigt, Barry Schwartz hat es am 6. Oktober aufgegriffen:
„Wenn Sie in mehreren Ländern tätig sind, können Sie jetzt deren kombinierten Traffic aus der Google-Suche sehen.”
Google auf LinkedIn, zitiert von Barry Schwartz bei Search Engine Roundtable, 6. Oktober 2026, eigene Übersetzung
Für eine deutschsprachige Website heißt das konkret: Deutschland, Österreich und die Schweiz anhaken, und Klicks und Impressionen stehen in einer Linie, ohne drei Exporte in einer Tabelle zu addieren. Danach lohnt der Gegencheck mit der Schweiz allein. Bewegt sie die Summe kaum, trägt eine eigene de-CH-Version mit Franken-Preisen den Pflegeaufwand noch nicht.
Zeiträume vor und nach einer Änderung vergleichen
Mit der Funktion Vergleichen messen Sie Zeiträume vor und nach einer Änderung. Nach einer Migration, einer Inhaltsaktualisierung oder einem technischen Fix vergleichen Sie die zwei Wochen davor mit den zwei Wochen danach, um die Wirkung zu beziffern. Exportieren Sie diese Daten über die API in Berichte, die Ihre Stakeholder tatsächlich lesen.
Die Google Indexing API
Mit der Indexing API melden Sie Google, dass eine Seite hinzugefügt, geändert oder entfernt wurde. Ihr Einsatzbereich ist eng. Googles Schnellstart sagt, sie könne “nur zum Crawlen von Seiten verwendet werden, die entweder JobPosting oder BroadcastEvent eingebettet in ein VideoObject enthalten” (eigene Übersetzung), also Stellenanzeigen und Livestream-Videos. Auf derselben Seite steht, dass alle Einreichungen eine strenge Spam-Erkennung durchlaufen und Missbrauch zum Entzug des Zugangs führen kann. Plugins, die jeden Blogbeitrag durch die API schicken, arbeiten außerhalb dieser Dokumentation, und auf Kundenseiten machen wir das nicht. Für normale Seiten nutzen Sie Sitemaps und das URL-Prüftool.
Kontingent und Grenzen
Die Kontingentseite legt Standardwerte pro Google-Cloud-Projekt fest, nicht pro Search-Console-Property:
| Kontingent | Standardwert |
|---|---|
Publish-Anfragen pro Tag (URL_UPDATED und URL_DELETED zusammen) | 200 |
getMetadata-Anfragen pro Minute | 180 |
| Anfragen pro Minute über alle Endpunkte | 380 |
URL_UPDATED meldet eine neue oder geänderte URL, URL_DELETED eine entfernte Seite. Bis zum 16. Oktober 2026 beschrieb Google die 200 als Wert für Onboarding und Tests, der produktive Einsatz lief über ein Freigabeformular. An diesem Tag verschwanden Beschreibung und Formular aus der Dokumentation; die Kontingentseite nennt nur noch die Standardwerte und verweist auf die API-Konsole. Anfragen lassen sich bündeln, und den Benachrichtigungsstatus bereits gemeldeter URLs können Sie abfragen.
Authentifizierung einrichten
- Legen Sie ein Google-Cloud-Projekt an unter console.cloud.google.com.
- Aktivieren Sie die Indexing API in der API-Bibliothek.
- Erstellen Sie einen Service Account unter IAM & Verwaltung und laden Sie die JSON-Schlüsseldatei herunter.
- Fügen Sie die E-Mail des Service Accounts als delegierten Inhaber Ihrer Search-Console-Property hinzu. Googles Voraussetzungen beschreiben den Weg: Property öffnen, in der Liste der bestätigten Inhaber auf “Inhaber hinzufügen” klicken und die Adresse aus dem Feld
client_emaildes JSON-Schlüssels einfügen (sie sieht aus wie[email protected]).
Umsetzung in WordPress mit PHP
Schreiben Sie die cURL-Anfrage nicht selbst. Verwenden Sie eine Bibliothek wie googleapis/google-api-php-client:
// Beispiel: Google über eine geänderte Stellenanzeige benachrichtigen
$client = new Google_Client();
$client->setAuthConfig('service_account.json');
$client->addScope(Google_Service_Indexing::INDEXING);

$service = new Google_Service_Indexing($client);
$postBody = new Google_Service_Indexing_UrlNotification();
$postBody->setUrl('https://ihredomain.de/jobs/frontend-entwickler/');
$postBody->setType('URL_UPDATED');

$service->urlNotifications->publish($postBody);Umsetzung in Node.js
Eine minimale Umsetzung, um Google über die URL einer Stellenanzeige zu benachrichtigen:
const { google } = require('googleapis');

const auth = new google.auth.GoogleAuth({
  credentials: JSON.parse(process.env.GOOGLE_INDEXING_CREDENTIALS),
  scopes: ['https://www.googleapis.com/auth/indexing'],
});

const indexing = google.indexing({ version: 'v3', auth });

async function submitUrl(url) {
  const res = await indexing.urlNotifications.publish({
    requestBody: { url, type: 'URL_UPDATED' },
  });
  console.log(`Submitted: ${url} - ${res.data.urlNotificationMetadata.latestUpdate.type}`);
}
Legen Sie die Zugangsdaten des Service Accounts als Umgebungsvariable (GOOGLE_INDEXING_CREDENTIALS) mit dem Inhalt der JSON-Schlüsseldatei ab. Committen Sie Zugangsdaten nie in die Versionsverwaltung.
Stapelversand mit Ratenbegrenzung
Wenn Sie mehrere URLs senden, halten Sie das Tageskontingent ein und bauen Sie Pausen zwischen den Anfragen ein:
const DAILY_QUOTA = 200;
const DELAY_BETWEEN_REQUESTS_MS = 1000;

async function submitBatch(urls) {
  const batch = urls.slice(0, DAILY_QUOTA);
  for (const url of batch) {
    try {
      await submitUrl(url);
      await new Promise(resolve => setTimeout(resolve, DELAY_BETWEEN_REQUESTS_MS));
    } catch (error) {
      console.error(`Failed to submit ${url}: ${error.message}`);
    }
  }
  console.log(`Submitted ${batch.length} of ${urls.length} URLs`);
}IndexNow und Google Indexing API im Vergleich
Die Google Indexing API richtet sich nur an Google. IndexNow ist ein offenes Protokoll, das mehrere Suchmaschinen gleichzeitig benachrichtigt. Die Teilnehmerliste auf indexnow.org nennt Bing, Yandex, Seznam, Naver, Yep, das Internet Archive und Amazonbot. Google steht nicht auf dieser Liste.
IndexNow funktioniert mit einer einfachen HTTP-POST- oder GET-Anfrage an den IndexNow-Endpunkt mit dem API-Schlüssel Ihrer Website. Der Schlüssel ist eine Textdatei im Wurzelverzeichnis Ihrer Domain, die den Besitz belegt.
curl "https://api.indexnow.org/indexnow?url=https://wppoland.com/de/neuer-beitrag/&key=IHR_API_SCHLUESSEL"Für Stapel erlaubt die IndexNow-Dokumentation bis zu 10.000 URLs pro POST. Eine Antwort 200 heißt nur, dass die Suchmaschine die Liste erhalten hat, nicht, dass sie die URLs crawlt:
const axios = require('axios');

async function submitIndexNow(urls, apiKey, host) {
  const response = await axios.post('https://api.indexnow.org/indexnow', {
    host,
    key: apiKey,
    keyLocation: `https://${host}/${apiKey}.txt`,
    urlList: urls,
  });
  console.log(`IndexNow response: ${response.status}`);
}
IndexNow ist nicht auf Stellenanzeigen beschränkt und damit der Push-Kanal für normale Inhalte bei den Suchmaschinen, die es unterstützen. Google findet diese Seiten weiterhin über Ihre Sitemap.
Sitemaps über die Search Console API einreichen
Neben der Indexing API verwaltet die Search Console API Sitemaps per Code. Das hilft bei Websites mit mehreren Sitemap-Dateien oder dynamisch erzeugten Sitemaps.
Sitemaps per Code einreichen
Die Sitemap-Methoden brauchen einen Client mit dem Scope https://www.googleapis.com/auth/webmasters, nicht den Indexing-Scope aus dem vorigen Abschnitt, und der Service Account braucht Zugriff auf die Property.
const { google } = require('googleapis');

const auth = new google.auth.GoogleAuth({
  credentials: JSON.parse(process.env.GOOGLE_SC_CREDENTIALS),
  scopes: ['https://www.googleapis.com/auth/webmasters'],
});
const searchconsole = google.searchconsole({ version: 'v1', auth });

async function submitSitemap(siteUrl, sitemapUrl) {
  await searchconsole.sitemaps.submit({
    siteUrl,
    feedpath: sitemapUrl,
  });
  console.log(`Sitemap submitted: ${sitemapUrl}`);
}Den Sitemap-Status überwachen
Fragen Sie den Listen-Endpunkt ab, um Fehler, Warnungen, die Zahl eingereichter URLs und den letzten Abruf jeder Datei zu sehen. Die Dokumentation der Sitemap-Ressource markiert contents[].indexed als veraltet und nicht zu verwenden, nehmen Sie indexierte Zahlen also aus dem Bericht zur Seitenindexierung:
async function checkSitemaps(siteUrl) {
  const res = await searchconsole.sitemaps.list({ siteUrl });
  for (const sitemap of res.data.sitemap || []) {
    const submitted = (sitemap.contents || []).reduce((n, c) => n + Number(c.submitted || 0), 0);
    console.log(`${sitemap.path}: ${submitted} submitted, last downloaded ${sitemap.lastDownloaded}`);
    if (Number(sitemap.errors) > 0 || Number(sitemap.warnings) > 0) {
      console.warn(`  Errors: ${sitemap.errors}, warnings: ${sitemap.warnings}`);
    }
  }
}
lastDownloaded ist das Feld, auf das sich ein Alarm lohnt: So haben wir den veralteten Abruf entdeckt, der weiter unten beschrieben ist.
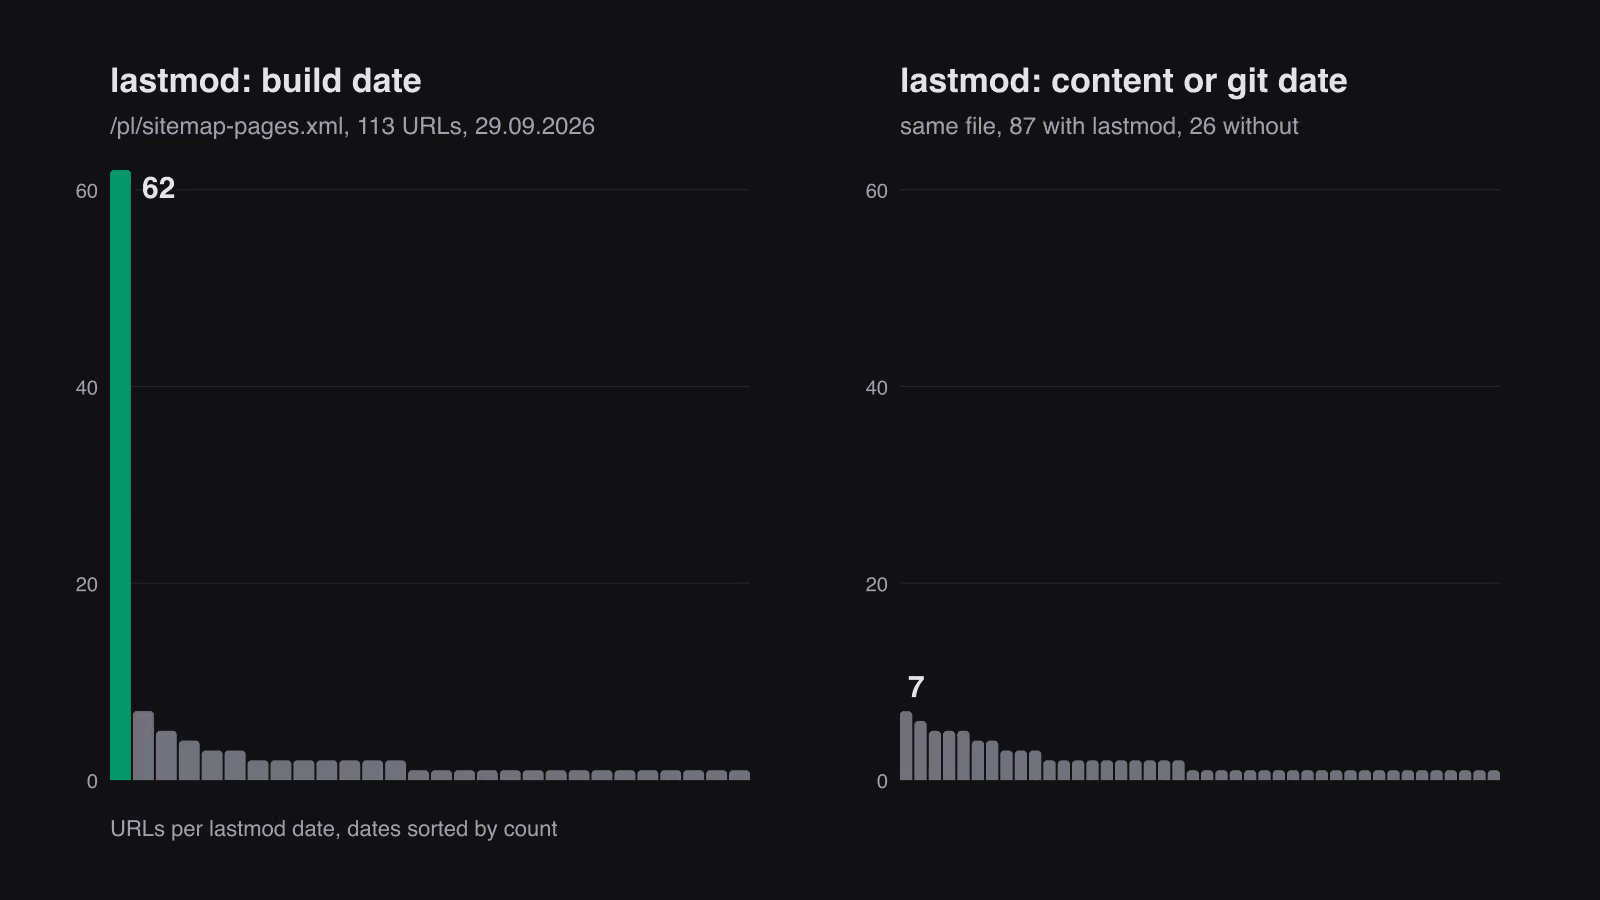
Verlassen Sie sich nicht auf den alten Ping-Endpunkt. Google hat am 26. Juni 2023 seine Abschaffung angekündigt: Sechs Monate später hörte er auf zu funktionieren, Anfragen enden mit 404. Sitemaps laufen über die Zeile Sitemap: in der robots.txt oder über die Search Console. Derselbe Beitrag sagt, dass Google lastmod nur dann zur Planung von Crawls nutzt, wenn der Wert dauerhaft der Realität entspricht.
Google-Indexierung in einer CI/CD-Pipeline automatisieren
Bei statischen Websites mit Astro, Next.js oder ähnlichen Frameworks (wie dem Stack von wppoland.com) sorgt die Einbindung in die Build-Pipeline dafür, dass jedes Deployment die richtigen Meldungen auslöst.
Beispiel für einen Post-Build-Hook
Ein Post-Build-Skript liest die erzeugte Sitemap, findet neue oder geänderte URLs und sendet sie an IndexNow. Nur URLs von Stellenanzeigen und Livestreams gehen an die Google Indexing API:
const { readFileSync } = require('fs');
const { XMLParser } = require('fast-xml-parser');

async function postBuildIndex(sitemapPath) {
  const xml = readFileSync(sitemapPath, 'utf-8');
  const parser = new XMLParser();
  const sitemap = parser.parse(xml);

  const urls = sitemap.urlset.url
    .filter(entry => {
      const lastmod = new Date(entry.lastmod);
      const oneDayAgo = new Date(Date.now() - 86400000);
      return lastmod > oneDayAgo;
    })
    .map(entry => entry.loc);

  console.log(`Found ${urls.length} recently modified URLs`);
  await submitIndexNow(urls, process.env.INDEXNOW_KEY, 'wppoland.com');  // IndexNow
  const jobUrls = urls.filter(u => u.includes('/jobs/'));  // nur JobPosting-Seiten
  await submitBatch(jobUrls);  // Google Indexing API
}Einbindung in CI/CD
In GitHub Actions oder GitLab CI fügen Sie nach dem Deployment einen Schritt hinzu:
- name: Notify search engines
  env:
    GOOGLE_INDEXING_CREDENTIALS: ${{ secrets.GOOGLE_INDEXING_CREDENTIALS }}
    INDEXNOW_KEY: ${{ secrets.INDEXNOW_KEY }}
run: node scripts/post-build-index.jsDas Kontingent einteilen
Mit standardmäßig 200 Publish-Anfragen pro Tag für das ganze Cloud-Projekt muss eine Jobbörse priorisieren:
- Neue Stellenanzeigen zuerst: Eine Anzeige, die Google noch nie gesehen hat, hat Vorrang.
- Abgelaufene Anzeigen danach: Senden Sie
URL_DELETED, wenn eine Stelle besetzt ist, damit sie aus den Ergebnissen verschwindet, statt Bewerber auf eine tote Seite zu schicken. - Unveränderte Inhalte überspringen: Vergleichen Sie
lastmod-Daten oder Inhalts-Hashes, damit kein Kontingent für unveränderte Seiten verbraucht wird. - Überhang auf den nächsten Tag legen: Hat ein Deployment mehr URLs als das Kontingent, speichern Sie den Rest und verarbeiten ihn am Folgetag über eine geplante Aufgabe.
Wie lange Crawling, Indexierung und Ausspielung wirklich dauern
Viele “Warum ist das noch nicht indexiert”-Fälle sind kein Fehler, sondern eine Frage der Uhr. Gary Illyes zeigte bei Search Central Live in Barcelona Googles interne Zeiten, Search Engine Roundtable veröffentlichte die Tabelle am 5. Oktober 2026. Jede Zeile hat einen typischen und einen langsamsten Wert:
| Prozess | Typisch | Am langsamsten |
|---|---|---|
| Entdeckung einer neuen URL | ~20 Stunden | Wochen bis nie |
| Aktualisierung einer bekannten URL | ~30 Tage | Wochen bis nie |
| Sitemap-Verarbeitung | ~24 Stunden | Bis zu 14 Tage, oder nie (Qualität) |
| Rendering | Sekunden, dazu Stunden in der Warteschlange | Tage bis Wochen |
| Indexierung, Ende zu Ende | ~1,5 Stunden | Monate oder nie (Qualität) |
| Änderung der Canonical-Wahl | 1-3 Wochen | Monate (widersprüchliche Signale) |
| Strukturierte Daten | Stunden bis 1-2 Wochen | Wochen oder nie (Qualität) |
| Entfernung in der Search Console (Inhaber) | ~2 Stunden | 24 Stunden |
| Titel-Update | 1-2 Tage | Mehrere Wochen bis Monate |
| Aufhebung einer manuellen Maßnahme | 1-2 Wochen | 4-6 Wochen, bei ruhenden Websites deutlich länger |
| Erholung nach Core Update | 3-6 Monate | 6 Monate bis 1 Jahr (nächstes Core Update) |
| Wirkung eines Spam Updates | 1-2 Wochen (laufend) | Monate (Batch-Aktualisierungen) |
Die Prozesse hängen zusammen: Eine Seite wird nicht indexiert, bevor sie gecrawlt ist, Verzögerungen addieren sich. Gary selbst sagte:
“bedenkt, dass dies eine Übung war, um zu sehen, ob das Publikum einen Bezug zu den Zahlen herstellen kann, die wir intern erhoben und auf diese Folien gebracht haben.”
Gary Illyes, Google, Search Engine Roundtable, eigene Übersetzung
Das sind Größenordnungen, keine Zusagen.
Eine Grenze gehört noch daneben. Die Seite mit den Limits der Search Console API erlaubt der URL Inspection API 2000 Abfragen pro Tag und 600 pro Minute je Website, eine Website mit 6000 URLs braucht also drei Tage, um alle einmal zu prüfen.
Beispiele für Indexierungsverzögerungen in der Search Console
- Eine veraltete Sitemap-Abholung versteckte 2034 URLs. GSC holte unsere sechs Standort-Sitemaps zuletzt am 1. September um 10:08 ab, mit 2037 URLs. Der Bestand wuchs auf 4071, fünf Tage lang kam kein neuer Abruf, obwohl Google die Blog-Sitemaps täglich las. Nach dem erneuten Einreichen per API am 6. September lief der Abruf am selben Tag. Seiten mit Impressionen stiegen von 223 auf 343, Impressionen von 1570 auf 4382, aber es gab 2 Klicks in 7 Tagen. Die Entdeckung bewegte sich, die Conversion nicht.
- Ein Urteil ist eine Momentaufnahme. Am 17. September hatten 3609 von 6747 Sitemap-URLs (53,5%) in 90 Tagen keine Impression. Von 19 geprüften URLs standen 6 auf “Excluded by noindex”, obwohl die Live-Seite
index, followauslieferte. Am 27. September waren es 3 von 20, letzter Crawl zwischen 7. Mai und 20. August. Dasnoindexwar weg, Google war nur noch nicht zurückgekommen. - IndexNow mit geratenen URLs verschwendet das Kontingent. Unser Skript baute 2328 URLs aus Dateinamen, keine stand in der Sitemap, alle antworteten mit 301. Bauen Sie die Liste aus der Sitemap, nicht aus dem Dateisystem.
Bevor Sie eine Seite für schwach erklären, vergleichen Sie das Datum des Urteils mit dem Datum Ihrer letzten Änderung. Ist das Urteil älter, messen Sie die Vergangenheit.
Warum Seiten nach dem Einreichen nicht indexiert werden
Bleiben Seiten nach dem Einreichen einer Sitemap oder einem Indexierungsantrag außerhalb des Index, prüfen Sie diese fünf Probleme, bevor Sie sich die Inhaltsqualität ansehen.
robots.txt blockiert wichtige Ressourcen
Eine häufige Fehlkonfiguration in WordPress blockiert CSS- oder JavaScript-Dateien, die der Googlebot zum Rendern braucht. Sehen Sie sich mit “Live-URL testen” an, was der Googlebot rendert. Sieht die Seite kaputt aus, prüfen Sie, ob Ihre robots.txt benötigte Dateien sperrt. Erlaubt sein sollten immer:
User-agent: Googlebot
Allow: /wp-content/themes/
Allow: /wp-content/plugins/
Allow: /wp-includes/
Blockieren Sie außerdem KI-Scraper, die Crawl-Budget verbrauchen, aber keinen Traffic senden:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /Canonical-Konflikte
Verweist Ihre Seite per <link rel="canonical"> auf eine andere URL, indexiert Google das Ziel. Das passiert oft durch abweichende Schrägstriche am Ende, HTTP/HTTPS-Konflikte oder www und ohne www. Prüfen Sie, ob WordPress-Einstellungen, CDN und Serverkonfiguration dasselbe Canonical-Format verwenden. In Yoast oder RankMath kontrollieren Sie, dass das Canonical nicht pro Seite überschrieben wird.
Noindex-Tags und -Header
Suchen Sie im Quelltext nach <meta name="robots" content="noindex">. In WordPress lässt sich das pro Seite (über SEO-Plugins), pro Kategorie oder global setzen, unter Einstellungen > Lesen > “Suchmaschinen davon abhalten, diese Website zu indexieren”. Prüfen Sie auch die HTTP-Antwort-Header auf X-Robots-Tag: noindex, das manche Sicherheits-Plugins oder CDN-Konfigurationen unbemerkt hinzufügen.
Probleme beim JavaScript-Rendering
Lädt Ihr WordPress-Theme Inhalte per JavaScript (React-basierte Themes, AJAX-Paginierung), sieht der Googlebot womöglich nicht den ganzen Inhalt. Das URL-Prüftool zeigt das gerenderte HTML. Vergleichen Sie es mit dem Quell-HTML, um zu sehen, was nur im Browser geladen wird. Die dauerhafte Lösung ist serverseitiges Rendering oder Pre-Rendering.
Lücken bei der Mobile-First-Indexierung
Google nutzt die mobile Version Ihrer Seite für Indexierung und Ranking. Versteckt die mobile Version Inhalte, nutzt anderes Markup oder lädt andere strukturierte Daten als der Desktop, wird die mobile Version indexiert. Das URL-Prüftool zeigt unter Seitenverfügbarkeit > Gecrawlt > Gecrawlt als, welcher Crawler die Seite abgerufen hat. Prüfen Sie, ob dort Smartphone steht, und suchen Sie im gerenderten HTML nach fehlenden Inhalten. Halten Sie Inhalte auf Mobilgeräten und Desktop gleich.
Bilder-Sitemap für AVIF und WebP erstellen
Yoast und RankMath ergänzen Bildeinträge automatisch, ein eigener oder Headless-Stack muss das selbst erledigen. Googles Dokumentation zu Bilder-Sitemaps beschreibt die Tags als Weg, Google auf Bilder hinzuweisen, die es sonst womöglich nicht findet, etwa Bilder, die Ihre Website per JavaScript lädt. Ein normales <img> in serverseitig gerendertem HTML wird auch ohne sie gefunden.
<url>
  <loc>https://wppoland.com/de/mein-beitrag/</loc>
  <image:image>
    <image:loc>https://wppoland.com/images/mein-beitrag.avif</image:loc>
  </image:image>
</url>
Jede <url> darf bis zu 1000 <image:image>-Tags enthalten. Google hat <image:caption>, <image:title>, <image:geo_location> und <image:license> aus seiner Dokumentation entfernt, Generatoren, die sie noch ausgeben, verschwenden also Bytes. Bilder auf einer CDN-Domain sind in Ordnung, solange diese Domain ebenfalls in der Search Console bestätigt ist und die robots.txt sie nicht blockiert.
Eine neue Seite Schritt für Schritt in den Index bringen
Diesen Ablauf nutzen wir bei wppoland.com für jeden Inhalt, den wir veröffentlichen oder aktualisieren:
- Seite veröffentlichen oder aktualisieren in WordPress oder Ihrem CMS. Strukturierte Daten, Meta-Tags und interne Links stehen, bevor die Seite live geht.
- Sitemap aktualisiert sich automatisch: Ihre XML-Sitemap wird neu erzeugt (Yoast, RankMath oder Ihr Static-Site-Generator erledigen das). Prüfen Sie, ob
lastmodden aktuellen Zeitpunkt trägt. - IndexNow: Das Post-Build-Skript oder der Publish-Hook sendet die URL an IndexNow und benachrichtigt Bing, Yandex und die übrigen Teilnehmer.
- Google Indexing API, nur Stellenanzeigen und Livestreams: Für eine Seite mit
JobPostingoder einemBroadcastEventin einemVideoObjectsendet dasselbe SkriptURL_UPDATED. Normale Seiten überspringen diesen Schritt. - Sitemap über die API: Hat sich die Sitemap-Datei selbst geändert, reichen Sie sie mit
sitemaps.submiterneut ein und prüfen am nächsten TaglastDownloaded. Für eine Handvoll wichtiger normaler Seiten nutzen Sie “Indexierung beantragen” im URL-Prüftool. - In der GSC überwachen: Prüfen Sie mit dem URL-Prüftool oder der URL Inspection API innerhalb ihres Limits von 2000 pro Tag, ob die Seite gecrawlt und indexiert wurde. Google selbst rechnet beim Crawling mit Tagen bis Wochen.
- Nachbessern: Ist die Seite weiterhin nicht indexiert, lesen Sie den Grund im Bericht zur Seitenindexierung, beheben Sie die Ursache und beantragen Sie erst dann ein erneutes Crawling.
So bleibt jede Änderung für Google sichtbar, ohne eine API außerhalb ihres dokumentierten Zwecks zu missbrauchen. Ob Jobbörse, Onlineshop mit saisonalen Produkten oder Agentur mit Kundenprojekten, die Reihenfolge ist dieselbe: zuerst korrekte Sitemaps, dann Push-Kanäle, wo sie erlaubt sind, und Search-Console-Daten zur Kontrolle.
Mehr über unsere SEO- und GEO-Optimierung.