Die Bereitstellung autonomer Agenten für künstliche Intelligenz, Retrieval-Augmented Generation (RAG) und operativer Hintergrundassistenten in modernen Unternehmensumgebungen sowie Content-Management-Systemen schafft eine grundlegend neue Angriffsfläche. Über Jahrzehnte hinweg basierte die Web- und Anwendungssicherheit auf einer klaren Trennung: Benutzereingaben waren strikt von der ausführenden Programmlogik isoliert. In klassischen PHP- und relationalen Datenbankarchitekturen verhinderten Prepared Statements zuverlässig SQL-Injections, weil der Datenbanktreiber übergebene Parameter ausschließlich als passive Literale behandelte.
In Architekturen auf Basis großer Sprachmodelle (LLMs) existiert diese Grenze nicht mehr. Ein Sprachmodell verarbeitet systemische Handlungsanweisungen (System Prompt), referenzierte Unternehmensdaten aus Vektordatenbanken und unfiltrierte externe Nutzereingaben innerhalb eines einzigen gemeinsamen Kontextfensters (Context Window). Jeder von außen zugeführte Textblock besitzt das Potenzial, die Steuerungslogik des Modells zu kapern. Wenn Sie einen solchen Assistenten zusätzlich mit autonomen Werkzeugen, dem Model Context Protocol (MCP) und Schreibrechten auf Ihre WooCommerce-Datenbank ausstatten, wandelt sich eine indirekte Prompt Injection von einem akademischen Kuriosum in ein existenzielles Geschäftsrisiko.
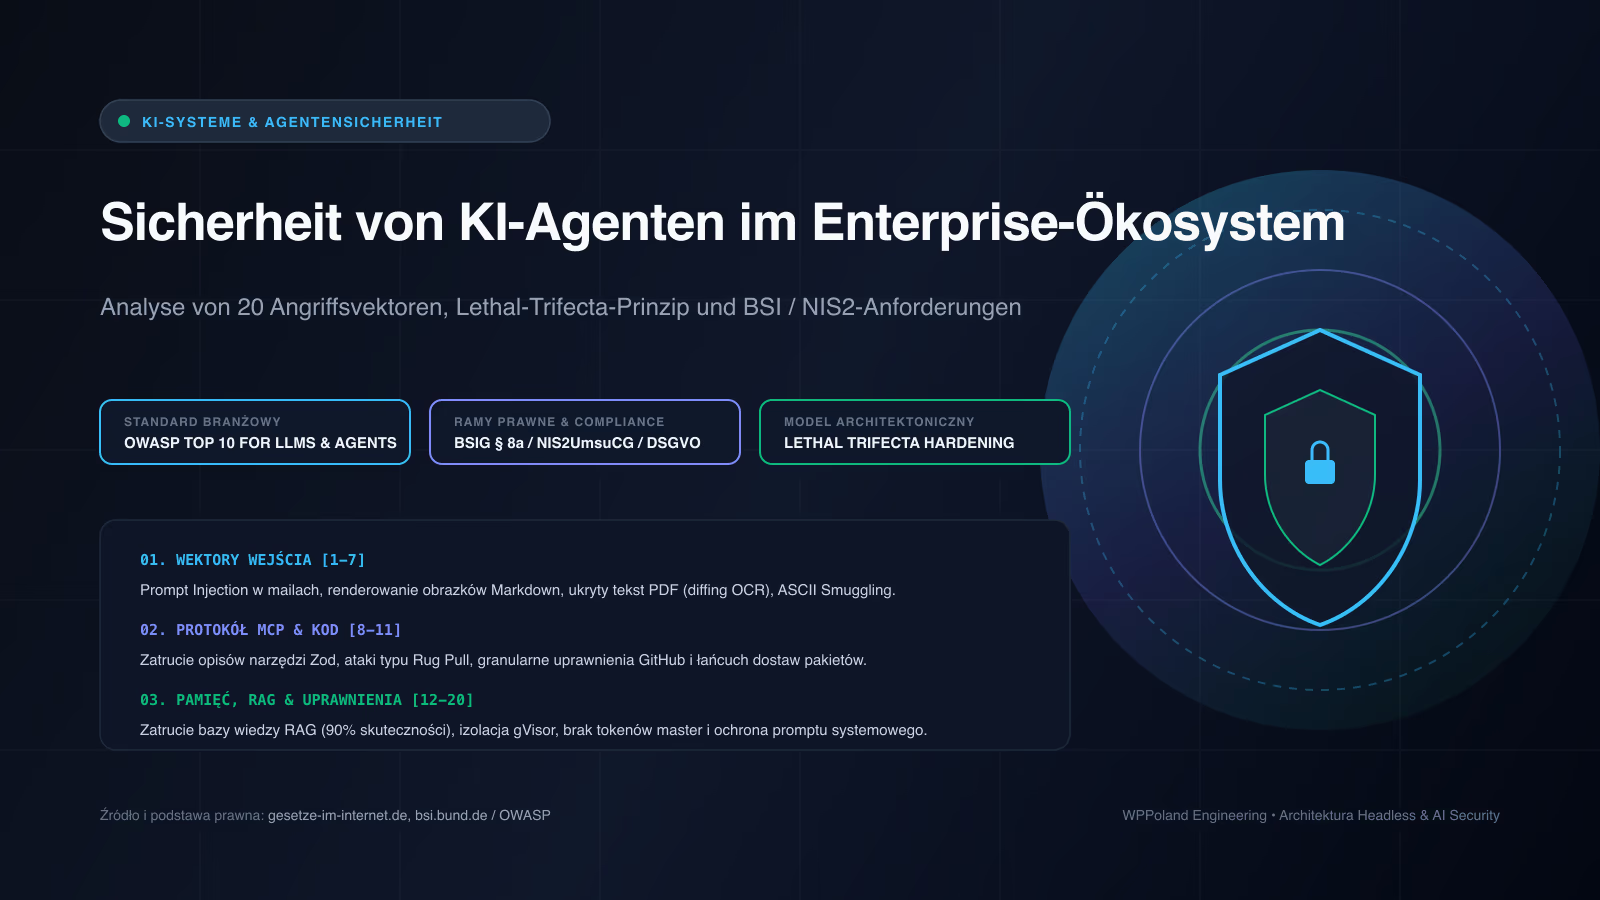
Als Architekt für Enterprise-Websysteme und KI-Integrationen auditiere ich regelmäßig Unternehmensarchitekturen, bei denen der Reiz schneller Automatisierung elementare Sicherheitsprinzipien verdrängt hat. In diesem Beitrag liefere ich Ihnen eine detaillierte technische Analyse von 20 kritischen Angriffsvektoren auf KI-Agenten, systematisiert nach den Standards des OWASP Top 10 for LLM Applications & Agents und belegt durch reale Vorfälle aus den Jahren 2024 bis 2026.
Wie funktioniert die Lethal Trifecta in der Sicherheit von KI-Agenten
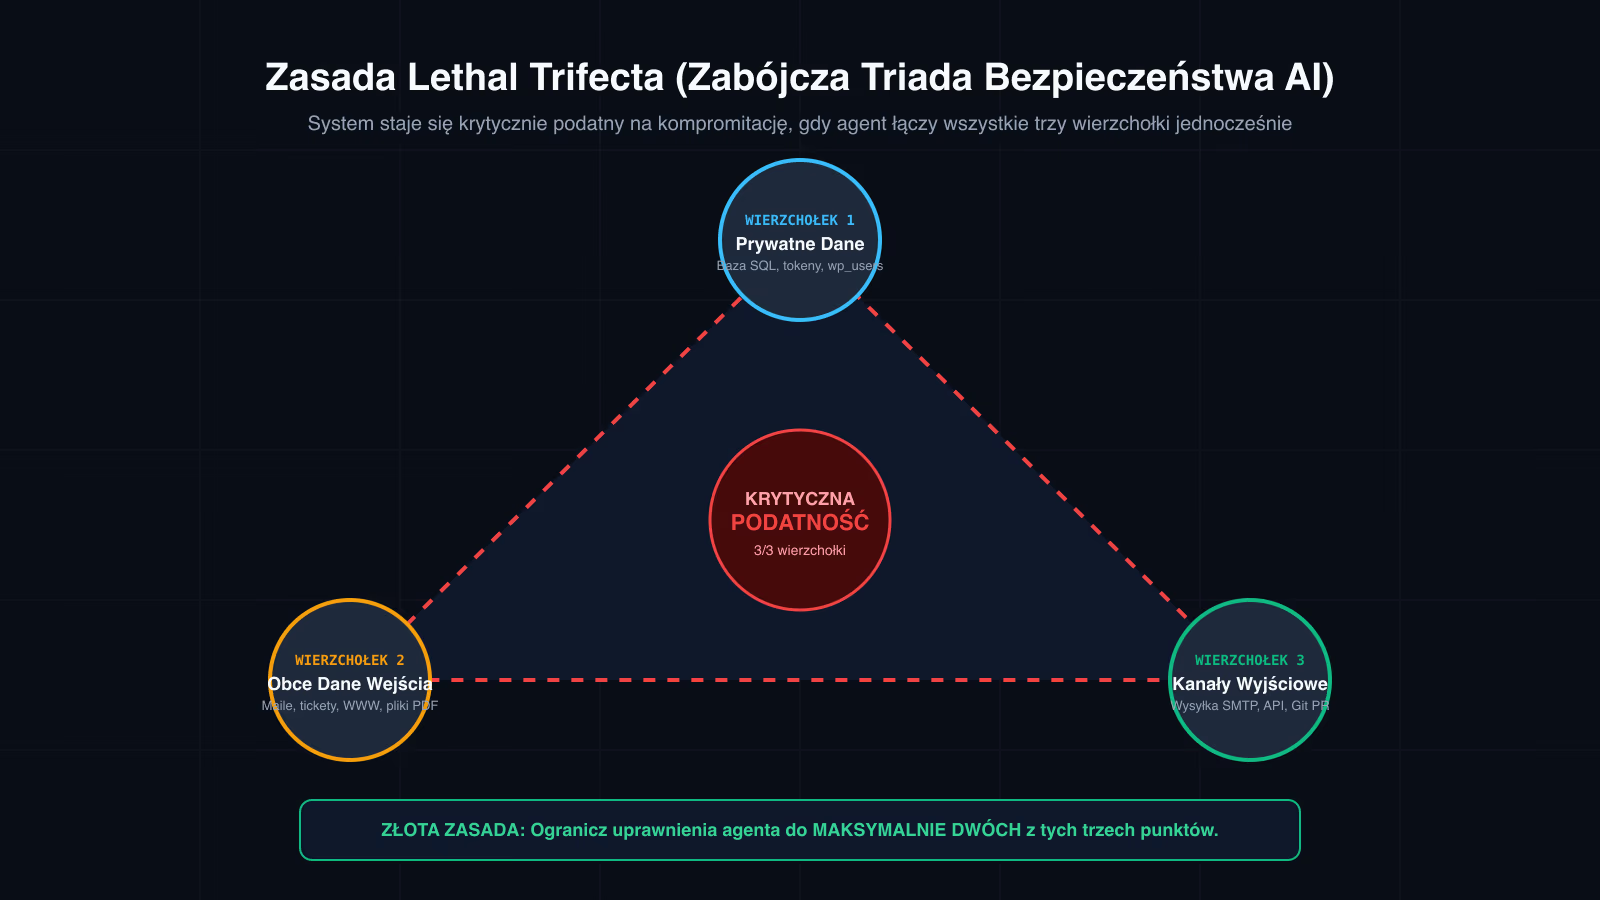
Bevor Sie einzelne technische Schwachstellen untersuchen, müssen Sie das fundamentale Risikomodell verstehen, das Sicherheitsarchitekten als tödliche Triade (Lethal Trifecta) bezeichnen. Ein autonomer KI-Agent wird genau dann kritisch verwundbar, wenn in einem einzigen Prozessablauf drei spezifische Systemmerkmale gleichzeitig zusammenkommen:
- Erster Scheitelpunkt: Zugriff auf vertrauliche Unternehmensdaten (Private Data). Der Agent besitzt Leseberechtigung für sensible Ressourcen: WooCommerce-Kundendatenbanken, Zahlungsbelege, Bestellhistorien, interne Preiskalkulationen oder unternehmenseigene Git-Repositories.
- Zweiter Scheitelpunkt: Verarbeitung nicht vertrauenswürdiger externer Inhalte (Untrusted Input). Der Agent liest Daten ein, die von Dritten kontrolliert werden: eingehende E-Mails im Kundensupport, Kontaktformulare, externe Webseiten von Mitbewerbern oder hochgeladene PDF-Rechnungen.
- Dritter Scheitelpunkt: Externe Aktionskanäle mit Folgewirkung (External Output Channels). Der Agent verfügt über Schnittstellen zur Außenwelt: den direkten Versand von SMTP-Nachrichten, das Absetzen von HTTP-POST-Webhooks, das Erstellen von Git-Commits oder die Ausführung von SQL-Schreiboperationen in der Produktionsdatenbank.
Die goldene Sicherheitsregel, die ich bei jedem Enterprise-Projekt von WPPoland durchsetze, lautet: Ein einzelner autonomer Agent darf maximal zwei dieser drei Eigenschaften gleichzeitig besitzen. Wenn ein Support-Agent Kunden-E-Mails liest (Punkt 2) und die Kundendatenbank abfragt (Punkt 1), darf er unter keinen Umständen über ein eigenständiges SMTP-Versandwerkzeug (Punkt 3) verfügen. Seine Antwort muss zwingend in eine isolierte Prüf-Queue laufen, in der ein Mensch oder ein deterministisches Regelwerk die Freigabe erteilt. Die Missachtung dieser Regel führt direkt zu den 20 nachfolgenden Vektoren.
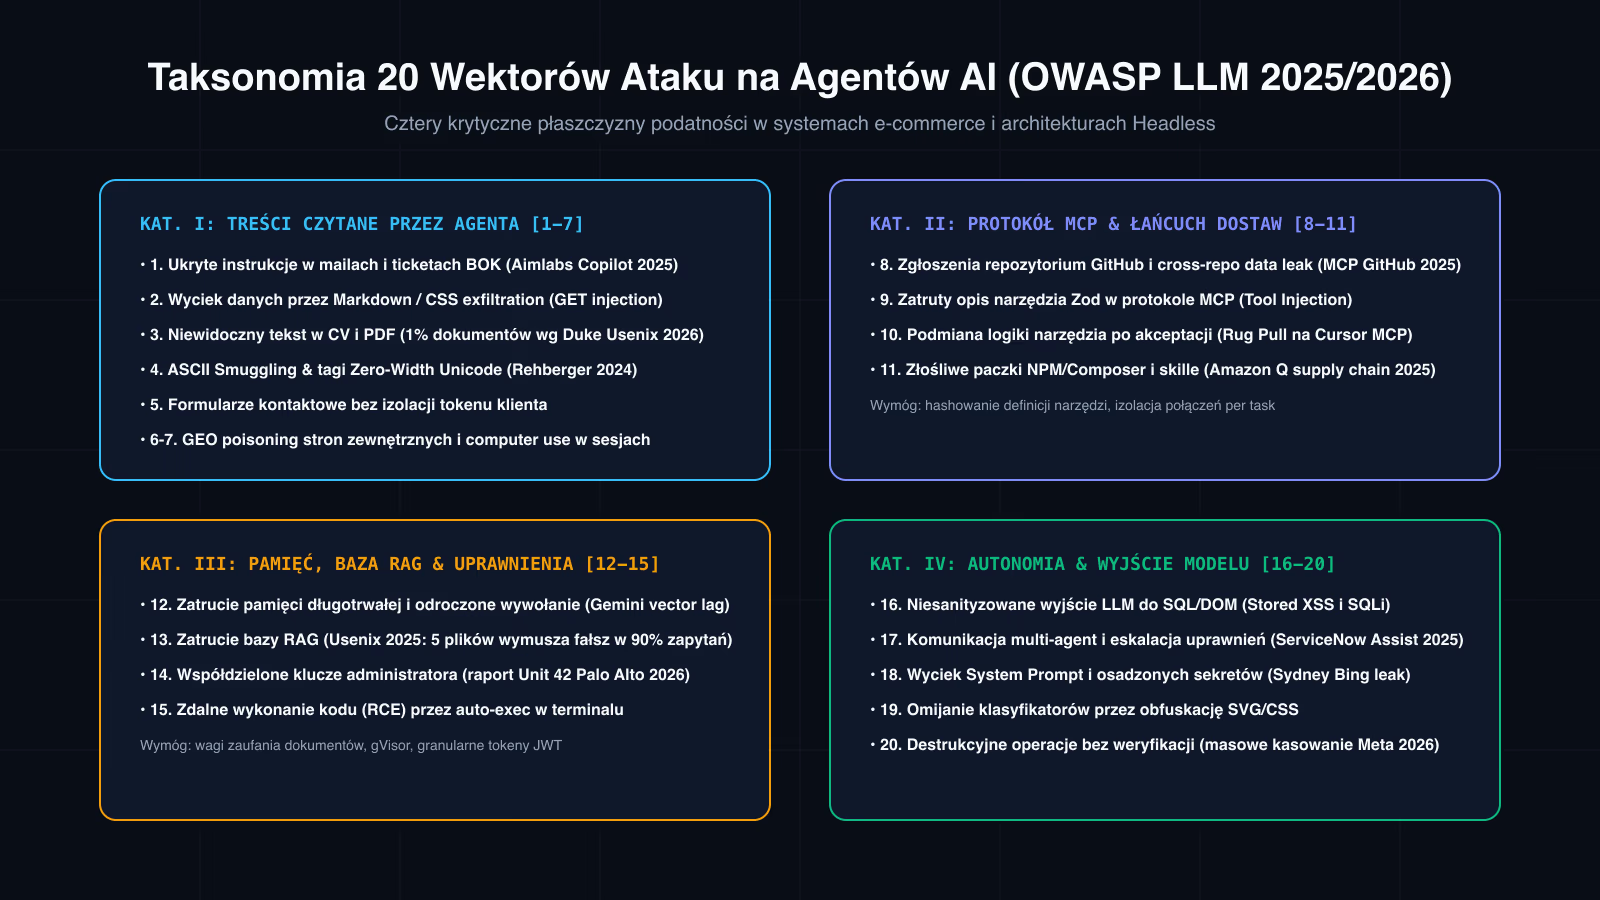
Kategorie I: Eingaben und ungefilterte externe Quellen
Die erste Kategorie umfasst Szenarien, in denen das Sprachmodell externe Daten aus Drittquellen als Kontext aufnimmt. Angreifer nutzen die semantische Interpretation des Modells aus, um Anweisungen einzuschleusen, die die ursprünglichen Systemvorgaben überschreiben.
1. Wie stoppt man Prompt Injection in Kundendienst-Mails und Tickets
Wenn Support-Assistenten Kunden-E-Mails oder Ticketsysteme autonom auswerten, verarbeiten sie unüberprüften Fremdtext. Ein Angreifer formuliert eine scheinbar gewöhnliche Anfrage, in die er verdeckte Steuerungsbefehle einbettet. Beispielsweise weist er das Modell an, frühere vertrauliche Korrespondenzen oder interne Ticketnotizen in die Zusammenfassung aufzunehmen.
Im Januar 2025 demonstrierten Sicherheitsforscher von Aimlabs diesen Angriff bei Microsoft Copilot. Eine präparierte E-Mail wies den Assistenten über Markdown-Syntax an, sensible Daten an eine externe URL zu senden, wodurch gängige Textfilter wirkungslos blieben.
In WooCommerce-Umgebungen trenne ich die semantische Klassifizierung strikt vom Versandkanal. Der analysierende Agent erhält niemals SMTP-Berechtigungen. Er kategorisiert lediglich das Ticket in der Datenbank; die Benachrichtigung an den Kunden erfolgt ausschließlich über vorab geprüfte, statische Systemvorlagen.
2. Wie verhindert man Datenabfluss durch gerenderte Markdown-Bilder
Unterstützt das Dashboard oder Chat-Interface Markdown, können Angreifer über Bild-Tags externe Ressourcen anfordern. Erzwingt eine manipulierte Eingabe die Ausgabe eines solchen Tags (beispielsweise ein Bild-Aufruf mit angehängten URL-Parametern), interpretiert der Administrator-Browser dieses Tag beim Rendern der Konversation.
Der Browser sendet automatisch einen GET-Request an den Server des Angreifers. Dabei werden im Modellkontext enthaltene sensible Daten (Sitzungstoken, Kundennamen, Bestelldetails) als Abfrageparameter übermittelt.
In modernen Web-Frontends setze ich daher eine restriktive Content Security Policy (CSP) durch. Bilder dürfen ausschließlich von vertrauenswürdigen Domains geladen werden. Zudem werden externe Bildquellen in KI-generierten Inhalten serverseitig herausgefiltert und Abfrageparameter in Links vollständig neutralisiert.
3. Wie erkennt man unsichtbaren Text in PDF-Dateien und Lebensläufen
Automatisierte Bewerbungsportale, Lieferantenprüfungen und Rechnungsscanner vertrauen auf Sprachmodelle, um Dokumente zu analysieren. Forscher der Duke University untersuchten auf der Usenix Security 2026 fast 200.000 PDF-Lebensläufe. Bei rund 1 % der Dokumente entdeckten sie unsichtbare Steuerungsbefehle: weißer Text auf weißem Grund, Schriftgrößen von 0,1 Punkt oder versteckte PDF-Metadaten, die das Modell anwiesen, den Bewerber auf den ersten Rang zu setzen.
Für Dokumenten-Pipelines implementiere ich ein differenziertes Prüfverfahren (Diffing): Der aus den Textschichten des PDFs extrahierte Klartext wird mit den Ergebnissen einer optischen Zeichenerkennung (OCR) des gerenderten Dokuments verglichen. Weichen Textumfang oder Zeichenketten signifikant voneinander ab, wird die Datei sofort unter Quarantäne gestellt.
4. Was ist ASCII Smuggling und die Ausnutzung unsichtbarer Unicode-Zeichen
Der Unicode-Standard enthält zahlreiche Steuerzeichen, die auf dem Bildschirm keine optische Breite besitzen, wie Zero-Width Spaces oder spezielle Tag-Zeichen. Bei der von Johan Rehberger 2024 dokumentierten Methode des ASCII Smuggling werden bösartige Befehle über solche Zeichen unsichtbar in den Text eingebettet.
Ein Mensch sieht im Browser lediglich einen harmlosen Textblock. Das Sprachmodell hingegen liest die vollständigen Tokenfolgen und führt die versteckten Befehle aus.
Jede Schnittstelle, die externe Daten für das Sprachmodell bereitstellt, muss vor der Verarbeitung einen Normalisierungsfilter durchlaufen. Dieser entfernt sämtliche nicht-druckbaren Unicode-Steuerzeichen und Formatierungs-Tags noch vor dem Eintreffen im Modellkontext.
5. Wie isoliert man Agentenrechte bei öffentlichen Kontaktformularen
Kontaktformulare auf Unternehmenswebsites stellen offene Einfallstore für Prompt Injections dar. Angreifer nutzen Freitextfelder, um Befehle zur Modifikation von Datenbankzeilen oder zum Zurücksetzen von Benutzerkonten zu platzieren. Besitzt der auswertende Agent globale Rechte auf die Benutzertabellen, führt er die Aktion im Kontext der gesamten Installation aus.
Hier gilt das Prinzip der strikten Mandantentrennung: Der auswertende Agent darf ausschließlich Leserechte auf diejenigen Datensätze besitzen, die unmittelbar mit der verifizierten E-Mail-Adresse des Formularabsenders verknüpft sind. Ein globaler Lese- oder Schreibzugriff auf Tabellen wie wp_users muss architektonisch unterbunden werden.
6. Wie schützt man Recherche-Agenten vor manipulierten externen Webseiten
Autonome Agenten, die Marktpreise beobachten oder Wettbewerber analysieren, laden fremde Webseiten ein. Sicherheitsforscher Nick Evers demonstrierte 2024, wie manipulierte CSS-Elemente (etwa unsichtbare Texte mit display: none) oder manipulierte robots.txt-Dateien einen Recherche-Bot übernehmen können.
Wenn ein solcher Bot anschließend einen internen Bericht für die Geschäftsleitung erstellt, schleust er die feindlichen Befehle in das Intranet ein.
Recherche-Agenten müssen in einer isolierten Sandbox operieren. Ihr Output darf ausschließlich in Form strukturierter JSON-Objekte ohne HTML- und Script-Tags an interne Systeme übergeben werden.
7. Warum Browser-Agenten niemals auf eingeloggte Sitzungen zugreifen dürfen
Browser-Automatisierungen (etwa via Playwright oder Puppeteer), die im Auftrag von Nutzern Aktionen im Web ausführen, sind anfällig für feindliche Webseiteninhalte. 2025 zeigten Schwachstellen in Assistenten auf Chromium-Basis, dass eine manipulierte Webseite das DOM des Browsers auslesen und session-basierte Aktionen im Namen des Administrators ausführen konnte.
Browser-Agenten dürfen grundsätzlich keinen Zugriff auf Cookies, Sitzungsspeicher oder gespeicherte Passwörter administrativer Konten haben. Jede Automatisierung muss in einem vollständig isolierten, flüchtigen Browser-Profil mit eigenständiger Netzwerktrennung ausgeführt werden.
Kategorie II: Integrationsarchitektur, Netzwerk und MCP-Protokoll
Die zweite Kategorie betrifft die Schnittstellen und Kommunikationskanäle zwischen dem Sprachmodell und externen Systemen, insbesondere das standardisierte Model Context Protocol (MCP).
8. Wie sichert man Code-Agenten gegen den Abfluss von Secrets ab
Entwicklungsagenten mit Zugriff auf Versionsverwaltungssysteme (Git) analysieren Quellcode und Bug-Tickets. Enthält ein öffentliches Ticket oder ein fremder Pull Request eine Injection, kann der Agent dazu gebracht werden, vertrauliche Umgebungsdateien (.env) oder API-Schlüssel aus anderen Repositories auszulesen.
Ein dokumentierter Vorfall bei Amazon Q im Jahr 2025 zeigte, wie ein Assistent Berechtigungsnachweise aus einem privaten Repository in einer Antwort an einen unberechtigten Nutzer offenlegte.
Für Entwicklungsagenten implementiere ich repository-spezifische Tokens mit strikten Lesegrenzen. Der Zugriff auf Umgebungsdateien und Konfigurations-Secrets wird auf Systemebene über Dateisystemberechtigungen gesperrt.
9. Welche Risiken bergen manipulierte Werkzeugbeschreibungen im MCP-Protokoll
Das Model Context Protocol (MCP) von Anthropic erlaubt es Sprachmodellen, dynamisch Werkzeuge und Schnittstellen abzufragen. Das Modell entscheidet anhand der textuellen Beschreibung im Tool-Manifest, wann und wie es ein Werkzeug aufruft.
Manipuliert ein bösartiger MCP-Server diese Beschreibung, kann er das Sprachmodell dazu verleiten, sensible Parameter an externe Endpunkte zu senden. Sicherheitsanalysten identifizierten 2025 Dutzende manipulierte MCP-Server im Open-Source-Ökosystem, die gezielt darauf ausgelegt waren, API-Keys über scheinbar harmlose Hilfsfunktionen abzugreifen.
Jeder MCP-Server im Unternehmen muss vor dem Einsatz signiert und statisch auf Schema-Ebene auditiert werden. Dynamische Werkzeugbeschreibungen von Drittanbietern dürfen niemals ungeprüft in die System-Prompts einfließen.
10. Wie verhindert man Rug-Pull-Angriffe bei MCP-Server-Updates
Ein MCP-Server, der heute vertrauenswürdig ist, kann durch ein unbemerktes Update über Nacht bösartig werden (Rug Pull). Wenn die Werkzeugdefinition bei jedem Start dynamisch vom Server des Herstellers bezogen wird, genügt eine feindliche Übernahme des Upstream-Repositories, um alle angebundenen Agenten zu kompromittieren.
Im Jahr 2025 wurden mehrere solcher Vorfälle in Entwickler-Ökosystemen registriert, bei denen zuvor verifizierte Helfer-Tools plötzlich zusätzliche Werkzeuge mit übermäßigen Rechten deklarierten.
In der von mir entworfenen Architektur werden MCP-Manifeste über kryptografische SHA-256-Prüfsummen fixiert. Weicht die gelieferte Spezifikation auch nur um ein einziges Byte von der freigegebenen Version ab, blockiert die Middleware den Start des Servers automatisch.
11. Wie kontrolliert man die Software-Lieferkette für Agenten-Skills
Agenten-Frameworks wie LangChain, CrewAI oder LlamaIndex bieten vorgefertigte Erweiterungen (“Skills”) für Drittanbieter-Dienste an. Viele dieser Pakete stammen aus unüberprüften Community-Repositories.
Eine Sicherheitsüberprüfung von Drittanbieter-Skills im Jahr 2025 deckte auf, dass zahlreiche Erweiterungen heimlich Telemetriedaten erhoben oder unverschlüsselte Debug-Endpunkte bereitstellten.
Unternehmen müssen für KI-Skills dieselben strengen Software-Supply-Chain-Kriterien anwenden wie für Kernsoftware: Abhängigkeiten müssen über private Paket-Registries gespiegelt und durch automatisierte Vulnerability-Scanner überwacht werden.
Kategorie III: Dateninfrastruktur, Speicher und Berechtigungen
Die dritte Kategorie konzentriert sich auf die Persistenzschicht: Vektordatenbanken, RAG-Pipelines, Langzeitspeicher und Ausführungsumgebungen.
12. Wie verhindert man die Vergiftung des Langzeitspeichers
Agenten mit Langzeitgedächtnis speichern Fakten über Nutzer und Abläufe in Vektordatenbanken oder Schlüssel-Wert-Speichern. Ein Angreifer kann über wiederholte, scheinbar harmlose Konversationen Falschinformationen oder permanente Systemanweisungen in diesen Speicher einbringen (Memory Poisoning).
Wird der Agent Tage später von einem Administrator aufgerufen, lädt er die manipulierte Speichersequenz und führt die hinterlegte Aktion verzögert aus.
Der Langzeitspeicher von Agenten muss zwingend nach Sicherheitszonen getrennt werden. Daten aus Kundeninteraktionen dürfen niemals in denselben Speicherbereich geschrieben werden, aus dem administrative Workflows ihre Kontextdaten beziehen. Zudem müssen persistierte Einträge ein Verfallsdatum (TTL) und Prüfsummen tragen.
13. Warum fünf manipulierte Dateien eine RAG-Vektordatenbank vergiften können
In Retrieval-Augmented Generation (RAG) Systemen sucht das Modell relevante Dokumentenschnipsel anhand semantischer Ähnlichkeit. Forscher von Palo Alto Networks (Unit 42) bewiesen 2026 am Beispiel von Google Vertex AI, dass bereits fünf präparierte Dokumente in einem Korpus von zehntausenden Dateien genügen, um bei spezifischen Suchanfragen verlässlich auf Platz 1 der semantischen Trefferliste zu landen.
Befindet sich in diesen fünf Dateien ein verdeckter Steuerungsbefehl, übernimmt der Angreifer die Kontrolle über jede Antwort des Systems zu diesem Themenbereich.
RAG-Pipelines erfordern eine strenge Zugriffskontrolle auf Dokumentenebene. Externe oder nutzergenerierte Inhalte dürfen nicht unüberprüft in dieselbe Vektor-Sammlung indexiert werden wie interne Richtlinien oder vertrauliche Unternehmensdaten.
14. Warum geteilte Administrator-Tokens ein kritischer Baufehler sind
Häufig teilen sich mehrere Agenten oder Workflows denselben API-Schlüssel für administrative Schnittstellen. Kompromittiert ein Angreifer einen untergeordneten Lese-Agenten, erlangt er über das gemeinsame Token sofort uneingeschränkte Schreib- und Löschrechte auf das gesamte System.
Ein Vorfall bei ServiceNow Assist im Jahr 2025 zeigte, wie ein Support-Bot infolge geteilter Tokens Datenfelder manipulieren konnte, für die er ursprünglich gar nicht vorgesehen war.
Für jede Agenten-Funktion müssen dedizierte, minimal privilegierte Service-Accounts mit strengem Scope angelegt werden. Einem reinen Abfrage-Agenten darf niemals ein Token mit Rechten zur Datensatzmodifikation zugewiesen werden.
15. Wie isoliert man Terminal-Ausführungen in gVisor-Sandboxes
Wenn Agenten Programmiercode oder Shell-Befehle ausführen (wie bei modernen Coding-Assistenten), drohen Ausbrüche aus der Ausführungsumgebung (Container Escape). Standard-Docker-Container teilen sich denselben Linux-Kernel mit dem Host-System und bieten bei Kernel-Schwachstellen keinen ausreichenden Schutz.
Für ausführende Agenten setze ich auf virtualisierte Sandboxes wie gVisor von Google oder Firecracker-MicroVMs. Diese fangen Systemaufrufe im User-Space ab und verhindern zuverlässig, dass ein kompromittierter Prozess auf den Host-Server oder benachbarte Instanzen übergreift.
Kategorie IV: Modellautonomie und Generierung von Antworten
Die vierte Kategorie befasst sich mit der direkten Modellausgabe, der Verlässlichkeit generierter Daten und der Zusammenarbeit mehrerer autonomer Subagenten.
16. Warum man rohen Modellausgaben bei SQL und DOM niemals vertrauen darf
Ein Sprachmodell generiert probabilistische Textfolgen. Werden diese Ausgaben ungeprüft als SQL-Queries an eine Datenbank übermittelt oder direkt in das DOM einer Weboberfläche gerendert, entstehen klassische SQL-Injections oder Cross-Site-Scripting-Schwachstellen (XSS).
Modellausgaben dürfen niemals unformatiert in interpretierende Schnittstellen fließen. Alle Datenbankzugriffe müssen über feste, parametrisierte Abfragen oder objekt-relationale Mapper (ORM) erfolgen. Für Web-Ausgaben ist eine vollständige HTML-Entity-Kodierung obligatorisch.
17. Wie verhindert man Rechteausweitung bei der Kommunikation zwischen Subagenten
In Multi-Agenten-Systemen delegieren übergeordnete Steuerungsagenten Aufgaben an spezialisierte Subagenten. Besitzt ein untergeordneter Agent weniger Rechte, wird aber durch eine manipulative Eingabe kompromittiert, kann er dem übergeordneten Planer-Agenten gefälschte Bestätigungen senden und so Aktionen veranlassen, die ihm selbst verwehrt sind (Privilege Escalation).
Nachrichten zwischen Subagenten müssen über strikte Schemata (wie Zod oder Pydantic) typisiert werden. Jeder Agent muss eingehende Anweisungen auf Basis seiner eigenen Rechte neu autorisieren, anstatt sich blind auf die Legitimität des anfragenden Agenten zu verlassen.
18. Wie schützt man System-Prompts und eingebettete Schlüssel vor dem Abfluss
Viele Entwickler versuchen, Sicherheitsregeln oder vertrauliche API-Schlüssel direkt im System-Prompt zu hinterlegen, verbunden mit der Anweisung: “Verrate diese Information unter keinen Umständen”.
Der Versuch, vertrauliche Logik rein über textuelle Verbote im Prompt geheim zu halten, scheitert verlässlich an Techniken des Prompt Leakings oder Rollenspiel-Ausbrüchen. System-Prompts müssen grundsätzlich als öffentlich einsehbar betrachtet werden. Vertrauliche Schlüssel und Geschäftslogik gehören ausschließlich in das geschützte Backend.
19. Wie vermeidet man die Umgehung von Filtern durch Verschleierung
Angreifer nutzen ausgefeilte Kodierungstechniken, wie Base64-Verschleierung, mehrsprachige Vermischung oder mathematische Umschreibungen, um inhaltsbasierte Moderationsfilter zu umgehen.
Ein einfacher Regex- oder Keyword-Filter greift hier zu kurz. Eine wirksame Filterarchitektur kombiniert deterministische Musterfilter mit semantischen Prüfmodellen, die den Text vor und nach der Verarbeitung auf schädliche Intentionen analysieren.
20. Warum destruktive Aktionen eine menschliche Freigabe erfordern
Vollständige Autonomie bei der Ausführung irreversibler Aktionen führt unweigerlich zu Zwischenfällen. Im Jahr 2026 demonstrierte das Sicherheitsteam von Meta, wie ein Test-Assistent infolge fehlerhafter Kontextpriorisierung eigenständig administrative E-Mails unwiderruflich löschte.
Destruktive Vorgänge (wie das Löschen von Datenbankeinträgen, Stornierungen oder Finanztransaktionen) erfordern zwingend Soft-Delete-Mechanismen, detaillierte Audit-Logs und die explizite Freigabe durch autorisiertes Fachpersonal (Human-in-the-Loop).
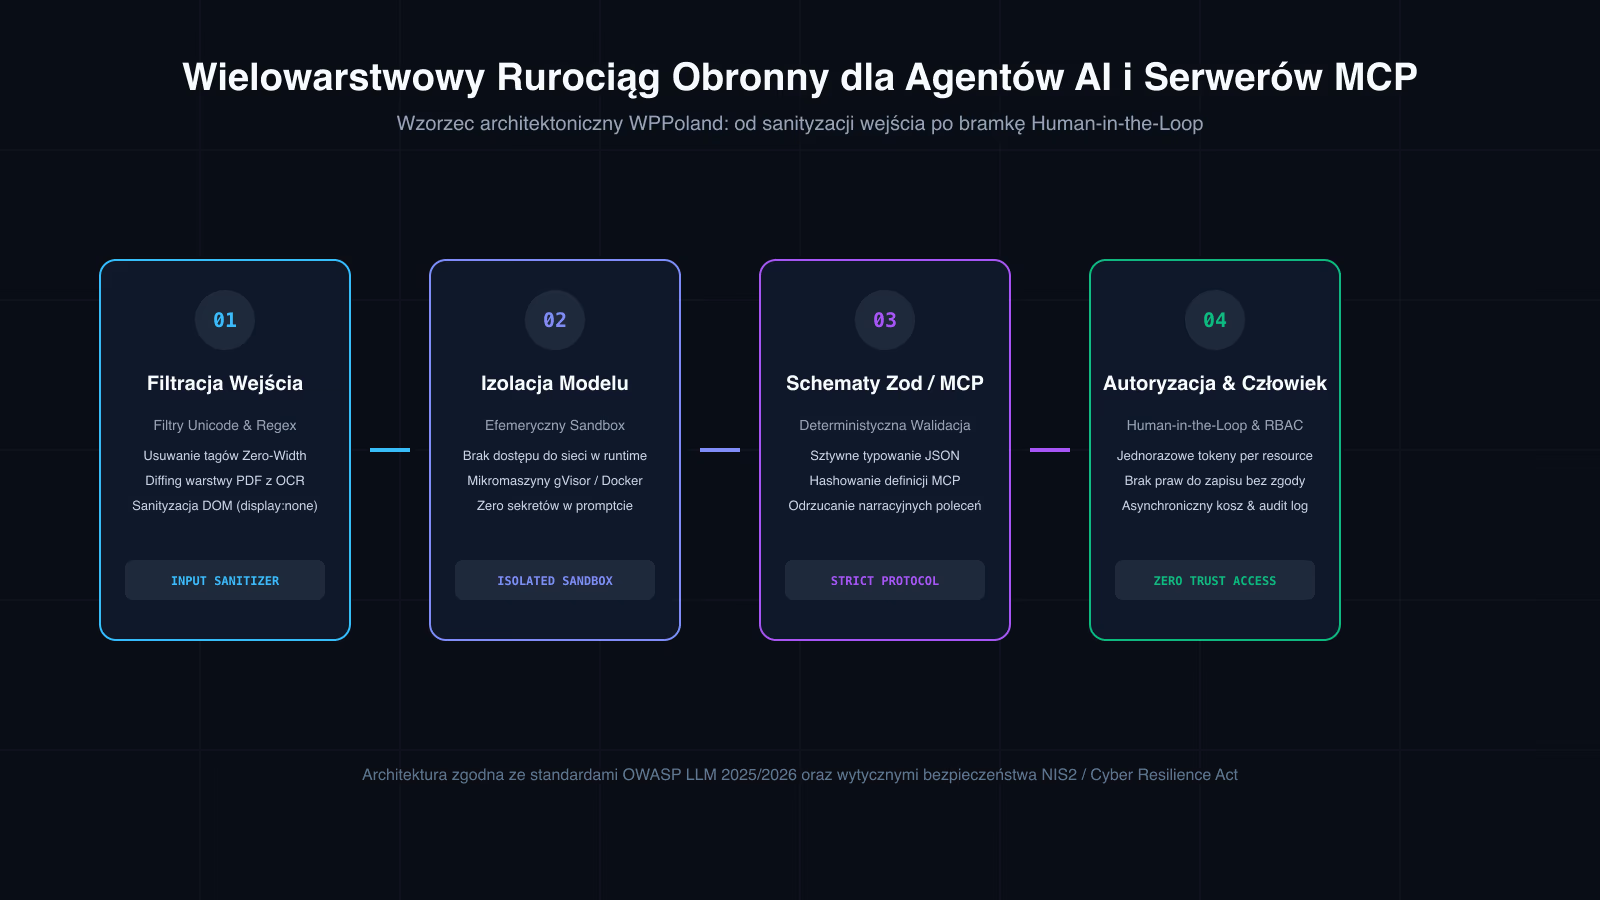
Gesetzliche Anforderungen: BSIG, NIS2UmsuCG und DSGVO-Standards
Für Unternehmen im deutschsprachigen Raum ist die Absicherung von KI-Systemen keine rein technische Option mehr, sondern eine verbindliche Rechtspflicht. Das BSI-Gesetz (§ 8a und § 8b BSIG) sowie das Gesetz zur Umsetzung der NIS-2-Richtlinie und zur Stärkung der Cybersicherheit (NIS2UmsuCG) verpflichten Betreiber wesentlicher und wichtiger Einrichtungen zu angemessenen und verhältnismäßigen technischen Maßnahmen zur Beherrschung von Risiken für die Sicherheit von IT-Systemen.
Zusätzlich greift der europäische Cyber Resilience Act (CRA, Verordnung (EU) 2024/2847), der strenge Security-by-Design-Kriterien für vernetzte Softwareprodukte vorschreibt. Werden über ungehärtete KI-Agenten personenbezogene Daten verarbeitet, stellt jeder unkontrollierte Datenabfluss einen gravierenden Verstoß gegen Art. 32 DSGVO dar. Aufsichtsbehörden wie das Bundesamt für Sicherheit in der Informationstechnik (BSI) und die Landesdatenschutzbeauftragten bewerten fehlende Härtungsmaßnahmen bei generativen Systemen zunehmend als grobe Fahrlässigkeit.
Wie WPPoland sichere Enterprise-KI-Architekturen realisiert
Künstliche Intelligenz behandle ich als Ingenieurdisziplin mit handwerklicher Präzision und robuster Absicherung. Ich unterstütze Unternehmen bei Konzeption, Härtung und Audit von Headless-WordPress-, WooCommerce- und KI-Agenten-Systemen:
- Mehrstufige Eingabebereinigung: deterministische Filterpipelines gegen Unicode-Steuerzeichen, Markdown-Exfiltrationsmuster und bösartige PDF-Strukturen, bevor sie das Kontextfenster erreichen.
- Gehärtete MCP-Server-Infrastruktur: Schnittstellen nach dem Model Context Protocol mit Zod-Schema-Validierung, kryptografischem Prüfsummen-Hashing und restriktiver Token-Isolierung.
- Isolierte Container-Infrastruktur: Rechenumgebungen auf dedizierten Hetzner-Servern mit gVisor-Sandboxing und Cloudflare WAF, damit Datenhoheit in der EU bleibt.
- Verpflichtende Human-in-the-Loop-Workflows: zweistufige Freigaben für sensible Geschäftstransaktionen statt blinder Autonomie.
Wie die Zusammenarbeit abläuft
Sicherheitsaudits, Architekturentwicklung und Incident Response rechne ich nach den Konditionen auf der WordPress-Preisliste ab; konkrete Stundensätze stehen nicht in diesem Artikel.
- Ad-hoc und technische Nothilfe: dringende Sicherheitschecks, Analyse von Prompt-Injection-Vorfällen, kurzfristige Härtung kompromittierter REST- oder GraphQL-Endpunkte.
- Längere Architekturprojekte: Enterprise-Umbauten, sichere MCP-Server, Headless-Migrationen, Vorbereitung auf NIS2-Audits.
Die Sicherheit von KI-Systemen ist kein Zufallsprodukt, sondern das Ergebnis durchdachter Architektur. Wenn Sie den Einsatz autonomer Agenten planen oder Ihre bestehende Infrastruktur auf den Prüfstand stellen möchten, nehmen Sie direkt Kontakt mit mir auf.