Das Änderungsprotokoll der Google-Search-Central-Dokumentation vom 1. Oktober 2026 nennt eine einzige Änderung: Der Leitfaden zur Nutzung generativer KI-Inhalte wurde um Informationen aus den Search Quality Raters Guidelines ergänzt. Die Seite zu den Spam-Richtlinien wurde zuletzt am 28. August 2026 aktualisiert. In Marketingkreisen wurde dies vielerorts als das Ende KI-gestützter Inhalte gedeutet. Die Fakten und die verfügbaren Marktdaten sprechen eine andere Sprache. Die Spam-Richtlinie zielt auf viele Seiten, die vor allem erstellt werden, um Rankings zu manipulieren, egal wie sie entstehen. Die Nutzung eines Sprachmodells ist nicht der Auslöser.
Korrektur, 20. November 2026. Eine frühere Version dieses Artikels datierte Googles Änderungen falsch und beschrieb Mechanismen, die Google nie veröffentlicht hat. Das Änderungsprotokoll vom 1. Oktober 2026 nennt eine einzige Änderung am Leitfaden zu KI-generierten Inhalten. Die Beschreibung der Berechnung von contentEffort und die Aussagen zu Bilderkennungssystemen wurden entfernt.
Wenn Sie eine Unternehmenswebsite auf WordPress, einen Onlineshop auf WooCommerce oder ein modernes Frontend auf Astro im DACH-Raum betreiben, müssen Sie die algorithmischen Bewertungskriterien im Detail kennen. In diesem Leitfaden analysieren wir das Signal contentEffort aus den internen Google-Suchdokumenten, vergleichen offizielle Verlautbarungen mit Marktdaten von Ahrefs und Lily Ray und stellen Ihnen reproduzierbare Verfahren vor, mit denen Sie lokale Städteseiten, Fachglossare und Autorenhub vor Abstrafungen schützen.
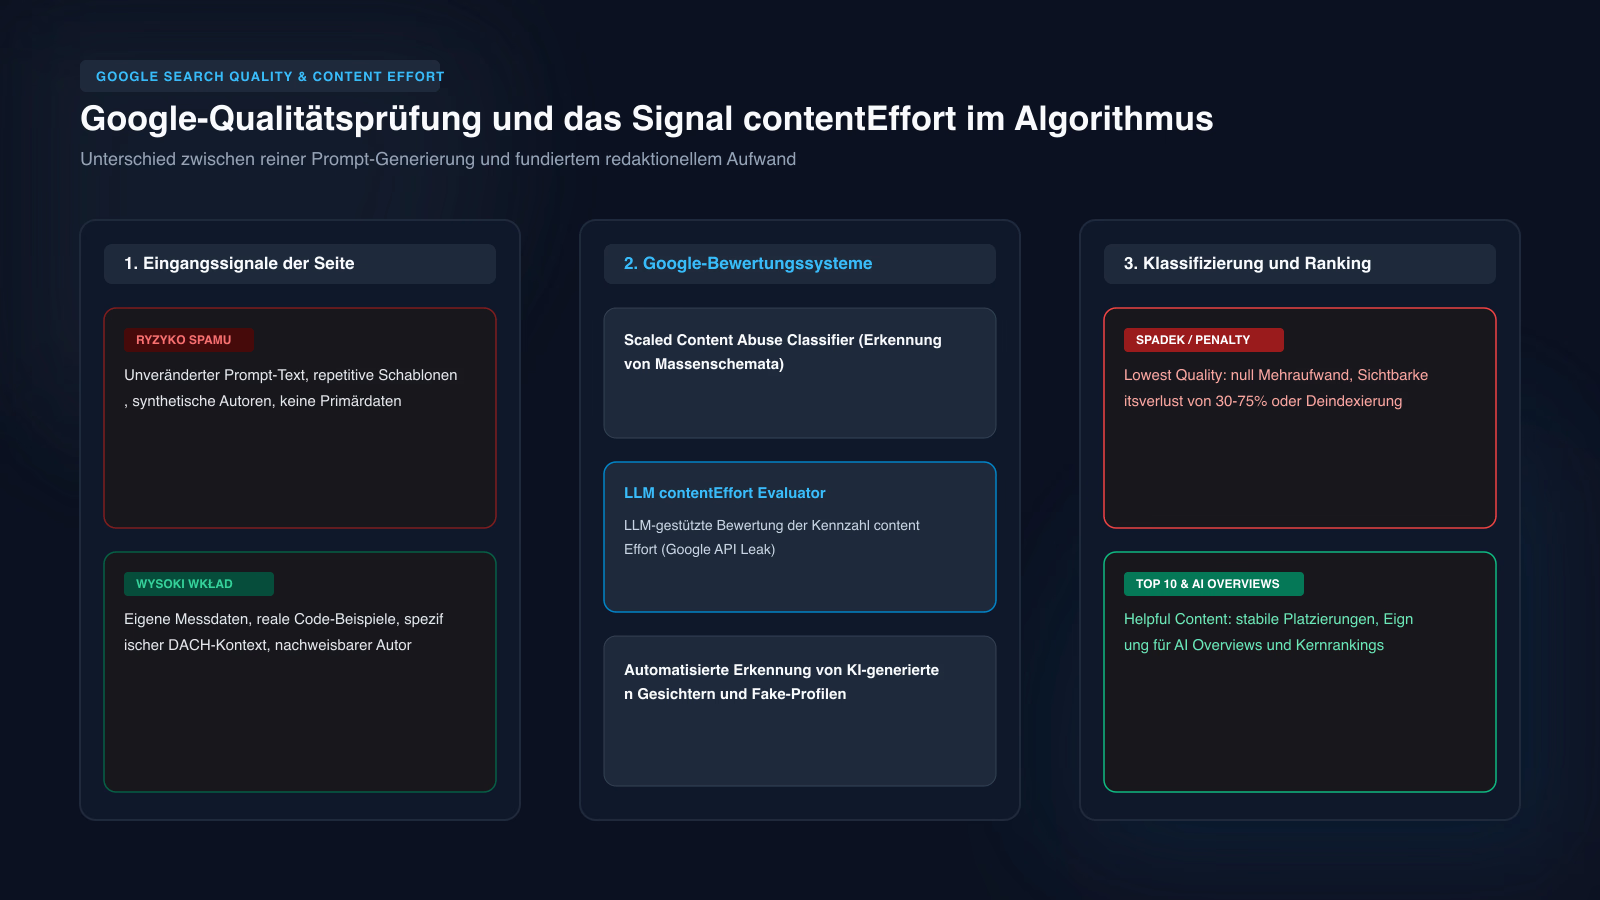
Ablauf der Google-Qualitätsprüfung: Von den Eingangssignalen über das Signal contentEffort und die Spam-Filter bis zur Ranking-Entscheidung in den SERPs. Quelle: Analyse von wppoland.com basierend auf Google Search Essentials, Stand 1. November 2026.
Werden KI-Texte von Google abgestraft?
Die häufigste Frage von Unternehmensverantwortlichen und Entwicklern lautet: Führt der Einsatz von Texten aus ChatGPT, Claude oder eigenen LLM-Pipelines automatisch zu Rankingverlusten bei Google? Aus Sicht der Softwaretechnik lautet die Antwort: Nein, sofern der Inhalt das Problem des Suchenden verlässlich löst und einen eigenständigen Mehrwert aufweist.
In den offiziellen Richtlinien zu webbasiertem Spam (Spam Policies for Google Web Search) verbietet Google Automatisierung nicht grundsätzlich. Der entscheidende Passus betrifft den Missbrauch von Inhalten in großem Maßstab (Scaled Content Abuse):
Der Missbrauch von Inhalten in großem Maßstab liegt vor, wenn viele Seiten in erster Linie generiert werden, um Suchrankings zu manipulieren, anstatt Nutzern zu helfen. Diese unlautere Praxis konzentriert sich typischerweise auf die Erstellung großer Mengen unorigineller Inhalte, die den Nutzern wenig oder keinen Mehrwert bieten, unabhängig davon, wie sie erstellt wurden.
Google Search Central, Spam Policies, Abschnitt Scaled content abuse (eigene Übersetzung)
Beachten Sie die Formulierung: “unabhängig davon, wie sie erstellt wurden”. Die Richtlinie unterscheidet nicht zwischen minderwertigen Textagenturen, automatisierten RSS-Scrapern und Sprachmodellen. Maßgeblich ist, ob viele Seiten vor allem existieren, um Rankings zu manipulieren, statt Nutzern zu helfen. Wenn eine Website generische Textblöcke ausliefert, die lediglich die bestehenden Top-10-Ergebnisse paraphrasieren, fällt sie unter diese Richtlinie.
Auf der Prüferseite nennen die Search Quality Rater Guidelines (Stand 11. September 2025) Seitenfunktionen wie Rechner und Spiele als Hauptinhalt (Main Content). Das ist eine Anleitung für menschliche Prüfer, keine Änderung vom 1. Oktober. Eine Seite mit 300 Wörtern präziser Einführung und einem funktionierenden Konfigurator kann Suchenden besser dienen als eine 3000 Wörter lange, generische Abhandlung ohne praktische Funktion.
Wenn Sie prüfen möchten, wie Ihre aktuelle Webpräsenz im Hinblick auf moderne Qualitätsrichtlinien aufgestellt ist, empfiehlt sich ein technisches Audit. Bei WPPoland analysieren wir Ihre Systemarchitektur im Rahmen des WordPress Website-Checks bis auf Code- und Indexierungsebene.
Was bedeutet die Kennzahl contentEffort im Google-Algorithmus-Leak?
Im Mai 2024 wurden tausende Seiten interner API-Dokumentation aus Googles Entwicklungsabteilung öffentlich. Unabhängige Analysten, darunter SparkToro und iPullRank, werteten die bis dahin undokumentierten Attribute aus.
Eines davon heißt contentEffort. In der geleakten Dokumentation (Modul QualityNsrPQData) wird es nur als “LLM-basierte Aufwandsschätzung für Artikelseiten” beschrieben (eigene Übersetzung). Das ist die gesamte überprüfte Beschreibung. Google hat nicht veröffentlicht, wie der Wert berechnet wird, welche Eingaben er nutzt oder welches Gewicht er im Ranking hat.
Verstehen Sie es als Richtungshinweis, nicht als Messgröße, die Sie optimieren können. Seiten mit eigenen Belegen (eigene Messungen, Screenshots, Code, Projektdaten) stehen besser da als Seiten, die wiederholen, was schon auf der ersten Ergebnisseite steht, was auch immer das Feld intern tut.
Die Rater Guidelines weisen in dieselbe Richtung. Die gültigen Search Quality Rater Guidelines (Stand 11. September 2025) verwenden in Abschnitt 4.6.6 die Formulierung “wenig bis gar kein Aufwand” (eigene Übersetzung) für Hauptinhalt ohne erkennbaren Eigenaufwand.
Wie viele KI-Texte ranken wirklich in den Top 10 bei Google?
Um die tatsächliche Marktlage nüchtern zu beurteilen, helfen empirische Auswertungen großer Suchergebnisdatensätze.
In einer viel beachteten Untersuchung analysierte Ahrefs tausende suchstarke Suchanfragen hinsichtlich des Anteils an KI-generierten Texten in den Top-Ergebnissen:
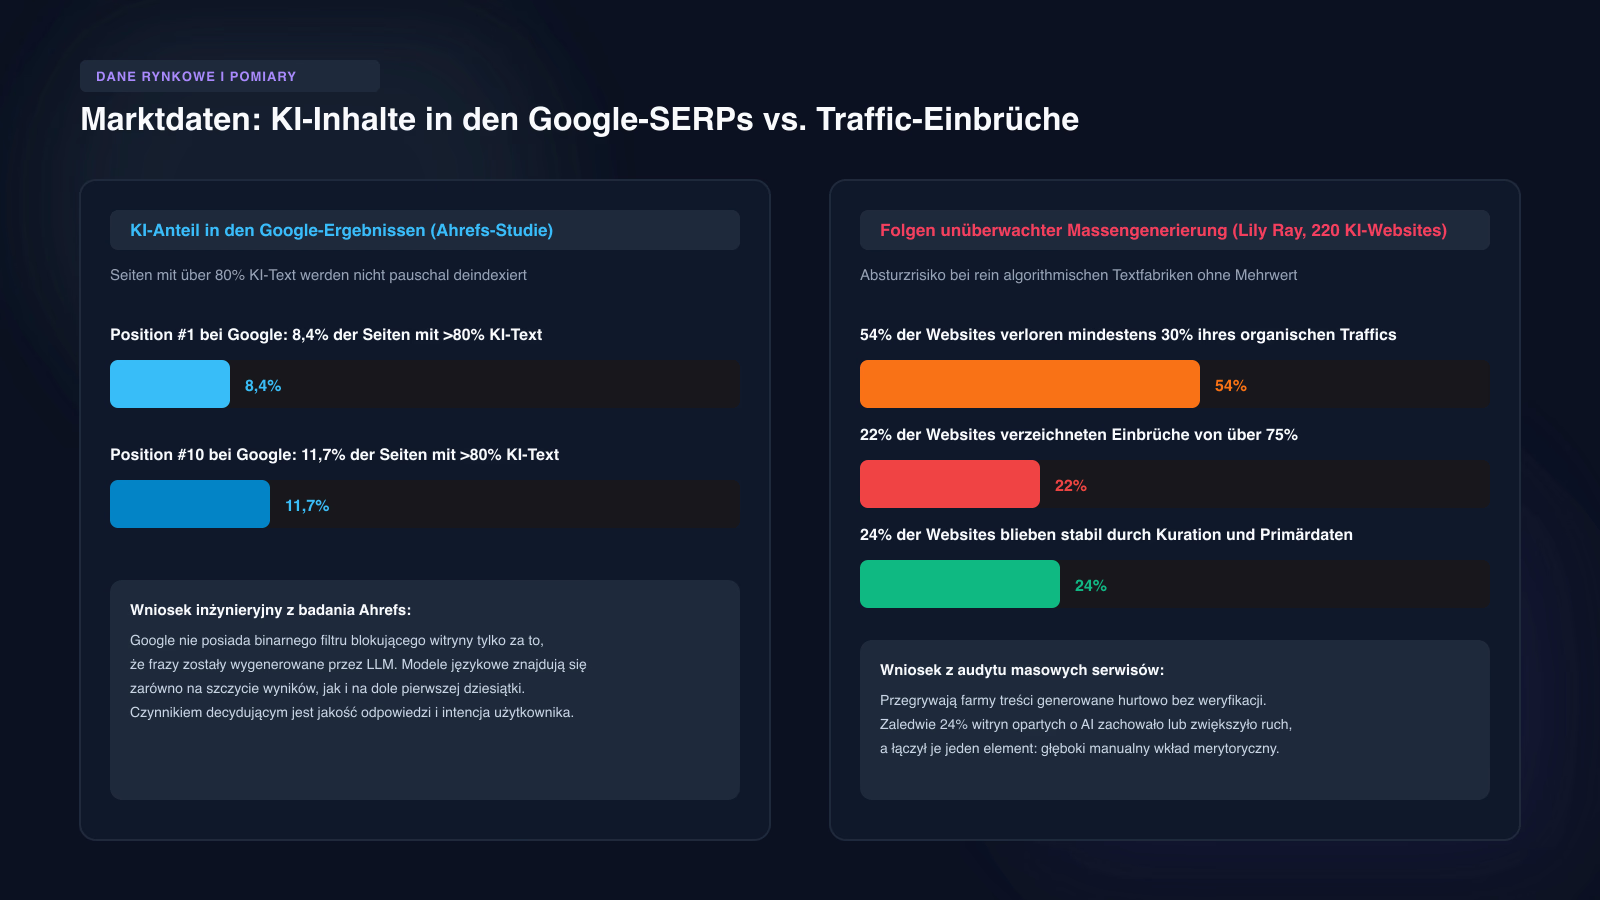
Anteil von KI-generierten Inhalten in den Google Top 10 laut Ahrefs sowie Traffic-Verluste bei Websites mit KI-Content-Strategien nach Lily Ray. Quellen: Ahrefs-Studie zu KI-Inhalten und Lily Ray im Search Engine Journal.
Auf Position 1 der organischen Google-Ergebnisse wiesen 8,4% der untersuchten Seiten einen KI-Textanteil von mindestens 80% auf. Auf Position 10 lag dieser Wert bei 11,7%.
Diese Messwerte zeigen, dass ein Sprachmodell allein eine Seite nicht aus den Top 10 fernhält. Sie zeigen nicht, warum diese Seiten dort stehen: Domain-Autorität, Backlinks, Seitenerlebnis und Passung zur Suchabsicht sind plausible Faktoren, die die Studie nicht trennt.
Anders sieht es bei Portalen aus, die KI als automatisierte Textfabrik ohne fachliche Kontrolle eingesetzt haben. Lily Ray berichtete im Search Engine Journal über 220 Websites mit KI-Content-Strategien:
- 54% verloren mindestens 30% ihres organischen Traffics.
- 22% verloren mindestens 75% ihres organischen Traffics.
Das Risiko liegt nicht im Werkzeug, sondern im Glauben, man könne Suchmaschinen durch Skripte ohne eigenen Fachbeitrag überlisten. Bei WPPoland unterstützen wir betroffene Unternehmen mit unserer Dienstleistung Rettung KI-erstellter Websites, um bestehende Bestände in wertbeständige Online-Assets zu überführen.
Welche Seiten verlieren nach Google-Updates am meisten?
Bei der Analyse abgestürzter Websites lassen sich acht typische Architekturmuster identifizieren, die besonders anfällig für Googles Spam-Klassifikatoren sind:
Paarweise Produktvergleiche (Tool A vs. Tool B). Affiliate-Seiten generieren oft tausende Kombinationen über Skripte. Da die Modelle für jedes Paar identische Vergleichstabellen und oberflächliche Texte ausgeben, fehlt jeder echte Messwert oder Praxistest.
Isolierte Glossarseiten und Einzelbegriff-Erklärungen. Die massenhafte Anlage von Unterseiten für Standardbegriffe (wie “Was ist eine API” oder “Was bedeutet Headless CMS”). Diese Seiten verlieren Traffic, weil Google Definitionen direkt in AI Overviews oder über Wikipedia ausgibt.
Ranglisten mit unbegründeter Eigenplatzierung auf Platz 1. Beiträge wie “Die 10 besten Agenturen”, bei denen der Website-Betreiber sich selbst stets die Bestnote gibt und Wettbewerbern pauschale Nachteile zuschreibt. Ohne transparente Testmethodik stufen Algorithmen dies als unzuverlässig ein.
Template-basierte “Alternativen zu [Wettbewerber]“-Seiten. Landingpages, die Markennamen von Marktführern abgreifen wollen. Wenn dort lediglich Preislisten abgeschrieben werden, ohne technische API-Grenzen oder Migrationsaufwände zu analysieren, erfolgt eine Abwertung als Thin Content.
Schablonenhafte Städteseiten im lokalen SEO. Die im deutschsprachigen Raum verbreitete Praxis, ein und denselben Dienstleistungstext für 200 Städte zu vervielfältigen, indem lediglich der Ortsname im Titel und Fließtext ausgetauscht wird.
Frage-Antwort-Farmen für GEO und AEO. Das massenhafte Erstellen kurzer FAQ-Seiten auf Basis von W-Fragen, um Erwähnungen in Perplexity oder ChatGPT zu erzwingen. Ohne eigene Primärdaten führt dies zur Deindexierung.
Themenfremde Füllartikel (Parasite SEO). Veröffentlichungen zu Finanz- oder Lifestyle-Themen auf der Domain eines Handwerksbetriebs, um unqualifizierten Traffic abzufangen. Google bewertet die thematische Kernautorität (Topical Authority) streng.
Automatisierte Katalog-Zusammenfassungen ohne Produkttests. Shops, die Lieferantendaten importieren und durch KI-Paraphrasierer schleusen. Ohne eigene Fotos, Maßprüfungen oder Anwendungstests ist der contentEffort gleich null.
Allen diesen Formaten ist gemein, dass sie für Suchmaschinen-Bots konzipiert wurden und nicht für menschliche Entscheidungsträger.
Städteseiten vor Duplicate-Content-Filtern schützen
Regionale Landingpages (beispielsweise /webentwicklung-berlin/, /webentwicklung-muenchen/ oder /webentwicklung-zuerich/) sind für Dienstleister und Agenturen zentrale Akquisitionskanäle. Wenn jedoch hunderte Unterseiten fast denselben Wortlaut teilen und nur der Ortsname wechselt, passt das zur oben zitierten Definition von Scaled Content Abuse. Google hat keinen Mechanismus für eine domainweite Abstrafung veröffentlicht, die sichere Annahme ist daher, dass die ganze Website betroffen sein kann.
Um Städteseiten im DACH-Raum abzusichern, müssen Sie eine Architektur regionaler Differenzierung etablieren:
Erstens: Dokumentieren Sie reale Projekte mit lokalem Bezug. Statt pauschaler Aussagen beschreiben Sie konkrete Implementierungen: Welches Unternehmen aus der Region wurde betreut, welche ERP-Anbindungen an lokale Logistiker wurden realisiert und welche Hosting-Herausforderungen bestanden?
Zweitens: Berücksichtigen Sie die spezifischen rechtlichen und behördlichen Rahmenbedingungen im Zielmarkt. Im DACH-Raum müssen Sie nationale Vorgaben präzise trennen:
- In Deutschland sind die Bestimmungen des Digitale-Dienste-Gesetzes (§ 5 DDG, ehemals TMG) bezüglich der Impressumspflicht sowie § 5a UWG (Irreführung durch Unterlassen) einzuhalten. Aufsichtsbehörden wie die Bundesbeauftragte für den Datenschutz (BfDI) und die Bundesnetzagentur (BNetzA) setzen strenge Maßstäbe.
- In Österreich gelten das Fern- und Auswärtsgeschäfte-Gesetz (FAGG) und die Aufsicht der Datenschutzbehörde (DSB).
- In der Schweiz greifen das Bundesgesetz gegen den unlauteren Wettbewerb (UWG) und das Obligationenrecht (OR). Bei grenzüberschreitendem Handel in die EU gilt Art. 6 der Rom-I-Verordnung (Verordnung (EG) Nr. 593/2008). Nennen Sie niemals polnische Rechtsnormen in deutschsprachigen Texten.
Drittens: Hinterlegen Sie reale logistische Gegebenheiten. Beschreiben Sie konkrete Abholstandorte, regionale Anfahrtswege oder lokale Server-Standorte (beispielsweise Rechenzentren in Frankfurt am Main oder Zürich).
Viertens: Nutzen Sie strukturierte Daten, die der Wirklichkeit entsprechen. Beschreiben Sie einen physischen Standort nur, wenn das Unternehmen wirklich einen hat. Ein vollständig remote arbeitendes Unternehmen erfindet keine Büroadresse, Telefonnummer oder Koordinaten und kann stattdessen areaServed mit einem eindeutigen Wikidata-Verweis nutzen.
Hier ein Beispiel für JSON-LD einer lokalen Leistungsseite. Alle Werte sind Platzhalter (example.com), ersetzen Sie sie durch Ihre eigenen Daten:
{
  "@context": "https://schema.org",
  "@type": "ProfessionalService",
  "name": "Beispiel Webagentur",
  "url": "https://example.com/berlin/",
  "areaServed": {
    "@type": "City",
    "name": "Berlin",
    "sameAs": "https://www.wikidata.org/wiki/Q64"
  }
}
Durch echte Daten und standardisierte Entitätenverknüpfungen schaffen Sie Inhalte, die algorithmisch stabil bleiben.
Glossarseiten vor Rankingverlusten schützen
Fachglossare wurden jahrelang genutzt, um über hunderte Definitionen schnell organische Reichweite aufzubauen. Nach den jüngsten Algorithmusanpassungen verloren derartige Portale oft mehr als die Hälfte ihrer Besucher.
Eine Standarddefinition aus dem Lehrbuch besitzt aus Googles Sicht kaum contentEffort. Sucht ein Anwender nach “Was ist ein REST-Endpunkt”, zeigt Google die Antwort direkt in den Suchergebnissen an, anstatt auf ein austauschbares Glossar zu verlinken.
Um ein technisches Glossar abzusichern, müssen Sie jeden Begriff mit einem Praxisnachweis (Production Proof) versehen:
- Präzise Definition: Ein bis zwei technisch exakte Sätze, optimiert für semantische Speakable-Selektoren.
- Reales Code-Beispiel: Zeigen Sie die konkrete Implementierung. Wenn Sie “Transients API in WordPress” erklären, zeigen Sie den echten Aufruf von
set_transient()mit Ablaufzeit und Fallback-Handling. - Fehlerdiagnose und Grenzwertbetrachtung: Erläutern Sie, was bei falscher Nutzung geschieht (beispielsweise Speicherüberlauf in der Datenbanktabelle
wp_options).
| Element | Anfällige Standard-Seite (Hohes Risiko) | Robuste Fachdokumentation (Hoher contentEffort) |
|---|---|---|
| Begriffsdefinition | Drei Absätze allgemeines KI-Geschwätz über die Bedeutung von Datenbank-Indizes. | Ein technischer Satz, der Indizes als interne B-Tree-Strukturen zur Abfragebeschleunigung definiert. |
| Code-Nachweis | Kein Code oder ein theoretisches SQL-Muster aus einem Anfänger-Tutorial. | Reale SQL-Analyse mittels EXPLAIN ANALYZE auf typische WooCommerce-Tabellenabfragen. |
| Fehleranalyse | Vage Warnung, dass langsame Datenbanken schlecht für die Nutzererfahrung sind. | Konkrete Analyse von Lock-Waits und CPU-Spitzen bei mehr als 100 parallelen Abfragen. |
| Compliance-Bezug | Keine Erwähnung von Datenschutz oder Gesetzen. | Technische Umsetzung der DSGVO-Löschfristen nach Art. 17 DSGVO in Transaktionsprotokollen. |
Mit dieser Tiefe fungiert Ihr Glossar als Fachreferenz, die von Entwicklern geschätzt und von Algorithmen dauerhaft indexiert wird.
Warum KI-Autorenbilder und Fake-Biografien schaden
Um den E-E-A-T-Kriterien zu genügen, haben zahlreiche Publisher erfundene Fachautoren mit Porträts aus Bildgeneratoren veröffentlicht.
Die Search Quality Rater Guidelines weisen menschliche Prüfer an, in gefälschten Autorenprofilen nach KI-generierten Bildern zu suchen. Google hat nicht veröffentlicht, ob und wie solche Bilder automatisch erkannt werden. Aussagen über Pupillengeometrie oder Ohrmuscheln sind Vermutungen, keine Dokumentation.
Das Problem ist praktisch. Hat ein angeblicher Fachautor für IT-Sicherheit oder Steuerrecht keinen überprüfbaren Fußabdruck (kein Eintrag in Fachregistern, kein verifiziertes GitHub- oder LinkedIn-Profil, keine Konferenzbeiträge), haben Leser und Prüfer keinen Grund, seinen Ratschlägen zu glauben.
Im DACH-Raum birgt dieses Vorgehen zudem rechtliche Konsequenzen. Gemäß § 5a Abs. 1 UWG in Deutschland und den entsprechenden Bestimmungen in Österreich und der Schweiz stellt das Vortäuschen beruflicher Qualifikationen oder einer falschen Identität eine irreführende geschäftliche Handlung dar. Abmahnungen durch Wettbewerber und Verbraucherschutzverbände sind die direkte Folge.
So setzen Sie Autorenprofile auf WordPress sauber um:
- Benennen Sie die realen Mitarbeiter oder Berater, die den Beitrag verfasst oder fachlich geprüft haben.
- Verwenden Sie authentische Fotografien ohne verzerrende Filter und speichern Sie diese im modernen AVIF-Format ab.
- Integrieren Sie ein
Person-Schema in JSON-LD, inklusivesameAs-Verweisen auf externe Fachprofile. Alle Werte im Beispiel sind Platzhalter (example.com), ersetzen Sie sie durch Ihre eigenen Daten:
{
  "@context": "https://schema.org",
  "@type": "Person",
  "name": "Beispiel Autor",
  "worksFor": {
    "@type": "Organization",
    "name": "Beispiel GmbH",
    "url": "https://example.com"
  },
  "url": "https://example.com/autor/beispiel-autor/",
  "sameAs": [
    "https://github.com/beispiel-autor",
    "https://www.linkedin.com/in/beispiel-autor/"
  ]
}
Authentische Autorenschaft schützt Ihre Domain vor Abstrafungen und schafft Vertrauen bei anspruchsvollen Unternehmenskunden.
Wie funktioniert der Ein-Prompt-Test?
Der Ein-Prompt-Test (Single Prompt Test) ist eine praktische Prüfmethode aus der Suchmaschinenoptimierung, um die Krisenfestigkeit von Inhalten zu ermitteln.
Das Prinzip lautet: Wenn ein Wettbewerber die Überschrift Ihres Artikels als einzelnen Prompt in ChatGPT oder Claude eingeben kann und die resultierende Antwort in Aufbau, Argumentation und Informationstiefe Ihrem veröffentlichten Text gleicht, besitzt Ihr Inhalt für Google keinen eigenständigen Wert.
Solche Inhalte werden bei künftigen Algorithmus-Updates zwangsläufig an Sichtbarkeit verlieren:
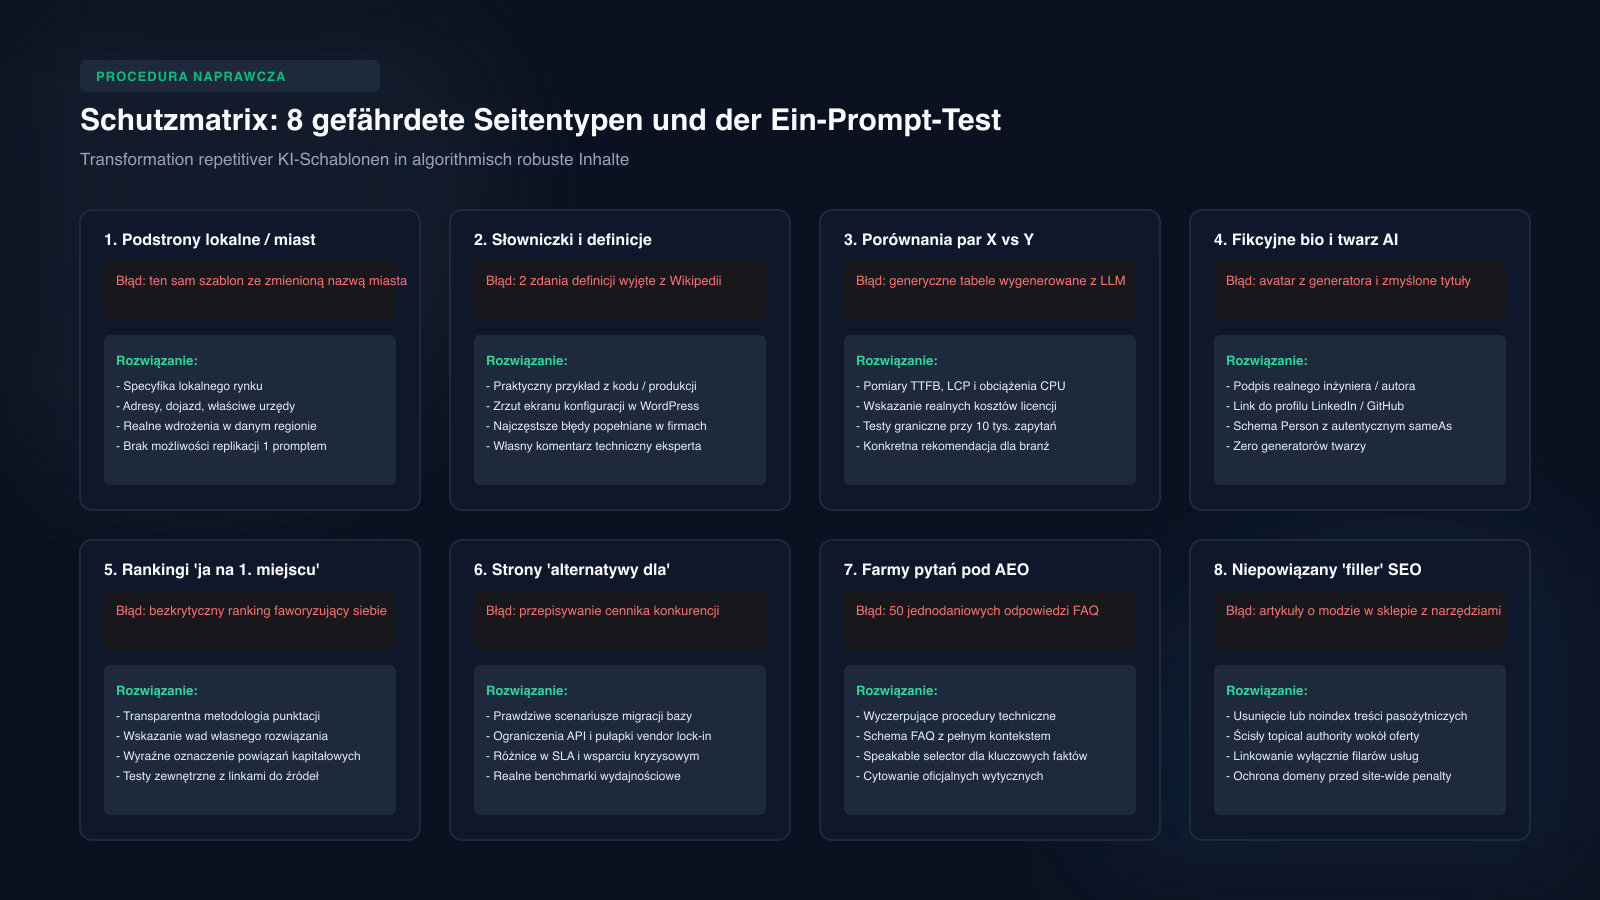
Schutzmatrix für acht anfällige Webseitenstrukturen mit konkreten technischen Maßnahmen zum Bestehen des Ein-Prompt-Tests. Quelle: WPPoland-Entwicklungsleitfaden, 2026.
So führen Sie den Test auf Ihrer Website durch:
Schritt 1: Wählen Sie stichprobenartig fünf Blogartikel oder Leistungsseiten Ihrer Website aus. Schritt 2: Geben Sie den exakten Titel ohne weitere Zusatzanweisungen in ein modernes Sprachmodell ein. Schritt 3: Vergleichen Sie das Ergebnis anhand von vier Kernfragen mit Ihrem Live-Text:
- Enthält Ihr Artikel konkrete Zahlen, Messwerte, Projektkosten oder Latenzzeiten, die das Modell nicht genannt hat?
- Zeigt Ihre Seite Screenshots, Log-Auszüge oder Architekturdiagramme aus echten Systemumgebungen?
- Vertritt Ihr Beitrag eine klare fachliche Position (z.B. die begründete Ablehnung eines bestimmten Plugins), anstatt vage Allgemeinplätze aufzuzählen?
- Verweist der Text auf spezifische Rechtsnormen oder technische Standards?
Können Sie diese Fragen nicht mit Ja beantworten, hat die Seite den Test nicht bestanden.
Um den Test zu bestehen, müssen Sie in jeden Beitrag mindestens einen Bestandteil einbauen, den ein Sprachmodell aus dem Prompt heraus nicht erfinden kann:
- Reale Lasttest-Ergebnisse (z.B. ein k6-Benchmark mit 500 parallelen Warenkörben in WooCommerce).
- Auswertungen eigener Webserver-Logs zum Crawling-Verhalten von Such-Bots.
- Konkrete Fallstudien mit messbaren Verbesserungen der Ladezeiten (LCP).
- Eigene Code-Lösungen für komplexe API-Schnittstellen.
Damit wird Ihre Website zur Primärquelle (Source of Truth), was stabile Rankings und Erwähnungen in AI Overviews sichert. In unseren Projekten zur GEO- und LLMO-Optimierung verankern wir diese semantischen Signale fest im WordPress-System.
Was tun nach starkem Traffic-Verlust durch ein Google-Update?
Wenn Ihre Website oder Ihr Onlineshop nach einem Google-Update massive Traffic-Verluste erlitten hat, ist planloses Löschen von Unterseiten der falsche Weg. Die Wiederherstellung erfordert ein strukturiertes Vorgehen in fünf Phasen:
Phase 1: Leistungsanalyse in der Google Search Console
Vergleichen Sie die Daten der letzten 28 Tage mit dem Zeitraum vor dem Update. Unterteilen Sie Ihre URLs in drei Gruppen:
- Stark betroffene Seiten mit mehr als 70% Verlust bei Klicks und Impressionen.
- Stabile Seiten, die Ihre verbleibende Themenautorität stützen.
- Vollständig deindexierte URLs als Indikator für Spam-Filter.
Identifizieren Sie, welche Templates am stärksten betroffen sind: Waren es automatisierte Städteseiten, generische Blogbeiträge oder importierte Produktbeschreibungen?
Phase 2: Bereinigung themenfremder Inhalte
Wenn früher hunderte Artikel veröffentlicht wurden, die keinen Bezug zu Ihrem eigentlichen Angebot haben, müssen Sie diese Altlasten bereinigen:
- Setzen Sie 301-Weiterleitungen auf thematisch passende Hauptseiten, wenn wertvolle externe Backlinks vorhanden sind.
- Verwenden Sie den HTTP-Header
X-Robots-Tag: noindex, wenn Inhalte für Bestandskunden erreichbar bleiben müssen, aber den Index belasten. - Antworten Sie mit dem Statuscode HTTP 410 Gone bei wertlosen Seiten, damit der Googlebot diese umgehend aus dem Index entfernt.
Phase 3: Überarbeitung umsatzrelevanter Kernseiten
Wählen Sie die wichtigsten 20% der abgestürzten Seiten aus, die früher Kundenanfragen oder Verkäufe generiert haben:
- Entfernen Sie floskelhafte KI-Einleitungen und ersetzen Sie diese durch technische Fakten.
- Fügen Sie eigene Grafiken, Systemdiagramme und verifizierte Produktfotos ein.
- Implementieren Sie Schema.org-Strukturdaten mit Verknüpfung zu offiziellen Wikidata-Entitäten.
- Hinterlegen Sie transparente Autorenprofile mit verifizierbarem beruflichem Hintergrund.
Phase 4: Beseitigung technischer Performance-Schulden
Skalierte Websites leiden häufig unter Performance-Engpässen. Unnötige Datenbankabfragen in WordPress, fehlendes Objekt-Caching und überdimensionierte Skripte verschwenden das Crawling-Budget.
Setzen Sie technische Standards um:
- Aktivieren Sie Redis-Object-Caching für datenbankintensive Abfragen in WooCommerce.
- Konfigurieren Sie Edge-Caching über Cloudflare Workers, um gecachte HTML-Seiten in wenigen Millisekunden auszuliefern.
- Bereinigen Sie die Datei
robots.txt, um das Crawlen nutzloser Filter-URLs zu unterbinden.
Phase 5: Erneute Einreichung und algorithmische Beobachtung
Reichen Sie Ihre aktualisierte XML-Sitemap in der Google Search Console ein. Die Neubewertung einer gesamten Domain erfolgt nicht über Nacht. Google muss überarbeitete Seiten mehrfach crawlen, um nachhaltige Qualitätsverbesserungen zu bestätigen. In der Praxis dauert dieser Erholungsprozess zwischen 4 und 12 Wochen.
| Phase | Maßnahmen | Technisches Ziel |
|---|---|---|
| Woche 1-2 | Search Console Segmentierung, Deindexierung und 410-Status für minderwertige Massenseiten. | Crawl-Budget entlasten, Index bereinigen. |
| Woche 3-6 | Manuelle Überarbeitung zentraler Seiten mit Primärdaten und Schema-Markup. | Seiten tragen eigene Belege, Rankings stabilisieren sich. |
| Woche 7-10 | Core Web Vitals optimieren, Edge-Caching aktivieren, Autorenprofile verifizieren. | E-E-A-T-Signale stärken, Crawl-Frequenz erhöhen. |
| Woche 11-16 | Abschluss der Reindexierung, Rückkehr in AI Overviews und Top-Suchergebnisse. | Dauerhafte Erholung der Kernumsatz-Rankings. |
Google hat die Tür für künstliche Intelligenz nicht verschlossen, aber die Qualitätsanforderungen verschärft. Erfolgreich bleiben jene Unternehmen, die Sprachmodelle als Werkzeug erfahrener Ingenieure nutzen und nicht als Ersatz für fachliche Substanz.