Website- & Anwendungsmigration in Mannheim
Ich migriere Websites von WordPress, Joomla, Drupal, Angular, Vue und anderen Technologien zu Astro und Next.js. Jede Migration plane ich so, dass SEO, Inhalte und Funktionen erhalten bleiben, und schalte in einem vereinbarten Zeitfenster um. Ich arbeite allein und habe langjährige Erfahrung mit älteren und modernen Stacks.
- Mein wordpress.org-Konto besteht seit 2006.
- Ich habe zum WordPress-Core in den Versionen 7.0 und 7.1 beigetragen.
- Ich betreue 30 Plugins auf wordpress.org.
- Ich organisiere WordCamps und trete dort als Speaker auf.
- Ich war bei jedem WordCamp Europe von 2017 bis 2026 dabei.
- Lokales WordPress-Meetup: WordPress Meetup Mannheim
Ein neues Frontend kennt Ihre alten Yoast- oder Rank-Math-Felder nicht. Titel, Meta-Beschreibung, Canonical, Open-Graph-Daten, strukturierte Daten, Sitemap und robots.txt entstehen in Astro und Next.js aus Code und Inhaltsmodell, nicht aus einem Plugin. Was ich nicht übertrage, ist nach dem Go-live weg. Hier steht, wie ich jedes dieser Elemente herüberhole, wie die beiden Frameworks sie erzeugen und was ich vor der Abnahme prüfe.
Welche SEO-Elemente ziehen bei einer Migration um?
Als Wahrheit nehme ich nicht die Plugin-Felder, sondern den gerenderten <head> jeder Seite des Altsystems. Das hat einen Grund: Felder enthalten oft Platzhalter, die erst beim Ausliefern aufgelöst werden. Rank Math dokumentiert dafür eigene Variablen mit Ersetzungsfunktion, und beide Plugins ändern Werte zusätzlich über Filter. Ein Export der Rohfelder liefert dann Text, der so nie in der Suche stand.
| Element | Alter Weg (Yoast, Rank Math) | Neuer Weg in Astro | Neuer Weg in Next.js |
|---|---|---|---|
| Titel und Beschreibung | Plugin-Felder, Filter wpseo_title, wpseo_metadesc bzw. rank_math/frontend/title, rank_math/frontend/description | Props im Layout, ausgegeben als <title> und <meta name="description"> | metadata oder generateMetadata, mit title.template |
| Canonical | Filter wpseo_canonical, rank_math/frontend/canonical | new URL(Astro.url.pathname, Astro.site) im Layout | alternates.canonical plus metadataBase |
| robots-Meta | Filter wpseo_robots, rank_math/frontend/robots | Meta-Tag im Layout, pro Seite steuerbar | robots-Feld in den Metadaten |
| Open Graph | Presenter und Filter wie wpseo_opengraph_title, rank_math/opengraph/url | Meta-Tags mit absoluter Bild-URL | openGraph-Feld oder Bilddateien nach Konvention |
| Strukturierte Daten | Schema-Ausgabe der Plugins | JSON-LD im Layout, aus Frontmatter gefüllt | script-Element mit JSON-LD in Layout oder Seite |
| XML-Sitemap | Plugin-Sitemap mit Ausschluss-Filtern | @astrojs/sitemap | sitemap.ts |
| robots.txt | Plugin oder statische Datei | public/robots.txt oder robots.txt.ts | robots.ts |
| Bild-Alt-Texte | Mediathek, pro Bild | Pflichtfeld im Inhaltsmodell | Pflichtfeld im Inhaltsmodell |
Die Plugin-Spalte stützt sich auf die Metadata-API der Yoast-Entwicklerdokumentation und die Filterliste von Rank Math.
Titel und Meta-Beschreibungen: übernehmen, nicht neu erfinden
Google nennt für beide Elemente keine feste Längengrenze: Ein <title> darf beliebig lang sein, wird aber in den Ergebnissen gekürzt, meist passend zur Gerätebreite. Bei der Meta-Beschreibung ist es genauso. Google nutzt sie nur manchmal als Snippet, nämlich wenn sie die Seite besser beschreibt als der sichtbare Text. Deshalb ändere ich bei der Migration keine Titel aus Prinzip. Seiten, die heute gut ranken, behalten ihren Wortlaut. Neu schreibe ich nur Titel, die heute vage oder doppelt sind.
In Astro reicht ein Layout, das title und description als Props nimmt und in den <head> schreibt. So zeigt es auch die Layout-Dokumentation. In Next.js liegt beides in der Metadata API. Ein title.template im Root-Layout hängt den Firmennamen an, aber nur für untergeordnete Segmente: Ein Template in derselben layout.js greift nicht für einen Titel in der page.js desselben Segments. Wer das übersieht, bekommt Titel ohne Suffix oder mit doppeltem. Wenn generateMetadata Daten holt, die auch die Seite braucht, werden fetch-Aufrufe dank Memoization nicht doppelt ausgeführt.
Ein zweiter Punkt für Next.js: Lässt sich die Seite vorab rendern, steht der Titel im ersten HTML. Sonst können die Metadaten nach dem ersten UI nachgeliefert werden. Ich prüfe darum im ausgelieferten HTML, nicht im Browser-Inspektor, ob Titel, Beschreibung und Canonical wirklich enthalten sind.
Canonical-Tags: eine Aussage pro Seite
Google empfiehlt eine selbstreferenzierende Canonical-Angabe auf der kanonischen Seite selbst. Dieselbe URL darf nicht in der Sitemap anders stehen als im Canonical, und robots.txt ist kein Mittel, um Duplikate zu steuern: Google kann gesperrte URLs ohne Inhalt trotzdem indexieren. Gegen die Auswahl einer kanonischen Seite im eigenen Auftritt rät Google auch von noindex ab, weil es die Seite ganz aus der Suche nimmt.
So sieht das aus, wenn ich es in Astro und Next.js baue:
---
const canonicalURL = new URL(Astro.url.pathname, Astro.site);
---
<link rel="canonical" href={canonicalURL} />
export const metadata = {
metadataBase: new URL('https://www.beispiel-firma.de'),
alternates: { canonical: '/leistungen/' },
}Der Astro-Ausschnitt stammt aus der API-Referenz. Die Next.js-Doku nennt als Besonderheit: Ein relativer Pfad in einem URL-Feld ohne metadataBase führt zu einem Build-Fehler. Das ist unbequem, aber gut, denn ein fehlender Host fällt so beim Bauen auf und nicht erst im Index. In Astro muss dafür site in der astro.config gesetzt sein, die Sitemap-Integration braucht es ohnehin.
XML-Sitemap und robots.txt: Der alte Bestand entscheidet
Eine Sitemap ist laut Google nur ein Hinweis, keine Garantie. Pro Datei sind 50 MB unkomprimiert oder 50.000 URLs erlaubt, die URLs müssen absolut sein, priority und changefreq ignoriert Google. lastmod zählt nur, wenn es nachprüfbar stimmt, zum Beispiel bei einer echten inhaltlichen Änderung, nicht beim Copyright-Jahr. Ein Build, der überall das Build-Datum einträgt, entwertet das Feld. Ich lese lastmod deshalb aus dem Inhalt, nicht aus der Build-Zeit.
Astro. @astrojs/sitemap (die Dokumentation zeigt Stand November 2026 Version 3.7.4) legt sitemap-index.xml und sitemap-0.xml an. Dazu braucht es die Option site. Mit filter() und serialize() schließe ich Seiten aus, i18n ergänzt hreflang-Verweise, und customSitemaps bindet fremde Sitemaps ein, wenn etwa ein Shop unter derselben Domain läuft. Wichtig: Für dynamische Routen im SSR-Modus erzeugt die Integration keine Einträge. Läuft Ihre Astro-Seite serverseitig, plane ich die Sitemap deshalb gesondert.
Next.js. Eine Datei sitemap.ts gibt ein Array von MetadataRoute.Sitemap zurück, optional mit alternates.languages für Sprachversionen und images. Die Datei ist ein Route Handler und wird standardmäßig gecacht, solange sie keine Request-Time-API nutzt.
robots.txt. Google weist darauf hin, dass eine gesperrte Seite trotzdem in den Ergebnissen erscheinen kann, dann ohne Beschreibung, und dass blockierte Ressourcen die Seite für den Crawler schwerer verständlich machen. Zum Ausblenden eignet sich noindex oder ein Passwortschutz. Astro liefert die Datei aus public/ oder über src/pages/robots.txt.ts, bei Next.js erzeugt robots.ts sie.
Auf der Staging-Seite reicht robots.txt nicht. Dort liegen oft echte Formulareinträge oder Kundendaten, und das ist in Mannheim eine Frage für den Landesbeauftragten für den Datenschutz und die Informationsfreiheit Baden-Württemberg: Nach § 40 Abs. 1 BDSG überwachen die nach Landesrecht zuständigen Behörden die Datenschutzvorschriften bei nichtöffentlichen Stellen. Mein Standard ist deshalb Passwortschutz, ohne echte Kundendaten, und noindex als zweite Sicherung.
Strukturierte Daten: Plugin-Graph in typisierte Felder übersetzen
Google empfiehlt JSON-LD für strukturierte Daten und liest es auch, wenn JavaScript es nachträglich einfügt. Die Plugins erzeugen daraus einen Graphen aus Organisation, Website, Seite und Artikel. Den baue ich im neuen Frontend nach: Pro Seitentyp gibt es eine Vorlage, die ihre Werte aus dem Inhaltsmodell zieht.
Die Next.js-Dokumentation empfiehlt ein script-Element im Layout oder auf der Seite. Sie warnt zugleich, dass JSON.stringify HTML-Zeichen nicht bereinigt, und schlägt vor, < durch die Escape-Sequenz \u003c zu ersetzen, um XSS zu verhindern. Das übernehme ich in jedes Projekt. Geprüft wird mit dem Rich-Results-Test von Google und mit dem Schema Markup Validator.
Für einen Betrieb mit Ladenlokal in Mannheim gehört zu LocalBusiness laut Googles Beispiel eine address vom Typ PostalAddress. Die Angaben müssen mit dem Impressum übereinstimmen. Eine B2B-Seite ohne Publikumsverkehr braucht diesen Typ nicht, hier genügt Organization.
Open Graph und Alt-Texte
Yoast gibt og:title, og:description, og:image und weitere Tags über eigene Presenter aus, jeweils mit einem Filter. Rank Math hat Filter wie rank_math/opengraph/url. In Next.js füllt das Feld openGraph diese Tags, und metadataBase macht relative Bildpfade absolut. In Astro setze ich die absolute Bild-URL im Layout, wie es die API-Referenz zeigt: new URL('https://img.wppoland.com/images/preview.png', Astro.url). Beim Umzug prüfe ich besonders, ob jede Seite ein eigenes, vorhandenes Bild hat und ob Bild-URLs nicht auf den alten Server zeigen.
Zum Alt-Text sagt Google, er sei das wichtigste Attribut für Bild-Metadaten, helfe Screenreader-Nutzern und gebe zusammen mit dem Seiteninhalt Hinweise auf das Bildthema. Aus der WordPress-Mediathek übernehme ich den Alt-Text pro Bild. Im Inhaltsmodell ist alt ein Pflichtfeld. Mit Content Collections in Astro bricht der Build ab, wenn es fehlt, so verschwinden Bilder nicht unbemerkt ohne Beschreibung.
Was bedeutet das für Mannheimer B2B-Seiten?
Die Wirtschafts- und Strukturförderung der Stadt nennt als regionale Cluster Mannheim Medical Technology, Smart Industries, Green Industry und Social Economy. Wer in solchen Feldern Produkte oder Verfahren beschreibt, hat oft viele Detailseiten mit eigenen Titeln, Datenblättern und Bildern. Genau diese Seiten tragen die Anfragen aus der Suche, und genau bei ihnen schleichen sich Fehler ein: ein Titel-Template, das den Firmennamen doppelt anfügt, ein Canonical auf die Startseite oder Datenblatt-PDFs ohne Weiterleitung.
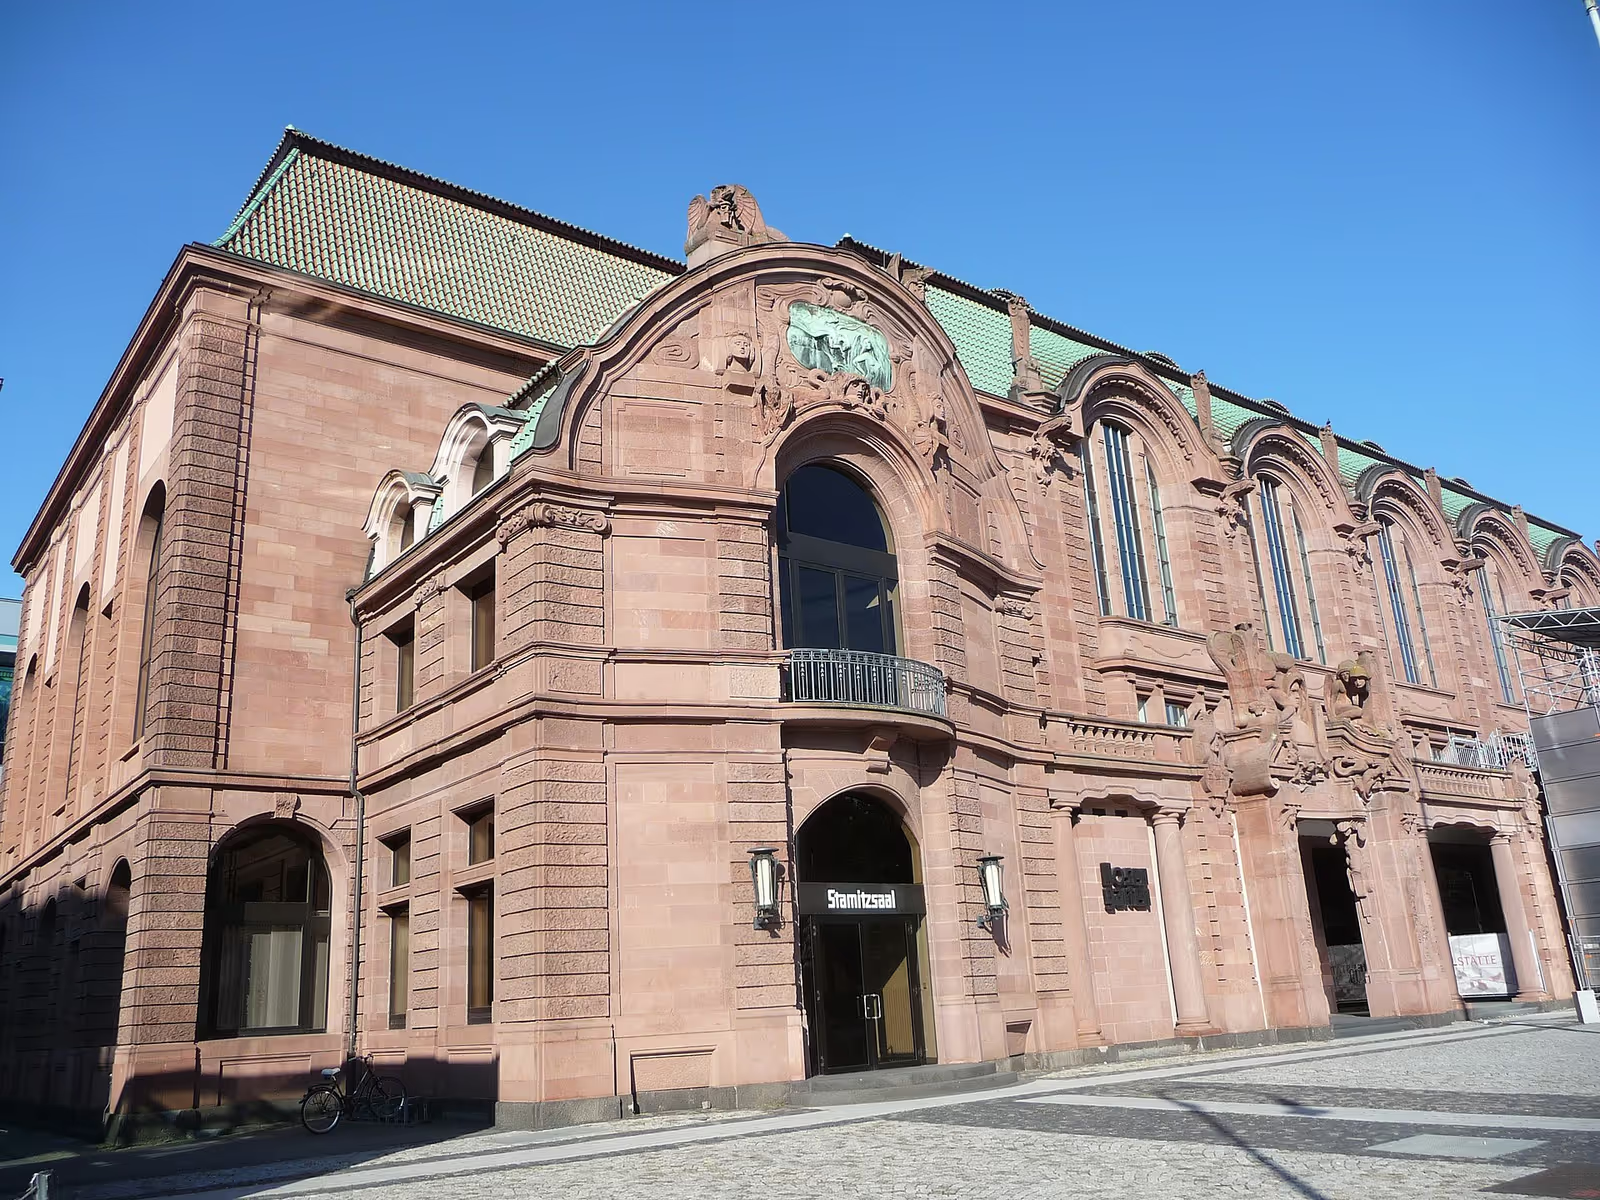
Foto: Immanuel Giel, CC BY-SA 4.0, Wikimedia Commons.
Wie prüfe ich vor dem Go-live, dass nichts fehlt?
- Vergleichs-Crawl. Ich crawle Alt- und Staging-Seite vollständig und vergleiche je URL Statuscode, Titel, Beschreibung, H1, Canonical, robots-Meta und Open-Graph-Tags. Abweichungen gehen in eine Liste, jede ist bewusst oder ein Fehler.
- Strukturierte Daten. Stichprobe je Seitentyp im Rich-Results-Test, Gesamtlauf auf Parsebarkeit.
- Sitemap. Jede URL ist absolut, liefert 200, ist indexierbar und steht in genau einer Sitemap. Keine Staging-Host-Namen, keine weitergeleiteten URLs.
- robots.txt. Sie sperrt nur, was ich sperren will, und verweist auf die neue Sitemap. Das Staging-noindex steht vor dem Go-live nicht mehr im Produktions-Build.
- Bilder. Jedes Bild hat Alt-Text, jede OG-Bild-URL antwortet.
- Nach dem Go-live. Ich reiche die neue Sitemap in der Search Console ein und beobachte Indexierung und Klicks pro URL-Gruppe. Wo etwas einbricht, suche ich zuerst in Canonicals und Weiterleitungen.
Von Ihnen brauche ich dafür Zugang zum Altsystem (Plugin-Einstellungen, Medien), Lesezugriff auf die Search Console und eine Liste der Seiten, die Ihnen geschäftlich am wichtigsten sind. Das Layout liefern Sie, ich setze es um. Fragen und Entscheidungen halte ich schriftlich fest.
Häufige Fragen zur SEO-Übernahme
Übernehmen Astro und Next.js die Felder aus Yoast oder Rank Math automatisch? Nein. Beide erzeugen den <head> aus Code und Inhaltsdaten. Ich lese die Werte aus dem gerenderten Altbestand aus und lege sie in typisierten Feldern ab.
Wie lang dürfen Titel und Meta-Beschreibung sein? Google nennt keine feste Grenze, kürzt aber in den Ergebnissen nach Gerätebreite. Ich behalte bewährte Texte und kürze nichts, nur weil ein Plugin eine Ampel zeigte.
Brauche ich priority und changefreq in der Sitemap? Nein, Google ignoriert beide. Wichtig sind absolute URLs und ein lastmod, das stimmt.
Reicht robots.txt, um die Staging-Seite zu schützen? Nein. Eine gesperrte URL kann trotzdem im Index auftauchen. Ich nutze Passwortschutz und noindex und arbeite ohne echte Kundendaten.
Wer pflegt strukturierte Daten nach dem Umzug? Die Werte stehen im Inhaltsmodell, die Vorlagen pro Seitentyp im Code. Ihre Redaktion ändert Felder, ich ändere nur Vorlagen, wenn sich Google-Vorgaben ändern.
Was passiert mit Bildern und Alt-Texten aus der Mediathek? Sie ziehen mit, jedes Bild behält seinen Alt-Text, und fehlende fallen im Build auf.
Das allgemeine Vorgehen beschreibe ich auf der Seite zur Migration nach Next.js und Astro. Wenn WordPress als Redaktionssystem bleiben soll, finden Sie die Details bei der Headless-CMS-Entwicklung.
Wie bekomme ich einen schriftlichen Umfang für die SEO-Übernahme?
Schicken Sie mir die URL Ihrer Seite, das eingesetzte SEO-Plugin, Ihre wichtigsten Seiten und, falls vorhanden, einen Wunschtermin für den Umzug. Ich prüfe den Bestand und melde mich schriftlich mit einem Umfang, der die oben genannten Punkte enthält. Die erste Einschätzung bekommen Sie kostenlos und in Textform. Nutzen Sie das Kontaktformular, ich antworte an Werktagen per E-Mail.
Ausgewählte Projekte
Beispiele aus meiner Arbeit.
E-Commerce-Entwicklung: rezydencjapark.pl
Rezydencja Park Mielno ist ein Ensemble exklusiver Apartments am Meer, konzipiert, um Harmonie mit der umgebenden Natur und eine familiäre Atmosphäre zu biet...
E-Commerce-Entwicklung: sztuczne-rosliny.pl
Der Online-Shop sztuczne-rosliny.pl ist eine moderne E-Commerce-Plattform, die ein Unternehmen repräsentiert, das sich auf den Import und Vertrieb von künstl...
E-Commerce-Entwicklung: zafriko.pl
Zafriko.pl ist ein fortschrittliches Projekt in meinem Portfolio als WordPress-Entwickler, das ich im Rahmen der Entwicklung einer modernen Social- und Enter...
WordPress Support & Entwicklung in Mannheim
Brauchen Sie die Leistung: Migration zu Next.js / Astro in Mannheim?
Beschreiben Sie Ihr Projekt per E-Mail. Antwort innerhalb von 48 Stunden.
Projekt beschreibenWeitere WordPress-Dienste und Wissensbasis entdecken
Migration zu Astro, Next.js und Headless WordPress.
WooCommerce-Synchronisierung mit ERP und Großhandel.
Geschäftsprozessautomatisierung rund um WordPress und Firmensysteme.
Bibliothek konkreter Automatisierungsfälle.
Headless WordPress, Sanity, Strapi und Contentful mit Astro oder Next.js.
Astro, MDX, Edge Delivery und an echtem Traffic gemessene Core Web Vitals.
Individuelle WordPress-Entwicklung und Architektur.
Skalierbare Headless-, ERP- und KI-Architektur für Enterprise.
Verwandte Kategorien
Unterstützende Artikel

Sechs bis sechzehn Wochen für typische Projekte, in vier Phasen: Analyse, Scoping, Build und Umstellung, Tuning. Die Variablen sind Katalogumfang, Anzahl der Integrationen, URL-Erhalt und die Bereitschaft des Redaktionsteams, nicht die Wahl des Frameworks.

Umfassende 4-Jahres-TCO-Analyse (Total Cost of Ownership), reale Core-Web-Vitals-Benchmarks, Astro 7 GraphQL APQ-Architektur und eine 10-Punkte-Entscheidungsmatrix für Enterprise-Entscheider zwischen entkoppeltem und traditionellem WordPress.

Die Entscheidung Shopify Plus vs WooCommerce headless im Jahr 2026 ist kein binärer "Plattform vs Custom"-Kompromiss mehr. Beide laufen headless, beide integrieren KI, beide liefern am Edge aus. Die echten Achsen sind Kontrolle, Gesamtkosten über fünf Jahre und Exit-Strategie. Dieser Artikel durchläuft die Entscheidungsmatrix mit bestätigten Plattformfakten.