Mein Platz in der WordPress-Community
- Mein wordpress.org-Konto besteht seit 2006.
- Ich habe zum WordPress-Core in den Versionen 7.0 und 7.1 beigetragen.
- Ich betreue 30 Plugins auf wordpress.org.
- Ich organisiere WordCamps und trete dort als Speaker auf.
- Ich war bei jedem WordCamp Europe von 2017 bis 2026 dabei.
- Lokales WordPress-Meetup: WordPress Meetup Köln
Next.js für Kölner Unternehmen: erst die Technik, die Google sieht
Eine Next.js-Seite kann schnell und gut gebaut sein und trotzdem in Suchergebnissen schwach auftreten. Meist liegt es an Kleinigkeiten: ein Canonical, das auf die falsche Adresse zeigt, eine Sitemap mit Seiten, die es nicht mehr gibt, ein Inhalt, der erst nach dem Laden von JavaScript im Dokument steht. Diese Seite beschreibt, wie ich das im App Router von Next.js einrichte und prüfe.
Ich bin Mariusz Szatkowski, ein Einzelentwickler aus Gdynia in Polen, und arbeite seit 2006 mit WordPress. Ich arbeite ausschließlich remote und schriftlich. Layouts, Mockups und Wireframes bringen Sie mit, ich setze sie um. Den Stand der Technik nehme ich aus der Dokumentation: Laut npm-Registry ist Next.js 16.4.6 die aktuelle stabile Version, veröffentlicht am 9. November 2026. Alle Beispiele auf dieser Seite folgen den Docs auf nextjs.org für diesen Zweig.
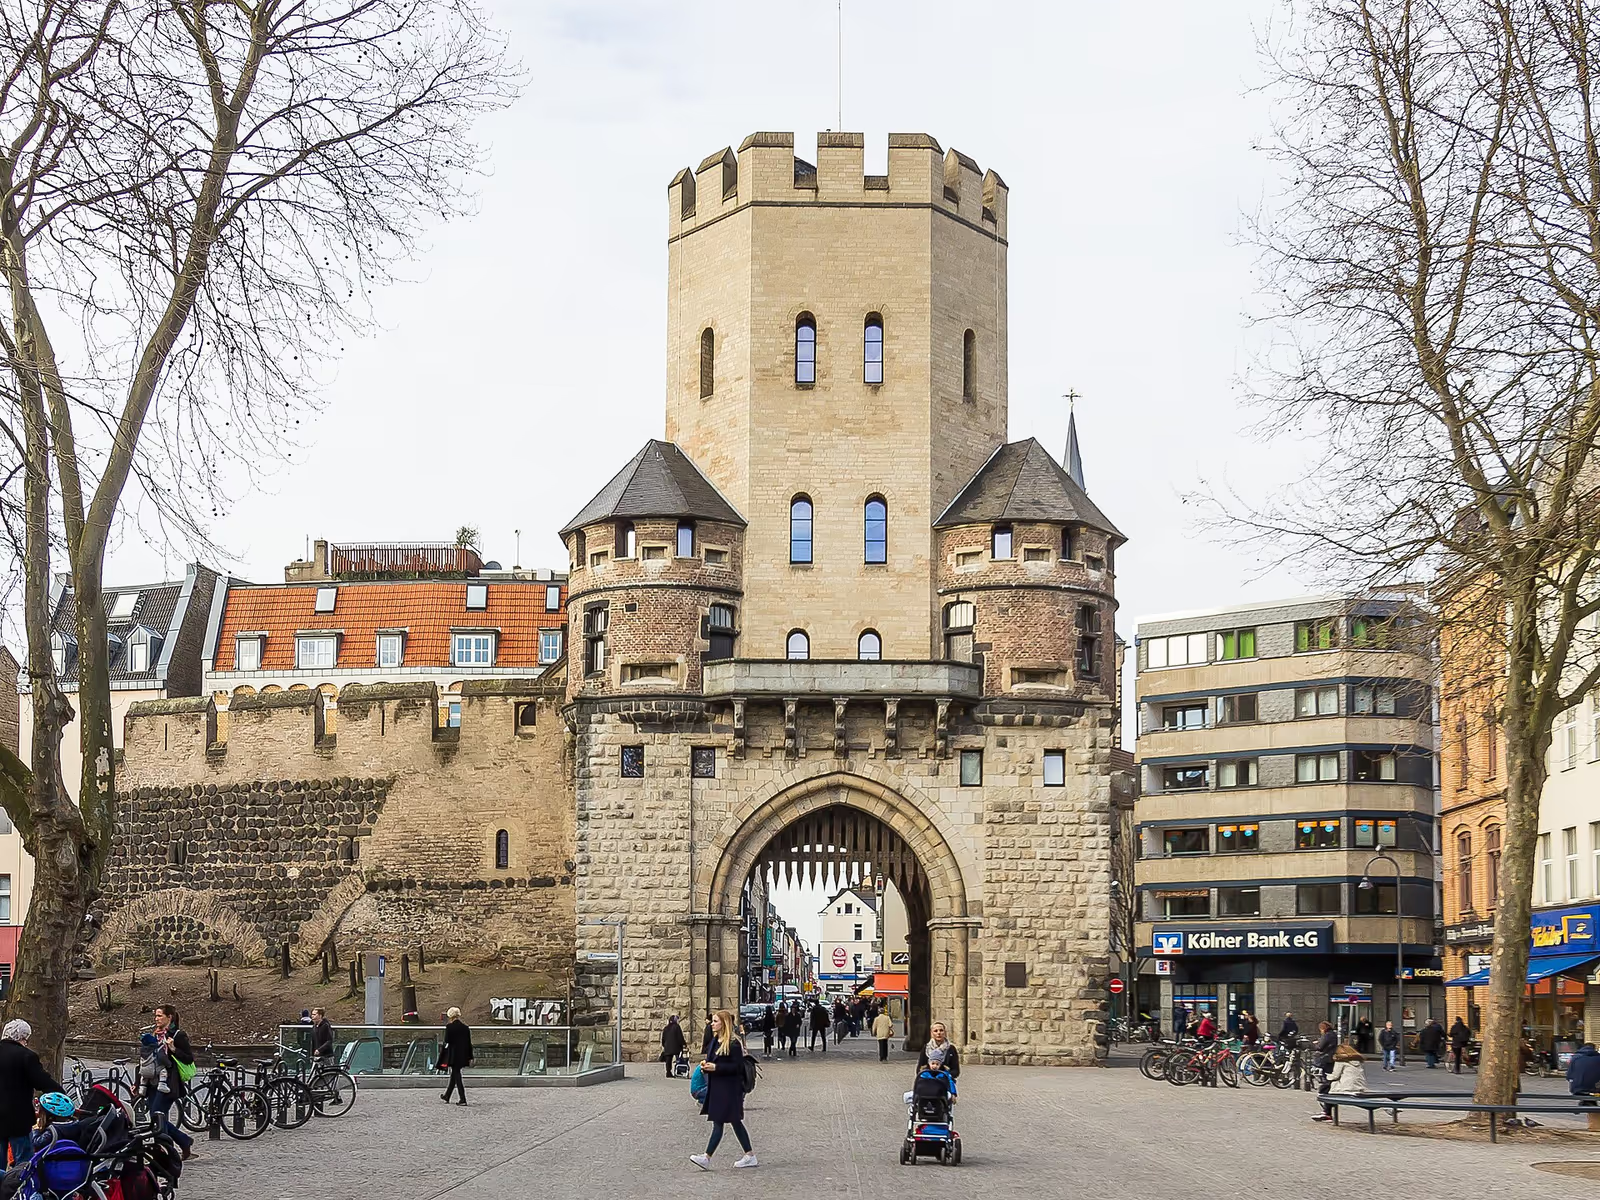
Foto: Raimond Spekking, CC BY-SA 4.0, Wikimedia Commons.
Was die Next.js-Dokumentation für SEO vorsieht
Laut der Anleitung zu Metadaten und OG-Bildern erzeugt Next.js die passenden <head>-Tags aus drei Quellen: einem statischen metadata-Objekt, einer Funktion generateMetadata und Dateikonventionen wie opengraph-image, robots und sitemap. Das metadata-Objekt und generateMetadata gibt es nur in Server Components.
| Aufgabe | Mittel im App Router |
|---|---|
| Titel, Beschreibung, robots-Angabe | metadata oder generateMetadata |
| Canonical und hreflang | alternates in den Metadaten |
| Vorschaubild beim Teilen | opengraph-image als Datei oder Code |
| Sitemap | app/sitemap.ts |
| robots.txt | app/robots.ts |
| Strukturierte Daten | JSON-LD-Script im Layout oder in der Seite |
| Nicht vorhandene Seite | notFound() |
Die folgenden Abschnitte gehen die Zeilen der Tabelle durch.
Titel, Beschreibung und Canonical mit generateMetadata
Für Seiten, deren Inhalt aus einem CMS oder einer Datenbank kommt, nutze ich generateMetadata. In den Docs stehen dafür zwei Regeln. Erstens sind params laut Docs ein Promise, man wartet also mit await darauf. Zweitens gilt: Wenn Metadaten und Seite dieselben Daten brauchen, merkt man sich die Abfrage mit Reacts cache, damit sie nur einmal läuft.
// app/lib/data.ts
import { cache } from 'react'

export const getPost = cache(async (slug: string) => {
  // Abfrage an CMS oder Datenbank
})
// app/blog/[slug]/page.tsx
import type { Metadata } from 'next'
import { notFound } from 'next/navigation'
import { getPost } from '@/app/lib/data'
export async function generateMetadata(
{ params }: { params: Promise<{ slug: string }> }
): Promise<Metadata> {
const { slug } = await params
const post = await getPost(slug)
if (!post) notFound()
return {
title: post.title,
description: post.description,
alternates: { canonical: `/blog/${slug}` },
}
}Das relative Canonical funktioniert, weil im Root-Layout metadataBase gesetzt ist. Laut Docs wird der relative Pfad mit metadataBase zu einer vollständigen URL zusammengesetzt, und ein relatives Feld ohne metadataBase führt zu einem Build-Fehler. Das ist ein brauchbarer Schutz: Der Build bricht ab, statt eine Seite ohne gültiges Canonical auszuliefern.
// app/layout.tsx
export const metadata = {
  metadataBase: new URL('https://www.beispiel-firma.de'),
}
Warum ich Canonicals so ernst nehme: Laut Google Search Central gehört rel="canonical" neben Weiterleitungen zu den starken Signalen, die Aufnahme in die Sitemap ist nur ein schwaches. Google empfiehlt absolute statt relativer Pfade im Canonical-Link und weist darauf hin, dass das Element nur im <head> akzeptiert wird. Wer Canonicals per JavaScript setzt, darf sie nicht auf einen anderen Wert ändern als den im ursprünglichen HTML. Mit alternates.canonical steht der Wert im Server-HTML und nicht erst nach dem Laden von Skripten.
Ein Punkt, der in der Praxis oft Duplikate erzeugt, ist der Schrägstrich am Ende. Laut Docs leitet Next.js standardmäßig /about/ auf /about um, und mit trailingSlash: true gilt es umgekehrt. Das Canonical muss zu der Variante passen, die der Server tatsächlich ausliefert.
Sitemap mit sitemap.ts
Die Datei app/sitemap.ts gibt ein Array von Adressen zurück, aus dem Next.js sitemap.xml erzeugt. Das Beispiel in den Docs enthält priority und changefreq. Laut Google Search Central ignoriert Google beide Werte. lastmod nutzt Google nur, wenn es durchgängig und überprüfbar stimmt. Ich lasse deshalb die beiden Felder weg und setze lastModified aus dem echten Änderungsdatum im CMS.
// app/sitemap.ts
import type { MetadataRoute } from 'next'
import { getAllPosts } from '@/app/lib/data'

export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  const posts = await getAllPosts()
  return posts.map((post) => ({
    url: `https://www.beispiel-firma.de/blog/${post.slug}`,
    lastModified: post.updatedAt,
  }))
}
Zwei Hinweise aus den Docs und von Google. Erstens ist sitemap.ts ein spezieller Route Handler und wird standardmäßig zwischengespeichert, solange er keine Request-Time-API nutzt. Zweitens gilt pro Sitemap ein Limit von 50 MB unkomprimiert oder 50.000 URLs. Bei größeren Katalogen teilt generateSitemaps die Datei auf. Seit Next.js 16 bekommt die Sitemap-Funktion die id als Promise, die zu einem String aufgelöst wird.
Sitemaps verweisen auf Adressen mit Status 200, die Sie indexiert haben wollen. Seiten mit noindex, Weiterleitungsziele ohne Inhalt und Duplikate gehören nicht hinein.
robots.ts ist kein Schalter für den Index
Mit app/robots.ts gibt Next.js eine robots.txt aus. Dort trage ich auch die Sitemap ein.
// app/robots.ts
import type { MetadataRoute } from 'next'

export default function robots(): MetadataRoute.Robots {
  return {
    rules: { userAgent: '*', allow: '/', disallow: '/interner-bereich/' },
    sitemap: 'https://www.beispiel-firma.de/sitemap.xml',
  }
}
Gleichzeitig ist robots.txt das Werkzeug, das am häufigsten falsch eingesetzt wird. Google schreibt in der Einführung zu robots.txt, die Datei diene vor allem dazu, Crawler-Traffic zu steuern, und sei kein Mechanismus, um eine Seite aus Google herauszuhalten. Eine gesperrte Seite kann ohne Beschreibung trotzdem in den Ergebnissen auftauchen, wenn andere Seiten darauf verlinken. Zum Ausschließen verweist Google auf noindex oder Passwortschutz.
Das hat eine Folge für Staging-Umgebungen. Eine Testumgebung nur mit Disallow: / zu schützen, reicht nicht. Ich setze dort Passwortschutz, und die Adressen der Testumgebung stehen in keiner Sitemap.
Außerdem warnt Google, Skript-, Bild- und Stildateien nicht zu sperren, wenn die Seite ohne sie schwerer zu verstehen ist. Für Next.js heißt das: /_next/static/ bleibt für Crawler erreichbar.
Server-Rendering: Was im ersten HTML steht, zählt
Hier liegt der häufigste Fehler bei Next.js-Seiten, die aus einer React-Single-Page-App umgebaut wurden. Laut Google Search Central läuft die Verarbeitung in drei Phasen: Crawling, Rendering, Indexierung. Alle Seiten mit Status 200 kommen in die Rendering-Warteschlange. Dort kann eine Seite laut Google wenige Sekunden bleiben, aber auch länger. Danach rendert ein headless Chromium das JavaScript. Google nennt außerdem den Satz, dass serverseitiges Rendern oder Prerendering weiterhin eine gute Idee sei, weil es Nutzer und Crawler beschleunige und nicht alle Bots JavaScript ausführen.
Im App Router sind Komponenten standardmäßig Server Components, ihr Ergebnis steht im HTML. Schwierig wird es, wenn ein Client Component den Hauptinhalt erst per useEffect und fetch im Browser lädt. Dann liegt in der ersten Antwort nur ein leerer Rahmen, und Bots ohne JavaScript sehen nichts. Mein Prüfschritt ist banal:
curl -s https://www.beispiel-firma.de/leistungen/ | grep -i "<h1"Steht die Überschrift der Seite in der Ausgabe, ist der Inhalt im ersten HTML. Fehlt sie, gehört der Datenabruf in eine Server Component oder in generateStaticParams mit Prerendering.
Zwei weitere Punkte aus der Google-Seite betreffen Next.js direkt:
- Echte Statuscodes. Eine gelöschte Seite muss mit 404 antworten, nicht mit 200 und einer Fehlermeldung im Text. Laut den Docs wirft
notFound()einen 404 und fügt einnoindex-Tag ein, damit die Seite nicht indexiert wird. - Echte Links. Google entdeckt Links nur als
<a>-Elemente mithref. Fragmente wie#/produktefür das Routing sind laut Google unzuverlässig. Die KomponenteLinkvon Next.js erzeugt<a href>und erfüllt das.
Zur Streaming-Metadaten-Funktion schreiben die Docs: Bei dynamisch gerenderten Seiten werden Metadaten nachgeliefert, ohne die Oberfläche zu blockieren. Für Bots, die Metadaten im <head> erwarten, ist das abgeschaltet. Die Standardliste umfasst laut Docs unter anderem Bingbot, Twitterbot und Slackbot und lässt sich über htmlLimitedBots ändern (seit Version 15.2.0). Vorgerenderte Seiten nutzen kein Streaming, weil die Metadaten schon beim Build feststehen. Das ist ein Argument für statisch erzeugte Seiten, wo der Inhalt es erlaubt.
Open-Graph-Bilder für geteilte Links
Wenn jemand Ihre Adresse in Slack, LinkedIn oder einem Messenger teilt, entscheidet das Open-Graph-Bild, wie die Vorschau aussieht. Next.js bietet zwei Wege. Wer ein fertiges Bild hat, legt opengraph-image.jpg in den Ordner der Route, und Next.js erzeugt die Tags og:image, og:image:type, og:image:width und og:image:height. Daneben kann opengraph-image.alt.txt den Alternativtext liefern. Laut Docs darf die Datei für Open Graph höchstens 8 MB groß sein, sonst bricht der Build ab.
Für Seiten mit vielen Varianten (Produkte, Beiträge, Standorte) erzeugt eine Datei opengraph-image.tsx das Bild per Code mit ImageResponse aus next/og. Laut Docs werden generierte Bilder zum Build-Zeitpunkt erzeugt und zwischengespeichert, solange sie keine Request-Time-API oder ungecachte Daten nutzen. Die Gestaltung des Bildes, also Schrift, Farben und Logo, liefern Sie, ich setze sie in die Vorlage um.
Strukturierte Daten mit JSON-LD
Die Next.js-Anleitung zu JSON-LD empfiehlt, die Daten als <script>-Tag im Layout oder in der Seite auszugeben. Sie weist auf ein Sicherheitsproblem hin: JSON.stringify bereinigt keine bösartigen Zeichenketten. Als Gegenmaßnahme ersetzt man < durch <.
// app/leistungen/[slug]/page.tsx
const jsonLd = {
  '@context': 'https://schema.org',
  '@type': 'Service',
  name: service.name,
  description: service.description,
}

return (
  <section>
    <script
      type="application/ld+json"
      dangerouslySetInnerHTML={{
        __html: JSON.stringify(jsonLd).replace(/</g, '\\u003c'),
      }}
    />
    {/* Inhalt der Seite */}
  </section>
)
Ein natives <script> ist hier richtig, nicht next/script: Die Docs begründen das damit, dass JSON-LD strukturierte Daten und kein ausführbarer Code seien. Zum Prüfen nennen sie den Rich Results Test von Google und den Schema Markup Validator. Typen lassen sich mit dem Community-Paket schema-dts absichern.
Google stellt in den Richtlinien für strukturierte Daten Bedingungen. Markiert werden darf nur, was Besucher auf der Seite sehen. Inhalte, die für Nutzer verborgen sind, dürfen nicht ausgezeichnet werden, und irrelevante oder irreführende Inhalte wie gefälschte Bewertungen ebenso wenig. Wenn Ihr CMS ein Feld für Sterne-Bewertungen hat, das auf der Seite nirgends sichtbar ist, bleibt es aus dem JSON-LD heraus.
Köln: Messetermine als Takt für Landingpages
Die Koelnmesse nennt auf ihrer Startseite für die DMEXCO 2026 mehr als 40.000 Teilnehmende und mehr als 700 Partner, darunter 100 Agenturen. Die ORGATEC fand dort vom 27. bis 30. Oktober 2026 mit 550 ausstellenden Unternehmen aus 39 Ländern statt, und die Imaging World zieht ab 2027 nach Köln, erste Ausgabe vom 24. bis 26. September 2027.
Für die Technik folgt daraus nur eine Beobachtung: Firmen in Köln, die für eine Messe eine eigene Seite pflegen, haben ein festes Zeitfenster, in dem Suchende diese Seite brauchen. Für solche Seiten ist es wichtig, dass die Adresse stabil bleibt und das Canonical nicht jährlich wechselt, sondern jedes Jahr dieselbe Seite aktualisiert wird. Das lastModified in der Sitemap sollte nach der Aktualisierung des Inhalts springen, nicht nach einem Deployment.
Datenschutz und Hosting in Nordrhein-Westfalen
Zuständige Aufsichtsbehörde für Unternehmen in NRW ist die Landesbeauftragte für Datenschutz und Informationsfreiheit, kurz LDI NRW. Ihre Seite zum Angemessenheitsbeschluss betrifft Next.js-Projekte, weil viele Auslieferungsplattformen in den USA sitzen.
Laut LDI NRW hat die EU-Kommission am 10. Juli 2023 den Angemessenheitsbeschluss für das EU-U.S. Data Privacy Framework angenommen. Er gilt nur für US-Unternehmen, die unter dem Framework zertifiziert sind. Verantwortliche und Auftragsverarbeiter müssen vorab prüfen, ob der Empfänger zertifiziert ist. Eine Liste dazu veröffentlicht das US-Handelsministerium. Die Seite weist außerdem darauf hin, dass kein generelles angemessenes Schutzniveau für Übermittlungen an US-Unternehmen festgestellt wurde.
Für die Praxis halte ich fest, wo Ihre Seite ausgeliefert wird und welche Anbieter Zugriffsdaten erhalten, und lege das in einer Liste ab, die Ihre Datenschutzberatung bewerten kann. Ob eine Plattform in Ihrem Fall zulässig ist, beurteile ich nicht. Ein Hosting in der EU oder ein selbst betriebener Node-Server ist eine Alternative, die ich einrichte, wenn Sie das wünschen.
Prüfliste für Ihre Next.js-Seite
Diese Punkte können Sie ohne mich abarbeiten:
- Steht die H1 der wichtigsten Seiten in der Ausgabe von
curl? - Ist
metadataBaseim Root-Layout gesetzt und zeigt das Canonical auf die Adresse, die der Server wirklich ausliefert? - Passt
trailingSlashzu den Adressen in Sitemap und Canonical? - Enthält die Sitemap nur Seiten mit Status 200, die indexiert werden sollen?
- Ist
lastModifiedein echtes Änderungsdatum? - Antwortet eine gelöschte Seite mit 404?
- Ist
/_next/static/in der robots.txt nicht gesperrt? - Ist die Staging-Umgebung per Passwort geschützt?
- Stimmt jede Angabe im JSON-LD mit dem sichtbaren Text überein?
- Wissen Sie, welche Anbieter Besucherdaten erhalten?
So läuft ein Projekt
- Anfrage. Sie schreiben mir über das Kontaktformular, welche Seite betroffen ist.
- Befund. Ich lese das HTML der wichtigsten Seiten, stelle Rückfragen und schicke Ihnen eine erste Einschätzung. Sie ist kostenlos.
- Umfang. Ich halte Aufgaben, Annahmen und Ausschlüsse schriftlich fest. Jede Erweiterung wird separat angeboten und beginnt erst nach Ihrer schriftlichen Bestätigung.
- Testumgebung. Änderungen sehen Sie zuerst dort und prüfen sie selbst.
- Freigabe. Sie geben anhand einer Liste frei, die vorab schriftlich feststeht.
- Betrieb. Auf Wunsch folgt laufende Pflege, siehe Wartung und Support Köln.
Soll eine bestehende Seite erst auf Next.js oder Astro umziehen, beschreibt Migration zu Astro und Next.js in Köln den Ablauf. Liegt Ihr Inhalt in WordPress, hilft die Seite WordPress-Entwickler Köln.
Was ich von Ihnen brauche
- Die Adresse der Seite oder Lesezugriff auf das Repository.
- Eine Testumgebung oder Ihr Einverständnis, dass ich eine aufsetze.
- Die Search-Console-Daten der Domain, falls vorhanden.
- Eine Ansprechperson, die Freigaben schriftlich erteilt.
- Layout, Bilder und Texte, soweit sie sich ändern sollen.
Häufige Fragen
Reicht die Metadata API von Next.js für technisches SEO aus?
Sie deckt Titel, Beschreibung, Canonical, hreflang, robots-Angaben und Open-Graph-Daten ab. Sitemap und robots.txt kommen über sitemap.ts und robots.ts, strukturierte Daten über ein JSON-LD-Script. Ob eine Seite ranken kann, entscheiden danach Inhalt, interne Links und Statuscodes.
Sieht Google den Inhalt meiner Next.js-Seite, wenn er per JavaScript nachgeladen wird?
Laut Google Search Central rendert Googlebot Seiten mit Status 200 mit einem headless Chromium, es kann aber länger dauern, und nicht alle Bots führen JavaScript aus. Wichtige Inhalte gehören deshalb in die erste HTML-Antwort. Ob das der Fall ist, prüfe ich mit curl auf Ihrer Seite.
Soll ich robots.txt nutzen, um Seiten aus Google herauszuhalten?
Nein. Google schreibt, robots.txt sei dafür kein Mechanismus. Eine gesperrte Adresse kann ohne Beschreibung trotzdem in den Ergebnissen erscheinen. Für den Ausschluss braucht es noindex oder einen Passwortschutz.
Welche Rolle spielt priority in der sitemap.ts?
Keine für Google. Laut Google Search Central werden priority und changefreq ignoriert, lastmod nur dann genutzt, wenn der Wert durchgängig und überprüfbar stimmt. Ich setze lastmod aus dem Änderungsdatum im CMS und lasse die anderen Felder weg.
Darf ich Next.js auf Vercel betreiben, wenn ich in Nordrhein-Westfalen sitze?
Das ist eine Frage der Datenübermittlung. Laut LDI NRW gilt der Angemessenheitsbeschluss für die USA nur für Unternehmen, die unter dem Data Privacy Framework zertifiziert sind, und der Verantwortliche muss das vorab prüfen. Die Bewertung Ihres Falls gehört zu Ihrer Datenschutzberatung.
Was muss ich von Ihrer Seite kennen, um sie einzuschätzen?
Die Adresse der Seite, das Ziel, eine Frist und den heutigen Stack. Für eine Einschätzung brauche ich keine Zugänge. Ich schreibe Ihnen, was ich im HTML finde, und was ich danach vorschlage.
Weitere Leistungen für Köln
- PHP-Entwickler Köln für Backends und Schnittstellen
- Astro-Entwickler Köln für inhaltsgetriebene Seiten mit wenig JavaScript
- Shopify-Entwickler Köln für Shops auf gehostetem Shopsystem
Schreiben Sie mir
Betreiben Sie in Köln eine Next.js-Seite, die in der Suche hinter ihren Möglichkeiten bleibt, oder planen Sie eine neue? Schicken Sie mir über das Kontaktformular die Adresse der Seite, das Ziel, Ihre Frist und den heutigen Stack. Ich lese das HTML, antworte schriftlich mit Rückfragen und schicke danach eine erste Einschätzung. Die ist kostenlos.
Ausgewählte Projekte
Beispiele aus meiner Arbeit.
Tech Platform: sportostroda.pl
Sportostroda.pl ist eines der interessanten Projekte in meinem Portfolio als WordPress-Entwickler. Es wurde als lokales Sportportal realisiert, das sich an d...
Tech Platform: strefapremium.pl
Die Website strefapremium.pl wurde als modernes Premium-Portal entworfen, das sich an Nutzer richtet, die exklusive Inhalte und Dienstleistungen suchen. Die ...
Tech Platform: VECTOR SOLUTIONS
Vector Solutions ist ein in Polen und ganz Europa als Pionier der Technologiebranche anerkannter Anbieter, der das Bild moderner Kommunikation verändert. Das...
WordPress Support & Entwicklung in Köln
Brauchen Sie die Leistung: Next.js-Entwickler in Köln?
Beschreiben Sie Ihr Projekt per E-Mail. Antwort innerhalb von 48 Stunden.
Projekt beschreibenWeitere WordPress-Dienste und Wissensbasis entdecken
Migration zu Astro, Next.js und Headless WordPress.
WooCommerce-Synchronisierung mit ERP und Großhandel.
Geschäftsprozessautomatisierung rund um WordPress und Firmensysteme.
Bibliothek konkreter Automatisierungsfälle.
Headless WordPress, Sanity, Strapi und Contentful mit Astro oder Next.js.
Astro, MDX, Edge Delivery und an echtem Traffic gemessene Core Web Vitals.
Individuelle WordPress-Entwicklung und Architektur.
Skalierbare Headless-, ERP- und KI-Architektur für Enterprise.
Verwandte Kategorien
Unterstützende Artikel

Sechs bis sechzehn Wochen für typische Projekte, in vier Phasen: Analyse, Scoping, Build und Umstellung, Tuning. Die Variablen sind Katalogumfang, Anzahl der Integrationen, URL-Erhalt und die Bereitschaft des Redaktionsteams, nicht die Wahl des Frameworks.

Umfassende 4-Jahres-TCO-Analyse (Total Cost of Ownership), reale Core-Web-Vitals-Benchmarks, Astro 7 GraphQL APQ-Architektur und eine 10-Punkte-Entscheidungsmatrix für Enterprise-Entscheider zwischen entkoppeltem und traditionellem WordPress.

Die Entscheidung Shopify Plus vs WooCommerce headless im Jahr 2026 ist kein binärer "Plattform vs Custom"-Kompromiss mehr. Beide laufen headless, beide integrieren KI, beide liefern am Edge aus. Die echten Achsen sind Kontrolle, Gesamtkosten über fünf Jahre und Exit-Strategie. Dieser Artikel durchläuft die Entscheidungsmatrix mit bestätigten Plattformfakten.