Mein Platz in der WordPress-Community
- Mein wordpress.org-Konto besteht seit 2006.
- Ich habe zum WordPress-Core in den Versionen 7.0 und 7.1 beigetragen.
- Ich betreue 30 Plugins auf wordpress.org.
- Ich organisiere WordCamps und trete dort als Speaker auf.
- Ich war bei jedem WordCamp Europe von 2017 bis 2026 dabei.
Wer in Bonn ein PHP-Backend betreibt, ruft früher oder später Schnittstellen des Bundes ab: Pegelstände, Wetterwarnungen, Zahlen aus dem Regionalatlas. Dieser Text zeigt an einem Beispiel, wie das sauber geht: Welche Dokumentation gilt, wie ein PHP-HTTP-Client konfiguriert wird, wie lange Antworten zwischengespeichert werden dürfen und welche Lizenz an den Daten hängt. Ich bin Mariusz Szatkowski, ein einzelner PHP-Entwickler aus Gdynia. Ich arbeite remote und schriftlich, ohne Termine und Anrufe.
Was bund.dev ist und wie weit seine Dokumentation reicht
Das Entwicklungsportal bund.dev wird auf GitHub von der Organisation bundesAPI betreut, die sich als “Bundesstelle für Open Data - Abteilung 1, Referat 312, Entwicklungsportal” beschreibt. Dort liegt pro Schnittstelle ein Repository mit OpenAPI-Beschreibung, etwa für PEGELONLINE (pegel-online-api), den Deutschen Wetterdienst (dwd-api), die Warn-App NINA (nina-api), den Regionalatlas oder die Autobahn GmbH.
Die Einträge sind nicht gleichwertig, und das merkt man am Wortlaut der jeweiligen README:
- Die
pegel-online-apibeschreibt den offiziellen Webservice der Wasserstraßen- und Schifffahrtsverwaltung des Bundes (WSV). Die README nennt keine Authentifizierung und “aktuell” keine API-Limitierung. - Die
dwd-apibeschreibt die Schnittstelle der DWD-App. Die Einheitentabelle in der README ist nach eigener Angabe “durch ausprobieren” entstanden und unvollständig. Eine solche Beschreibung ist eine Arbeitsgrundlage, kein Vertrag: Der DWD kann die App-Schnittstelle ändern, ohne dass jemand Sie warnt.
Für ein Produktivsystem heißt das: Ich bevorzuge den Dienst, den der Betreiber selbst als Webservice dokumentiert. Beim DWD ist das der Open-Data-Server unter opendata.dwd.de mit der Dokumentation des Climate Data Center, auf die auch die dwd-api verweist.
Beispiel: der Rheinpegel Bonn über PEGELONLINE
Die Anleitung zur REST-API von PEGELONLINE nutzt für ihr eigenes JavaScript-Beispiel die Messstelle Bonn. Die Messstelle hat die UUID 593647aa-9fea-43ec-a7d6-6476a76ae868. Die Dokumentation legt fest:
- Die Daten sind über HTTP-URLs adressierbar, das Ergebnis ist JSON. Abrufbar sind die letzten 31 Tage.
- Messstellen sollen nur über die UUID angesprochen werden, “Messstellennummer oder -namen können sich verändern bzw. sind nicht eindeutig”.
- Das Format bestimmt die Dateiendung:
.json, bei Messwerten auch.csvoder.png. - Mit
includeTimeseries=true&includeCurrentMeasurement=truekommen die Zeitreihen und der aktuelle Wert mit.
Bei meinem Abruf am 11.11.2026 lieferte die Messstelle als Gewässer RHEIN, die Nummer 2710080 und zwei Zeitreihen: W (Wasserstand, Einheit cm) und Q (Abfluss, Einheit m³/s).
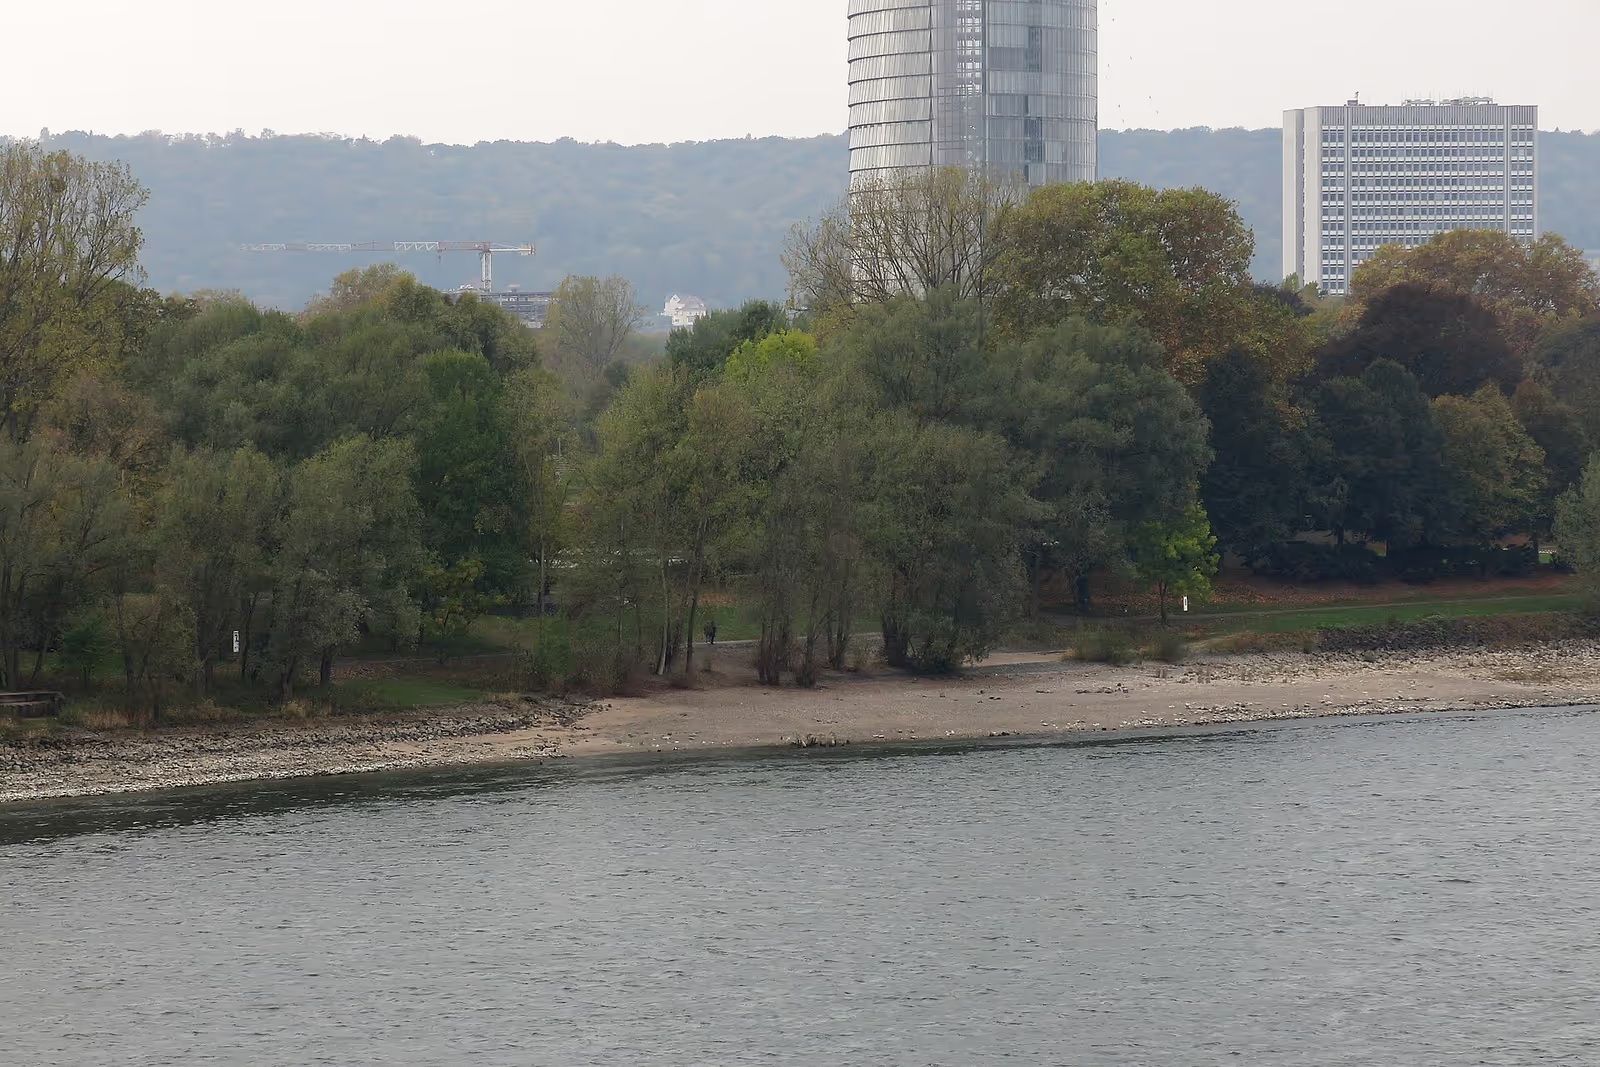
Foto: Bergsteiger1950, CC BY-SA 4.0, Wikimedia Commons.
Der Abruf mit dem Symfony HttpClient, den ich so gegen die Live-Schnittstelle laufen ließ (PHP 8.4):
<?php
declare(strict_types=1);

use Symfony\Component\HttpClient\HttpClient;
use Symfony\Component\HttpClient\RetryableHttpClient;

$client = new RetryableHttpClient(HttpClient::createForBaseUri(
    'https://pegelonline.wsv.de/webservices/rest-api/v2/',
    ['timeout' => 5, 'max_duration' => 15]
));

$messung = $client
    ->request('GET', 'stations/593647aa-9fea-43ec-a7d6-6476a76ae868/W/currentmeasurement.json')
    ->toArray(); // wirft bei HTTP-Fehler und bei ungültigem JSON

echo $messung['value'], ' cm um ', $messung['timestamp'];
toArray() gibt die Felder timestamp, value und die Zustandsfelder stateMnwMhw und stateNswHsw zurück. Ein anderer Pegel braucht nur eine andere UUID aus der Stationsliste.
Guzzle oder Symfony HttpClient: was die Dokumentation zu Zeitlimits sagt
Beide Clients sind gut. Entscheidend sind die Voreinstellungen, die in beiden Dokumentationen stehen:
| Guzzle 7 | Symfony HttpClient | |
|---|---|---|
| Gesamtzeitlimit | timeout, Standard 0, also “wait indefinitely” | max_duration begrenzt Anfrage und Antwort insgesamt |
| Leerlauf | read_timeout bei Streams, Standard ist default_socket_timeout | timeout, sonst default_socket_timeout |
| HTTP-Fehler | Ausnahme bei 4xx und 5xx, abschaltbar mit http_errors => false | getContent() und toArray() werfen bei 3xx bis 5xx, abschaltbar mit false als Argument |
| Wiederholungen | nicht als Option dokumentiert, nur über eigene Middleware | RetryableHttpClient, Standard: 3 Versuche mit wachsender Pause |
Zwei Folgen für den Alltag. Erstens: Ein Guzzle-Client ohne gesetztes timeout wartet laut Dokumentation unbegrenzt. Ein hängender Bundesdienst blockiert dann einen PHP-FPM-Worker, bis der Webserver abbricht. Ich setze deshalb Zeitlimits in jedem Client, immer. Zweitens: Die Wiederholungsstrategie von Symfony wiederholt nach Dokumentation bei 423, 425, 429, 502 und 503 für jede HTTP-Methode, bei 500, 504, 507 und 510 nur bei idempotenten Methoden. Eine Abfrage mit GET ist idempotent, ein POST an eine Rechnungsschnittstelle nicht: Dort wiederhole ich nur mit einem Idempotenzschlüssel.
Zwischenspeichern: so oft, wie sich die Daten ändern
PEGELONLINE beschreibt das Caching selbst. Die API setzt bei den meisten Ressourcen Expires und max-age, Änderungen seien “zwischen 1 und 60 Sekunden” möglich. Alle Antworten tragen zusätzlich einen ETag, ein erneuter Abruf mit If-None-Match liefert bei unveränderten Daten den Status 304 ohne Inhalt. Die Antworten werden mit Accept-Encoding: gzip auf bis zu 10 Prozent der Originalgröße komprimiert.
Bei meinem Abruf lautete der Header Cache-Control: max-age=38. Ein Pegelwert, der sich im Minutentakt ändert, muss also nicht bei jedem Seitenaufruf Ihrer Webseite neu geholt werden. Der einfachste Weg ist ein Anwendungs-Cache mit festem Ablauf, hier mit der Cache-Komponente von Symfony:
<?php
declare(strict_types=1);

use Symfony\Component\Cache\Adapter\FilesystemAdapter;
use Symfony\Contracts\Cache\ItemInterface;

$cache = new FilesystemAdapter('pegel');

$messung = $cache->get('pegel_bonn_w', function (ItemInterface $item) use ($client): array {
    $item->expiresAfter(60); // der Callback läuft nur bei einem Cache-Miss
    return $client
        ->request('GET', 'stations/593647aa-9fea-43ec-a7d6-6476a76ae868/W/currentmeasurement.json')
        ->toArray();
});
In meinem Lauf dauerte der erste Aufruf rund 300 ms, der zweite Aufruf innerhalb der 60 Sekunden praktisch 0 ms. Der CachingHttpClient von Symfony kann das auch auf HTTP-Ebene nach RFC 9111. Die Dokumentation weist darauf hin, dass die Antwort vollständig gelesen werden muss, damit sie im Cache landet. In meinem Test mit Symfony HttpClient 8.1 akzeptierte er nur absolute URLs, eine Basis-URI am inneren Client reichte nicht.
Ein Cache hat noch einen zweiten Nutzen: Fällt der Bundesdienst aus, kann Ihre Seite den letzten Wert mit Zeitstempel anzeigen, statt leer zu bleiben. Wichtig ist die Zeitangabe, denn ein veralteter Pegel ohne Datum ist eine falsche Auskunft.
Lizenz: was die Datenlizenz Deutschland erlaubt
Die Daten von PEGELONLINE stehen laut Nutzungsbedingungen (Stand 21.05.2024) unter der Datenlizenz Deutschland Zero 2.0. Der Lizenztext lautet: “Jede Nutzung ist ohne Einschränkungen oder Bedingungen zulässig.” Ausdrücklich genannt sind Vervielfältigen, Verändern, Weitergeben, das Zusammenführen mit eigenen Daten und das Einbinden in Geschäftsprozesse, Produkte und Anwendungen, kommerziell wie nicht kommerziell.
Andere Bereitsteller nutzen strengere Varianten. Der Überblick:
| Quelle | Lizenz | Was Sie tun müssen |
|---|---|---|
| PEGELONLINE (WSV) | Datenlizenz Deutschland Zero 2.0 | Nichts. Die WSV liefert “ungeprüfte Rohdaten” und übernimmt keine Haftung für ihre Richtigkeit. |
| Datensätze anderer Bereitsteller | Datenlizenz Deutschland Namensnennung 2.0 (dl-de/by-2-0) | Quellenvermerk mit Bereitsteller, Lizenzvermerk samt Link zum Lizenztext und Verweis auf den Datensatz; Änderungen kenntlich machen |
| DWD, frei zugängliche Geodaten | Creative Commons BY 4.0 | Quellenvermerk, wie in den rechtlichen Hinweisen des DWD beschrieben |
Die Praxisfolge: Ich lege die Lizenz jedes eingebundenen Datensatzes im Projekt-README ab, mit Link, und baue den Quellenvermerk dort in die Seite ein, wo die Lizenz ihn verlangt. Bei einer Zero-Lizenz nenne ich die Quelle trotzdem, damit Leser prüfen können, woher eine Zahl kommt.
Datenschutz: Abruf im Browser oder auf dem Server
Die PEGELONLINE-Anleitung zeigt ein jQuery-Beispiel, das die Schnittstelle direkt aus dem Browser aufruft. Die Antworten tragen Access-Control-Allow-Origin: *, das geht also. Nach den Nutzungsbedingungen speichert PEGELONLINE für jeden Datendownload Informationen in einer Protokolldatei und wertet sie anonymisiert aus.
Bei einem Browser-Abruf sendet jeder Besucher Ihrer Webseite seine Anfrage an einen Dritten. Ich rufe deshalb auf dem Server ab und liefere die zwischengespeicherte Antwort selbst aus. Das spart Anfragen an den Bundesdienst, und die IP-Adressen Ihrer Besucher gehen nicht an ihn. Ob und wie ein Dienst in Ihre Datenschutzerklärung gehört, klären Sie mit Ihrer Datenschutzberatung. Die zuständige Aufsicht in Nordrhein-Westfalen ist die LDI NRW, die auf einer eigenen Seite ein Muster für Datenschutzhinweise für “einfache” Websites nicht-öffentlicher Betreiber anbietet.
Checkliste: eine öffentliche Schnittstelle in PHP anbinden
- Dokumentation des Betreibers lesen, nicht nur die Beschreibung im Katalog. Prüfen, ob es ein offizieller Webservice oder eine App-Schnittstelle ist.
- Lizenz und Nutzungsbedingungen notieren, inklusive Stand und Link.
- Bezeichner verwenden, die der Betreiber als stabil nennt (hier: die UUID, nicht der Name).
- Zeitlimits setzen: Gesamtdauer und Verbindungsaufbau.
- Wiederholungen nur für idempotente Anfragen, mit Obergrenze.
- Antworten gemäß
Cache-ControlundETagzwischenspeichern, den Zeitpunkt der Messung mit anzeigen. - Ausfall einplanen: letzter bekannter Wert mit Zeitstempel statt Fehlerseite.
- Quellenvermerk setzen, wo die Lizenz ihn verlangt.
- Einen kleinen Test mit aufgezeichneter Antwort schreiben, damit eine Änderung des Formats auffällt.
So arbeite ich mit Ihnen zusammen
Ich bin ein einzelner Entwickler und arbeite remote und schriftlich. Es gibt keine Termine und keine Anrufe, alle Fragen und Entscheidungen stehen in Textform und bleiben nachvollziehbar. Layout, Grafiken und Entwürfe bringen Sie mit, ich setze sie um. Der Ablauf: Sie beschreiben das Ziel, ich stelle schriftliche Rückfragen, danach folgen ein schriftlicher Umfang mit Annahmen, die Umsetzung auf einer Testumgebung, Ihre Abnahme und auf Wunsch eine laufende Betreuung. Hinweise zur Wartung finden Sie auf der Seite Wartung und Support in Bonn.
Häufige Fragen
Muss ich für Bundes-APIs einen Schlüssel beantragen?
Das hängt vom Dienst ab. Die README der pegel-online-api nennt keine Authentifizierung und aktuell keine Limitierung. Für andere Einträge im Katalog gilt die Dokumentation des jeweiligen Betreibers.
Darf ich die Daten kommerziell nutzen?
Bei PEGELONLINE ja, die Datenlizenz Deutschland Zero erlaubt “jede Nutzung” ohne Bedingungen. Bei Namensnennungslizenzen wie dl-de/by-2-0 oder CC BY 4.0 müssen Sie die Quelle angeben. Die Lizenz steht auf der Seite des Betreibers, ich lese sie vor der Umsetzung.
Wie oft darf ich die Schnittstelle abfragen?
Die PEGELONLINE-Dokumentation nennt keine feste Zahl, beschreibt aber Caching über Cache-Control, Expires und ETag. Ich richte die Abruffrequenz danach aus und speichere die Antwort für wenige Sekunden bis eine Minute zwischen.
Guzzle oder Symfony HttpClient?
Beide sind für diese Aufgabe geeignet. Der Symfony HttpClient bringt Wiederholungen und einen Caching-Dekorator mit, bei Guzzle setze ich Zeitlimits ausdrücklich, weil der Standard unbegrenzt wartet. In einem bestehenden Laravel-Projekt bleibe ich bei dem, was dort schon eingesetzt wird.
Was passiert, wenn der Bundesdienst ausfällt?
Ihre Seite zeigt den letzten zwischengespeicherten Wert mit dem Zeitpunkt der Messung. Fehler landen im Log des Projekts, die Seite selbst bleibt erreichbar.
Wie fange ich an?
Schreiben Sie mir über das Kontaktformular: die Adresse Ihrer Seite oder Anwendung, welche Daten Sie einbinden möchten, Ihren Termin und den aktuellen Stack. Ich antworte schriftlich an Werktagen. Die erste Einschätzung zu Umfang und Vorgehen bekommen Sie schriftlich und kostenlos.
Ausgewählte Projekte
Beispiele aus meiner Arbeit.
E-Commerce-Entwicklung: mochola.com
mochola.com ist eine moderne E-Commerce-Plattform, die auf WooCommerce basiert, das ich als Entwickler realisiert habe, und auf den Verkauf von Autoersatztei...
E-Commerce-Entwicklung: nehrebeccy.pl
nehrebeccy.pl ist eine moderne künstlerische Agentur, die Erfahrung in der Organisation kultureller Veranstaltungen mit der Präsentation eines vielfältigen k...
E-Commerce-Entwicklung: nolaclub.pl
nolaclub.pl ist ein Onlineshop für Nagellacke und Kosmetik, mit Produktkatalog, Kaufprozess und technischem SEO.
WordPress Support & Entwicklung in Bonn
Brauchen Sie die Leistung: PHP-Entwickler in Bonn?
Beschreiben Sie Ihr Projekt per E-Mail. Antwort innerhalb von 48 Stunden.
Projekt beschreibenWeitere WordPress-Dienste und Wissensbasis entdecken
Individuelle WordPress-Entwicklung und Architektur.
Shops, Checkout-Prozesse und Verkaufslogik.
Shopify-Themes, Liquid und WooCommerce → Shopify-Migrationen.
Headless WordPress, Sanity, Strapi und Contentful mit Astro oder Next.js.
Claude, OpenAI und RAG in WordPress mit BYOK und EU-Residenz.
Geschäftsprozessautomatisierung rund um WordPress und Firmensysteme.
Bibliothek konkreter Automatisierungsfälle.
NIS2- und DORA-Scoping, Lieferantenregister, Incident-Runbook.
Verwandte Kategorien
Unterstützende Artikel
Ein Leitfaden aus der Praxis für eine WordPress-Website, die 2026 rankt. Technisches SEO, Core Web Vitals, Schema, AEO, GEO, hreflang und die Reihenfolge, mit der es beim ersten Mal klappt.
Migration von Shopify zu WooCommerce ohne Datenverlust, Kundenverlust oder SEO-Ranking-Einbußen. Umfasst Produkttransfer, 301-Weiterleitungen, URL-Mapping, WP-CLI-Automatisierung und Checkliste nach der Migration.

Die vollständige Checkliste nach der WordPress-Installation. 50 Schritte zu Sicherheit, Performance, SEO und Backups. Eine professionelle Konfiguration ab dem ersten Tag.