Mein Platz in der WordPress-Community
- Mein wordpress.org-Konto besteht seit 2006.
- Ich habe zum WordPress-Core in den Versionen 7.0 und 7.1 beigetragen.
- Ich betreue 30 Plugins auf wordpress.org.
- Ich organisiere WordCamps und trete dort als Speaker auf.
- Ich war bei jedem WordCamp Europe von 2017 bis 2026 dabei.
Wer in Duisburg einen PHP-Programmierer sucht, hat oft dieses Problem: Ein Export aus dem Warenwirtschaftssystem, dem Lager oder dem Kundenstamm ist über die Jahre gewachsen, und der Import dafür stürzt mit „Allowed memory size exhausted“ oder „Maximum execution time exceeded“ ab. Dieser Text zeigt, wie ich große CSV- und XML-Dateien in PHP verarbeite, ohne den Arbeitsspeicher zu sprengen, wo solche Importe laufen sollten und wie man Eingaben prüft, bevor sie in der Datenbank landen.
Mein Name ist Mariusz Szatkowski. Ich sitze in Gdynia in Polen und programmiere seit 2006 in PHP. Ich bin eine Einzelperson, keine Agentur, und arbeite ausschließlich remote und schriftlich. Ein Projektleiter sitzt nicht dazwischen: Fragen zum Import beantwortet die Person, die ihn programmiert.
Ein echtes CSV aus Duisburg als Beispiel
Die Stadt betreibt ein Open-Data-Portal, das Datensätze auch über eine DKAN-API mit JSON-Ausgabe zugänglich macht. Dort liegt die Einwohnerstatistik nach Ortsteilen, Quelle ist laut Portal die Einwohnermeldedatei, die Lizenz ist Creative Commons Namensnennung 3.0 Deutschland.
Ich habe die Datei für 2024 heruntergeladen und angesehen. Sie zeigt die Eigenheiten, an denen Importe in der Praxis scheitern:
- Das Trennzeichen ist ein Semikolon, nicht das Komma, das viele Beispiele annehmen.
- Textfelder stehen in Anführungszeichen, Zahlen nicht.
- Die Kopfzeile enthält einen Umlaut (
InsgesamtMännlich), die Datei ist UTF-8 mit Windows-Zeilenenden. - Sie hat 46 Datenzeilen, eine je Ortsteil, jede mit elf Spalten.
Die Datei ist klein, sie passt locker in den Speicher. Ein Export Ihres Warenwirtschaftssystems mit einer Million Zeilen tut das nicht, und genau dafür gilt dasselbe Muster. Wer es an einer kleinen Datei richtig baut, hat es für die große schon.
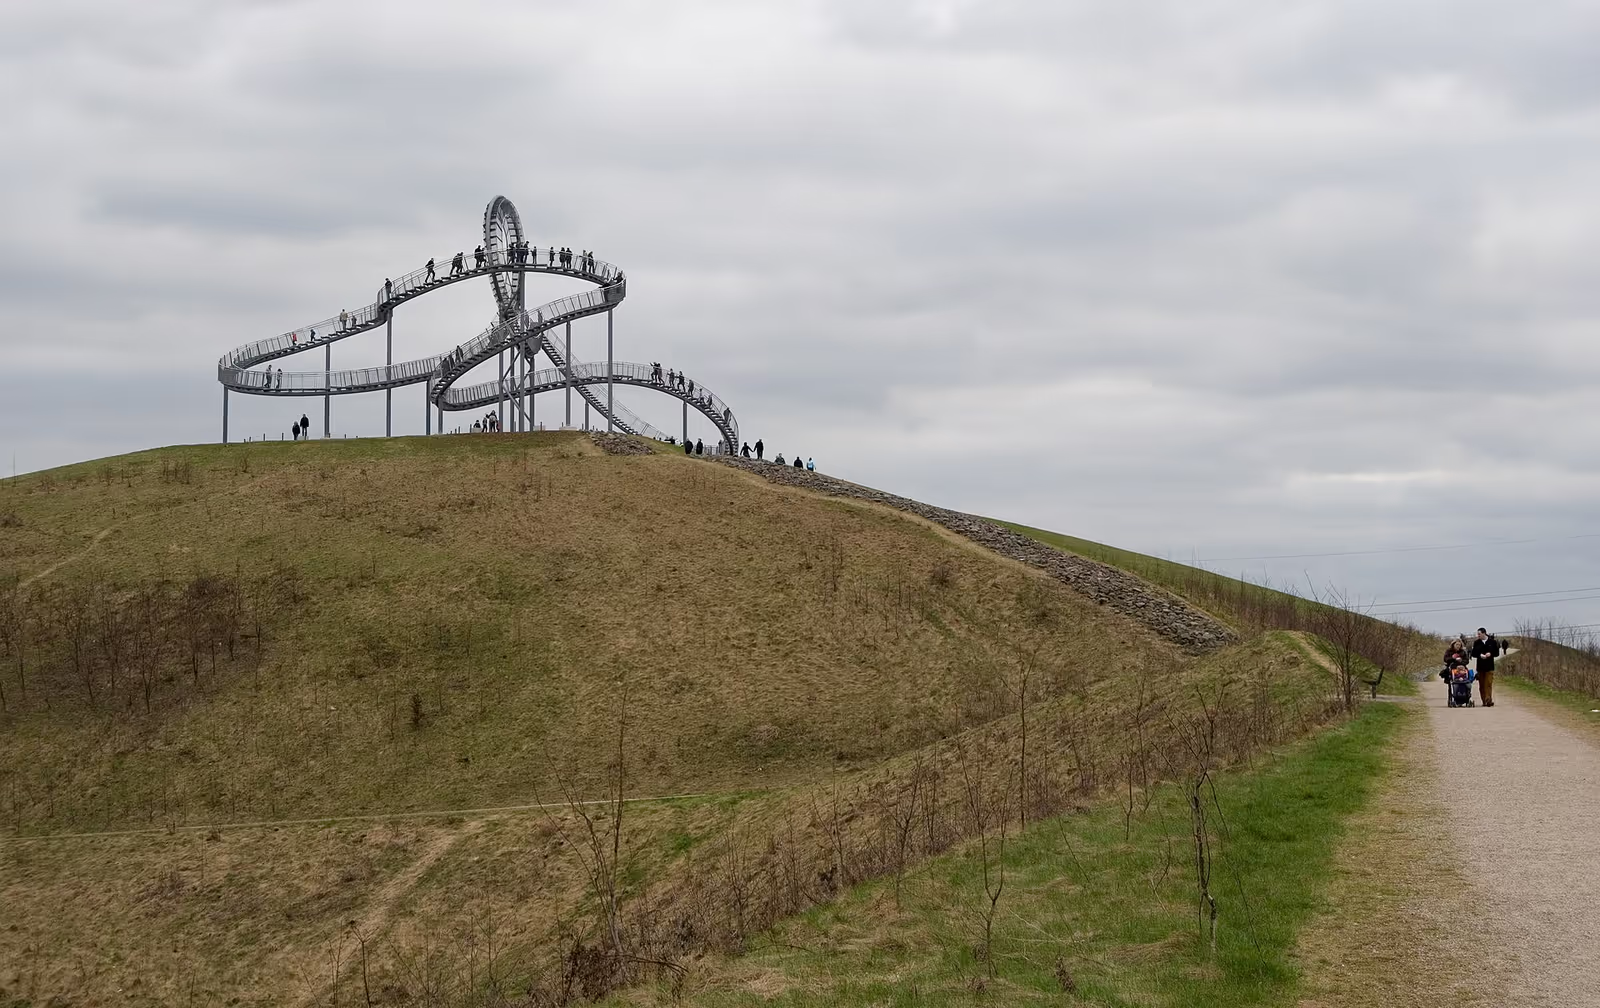
Foto: kaʁstn Disk/Cat, CC BY-SA 3.0 de, Wikimedia Commons.
CSV zeilenweise lesen: ein Generator statt eines Arrays
Das PHP-Handbuch beschreibt Generatoren als Weg, Daten an eine foreach-Schleife zu liefern, ohne vorher ein Array im Speicher aufzubauen, das ein Speicherlimit sprengen könnte. Für CSV heißt das: Die Funktion liest eine Zeile, gibt sie mit yield zurück und vergisst sie wieder.
function zeilen(string $pfad): Generator
{
    $handle = fopen($pfad, 'rb');
    if ($handle === false) {
        throw new RuntimeException("Datei nicht lesbar: $pfad");
    }
    try {
        $kopf = fgetcsv($handle, null, ';', '"', '');
        $nr = 1;
        while (($feld = fgetcsv($handle, null, ';', '"', '')) !== false) {
            $nr++;
            if ($feld === [null]) {
                continue; // Leerzeile
            }
            if (count($feld) !== count($kopf)) {
                throw new UnexpectedValueException("Zeile $nr: falsche Spaltenzahl");
            }
            yield $nr => array_combine($kopf, $feld);
        }
    } finally {
        fclose($handle);
    }
}
Drei Details, die ich bewusst so schreibe:
- Der fünfte Parameter von
fgetcsvist leer. Laut Handbuch ist es seit PHP 8.4 veraltet, sich auf den Standardwert vonescapezu verlassen. Der leere String schaltet den PHP-eigenen Escape-Mechanismus ab, der sonst nicht RFC-4180-konforme Ergebnisse liefern kann. - Eine Leerzeile liefert
[null]. Das Handbuch beschreibt, dass eine leere Zeile als Array mit einem einzelnennullzurückkommt. Ohne die Prüfung entsteht eine Phantomzeile am Dateiende. - Die Zeilennummer ist der Schlüssel. Meldet die Prüfung später einen Fehler, kann der Fachbereich die Zeile in der Quelldatei öffnen.
Wer lieber ein Objekt möchte: SplFileObject kennt die Flags READ_CSV, READ_AHEAD, SKIP_EMPTY und DROP_NEW_LINE. Nach dem Handbuch wirkt SKIP_EMPTY nur zusammen mit READ_AHEAD. Die Handbuchseite markiert SplFileObject::fgetcsv, fputcsv und getCsvControl als veraltet ab PHP 8.6 (zum Abrufzeitpunkt ein Release Candidate). Deshalb nehme ich in neuem Code die einfachen Funktionen, die ich oben gezeigt habe.
Die Summe der Spalte Insgesamt aus der Duisburger Datei lässt sich damit in wenigen Zeilen bilden, ohne dass mehr als eine Zeile gleichzeitig im Speicher liegt. Ich habe das mit der echten Datei durchlaufen lassen, es läuft ohne Fehler.
XML Knoten für Knoten: XMLReader
Kataloge, Artikelstämme und Behördenexporte kommen oft als XML. simplexml_load_file baut den gesamten Baum im Speicher auf, bei einer großen Datei ist das genau das Problem. Der XMLReader ist laut Handbuch ein Pull-Parser: Er arbeitet wie ein Cursor, der in einem Datenstrom vorwärts läuft und an jedem Knoten anhält.
Ich lese damit bis zum gewünschten Element und hole nur diesen einen Teilbaum mit expand() als DOM-Knoten. Die Methode gibt laut Handbuch eine Kopie des aktuellen Knotens zurück. Danach springt next() zum nächsten gleichnamigen Geschwisterknoten und überspringt dabei alle Unterbäume.
$reader = XMLReader::open($pfad);
if ($reader === false) {
    throw new RuntimeException("Datei nicht lesbar: $pfad");
}
while ($reader->read() && $reader->name !== 'artikel') {
    // bis zum ersten Artikel vorspulen
}
while ($reader->name === 'artikel') {
    $knoten = simplexml_import_dom($reader->expand(new DOMDocument()));
    // $knoten->nummer prüfen und speichern
    $reader->next('artikel');
}
$reader->close();
Die Schleife ist absichtlich in zwei Teile gespalten. Wer next() am Ende einer einzelnen while ($reader->read())-Schleife aufruft, überspringt jeden zweiten Artikel, weil read() danach erneut weiterspringt. Ich habe das mit einem kleinen Katalog aus drei Artikeln nachgestellt: Die zusammengezogene Variante lieferte Artikel 1 und 3, die geteilte alle drei. Solche stillen Lücken fallen in Tests mit zehn Datensätzen selten auf und in der Produktion erst, wenn Zahlen nicht stimmen.
Ab PHP 8.4 gibt es außerdem XMLReader::fromStream, das einen XMLReader aus einem Stream erzeugt. Das hilft, wenn die Datei aus einem Upload oder einem Dienst kommt und nicht auf der Platte liegt.
memory_limit und max_execution_time richtig einordnen
Beide Werte schützen den Server vor Skripten, die zu viel verbrauchen. Nach der Konfigurationsseite im Handbuch gilt:
| Einstellung | Standard laut Handbuch | Wichtig dazu |
|---|---|---|
memory_limit | 128M | -1 bedeutet kein Limit |
max_execution_time | 30 Sekunden | Im CLI ist der Standard 0, also unbegrenzt |
Dazu kommen zwei Punkte, die in alten Anleitungen fehlen:
set_time_limit()startet den Zähler neu. Laut Handbuch läuft ein Skript, das nach 25 Sekundenset_time_limit(20)aufruft, insgesamt 45 Sekunden. Zeit außerhalb des Skripts, etwa in Datenbankabfragen oder Systemaufrufen, zählt auf Nicht-Windows-Systemen nicht mit.memory_limitist in neuen Patch-Versionen ein weiches Limit. Das Handbuch nennt PHP 8.5.12, 8.4.27, 8.3.36 und 8.2.35: Eine Allokation, die das Limit überschreitet, darf meistens noch abgeschlossen werden, bevor der Fehler kommt. Das neuememory_hard_limit_percentsetzt die absolute Grenze, bei Überschreitung endet der Prozess sofort mit Exit-Status 137. Das Handbuch ordnet die Einstellung den Sicherheitsreleases vom Oktober 2026 zu. Wer seine PHP-Version seitdem nicht aktualisiert hat, sollte das vor jeder Importarbeit tun.
Den tatsächlichen Verbrauch eines Imports lese ich mit memory_get_peak_usage() aus und schreibe den Wert am Ende ins Protokoll. Ein Importlauf, dessen Spitzenwert mit der Dateigröße wächst, streamt nicht, egal wie das Skript aussieht.
Wo ein Import läuft: CLI oder Queue statt Webrequest
Ein Import, den jemand per Knopfdruck im Browser startet, hat zwei Probleme: das Zeitlimit des Webservers und den wartenden Browser. Ich verlege solche Aufgaben aus dem Webrequest heraus.
- Als CLI-Skript mit Cronjob. Im CLI ist
max_execution_timestandardmäßig 0. Das Skript bekommt eine eigene Sperre, damit nicht zwei Läufe gleichzeitig starten, und schreibt ein Protokoll. - Als Queue-Job. In Laravel legt der Upload nur die Datei ab und stellt einen Job in die Warteschlange. Ein Worker verarbeitet ihn getrennt vom Browser.
Zur Laravel-Queue-Dokumentation gehören drei Angaben, die ich bei jedem Importjob prüfe:
queue:work --memorysetzt die Grenze in Megabyte, bei der der Worker sich beendet. Standard sind 128 MB. Auch ein Prozentwert vonmemory_limitist möglich, aber nur bei endlichemmemory_limit. Ein Prozessmanager wie Supervisor startet den Worker danach neu.--timeoutoder das Attribut#[Timeout(120)]an der Job-Klasse begrenzt die Laufzeit eines Jobs. Der Wert an der Klasse hat Vorrang vor dem Kommandozeilenwert.- Der Timeout muss mehrere Sekunden kürzer sein als
retry_after. Sonst kann ein Job nach Angabe der Dokumentation doppelt verarbeitet werden.
Der letzte Punkt ist bei Importen der gefährlichste, denn ein doppelt verarbeiteter Import schreibt Bestellungen oder Lagerbestände zweimal. Deshalb baue ich Importe so, dass ein zweiter Lauf über dieselbe Datei dasselbe Ergebnis liefert (Schlüssel aus der Quelle, upsert statt insert).
In Symfony gibt es für denselben Zweck den Messenger. Welches Framework passt, hängt von dem Projekt ab, das Sie schon haben. Ich schreibe Ihnen die Empfehlung und die Begründung auf.
Eingaben prüfen, bevor sie in die Datenbank gehen
Eine Datei von außen ist unzuverlässig, auch wenn sie aus dem eigenen Warenwirtschaftssystem kommt. Spalten verschieben sich nach einem Update, Zahlen kommen mit Komma, ein Feld bleibt leer. Ich prüfe jede Zeile, bevor sie geschrieben wird:
- Spaltenzahl und Kopfzeile. Stimmt die Struktur nicht, bricht der Lauf ab, bevor etwas in die Datenbank geht.
- Zahlen mit
filter_var. Nach dem Handbuch liefertfilter_varbei einem Fehlerfalse. Mit dem FlagFILTER_NULL_ON_FAILUREkommt stattdessennullzurück, undfalsebleibt ein gültiger Wert, etwa bei booleschen Feldern. - Pflichtfelder und Wertebereiche. Eine Einwohnerzahl ist nicht negativ, eine Artikelnummer nicht leer.
- Fehlerprotokoll mit Zeilennummer. Fehlerhafte Zeilen werden gemeldet, die übrigen laufen durch, wenn Sie das so festlegen.
$anzahl = filter_var($row['Insgesamt'], FILTER_VALIDATE_INT, FILTER_NULL_ON_FAILURE);
if ($anzahl === null || $anzahl < 0) {
    fwrite(STDERR, "Zeile $nr: Insgesamt ist keine gültige Zahl\n");
    continue;
}
Datenbankzugriffe gehen über vorbereitete Abfragen (PDO oder das Framework), nie über zusammengesetzte SQL-Strings aus Dateiinhalt.
Datenschutz: Importdateien mit Personenbezug
Die Duisburger Einwohnerstatistik enthält Zahlen je Ortsteil, keine Einzelpersonen. Ihre eigenen Importdateien enthalten oft Namen, Adressen oder Bestellungen. Zuständig für die Aufsicht ist in Nordrhein-Westfalen die Landesbeauftragte für Datenschutz und Informationsfreiheit (LDI NRW).
Die LDI NRW gibt in ihren Hinweisen zum Verzeichnis von Verarbeitungstätigkeiten nach Art. 30 DSGVO vor, dass das Verzeichnis die vorgesehenen Fristen für die Löschung der verschiedenen Datenkategorien nennen soll. Für Importe heißt das technisch:
- Die hochgeladene Datei und jede Zwischenkopie haben eine Frist und werden nach dem Lauf gelöscht.
- Das Fehlerprotokoll enthält Zeilennummern und Fehlerarten, nicht den Inhalt der Zeile.
- Der Importordner liegt außerhalb des öffentlich erreichbaren Webverzeichnisses.
Welche Daten Ihre Importe tatsächlich berühren und welche Fristen gelten, klärt Ihre Datenschutzberatung. Ich liefere die technische Übersicht: welche Dateien, Tabellen und Logs Personendaten enthalten.
Checkliste für Importe
| Prüfpunkt | Gut, wenn |
|---|---|
| Lesen | Zeile für Zeile oder Knoten für Knoten, nie die ganze Datei auf einmal |
| Speicher | Spitzenwert von memory_get_peak_usage() wächst nicht mit der Dateigröße |
| Ort | Lauf im CLI oder in der Queue, nicht im Webrequest |
| Timeout und Wiederholung | Job-Timeout kürzer als retry_after, zweiter Lauf schreibt nichts doppelt |
| Format | Trennzeichen, Kodierung und escape sind ausdrücklich gesetzt |
| Prüfung | Jede Zeile wird validiert, Fehler tragen die Zeilennummer |
| Datenschutz | Löschfrist für Datei und Kopien, kein Zeileninhalt im Log |
Wie ein Projekt mit mir abläuft
Sie schicken mir eine Beispieldatei oder deren Aufbau und beschreiben, was damit geschehen soll. Ich stelle Rückfragen schriftlich und fasse Umfang und Annahmen schriftlich zusammen. Gebaut und getestet wird auf einer Staging-Umgebung mit Ihren Beispieldaten, nicht auf der Produktion. Zur Abnahme bekommen Sie das Protokoll eines Probelaufs, und der Code geht in Ihr Repository.
Was ich von Ihnen brauche: eine Beispieldatei mit repräsentativen Zeilen (ohne echte Personendaten, wenn es sich vermeiden lässt), die Beschreibung des Zielsystems, die PHP-Version und das Framework, soweit vorhanden, und Zugang zur Staging-Umgebung. Grafikdesign, Mockups und Wireframes gehören nicht zu meinem Angebot. Wenn eine Oberfläche für den Import nötig ist, liefern Sie das Layout, ich setze es um. Mehr zu meiner Arbeit als PHP-Entwickler steht auf der Seite PHP-Entwickler.
Häufige Fragen
Warum bricht mein Import bei großen Dateien ab?
Meistens lädt der Code die ganze Datei oder die ganze Ergebnisliste in ein Array. Dann zählt die Dateigröße gegen memory_limit, das laut PHP-Handbuch standardmäßig 128M beträgt. Ich lese stattdessen Zeile für Zeile oder Knoten für Knoten und halte nie mehr als einen Datensatz im Speicher.
Soll ich memory_limit einfach erhöhen?
Als Notlösung kann das helfen, als Dauerlösung nicht. Der Bedarf wächst mit der Datei, und das nächste größere Export-File sprengt den neuen Wert wieder. Ich messe mit memory_get_peak_usage, baue auf Streaming um und lasse das Limit so, dass ein Fehler früh auffällt.
Warum gehört ein Import nicht in einen normalen Webrequest?
Ein Webrequest hat ein Zeitlimit, und der Browser wartet auf die Antwort. Im CLI ist max_execution_time laut Handbuch 0. Ein Queue-Worker oder ein Cronjob läuft unabhängig vom Browser, schreibt ein Protokoll und kann nach einem Fehler gezielt neu starten.
Was passiert mit fehlerhaften Zeilen?
Ich prüfe jede Zeile vor dem Schreiben: Spaltenzahl, Zahlen, Datumsformate, Pflichtfelder. Fehlerhafte Zeilen landen mit Zeilennummer in einem Protokoll, die übrigen laufen durch. Sie entscheiden schriftlich, ob ein Import bei einem Fehler ganz abbricht oder weiterläuft.
Wer ist in Nordrhein-Westfalen für den Datenschutz zuständig?
Für Unternehmen mit Sitz in Nordrhein-Westfalen ist in der Regel die Landesbeauftragte für Datenschutz und Informationsfreiheit NRW (LDI NRW) die Aufsichtsbehörde. Ob und wie Ihr Import Personendaten berührt, klärt Ihre Datenschutzberatung. Ich liefere die technische Übersicht dazu.
Übernehmen Sie Design und Layout?
Nein. Layout, Mockups und Wireframes bringt der Auftraggeber mit. Für Importe und Schnittstellen braucht es keine, dort geht es um Datenformate.
Anfrage schicken
Schicken Sie mir über die Kontaktseite die Adresse Ihrer Anwendung oder eine Beispieldatei, das Ziel des Imports, den Termin und den aktuellen Stack mit PHP-Version und Framework. Die erste schriftliche Einschätzung mit Rückfragen kostet Sie nichts.
Ausgewählte Projekte
Beispiele aus meiner Arbeit.
E-Commerce-Entwicklung: funderwear.pt
Funderwear.pt ist ein WooCommerce-Onlineshop, der selbst die anspruchsvollsten Kunden bedient, jene, die außergewöhnliche Geschenke suchen oder sich mit ein...
E-Commerce-Entwicklung: haveabook.pl
haveabook.pl ist eine Plattform für einen Verlag und eine Druckerei, die anspruchsvolle Kunden aus skandinavischen Ländern betreut, mit Angebotskatalog, Bestellfluss und mehrsprachiger Inhaltsstruktur.
E-Commerce-Entwicklung: ILOVEHAIR
Ilovehair.pl ist ein auf WordPress basierender Onlineshop, der sich dem Verkauf professioneller Friseurprodukte der Marke Hair Saloon Products widmet. Als Pr...
WordPress Support & Entwicklung in Duisburg
Brauchen Sie die Leistung: PHP-Entwickler in Duisburg?
Beschreiben Sie Ihr Projekt per E-Mail. Antwort innerhalb von 48 Stunden.
Projekt beschreibenWeitere WordPress-Dienste und Wissensbasis entdecken
Individuelle WordPress-Entwicklung und Architektur.
Shops, Checkout-Prozesse und Verkaufslogik.
Shopify-Themes, Liquid und WooCommerce → Shopify-Migrationen.
Headless WordPress, Sanity, Strapi und Contentful mit Astro oder Next.js.
Claude, OpenAI und RAG in WordPress mit BYOK und EU-Residenz.
Geschäftsprozessautomatisierung rund um WordPress und Firmensysteme.
Bibliothek konkreter Automatisierungsfälle.
NIS2- und DORA-Scoping, Lieferantenregister, Incident-Runbook.
Verwandte Kategorien
Unterstützende Artikel
Ein Leitfaden aus der Praxis für eine WordPress-Website, die 2026 rankt. Technisches SEO, Core Web Vitals, Schema, AEO, GEO, hreflang und die Reihenfolge, mit der es beim ersten Mal klappt.
Migration von Shopify zu WooCommerce ohne Datenverlust, Kundenverlust oder SEO-Ranking-Einbußen. Umfasst Produkttransfer, 301-Weiterleitungen, URL-Mapping, WP-CLI-Automatisierung und Checkliste nach der Migration.

Die vollständige Checkliste nach der WordPress-Installation. 50 Schritte zu Sicherheit, Performance, SEO und Backups. Eine professionelle Konfiguration ab dem ersten Tag.