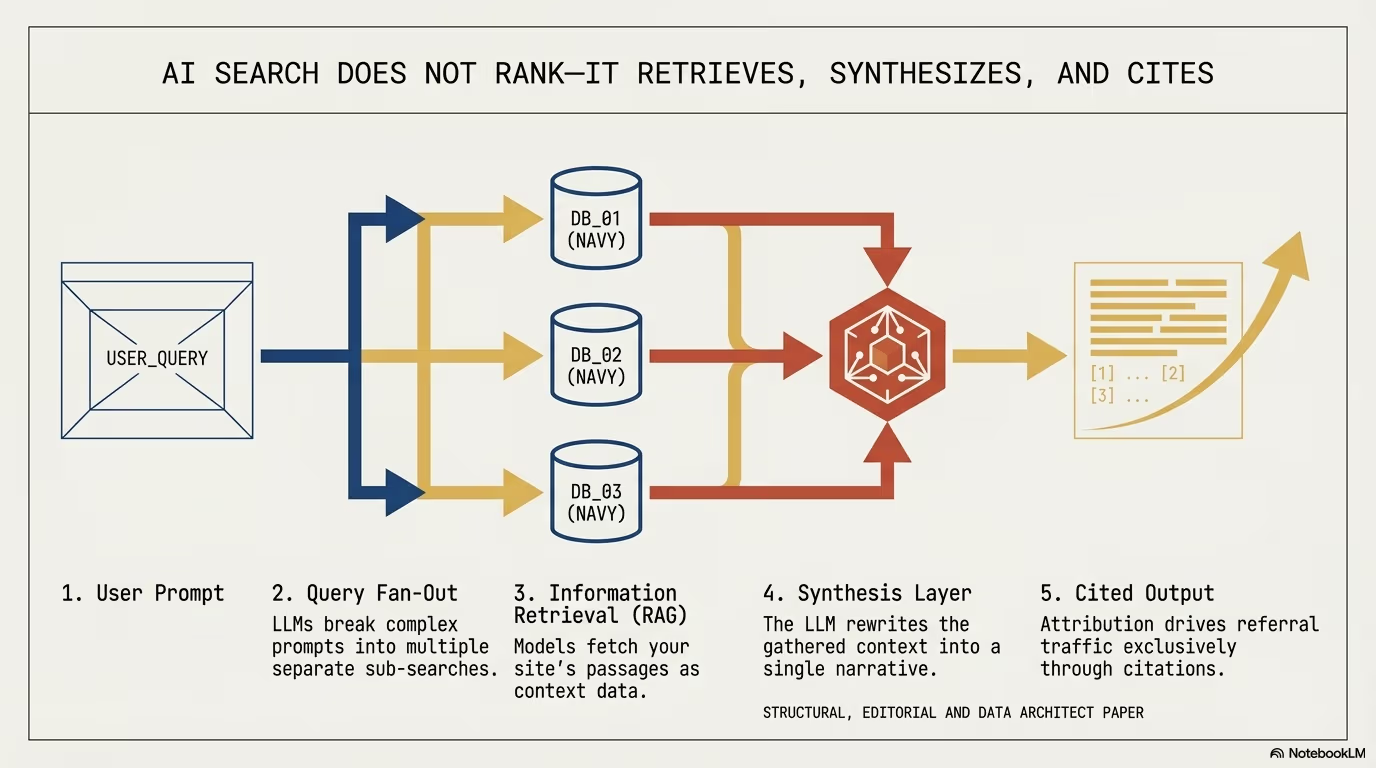
Die klassische Suche war einfach aufgebaut: Jemand gab eine Anfrage ein, die Suchmaschine schlug sie in einem invertierten Index nach, und die Ranking-Systeme lieferten eine geordnete Liste von URLs. Google AI Mode, AI Overviews, ChatGPT Search und Perplexity schieben einen Schritt dazwischen. Bevor eine Antwort entsteht, kann aus einer Frage eine Reihe verwandter Suchanfragen werden, und die Antwort zitiert die Seiten, die diese Suchanfragen gefunden haben.
Dieser Schritt läuft nicht bei jeder Frage. In der weiter unten besprochenen Ahrefs-Studie beantwortete ChatGPT etwa 6 von 7 Prompts ganz ohne Websuche. Wenn aber gesucht wird, setzt sich die Antwort aus konkreten Absätzen, Tabellen und Codebeispielen zusammen statt aus einer Rangliste von zehn Links. Deshalb zählt, welche Teile einer Seite für sich allein verständlich sind.
Was ist Query fan-out und wie funktioniert die Abfragedekomposition
Query fan-out ist Googles Bezeichnung dafür, eine Frage in mehrere gleichzeitig laufende Suchanfragen aufzuteilen. Googles Leitfaden zu generativen KI-Funktionen definiert ihn als „eine Reihe gleichzeitiger, verwandter Anfragen, die vom Modell erzeugt werden, um weitere Informationen anzufordern und zusätzliche relevante Suchergebnisse für die Anfrage des Nutzers abzurufen“ (Google Search Central, eigene Übersetzung). Googles Beispiel: Bei der Frage, wie man einen Rasen voller Unkraut repariert, könnten die Fan-out-Anfragen nach den besten Herbiziden für Rasen, nach Unkrautentfernung ohne Chemie und nach Vorbeugung gegen Unkraut suchen.
Google verwendete den Begriff bei der Ankündigung von AI Mode am 5. März 2025 und beschrieb eine Technik, die mehrere verwandte Suchen gleichzeitig über Unterthemen und verschiedene Datenquellen hinweg ausführt. Am 20. Mai 2025 kam Deep Search hinzu, das dieselbe Technik nutzt und laut Google Hunderte von Suchen ausführen kann (Google-Blog). Googles Dokumentation zu KI-Funktionen sagt, dass sowohl AI Overviews als auch AI Mode Fan-out nutzen können und dass beide Funktionen unterschiedliche Modelle und Techniken verwenden können, weshalb sich ihre Antworten und Links unterscheiden.
Wie viele Unteranfragen laufen, hängt vom Produkt ab. Ahrefs hat 66,6 Millionen kostenlose, abgemeldete ChatGPT-Antworten und die zugehörigen 15 Millionen Fan-out-Anfragen aus August und September 2026 ausgewertet (Ahrefs). Nur 14,4 Prozent der Antworten lösten eine Websuche aus, und diese stellten im Schnitt etwa 1,6 Fan-out-Anfragen. Im selben Artikel nennt Ahrefs Tests von Suganthan Mohanadasan mit angemeldetem Konto, in denen ein Thinking-Modell 15 bis 40 Anfragen stellte, sowie Daten von Peec, wonach 56,5 Prozent der Prompts zwei oder mehr Anfragen auslösten. Kostenlose Sitzungen suchen seltener als bezahlte Modelle und Reasoning-Modelle.
Nehmen wir einen technischen Prompt aus dem Enterprise-Umfeld:
Welches Headless-WordPress-Setup eignet sich am besten für einen WooCommerce-Katalog mit 50.000 Produkten und ERP-Synchronisierung über mehrere Regionen?
Anbieter veröffentlichen ihre vollständigen Pipelines nicht. Die folgende Abfolge ist eine allgemeine Beschreibung von Retrieval-Augmented Generation (RAG), auf der Googles KI-Funktionen laut Google beruhen, mit einem beispielhaften Fan-out für diesen Prompt:
- Die Frage lesen: Das Modell erkennt die Themen (WordPress, Headless-Architektur, WooCommerce, ERP) und die Randbedingungen (50.000 Produkte, mehrere Regionen).
- Verwandte Suchanfragen erzeugen (die Fan-out-Phase), zum Beispiel:
- Anfrage 1: WPGraphQL vs REST API batch query latency 50k WooCommerce products
- Anfrage 2: Headless WooCommerce ERP webhook queue congestion mitigation
- Anfrage 3: Astro SSR vs Next.js static build performance high SKU catalog
- Anfrage 4: WooCommerce High-Performance Order Storage database memory footprint
- Abruf: Google sagt, dass es seine zentralen Ranking-Systeme nutzt, um relevante Seiten aus seinem Index abzurufen. Suganthan Mohanadasan hat das mit der Gemini-API getestet: Eine Frage nach einer Seite, die nie existiert hat, erzeugte Suchanfragen, aber keinen Eintrag in seinem Server-Log, weil das Grounding Googles Index liest und nicht die Live-Seite (Suganthan Mohanadasan).
- Prüfung der abgerufenen Seiten: Die Systeme prüfen konkrete Informationen aus diesen Seiten.
- Antwort mit Links: Die Antwort zeigt anklickbare Links zu Seiten, die ihre Informationen stützen.
Für Content-Teams folgt daraus, dass eine Seite für mehrere dieser verwandten Suchanfragen in Frage kommen kann, solange sie sie mit Text beantwortet, den die Suchmaschine finden kann. Google zieht dabei eine Grenze: Für jede Fan-out-Anfrage eine eigene Seite anzulegen, vor allem um Rankings oder KI-Antworten zu manipulieren, verstößt gegen die Spam-Richtlinie zum Missbrauch skalierter Inhalte.
Warum eigenständige Abschnitte zitiert werden
Generative Suchmaschinen zitieren konkrete Abschnitte, nicht ganze Seiten. Damit beginnt der Leitfaden von Lumar zur Zitierbarkeit von Abschnitten: „Unserer Erfahrung nach zitieren generative Suchmaschinen bestimmte Abschnitte von Inhalten und nicht Seiten als Ganzes“ (Lumar, eigene Übersetzung). Lumar stellt das als Praxiserfahrung dar, nicht als gemessene Studie, und nennt weder Wortzahlen noch Zitatanteile.
Der Abschnittstest von Lumar hat fünf Prüfpunkte: Der Abschnitt beantwortet eine Frage, ist ohne den umgebenden Text verständlich, enthält die nötigen Fakten (Einheiten, Versionen, Bedingungen), bleibt bei einem Thema und hat genug Details, ohne abzuschweifen. Zur Länge sagt Lumar nur, dass sehr kurze Abschnitte Kontext verlieren, sehr lange Ideen vermischen und sich die ideale Länge nicht einfach messen lässt. Google geht für die eigenen Funktionen weiter: Es gibt keine Pflicht, Inhalte in kleine Stücke zu zerlegen, und keine ideale Seitenlänge.
Wie man Absätze ohne Abhängigkeit vom restlichen Text verfasst
Ein zitierbarer Abschnitt vermittelt seine Aussage ohne den vorherigen Absatz. Lumar fragt, ob ein Abschnitt Pronomen wie dies, es oder sie ohne klaren Bezug enthält oder Wendungen wie „wie oben erwähnt“. Der Grounding-Checker von Suganthan Mohanadasan fand dasselbe Problem in dessen eigenem Artikel: Ein Satz über das erneute Senden einer Anfrage, der mit dem englischen Pronomen „It“ begann, erreichte nur 8 Prozent bei der Frage, ob er für sich allein verständlich ist, weil herausgelöst niemand weiß, worauf sich das Pronomen bezieht. Ein schwaches Beispiel:
Diese Technologie beschleunigt die Ladezeiten erheblich und senkt gleichzeitig die Serverkosten…
Ohne Kontext bezieht sich „diese Technologie“ auf nichts. Eine eigenständige Fassung nennt das Subjekt und eine überprüfbare Tatsache:
Google AI Overviews und AI Mode können eine Seite nur dann als unterstützenden Link zeigen, wenn die Seite indexiert ist und in der Google-Suche mit einem Snippet erscheinen darf.
Der zweite Satz nennt die Produkte, die Bedingung und das Ergebnis. Er lässt sich allein zitieren, ohne seine Bedeutung zu ändern. Suganthan fügt eine ehrliche Einschränkung hinzu: Er hat nicht nachgewiesen, dass eigenständige Sätze häufiger zitiert werden. Behandeln Sie das also als redaktionelle Prüfung, nicht als Rankingfaktor.
Warum der erste Satz unter der Überschrift zählt
Lumar nennt „frühe Klarheit“ unter den Merkmalen, die generative Systeme bevorzugen könnten: Die Kerninformation steht am Anfang. Ein Abschnitt, der mit einer Anekdote oder einer rhetorischen Frage beginnt, kommt später zur Sache, und eine aus der Seite herausgelöste Passage enthält die späteren Sätze womöglich nicht.
Mit der Antwort zu beginnen (BLUF, Bottom Line Up Front) ist ein einfacher Weg, das umzusetzen. Der erste Satz unter einer Überschrift liefert die Definition oder das Urteil. Die folgenden Sätze ergänzen Messwerte, Grenzfälle und Implementierungsdetails.
Welche konkreten Fakten besser wirken als Marketing-Adjektive
Wörter wie revolutionär, bahnbrechend, nahtlos oder Next-Generation enthalten keine überprüfbare Information. Lumars Merkmal „dichte Fakten“ und der Prüfpunkt „nötige Fakten“ weisen in dieselbe Richtung. Leichter zitierbare Abschnitte enthalten meist:
- Messwerte mit Einheiten (Millisekunden, Megabyte, Anfragen pro Sekunde).
- Genaue Namen und Versionen von Software, Protokollen und Spezifikationen (HTTP/3, PHP 8.4, OAuth 2.1, RFC 9110).
- Die Bedingungen, unter denen eine Aussage gilt, und die Ursache hinter einem Ergebnis.
Warum sich Tabellen und Spezifikationen für KI-Zitate eignen
Zu Lumars Beispielen für Abschnitte, die eher zitiert werden, gehören Schritt-für-Schritt-Anleitungen und Spezifikationen. Beide enthalten Fakten, die für sich allein verständlich sind, und genau das leistet auch eine Vergleichstabelle. Wir haben keine veröffentlichte Studie gefunden, die misst, um wie viel häufiger Tabellen als Fließtext zitiert werden. Das Argument für eine Tabelle ist daher Klarheit: Wenn der Inhalt mehrere Elemente anhand derselben Merkmale vergleicht, zeigt eine Tabelle das, ohne dass jemand Sätze entwirren muss.
Die folgende Tabelle stellt Annahmen der klassischen SEO dem gegenüber, was die genannten Quellen über generative Suche sagen:
| Dimension | Klassischer SEO-Fokus | Generative Suche laut den genannten Quellen |
|---|---|---|
| Ziel | Platzierung in der Linkliste | Eine Seite, auf die die Antwort als Beleg verlinkt |
| Genutzte Einheit | Gesamte URL | Konkrete Abschnitte (Lumar, aus Erfahrung) |
| Wie eine Seite gefunden wird | Anfrage gegen den Index | Mehrere verwandte Anfragen pro Frage (Google, Ahrefs) |
| Voraussetzung | Indexiert und mit Snippet angezeigt | Dasselbe, plus Aufnahme der Website in die generativen KI-Funktionen in der Search Console (Google) |
| Strukturierte Daten | Berechtigung für Rich Results | Nicht erforderlich, kein spezielles Markup für KI-Funktionen (Google) |
| Masse als Taktik | Seiten pro Keyword-Variante | Seiten pro Fan-out-Anfrage gelten als Missbrauch skalierter Inhalte, wenn sie manipulieren sollen (Google) |
| Messung | Impressionen und Klickrate | Bericht zur Leistung generativer KI in der Search Console, dazu Zitat-Tracking in Drittanbieter-Tools |
Wie man die eigene Website mit Wikidata verbindet, damit Entitäten eindeutig sind
Google beschreibt Wikidata nicht als Vertrauenssignal für Gemini oder AI Mode. Sein Leitfaden sagt, dass strukturierte Daten für die generative KI-Suche nicht erforderlich sind und kein spezielles schema.org-Markup nötig ist, empfiehlt strukturierte Daten aber als Teil normaler SEO für Rich Results. Was Suganthan Mohanadasan tatsächlich über Gemini dokumentiert, ist praktischer:
- Die Gemini-API liefert
groundingMetadatamit den Suchanfragen, die Gemini formuliert hat (webSearchQueries), den genutzten Seiten (groundingChunks) und den Verknüpfungen zwischen diesen Seiten und Teilen der Antwort (groundingSupports). - Die zitierten Quellen wechseln zwischen Durchläufen derselben Frage, ein einzelner Test ist also eine Anekdote. Er lässt jede Anfrage fünfmal laufen und zählt Wiederholungen.
- In seinen Tests im September wurden Publisher, deren robots.txt Google-Extended sperrte, in 0 von 10 Durchläufen zitiert, Publisher ohne Sperre in 6 von 6.
JSON-LD-Code mit Wikidata-Entitäten für WordPress und Astro
Die Themen eines Artikels mit Wikidata-QIDs zu verknüpfen, hilft weiterhin bei der Eindeutigkeit: Astro als Framework und Astro als Firmenname sind dann nicht mehr dieselbe Zeichenkette. Diese Website nutzt dafür about und mentions. knowsAbout gehört zu Person oder Organization, nicht zu einem Artikel:
{
  "@context": "https://schema.org",
  "@type": "TechArticle",
  "headline": "Query fan-out und zitierbare Abschnitte in der KI-Suche",
  "description": "Technischer Leitfaden zu Query fan-out und eigenständigen Inhaltsabschnitten.",
  "inLanguage": "de",
  "author": {
    "@type": "Organization",
    "name": "wppoland.com",
    "url": "https://wppoland.com",
    "knowsAbout": [
      {
        "@type": "Thing",
        "name": "Search engine optimization",
        "sameAs": "https://www.wikidata.org/wiki/Q180711"
      },
      {
        "@type": "Thing",
        "name": "Web development",
        "sameAs": "https://www.wikidata.org/wiki/Q386275"
      }
    ]
  },
  "about": [
    {
      "@type": "Thing",
      "name": "Large language model",
      "sameAs": "https://www.wikidata.org/wiki/Q115305900"
    },
    {
      "@type": "Thing",
      "name": "Information retrieval",
      "sameAs": "https://www.wikidata.org/wiki/Q816826"
    }
  ]
}
Das Markup macht klar, um welche Entitäten es im Artikel geht. Zitate bringt es für sich genommen nicht, und Google sagt das auch.
Was KI-Suchcrawler und KI-Anbieter erwarten
Für Teams, die an generativer Suche arbeiten, haben sich 2026 zwei Dinge geändert. Auf der Regelseite weist Mike King von iPullRank darauf hin, dass das Update der Nutzungsrichtlinie von Anthropic für 2026, veröffentlicht am 8. Oktober und gültig ab 12. November, verbietet, Claude zur Manipulation der Quellen einzusetzen, aus denen Suchmaschinen oder KI-Systeme ihre Antworten beziehen, etwa mit Netzwerken von Websites, die sich als unabhängig ausgeben (iPullRank). Derselbe Artikel erinnert daran, dass Google massenhaft erzeugte Seiten für Fan-out-Anfragen als Missbrauch skalierter Inhalte behandelt. Beide Regeln zielen auf dasselbe Vorgehen: vorgetäuschte Unabhängigkeit und Seiten aus der Massenproduktion.
Auf der technischen Seite ist das Rendering die Grenze. Vercel und MERJ berichteten im Dezember 2024, dass keiner der großen KI-Crawler JavaScript ausführte, auch nicht die von OpenAI und Anthropic, während Gemini die Infrastruktur von Googlebot nutzt und vollständig rendert (Vercel).
Wie Inhalte ausgeliefert werden sollten, damit KI-Crawler sie lesen können
Damit die Crawler hinter ChatGPT, Claude und Perplexity den Inhalt sehen, sollte die Infrastruktur drei Grundsätze einhalten:
- Inhalt im Server-HTML: Eine Single-Page-Anwendung, die einen leeren Container erst im Browser füllt, zeigt diesen Crawlern eine leere Seite. Statische Ausgabe aus Astro, serverseitiges Rendering oder ein klassisches WordPress-Theme senden den Text schon in der ersten Antwort.
- Semantisches HTML, wo es passt:
article,section,headerund Definitionslisten (dl,dt,dd) markieren Themengrenzen klarer alsdiv-Elemente mit Utility-Klassen. Googles Leitfaden ergänzt, dass perfekt semantisches HTML nicht erforderlich ist und vor allem Menschen mit Screenreadern hilft. - Prüfen, was der Crawler erhalten hat: Rufen Sie die Seite ohne JavaScript ab (curl oder das URL-Prüftool für Googlebot) und stellen Sie sicher, dass der Text vorhanden ist.
Wie man Faktenkarten in WordPress und Astro implementiert
Eine Faktenkarte ist ein redaktionelles Muster, kein Rankingsignal: ein Kasten, der eine Tatsache mit Einheit, Bedingungen und Quelle nennt, damit die Aussage auch allein zitiert noch stimmt. Er entspricht direkt Lumars Prüfpunkt „nötige Fakten“. Quelle und Messwert als Pflichtfelder verhindern, dass eine Aussage ohne sie veröffentlicht wird.
Hier ist eine Astro-Komponente für dieses Muster:
---
interface Props {
  entityName: string;
  claim: string;
  metric: string;
  sourceUrl: string;
  sourceName: string;
}

const { entityName, claim, metric, sourceUrl, sourceName } = Astro.props;
---

<aside class="fact-card my-6 p-6 border-l-4 border-emerald-600 bg-slate-50 dark:bg-slate-900 rounded-r-lg">
  <p class="text-xs font-mono uppercase tracking-wider text-slate-500 mb-2">{entityName}</p>
  <p class="text-lg font-semibold text-slate-900 dark:text-slate-100 mb-2">{claim}</p>
  <p class="text-sm font-medium text-emerald-700 dark:text-emerald-400">
    <strong>{metric}</strong>, source: <a href={sourceUrl}>{sourceName}</a>
  </p>
</aside>
Die Karte wird als einfaches HTML in der Serverantwort ausgeliefert. Sie verzichtet bewusst auf ClaimReview-Markup: Dieser Typ ist für Faktencheck-Organisationen gedacht, die Aussagen anderer prüfen, nicht für eigene Aussagen eines Publishers.
Wie man einen Faktenkarten-Block in WordPress Gutenberg registriert
In WordPress funktioniert dasselbe Muster als eigener Gutenberg-Block oder ACF-Block. Die PHP-Vorlage sollte nichts ausgeben, wenn ein Pflichtfeld leer ist, statt Fülltext zu erfinden:
<?php
/**
 * ACF block template: fact card
 *
 * @param array $block Block settings and attributes.
 */

$entity_name = get_field( 'fact_entity_name' );
$core_claim  = get_field( 'fact_claim' );
$metric      = get_field( 'fact_metric' );
$source_url  = get_field( 'fact_source_url' );

if ( ! $core_claim || ! $source_url ) {
    return;
}
?>
<section class="fact-card border border-slate-200 p-5 rounded my-4">
    <h3 class="text-base font-bold text-slate-800 mb-1"><?php echo esc_html( $entity_name ); ?></h3>
    <p class="text-slate-700 text-sm leading-relaxed mb-3"><?php echo esc_html( $core_claim ); ?></p>
    <p class="text-xs font-mono text-emerald-700">
        <strong><?php echo esc_html( $metric ); ?></strong>,
        <a href="<?php echo esc_url( $source_url ); ?>"><?php esc_html_e( 'source', 'textdomain' ); ?></a>
    </p>
</section>
So kann niemand im Redaktionsteam eine Karte ohne Aussage und Quelle veröffentlichen.
Wie man sauberes Markdown für KI-Crawler über Cloudflare Workers bereitstellt
Manche KI-Agenten fordern mit dem Header Accept: text/markdown Markdown an. wppoland.com beantwortet solche Anfragen aus der Middleware von Cloudflare Pages, die auf Workers läuft: Sie entfernt Skripte, Styles und Navigation aus dem gerenderten HTML und liefert den Hauptinhalt als Markdown, mit einem kanonischen Link-Header auf die HTML-Seite.
- Kleinere Antwort: Eine einzelne Anfrage an die englische Fassung dieses Artikels am 17. Oktober 2026 ergab 248.112 Byte unkomprimiertes HTML und 27.215 Byte Markdown.
- Weniger Layout-Ballast: Überschriften, Listen und Tabellen kommen als Markdown-Struktur statt als verschachteltes Markup an.
- Gleiche URL, eigener Cache-Eintrag: Die HTML-Antwort trägt
Vary: Accept, damit Caches Browsern nicht die Markdown-Fassung ausliefern.
Die Google-Suche nutzt das nicht. Ihr Leitfaden sagt, dass weder Markdown noch andere spezielle Dateien nötig sind, um in der Google-Suche zu erscheinen, auch nicht in ihren generativen KI-Funktionen. Die Markdown-Antwort ist für andere Agenten gedacht, die sie anfordern.
Welche B2B-Fragen Entscheider im DACH-Raum an KI-Suchmaschinen stellen
Im deutschsprachigen Raum berühren B2B-Anfragen häufig Compliance, Datenschutz und bestehende ERP-Landschaften. Eine typische Frage könnte so lauten:
Wie lässt sich WooCommerce für B2B-Bestellungen mit SAP S/4HANA synchronisieren, unter Einhaltung der DSGVO und mit Serverstandort Frankfurt?
Ein Fan-out für diesen Prompt könnte ihn in Suchanfragen wie diese aufteilen:
- WooCommerce SAP OData Schnittstelle Durchsatz B2B Kundenpreise
- DSGVO konformes Server-Side Tracking WooCommerce ohne Drittlandtransfer
- Cloudflare Pages Rechenzentrum Frankfurt Datenresidenz EU Entkopplung
- WooCommerce B2B Staffelpreise API Performance bei 50000 Artikeln
Eine allgemeine Übersichtsseite zur Shoperstellung hat jeder dieser Suchanfragen wenig zu bieten. Googles Leitfaden empfiehlt Inhalte, die keine Massenware sind und auf eigener Erfahrung beruhen, und Ahrefs berichtet, dass ChatGPT Zitate von zusammenfassenden Seiten zu den Quellen verlagert, die Informationen selbst erzeugen. Für einen Integrator heißt das: dokumentieren, was nur das eigene Team gemessen hat, also konkrete Systemgrenzen, Datentransferpfade und Lastgrenzen.
Wie Edge-Caching bei hoher Crawler-Last hilft
Crawler wie GPTBot und ClaudeBot erzeugen zusätzliche Last auf Hosting-Setups, und dynamische PHP-Prozesse in WordPress reagieren auf Lastspitzen empfindlicher als statisch ausgelieferte Seiten. Das hat wenig mit dem Fan-out in Google zu tun: Wie oben beschrieben, liest das Grounding von Gemini Googles Index und nicht die Live-Seite. Es betrifft die Crawler und Abrufe, die Seiten direkt anfordern.
Für entkoppelte Architekturen mit Cloudflare und Astro gelten drei Leitlinien:
- Stale-While-Revalidate: Mit einem Header wie
Cache-Control: public, max-age=3600, stale-while-revalidate=86400(RFC 5861) darf ein Cache eine leicht veraltete Kopie ausliefern, während er im Hintergrund eine neue holt, sodass Crawler-Anfragen nicht bis zu PHP durchschlagen. - Gezielte Invalidierung per Cache-Tag: Bei Änderungen im WordPress-Backend werden nur die betroffenen Cache-Tags über die Cloudflare-API geleert, statt den gesamten CDN-Speicher zu leeren. Unveränderte Fachartikel bleiben im Cache.
- Keine versehentlichen Sperren: Sicherheits-Plugins und WAF-Regeln können intensive Crawler-Aktivität als Angriff einstufen. Prüfen Sie, dass die Crawler, deren Zugriff Sie wollen, nicht pauschal geblockt werden.
Wie man die eigene Website in 6 Schritten auf KI-Suchmaschinen prüft
Um zu prüfen, ob Inhalte diesen Standards entsprechen, führen Sie diese sechsstufige Prüfung durch:
+-------------------------------------------------------------------+
|               PRÜFABLAUF ZITIERBARKEIT VON ABSCHNITTEN            |
+-------------------------------------------------------------------+
                                  |
                                  v
         [ SCHRITT 1: Pronomen am Absatzanfang ]
                 ("es", "dies", "wie oben" ersetzen)
                                  |
                                  v
       [ SCHRITT 2: Antwort zuerst unter Überschriften ]
              (Definition oder Urteil im ersten Satz)
                                  |
                                  v
     [ SCHRITT 3: Tabellen für Vergleiche und Spezifikationen ]
               (Gleiche Merkmale verglichen? Tabelle nutzen)
                                  |
                                  v
        [ SCHRITT 4: Entitäten-Markup prüfen ]
               (QIDs in about und mentions passen zum Text)
                                  |
                                  v
       [ SCHRITT 5: Wiederholte Prompt-Tests ]
               (Mehrere Durchläufe pro Anfrage, Wiederholungen zählen)
                                  |
                                  v
     [ SCHRITT 6: Crawler-Zugang und Logs ]
(robots.txt, CDN-Regeln, GPTBot, ClaudeBot)- Pronomen-Prüfung: Prüfen Sie die Absatzanfänge. Beginnt ein Abschnitt mit es, sie, dieser Ansatz oder wie oben erwähnt, ersetzen Sie das Pronomen durch den Namen der Technologie oder des Begriffs.
- Antwort zuerst: Prüfen Sie, ob der erste Satz unter jeder H2- und H3-Überschrift die Antwort nennt, bevor Hintergrund folgt.
- Tabellen-Prüfung: Wo ein Abschnitt mehrere Elemente anhand derselben Merkmale vergleicht (Parameter, Tarife, Benchmarks), verwenden Sie eine HTML-Tabelle.
- Entitäten-Markup: Prüfen Sie, ob die QIDs in
aboutundmentionsauf die Entitäten verweisen, um die es im Text tatsächlich geht. - Wiederholte Prompt-Tests: Geben Sie die verwandten Suchanfragen mehrmals in Perplexity, ChatGPT Search und Gemini ein, weil Zitate zwischen Durchläufen wechseln. Für Googles eigene Funktionen nutzen Sie den Bericht zur Leistung generativer KI in der Search Console.
- Zugang und Logs: Prüfen Sie, ob die Website in der Search Console in die generativen KI-Funktionen aufgenommen ist, ob robots.txt und CDN-Regeln die gewünschten Crawler zulassen (Googlebot, OAI-SearchBot, PerplexityBot, ClaudeBot), und beobachten Sie in den Server-Logs deren Statuscodes und Crawl-Frequenz.
Wie man Webinhalte für generative Suchsysteme konzipiert
Generative Suche ersetzt technische SEO nicht. Googles eigene Position lautet, dass Optimierung für die generative KI-Suche weiterhin SEO ist: Eine Seite muss indexiert sein und für ein Snippet in Frage kommen, und Chunking, llms.txt oder spezielles Markup sind nicht erforderlich. Die veröffentlichten Daten zum Fan-out sind enger als die Behauptungen darum herum: Das kostenlose ChatGPT-Modell suchte in der Ahrefs-Stichprobe bei 14,4 Prozent der Antworten im Web, und die von Gemini zitierten Quellen wechseln von Durchlauf zu Durchlauf.
Was über alle Quellen hinweg trägt, ist schlicht: Abschnitte, die eine Frage in eigenen Worten beantworten, Fakten mit Einheiten und Quellen, Inhalt im Server-HTML und Informationen, die das Team selbst gemessen hat, statt fremde zusammenzufassen.