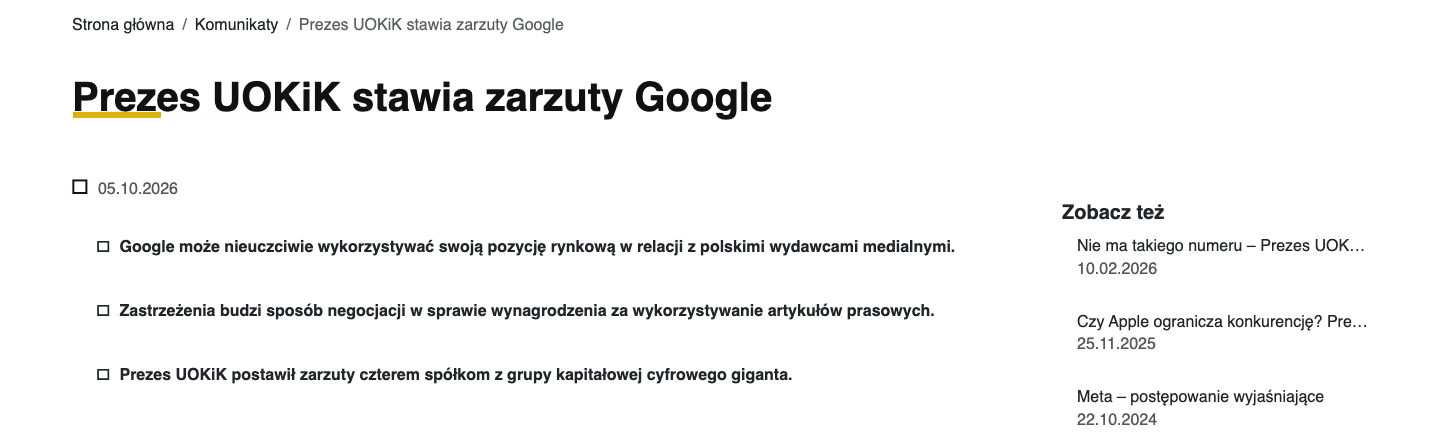
Am 5. Oktober 2026 hat der UOKiK-Präsident Vorwürfe gegen vier Unternehmen der Google-Gruppe in Bezug auf die Verhandlungen mit Presseverlegern über Zahlungen für die Nutzung ihrer Artikel erhoben. Das Verfahren betrifft die Google-Suchmaschine, Google News und Google Discover. Diese Vorwürfe betreffen den polnischen Markt und polnische Presseverleger; die Mechanik der Steuerungsmöglichkeiten gilt jedoch für jede Website. Für einen Verleger, der ein Portal auf WordPress betreibt, ändert sich heute auf technischer Ebene nichts an Datenverkehr oder Indexierung. Der Kontext von Vergütungsverhandlungen ändert sich, und einige Einstellungen, die ein Verleger selbst kontrolliert, lohnt es sich jetzt durchzugehen, bevor jemand sie unter dem Eindruck von Schlagzeilen ändern könnte.
Was das UOKiK Google vorwirft
Die Vorwürfe betreffen Daten, die Verleger nicht erhielten. Die Mitteilung des Amtes beschreibt dies wie folgt:
“Aus den Informationen, die dem Amt vorliegen, geht hervor, dass Google den Verlegern bei seinem Vergütungsangebot nicht die gesetzlich vorgeschriebenen Daten vorgelegt hat, mit denen sich die angebotenen Sätze bewerten lassen.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5. Oktober 2026, eigene Übersetzung
Das Amt führt auf, was konkret fehlte: Informationen darüber, wie Google Presseerzeugnisse nutzt und welche Einnahmen es daraus erzielt, eine Erklärung der Parameter, die in die Berechnung einflossen, sowie Dokumente, um die Annahmen zu überprüfen. Das Ergebnis nennt das UOKiK Informationsasymmetrie: Der Verleger kann nicht beurteilen, ob das Angebot rentabel ist, noch kann er einen eigenen, auf Daten gestützten Gegenvorschlag machen.
Der Rechtsvorwurf ist der Verdacht eines Missbrauchs einer beherrschenden Stellung. Das Innehaben einer solchen Stellung ist nicht verboten. Verboten ist die Ausnutzung dieser Stellung, um Vertragspartnern Bedingungen aufzuzwingen, die von der Plattform abhängig sind. Die Mitteilung unterstreicht, dass Verleger auf Google als Kanal zu ihren Lesern angewiesen sind und nicht über umfassendes Wissen über den Wert ihrer genutzten Inhalte verfügen.
Die Vorwürfe betreffen vier Unternehmen:
| Unternehmen | Rolle nach UOKiK-Mitteilung |
|---|---|
| Alphabet Inc. | Muttergesellschaft der Google-Gruppe |
| Google LLC | Werbedienste, früher Betreiber der Google-Suchmaschine im EWR |
| Google Ireland Limited | aktueller Betreiber und Manager der Google-Suchmaschine im EWR-Gebiet |
| Google Poland | Verkauf von Werbeflächen im Internet |
UOKiK-Präsident Tomasz Chróstny bewertet die Folgen der fehlenden Daten in einer Stellungnahme zur Mitteilung so:
“Das Fehlen dieser Daten führte zu einer Situation, in der die Verhandlungen scheinhaft wurden und darauf abzielten, dass der marktbeherrschende Akteur Bedingungen durchsetzte.”
Tomasz Chróstny, UOKiK-Präsident, Mitteilung des UOKiK, 5. Oktober 2026, eigene Übersetzung
Auf welcher Grundlage können Verleger Zahlungen von Google verlangen
Die Grundlage ist eine Urheberrechtsreform von 2024, die die Richtlinie (EU) 2019/790, genannt DSM-Richtlinie, umsetzt. Das Recht der Verleger auf Vergütung folgt aus deren Artikel 15. Nach der Mitteilung des UOKiK ermöglichen die Bestimmungen Online-Diensten, Presseerzeugnisse im Gegenzug für eine Vergütung zu nutzen, und die Plattform ist verpflichtet, dem Verleger die für die Festsetzung der Vergütungshöhe erforderlichen Informationen zur Verfügung zu stellen. Diese Informationspflicht ist genau das, was das Amt dem Unternehmen zufolge nicht erfüllt hat.
Artikel 15 der Richtlinie hat mehrere Grenzen, die ein WordPress-Verleger kennen sollte, denn sie bestimmen, ob er überhaupt eine Partei in diesem Gespräch ist:
- Das Recht erstreckt sich nicht auf Hyperlinks oder die Nutzung einzelner Wörter oder sehr kurzer Textausschnitte aus Veröffentlichungen.
- Es erstreckt sich nicht auf private oder nicht kommerzielle Nutzung durch einzelne Benutzer.
- Es erlischt zwei Jahre nach Veröffentlichung, gerechnet vom 1. Januar des auf die Veröffentlichung folgenden Jahres.
- Autoren von Texten müssen einen angemessenen Anteil an den Einnahmen erhalten, die der Verleger aus dieser Quelle erhält.
Eine separate Frage ist die Definition. Artikel 2 Absatz 4 der Richtlinie definiert eine Presseveröffentlichung als eine Sammlung, die hauptsächlich aus Werken literarischer Natur mit journalistischem Charakter besteht und als Einzelausgabe einer periodischen oder regelmäßig aktualisierten Veröffentlichung unter einem einzigen Titel veröffentlicht wird, mit dem Ziel, die Allgemeinheit zu informieren, auf Initiative und unter redaktioneller Verantwortung des Diensteanbieters. Wissenschaftliche Zeitschriften sind ausdrücklich ausgeschlossen. In der Praxis erfüllt ein regelmäßig gepflegtes Portal mit lokalen Nachrichten und Redaktion diese Definition leichter als ein Unternehmens-Blog, der Verkaufsartikel veröffentlicht. Die Grenzen des konkreten Falls bewertet ein Anwalt, nicht die Person, die WordPress konfiguriert.
Sollten sich die Parteien nicht einigen, sehen die Bestimmungen einen Schiedsrichter vor. Das UOKiK macht jedoch darauf aufmerksam, dass es nicht selbst eine Partei ist:
“Wichtig ist zu vermerken, dass der UOKiK-Präsident keine Partei in den Verhandlungen oder in Streitigkeiten zwischen Google und Presseverlegern ist.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5. Oktober 2026, eigene Übersetzung
Nach derselben Mitteilung bewertet das Amt nicht, ob der angebotene Satz angemessen ist. Kommt es zu keiner Einigung zwischen den Parteien, kann der Präsident der Behörde für elektronische Kommunikation die Vergütungshöhe festsetzen. Das Verfahren des UOKiK betrifft daher die Art der Verhandlungsführung, nicht den Betrag.
Betreffen die UOKiK-Vorwürfe AI Overviews
Nein, und das macht die Mitteilung selbst klar. Die Einleitung beschreibt das Phänomen breiter: Leser bleiben bei Textausschnitten in Suchergebnissen oder bei einer von künstlicher Intelligenz erstellten Zusammenfassung von Artikeln stecken und klicken nicht auf den Link. Das Amt grenzt den Umfang des Verfahrens jedoch eng ein. Die auf künstlicher Intelligenz basierenden Dienste von Google prüft die Europäische Kommission, die im Dezember 2025 ein formales Verfahren eingeleitet hat, um zu untersuchen, ob Google die Inhalte von Verlegern in solchen Diensten ohne angemessene Vergütung und ohne Möglichkeit zum Widerspruch nutzt. Das UOKiK schreibt:
“Der Untersuchungsgegenstand der KE unterscheidet sich von dem vom UOKiK-Präsidenten eingeleiteten Kartellverfahren.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5. Oktober 2026, eigene Übersetzung
Das Verfahren der polnischen Behörde umfasst die Nutzung von Verlagsinhalten in Google-Suchergebnissen sowie in Google News und Discover. Beide Verfahren sind unabhängig, was laut Mitteilung vor Einleitung des Hauptverfahrens mit der Kommission abgestimmt wurde.
Was die Vorwürfe für einen WordPress-Verleger heute ändern
Auf technischer Ebene nichts. Vorwürfe sind ein Stadium eines kartellrechtlichen Verfahrens, keine Entscheidung. Eine Geldbuße von bis zu 10 Prozent des Umsatzes ist die gesetzlich vorgesehene Obergrenze, und die Mitteilung vermerkt, dass die Haftung der einzelnen Unternehmen erst während des Verfahrens analysiert wird. Rankings, Indexierung, Discover und Suchmaschinen-Datenverkehr funktionieren morgen genauso wie gestern.
Der Kontext von Verhandlungen um Geld ändert sich. Die Mitteilung besagt, dass Google keine Verträge mit den meisten polnischen Presseverlegern unterzeichnet hat und dass Bedenken wegen der Art bestehen, in der das Unternehmen mit Organisationen, die Verleger vertreten, verhandelt hat. Ein Verleger, der einer solchen Organisation angehört, hat ab sofort eine öffentliche Position der Behörde, dass die Forderung nach Daten zur Inhaltsnutzung und Einnahmen eine gesetzliche Forderung ist. Ein Verleger, der zu keiner Organisation gehört, sollte zumindest wissen, wer in seinem Namen verhandelt oder ob jemand dies tut.
Die zweite Änderung ist das Risiko voreiliger Entscheidungen. Nach einem spektakulären Fall mit Google-Beteiligung ist es verlockend, “Google in robots.txt abzuschneiden” oder massenhaft noindex hinzuzufügen. Der Verleger verliert dadurch Datenverkehr und gewinnt keine Verhandlungsargumente. Die Vergütung nach Artikel 15 steht dem Verleger für die Nutzung von Veröffentlichungen in der Suche, in News und in Discover zu. Eine aus der Suchmaschine entfernte Seite wird nicht mehr Gegenstand dieser Verhandlung.
Was der Verleger selbst kontrolliert: Content-Signal, Google-Extended und Search Console
Der Verleger hat heute drei separate Mechanismen, um Einfluss darauf zu nehmen, was Google mit seinen Inhalten tut, und einen vierten, der wie ein Hauptschalter funktioniert.
| Mechanismus | Wo wird es konfiguriert | Was beeinflusst es | Was beeinflusst es nicht |
|---|---|---|---|
| Steuerung von Search generative AI | Search Console, Einstellungen | AI Overviews, AI Mode, generative Funktionen in Discover | Rankings, KI-Training |
| Google-Extended | robots.txt | Training und Grounding von Gemini-Modellen außerhalb der Suchmaschine | Präsenz in Google Search, Rankings |
| Content-Signal | robots.txt | Erklärung der Zustimmung zu search, ai-input, ai-train | blockiert technisch nichts |
| noindex | meta robots oder HTTP-Header | entfernt URL vollständig aus Google Search | nichts bleibt in der Suchmaschine |
Steuerung von Search generative AI in Search Console
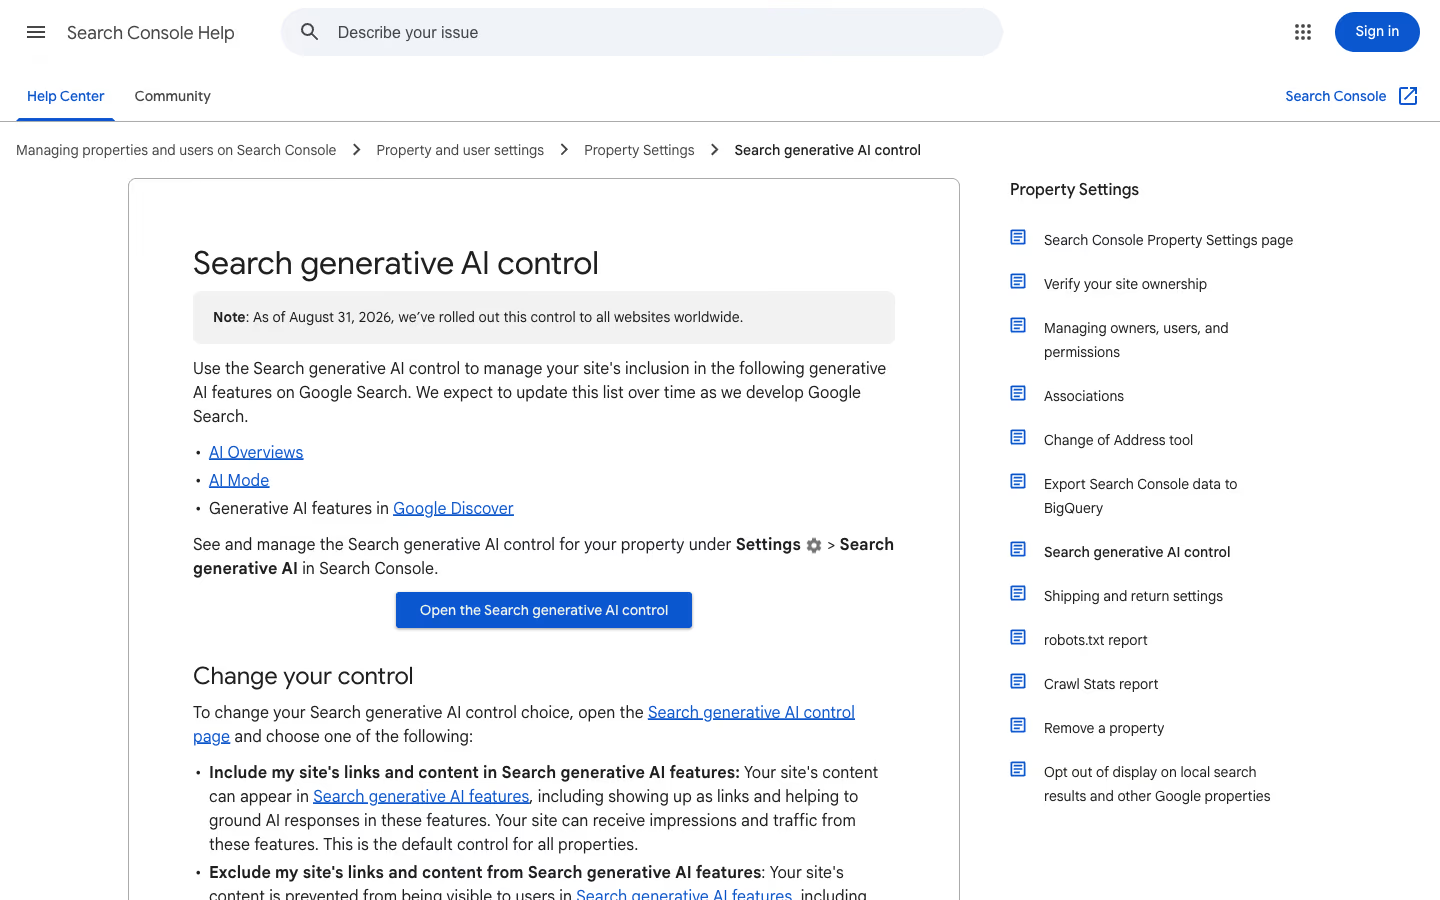
Dies ist die neueste dieser Einstellungen. Google beschreibt sie in der Hilfe zu Search Console und nennt das Veröffentlichungsdatum:
“Seit dem 31. August 2026 haben wir diese Steuerung für alle Websites weltweit eingeführt.”
Google, Search generative AI control, Search Console Help, eigene Übersetzung
Die Steuerung ist für alle Websites weltweit verfügbar. Sie umfasst AI Overviews, AI Mode und generative Funktionen in Google Discover. Standardmäßig ist die Website eingeschlossen. Nach dem Ausschließen wird der Inhalt weder als Link noch als Quelle für das Grounding von Antworten in diesen Funktionen angezeigt, und Google vermerkt, dass die Änderung normalerweise innerhalb weniger Tage wirkt, in manchen Fällen aufgrund von Cache länger dauert. Die Einstellung wird vererbt: Eine URL-Präfix-Property, etwa ein separater Bereich der Website, übernimmt sie von ihrer übergeordneten Property, es sei denn, der Inhaber legt für sie eine eigene Einstellung fest.
Die wichtigste Einschränkung steht in derselben Dokumentation:
“Diese Steuerung wirkt sich nicht auf das KI-Training aus. Um das Training der Modelle zu begrenzen, die in den Search generative AI-Funktionen verwendet werden, verwenden Sie Google-Extended.”
Google, Search generative AI control, Search Console Help, eigene Übersetzung
Diese Steuerung hat keinen Einfluss auf das KI-Training, und zur Begrenzung des Trainings der in diesen Funktionen verwendeten Modelle verweist Google auf Google-Extended. Prüfen Sie vor einer Änderung der Einstellung den Leistungsbericht zur KI-Funktion in Search Console. Ohne Zahlen von vor der Änderung können Sie nicht beurteilen, wie viel Datenverkehr die Entscheidung gekostet hat.
Google-Extended in robots.txt
Google-Extended ist ein Token in robots.txt, kein separater Crawler. Nach der Dokumentation zu Google-Crawlern hat es keine eigene User-Agent-Zeichenkette in HTTP-Anfragen, daher werden Sie es nicht in den Serverprotokollen sehen. Das Crawling wird von den normalen Google-Robots durchgeführt, und das Token funktioniert als Einstellung. Es betrifft das Training zukünftiger Gemini-Modelle und das Grounding von Antworten in Gemini Apps sowie in Vertex AI. Google versichert, dass es die Präsenz der Website in Google Search nicht beeinflusst und kein Ranking-Signal ist.
Auf WordPress ist robots.txt manchmal eine physische Datei im Stammverzeichnis oder eine von WordPress über die Funktion do_robots() generierte Datei. Die physische Datei hat Vorrang, überprüfen Sie daher zuerst, welche der Server tatsächlich bereitstellt, bevor Sie etwas in das SEO-Plugin-Bedienfeld einfügen. Für die generierte Datei genügt ein Filter:
add_filter( 'robots_txt', function ( $output, $public ) {
    if ( $public ) {
        $output .= "\nUser-agent: Google-Extended\nDisallow: /\n";
    }
    return $output;
}, 10, 2 );Content-Signal und Artikel 4 der Richtlinie
Unsere eigene robots.txt verwendet die Zeile Content-Signal: search=yes, ai-input=yes, ai-train=no, und ein Kommentar darüber zeigt an, dass diese Einschränkungen einen ausdrücklichen Rechtevorbehalt im Sinne von Artikel 4 der Richtlinie 2019/790 darstellen. Artikel 4 ist die Ausnahme für Text und Data Mining, die der Rechteinhaber in maschinenlesbarer Form ausschließen kann. Dies ist eine andere Bestimmung als Artikel 15, auf dem der Streit der Verleger mit Google basiert. Die erste befasst sich mit der Frage, ob es erlaubt ist, Inhalte zum Analysieren und Trainieren zu kopieren. Die zweite befasst sich mit der Frage, ob und wie viel eine Plattform für die Nutzung von Veröffentlichungen in ihren Diensten zahlt. Eine Zeile in robots.txt ist weder ein Vertrag noch ein Vergütungsantrag.
Content-Signal hat auch eine technische Einschränkung, die wir an unserem eigenen Beispiel beschrieben haben: eine Zeile, die nur in der Wildcard-Gruppe platziert ist, erreicht Crawler nicht, die eigene Abschnitte in der Datei haben. In unserer Datei steht das Signal heute separat in den Gruppen einzelner Crawler, einschließlich der Google-Extended-Gruppe. Wir haben nicht gemessen, welche Betreiber es respektieren, und behaupten das nicht.
noindex als einziger vollständiger Ausstieg aus der Google-Suche
Die Google-Dokumentation ist klar: Um zu verhindern, dass Inhalte in Google Search angezeigt werden, muss noindex verwendet werden. Auf WordPress setzt seit Version 5.7 ein Filter wp_robots das Meta-Tag robots, und die meisten SEO-Plugins tun dies pro Beitrag oder pro Inhaltstyp. noindex entfernt die Seite aus Ergebnissen, News und Discover, also aus den Diensten, für die der Verleger Vergütung verlangen kann. In Verhandlungen bringt es daher nichts. Es macht Sinn für Tag-Archive, Suchseiten und technische Inhalte, nicht für redaktionelle Artikel.
Website-Einstellungen nach den UOKiK-Vorwürfen prüfen
Überprüfen Sie ein Nachrichtenportal auf WordPress in fünf Schritten:
- Laden Sie
robots.txtvon der Produktionsseite mitcurlherunter und prüfen Sie, ob der Server eine physische Datei oder eine generierte Datei bereitstellt. Cache-Plugins und CDNs können eine alte Version liefern. - Listen Sie die User-Agent-Gruppen auf und prüfen Sie, ob die Erklärungen, um die es Ihnen geht, in jeder Gruppe vorhanden sind, die davon betroffen sein sollte.
- Notieren Sie den Stand des Leistungsberichts zur KI-Funktion in Search Console. Ohne Referenzpunkt können Sie die Auswirkungen einer Änderung nicht beurteilen.
- Entscheiden Sie separat über die Steuerung von Search generative AI für die Domain-Property und für Bereiche, die als eigene Properties eingerichtet sind.
- Überprüfen Sie, wo noindex steht. Ein Template, das versehentlich noindex zu Nachrichtenkategorien hinzufügt, kostet mehr als jede Entscheidung zu KI.
Wenn Sie auch für generierte Antworten optimieren, haben wir den Kontext dieser Entscheidungen in unserem Leitfaden zu GEO beschrieben. Die Deaktivierung der Website für generative Funktionen und die gleichzeitige Optimierung für Zitate in denselben Funktionen sind zwei widersprechende Ziele. Wählen Sie daher bewusst einen aus.
Wie es im UOKiK-Verfahren gegen Google weitergeht
Das Verfahren läuft weiter, und die Mitteilung nennt keinen Entscheidungstermin. Es gibt drei Handlungsfäden zu beobachten. Der erste ist das Verfahren selbst und eine mögliche Entscheidung mit Strafe. Der zweite sind Verhandlungen zwischen Verlegern und Google und eine mögliche Rolle des UKE-Präsidenten, falls es zu keiner Einigung kommt. Der dritte ist das Verfahren der Europäischen Kommission zu KI-Diensten, das AI Overviews direkt betreffen kann, was der polnische Fall nicht tut.
Die Mitteilung ordnet die Angelegenheit in eine breitere Reihe ein: Das UOKiK beendet ein Kartellverfahren gegen Apple und führt gegen Meta ein Vorverfahren zur geänderten Darstellung von Links zu Presseveröffentlichungen. Die technischen Einstellungen der Website ändert der Verleger selbst innerhalb einer Stunde und kann die Auswirkungen in Search Console messen. Das Recht auf Vergütung ergibt sich aus dem Gesetz und wird in Verhandlungen, vor dem UKE-Präsidenten oder indirekt in einem Verfahren des UOKiK entschieden.