Jeder der acht unten beschriebenen Defekte lief durch ein Skript oder einen Agenten, der seine Arbeit mit einer Erfolgsmeldung beendete. Keiner warf eine Exception. Alle gingen in Produktion, auf einer mehrsprachigen Website, die wir seit Jahren bauen und betreiben, und alle haben wir erst gefunden, als wir das Ergebnis mit etwas anderem verglichen als mit dem Bericht des Werkzeugs selbst.
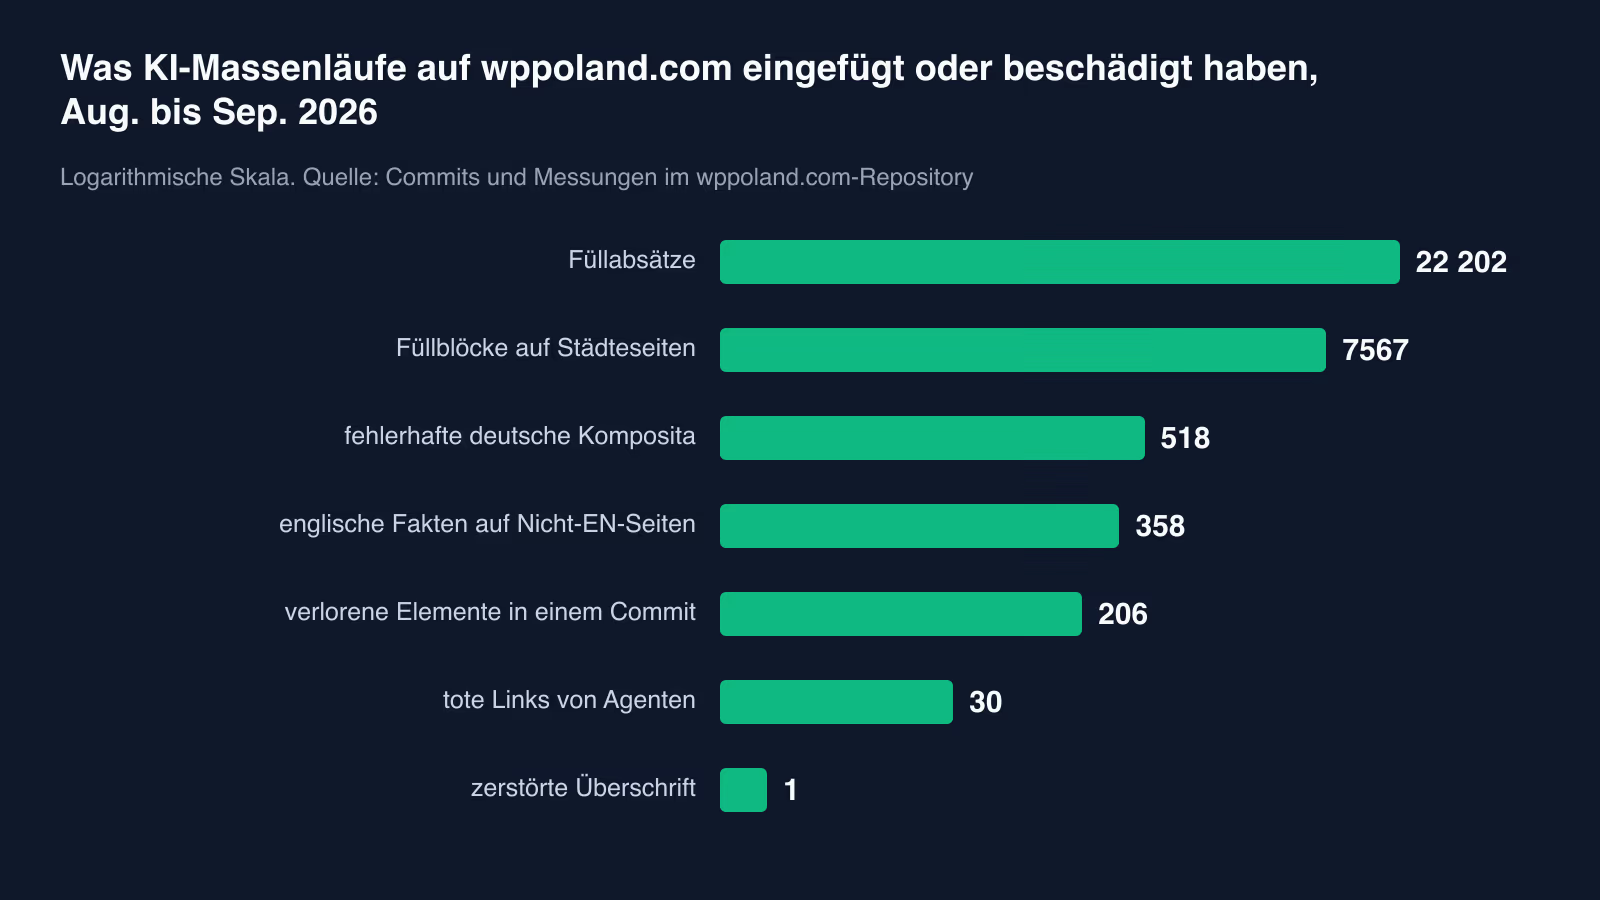
Kurz gesagt: Zwischen August und September 2026 haben KI-Massenläufe 22 202 Absätze Fülltext auf unsere Website gebracht, eine Überschrift zerstört, 358 englische Sätze auf Seiten in fünf anderen Sprachen und 518 fehlerhafte deutsche Komposita hinterlassen. Agenten, die Städteseiten schrieben, fügten erfundene Case Studies und 30 Links zu Seiten hinzu, die es nicht gibt. Wir beschreiben den Mechanismus jedes Defekts und das Gate, das ihn heute abfängt.
Wir schreiben über unsere eigene Website, weil wir nur hier die vollständigen Daten haben: Commit, Dateianzahl, Zustand vorher und nachher. Search Engine Land hat diese Woche einen Text über zehn Wege veröffentlicht, auf denen Claude SEO entgleisen lassen kann, wenn niemand seine Arbeit prüft. Das hier ist die Version mit Belegen.
Umfang und Kontext
wppoland.com läuft auf Astro und wird statisch in sechs Sprachen gebaut: Polnisch, Englisch, Deutsch, Norwegisch, Portugiesisch und Spanisch. Der letzte Produktions-Build vom 29. September 2026 erzeugte 13 733 Seiten. Die Inhalte entstehen und werden überarbeitet durch Coding-Agenten und durch Node-Skripte, die Tausende Dateien auf einmal durchlaufen. Wir haben über 70 Qualitäts-Gates in CI und lokal.
Trotzdem ist jeder der beschriebenen Defekte durch alle Gates gekommen. Der Grund ist jedes Mal derselbe, und wir kommen am Ende darauf zurück.
| Defekt | Was in Produktion ging | Wie wir es gefunden haben | Gate heute |
|---|---|---|---|
| Auffüllen auf eine Wortzahl | 22 202 Absätze in 873 Dateien | 59 Kopien eines Absatzes auf einer Live-Seite | check:no-batch-filler |
| Fülltext der Städteseiten | 7567 Blöcke in 2621 Dateien | Nummerierte Überschriften “Ateny (1)” bis “Ateny (26)“ | dasselbe, auf Städte erweitert |
| Preis-Regex | 1 zerstörte Überschrift | Scanner für zusammengeklebte Wörter | check:glued-words |
| Übersetzung nur der Konjunktionen | 358 englische Sätze in 104 Dateien | Vergleich mit dem englischen Gegenstück | Detektor auf Basis der wpId |
| Begriffsersetzung ohne Komposita | 518 Komposita in 356 Dateien | Manuelles Lesen der Seite | Suche nach der Klasse, nicht nach dem Literal |
| Erfundene Case Studies | 13 Seiten, 30 tote Links | Review der Agenten vor der Veröffentlichung | Validierung interner Links |
| Deploy, der den alten Cache aufgewärmt hat | 5 von 6 Startseiten mit altem Inhalt | Vergleich des Inhalts, nicht der HTTP-Codes | zweiter Purge nach dem Smoke-Test |
| Vertiefung, die Inhalte ersetzt hat | 142 bis 206 Elemente pro Commit | Vergleich mit der vorherigen Dateiversion | check:element-loss |
1. Auffüllen auf eine Wortzahl: 22 202 Absätze
Unsere redaktionellen Richtlinien sagen, dass ein Blogbeitrag etwa 2500 Wörter hat. Das war ein Hinweis für einen Menschen. Eine Serie von Batch-Skripten behandelte ihn als zu erfüllendes Ziel und füllte kürzere Texte mit generiertem Fülltext auf.
Das Ergebnis, gemessen beim Aufräumen am 29. August: 22 202 nummerierte Absätze der Art “Notatka wdrożeniowa 47” (Umsetzungsnotiz 47) in 873 Dateien, bis zu 60 identische Kopien in einem Beitrag, dazu 4 144 Vorlagenabschnitte, rotiert aus einem Pool von fünf pro Sprache. Zwei dieser Abschnitte waren interne redaktionelle Anweisungen, veröffentlicht als Artikeltext. Auf der Live-Seite zu WordPress-Sicherheitsupdates stand derselbe Absatz 59 Mal.
Das Skript hatte keinen Fehler. Es tat genau das, worum man es gebeten hatte: die Wortzahl erhöhen. Der Fehler lag darin, dass die Wortzahl, eine Hilfsgröße, zum Ziel erklärt wurde.
Gate heute: check:no-batch-filler in jedem Lauf von npm run check. Die erste Version suchte nach den Literalen des Generators und ließ Fülltext durch, der mit anderem Wortlaut zurückkam. Die aktuelle Version schaut auf die Form: dieselbe Überschrift zweiter Ebene dreimal in einer Datei ist ein Fehler, unabhängig vom Wortlaut.
2. Städteseiten: derselbe Fülltext, ein anderes Verzeichnis
Die Sammlung der Städteseiten wurde wochenlang von jedem Gate übergangen, weil keines sie scannte. Die Durchläufe 11 bis 14 füllten diese Seiten auf 2200 und dann auf 2500 Wörter auf. Beim Aufräumen am 30. August haben wir 7567 nummerierte Blöcke und rund 21 000 wiederholte Abschnitte aus 2621 Dateien entfernt. Die Seite /pl/woocommerce-programista-ateny/ zeigte Abschnitte von “Ateny (1)” bis “Ateny (26)”.
Schlimmer noch: Einer der Durchläufe hängte an jede Sprache außer Norwegisch Blöcke auf Spanisch an. Polnische, deutsche und portugiesische Städteseiten hatten Abschnitte mit dem Titel “Entrega y seguimiento”.
Die zweite Lektion kam beim Entfernen. Die erste Version des Aufräumskripts verglich ganze Literale und meldete Erfolg, ließ aber 9642 Abschnitte stehen, weil spätere Reparaturskripte diesen Fülltext an Ort und Stelle korrigiert hatten (zum Beispiel die spanische Genusform in 1506 Dateien). Ein exakter Bytevergleich sah keinen einzigen Block, den ein Reparaturskript angefasst hatte. Heute gleichen wir die Überschrift plus die ersten vier Wörter ab.
Nach dem Entfernen des Fülltexts fielen 724 Seiten unter die Schwelle von 2000 Wörtern. Wir haben sie in der Google Search Console geprüft, bevor wir irgendetwas entschieden: Nur 2 hatten in 90 Tagen überhaupt einen Klick, 575 hatten null Impressionen. 723 haben wir auf noindex gesetzt, statt sie wieder aufzufüllen.
3. Der Preis-Regex, der eine Überschrift gefressen hat
Dienstleistungsseiten nennen außerhalb der Preisseite keine Preise, also ersetzte ein Skript Beträge in Złoty durch “wycena indywidualna” (individuelles Angebot). Der Regex erkannte “zł”, das Symbol der polnischen Währung, ohne Unterscheidung von Groß- und Kleinschreibung und ohne Wortgrenze danach.
Auf der polnischen Seite zum Sicherheitsaudit sah die Überschrift “2. Złośliwe przekierowania” (2. Bösartige Weiterleitungen) für diesen Regex wie der Preis “2. Zł” aus. In Produktion stand dort “wycena indywidualna ośliwe przekierowania” (individuelles Angebot, gefolgt vom Wortrest “ośliwe przekierowania”). Derselbe Regex steckte in einem zweiten Skript, für Preise auf Städteseiten.
Wir haben das zufällig gefunden, beim Bau eines Scanners für Überschriften mit zusammengeklebten Wörtern, der bei derselben Gelegenheit 13 Überschriften ohne Leerzeichen vor einer Präposition entdeckte (“Is AMP deadin 2026?”). Die Korrektur ist ein negativer Lookahead in beiden Skripten. Im gesamten Korpus fiel nur eine Überschrift zum Opfer, aber es war die Überschrift einer Verkaufsseite.
4. Eine Übersetzung, die nur Konjunktionen ersetzte
Das Faktenfeld (llmCard) wird sichtbar unter den Artikeln angezeigt und fließt in die Daten für Sprachmodelle ein. Auf Seiten in fünf Sprachen außer Englisch waren 358 solcher Sätze auf Englisch, in 104 Dateien. Ein Teil war halb übersetzt: Ein altes Skript hatte nur die Konjunktion ersetzt, also schrieb eine deutsche Portfolio-Seite “Contact und inquiry forms” und eine polnische “granite, conglomerate, i marble countertops”.
Am interessantesten war die Erkennung. Der erste Detektor, der auf dem Anteil englischer Funktionswörter beruhte, fand 172 Sätze. Die Übersetzungsagenten meldeten selbst, dass in denselben Dateien weitere englische Sätze übrig geblieben waren, und sie hatten recht. Ein zweiter Durchlauf verglich jeden Satz mit den Fakten des englischen Gegenstücks derselben Seite (dieselbe wpId). Ohne zusätzlichen Filter lieferte er 4004 Treffer, vor allem Technologielisten auf Städteseiten und das norwegische “for”. Mit der Bedingung von mindestens zwei englischen Funktionswörtern blieben 170 echte übrig. Die letzten 12 haben wir von Hand korrigiert.
Jede der fünf Übersetzungen haben wir per Skript geprüft, nicht anhand des Agentenberichts: In jeder Datei haben sich nur die angegebenen Positionen geändert, jede Zahl ist erhalten geblieben, es gibt keine langen Gedankenstriche.
5. Eine Begriffsersetzung, die keine Komposita kannte
Ein Durchlauf zur Vereinheitlichung des Vokabulars ersetzte einen deutschen Begriff durch “laufende Betreuung”. Komposita behandelte er nicht, also schrieben die Seiten “laufende Betreuung-Commitments”, “laufende Betreuung-Übergabe” und “Wartungs-laufende Betreuung”. Das ist kein Deutsch. Insgesamt 518 Vorkommen in 356 Dateien, alle auf indexierten Seiten.
Der Eintrag in unserem Backlog hatte einen Prüfbefehl, der nur nach der Form mit Bindestrich nach dem Begriff suchte. Hätten wir genau das korrigiert, was er anzeigte, wäre er grün geworden, und 157 Komposita in der zweiten Form in 118 Dateien wären stehen geblieben. Also haben wir nach der Klasse des Defekts gesucht (jeder Bindestrich, der an den Begriff grenzt), nicht nach dem Literal, das jemand in die Aufgabe geschrieben hatte.
Die Reparaturmethode war einfach: 497 der 518 Vorkommen stammten aus vier Vorlagensätzen. Jeden davon haben wir einmal von Hand in korrektes Deutsch umgeschrieben (“Übergabe in die laufende Betreuung”, “Wartungsbetreuung”) und als exakten Satz ersetzt. Die übrigen 21 haben wir einzeln korrigiert.
6. Agenten, die Referenzen erfinden
Dreizehn kuratierte Städteseiten wurden von Agenten geschrieben. Das Review vor der Veröffentlichung am 26. August fand darin Abschnitte wie “Case Study 1: Dystrybutor B2B z Bielan Wrocławskich” (ein B2B-Distributor aus Bielany Wrocławskie) mit präzisen Zahlen: +52 % Anfragen, LCP von 4,5 s auf 0,7 s, 100/100 in PageSpeed. Keinen dieser Kunden gibt es. Dieselben Zahlen steckten auch im Faktenfeld und in den Speakable-Daten, nicht nur im Text.
Dazu verlinkten die Abschnitte “Weitere Standorte” auf Städte, die geografisch geraten waren: Lübeck, Kiel, Regensburg, Girona, Tromsø. 30 tote Links in 8 Dateien.
Das fängt kein textbasiertes Gate ab, denn eine erfundene Case Study ist syntaktisch korrekt. Abgefangen wird es durch eine Prozessregel: Der Agent bekommt im Auftrag eine Liste der existierenden Adressen, und jede zahlenmäßige Behauptung über einen Kunden braucht eine Quelle im Repository, sonst fliegt sie raus.
7. Deploy erfolgreich, Produktion mit altem Inhalt
Das Deploy-Skript lief am 8. September sauber durch: Upload, Cache-Purge, Smoke-Test 81/81 OK, Exit-Code 0. Auf der Live-Website zeigten fünf von sechs Startseiten die alten Kacheln.
Die Reihenfolge war: Upload, Purge, 8 Sekunden Pause, Smoke-Test. Cloudflare Pages hatte das neue Deployment noch nicht aktiviert, also trafen die 81 Anfragen des Tests den vorherigen Build und füllten den Cache damit für eine Stunde. Der Prüfschritt machte den Purge zunichte, der kurz zuvor ausgeführt worden war. Kein Signal war falsch. Keines maß das, was schiefging: Der Test prüfte HTTP-Codes, nicht den Inhalt.
Heute: Das Skript leert den Cache ein zweites Mal, nach dem Test, und wir bestätigen das Deployment mit einer Formulierung aus der konkreten Änderung auf der Live-Seite, mit einem Parameter, der den Cache umgeht.
8. Vertiefung, die Inhalte ersetzt hat
Die Durchläufe zum “Vertiefen” kurzer Beiträge sollten Inhalt ergänzen. In der Praxis ersetzte ein Teil von ihnen den gesamten Artikeltext. Neun Beiträge haben wir aus der Git-Historie wiederhergestellt.
Danach haben wir ein Gate gebaut, das jede geänderte Datei mit ihrer Basisversion vergleicht und den Verlust eines Elements meldet: Tabelle, Komponente, iframe, Bild, Codeblock, FAQ-Frage, howTo-Schritt, interner Link. Rückwirkend über die letzten 60 Commits mit Inhalt laufen gelassen, markierte es jeden Vertiefungsdurchlauf von 128 bis 185, von denen jeder 142 bis 206 Elemente verlor, darunter Tabellen, eingebettete Videos und Codeblöcke.
Die erste Version dieses Gates erkannte Überschriften am Text. Auf dem aktuellen Branch meldete sie 17 verlorene Überschriften, und alle 17 waren Reparaturen: getrennte zusammengeklebte Wörter, eine wiederhergestellte zerfressene Überschrift. Eine Umbenennung ist kein Verlust. Überschriften, Links und FAQ zählen wir daher mengenmäßig, und die Identität prüfen wir nur noch bei Bildern, Komponenten und iframes.
Der gemeinsame Mechanismus: Erfolg aus Sicht des Werkzeugs
Alle acht Fälle haben dieselbe Form. Das Werkzeug maß, was es selbst getan hatte, und meldete auf dieser Grundlage Erfolg. Das Auffüllskript maß die Wortzahl. Das Aufräumskript maß, ob es seine Literale gefunden hatte. Die Prüfung aus dem Backlog maß eine Form des Kompositums. Der Smoke-Test maß HTTP-Codes.
Jeden Defekt haben wir erst gefunden, als wir das Ergebnis mit etwas Externem verglichen haben:
- mit der vorherigen Version derselben Datei (verlorene Tabellen und Abschnitte),
- mit dem Gegenstück in einer anderen Sprache (englische Sätze auf deutschen Seiten),
- mit der Live-Seite statt mit dem Deploy-Log (alter Cache),
- mit der Klasse des Defekts statt mit dem Literal aus der Aufgabe (die zweite Form der Komposita),
- mit Nachfragedaten (723 Städteseiten ohne eine einzige Impression).
Daraus ergibt sich eine praktische Regel, die wir seit September anwenden: Der Bericht eines Agenten oder Skripts ist eine Hypothese. Das Ergebnis prüft ein separates Skript, das nicht weiß, was das Werkzeug vorhatte, und den Zustand vorher mit dem Zustand nachher vergleicht.
Was ich vor dem ersten Massenlauf ändern würde
- Kein Zahlenziel für ein Skript, das Prosa schreibt. Wortzahl, Linkanzahl und FAQ-Anzahl sind Messgrößen zum Ablesen, nicht zum Erfüllen.
- Ein Gate, das mit der vorherigen Dateiversion vergleicht, vor dem ersten Batch-Commit, nicht nach dem dreißigsten.
- Jeder Regex auf Text wird an Überschriften und an Wörtern mit polnischen Sonderzeichen getestet, denn “Zł” ist der Anfang vieler polnischer Wörter.
- Übersetzungen werden durch den Vergleich mit dem Gegenstück in der Ausgangssprache geprüft, nicht mit einer Wortliste.
- Der Prüfbefehl einer Aufgabe sucht nach der Klasse des Defekts. Wenn die Aufgabe ein Beispiel nennt, suchen Sie auch nach dessen Varianten.
- Ein Deployment wird durch Inhalt auf der Live-Seite bestätigt, in jeder Sprache.
Was dieser Text nicht beweist
Wir behaupten nicht, dass uns diese Defekte Traffic gekostet haben, denn das haben wir nicht auf eine Weise gemessen, die es entscheiden würde. Ein Teil der Seiten mit Fülltext hatte auch vorher keine Impressionen.
Das Spam-Update von Google im September begann am 25. September 2026 und soll etwa zwei Wochen dauern. Laut der Zusammenfassung von Search Engine Roundtable vom 28. September traf es programmatische Seiten und KI-generierte Inhalte, und Google veröffentlichte in derselben Woche eine Arbeit über das System SAFE zur Erkennung von massenhaftem “AI slop”. Unsere Städteseiten sind genau diese Kategorie. Die Auswertung in der Search Console, getrennt für Städteseiten, Blog und Dienstleistungsseiten, machen wir nach dem Ende des Updates und beschreiben sie, unabhängig vom Ergebnis.
Eine letzte Anmerkung betrifft uns selbst: Auch dieser Text ist mithilfe eines Agenten entstanden. Jede Zahl darin stammt aus einem Commit oder aus einer Messung in unserem Repository und ist durch dieselben Gates gelaufen, die wir hier beschreiben.