Einleitung
Ihre Website rankt bei Google, die Core Web Vitals sind grün, das Schema validiert. Fragt jemand ChatGPT, Claude, Perplexity oder Google AI Overviews nach Ihrer Branche, fehlt Ihre Marke trotzdem in der Antwort. Generative Engine Optimization befasst sich mit dieser Lücke zwischen klassischem SEO und dem, was AI-Suchmaschinen zitieren.
GEO und SEO laufen nebeneinander. SEO regelt, wie Such-Crawler Inhalte indexieren und ranken, GEO, wie große Sprachmodelle sie abrufen, interpretieren und zitieren. Einige Techniken wirken in beiden Bereichen, und keine veröffentlichte Norm hält mit dem Tempo des Feldes Schritt. Der Leitfaden beschreibt, was in der Praxis wirkt, was Mythos ist und in welcher Reihenfolge Sie die Hebel angehen.
Warum KI-Sichtbarkeit 2026 zählt
KI-Assistenten schicken inzwischen messbar Besucher, aber deutlich weniger als die organische Google-Suche. ChatGPT Search ist für Nutzer mit installierter App in die iOS-Adressleiste eingebettet. Perplexity hat den Sprung vom Power-User-Tool zum Mainstream-Produkt geschafft. Claude liest das offene Web über sein Such-Tool. Google AI Overviews erscheinen bei einem großen Anteil informationeller Anfragen in englischsprachigen Märkten und rollen quartalsweise in weitere Sprachen aus.
Zwei GA4-Datensätze liefern Zahlen. Marie Haynes (21. Oktober 2026) hat 12 Monate auf 100 Websites ausgewertet: Sitzungen aus ChatGPT entsprachen 0,62 % der organischen Google-Sitzungen, und die Besuche aus ChatGPT gehen seit August 2025 zurück. Auf den 55 Websites, die Konversionen erfassten, lag die Konversionsrate von ChatGPT-Besuchern bei 13,8 % gegenüber 3,02 % bei Google, trotzdem brachte Google 96,5 % der Konversionen über alle verglichenen Kanäle. Die Vergleichsstudie von The SEO Works (7. September 2026, aktualisiert am 14. Oktober) umfasst 95 Websites von September 2025 bis August 2026: Die organische Suche brachte 39-mal so viele Besuche wie KI-Assistenten, der KI-Anteil an den organischen Besuchen stieg von 2,25 % auf 3,86 %, und auf 23 von 63 Websites mit ausreichend Daten konvertierten KI-Besuche schlechter als organische.
Die wirtschaftliche Folge ist klar. Selbst wenn ein Interessent am Ende über klassische Suche kauft, registriert oder bucht, wurde seine Shortlist zuvor von einem LLM gefiltert. Wer nicht auf dieser Liste steht, spielt nicht mit. Klassisches SEO bleibt relevant, weil es dieselbe Crawling-Infrastruktur speist, die viele AI-Systeme nutzen. Aber SEO allein reicht nicht mehr.
Was ist der Unterschied zwischen KI-Suche und LLMs?
Beide Begriffe sind gebräuchlich und die Konsistenz ist wichtiger als die Wahl. “AI-Suche” ist der breitere, nutzerorientierte Ausdruck. Er umfasst Chatbots, RAG-Werkzeuge, AI Overviews und hybride Systeme. “LLMs” meint konkret die zugrunde liegenden Sprachmodelle. In diesem Leitfaden steht “AI” für die Entdeckungsoberfläche und “LLMs” für die Technik dahinter. Das Optimierungsziel bleibt dasselbe.
Liste der KI-Crawler und User-Agents 2026
Bevor Sie Code anfassen, wissen Sie, für wen Sie optimieren. Stand April 2026 sind die wichtigsten User-Agents:
GPTBot, OpenAI, Training und Offline-Retrieval.OAI-SearchBot, ChatGPT Live-Suche.ChatGPT-User, On-demand-Abrufe, ausgelöst durch einen Nutzer-Prompt.ClaudeBotundClaude-User, Anthropic.PerplexityBotundPerplexity-User, Perplexity AI.Google-Extended, die Opt-out-Steuerung für Gemini-Training.CCBot, Common Crawl, speist viele kleinere LLMs.Applebot-Extended, Opt-out für Apple-Intelligence-Training.Bytespider, ByteDance.Meta-ExternalAgent, Meta AI.
Keiner davon führt JavaScript aus. Alle respektieren robots.txt. Die meisten identifizieren sich ehrlich. Ein Teil holt Inhalte genau in dem Moment, in dem der Nutzer den Prompt absetzt, was den Zyklus von Tagen auf Sekunden verkürzt.
Welche GEO-Maßnahmen funktionieren nicht?
Die GEO-Szene ist voller Folklore. Das meiste hat keine empirische Stütze.
Eigene Meta-Tags wie <meta name="ai-content-url"> oder <meta name="llms"> haben keine bekannte Implementierung in irgendeinem ausgelieferten LLM-Produkt. Dateien wie /.well-known/ai.txt und /ai.txt haben konkurrierende Vorschläge und null Adoption. HTML-Kommentare für Bots werden von jedem gängigen Crawler vor der Verarbeitung entfernt. Mensch-oder-AI-Umschalter erfordern einen Klick, und Bots klicken nicht. User-Agent-Sniffing, um LLMs andere Inhalte auszuspielen, verletzt Googles Cloaking-Richtlinie und kann manuelle Strafen auslösen. Dedizierte “AI-Infoseiten” zeigen kein differenzierendes Verhalten in Zitationsdaten. Reines JSON-LD und Schema.org wird von Microsoft Copilot über Bing gelesen und beeinflusst weiterhin klassisches SEO, aber kontrollierte Tests zeigen, dass ChatGPT, Claude und Perplexity strukturierte Daten bei der Antwortsynthese weitgehend ignorieren.
Das Muster ist immer dasselbe. Jemand schlägt eine Spezifikation vor, schreibt einen Blogpost, und andere Blogposts zitieren diesen einen. Bevor Sie eine GEO-Technik übernehmen, fragen Sie, ob es Belege für echten Konsum gibt oder nur für die Existenz des Vorschlags.
Funktionieren selbstreferenzielle Bestenlisten noch in AI Overviews
Die Bestenliste “Die 10 besten Tools für X”, in der sich der Herausgeber selbst auf Platz eins setzt, war 2025 die billigste GEO-Taktik. Sie verliert an Wirkung. In ihrem Update vom 4. Oktober 2026 hat Lily Ray ihre Auswertung mit 100 englischsprachigen Suchanfragen nach der besten B2B-Software wiederholt. Im Vergleich zu Juni zitieren Googles AI Overviews 38% weniger selbstreferenzielle Bestenlisten und lassen die herausgebende Marke “in 83% der Fälle, gegenüber 69% im Juni” aus der Empfehlung heraus (Lily Ray, eigene Übersetzung).
Ray berichtet außerdem unter Berufung auf John Campbells Zusammenfassung der Search Central Live in Barcelona, Gary Illyes habe massenhaft produzierte Inhalte als größeres Problem als Linkspam bezeichnet. Bei einer früheren Search Central Live im Mai soll Illyes laut Ray den Kauf von Erwähnungen mit dem Kauf von Links verglichen haben.
Trotzdem ist ein Markt entstanden. Ray nennt bezahlte Platzierungen in fremden Bestenlisten, nach Domain Rating bepreist und oft ab etwa 135 bis 250 USD pro Stück, sowie Pakete mit “KI-Markenerwähnungen”, etwa 5 Erwähnungen für 1.500 USD. Das sind Marktpreise Dritter aus ihrem Artikel, keine Preise von mir, und ich biete solche Leistungen weder an noch empfehle ich sie. Falls Sie im DACH-Raum Angebote für bezahlte Platzierungen auf Vergleichsportalen bekommen, prüfen Sie sie auf genau dieses Muster. Hält Illyes’ Vergleich, trägt eine gekaufte Erwähnung dasselbe Risiko wie ein gekaufter Link.
Warum erfundene Statistiken von KI und anderen Websites zitiert werden
Metehan Yesilyurt von Peec AI hat das Prinzip “Statistiken veröffentlichen, Zitate sammeln” bis ins Absurde getestet (7. Oktober 2026). Er kaufte eine neue Domain und erzeugte an einem einzigen Tag mit GPT-4.1 50.000 Statistikseiten, für etwa 30 USD; mit 15.000 später ergänzten Listicles kostete das Experiment insgesamt etwa 50 USD. Er schreibt: “Jede einzelne davon war gefälscht” (Peec AI, eigene Übersetzung). Die Website sammelte mehr als 330 verweisende Domains, darunter Shopify, Bluehost und DHL. In den letzten 30 Tagen kamen über 600.000 Bot-Anfragen, rund 72.000 davon von ChatGPT-User. Zwei Google-Updates kurz nach dem Start ließen die Google-Sichtbarkeit einbrechen, trotzdem lag die Seite am 7. Oktober bei der Sichtbarkeit auf den beobachteten Prompts auf Platz zwei, nur hinter Statista.
Daraus folgen zwei Dinge. Eine Zahl, die ChatGPT und eine bekannte Marke wiederholen, ist von keinem der beiden geprüft. Bevor Sie eine Statistik zitieren, verfolgen Sie sie bis zur Originalstudie, zu Methode und Stichprobe zurück, und streichen Sie sie, wenn die Spur auf einer Website ohne Methodik endet. Und kopieren Sie die Taktik nicht: Die Google-Sichtbarkeit hat zwei Updates nicht überstanden, und jeder, der eine erfundene Zahl wiederholt, verbreitet sie weiter. Der Hebel “nachprüfbare Statistiken” weiter unten wirkt nur, wenn die Statistiken echt sind.
Wovon hängt ab, ob eine KI-Suchmaschine eine Seite zitiert?
Aktualisierung, 18. Oktober 2026. ChatGPT, Gemini und Perplexity zitieren eine Seite, wenn ihre eigene Suche sie findet. Innerhalb einer Website hilft von allen Inhaltsmerkmalen nur ein Titel und ein Absatz, die zur gestellten Frage passen. Das zeigt eine Studie von Mahe Chen und Nick Koudas von der University of Toronto, die am 10. Oktober 2026 auf arXiv erschien. Über zwei Zeiträume von je 90 Tagen stellten die Autoren den drei Engines täglich kaufnahe Fragen über deren APIs und sammelten 158.099 Antworten mit 468.037 Zitaten. Der erste Datensatz betrifft den US-Markt für Heiminternet, den wenige große Marken dominieren, der zweite kleine Anbieter von Business-Software.
Vergleicht man Seiten derselben Website, bestehen nur zwei Merkmale alle Robustheitstests der Autoren: ein Titel und ein bester Absatz, die zu den Fragen der Nutzer passen. FAQ-Blöcke, schema.org-Markup, Zusammenfassungsboxen, Autorenboxen und Ladezeit wirken nur im Vergleich verschiedener Websites, weil sie sich auf Websites häufen, die aus anderen Gründen öfter zitiert werden. Im meistzitierten Viertel der Websites haben 43% der Seiten einen FAQ-Block, im am wenigsten zitierten Viertel 23%. Der Absatz-Effekt gilt für alle drei Engines. Ein passender Titel hilft bei Gemini und Perplexity, bei ChatGPT zeigt er keine Wirkung, weil ChatGPT jede Frage in eigene Suchanfragen umschreibt.
| Seitenmerkmal, Vergleich innerhalb einer Website | Veränderung der Zitate |
|---|---|
| Bester Absatz passt zur Frage, +1 Standardabweichung | +15,5% |
| Titel passt zur Frage, +1 Standardabweichung | +14,1% |
| FAQ-Block, schema.org, Zusammenfassungsbox, Autorenbox, Ladezeit | kein signifikanter Effekt (zwischen Websites +7,5% bis +20,9%) |
| Mehr verweisende Websites, +1 Standardabweichung | +22,7%, vor allem bei Gemini |
Jede Seite, die ChatGPT zitiert, hat zuvor seine eigene Suche geliefert. Welche Seiten diese Suche abruft, erklärt 32% der Unterschiede bei den Zitaten zwischen Seiten einer Website, alle Seitenmerkmale zusammen 2,8%. Die Engines suchen mit Teilanfragen, die sie bei jeder Antwort neu formulieren, und 97% der von ChatGPT abgerufenen Seiten stehen für diese Anfragen nicht in Googles Top 50. Ein gutes Google-Ranking sagt daher wenig über die Sichtbarkeit in KI-Antworten. Links sind das einzige äußere Signal, das in den Abruf eingeht, vor allem bei Gemini. Sie wurden allerdings erst nach den Zitaten erhoben, die Richtung des Zusammenhangs ist offen.
Auch das Wissen des Modells wirkt mit. ChatGPT schreibt eine Marke in 67% der Fälle in seine Suchanfragen, wenn sein Modell sie für die Frage ohne Suche empfiehlt, sonst in 11%. Für 46% seiner Nennungen von Marken, die in der Frage nicht vorkommen, gibt es keine zitierte Seite, die sie nennt. Bei den kleinen B2B-Anbietern, die das Modell kaum kennt, erhöhte eine zitierte Drittseite mit dem Namen des Anbieters die Chance auf eine Nennung durch ChatGPT um das 39,7-Fache, im Verbrauchermarkt um das 4,2-Fache.
FAQ-Blöcke und schema.org-Markup bringen weiterhin Rich Results in Google und erleichtern Maschinen das Parsen einer Seite. Als Hebel für KI-Zitate innerhalb Ihrer eigenen Website stützen diese Daten sie nicht. Belastbar sind ein Titel und ein bester Absatz, die die Frage in ihren eigenen Worten beantworten, Seiten, die die Suche der Engine tatsächlich abruft, und Nennungen auf fremden Websites, die für kleine Unternehmen am meisten zählen. Die Ergebnisse sind Korrelationen aus kleinen API-Modellen (GPT-5.4 nano, Gemini 3.1 Flash Lite, Sonar) mit englischen Fragen zum US-Markt. Prüfen Sie sie an Ihren eigenen Fragen, bevor Sie Prioritäten verschieben.
Ein zweiter Test vom Oktober 2026 zeigt, wo strukturierte Daten unterwegs verloren gehen. Rick Ramos von serptwerker.com hat auf 60 Testseiten eine Angabe nur im JSON-LD hinterlegt und sie in 21.600 Versuchen auf Modellebene sowie in 1.644 Abrufen über die Werkzeuge der Anbieter geprüft. Bekommt ein Modell den Inhalt direkt, wirkt eine Angabe im JSON-LD genauso wie dieselbe Angabe im Fließtext. Ruft der Assistent die Seite selbst ab, sieht es anders aus: Claude Web Fetch und die GPT-5.5-Websuche nannten die Angabe 0-mal in 100 Versuchen, weil das JSON-LD das Modell nicht erreicht, Gemini mit URL Context las sie in 92 von 100 Versuchen (Flash) und in 89 von 89 (Pro). Die Apps ChatGPT und Claude.ai gaben sie kein einziges Mal aus. Für einen WooCommerce-Shop oder eine Firmenwebsite auf WordPress heißt das: Adresse, Öffnungszeiten, Leistungsumfang und jede andere Angabe, die in einer KI-Antwort landen soll, gehören in den sichtbaren Seitentext. Das Schema muss zu diesem Text passen, denn Gemini Pro gab in 8 von 20 Versuchen eine veraltete Antwort aus einem FAQPage-Block aus.
Eine dritte Messung betrifft die Quellen in AI Overviews selbst. Barlo Digital veröffentlichte am 8. Oktober 2026 einen einzelnen Durchlauf vom 5. Oktober: 117 US-Desktop-Suchen nach Unterstützung im Marketing. Bei 97 davon (83%) erschien ein AI Overview, 90 nannten Quellen. Diese 90 Antworten zitierten 402 verschiedene Domains, 329 davon (82%) nur ein einziges Mal. YouTube stand in 60% der Übersichten, Reddit in 34%, LinkedIn in 19% und Agenturverzeichnisse wie Clutch in 8%. Die Autoren raten: “Halten Sie Verzeichnisprofile korrekt, aber erwarten Sie nicht, dass sie die KI-Sichtbarkeit tragen” (eigene Übersetzung). Es ist eine Nische an einem Tag, doch bei so breit gestreuten Zitaten hat eine Seite, die eine konkrete Frage klar beantwortet, eine echte Chance auf einen Platz in den Quellen.
Wie macht man eine Website für KI und LLMs sichtbar?
Sortiert nach Impact für typische inhaltsreiche Sites.
1. Zuerst robots.txt prüfen
Die robots.txt kommt zuerst: Ein dort gesperrter Crawler ruft die Seite, die er zitieren könnte, gar nicht erst ab. Viele Sites tragen noch Disallow-Regeln für AI-Crawler aus dem Jahr 2023, als es um Trainingsdaten ging. Jeder der sieben Crawler unten lässt sich in einem eigenen Eintrag zulassen oder sperren, entscheiden Sie also Crawler für Crawler. Ein sinnvoller Standard für Unternehmen, die AI-Sichtbarkeit wollen:
User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: CCBot
Allow: /
Wollen Sie Sichtbarkeit in ChatGPT, aber keine Nutzung Ihrer Inhalte für das Training, erlauben Sie OAI-SearchBot und ChatGPT-User und sperren GPTBot. OpenAI dokumentiert diese Trennung. Apple, Google und Anthropic bieten analoge Steuerungen.
2. Markdown-Geschwister für jede Seite
Die hebelstärkste technische Änderung der Liste. Stellen Sie zu jeder Seite unter derselben URL mit angehängtem .md eine saubere Markdown-Fassung bereit, etwa /blog/post und /blog/post.md. Die Markdown-Version wirft Navigation, Footer, Analytics-Snippets, Cookie-Banner und alles andere raus, was Tokens aufbläht, ohne Information beizusteuern.
Unabhängige Messungen über mehrere Content-Sites zeigen konsistent Token-Reduktionen im Bereich von 70 bis 85 Prozent, wenn Markdown gerenderten HTML ersetzt. Ein Blogpost von 15.000 Tokens sinkt typischerweise auf 3.000. Das zählt, weil ein LLM, das Ihre Seite zur Beantwortung eines Prompts abruft, ein endliches Kontextbudget hat. Kleinere, sauberere Inhalte passen vollständiger hinein und werden treuer zitiert.
Auf Astro, Next.js oder jedem static-first Framework ist die Erzeugung von .md-Endpunkten aus derselben Content Collection, die auch die HTML-Ansicht speist, ein halber Arbeitstag. Die Markdown-Fassung sollte Titel, Veröffentlichungsdatum, Autor, eine kurze Zusammenfassung, den Haupttext und klar markierte Quellen enthalten.
3. Die Markdown-Version bekannt machen
Ein LLM-Crawler, der auf Ihrer HTML-Seite landet, muss erkennen, dass ein Markdown-Geschwister existiert. Zwei komplementäre Mechanismen decken die zwei Klassen von Clients ab.
Im HTML-Head:
<link rel="alternate" type="text/markdown" href="/blog/post.md" />Im HTTP-Response-Header:
Link: </blog/post.md>; rel="alternate"; type="text/markdown"Das Tag im HTML-Head lesen Parser, die das DOM auswerten. Den HTTP-Header sehen Headless-Agenten, die nur HEAD oder GET senden und kein Markup parsen. Der Aufwand ist eine Zeile im Layout und ein Eintrag in den CDN-Headern, danach findet ein Crawler die Markdown-Fassung, ohne Ihr URL-Schema zu raten.
4. Content Negotiation auf Accept: text/markdown
HTTP Content Negotiation steht seit 1997 im Standard. Sendet ein Client Accept: text/markdown, geben Sie die Markdown-Repräsentation von derselben URL zurück. Kombinieren Sie mit Vary: Accept, damit CDNs jede Repräsentation korrekt cachen. Claude Code, Cursor und mehrere Research-Agenten senden diesen Header bereits standardmäßig. Content Negotiation ist der wahrscheinlich dauerhafteste Standard, weil sie keine neuen Spezifikationen braucht und den bestehenden HTTP-Stack nutzt. In Cloudflare Workers passt die Implementierung in unter zwanzig Zeilen.
Was eine Website gemessen hat, Oktober 2026: In den Cloudflare-Logs von Amir Pournasserian zu seiner privaten Website kamen Crawler über die .md-Adressen an das Markdown, die im <head> jeder Seite stehen. Vom 10. bis 17. Oktober 2026 stellten sieben verifizierte Crawler (Amazonbot, ExaUser, OAI-SearchBot, GPTBot, Applebot, ClaudeBot und Meta-ExternalAgent) 143 Anfragen nach den Kopien. Die Aushandlung über Accept: text/markdown wurde am 18. Oktober freigeschaltet, und in den ersten 49 Minuten nutzte sie ein verifizierter Crawler, ExaSearchBot. Einen Crawler-Betreiber, der das Senden dieses Headers dokumentiert, fand der Autor nicht. Gesendet wird er von Entwicklerwerkzeugen wie Claude Code, OpenCode und dem Chat in VS Code. Nach diesen Daten erreichen der Link im <head> und eine feste .md-Adresse heute die Crawler, die Aushandlung bedient KI-Programmierwerkzeuge. Eine kleine private Website, acht Tage für die Kopien, keine Stunde für die Aushandlung.
5. llms.txt und llms-full.txt veröffentlichen
Zwei Dateien im Site-Root erledigen die Arbeit.
/llms.txt ist ein kuratierter Markdown-Index. Er listet die wichtigsten Seiten, nach Thema gruppiert, mit einzeiligen Beschreibungen. Denken Sie daran als README für ein LLM, das nach Ihrer Site gefragt wurde.
/llms-full.txt fasst den vollen Markdown-Inhalt Ihrer Kernseiten in einer Datei zusammen. Analytics über verschiedene Publisher zeigen, dass diese Datei spürbar mehr LLM-Traffic bekommt als der kurze Index. Beide zum Buildzeitpunkt aus derselben Content Collection generieren und bei jedem Deploy neu erzeugen. Kein großer LLM-Anbieter hat sich formal zum Lesen verpflichtet, aber die Dateien erscheinen häufig genug in Server-Logs, um den Aufwand zu rechtfertigen.
6. In sichtbare Inhaltsqualität investieren
Der größte und meist übersehene Hebel. LLMs synthetisieren Antworten, indem sie Kandidatensätze aus abgerufenen Seiten gewichten. Sätze mit konkreten, zuordenbaren Informationen bekommen höheres Gewicht als vage Aussagen. “Studien zeigen, dass AI-Sichtbarkeit wichtig ist” ist fast nutzlos. “Unabhängige Tests 2026 zeigten, dass direkte Zitate namentlich genannter Experten die Zitierquote um rund 43 Prozent steigern” wird zitiert.
Drei Maßnahmen erhöhen die Zitierquote verlässlich bei zuvor schwach zitierten Inhalten:
- Direkte Zitate namentlich genannter Experten.
- Nachprüfbare Statistiken mit klar zugeordneter Quelle.
- Autoritative externe Verweise auf Primärquellen.
Alle drei Signale stehen sichtbar im Text. Für eine WordPress-Agentur, ein SaaS-Unternehmen oder jeden Betrieb mit Fachwissen heißt das: statt generischer Listicles Artikel, die konkrete Versionen, Daten, Personen und Zahlen nennen. Quellen stehen inline, Teammitglieder werden namentlich zitiert, jedes erwähnte Tool bekommt Jahr und Version. Das ist solides journalistisches Handwerk, und GEO belohnt genau das.
SEO- und GEO-Checkliste für 2026
Crawlbarkeit und Indexierung:
- robots.txt erlaubt sowohl klassische Such-Crawler als auch die AI-User-Agents, bei denen Sie sichtbar sein wollen.
- XML-Sitemap ist aktuell und in Google Search Console sowie Bing Webmaster Tools eingereicht.
- Interne Verlinkung folgt einer klaren thematischen Struktur: Hub und Spoke oder Topical Maps.
- Canonical-Tags sind bei duplizierten oder parametrisierten URLs korrekt.
On-Page, weiter relevant für Menschen und für LLM-Retrieval:
- Aussagekräftige, keywordinformierte Titel und H1 in Sentence Case.
- Ein H1 pro Seite, logische H2- und H3-Hierarchie.
- Meta-Descriptions für Menschen geschrieben, nicht überstopft.
- Schema.org-Typen, die zum Inhalt passen, etwa Article, FAQPage, Product, Organization, Person, HowTo, für Rich Results in Google und das Parsen (zu KI-Zitaten siehe die Aktualisierung vom 18. Oktober 2026 weiter oben).
- Alt-Texte, die das Bild beschreiben, nicht das Keyword.
Core Web Vitals. AI-Crawler führen kein JavaScript aus, klassische Suche schon:
- LCP unter 2,5 Sekunden mobil.
- CLS unter 0,1.
- INP unter 200 Millisekunden.
GEO-spezifisch:
- Markdown-Endpunkte für jede Content-Seite.
<link rel="alternate" type="text/markdown">in jedem Layout.Link:-HTTP-Header auf CDN-Ebene.- Content Negotiation auf
Accept: text/markdown. /llms.txtund/llms-full.txtim Site-Root, bei jedem Deploy regeneriert.- Sichtbare Quellen, Zitate und Statistiken im Inhalt selbst.
- Konsistent verwendete Named Entities: Personen, Produkte, Firmen, Versionen, Daten.
Messung:
- Server-seitiges Logging von User-Agent und Referer am Edge.
- Ein Dashboard, das AI-Crawler-Traffic von menschlichem und klassischem Such-Traffic trennt.
- Monatliche Testprompts in ChatGPT, Claude, Perplexity und Gemini für Marken-Mentions.
In welcher Reihenfolge setzt man GEO um?
Für eine Site, die bisher nichts davon hat, arbeiten Sie in dieser Reihenfolge. Jeder Schritt hat für sich Wert.
- robots.txt auditieren und korrigieren. Ohne das wirkt nichts anderes.
<link rel="alternate" type="text/markdown">ergänzen und auf den künftigen Markdown-Endpunkt zeigen. Sie können das vor der Implementierung ausliefern.- Die Markdown-Rendering-Prozess bauen. Mit dem Content-Typ mit dem höchsten Traffic beginnen und ausrollen.
- Den
Link:-Header und Content Negotiation aufAccept: text/markdownam CDN einrichten. /llms.txtund/llms-full.txtzum Buildzeitpunkt aus der Content Collection erzeugen.- Flagship-Artikel überarbeiten: Named Entities, direkte Zitate, belegte Statistiken. Redaktionelle Daueraufgabe mit dem höchsten Langfristeffekt.
- Server-seitige Analytics für AI-Crawler-Traffic instrumentieren.
Die Schritte eins bis fünf sind reines Engineering und passen in einen Sprint. Schritt sechs ist Redaktion und verzinst sich über Quartale. Schritt sieben sagt Ihnen, ob irgendetwas davon gewirkt hat.
Wie man AI-Sichtbarkeit misst
Klassische Analytics sieht den meisten AI-Crawler-Traffic nicht. Weil die Crawler kein JavaScript ausführen, bleiben sie bei GA4 und Plausible komplett unsichtbar. Sie brauchen Server-side-Logging.
Am Edge erfassen: vollständiger User-Agent, Referer-Header, angefragter Pfad, zurückgegebener HTTP-Status, Response-Größe. Nach User-Agent-Mustern segmentieren, etwa GPTBot, ClaudeBot, PerplexityBot, OAI-SearchBot, Bytespider, CCBot, Applebot-Extended und Google-Extended, und daraus ein wöchentliches Dashboard bauen.
Ergänzen Sie das durch Brand-Mention-Tracking. Einmal pro Woche ein festes Prompt-Set in ChatGPT, Claude, Perplexity und Gemini laufen lassen und protokollieren, ob Ihre Marke zitiert wurde, an welcher Position und mit welchem Textausschnitt. Tools wie Profound, Peec AI und Otterly automatisieren das. Eine disziplinierte Tabelle funktioniert ebenso.
Schon die Auswahl der Prompts verändert das Ergebnis. Momentic veröffentlichte am 20. Oktober 2026 eine Auswertung von 145.498 bewerteten Antworten auf 8.342 Prompts für 18 Marken, gesammelt vom 13. Juli bis 15. August 2026 auf 11 Antwortoberflächen. Nannte der Prompt die Marke, erwähnte die Antwort sie in 91,6% der Fälle, ohne Namen in 19,6%. Die Bitte um eine Auswahl (“was empfehlen Sie”, “bestes X für Y”) brachte im Schnitt 4,55 Optionen und eine Empfehlung der beobachteten Marke in 22,8% der Antworten, gegenüber 1,25 Optionen und 8,0% bei Fragen ohne diese Bitte. Derselbe Prompt am selben Tag widersprach sich bei der Markenerwähnung in 4,5% der Wiederholungsgruppen ohne Marke und in 5,1% mit Marke. Negativ formulierte Fragen hoben den Anteil der Antworten mit einem Vorbehalt gegenüber der Marke auf 67,1%, gegenüber 32,0% bei den übrigen. AI Overviews nannten Quellen in 79% der Antworten, ChatGPT mit Browsing in 88% und API-Modi ohne Suche in 0%. Die Autoren empfehlen: “Berichten Sie Marken-Prompts als eigene Gruppe und halten Sie sie aus der Hauptquote der Erwähnungen heraus” (eigene Übersetzung). In der Tabelle heißt das: getrennte Gruppen für Prompts mit Marke, ohne Marke und mit Auswahlbitte sowie mehrere Durchläufe pro Prompt statt einem.
Holt ein Crawler zwar Ihren Markdown-Endpunkt ab, Ihre Marke taucht aber nie im Zitationsset auf, dann ist der Inhalt erreichbar, aber nicht wettbewerbsfähig. Zurück zum redaktionellen Hebel.
Wie unterscheidet man KI-Erwähnung und KI-Empfehlung?
Eine Erwähnungszahl beantwortet nur, ob die Marke auftauchte. Ob die Antwort den Leser zu Ihnen schickte, sagt sie nicht. Seers Beitrag zu KPIs der AI-Sichtbarkeit nennt den Problemfall:
“In der KI-Suche ist es durchaus möglich, aufzutauchen und dabei ANTI-empfohlen zu werden.”
Seer Interactive, AI visibility KPIs, eigene Übersetzung
Das heißt: Man kann auftauchen und trotzdem ausdrücklich abgeraten bekommen. Das Beispiel ist eine ChatGPT-Antwort, die über zwei bekannte Ferienwohnungsmarken hinausschauen ließ. Beide waren sichtbar, keine wurde empfohlen. Die Grundlage sind Anekdoten, kein Datensatz. Es ist also eine Warnung vor der Kennzahl, keine gemessene Quote.
Führen Sie deshalb pro Prompt zwei Spalten: zitiert und empfohlen. Notieren Sie, wenn die Antwort den Leser woandershin lenkt.
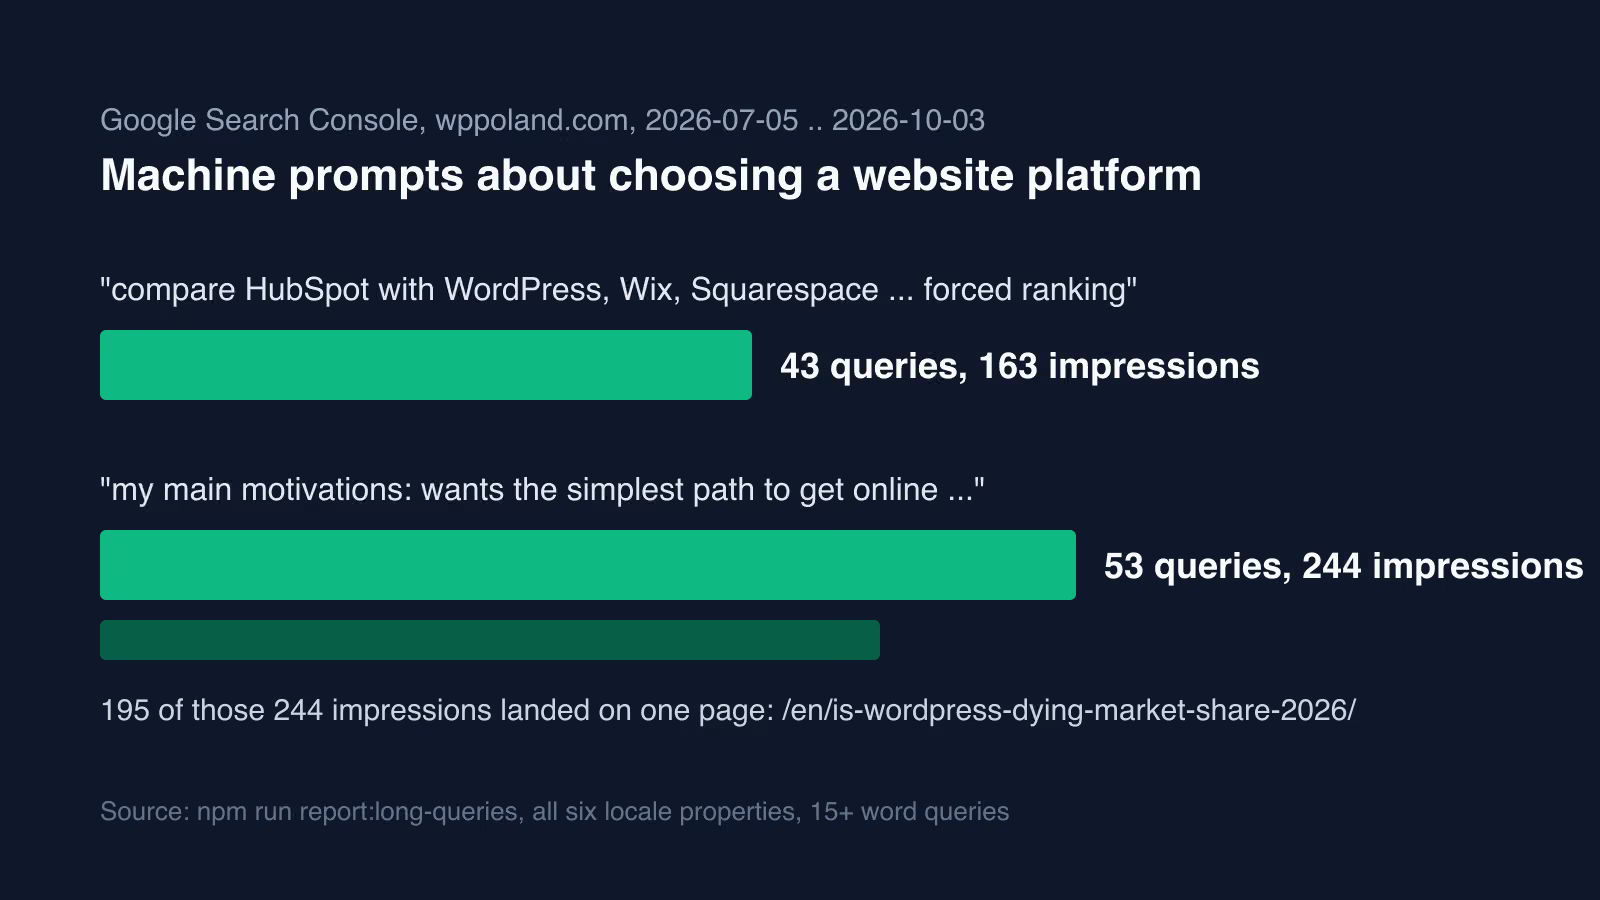
Meine eigenen Zahlen zeigen, warum eine Spalte täuscht. Im Geoboard-Lauf mit polnischen Kaufabsicht-Prompts hatte wppoland.com 47 % Erwähnungsrate und 0 % Autoritätsrate: dabei, aber nie zuerst. Am 5. Oktober 2026 habe ich 24 Schmerz-Prompts mit je 60 Läufen pro Modell abgefragt, zusammen 2.878 Antworten von gpt-4o-mini und gemini-2.5-flash-lite. Keine nannte wppoland. Auf “wen beauftragen”-Fragen nannten die Modelle Vermittlungsportale wie freelancer.com, keine Firmen. Beide Tests fragen die Modelle ohne Live-Suche ab. Sie messen also das Gedächtnis des Modells, nicht das, was ChatGPT mit Websuche findet.
Eine dritte Spalte lohnt sich: Kennt der Assistent die Marke beim Namen? Der Envoyra-Bericht vom Herbst 2026 stellte ChatGPT, Claude, Gemini und Perplexity in vier wöchentlichen Durchläufen vom 13. September bis 4. Oktober 2026 Kauffragen zu fünf Arten von Unternehmenssoftware, insgesamt 2.720 Antworten, dazu 720 Antworten auf reine Namensfragen vom 7. bis 9. Oktober. Keap wurde in 24 von 24 Namensantworten korrekt beschrieben, aber nur in 3 von 400 CRM-Antworten empfohlen. Profound wurde in 136 von 384 Kategorieantworten empfohlen, beim Namen aber nur in 5 von 24 erkannt, oft verwechselt mit einer gleichnamigen Firma. Nur 144 von 680 Paaren aus Frage und Assistent lieferten in allen vier Wochen dieselbe Markenliste, und die vier Assistenten nannten nur in 1 von 5 Kategorien denselben Spitzenreiter. Envoyra nennt die Grenzen selbst: Das Unternehmen verkauft KI-Sichtbarkeitsmonitoring, die Fragen sind nicht veröffentlicht, Claude und Gemini liefen über die API ohne Websuche, und der Erkennungstest umfasst 6 Antworten pro Marke und Assistent. Wie ich dieses Tracking für Kunden aufbaue: GEO- und LLMO-Optimierung.
Eine Empfehlung kann auch über Nacht verschwinden. Lukas Campos beschreibt, wie der Plugin-Manager von ChatGPT seinen Dienst Audioscrape sechs Tage lang, vom 4. bis 9. September 2026, in Gesprächen empfahl: Die täglichen Anmeldungen über ChatGPT lagen 36-mal höher als zuvor, und 96% der Anmeldungen jener Woche kamen über die ChatGPT-Anmeldung statt über die Website der Firma. Geschlossen hat das Fenster eine Änderung auf Seiten der Plattform, nicht etwas, das die Firma getan hat (Campos, router economy). Das ist ein Fall aus einem Plugin-Verzeichnis, keine zitierte Seite in einer Antwort, die Lehre gilt trotzdem: Eine Empfehlung im Assistenten ist gemietet. Messen Sie die Spalte “empfohlen” also Tag für Tag und machen Sie aus dem Traffic eines solchen Fensters sofort einen direkten Kontakt.
Was sind Fan-out- und Grounding-Abfragen?
Die KI-gestützte Zusammenfassung von SearchPilot zu einem Webinar mit Cyrus Shepard ist keine Mitschrift. Sie stützt sich auf seine Auswertung von 54 Studien zu AI-Zitaten und trennt zwei Arten von Suchen. Fan-out-Anfragen recherchieren die Frage: Ein Prompt kann viele Hintergrundsuchen auslösen. Grounding-Anfragen belegen eine Aussage, die das System schon treffen will. Laut Zusammenfassung stammen viele sichtbare Zitate aus der Grounding-Phase. Eine Seite kann die Recherche prägen, ohne zitiert zu werden, oder für die Bestätigung einer Aussage zitiert werden, ohne die Empfehlung zu beeinflussen.
In den eigenen Berichten tauchen diese Anfragen nicht auf. Ein Rückblick von ROAST auf Google Search Central Live in Barcelona sagt es knapp:
“Die Fan-out-Anfragen von Google erscheinen nicht in der Search Console, da sie nicht von Nutzern stammen.”
ROAST, Google Search Central Live Deep Dive Barcelona, day 3 recap, eigene Übersetzung
Welche KPIs für KI-Sichtbarkeit messen
- Jeden Prompt wiederholen. Seer schlägt vor, die zehn wichtigsten Prompts im Monat 10-, 20- oder 30-mal laufen zu lassen. Das Ergebnis nennt Seer eine Momentum-Kennzahl, “keine endgültige KPI, die man auf das Dashboard der Geschäftsleitung setzt” (Seer Interactive, eigene Übersetzung).
- Google-Traffic neben LLM-Traffic beobachten. Die SearchPilot-Zusammenfassung beschreibt einen Omio-Test: Eine strukturierte Zusammenfassung oben auf der Seite hob den LLM-Traffic, während Google organisch in die falsche Richtung lief.
Fragen zu Markdown, Crawler-Blockade und Ergebnissen
Kannibalisiert Markdown meinen SEO-Traffic? Nein. Google indexiert den HTML-Canonical. Die Markdown-Fassung wird als rel="alternate"-Repräsentation angekündigt, was Google signalisiert, sie nicht als Duplikat zu werten.
Wird das alles nicht missbraucht? LLMs bewerten Kandidatenquellen nach Vertrauenssignalen, nicht nach Dateiformat. Markdown zu veröffentlichen macht dünnen Inhalt nicht zitierbar. Die Investition schützt vor dem Abwärtsrisiko unlesbar zu sein, ohne das Aufwärts einer Zitation zu garantieren.
Soll ich AI-Crawler blockieren? Geschäftsentscheidung, keine technische. Wenn Direkt-Traffic Ihr Umsatz ist, sind Trainingsblockade plus Retrieval-Zulassung ein sinnvoller Mittelweg. Wenn Entdeckbarkeit Ihr Umsatz ist, blockieren Sie nichts.
Wann sehen wir Ergebnisse? Die Engineering-Schicht wirkt binnen Tagen, sobald die Crawler neu abrufen. Die redaktionelle Schicht verzinst sich über Quartale. Erwarten Sie messbare Veränderungen in AI-Zitationen vier bis acht Wochen nach gemeinsamem Rollout beider Schichten.
Wie verfolgt man KI-Zitate der eigenen Website?
Alles oben setzt voraus, dass man raten muss, ob die ganze Installation wirklich funktioniert. Muss man nicht. Ich habe wppoland.com selbst ein ganzes Quartal lang als Testobjekt laufen lassen und die rohe Methode veröffentlicht, nicht nur das Ergebnis.
Wie wir die eigenen KI-Zitate von wppoland.com 90 Tage lang verfolgt haben ist das Protokoll dieses Experiments: Edge-seitige User-Agent-Erfassung, ein wöchentliches festes Prompt-Set über vier Assistenten und die Woche-für-Woche-Zitationskurve. Es ist die Referenzimplementierung für Schritt sieben der pragmatischen Reihenfolge oben, umgesetzt auf meiner eigenen Infrastruktur statt nur abstrakt beschrieben. Bei der Protokollierung am Edge muss die IP-Anonymisierung nach DSGVO von Anfang an mitgedacht werden, ein Punkt, der in der überwiegend US-zentrierten GEO-Literatur selten auftaucht.
KI-Zitations-Monitoring: was Sie verfolgen sollten und wie oft macht aus diesem einmaligen Experiment eine wiederholbare Kadenz. Er legt fest, welche Felder am Edge zu loggen sind, wie oft das Prompt-Set neu laufen sollte, ohne ein Quartalsbudget in Rauschen zu verbrennen, und ab welcher Schwelle ein Rückgang der Zitationen Signal statt normaler Woche-zu-Woche-Varianz ist.
Warum Perplexity Ihre Marke zitiert und ChatGPT nicht erklärt die Aufspaltung, die als Erstes auffällt, sobald man zu messen beginnt: dieselbe Seite wird von einem Assistenten zuverlässig zitiert und von einem anderen nie, aus strukturellen Gründen, die nichts mit Inhaltsqualität zu tun haben. Zu wissen, welcher Assistent welches Signal honoriert, verändert, wohin Sie die redaktionelle Stunde aus Schritt sechs investieren.
Lesen Sie diese drei Artikel zusammen, bevor Sie ein Dashboard von Grund auf bauen. Das Engineering-Muster ist fertig. Die offene Frage ist, was Ihre eigenen Logs über Ihre eigene Domain sagen.
Wie optimiert man Inhalte für RAG und Chunking?
Generative Suchmaschinen wie Perplexity und ChatGPT teilen Inhalte in 512-Token-Chunks auf, um semantische Vektoreinbettungen zu berechnen:
- Autonome Abschnitte unter H2 und H3: Jeder Unterabschnitt muss eine eigenständige These enthalten, die Marken- und Technologienamen explizit nennt. Das Vermeiden unklarer Pronomen verhindert Bedeutungsverlust beim Vector Retrieval.
- Explizite Schema.org-Verknüpfungen (SameAs, Mentions): Verlinken Sie Ihre JSON-LD-Entitäten mit Wikidata-Einträgen, um dem Wissensgraphen eine eindeutige Identifizierung zu ermöglichen.
- Markdown-Tabellen als Zitationsbeschleuniger: Sprachmodelle bevorzugen tabellarische Vergleiche gegenüber Fließtext bei der Generierung direkter Antworten.
- Faktische Konsistenz über Sprachgrenzen hinweg: Einheitliche Kennzahlen und Spezifikationen über alle Sprachversionen hinweg verhindern Verwirrung bei multilinguale Abfragen und stärken das semantische Vertrauen generativer Modelle.
Langfristige GEO-Strategie für die KI-Suche
GEO ändert sich jeden Monat: neue Standardvorschläge, neue Crawler, neue Gewichtung von Zitaten bei den großen LLMs. Was jedes Retrieval-System braucht, bleibt gleich, und dort lohnt die Investition: saubere, gut strukturierte Inhalte mit Quellen, in einem Format, das sich günstig verarbeiten lässt.
Die technische Installation, also Markdown-Geschwister, Content Negotiation und llms.txt, ist Einsatz. Die redaktionelle Arbeit, also Named Entities, direkte Zitate, belegte Statistiken und autoritative Quellen, ist der Graben. Ihre Infrastruktur kopiert die Konkurrenz in einer Woche. Fünf Jahre substanzielle Texte namentlich genannter Experten aus Ihrem Haus kopiert niemand.
Installieren Sie die Infrastruktur einmal. Verbringen Sie die restliche Zeit damit, Dinge zu schreiben, die zitiert werden wollen.
Dieselbe Checkliste fahre ich, wenn ich KI in WordPress integriere für Publisher, die Zitationen brauchen und nicht nur ein weiteres Chatbot-Plugin.