Joost de Valk hat am 27. September 2026 einen Text darüber veröffentlicht, dass fast niemand XML-Sitemaps richtig macht. Mit dem Plugin Sitemap Inspector hat er sechs Websites durchgesehen, von Adobe bis GOV.UK, und überall dasselbe gefunden: Adressen mit noindex, Weiterleitungen, 404, Canonicals, die woanders hinzeigen, ein einziges Datum für Hunderte Einträge. Seine These lautet: “A sitemap should list the URLs a site wants indexed, and nothing else.”
Wir stimmen der These und der Liste zu. Wir haben damit unsere eigene Website geprüft. Zwischen August und Oktober 2026 haben wir im Sitemap-Generator von wppoland.com fünf Fehler gefunden, jeden davon auf der Produktion gemessen. Drei davon hätte Joosts Liste erwischt. Zwei erwischt kein Inspektor, der die Einträge einer Sitemap liest, weil sie darin bestanden, was in ihr fehlte. Dieser Text handelt von beiden Arten.
Technischer Kontext: wppoland.com ist eine Astro-Website in sechs Sprachen mit rund 6700 Adressen in den Sitemaps. Die Sitemaps erzeugt eine eigene Integration, astro-sitemaps.mjs, kein Plugin. Das ist für die Schlussfolgerungen wichtig: Jeder der folgenden Fehler steckte im Code, der Daten liest und die Liste baut, nicht in der Liste selbst.
Fehler 1: Build-Datum als lastmod
Am 24. August 2026 hatten fünf verschiedene Sitemaps genau einen lastmod-Wert für alle Einträge, denselben, den heutigen. Die Integration berechnete new Date() einmal und stempelte damit 3079 Adressen. Jedes Deployment verkündete Google, dass sich alles geändert habe.
Google beschreibt die Bedingung ausdrücklich: <lastmod> wird verwendet, wenn der Wert “consistently and verifiably” mit der letzten Änderung der Seite übereinstimmt (Google Search Central, Seite zum Erstellen von Sitemaps, Aktualisierung vom 8. Juli 2026). Ein Datum, das bei jedem Build springt, erfüllt diese Bedingung nicht. Google hört also auf, ihm für die gesamte Domain zu vertrauen, auch dort, wo es stimmen würde. In Stichproben aus dieser Zeit lag der letzte Crawl mancher Seiten drei Wochen bis drei Monate zurück.
Die Korrektur setzte updatedDate aus dem Frontmatter ein, ersatzweise pubDate. Wirkung auf das Artefakt: Die polnische Blog-Sitemap ging von 1 auf 98 verschiedene Daten.
Bei dieser Korrektur passiert leicht ein Fehler zweiter Ordnung. Verlockend war, für die Städteseiten das Feld lastVerified einzusetzen, weil jede der 4733 Dateien es hat. Nur haben 4697 von 4733 Dateien darin denselben Wert. Das ist ein Sammelstempel, kein Signal, und hätte denselben Defekt nur von “heute” auf ein anderes festes Datum verschoben. Bevor irgendein Datumsfeld in lastmod landet, muss man zählen, wie viele verschiedene Werte es hat.
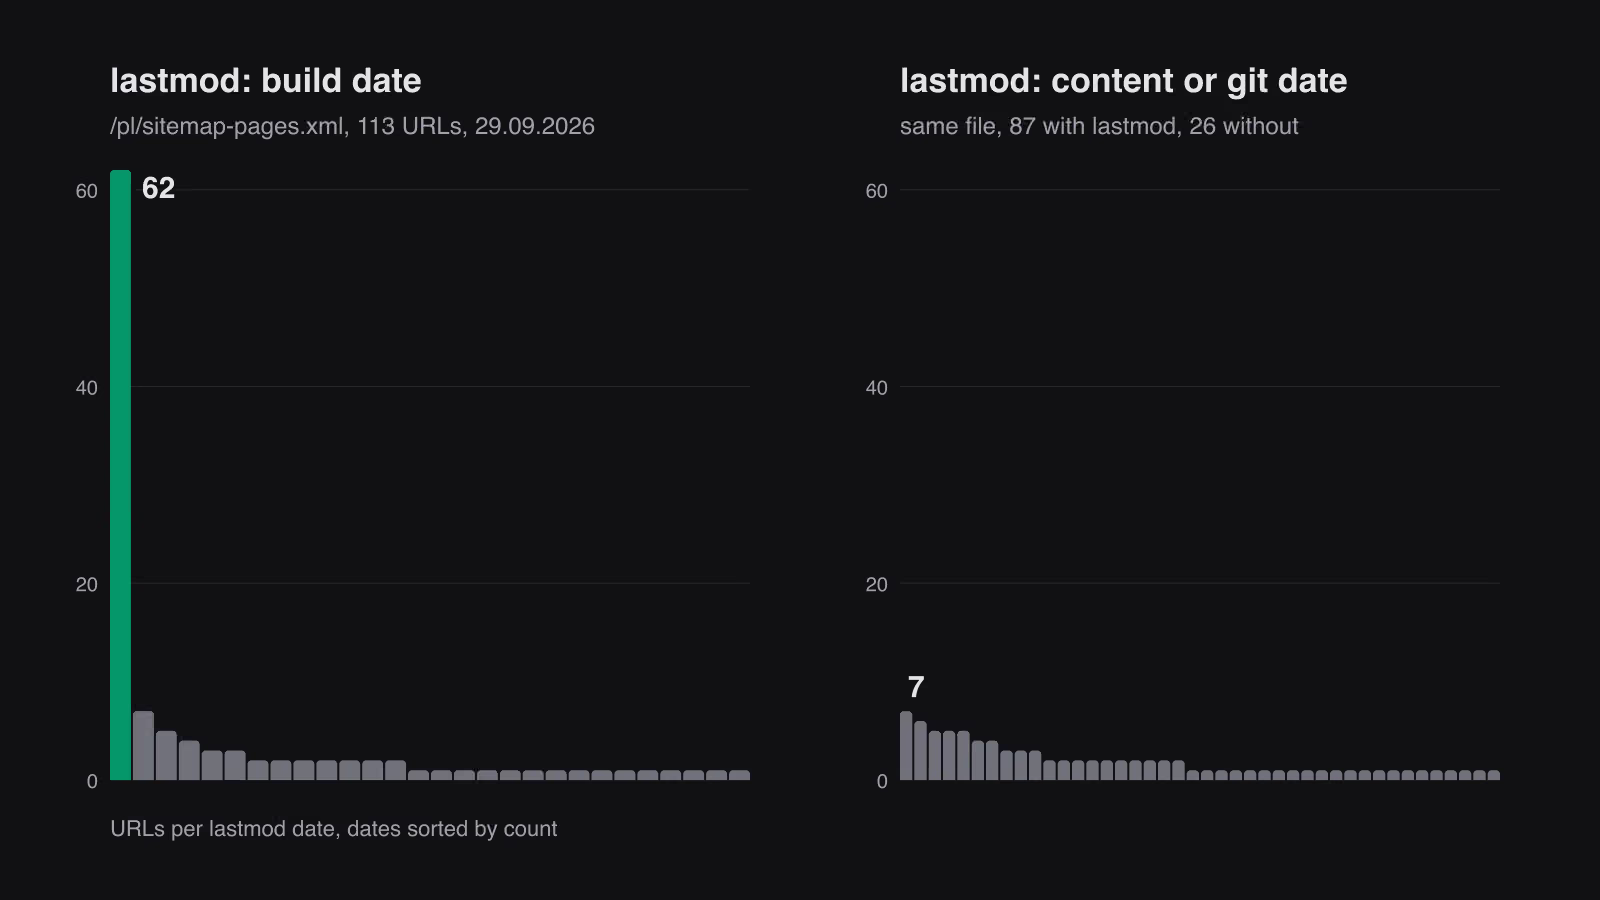
Die Korrektur vom August umfasste Blog, Portfolio und die Seiten aus Content-Collections. Handgeschriebene .astro-Routen umfasste sie nicht. Joosts Artikel hat uns zu einer erneuten Prüfung gebracht: Am 29. September hatten in /pl/sitemap-pages.xml 62 von 113 Adressen weiterhin das Build-Datum als lastmod, weil es für sie kein Datum im Inhalt gibt und der Code dann auf today zurückfiel. Der Fix (Commit af97c7a887) nimmt für solche Routen das Datum des letzten Commits der Quelldatei, aus einem einzigen git log-Aufruf pro Build, und lässt lastmod weg, wenn auch das fehlt. Das gemeinsame Template [lang]/[slug].astro zählt bewusst nicht als Quelle, weil sein Datum über keine konkrete Seite etwas aussagt. Dieselbe Datei nach dem Fix: 87 von 113 Adressen haben lastmod, 42 verschiedene Daten, das häufigste entfällt auf 7 Adressen, und 26 Adressen haben überhaupt kein Datum. In der polnischen Sitemap der Städteseiten hatten vor dem Fix 684 von 692 Einträgen das Build-Datum, danach haben 8 Einträge ein echtes Datum: Das Städte-Template hat kein Datum, das sich ehrlich verwenden ließe, also deklariert der Rest keines. Die Korrektur ist seit dem 29. September 2026 in Produktion, und die Live-Datei zeigt dieselben Zahlen.
Fehler 2: Der noindex-Filter bewachte ein einziges Feld
Nachdem 723 Städteseiten auf noindex herabgestuft worden waren, meldete die Search Console sie weiterhin als gefunden. Die Seiten selbst hatten ein korrektes noindex. Sie kamen auf einem anderen Weg zu Google zurück: sitemap-locations.xml führte sie als Sprachalternativen (xhtml:link, auch x-default) von Seiten, die im Index geblieben waren.
Der noindex-Filter in der Integration prüfte nur <loc>. Die Alternativen stammen aus dem Head der Seite, der alle Sprachversionen aufführt, also sah der Filter sie nicht. Der Fix behält nur die Alternativen, deren Adresse selbst ein <loc> in der Sitemap ist. Danach lieferte der Build 6407 Adressen und 0 fehlerhafte Alternativen.
Die Lehre reicht über Sitemaps hinaus: Ein Filter auf einem Feld eines Eintrags deckt die übrigen Felder desselben Eintrags nicht ab, die eine Adresse tragen. In einer Sitemap gibt es mehrere solcher Stellen: loc, Alternativen, x-default, image:loc.
Fehler 3: 500 funktionierende Seiten außerhalb der Sitemap
Am 21. September 2026 begann die Integration, jede Adresse auszulassen, die zu den Präfixen passte, die die Middleware in functions/_middleware.ts weiterleitet. Nur leitet die Middleware sie ausschließlich dann weiter, wenn die Ressource 404 liefert, und jeder Sitemap-Kandidat ist eine gebaute Seite, liefert also nie 404. Der Filter hat die Regel ohne ihre Bedingung kopiert.
Ergebnis: 500 funktionierende Seiten mit index, follow fielen aus der Sitemap, darunter das Ziel einer der Weiterleitungen (/pl/audyt-bezpieczenstwa-wordpress/ passte zum Präfix audyt-bezpieczenstwa-). Der Fix ging am 26. September live, der Build mit Sitemap ergab +500 Adressen und 0 entfernte.
Diesen Fehler erwischt keine Eintragsprüfung. Jede der verbliebenen Adressen war korrekt: Sie renderte, hatte kein noindex und leitete nicht weiter. Weniger Adressen in der Sitemap sehen nach Aufräumen aus, nicht nach einem Defekt. Finden lässt sich das nur durch einen Vergleich der Adressmenge vor und nach der Änderung.
Fehler 4: >- als Bildadresse
Die Integration zog heroImage per regulärem Ausdruck aus dem Frontmatter, Zeile für Zeile. Bei einem gefalteten YAML-Block (heroImage: >-) steht der Wert in der nächsten Zeile, also fing der Regex das wörtliche >-. Die Sitemap bekam Einträge wie <image:loc>https://wppoland.com/>-</image:loc>.
Am 17. September 2026 gab es auf der Produktion 31 solcher Einträge in sechs Sprachen. Die Search Console zeigte fünf Fehler für pl/sitemap-blog.xml, während das XML selbst korrekt aufgebaut und jedes <loc> in Ordnung war. Auch das YAML in den Dateien war korrekt. Kaputt war der Leser.
Der Fix parst das Frontmatter mit einem YAML-Parser, und die Funktion, die die Metadaten ausliest, haben wir aus der Integration exportiert, damit ein Test sie ohne vollständigen Build erreicht. Vorher steckte sie mitten in einer 900-zeiligen Datei, und kein Test kam an sie heran.
Fehler 5: IndexNow schickte Adressen, die es nicht gibt
Das IndexNow-Skript baute Adressen aus Dateinamen in src/content/. Am 17. September 2026 erzeugte es 2328 Adressen, von denen 0 in der Sitemap vorkamen. Blogbeiträge bekamen ein Segment /blog/, das es in den Adressen nicht gibt, und Seiten behielten das Sprachsuffix aus dem Dateinamen (/de/about.de/). Beide Varianten lieferten 301. Dazu erfasste das Dateimuster nur .md, sodass 100 Service-Säulen in .mdx nie gesendet wurden.
Der Fix passt in einen Satz: Die Quelle der Adressen für IndexNow ist sitemap-index.xml. Diese Menge ist bereits geprüft: Die Seiten rendern und haben kein noindex. Die Heuristik aus Dateinamen verschwand samt drei Fehlerklassen.
Fehler ohne Fehler: Google hat die Sitemap nicht abgerufen
Dieser Fall war kein Defekt des Generators, gehört aber zur selben Familie. Anfang September 2026 zählten die sechs Standort-Sitemaps nach der Freigabe der Städteseiten 4071 Adressen. Auf unserer Seite war alles korrekt: Stichproben lieferten 200 und index, follow, keine Adresse aus der Sitemap war noindex oder eine Weiterleitung.
Die Search Console hatte diese Sitemaps zuletzt am 1. September um 10:08 abgerufen, als sie 2037 Adressen hatten, und sie fünf Tage lang nicht aktualisiert. Die Blog-Sitemaps las sie täglich. Alles, was nach dieser Uhrzeit hinzukam, existierte für Google nicht. Eine erneute Einreichung über die API wurde noch am selben Tag abgerufen.
In der Woche darauf stieg die Zahl der Städteseiten mit Impressionen von 223 auf 343 und ihre Impressionen von 1570 auf 4382. Diese 343 Seiten sind 8,4 Prozent von 4071 und brachten in sieben Tagen 2 Klicks. Freigeschaltet wurde die Entdeckung, nicht der Traffic, und das sind zwei verschiedene Zahlen.
Was ein Eintrags-Inspektor nicht sieht
| Fehler | Wie er in der Sitemap aussah | Findet ihn eine Eintragsprüfung | Was ihn gefunden hat |
|---|---|---|---|
| Build-Datum als lastmod | alle Einträge mit einem Datum | ja, als wiederholtes lastmod | Zahl verschiedener Daten in der Datei |
| Alternativen neben noindex | korrekte <loc>, fehlerhafte xhtml:link | teilweise, wenn sie Alternativen prüft | noindex-Bericht der Search Console |
| 500 Seiten außerhalb der Sitemap | jeder vorhandene Eintrag korrekt | nein | Vergleich der Adressmenge vorher und nachher |
>- als Bild | 31 fehlerhafte image:loc | ja, wenn sie Bilder prüft | Sitemap-Fehler in der Search Console |
| IndexNow außerhalb der Sitemap | Sitemap korrekt | nein, Fehler außerhalb der Sitemap | Schnittmenge der Sendeliste mit der Sitemap |
| Sitemap nicht abgerufen | Datei korrekt und aktuell | nein | Abrufdatum in der Search Console |
Ein Plugin wie das, das Joost verwendet hat, beantwortet die Frage “Ist das, was in der Sitemap steht, korrekt?”. Das ist eine gute Frage, und die meisten Websites beantworten sie, wie er gezeigt hat, nicht. Drei unserer sechs Fälle betrafen aber etwas anderes: was in der Sitemap fehlt, was sie weiterverwendet und welche Version Google sieht.
Checkliste für den Sitemap-Generator
Die Eintragsprüfung ist eine notwendige Bedingung, keine hinreichende. Diese fünf Punkte prüfen den Generator, nicht die Datei selbst:
- Zählen Sie die verschiedenen
lastmod-Werte in jeder Datei. Ein Wert für Hunderte Einträge ist ein Stempel, kein Datum. Dasselbe gilt vor dem Einsetzen eines neuen Datumsfelds: Haben fast alle Dateien darin denselben Wert, taugt das Feld nicht fürlastmod. Keinlastmodist besser als ein falsches. - Vergleichen Sie die Adressmenge vor und nach einer Änderung am Generator. Zahl der hinzugefügten und entfernten Adressen, mit Liste. Ein Rückgang der Adresszahl braucht ebenso eine Erklärung wie ein Anstieg.
- Jedes Feld, das eine Adresse trägt, unterliegt denselben Filtern.
loc, Sprachalternativen,x-default,image:loc. Ein Filter auf einem davon schützt die anderen nicht. - Eine aus einer anderen Komponente kopierte Regel kommt mit ihrer Bedingung. Eine Weiterleitung “bei 404” ist nicht dasselbe wie eine Weiterleitung immer.
- Die Sitemap ist die einzige Adressquelle für alles, was Adressen weitergibt: IndexNow, Indexing API, Listen zur manuellen Einreichung. Und einmal pro Woche: das Datum des letzten Abrufs in der Search Console und die dort sichtbare Adresszahl neben der Zahl der
<loc>in der Live-Datei.
Zwei Dinge aus der Google-Dokumentation, die man griffbereit haben sollte: Eine Sitemap-Datei fasst höchstens 50 000 Adressen oder 50 MB unkomprimiert, und die Werte <priority> und <changefreq> werden ignoriert. Sie schaden nicht, aber Arbeit lohnt sich an ihnen nicht.
Läuft die Website als headless WordPress, kommt die Frage hinzu, wer die Sitemap überhaupt erzeugt, das Frontend oder WordPress. Das haben wir separat im Text über Sitemap und kanonische Adresse in headless WordPress beschrieben.