Thorsten Balls Prognosen und die Daten, an denen wir sie prüfen
Am 19. September 2026 veröffentlichte Thorsten Ball auf X einen kurzen Beitrag: Die meisten Prognosen, die er sieht, seien noch viel zu vorsichtig, also legt er eigene vor. Dazu gehört eine Notiz mit dem Titel „What I believe about the future of software development“ und 16 Thesen. Ball ist Mitgründer und Mitentwickler von Amp, hat vorher bei Sourcegraph und Zed gearbeitet und zwei Bücher über Programmierung im Selbstverlag herausgebracht. Das ist keine Stimme von außerhalb der Branche.
Die Thesen sind scharf: Code Review wird sterben, Unit Tests könnten sterben, das Terminal ist tot, Open Source in seiner heutigen Form ergibt keinen Sinn mehr. Wir antworten auf jede einzeln, mit einer Bewertung: Wir stimmen zu, wir stimmen teilweise zu oder wir widersprechen.
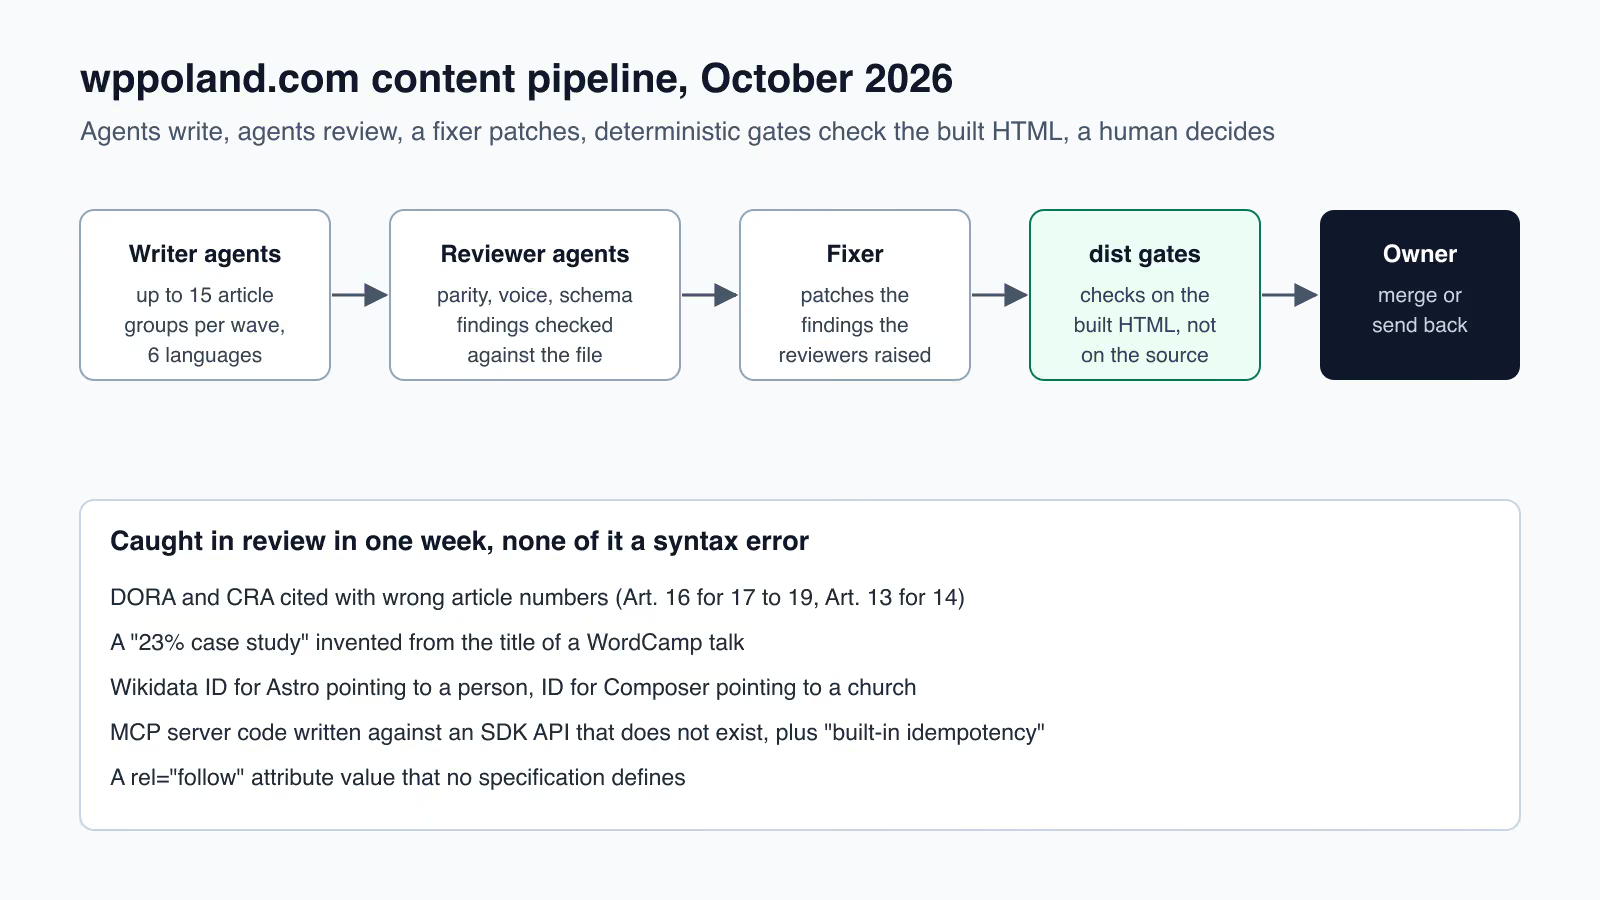
Unsere Belege stammen aus einer Quelle, die wir aus nächster Nähe kennen: aus der KI-Agenten-Pipeline, die im Oktober 2026 die Inhalte dieser Website ausbaut. Die schreibenden Agenten arbeiten parallel und bearbeiten in einer Welle bis zu 15 Artikelgruppen in sechs Sprachen. Laut Repository-Historie umfasste Welle 20 vom 15. Oktober 14 Gruppen und 85 Dateien. Unabhängige Review-Agenten prüfen die Übereinstimmung der Sprachversionen, den Stil und die strukturierten Daten, ein eigener Agent korrigiert, was sie gemeldet haben. Am Ende entscheiden Prüfungen, die auf dem gebauten HTML laufen, ob eine Änderung überhaupt weitergehen darf. Das Schema zeigt die Abbildung oben auf der Seite.
Die Pipeline arbeitet auf einer Live-Website mit Tausenden von Seiten. Ein Agentenfehler, den niemand bemerkt, landet also direkt in der Suchmaschine. Deshalb ist unsere Sicht auf die Zukunft der Softwareentwicklung enger als die von Ball, stützt sich aber auf das, was wir in der letzten Woche selbst gesehen haben.
Zukunft der Softwareentwicklung nach Thorsten Ball
Hier stehen alle Thesen der Notiz in der Reihenfolge des Autors, mit unserer Bewertung. Jede wird weiter unten ausgeführt.
| These von Thorsten Ball | Unsere Bewertung |
|---|---|
| Code Review wird sterben | Wir widersprechen, das Review wechselt den Gegenstand |
| Unit Tests könnten sterben | Wir widersprechen |
| Das Handwerk des Codeschreibens verschwindet | Wir stimmen teilweise zu |
| Das Handwerk, Software zu bauen, wird wichtiger als je zuvor | Wir stimmen zu |
| Die meisten Fehler sind „Sie haben um das Falsche gebeten“ | Wir stimmen zu |
| Open Source in seiner heutigen Form ergibt keinen Sinn mehr | Wir widersprechen |
| Menschliche Beiträge zur Performance bleiben ein Randfall | Wir stimmen teilweise zu |
| Das Terminal ist tot | Wir widersprechen |
| Tokens sind das neue Computing-Paradigma | Wir stimmen teilweise zu |
| Die Triade aus PM, Design und Engineering verschwindet | Wir stimmen teilweise zu |
| Der Abstand zwischen großen und kleinen Unternehmen wächst | Wir stimmen teilweise zu |
| Es gibt keinen Beweis, dass „guter Code“ eine Rolle spielen wird | Wir stimmen teilweise zu |
| Manche können sich die Softwareproduktion nicht mehr leisten | Wir stimmen teilweise zu |
| Fraglich, ob günstigere Modelle genutzt werden | Wir stimmen zu |
| UI wird spontan generiert | Keine Daten auf unserer Seite |
| Das dauert eine Generation | Wir stimmen zu |
Bilanz: In vier Punkten geben wir Ball recht, in vier widersprechen wir, in sieben sehen wir die Richtung, aber nicht das Ausmaß, und in einem fehlen uns Daten.
Ist Code-Review mit KI noch sinnvoll
„Code Review wird sterben. Ich meine: Es ist schon tot. Aber in Zukunft werden Menschen keinen Bug und kein Problem in Code finden, den ein Modell erzeugt hat, zumindest nicht in vertretbarer Zeit. Menschen werden nur noch das System und seine Komposition prüfen, aber nicht in PRs und nicht, indem sie jede Codezeile durchgehen.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir widersprechen, auch wenn die zweite Hälfte der These zutrifft.
In einem Punkt hat Ball recht: Wer pro Welle Hunderte Dateien Zeile für Zeile durchsieht, hat keine Chance. Seine Schlussfolgerung ist trotzdem falsch. Das Review stirbt nicht, es wechselt seinen Gegenstand. In unserer Pipeline sucht niemand mehr nach einem fehlenden Semikolon. Der Prüfer sucht nach einer falschen Behauptung, die syntaktisch einwandfrei ist.
Die Liste aus einer einzigen Oktoberwoche 2026, gefunden von den Prüfern:
- Agenten nannten in Texten über Regulierung falsche Artikelnummern: Artikel 16 DORA, wo die Artikel 17 bis 19 richtig gewesen wären, und Artikel 13 CRA, wo Artikel 14 gemeint war.
- Ein Agent machte aus dem bloßen Titel eines WordCamp-Vortrags eine „Fallstudie mit einem Ergebnis von 23 Prozent“. Eine solche Studie gab es nicht.
- Die für Astro angegebene Wikidata-Kennung verwies auf eine Person, die für Composer auf eine Kirche.
- Ein Agent schrieb den Code eines MCP-Servers für eine SDK-API, die es nicht gibt, und schrieb dem MCP-Protokoll eine „eingebaute Idempotenz“ zu, die es nicht hat.
- In einem Text über Links tauchte das Attribut
rel="follow"auf, das keine Spezifikation definiert.
Keiner dieser Fehler ist ein Codefehler im klassischen Sinn. Jeder hätte den Compiler, den YAML-Parser und den Markdown-Validator passiert. Jeder wäre veröffentlicht worden, wenn das Review gestorben wäre. Dazu kommt: Einige davon sind Behauptungen, die Leser ungeprüft übernehmen, weil sie wie Fakten aus einer Dokumentation klingen.
Die zweite Hälfte von Balls These trifft zu: Das Review wandert von PRs zum System. Unsere Prüfer lesen keine Diffs, sie gleichen Behauptungen mit Quellen und Sprachversionen untereinander ab. Aus „Ist diese Zeile korrekt“ wird „Ist dieser Satz wahr, und hält das Ganze zusammen“. Das passiert nicht im Fenster eines Pull Requests, aber es passiert weiterhin, und beim Menschen bleibt die Entscheidung, ob eine Änderung in Produktion geht.
Braucht man Unit-Tests mit KI noch
„Unit Tests könnten auch sterben. Wozu Stützräder, wenn man nie umfällt? Modelle haben für mich 900 Zeilen Arduino-C geschrieben, sie ohne einen einzigen Fehler kompiliert und auf das Gerät geschickt, wo das Programm einwandfrei lief. 900 Zeilen werden in Zukunft nichts sein.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir widersprechen.
Das Arduino-Beispiel ist echt und beeindruckend. Es beweist aber etwas anderes, als die These nahelegt. Ein Programm, das kompiliert und läuft, erfüllt ein einziges Kriterium: Es tut etwas, ohne abzustürzen. Offen bleibt, ob es bei jeder Eingabe tut, was der Autor wollte, und ob es das nach der nächsten Änderung noch tut.
Auf unserer Website haben sich die Tests als am wertvollsten erwiesen, die das Build-Ergebnis prüfen und nicht den Quellcode. Prüfungen auf dem Verzeichnis dist zählen die H1-Überschriften jeder Seite, kontrollieren, ob Markdown-Syntax als Text durchgerutscht ist und ob die strukturierten Daten zur kanonischen URL passen. Diese Prüfungen fanden Regressionen in Änderungen, die ohne eine einzige Warnung kompiliert hatten. Der Compiler weiß nicht, dass eine Seite eine H1-Überschrift haben sollte und zwei hat.
Ein Test ist kein Stützrad. Er hält eine Erwartung in einer Form fest, die eine Maschine bei jeder weiteren Änderung prüft, auch bei der, die ein Agent in einem halben Jahr macht. Je mehr Code Modelle schreiben, desto mehr lohnt sich so eine Festlegung, weil kein Mensch alles liest, was sie erzeugt haben. Was sich eher ändert, ist die Ebene der Tests: weniger Tests einzelner Funktionen, mehr Tests des Verhaltens und Ergebnisses des ganzen Systems.
Lohnt es sich 2027 noch, programmieren zu lernen
„Das Handwerk des Codeschreibens wird verschwinden. Ja, es gibt noch italienische Schuhmacher. Aber schauen Sie auf Ihre Füße.“
„Das Handwerk, Software zu bauen, wird wichtiger sein als je zuvor. Zu wissen, wie man Geschäftsprobleme mit Software löst, wie andere Software das gemacht hat und warum so und warum nicht, wann und wie man ausliefert, wie man Feedback dazu bekommt: Das ist das neue Spiel.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Der ersten These stimmen wir teilweise zu, der zweiten voll.
Code Zeile für Zeile zu schreiben verliert tatsächlich an Bedeutung. In unserer Pipeline schreiben Agenten Inhalte, Korrekturen und Hilfsskripte schneller als jeder von uns. Um aber zu beurteilen, ob der Code eines MCP-Servers eine API aufruft, die existiert, muss man diesen Code lesen können und wissen, wo man im SDK nachschaut. Das Lesen von Code verschwindet nicht zusammen mit dem Schreiben. Der Schuhmacher aus Balls Bild muss keine Schuhe mehr nähen, aber jemand muss erkennen, dass die Sohle schief aufgeklebt ist.
Die zweite These ist der treffendste Satz der ganzen Notiz. Zu wissen, was man baut, wie man es aufteilt, wann man es ausliefert und wie man die Wirkung misst, ist heute der Engpass. Unser Repository hat dafür ein eigenes Dokument mit Produktgrundsätzen. Es beginnt mit der Feststellung, dass das Problem nicht mehr „Wie setzen wir das um“ heißt, sondern „Was sollte überhaupt entstehen“.
Auf die Frage, ob man programmieren lernen sollte, antworten wir deshalb: Lernen Sie, Software zu bauen, und betrachten Sie das Schreiben von Code als Weg, zu verstehen, was ein Agent produziert. Ob KI Webentwicklern die Arbeit wegnimmt, behandeln wir ausführlicher im Beitrag Werden KI WordPress-Entwickler ersetzen, die Arbeit mit Agenten im Team im Artikel über Agentic Engineering.
Fehler in KI-Code entstehen oft durch falsche Anforderungen
„Die meisten Bugs werden keine ›Coding‹-Bugs sein. Es werden Bugs der Art ›Sie haben um das Falsche gebeten‹ sein.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir stimmen zu.
Diese These bestätigt unsere teuerste Lektion. Frühere Aufgabenpakete für die Agenten verlangten, Artikel auf eine bestimmte Wortzahl auszubauen. Die Agenten taten genau das: Sie ergänzten Text, der den Zähler erhöhte und keinen Inhalt brachte. Der Code der Skripte war fehlerfrei. Falsch war die Anforderung. Heute verbietet eine Regel im Repository Skripte, die Inhalte auf eine Wortzahl auffüllen, und eine eigene Prüfung erkennt wiederkehrende Füllblöcke.
Derselbe Mechanismus zeigt sich bei der erfundenen Fallstudie mit 23 Prozent. Der Agent bekam die Aufgabe „Füge einen Abschnitt auf Basis von Quellen hinzu“ und eine Quelle, die nur aus dem Titel eines Vortrags bestand. Das Modell füllte die Lücke mit einer Zahl. Die Anforderung sagte nicht, was zu tun ist, wenn die Quelle zu dünn ist.
Die praktische Folgerung: Die meiste Zeit in der Arbeit mit Agenten kostet heute das Formulieren der Aufgabe, also die Beschreibung, was das Ergebnis ist, was verboten ist und was zu tun ist, wenn Daten fehlen. Das ist eine Spezifikation, nur kürzer und häufiger geschrieben als früher.
Hat Open-Source durch KI noch eine Zukunft
„Open Source in seiner heutigen Form ergibt keinen Sinn mehr. ›Bei genügend Augen sind alle Fehler oberflächlich‹ (eigene Übersetzung) stimmt immer noch, aber jetzt haben wir künstliche Augen.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir widersprechen.
Ball bezieht sich auf Linus’ Gesetz, formuliert von Eric S. Raymond: Bei genügend vielen Beteiligten werden Fehler schnell gefunden. Die These lautet, dass das offene Beitragsmodell seinen Sinn verliert, wenn Modelle statt Menschen auf den Code schauen können.
Die Daten aus einem der wichtigsten Open-Source-Projekte zeigen den gegenteiligen Effekt. Daniel Stenberg, Autor von curl, beendete das Bug-Bounty-Programm des Projekts am 31. Januar 2026. Seit 2019 hatte das Programm 87 bestätigte Schwachstellen und über 100.000 USD an Prämien für Forscher gebracht. Laut Stenberg erwiesen sich in früheren Jahren über 15 Prozent der Meldungen als echte Schwachstellen, seit 2025 fiel der Anteil bei einer Flut KI-generierter Berichte unter 5 Prozent. Nicht einmal eine von zwanzig Meldungen war echt.
Künstliche Augen gibt es, aber in dieser Form erzeugen sie Meldungen statt Korrekturen und belasten genau die menschlichen Maintainer, die von ihnen profitieren sollten. Open Source ändert also seine Eingangsfilter, nicht sein Prinzip. WordPress, mit dem wir täglich arbeiten, lebt weiterhin von offenem Code und von Menschen, die entscheiden, was in den Core kommt. Diese Auswahl verschwindet nicht, wenn es mehr Code gibt. Sie wird wichtiger.
Spielt die Performance von Code mit KI noch eine Rolle
„Performance-kritische Beiträge von Menschen bleiben, was sie sind: ein Randfall. Bei 99 % der Software spielt es keine Rolle, dass man einen schnelleren Algorithmus hätte schreiben oder eine bessere Datenstruktur hätte wählen können. […] Wenn es darauf ankommt, können die Modelle das beheben.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir stimmen teilweise zu.
Gegen den ersten Teil lässt sich wenig sagen. Der meiste Code ist kein Engpass und wird nie einer sein. Strittig ist der Satz „Die Modelle können das beheben“. Ein Modell behebt ein Performance-Problem, wenn jemand weiß, wo die Zeit verloren geht. In unserem Build lag das Problem nicht in einem Algorithmus, den jemand besser hätte schreiben können, sondern in einem Schritt, an den niemand gedacht hatte, bis wir die Dauer der einzelnen Phasen gemessen haben. Die Messung machte ein Mensch, die Korrektur konnte danach ein Modell schreiben.
Bei WordPress-Websites sieht es in der Praxis ähnlich aus: Ein langsamer Shop hat selten einen einzigen schlechten Algorithmus. Er hat zu viele Plugins, Abfragen ohne Index oder einen Cache an der falschen Stelle. Die Entscheidung, was wegfällt, verlangt Verständnis für das Geschäft des Kunden, nicht nur einen Profiler.
Stirbt das Terminal durch KI-Agenten
„Das Terminal ist tot. Die meisten Entwicklerwerkzeuge werden von Tokens weggespült. Shells, Texteditoren und CLI-Tools werden nicht mehr von Menschen benutzt.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir widersprechen, verstehen aber, woher die These kommt.
Ball betont selbst, dass er das als Liebhaber des Terminals schreibt. Er hat recht, dass Menschen sich immer seltener die Flags von jq merken. Unsere Pipeline zeigt aber, dass das Terminal nicht verschwindet, sondern seinen Nutzer wechselt. Die Agenten arbeiten genau in der Shell: Sie führen npm run gates:run aus, lesen Dateien, rufen git auf. Jede Prüfung, die ihre Fehler findet, ist ein Kommandozeilenskript.
Das Terminal wird zur Schnittstelle für Agenten und für den Menschen, der kontrolliert, was ein Agent getan hat. Meldet ein Prüfer einen Fehler, ist ein einzelner grep-Befehl auf der Datei der schnellste Weg zur Verifikation. Menschen schreiben weniger Befehle, lesen aber mehr davon.
Tokens als neues Computing-Paradigma erklärt
„Tokens sind das neue Computing-Paradigma. Alles wird darauf neu aufgebaut. […] Wir treten in die post-binäre Ära ein.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir stimmen teilweise zu.
Ball merkt an, dass wir 80 Jahre lang deterministische Computer hatten und verwechseln, wie sie funktioniert haben, mit der Art, wie sie funktionieren müssen. Das ist ein fairer Einwand. Unsere Erfahrung fügt eine Einschränkung hinzu: Je mehr Arbeit nicht deterministische Modelle erledigen, desto wertvoller werden die deterministischen Prüfungen um sie herum.
In unserer Pipeline kann ein Agent denselben Satz auf zehn Arten schreiben, aber die Prüfung zählt Überschriften immer gleich. Diese Kombination funktioniert: Das Modell erzeugt, das Skript prüft. Die post-binäre Ära, falls sie kommt, wird auf einem binären Fundament der Kontrolle stehen. Ein verantwortungsvoller Einsatz, bei dem sich ein Modell ohne hartes Kriterium selbst prüft, ist für uns schwer vorstellbar.
Ersetzt KI Produktmanager und Designer
„Die Triade aus PM/Design/Eng wird verschwinden. […] ›Engineers‹, die als ›Fleisch-Proxys‹ agieren, Tickets in Agenten schieben und Menschen Bericht erstatten, werden nicht mehr wertvoll sein.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir stimmen teilweise zu.
Die These von den „Fleisch-Proxys“ trifft. Eine Rolle, die nur Aufgaben zwischen Mensch und Agent weiterreicht, hat keinen Wert, weil der Agent die Aufgabe direkt annimmt. In unserer Pipeline gibt es keinen Vermittler zwischen dem Inhaber und den Agenten.
Die Entscheidungen, die sich die Triade teilte, verschwinden aber nicht mit der Rollenteilung. Jemand muss weiterhin entscheiden, was gebaut wird und was nicht, wie die Oberfläche aussehen soll und ob eine Änderung fertig ist. Bei uns haben sich diese Entscheidungen in einer Person gebündelt, statt sich aufzulösen. Das ist eher eine Zusammenlegung der Rollen in einem Kopf als ihr Ende. Daraus folgt eine Anforderung: Wer Agenten führt, braucht Kompetenzen aus allen drei Bereichen.
KI im kleinen Unternehmen und im Konzern
„Der Unterschied zwischen Softwareentwicklung in großen Konzernen und in kleinen Unternehmen wird größer.“
„Manche Leute werden aus der Softwareproduktion herausgepreist. […] Wenn Sie nicht genug Tokens bekommen, spielen Sie in der zweiten Liga. Sie müssen an die Tokens herankommen.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Beiden Thesen stimmen wir teilweise zu.
Ball schreibt, Start-ups, die Google-Praktiken kopieren, würden noch lächerlicher wirken, weil sie schneller und mit weniger Einschränkungen bauen können. Aus Sicht eines kleinen Teams stimmt das: Unsere Agenten-Pipeline hat kein Architekturgremium, und eine Welle von Änderungen in mehreren Dutzend Dateien geht an einem Tag durch. Was uns vor Fehlern schützt, ist aber genau eine Praxis aus großen Unternehmen: automatische Prüfungen, unabhängiges Review, ein einziger Verantwortlicher für die Entscheidung. Ein kleines Unternehmen kann auf Prozess verzichten, aber nicht auf Kontrolle.
Zu den Tokenkosten: Der Zugang zu starken Modellen kostet tatsächlich Geld, und diese Kosten wachsen mit der Zahl paralleler Agenten. Die Grenze verläuft aber nicht zwischen Reichen und Armen, sondern zwischen denen, die Tokens in ein geprüftes Ergebnis verwandeln können, und denen, die für Text zum Wegwerfen bezahlen. Auch der Fülltext für den Wortzähler hat Tokens gekostet.
Günstiges oder intelligentes KI-Modell zum Programmieren
„Es ist fraglich, ob günstigere Modelle genutzt werden. […] Ein intelligenteres Modell macht weniger Fehler und braucht weniger Durchgänge. Wann denken Sie wirklich: ›Es ist für mich in Ordnung, wenn es ein paar Mal falsch liegt‹?“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir stimmen zu.
Unsere Pipeline hat dieses Prinzip in den Anweisungen des Repositorys festgeschrieben. Der Agent, der Texte und Übersetzungen schreibt, arbeitet mit dem standardmäßigen, stärkeren Modell. Das günstigere Modell übernimmt ausschließlich Reviews mit reinem Lesezugriff, und jede seiner Meldungen wird in der Datei geprüft, bevor jemand etwas korrigiert.
Diese Aufteilung beantwortet Balls Frage direkt. Ein günstiges Modell ist dort akzeptabel, wo ein Irrtum eine einzige Prüfung kostet. Wo ein Irrtum in einem Produktionstext in sechs Sprachen landet, wird die Ersparnis bei den Tokens zu einem längeren Review und mehr Korrekturen. Es zählen die Kosten des ganzen Zyklus, nicht der Preis eines einzelnen Aufrufs.
Ist Clean Code mit KI noch wichtig
„Es gibt keinen Beweis, dass ›guter Code‹ in Zukunft eine Rolle spielen wird. Der Begriff ›guter Code‹ beruht vor allem auf der Vorstellung, dass Menschen leicht, günstig und effizient damit arbeiten können. Aber Menschen werden den Großteil des Codes nicht verändern.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir stimmen teilweise zu.
Eine Zeilenbreite von 80 Spalten spielt für einen Agenten tatsächlich keine Rolle. Ein Teil der Clean-Code-Regeln überlebt jedoch aus einem anderen Grund als der Bequemlichkeit von Menschen: Code muss sich prüfen lassen. Unsere Prüfungen funktionieren nur, weil das Ergebnis eine vorhersehbare Struktur hat. Frontmatter mit einem klaren Feldvertrag, ein einziger Eigentümer für jede Kennung in den strukturierten Daten, eine einzige Funktion, die die URL einer Leistung bestimmt. Als zwei Stellen im Code dieselbe Schema-Kennung ausgaben, lag das Problem nicht in Unschönheit, sondern darin, dass keine Prüfung wusste, welche davon die maßgebliche Quelle ist.
„Guter Code“ bedeutet nicht mehr „angenehm zu lesen“. Er bedeutet zunehmend „Code, dessen Korrektheit sich automatisch verifizieren lässt“. Das ist eine Verschiebung, kein Ende.
Von KI in Echtzeit generierte Benutzeroberflächen
„Modelle werden so schnell, dass UI spontan generiert wird. Viel UI existiert nur, weil Software nicht versteht, was Sie wollen.“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir haben keine Daten, die diese These bestätigen oder widerlegen.
Ball schreibt, Menüs, Einstellungsseiten, Dashboards und Filter seien zu einem großen Teil eine Schnittstelle des Menschen zu einer „dummen Maschine“. Die Beobachtung ist interessant. Wir generieren keine Oberflächen in Echtzeit und haben keine Messung, mit der sich beurteilen ließe, wie eine solche Oberfläche bei Barrierefreiheit, Vorhersehbarkeit und Nutzervertrauen abschneidet. Das sagen wir lieber offen, statt zu raten.
Eine Beobachtung aus unserer Arbeit: Die Nutzer der Websites, die wir bauen, erwarten weiterhin, dass ein Button beim zweiten Besuch an derselben Stelle ist. Eine Oberfläche, die sich bei jedem Aufruf ändert, müsste dieses Bedürfnis irgendwie erfüllen.
Wann KI die Softwareentwicklung verändert
„Es wird eine Generation dauern, bis die ›neue Software‹ die ›alte Software‹ ersetzt. […] In 10 Jahren wird es Menschen geben, die angestellt sind, um Code zu schreiben. Aber wollen Sie diesen Job haben?“
(Thorsten Ball, Beitrag auf X vom 19. September 2026, eigene Übersetzung)
Bewertung: Wir stimmen zu.
Schon die Messung, was KI Entwicklern bringt, erweist sich als schwierig. Die Organisation METR führte 2025 eine randomisierte kontrollierte Studie mit erfahrenen Open-Source-Entwicklern durch, die in ihren eigenen Repositorys arbeiteten. Mit KI-Werkzeugen brauchten sie für die Aufgaben 19 Prozent mehr Zeit. Im Februar 2026 beschrieb METR eine zweite Studie: Für die Entwickler aus der ersten Runde lag die geschätzte Veränderung der Bearbeitungszeit bei minus 18 Prozent (Konfidenzintervall von minus 38 bis plus 9 Prozent), für neue Teilnehmer bei minus 4 Prozent. METR selbst stufte diese Daten aber als unzuverlässiges Signal ein, weil immer mehr Entwickler die Teilnahme ablehnten, da sie nicht ohne KI arbeiten wollten.
Das zeigt die Übergangsphase gut: Die Werkzeuge sind so tief in die Arbeit eingewachsen, dass sich kaum noch eine Kontrollgruppe finden lässt, und gleichzeitig gibt es keine harte Zahl dafür, was sie bringen. Eine Generation ist ein vernünftiger Zeitrahmen für einen solchen Wandel. Balls Frage am Ende der Notiz überlassen wir den Lesern.
Was das für Unternehmen bedeutet, die Software beauftragen
Aus den 16 Thesen ziehen wir vier praktische Schlüsse für Unternehmen, die Websites, Shops und Integrationen in Auftrag geben.
- Fragen Sie, wer Behauptungen prüft und wie, nicht nur den Code. KI-Code kompiliert korrekt. Die Fehler stecken in Fakten, Paragrafen- und Artikelnummern, API-Namen und geschäftlichen Annahmen.
- Verlangen Sie automatische Prüfungen am Ergebnis. Ein Test, der die gebaute Seite oder das Verhalten einer Integration prüft, findet eine Regression, die im Quellcode nicht sichtbar ist.
- Investieren Sie in die Aufgabenbeschreibung. Die meisten Fehler sind falsche Anforderungen. Eine gute Spezifikation ist günstiger als Korrekturen.
- Sparen Sie nicht am Modell, wo das Ergebnis in Produktion geht. Ein günstiges Modell im Review mit Verifikation, ein starkes Modell dort, wo Inhalte oder Code entstehen.
Wenn Sie eine Website oder Anwendung haben, die schnell mit KI-Hilfe gebaut wurde, und nicht wissen, was darin steckt, übernehmen wir die Rettung KI-erstellter Websites. Wenn Sie Agenten mit der oben beschriebenen Kontrolle in Ihre eigenen Prozesse einführen möchten, sehen Sie sich unsere KI-Implementierung und die Entwicklung von MCP-Servern an. Den größeren Zusammenhang, warum KI-Gewinne langsamer kommen, als die Anbieter versprechen, beschreiben wir im Beitrag über das KI-Produktivitätsparadox.
Zuletzt aktualisiert: 15. Oktober 2026.