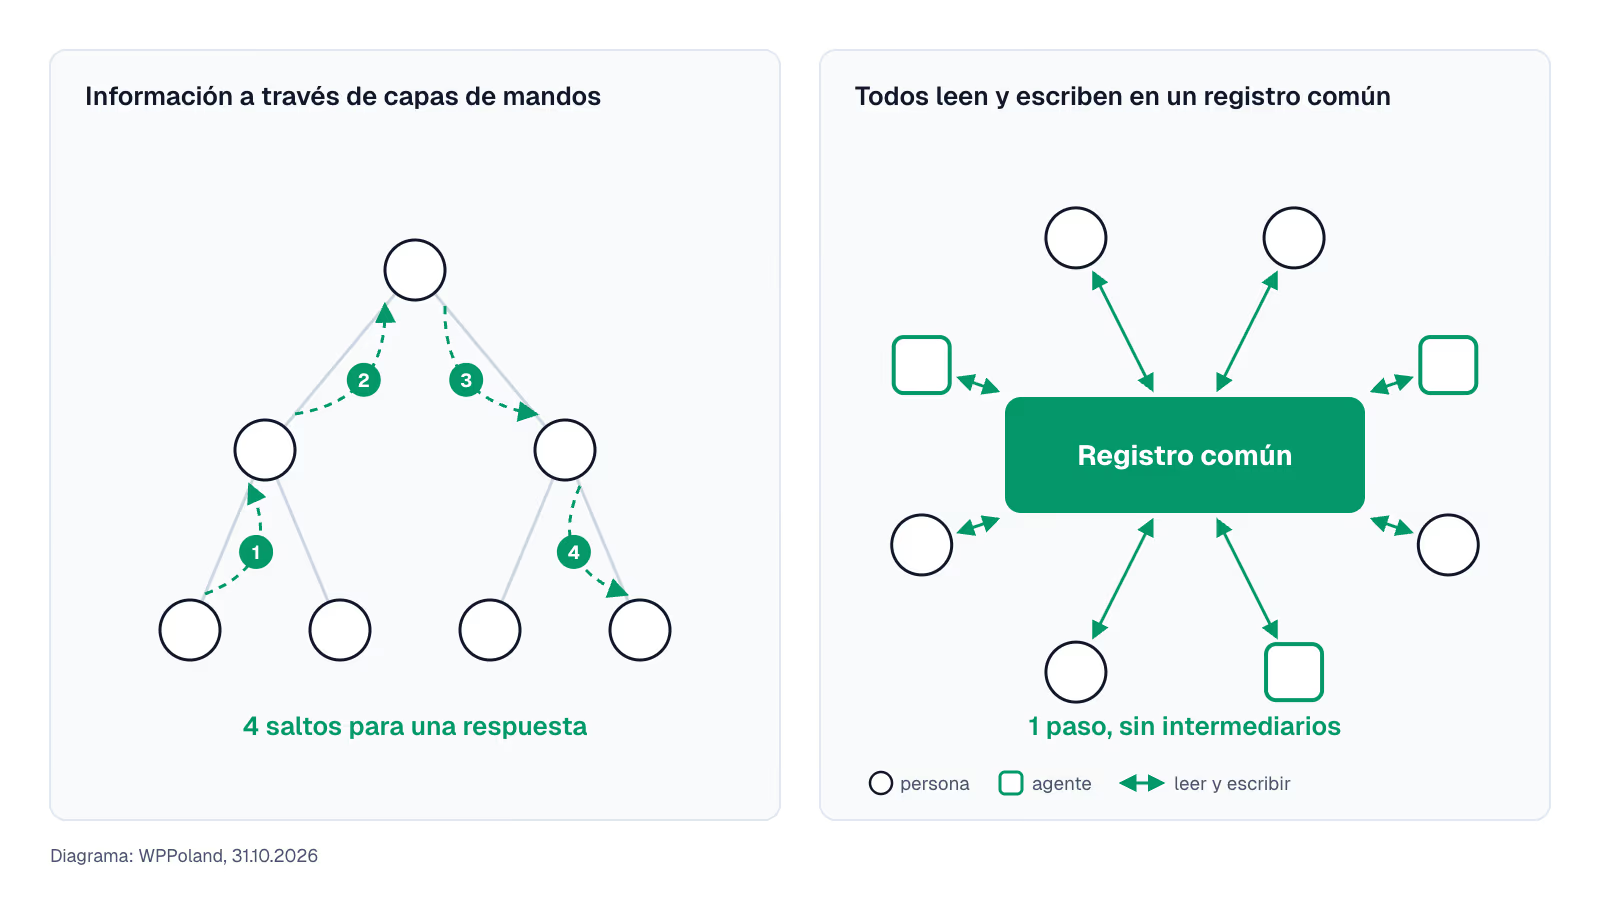
Una peluquería, una clínica o una empresa de reformas recibe una consulta por el formulario de su web un viernes a las 21:00. El dueño la lee el lunes, y desde el sábado el cliente ya está hablando con otra persona. De ahí la idea de que las consultas las gestione una automatización: respuesta en un minuto, reparto a la persona adecuada, nada se pierde en la bandeja de entrada.
La mayoría de las guías empiezan por un modelo de lenguaje que responde al cliente. Yo empiezo por el otro extremo, porque en mi propio formulario de wppoland.com la mayor parte del trabajo la hacen las capas anteriores y posteriores al modelo. A continuación, cinco capas en el orden en que las atraviesa una consulta, con lo que me funciona y con los puntos en los que la IA de verdad aporta.
Cómo filtrar el spam del formulario de WordPress antes de que lo vea la IA
Una automatización que responde al spam hace dos daños a la vez: pagas cada llamada al modelo y envías respuestas a direcciones que solo esperan eso. Por eso el filtro tiene que estar delante del modelo. El mío tiene tres capas.
La primera es un campo trampa invisible. Una persona no lo ve, mientras que un bot sencillo rellena todos los campos. Campo rellenado significa bot.
La segunda es Cloudflare Turnstile verificado en el servidor. El token del navegador llega a mi función, y solo ella pregunta a Cloudflare si es válido. Nunca desde el navegador: el secreto quedaría a la vista y el resultado sería fácil de falsificar. Rechazo las consultas sin token o con un token no válido. Cuando la propia verificación de Cloudflare no responde, la consulta pasa, porque la caída de un servicio ajeno no puede tragarse a clientes reales.
La tercera son firmas de contenido que no aparecen en ninguna consulta real: un enlace HTML escrito a mano en la descripción del proyecto, etiquetas BBCode, un enlace de Telegram en el campo de la web. Además añadí a la lista el nombre de una herramienta para enviar spam a formularios, porque el 29 de julio de 2026 llegó una serie de consultas de casinos desde una dirección que contenía el nombre de esa herramienta.
Turnstile por sí solo no siempre basta. El autor del blog elszczepano contó en agosto de 2026 que Cloudflare marcaba como bot probable aproximadamente la mitad del tráfico de su web en WordPress, y aun así entraban cientos de comentarios de spam (When SIMPLER means BETTER?). Lo que funcionó fue un campo trampa propio enganchado en functions.php: un envío solo pasa cuando ese campo existe y está vacío. Según el autor, desde noviembre de 2025 ningún comentario ha acabado en spam. Su conclusión vale también para formularios: los bots de spam son genéricos, así que incluso un mecanismo sencillo que no esperan filtra a la mayoría.
Al spam le respondo igual que a una consulta real: mensaje de recepción y número. Un remitente que se entera de que ha sido rechazado cambia de dirección y sigue intentándolo.
Qué campos del formulario ahorran trabajo al modelo de IA
Parte de las consultas se puede repartir sin ningún modelo. Mi formulario tiene tres campos de opción cerrada: tipo de proyecto (web nueva, reparación, mantenimiento, migración, otro), plazo y rango de presupuesto. Cada uno se puede repartir con una simple condición en el código, por ejemplo la reparación de una tienda online a la cola urgente y una migración a la persona que se ocupa de migraciones.
Un detalle me costó algo de tiempo. El formulario envía el rango de presupuesto como código, por ejemplo band-3, y los rangos no están en la misma moneda en todos los idiomas (la versión polaca en zlotys, las demás en euros). Un correo solo con el código era ilegible, así que la función añade al código una etiqueta con el importe en el idioma del formulario. La misma lista de etiquetas existe en dos sitios, y por eso una prueba comprueba en cada compilación que ambas sean idénticas.
Solo la descripción del proyecto en texto libre necesita algo más que una condición.
Cómo repartir una consulta del formulario con un modelo de decisión
Para repartir no necesitas un modelo que escriba textos largos. Basta un modelo de decisión: recibe un texto y una lista de opciones y devuelve una de ellas. Por ejemplo: “a qué equipo pasar esta consulta: tienda online, web corporativa, integración, otro” o “es urgente esta consulta: sí, no”.
Hay al menos dos modelos así en el mercado. Jev, que uso en el control de calidad de textos de este repositorio, y Clef, que Cloudflare publicó a principios de octubre de 2026 en Workers AI y en Hugging Face, con licencia Apache 2.0 y compatible con la API de Jev. Según las mediciones de la propia Cloudflare, la latencia mediana es de 209,3 ms para Clef, 38,8 ms para el más pequeño Clef-flash y 524,1 ms para Jev (Cloudflare). Son cifras del fabricante, así que las comparaciones independientes pueden dar otro resultado.
Para una empresa polaca hay una tercera opción, basal de Remek Kinas: funciona en polaco e inglés, tiene pesos abiertos con licencia Apache 2.0 y se ejecuta en local, también en un Mac con Apple Silicon o mediante Ollama, así que el contenido de las consultas no sale de la empresa. Responde a los mismos tipos de pregunta que Jev mediante un endpoint con el mismo nombre. Desde la versión 2.2 incluye basal-calibrate, que ajusta la confianza del modelo a unos cientos de ejemplos etiquetados de tu propio proceso, y las preguntas con un error máximo definido marcan los casos inciertos como aplazados, es decir, para que decida una persona. El autor mide la calidad con su propio benchmark Werdykt, así que prueba el modelo con tus consultas antes de confiar en él. El español no está soportado.
El coste con mis números: evaluar 300 párrafos con Jev costó un centavo, y pasar por él todo el corpus, unos 134 000 párrafos, costaría 3,32 USD y llevaría 100 minutos. Con unas decenas de consultas al mes, el coste de un modelo de decisión es despreciable. Lo que cuesta más es el tiempo de configurarlo y de comprobar que el reparto es correcto.
Cuándo debe el modelo de decisión pasar la consulta a una persona
Las capas anteriores forman una jerarquía que Parth Parikh compara con la memoria de un ordenador en su ensayo To Make, or to Buy: The Economics of Decision Models, de octubre de 2026: las reglas resuelven lo que pueden, un modelo de decisión se ocupa de la parte siguiente, un modelo de lenguaje de los casos más difíciles y una persona del resto. Cada nivel responde solo donde está seguro y pasa lo demás al nivel siguiente. En mi formulario, las reglas son los campos de opción fija, el modelo de decisión reparte la descripción libre del proyecto, el modelo de lenguaje escribe el borrador de la respuesta y una persona lo aprueba.
Queda por saber cuánta seguridad necesita el modelo de decisión. Parikh recurre a la regla de Chow (que él fecha en 1970): un nivel responde cuando la probabilidad de error, es decir, 1 menos la probabilidad más alta, es menor que el coste de pasar al nivel siguiente. Ese coste, medido en unidades de una respuesta errónea, es la tasa de error del nivel siguiente más su precio dividido entre el coste de un error.
Un ejemplo hipotético en unidades de coste abstractas. Una consulta asignada a la persona equivocada cuesta 50 unidades (retraso, un día perdido). Una persona que la lee y la asigna cuesta 5 unidades y se equivoca en el 2 % de los casos. El umbral queda en 0,02 + 5/50 = 0,12, así que el modelo solo asigna por su cuenta cuando su mejor opción tiene una probabilidad superior a 0,88. La comprobación con 100 consultas en las que el modelo está seguro al 70 %: si las asigna todas, 30 acaban en el sitio equivocado, es decir, 30 × 50 = 1500 unidades. Si las asigna todas una persona: 100 × 5 + 2 × 50 = 600 unidades. Sale más barata la persona. Con un 95 % de seguridad sale más barato el modelo: 5 × 50 = 250 unidades frente a las mismas 600.
Si una consulta mal asignada cuesta 500 unidades, por ejemplo una reclamación con plazo, el umbral baja a 0,02 + 5/500 = 0,03 y el modelo necesita más del 97 % de seguridad. Entonces el precio del trabajo de la persona apenas cambia el resultado, y lo que decide es la frecuencia con la que la propia persona se equivoca. Si tu modelo permite fijar un error máximo, como basal, este cálculo te da el valor que debes introducir en lugar de una corazonada.
Parikh añade dos salvedades. Un modelo puede equivocarse con mucha seguridad, así que envía igualmente una pequeña muestra aleatoria, por ejemplo el 1 % de las decisiones seguras, al nivel siguiente; de paso verás la tasa de error real. Y no todos los errores cuestan lo mismo: un asunto legal enviado al equipo equivocado cuesta más que una confusión entre dos colas técnicas, así que el coste del error debería depender de la categoría.
Cuáles son las limitaciones y los errores de clasificadores como Jev en la práctica
Actualización del . Las pruebas independientes y las mediciones de ingeniería sobre modelos de clasificación (analizadas en el estudio JEV sin hype: clasificadores de IA frente a LLMs clásicos) desmienten las promesas de ausencia total de alucinaciones o de un supuesto Sistema 1 intuitivo. En la práctica, la arquitectura de modelos como Jev se apoya en la inferencia zero-shot NLI (Natural Language Inference) sobre modelos codificadores (estructuras derivadas de BERT). En lugar de generar texto token a token, el modelo evalúa la probabilidad de las etiquetas en una sola pasada. Esto aporta una velocidad entre 20 y 200 veces superior a la de los modelos conversacionales, pero presenta cuatro limitaciones claras:
- Error forzado cuando ninguna opción encaja: El clasificador no inventa palabras ajenas a la lista, pero si la consulta no encaja en ninguna categoría prevista, Jev rara vez escoge la ausencia de coincidencia. En pruebas independientes, la elección correcta de “ninguna de las anteriores” solo se produjo en el 7 % de los casos; en el 93 % restante, el modelo forzó la asignación a una etiqueta incorrecta.
- Sensibilidad al orden de las opciones: Cambiar el orden de las etiquetas en la lista reduce la precisión de un 91 % a un 76,5 %. Para estabilizar el enrutamiento en producción, debes permutar el orden de las opciones y promediar las probabilidades (ensemble averaging), o aplicar una ordenación alfabética fija con margen de seguridad.
- Falta de comprensión numérica y de presupuestos: Si un cliente detalla su presupuesto en el mensaje (por ejemplo, 15 000 €), el modelo NLI falla en más del 90 % de los casos al relacionar la cifra con su rango correspondiente. Los importes numéricos, las fechas y los datos estructurados deben extraerse siempre mediante expresiones regulares deterministas o esquemas de validación Zod antes de consultar al modelo.
- Vulnerabilidad a inyecciones de instrucciones (prompt injection): Al entrar el texto directamente en el contexto de atención del codificador, cualquier instrucción manipulada en el formulario puede alterar los pesos y falsear la prioridad del ticket.
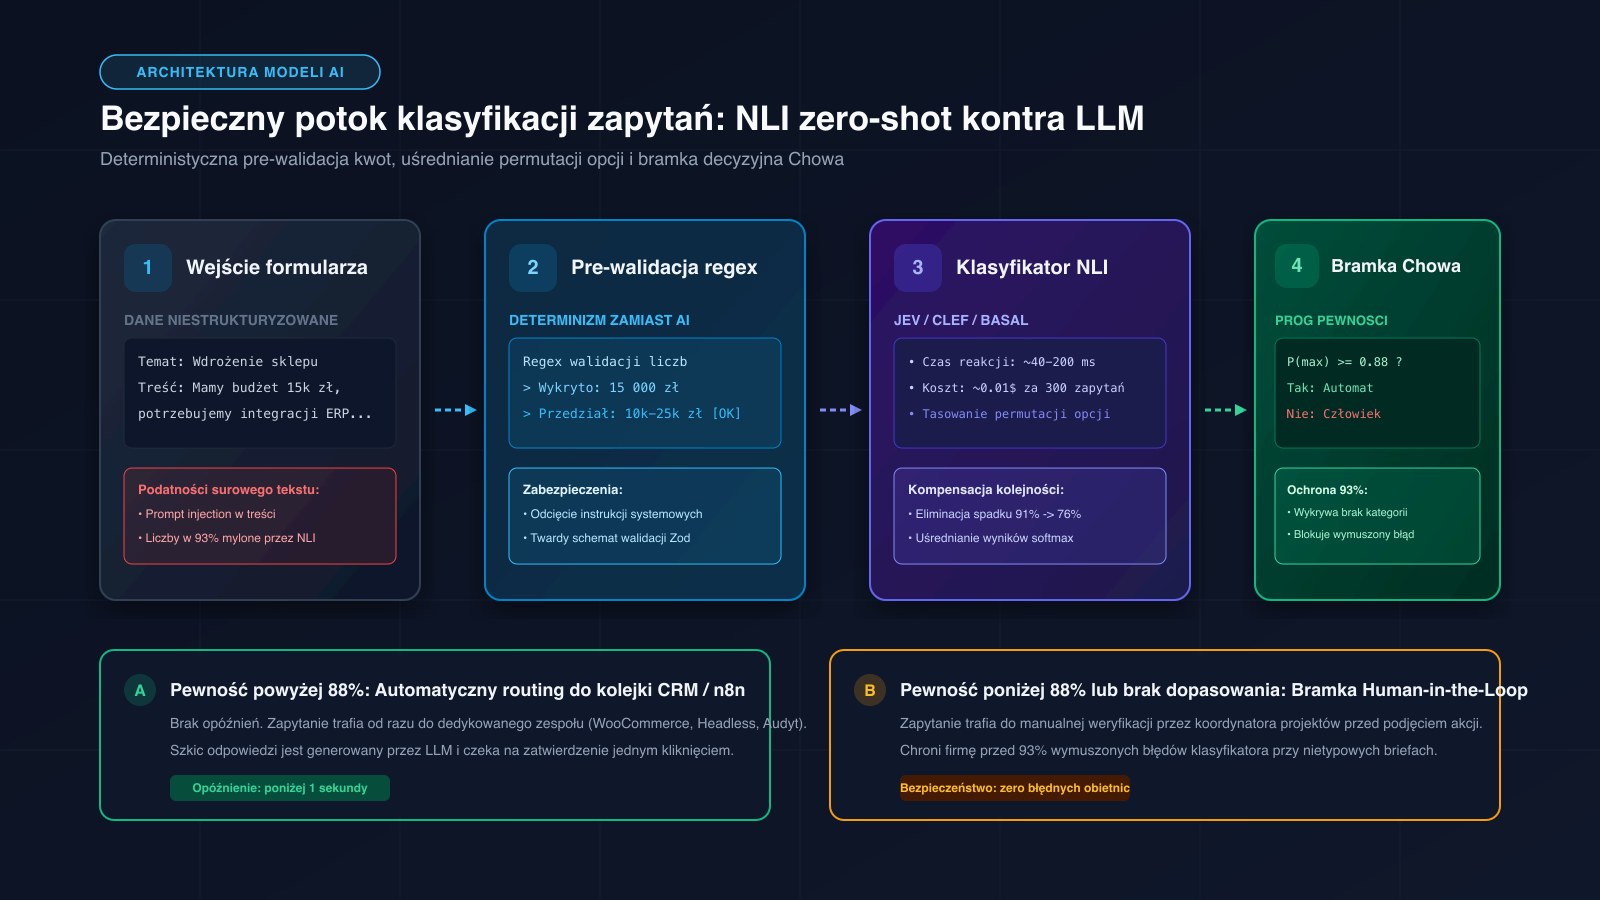 Flujo de decisión seguro: extracción determinista de cifras con regex, compensación del orden de opciones y verificación del umbral de Chow antes de la revisión humana.
Puede la IA responder sola a los clientes del formulario
Técnicamente, sí. En la práctica, la primera respuesta a una consulta suele indicar un plazo, un alcance o un precio, es decir, una promesa en nombre de la empresa. Un modelo que le escribe al cliente “lo hacemos en una semana” en un proyecto de dos meses cuesta más de lo que ahorra.
Anthropic describe el mismo principio en su guía sobre agentes para comercio: ninguna llamada a herramientas que haga el modelo mueve dinero ni cambia nada en la empresa, y lo peor que puede hacer el modelo es proponer un cambio que aprueba una persona o una regla (A guide to the anatomy of effective commerce agents). Los pedidos, pagos, reembolsos y cambios de precio pasan allí por la misma aprobación que la empresa ya usa para esos cambios sin IA. Una respuesta con presupuesto para el cliente es el mismo tipo de cambio.
Una configuración más segura: el modelo prepara el borrador y lo envía una persona. El borrador recibe el contexto de los campos del formulario y la descripción del servicio al que se refiere la consulta. La aprobación lleva un minuto, y el cliente recibe respuesta el mismo día en lugar del lunes. Sin intervención humana solo debería salir la confirmación de recepción con el número de referencia. En mi caso, el cliente ve ese número, en un formato con la fecha y un sufijo aleatorio, nada más enviar el formulario.
Cómo conectar un formulario de WordPress con n8n y Claude
Hay dos caminos. El primero es n8n: el formulario envía los datos a un nodo Webhook, que inicia el flujo. El nodo tiene una dirección de prueba y otra de producción separadas, así que puedes probar el flujo sin tocar el formulario que está en marcha (documentación de n8n). Más adelante en el mismo flujo, n8n tiene un nodo Anthropic listo para el borrador de respuesta en Claude y nodos para correo, Slack o un CRM.
El segundo camino es código propio. Mi formulario lo gestiona una función en Cloudflare Pages: validación de campos, filtro de spam, Turnstile, envío y telemetría en un solo archivo. Menos piezas que mantener y control total sobre lo que acaba en los registros, pero cada cambio requiere un programador.
La elección depende de quién vaya a cambiar las reglas. Si el dueño quiere añadir por su cuenta una nueva categoría de consultas, gana n8n. Si las reglas cambian una vez por trimestre, el código propio es más sencillo de mantener.
Qué hacer cuando falla el envío del correo del formulario
Una automatización que aceptó una consulta y no la entregó es peor que no tener automatización, porque el cliente cree que el mensaje llegó. En mi caso, la consulta sale primero por Resend y, si falla, por Web3Forms. Con el segundo proveedor apareció un detalle fácil de pasar por alto: Web3Forms responde con el código 200 incluso cuando rechaza el mensaje, y el aviso del rechazo va en el cuerpo de la respuesta. Comprobar solo el código HTTP daría ese envío por bueno.
La segunda lección tiene que ver con los errores. Cada vía de fallo devuelve su propio código, no solo un mensaje. Dos de ellos comparten el estado HTTP 422 y significan cosas completamente distintas: un formulario mal rellenado y un token antispam caducado. Mientras el navegador agrupaba todos los errores bajo un mismo nombre, el error del token caducado era invisible en la telemetría.
Cuánto cuesta la gestión automática de consultas y cuándo compensa
Con poco volumen, el coste de los modelos es despreciable; lo que cuenta es el tiempo de implantación y mantenimiento. Compensa cuando las consultas llegan fuera del horario laboral, cuando van a varias personas o cuando parte de ellas se pierde hoy en la bandeja de entrada. Con unas pocas consultas al mes, será más rápido configurar un aviso en el móvil.
Puedes calcular tus propios números en la calculadora de rentabilidad de la automatización. Implanto este tipo de flujo en webs WordPress dentro de la automatización de procesos de negocio y la integración de IA con WordPress: primero el filtro y los campos, después el reparto y al final el borrador de respuesta, cada paso comprobado con consultas reales antes de pasar al siguiente.