No, Cloudflare no bloquea a Googlebot por defecto. Pero desde el 15 de septiembre de 2026 una opción de los ajustes de bots de IA hace algo que mucha gente no espera: “Block” detiene a Googlebot en la entrada, con búsqueda incluida, y no solo el entrenamiento de IA. Si tu WordPress está detrás de Cloudflare y alguien “desactivó la IA” en las últimas semanas, conviene comprobarlo hoy.
El 7 de octubre de 2026, en el resumen diario de Search Engine Roundtable, apareció una frase de una publicación en X: “Cloudflare pasó a bloquear a Google por defecto el 9/15” (Search Engine Roundtable, 7 de octubre de 2026, traducción propia). La publicación de X no se podía abrir sin iniciar sesión, así que a continuación me baso solo en fuentes de Cloudflare. Comprobé todas las citas el 8 de octubre de 2026.
Qué cambió Cloudflare el 15 de septiembre de 2026
Hasta ahora había un único interruptor, “Block AI bots”. Ahora hay tres categorías y cada una tiene su propio ajuste. Cloudflare las define así:
- Search: “rastreo para construir un índice de búsqueda.”
- Training: “rastreo para entrenar o ajustar un modelo.”
- Agent: “agentes dirigidos por el usuario que visitan una página en nombre de una persona, como los bots de obtención de los chats y los agentes que manejan un navegador.”
Fuente de las definiciones: Cloudflare Blog, 15 de septiembre de 2026, traducción propia.
Hay cuatro opciones: Allow, Disallow AI Training, Block on pages with ads y Block. Disallow AI Training solo existe en la categoría Training. Cloudflare indica que los nuevos ajustes están disponibles “a todos los clientes, en todos los planes” (traducción propia), es decir, también en el plan gratuito.
Por qué la opción Block detiene a Googlebot
Porque Googlebot es un rastreador mixto. Cloudflare llama así al bot que, con un único user agent, atiende tanto la búsqueda como el entrenamiento:
“Un rastreador de uso mixto es un único rastreador que hace tanto Search como Training.”
Cloudflare Blog, 15 de septiembre de 2026, traducción propia
Cloudflare cita tres rastreadores de este tipo: Applebot, Bingbot y Googlebot. Como no se puede detener “la parte de Googlebot que entrena”, el bloqueo afecta al bot entero. Cloudflare lo dice claramente:
“Impedirá que Applebot, Bingbot y Googlebot lleguen a tu sitio […] búsqueda incluida.”
Cloudflare Blog, 15 de septiembre de 2026, traducción propia
Lo mismo vale para la opción Block on pages with ads, solo que con un alcance más estrecho: según Cloudflare, los rastreadores, también los mixtos, quedan bloqueados en las páginas donde se ha detectado publicidad. Para un blog en WordPress con AdSense eso puede significar que Google deje de ver precisamente las entradas que generan ingresos.
La opción segura para el buscador es Disallow AI Training. Solo publica una preferencia en robots.txt, y Cloudflare señala que Googlebot “puede seguir rastreando tu sitio para la búsqueda” (traducción propia). La renuncia al entrenamiento de los modelos de Google se gestiona con un token aparte, Google-Extended, que describí en la entrada sobre los tres interruptores de IA de Google.
Qué ha pasado con el antiguo interruptor Block AI bots
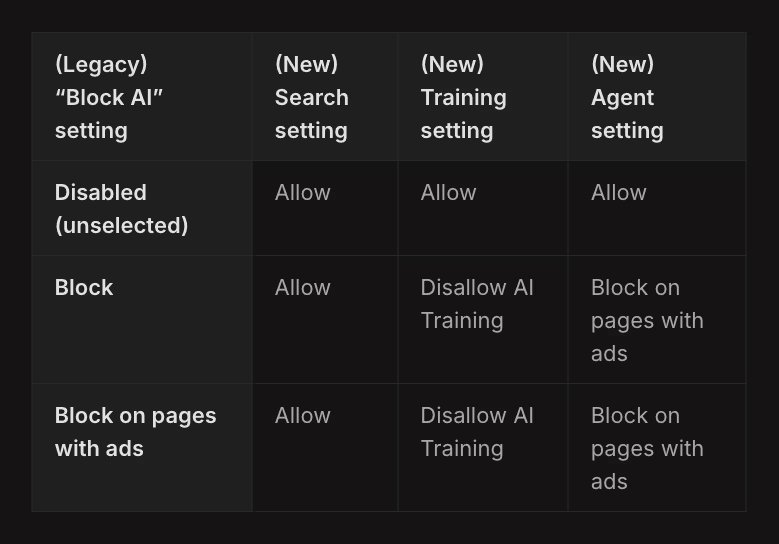
Cloudflare lo retira y traslada las zonas existentes a los nuevos ajustes. La tabla de migración de la entrada del blog es esta:
| Antiguo “Block AI” | Search | Training | Agent |
|---|---|---|---|
| Desactivado | Allow | Allow | Allow |
| Block | Allow | Disallow AI Training | Block on pages with ads |
| Block on pages with ads | Allow | Disallow AI Training | Block on pages with ads |
Según esta tabla, nadie que tuviera el antiguo interruptor ha recibido automáticamente un bloqueo de Googlebot. Search siempre pasa a Allow y Training a Disallow AI Training, la variante basada en robots.txt.
Los dominios nuevos, añadidos desde el 15 de septiembre, reciben uno de dos conjuntos durante el alta. Web sin anuncios: todo en Allow. Web con anuncios: Search Allow, Training Disallow AI Training, Agent Block on pages with ads. En ambos conjuntos está activado Preference Sync, que según Cloudflare “publica en robots.txt la preferencia de no entrenamiento aplicable” (traducción propia) y sustituye al anterior Managed Robots.txt.
Bloquear el entrenamiento de IA en Cloudflare bloquea a Googlebot
La página de documentación sobre el bloqueo de bots de IA contiene una frase que no cuadra con la tabla:
“Los rastreadores de uso mixto que combinan Search y Training también quedarán bloqueados por todas las configuraciones que bloquean el entrenamiento de IA”
Cloudflare Docs, Block AI bots, traducción propia
Si se toma al pie de la letra, cualquier configuración que bloquee el entrenamiento, incluido el antiguo interruptor, bloquea también a Googlebot. La tabla de migración dice lo contrario. Cuál de las dos versiones describe lo que el servidor de Cloudflare hace realmente con tu tráfico solo lo deciden tu propia zona y tus propios registros, no ninguno de esos dos textos.
La documentación indica además que el antiguo interruptor está “se retira el 15 de septiembre de 2026” (traducción propia) y que, para los dominios nuevos, “Search seguirá permitido” (traducción propia). Ni la entrada ni la documentación mencionan Cloudflare Pages.
Por qué Cloudflare puede bloquear GPTBot sin tocar la búsqueda, pero no Googlebot
La misma entrada explica por qué Google, Apple y Microsoft reciben un trato distinto al de otras empresas de IA. Cloudflare ha creado la designación “Accountable” para operadores de crawlers. Para obtenerla, un operador tiene que cumplir, o comprometerse a cumplir, cuatro requisitos: una forma de excluirse del entrenamiento de IA (mediante robots.txt o un estándar parecido), una forma de excluirse de los resúmenes de IA, visibilidad a nivel de URL sobre qué páginas se pusieron a disposición del entrenamiento y la garantía de que excluirse del entrenamiento no afecta a los resultados de búsqueda tradicionales (Cloudflare Blog, 15 de septiembre de 2026).
Cloudflare considera Applebot, Googlebot y Bingbot crawlers mixtos con la designación Accountable. Los crawlers de entrenamiento de Amazon, Anthropic, Meta y OpenAI están clasificados de otra forma: esas empresas usan crawlers separados para búsqueda y para entrenamiento, así que Cloudflare puede bloquear el bot de entrenamiento y dejar pasar el de búsqueda. Esa es toda la razón de que Disallow AI Training funcione como funciona. Los crawlers que solo entrenan quedan bloqueados, y los crawlers mixtos con la designación Accountable siguen permitidos para la búsqueda y reciben la preferencia contra el entrenamiento a través de robots.txt.
La preferencia solo sirve si el operador la lee. Google respeta un Disallow para el token Google-Extended y Apple lo respeta para Applebot-Extended. Microsoft es distinto: según la misma entrada, Bing todavía está construyendo el soporte de una preferencia contra el entrenamiento en robots.txt a nivel de dominio, prevista para principios de 2027, y hasta entonces Disallow AI Training no transmite esa preferencia a Bing de forma automática. Mientras tanto, Cloudflare remite a la metaetiqueta NOARCHIVE y a la herramienta Block URLs de Bing.
Cómo comprobar si Googlebot entra en tu WordPress
Tres pasos, unos tres minutos, si tienes acceso a Search Console y a la cuenta de Cloudflare.
- Inspección de URLs en Search Console. Pega la dirección de la página de inicio y lanza la prueba de URL publicada. Buscas una obtención de la página correcta y una fecha de último rastreo posterior al 15 de septiembre. Repítelo con una entrada que tenga anuncios, si los muestras, porque ahí actúa la variante Block on pages with ads.
- Estadísticas de rastreo. En los ajustes de Search Console abre las estadísticas de rastreo y el desglose por respuesta. Un aumento brusco de respuestas 403 desde mediados de septiembre es una señal de que algo en la red de Cloudflare está deteniendo a Googlebot.
- Ajustes de la zona en Cloudflare. Cloudflare escribe que los nuevos controles “pueden configurarse en los Security Settings del dominio (zona)” (traducción propia). Comprueba qué hay configurado en Search, Training y Agent. Si ves Block en Training o en Search y quieres seguir en Google, cámbialo a Disallow AI Training o a Allow.
De paso, echa un vistazo a robots.txt. Si Preference Sync está activo, Cloudflare añade ahí su preferencia. En WordPress el robots.txt también lo suele generar un plugin de SEO, así que revisa el archivo final en la dirección /robots.txt y no los ajustes del plugin. Nuestra propia línea Content-Signal muestra lo fácil que es que robots.txt se desvíe de lo que damos por hecho.
Google-Extended en robots.txt saca la web de la búsqueda de Google
No. La documentación de Google sobre sus rastreadores comunes dice que Google-Extended no tiene una cadena de user agent propia en las peticiones HTTP. El rastreo lo hacen los user agents de Google que ya existen, y el token funciona solo como control en robots.txt. Google afirma que no afecta a la inclusión de un sitio en la búsqueda de Google ni se usa como señal de posicionamiento. Solo controla si el contenido rastreado puede usarse para entrenar futuros modelos Gemini y para grounding en las apps de Gemini y en Vertex AI (Google Search Central, rastreadores comunes de Google).
La misma página explica un detalle que importa al probar. La prueba de URL publicada de Search Console y la prueba de resultados enriquecidos obtienen la página como Google-InspectionTool, un rastreador de las herramientas de prueba que no tiene efecto en la búsqueda de Google. Una prueba en directo correcta te dice, por tanto, que la zona deja pasar ahora mismo a un rastreador de Google. Cómo se ha tratado al propio Googlebot en las últimas semanas lo muestran las estadísticas de rastreo, y por eso la comprobación de arriba usa las dos cosas.
Qué pasa con las páginas indexadas cuando Googlebot recibe un 403
Un bloqueo en Cloudflare responde a Googlebot con una página de error en lugar de tu contenido, y por eso la comprobación de arriba busca respuestas 403. Google describe cómo reaccionan sus rastreadores. Todos los códigos 4xx salvo el 429 se tratan igual, no afectan a la frecuencia de rastreo y, en la búsqueda de Google, el proceso de indexación elimina la URL del índice si ya estaba indexada (Google Search Central, códigos de estado HTTP y errores de red).
Un bloqueo no se limita a pausar el rastreo nuevo. Las páginas que ya posicionan pueden salir del índice mientras dure. La misma página desaconseja usar 401 y 403 para limitar la frecuencia de rastreo. Si lo que de verdad buscas es aliviar un servidor WordPress, los códigos que Google interpreta como señal para frenar son el 429 y los 5xx: sus rastreadores pasan temporalmente a rastrear más despacio en lugar de eliminar URLs.
Cómo verificar si una petición de los logs viene de verdad de Googlebot
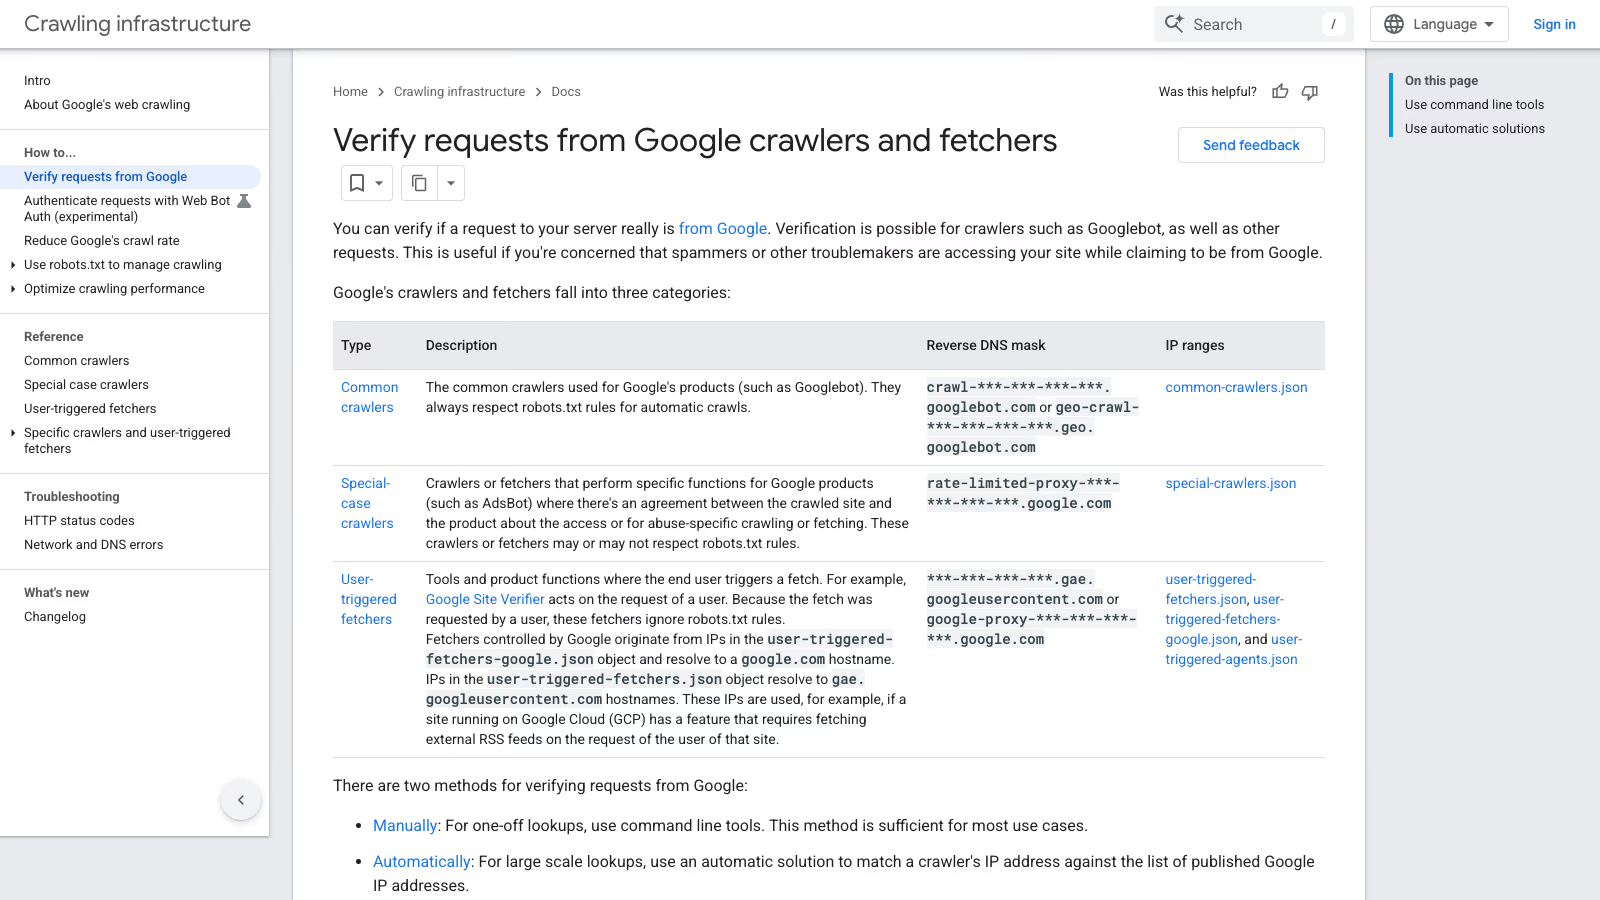
Cualquiera puede enviar una petición con “Googlebot” en el user agent, así que una línea de log por sí sola no prueba nada. El método de Google es una comprobación de DNS en los dos sentidos: haz una búsqueda DNS inversa de la dirección IP del log con el comando host, confirma que el nombre de host termina en googlebot.com, google.com o googleusercontent.com, y luego haz una búsqueda directa de ese nombre y comprueba que devuelve la misma IP. Google publica además los rangos de IP de sus rastreadores en archivos JSON, separados en rastreadores comunes, rastreadores especiales, fetchers activados por usuarios y agentes activados por usuarios (Google Search Central, verificar Googlebot).
El nombre de host también te dice qué tipo de rastreador tienes delante. Googlebot y los demás rastreadores comunes resuelven a crawl-***-***-***-***.googlebot.com (o a una variante en geo.googlebot.com) y respetan siempre robots.txt en los rastreos automáticos. Los fetchers activados por usuarios resuelven en gae.googleusercontent.com o google-proxy-***.google.com e ignoran robots.txt, porque la petición la hizo una persona.
Cloudflare hace una comprobación parecida por su lado. Sus bots verificados son bots cuya identidad Cloudflare ha confirmado mediante una firma criptográfica Web Bot Auth, una lista de IP publicada con un user agent estable o DNS inverso, y según su documentación han estado excluidos de las configuraciones de bots por defecto en todos los planes (Cloudflare Docs, Verified bots). En una regla WAF, el campo cf.client.bot indica si la petición viene de un bot o rastreador conocido y legítimo (Cloudflare Docs, cf.client.bot). Una trampa en el plan gratuito: Bot Fight Mode funciona en un proceso aparte, y Cloudflare escribe que no se puede eludir ni omitir con reglas WAF ni con Page Rules (Cloudflare Docs, Bot Fight Mode). Una regla de omisión escrita “para proteger a Googlebot” no cambia lo que hace Bot Fight Mode.
Qué ajuste elegir para una web corporativa en WordPress
Para una web que vive de las búsquedas en Google, una configuración sensata es esta:
| Categoría | Ajuste | Por qué |
|---|---|---|
| Search | Allow | Es el tráfico del buscador que quieres |
| Training | Allow o Disallow AI Training | Disallow AI Training expresa la oposición mediante robots.txt sin bloquear a Googlebot |
| Agent | Allow | Los agentes de IA visitan la web en nombre de una persona concreta, a menudo un cliente potencial |
Deja Block para los casos en que de verdad quieras desaparecer de los buscadores, por ejemplo un entorno de pruebas o un panel que no debe indexarse. Para eso, de todos modos, funcionan mejor noindex y la protección con contraseña.
Si prefieres que tu contenido no acabe en las respuestas de IA, esa es una decisión aparte. Tiene herramientas propias en Google y las trato dentro de la optimización SEO, GEO y AEO para WordPress. El bloqueo en la red de Cloudflare no sirve para eso, porque junto con la IA elimina el buscador.
Antes de bloquear un crawler, cuenta cuántas peticiones hace por cada visitante que te envía. Nick Gray describió el 7 de agosto de 2026 su web PatronView, de 1,5 millones de páginas: un solo día recibió 3,6 millones de peticiones de bots chinos, Google hizo 46 rastreos por cada visitante enviado y Bingbot hizo 158.610 peticiones para 680 visitantes. La regla de omisión para bots verificados, (cf.client.bot), va en su configuración después de las reglas de bloqueo y antes de las de desafío, de modo que un bot bloqueado sigue bloqueado, pero Googlebot nunca recibe un desafío. Solo el 0,24% de sus desafíos se resuelve, lo que el autor interpreta como señal de que afectan casi solo a bots.
El lado legal sigue abierto. En junio de 2025, Brian Williamson, de Communications Chambers, publicó el informe AI, Copyright and the Public Good, independiente y financiado por Google según su propia nota. El informe propone tratar el entrenamiento de IA con obras protegidas como uso legítimo (fair use), considera costosos los mecanismos de exclusión voluntaria (opt-out) y las obligaciones de transparencia, y quiere centrar los derechos de autor en si las respuestas de la IA los infringen. Es una propuesta política, no ley vigente. Por ahora, el control que tienes de verdad son los ajustes de bots en el borde de la red, así que configúralos para no bloquear a Googlebot junto con los crawlers de IA.
Ejemplo de ajustes de bots de IA de Cloudflare en una web real
wppoland.com está en Cloudflare, así que lo comprobé en nuestra propia web el 8 de octubre de 2026. La API de Cloudflare devuelve para nuestra zona ai_training, ai_search y ai_user con el valor disabled, y el antiguo interruptor ai_bots_protection también está en disabled. No hay ningún bloqueo de bots de IA activado.
Search Console lo confirma desde el otro lado: la inspección de la URL /pl/ muestra el último rastreo el 8 de octubre de 2026 a las 12:12, una obtención de la página correcta y un robots.txt que permite el acceso. Es una zona con un ajuste, y todo el problema está en que los ajustes cambian de una zona a otra.
Lista de comprobación de los ajustes de bots de IA en Cloudflare
- Lanza la prueba de URL publicada en Search Console para la página de inicio y para una entrada con anuncios.
- Revisa las estadísticas de rastreo en busca de respuestas 403 desde el 15 de septiembre de 2026.
- Abre Security Settings de la zona en Cloudflare y comprueba Search, Training y Agent.
- No uses Block si quieres seguir en Google. Para oponerte al entrenamiento está Disallow AI Training.
- Revisa el archivo final
/robots.txt, porque en él escriben tanto Cloudflare como el plugin de SEO. - Si tu dominio se añadió a Cloudflare después del 15 de septiembre, comprueba qué conjunto predeterminado se eligió durante el alta.