El registro de cambios de la documentación de Google Search Central del 1 de octubre de 2026 recoge un único cambio: la guía sobre el uso de contenido generado con IA se actualizó con información de las Search Quality Raters guidelines. La página de políticas antispam se actualizó por última vez el 28 de agosto de 2026. En muchos entornos de marketing digital se interpretó esto como el fin de las publicaciones apoyadas en IA. Los hechos y los datos disponibles muestran otro escenario. La política antispam apunta a muchas páginas creadas sobre todo para manipular el posicionamiento, se hayan generado como se hayan generado. Usar un modelo de lenguaje no es el desencadenante.
Corrección, 20 de noviembre de 2026. Una versión anterior de este artículo fechó mal los cambios de Google y describió mecanismos que Google nunca ha publicado. El registro de cambios del 1 de octubre de 2026 recoge un único cambio en la guía sobre contenido generado con IA. Se han eliminado la descripción de cómo se calcula contentEffort y las afirmaciones sobre clasificadores de imágenes.
Si gestionas un sitio corporativo en WordPress, una tienda online en WooCommerce o una arquitectura moderna en Astro, debes comprender los mecanismos de ingeniería con los que los buscadores evalúan tus páginas. En esta guía técnica analizamos el parámetro contentEffort descubierto en los documentos internos de Google, comparamos las declaraciones corporativas con estudios de mercado de Ahrefs y Lily Ray, y te proporcionamos procedimientos reproducibles para blindar páginas locales de ciudades, glosarios técnicos y perfiles de autor frente a caídas de tráfico.
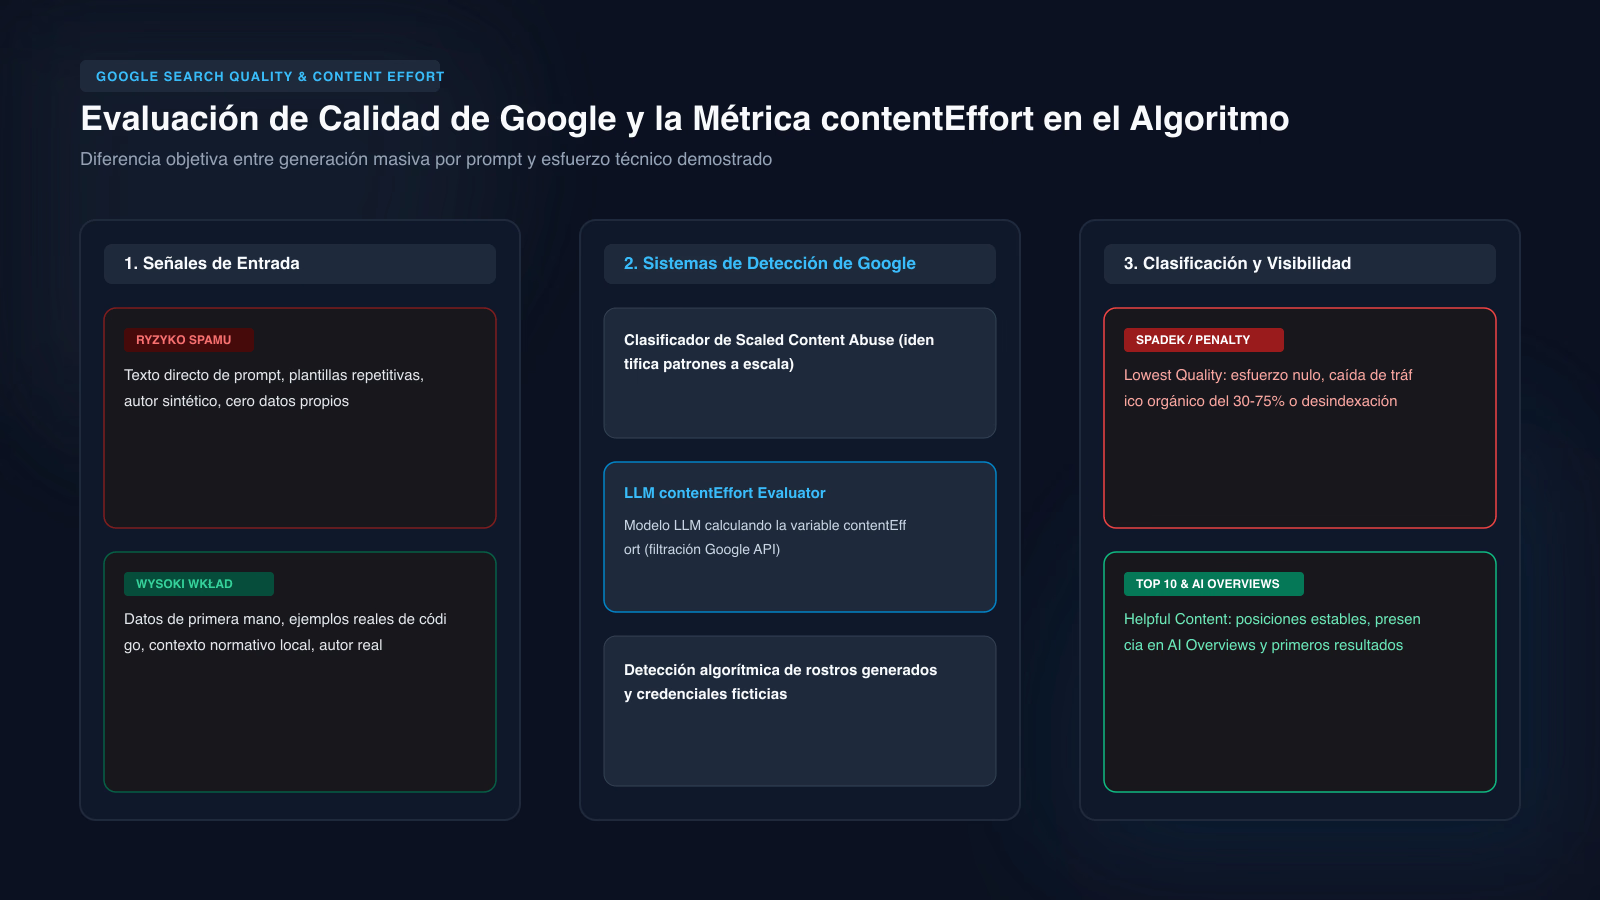
Flujo de evaluación de calidad de Google: Desde las señales de entrada hasta el cálculo de contentEffort y los clasificadores de spam, hasta la decisión final en las SERPs. Fuente: Análisis técnico de wppoland.com basado en Google Search Essentials, verificado el 1 de noviembre de 2026.
¿Penaliza Google el contenido generado con IA?
La duda más habitual entre directores técnicos y responsables de comercio electrónico es si publicar textos redactados con ChatGPT, Claude o integraciones directas por API implica penalizaciones automáticas. La respuesta práctica es no, siempre que la publicación resuelva de verdad la necesidad del usuario y demuestre un esfuerzo de trabajo contrastable.
En sus políticas contra el spam web (Spam Policies for Google Web Search), Google no prohíbe el uso de la automatización. La definición determinante se concentra en el abuso de contenido a escala (scaled content abuse):
El abuso de contenido a escala se produce cuando se generan muchas páginas con el objetivo primordial de manipular las clasificaciones de los motores de búsqueda en lugar de ayudar a los usuarios. Esta práctica abusiva suele centrarse en la creación de grandes cantidades de contenido poco original que aporta escaso o nulo valor, sin importar cómo se haya generado.
Google Search Central, Spam Policies, sección Scaled content abuse, (traducción propia)
Fíjate en la precisión: “sin importar cómo se haya generado”. La política no establece una frontera entre redactores de bajo coste, scrapers automáticos de feeds RSS y modelos de lenguaje. Lo que importa es si muchas páginas existen sobre todo para manipular el posicionamiento en lugar de ayudar a los usuarios. Si tu web publica bloques extensos que se limitan a refrasear los diez primeros resultados sin aportar mediciones ni pruebas propias, queda expuesta a esta política.
Por el lado de los evaluadores, las Search Quality Rater Guidelines (del 11 de septiembre de 2025) citan funciones de página como calculadoras y juegos como contenido principal (Main Content). Es una guía para evaluadores humanos, no un cambio del 1 de octubre. Una página con 300 palabras de explicación técnica y una calculadora que funcione sin errores puede servir mejor al usuario que un texto de 3000 palabras sin función práctica.
Si quieres evaluar cómo responde tu sitio web ante estos estándares de calidad, conviene realizar una auditoría de base. En WPPoland llevamos a cabo diagnósticos completos mediante nuestro servicio de chequeo de sitio WordPress, revisando el rendimiento de carga y la estructura de indexación.
¿Qué significa contentEffort en la filtración de Google?
En mayo de 2024 se hicieron públicas miles de páginas de documentación de APIs internas de Google. Analistas independientes, entre ellos SparkToro e iPullRank, revisaron los atributos que hasta entonces no estaban documentados.
Uno de ellos es contentEffort. En la documentación filtrada (módulo QualityNsrPQData) se describe solo como “estimación del esfuerzo basada en LLM para páginas de artículos” (traducción propia). Esa es toda la descripción verificada. Google no ha publicado cómo se calcula el valor, qué datos usa ni qué peso tiene en el posicionamiento.
Tómalo como una pista de dirección, no como una puntuación que se pueda medir y optimizar. Las páginas que aportan pruebas propias (mediciones, capturas, código, datos de proyectos) están mejor situadas que las que repiten lo que ya aparece en la primera página de resultados, haga lo que haga el campo internamente.
Las pautas para evaluadores apuntan en la misma dirección. Las Search Quality Rater Guidelines vigentes (del 11 de septiembre de 2025) usan en la sección 4.6.6 la expresión “poco o ningún esfuerzo” (traducción propia) para el contenido principal sin esfuerzo real.
¿Cuánto contenido de IA se posiciona realmente en el top 10 de Google?
Para definir una estrategia empresarial sólida hay que basarse en estudios empíricos sobre resultados reales de búsqueda.
Una investigación extensa realizada por Ahrefs examinó miles de consultas comerciales con alto volumen de tráfico para medir la penetración de textos generados por inteligencia artificial en la primera página de Google:
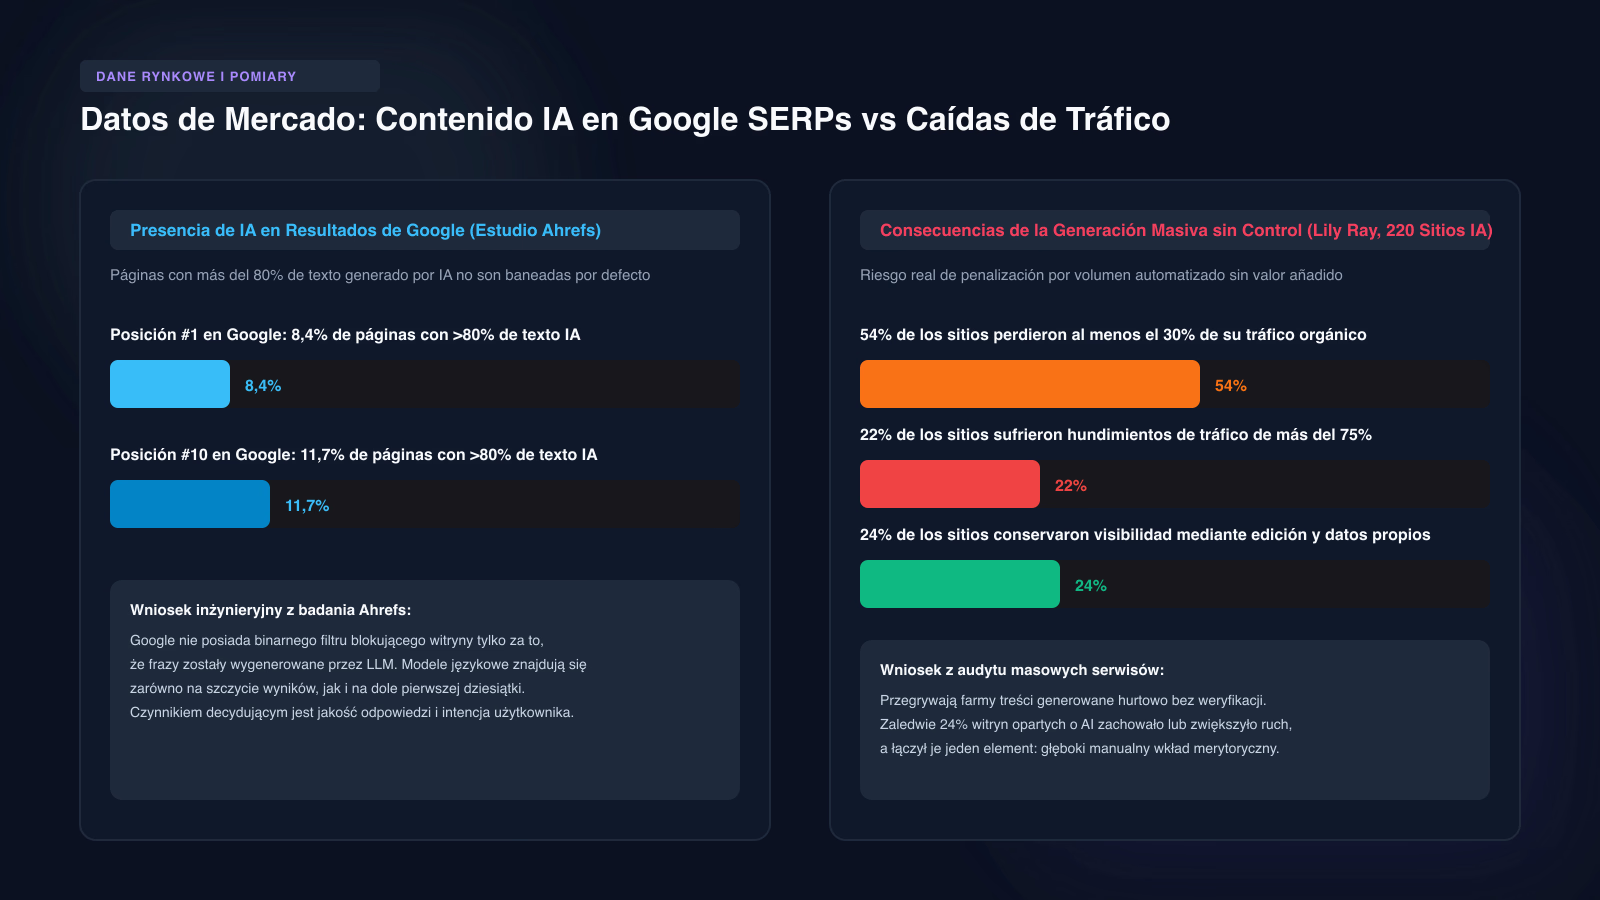
Presencia de textos dominados por IA en los diez primeros puestos de Google según Ahrefs y caídas de tráfico en sitios con estrategias de contenido con IA según Lily Ray. Fuentes: estudio de Ahrefs sobre contenido con IA y Lily Ray en Search Engine Journal.
En la primera posición de los resultados orgánicos de Google, un 8,4% de las páginas analizadas tenían al menos un 80% de contenido generado por IA. En la décima posición, ese porcentaje era del 11,7%.
Estas cifras muestran que un modelo de lenguaje por sí solo no deja una página fuera del top 10. No muestran por qué esas páginas están ahí: la autoridad de dominio, los enlaces, la experiencia de página y el ajuste a la intención de búsqueda son factores plausibles que el estudio no separa.
El panorama es distinto en los sitios que usaron la IA como una fábrica masiva sin control de calidad. Lily Ray informó en Search Engine Journal sobre 220 sitios con estrategias de contenido con IA:
- El 54% perdió al menos el 30% de su tráfico orgánico.
- El 22% perdió al menos el 75% de su tráfico orgánico.
El peligro no radica en la tecnología, sino en suponer que los algoritmos pueden sortearse con textos clónicos sin valor añadido. En WPPoland asesoramos a empresas afectadas mediante nuestro servicio de rescate de webs hechas por IA, transformando inventarios de baja calidad en recursos estables y rentables.
¿Qué tipos de páginas pierden más tráfico tras las actualizaciones de Google?
Al auditar los dominios que han sufrido fuertes pérdidas de visibilidad, se repiten ocho estructuras de contenido vulnerables a los clasificadores de spam:
Páginas de comparación por pares de productos (Herramienta A frente a Herramienta B). Los portales de afiliación generan miles de cruces mediante scripts. Al producir tablas idénticas y conclusiones genéricas para cada par, el visitante no encuentra ninguna prueba física ni análisis de rendimiento real.
Entradas de glosario con definiciones aisladas. La creación sistemática de páginas cortas de 300 palabras para explicar siglas habituales (como “qué es una API” o “qué significa headless CMS”). Estos contenidos pierden visibilidad porque Google responde directamente en las AI Overviews o remite a la Wikipedia.
Listas comparativas que sitúan a la propia empresa en primer lugar sin justificación. Artículos como “Las 10 mejores agencias web”, donde el autor siempre se otorga la máxima puntuación y atribuye defectos vagos a los competidores. La falta de metodología objetiva lleva a catalogar la página como publicidad engañosa.
Plantillas de “alternativas a [competidor]”. Páginas de captación pensadas para capturar búsquedas de marcas de referencia. Si el contenido solo resume los precios públicos del rival sin evaluar límites de API o problemas de migración, se descarta como contenido superficial.
Páginas locales repetitivas en posicionamiento municipal. La práctica habitual de clonar un texto de servicios de 1500 palabras en cientos de municipios cambiando únicamente el nombre de la localidad en el H1 y los primeros párrafos.
Granjas de preguntas y respuestas para GEO y AEO. La publicación masiva de respuestas breves a preguntas frecuentes con el objetivo de lograr menciones en Perplexity o SearchGPT. Sin fuentes documentales propias, estas páginas son desindexadas con rapidez.
Artículos de relleno desconectados de la actividad principal (parasite SEO). Publicar contenidos sobre préstamos o dietas en el dominio de una empresa de reformas con el único propósito de captar tráfico residual. Google audita con severidad la autoridad temática troncal (Topical Authority).
Catálogos automáticos sin pruebas de producto. Tiendas de dropshipping que importan ficheros de proveedores y pasan las descripciones por herramientas de reescritura de IA. Sin fotografías reales, sin comprobaciones técnicas y sin pruebas de uso, el valor de contentEffort es nulo.
Todos estos formatos adolecen del mismo problema: se diseñaron para manipular rastreadores en lugar de solucionar dudas reales a personas que buscan respuestas fiables.
¿Cómo evitar contenido duplicado en páginas de ciudades?
Las páginas locales de servicios (por ejemplo, /desarrollo-web-madrid/, /desarrollo-web-barcelona/ o /desarrollo-web-valencia/) son vías clave de captación comercial. Sin embargo, replicar casi el mismo texto en decenas de municipios crea un riesgo serio para todo el dominio.
Si Google detecta que una red de páginas locales comparte un texto idéntico sustituyendo solo el nombre de la ciudad, encaja con la definición de abuso de contenido a escala citada arriba. Google no ha publicado un mecanismo de sanción para todo el dominio, así que lo prudente es asumir que puede verse afectado el sitio entero.
Para proteger las páginas locales en el mercado español, debes aplicar una arquitectura de diferenciación basada en datos reales:
Primero: Detalla proyectos reales desarrollados en la provincia o comunidad autónoma en cuestión. En lugar de generalidades, documenta casos concretos: señala qué empresa de la zona confió en tus servicios, qué integraciones logísticas se configuraron y qué retos de infraestructura se resolvieron.
Segundo: Cumple con rigor el marco legal y regulatorio español. En comercio electrónico y servicios digitales debes citar y aplicar el Texto Refundido de la Ley General para la Defensa de los Consumidores y Usuarios (TRLGDCU, Real Decreto Legislativo 1/2007) y la Ley de Servicios de la Sociedad de la Información y de Comercio Electrónico (LSSI-CE, Ley 34/2002). En materia de competencia y publicidad rige la Ley de Competencia Desleal (Ley 3/1991). Como organismos supervisores de referencia deben figurar la Agencia Española de Protección de Datos (AEPD), la Agencia Española de Supervisión de Inteligencia Artificial (AESIA) y el Ministerio de Consumo. En operaciones con clientes europeos rige el artículo 6 del Reglamento Roma I (Reglamento (CE) n.º 593/2008). No cites leyes de otros países que no tengan validez en España.
Tercero: Aporta datos logísticos específicos de la zona. En plataformas de comercio describe puntos de recogida, plazos de entrega provinciales e integraciones con transportistas locales.
Cuarto: Usa datos estructurados que se ajusten a la realidad. Describe una ubicación física solo si el negocio la tiene. Un negocio que trabaja totalmente en remoto no debe inventar dirección de oficina, teléfono ni coordenadas, y puede usar areaServed con una referencia inequívoca a Wikidata.
Este es un ejemplo de JSON-LD para una página local de servicios. Todos los valores son marcadores de posición (example.com), sustitúyelos por tus propios datos:
{
  "@context": "https://schema.org",
  "@type": "ProfessionalService",
  "name": "Agencia Web de Ejemplo",
  "url": "https://example.com/madrid/",
  "areaServed": {
    "@type": "City",
    "name": "Madrid",
    "sameAs": "https://www.wikidata.org/wiki/Q2807"
  }
}
Al incluir referencias geográficas y normativas concretas, el contenido resiste los análisis automáticos de similitud.
¿Cómo evitar que glosarios y definiciones pierdan visibilidad en Google?
La publicación de glosarios técnicos fue una fórmula muy empleada para ganar cientos de URLs indexadas con rapidez. Con las revisiones algorítmicas recientes, muchas de estas secciones han perdido la mayor parte de su tráfico habitual.
Una definición de manual tiene una valoración mínima de contentEffort. Cuando un desarrollador busca “qué es una petición REST”, Google ofrece la respuesta directamente en sus paneles informativos en vez de enviar tráfico a glosarios genéricos.
Para mantener con éxito un glosario técnico, debes incorporar en cada término una prueba práctica de implementación (production proof):
- Definición concisa: Una o dos frases técnicas muy precisas, preparadas para selectores speakable.
- Fragmento de código real: Muestra la configuración práctica. Si defines la “Transients API en WordPress”, detalla la llamada a
set_transient()con su tiempo de expiración y la gestión de fallos. - Diagnóstico de errores y casos límite: Explica las incidencias que surgen si se usa de forma incorrecta (como problemas de memoria en la tabla
wp_options).
| Elemento | Implementación Débil (Riesgo Alto) | Documentación Técnica (Alto contentEffort) |
|---|---|---|
| Definición Teórica | Tres párrafos redactados por IA explicando que los índices de bases de datos son importantes. | Una frase técnica que define el índice como una estructura B-Tree que acelera la recuperación de registros. |
| Código de Prueba | Sin código o con una consulta SQL elemental copiada de un manual básico. | Análisis SQL real con EXPLAIN ANALYZE sobre consultas habituales en tablas de WooCommerce. |
| Diagnóstico | Aviso genérico de que las tablas lentas perjudican la experiencia de usuario. | Evaluación técnica de bloqueos y picos de uso de CPU por encima del 90% con más de 100 consultas simultáneas. |
| Cumplimiento Legal | Sin mención a normativa de datos. | Protocolo de borrado de identificadores en registros de errores según el RGPD (artículo 5.1.e). |
Con este nivel de detalle, el glosario se convierte en una referencia técnica útil que los algoritmos conservan en las primeras posiciones.
¿Por qué son un problema las fotos de autor generadas y las biografías falsas?
Para simular el cumplimiento de los principios E-E-A-T, bastantes sitios crearon especialistas ficticios con imágenes generadas por ordenador.
Las Search Quality Rater Guidelines indican a los evaluadores humanos que busquen imágenes generadas por IA en perfiles de autor falsos. Google no ha publicado si detecta esas imágenes de forma automática ni cómo. Las afirmaciones sobre la geometría de las pupilas o las orejas son conjeturas, no documentación.
El problema es práctico. Si un supuesto experto en seguridad o fiscalidad no deja ningún rastro comprobable (sin registros mercantiles, sin perfil en GitHub o LinkedIn y sin menciones de terceros), los lectores y los evaluadores no tienen motivo para creer sus consejos.
En España, esta conducta vulnera la Ley de Competencia Desleal (Ley 3/1991). Su artículo 5 tipifica como desleal por engañosa cualquier conducta que contenga información falsa o que induzca a error a los destinatarios sobre las características principales del empresario o sus cualificaciones profesionales. El Ministerio de Consumo y los tribunales sancionan estas prácticas con severidad.
Pautas para configurar autores de forma profesional en WordPress:
- Asigna los artículos a los ingenieros y consultores de tu equipo que hayan participado en el proyecto o revisado la publicación.
- Utiliza fotografías reales en el entorno de trabajo, optimizadas en formato AVIF y sin retoques que alteren la identidad.
- Inserta el esquema
Personen JSON-LD enlazando mediantesameAsa perfiles contrastables. Todos los valores del ejemplo son marcadores de posición (example.com), sustitúyelos por tus propios datos:
{
  "@context": "https://schema.org",
  "@type": "Person",
  "name": "Autor de Ejemplo",
  "worksFor": {
    "@type": "Organization",
    "name": "Empresa de Ejemplo",
    "url": "https://example.com"
  },
  "url": "https://example.com/autor/autor-de-ejemplo/",
  "sameAs": [
    "https://github.com/autor-de-ejemplo",
    "https://www.linkedin.com/in/autor-de-ejemplo/"
  ]
}
La autoría auténtica protege la web frente a penalizaciones algorítmicas y aporta confianza a la hora de cerrar proyectos con clientes corporativos.
¿Qué es el test del prompt único y cómo aplicarlo en tu sitio web?
El test del prompt único (single prompt test) es una fórmula de evaluación formulada por ingenieros de búsqueda para medir la solidez de un contenido frente a caídas algorítmicas.
La regla es directa: Si un competidor puede introducir el título de tu artículo en ChatGPT o Claude como un prompt básico y obtener una respuesta equivalente en orden, ideas y profundidad al texto publicado en tu web, tu contenido carece de valor diferencial frente a los motores de búsqueda.
Esas páginas perderán posiciones de forma progresiva:
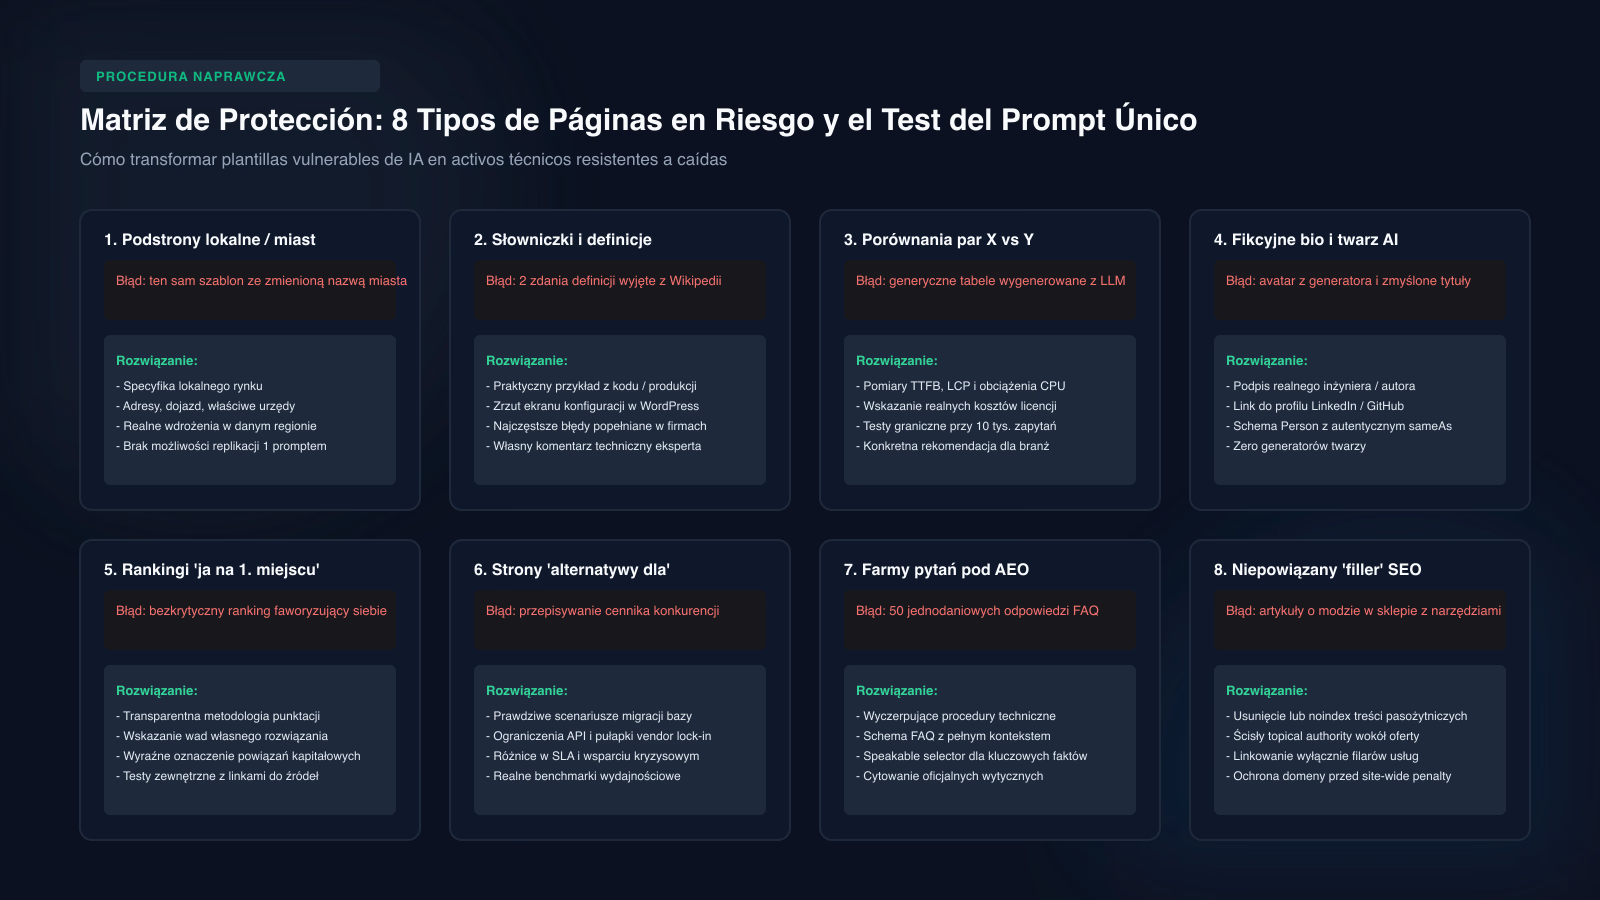
Matriz de corrección para ocho tipos de páginas frágiles mostrando las medidas técnicas necesarias para superar el test del prompt único. Fuente: Metodología técnica de WPPoland, 2026.
Cómo aplicar este análisis en tu propia web:
Paso 1: Selecciona una muestra de cinco artículos del blog o páginas de servicios de tu plataforma. Paso 2: Introduce los títulos textuales en un modelo de lenguaje avanzado sin añadir condiciones previas. Paso 3: Compara la respuesta obtenida con tu publicación aplicando cuatro preguntas críticas:
- ¿Contiene tu texto cifras, fechas, presupuestos o requisitos de hardware que el modelo no ha incluido?
- ¿Aporta tu página capturas de pantalla, esquemas de servidores o diagramas de código propios?
- ¿Expone el artículo un criterio técnico contundente (como desaconsejar un plugin por problemas de rendimiento en base de datos) en lugar de una lista neutra de pros y contras?
- ¿Se apoya el texto en leyes vigentes, normativas oficiales o manuales de referencia de fabricantes?
Si no puedes responder de forma afirmativa a estas cuestiones, la página no supera el test y corre riesgo en futuras actualizaciones.
Para superar la prueba, cada artículo debe incorporar elementos que un modelo de lenguaje no pueda improvisar desde un prompt:
- Datos de pruebas de carga reales (como un test con k6 simulando 500 compras simultáneas en WooCommerce).
- Análisis de registros de servidor sobre el comportamiento de rastreo de Googlebot.
- Casos de estudio documentados con cifras de mejora en tiempos de carga (LCP).
- Fragmentos de código propio que solucionen problemas técnicos de integración.
Esto asegura que tu web siga actuando como fuente primaria de datos (source of truth). Dentro de nuestros servicios de optimización SEO, GEO y AEO estructuramos esquemas semánticos que potencian la citabilidad de la información en buscadores y modelos de inteligencia artificial.
¿Qué hacer si pierdes tráfico tras una actualización de Google?
Si tu plataforma web o tienda WooCommerce ha sufrido una caída brusca de visitas tras una actualización algorítmica, borrar páginas al azar solo empeorará las cosas. La recuperación exige aplicar un protocolo técnico en cinco fases:
Fase 1: segmentación en Google Search Console
Compara el rendimiento en Search Console durante los últimos 28 días con el periodo anterior al desplome. Separa las URLs en tres grupos de trabajo:
- Páginas con descensos superiores al 70% en impresiones y clics.
- Páginas estables que siguen sosteniendo la autoridad temática.
- URLs desindexadas por completo, lo que delata la aplicación de filtros contra contenido a escala.
Revisa qué plantillas han sido las más castigadas: ¿páginas locales idénticas, entradas de blog automáticas o fichas de catálogo importadas?
Fase 2: retirar o desindexar contenidos secundarios
Si tu web acumuló cientos de textos que no guardan relación con tu actividad central, debes suprimir esa carga:
- Crea redirecciones 301 hacia páginas principales de referencia si esas URLs disponen de enlaces externos de calidad.
- Aplica la cabecera HTTP
X-Robots-Tag: noindexsi los documentos deben seguir disponibles para clientes pero conviene retirarlos de la búsqueda. - Devuelve el código de estado HTTP 410 Gone en páginas sin utilidad para que los rastreadores las supriman de inmediato del índice.
Fase 3: renovar las páginas que facturan
Escoge el 20% de las URLs con mayor impacto comercial que antes aportaban presupuestos o pedidos:
- Elimina introducciones genéricas redactadas por IA y aporta datos técnicos precisos.
- Añade capturas de sistemas reales, diagramas de arquitectura y fotografías auténticas de producto.
- Configura marcado Schema.org con enlaces a entidades reconocidas de Wikidata.
- Asigna la autoría a especialistas reales con perfiles profesionales contrastables.
Fase 4: limpiar la deuda técnica y el presupuesto de rastreo
Los sitios con gran volumen de páginas sufren a menudo problemas de rendimiento. Consultas ineficientes a la base de datos de WordPress, falta de caché de objetos y scripts pesados consumen el presupuesto de rastreo antes de que los robots analicen las páginas clave.
Ajustes indispensables en el alojamiento:
- Activa caché de objetos mediante Redis para optimizar consultas en WooCommerce.
- Habilita caché en el borde (Edge Caching) a través de Cloudflare Workers para entregar páginas en pocos milisegundos.
- Limpia el fichero
robots.txtpara bloquear rastreos innecesarios en filtros dinámicos.
Fase 5: reenviar a Google y seguir la respuesta
Vuelve a enviar los mapas de sitio XML actualizados en Google Search Console. La reevaluación de un dominio no es inmediata. Los rastreadores de Google necesitan visitar las páginas modificadas en múltiples ocasiones para confirmar la mejora de calidad, un ciclo que suele prolongarse entre 4 y 12 semanas.
| Fase | Tareas Operativas | Meta Técnica |
|---|---|---|
| Semanas 1-2 | Análisis en Search Console, aplicación de noindex y 410 en páginas de baja calidad. | Reducir consumo de rastreo y frenar pérdidas añadidas. |
| Semanas 3-6 | Renovación manual de páginas clave con datos propios y datos estructurados. | Las páginas aportan pruebas propias y recuperan visibilidad secundaria. |
| Semanas 7-10 | Optimización de Core Web Vitals, Edge Caching y verificación de autores. | Mejorar señales E-E-A-T y aumentar la frecuencia de rastreo. |
| Semanas 11-16 | Conclusión del rastreo y recuperación en AI Overviews y primeros puestos orgánicos. | Estabilización del tráfico en búsquedas de negocio. |
Los motores de búsqueda siguen premiando la eficiencia, pero han elevado las exigencias de calidad técnica. Las organizaciones que triunfan utilizan la inteligencia artificial para respaldar a ingenieros con experiencia, no para reemplazar el conocimiento riguroso ni la verdad técnica.