Tres ajustes se confunden cuando el propietario de un sitio dice “quiero salir de la IA”. Uno está en Search Console, otro en robots.txt bajo el token Google-Extended y otro en robots.txt como línea Content-Signal. Responden a preguntas distintas y ninguno es un interruptor general de la IA.
Las páginas de Google trazan las diferencias con bastante claridad. El problema es que están repartidas en cuatro páginas. Este artículo las pone una junto a otra, cita cada página donde importa y termina con una tabla para elegir. Todas las citas se leyeron el 6 de octubre de 2026.
wppoland.com es un buen caso de prueba porque es incómodo: seis subcarpetas de idioma, cada una verificada como propiedad de prefijo de URL propia bajo una propiedad de dominio, y un robots.txt que ya lleva una línea Content-Signal. No hemos medido ningún efecto de estos interruptores en el tráfico, y nada de lo que sigue afirma uno.
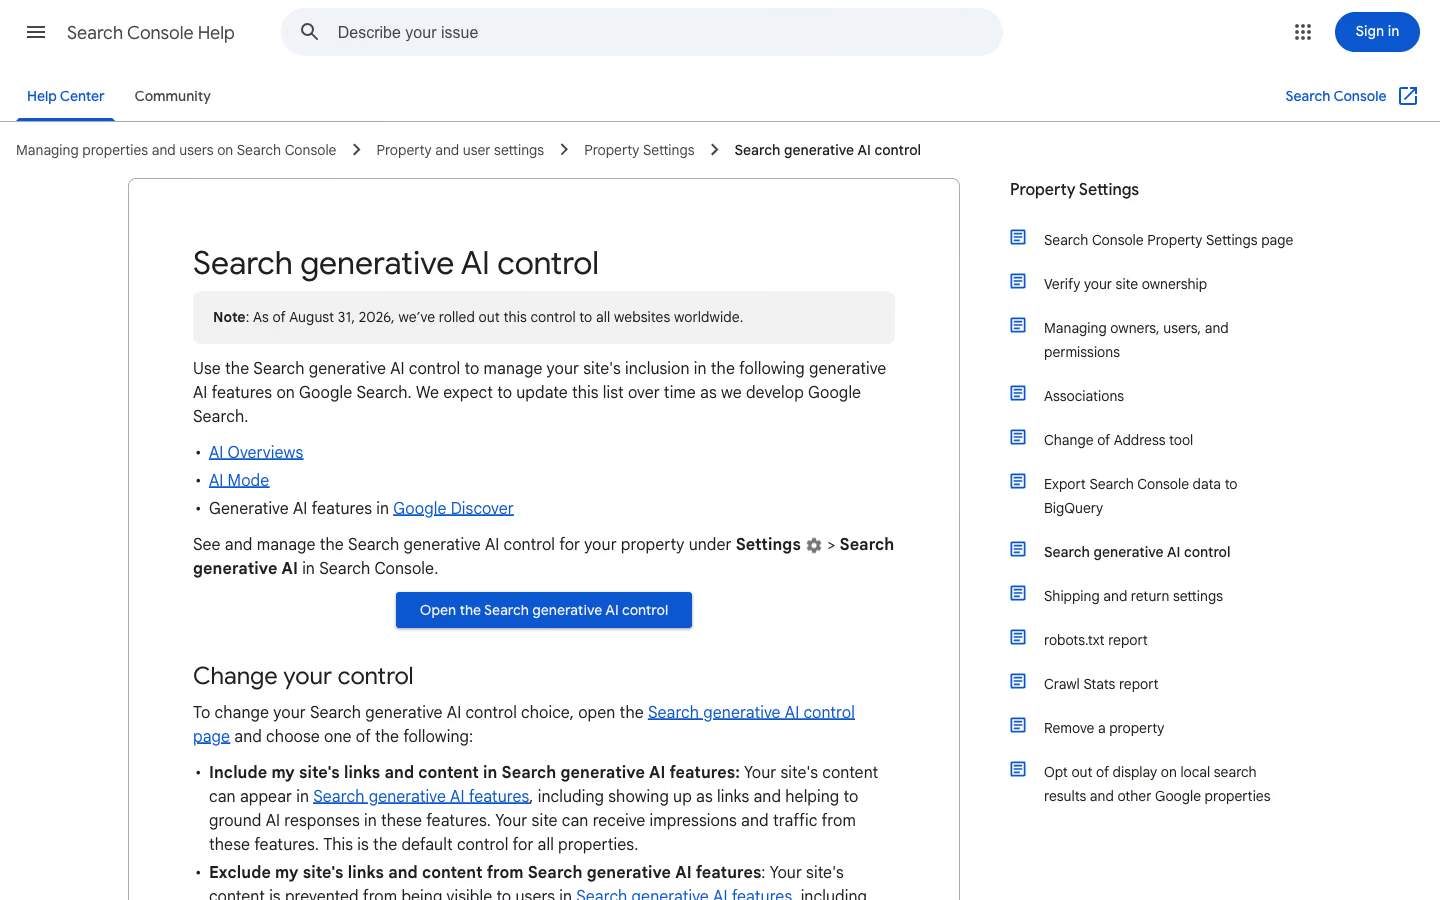
Quien usa Search Console en español ve las etiquetas traducidas: el control se llama “Control de la IA generativa de la Búsqueda”, la ruta es “Ajustes > IA generativa en la Búsqueda” y las funciones son “Vistas creadas con IA”, “Modo IA” y “funciones de IA generativa en Google Discover”. En la documentación en inglés aparecen como AI Overviews y AI Mode. Las citas en español de este artículo proceden de las páginas de Google en español.
¿Qué interruptor de Google saca mi sitio de las Vistas creadas con IA y del Modo IA?
El Control de la IA generativa de la Búsqueda de Search Console, en “Ajustes > IA generativa en la Búsqueda”. La página de ayuda de Google enumera lo que gestiona: Vistas creadas con IA, Modo IA y funciones de IA generativa en Google Discover, y avisa de que prevé actualizar esa lista con el tiempo. Sobre el despliegue:
“Desde el 31 de agosto del 2026, hemos implementado este control en todos los sitios web de todo el mundo.”
Ayuda de Google Search Console, Control de la IA generativa de la Búsqueda
Se elige entre incluir, excluir y heredar de la propiedad superior. Incluir es la opción predeterminada en todas las propiedades, y heredar es la predeterminada cuando la propiedad tiene una propiedad superior. Qué hace excluir:
“Si excluyes tu sitio, los enlaces a tu sitio y el contenido de tu sitio no aparecerán en las funciones de IA generativa de la Búsqueda. El contenido de otros sitios seguirá estando disponible en esas funciones y puede que se parezca al tuyo. El contenido rastreado de tu sitio no podrá usarse como entrada para generar una respuesta o vista previa basada en IA en las funciones de IA generativa de la Búsqueda.”
Ayuda de Google Search Console, Control de la IA generativa de la Búsqueda
Dos detalles importan. Se van también los enlaces, no solo el texto, así que no sirve para que mencionen el sitio sin que lo visiten. Y la entrada de fundamentación está cubierta: el contenido excluido no se usa para construir una respuesta en estas funciones.
Google también deja claro lo que el control no es:
“Este control solo tiene efecto si tu contenido puede aparecer en determinadas funciones de IA generativa de la Búsqueda, y no se usa como señal de posicionamiento o inclusión que afecte a otras partes de la Búsqueda.”
Ayuda de Google Search Console, Control de la IA generativa de la Búsqueda
“Este control no afecta al entrenamiento de la IA. Para limitar el entrenamiento de los modelos que se usan para generar respuestas en las funciones de IA generativa de la Búsqueda, usa Google-Extended. Para impedir por completo que tu contenido aparezca en la Búsqueda de Google, usa noindex.”
Ayuda de Google Search Console, Control de la IA generativa de la Búsqueda
Sobre los plazos, la página dice que un cambio suele tardar unos días: el contenido se excluye en 1 o 2 días tras aplicarse el control y parte de él más tarde por el almacenamiento en caché y la propagación.
Desde el 21 de octubre de 2026, el control figura también en la página de Google sobre qué compartes con la Búsqueda de Google, como opción para todo el sitio con la que gestionas la inclusión de tu sitio en las Vistas creadas con IA y el Modo IA. El registro de cambios de la documentación de Search Central fecha esa edición el 21 de octubre y la describe como la incorporación de opciones que ya existían, así que el control en sí no ha cambiado.
¿Google-Extended saca mi sitio de las Vistas creadas con IA?
No. Google-Extended está documentado en la página general de rastreadores, y las áreas de producto que nombra son Gemini y Vertex AI, no la Búsqueda:
“Google-Extended es un token de producto independiente que los editores de sitios web pueden usar para gestionar si el contenido que Google rastrea en sus sitios puede usarse para entrenar generaciones futuras de los modelos de Gemini que sustentan las aplicaciones de Gemini y la API de Vertex AI para Gemini y para la fundamentación (proporcionar contenido del índice de la Búsqueda de Google al modelo en el momento de la petición para mejorar la veracidad y la relevancia) en aplicaciones de Gemini y la fundamentación con la Búsqueda de Google en Vertex AI.”
“Google-Extended no afecta a la inclusión de los sitios en la Búsqueda de Google ni se utiliza como factor de posicionamiento en la Búsqueda de Google.”
Leídas junto con la sección anterior, las dos páginas se reparten el trabajo. El control de la Búsqueda gestiona la fundamentación y la visualización dentro de las funciones de la Búsqueda. Google-Extended gestiona el entrenamiento y la fundamentación que hacen las aplicaciones de Gemini y Vertex AI. Ninguna página dice cubrir el área de la otra, y la del control de la Búsqueda remite a Google-Extended para el entrenamiento.
Hay una consecuencia práctica que se deriva de cómo funciona el token:
“Google-Extended no tiene una cadena de user-agent de solicitud HTTP independiente. El rastreo se hace con las cadenas de user-agent de Google.”
Nuestra lectura: no hay ninguna línea Google-Extended que buscar en los registros de acceso, así que el grupo de robots.txt es el único lugar donde existe la elección.
¿Qué hace Content-Signal en robots.txt para Google?
Content-Signal es otra clase de cosa. Es una directiva de robots.txt publicada por Cloudflare, con tres señales. El sitio define ai-input así:
“Introducir contenido en uno o varios modelos de IA (por ejemplo, generación aumentada por recuperación, fundamentación u otra toma de contenido en tiempo real para respuestas de búsqueda con IA generativa).”
contentsignals.org (traducción propia del original en inglés)
Y ai-train en una línea:
“Entrenar o ajustar modelos de IA.”
contentsignals.org (traducción propia del original en inglés)
La tercera señal, search, cubre la creación de un índice de búsqueda y la devolución de enlaces y extractos breves, y el sitio señala que “no incluye ofrecer resúmenes de búsqueda generados por IA” (traducción propia). El mismo sitio es tajante sobre los límites:
“La directiva Content-Signal funciona indicando tu preferencia por permitir (yes) o no permitir (no) ciertas categorías de acciones de IA. No todos los sistemas automatizados respetan los archivos robots.txt, y algunos pueden ignorar estas directivas Content-Signal.”
contentsignals.org (traducción propia del original en inglés)
“Los archivos robots.txt expresan tus preferencias. Sin embargo, no impiden que los operadores de rastreadores tomen tu contenido a nivel técnico.”
contentsignals.org (traducción propia del original en inglés)
Ni la página de ayuda de Search Console ni la documentación de rastreadores de Google citadas aquí mencionan Content-Signal. Buscamos en el texto de ambas y no encontramos ninguna aparición. Es una afirmación sobre esas dos páginas, no sobre lo que haga ningún sistema de Google. Para planificar, significa que una línea Content-Signal es una declaración dirigida a todos los rastreadores y no un control de Google. Cómo se comporta la línea dentro de los grupos de robots.txt se explica en nuestro artículo sobre el error de alcance de Content-Signal.
Si tu sitio está detrás de Cloudflare, hay un cuarto interruptor que actúa en la red de Cloudflare, antes de llegar a la web, en lugar de en robots.txt. Desde el 15 de septiembre de 2026 su opción Block también detiene a Googlebot, como explico en ¿Cloudflare bloquea a Googlebot?.
¿noindex y nosnippet bloquean las Vistas creadas con IA?
Los dos funcionan, los dos son bruscos, y no son igual de bruscos.
noindex saca la página de la Búsqueda de Google, y la propia página del control de la Búsqueda lo nombra como la forma de hacerlo. El coste es el evidente: la página pierde también sus resultados orgánicos.
nosnippet es más acotado, y la documentación de Google sobre la etiqueta meta robots dice que llega a las funciones de IA:
“No se muestra ningún fragmento ni la vista previa de ningún vídeo en los resultados de búsqueda de la página. Es posible que se siga mostrando una miniatura de imagen estática si hay una disponible en el caso de que mejore la experiencia de usuario. Se aplica a todas las formas de resultados de búsqueda (en la Búsqueda web de Google, Google Imágenes, Discover, las vistas creadas con IA y el modo IA) y también evitará que el contenido se use como entrada directa en las vistas creadas con IA y en el modo IA.”
Documentación de Google sobre la etiqueta meta robots, nosnippet
El inconveniente está en la primera frase. nosnippet quita el fragmento también de los resultados normales de enlaces azules, y se fija por página, así que puede costar clics que el control de la Búsqueda no costaría. Esta segunda parte es una inferencia nuestra a partir de las dos páginas, no una medición.
Hay una trampa más, que afecta a los sitios que combinan herramientas. Google escribe:
“Si no se permite rastrear una página a través del archivo robots.txt, no se podrá encontrar ninguna información sobre reglas para indexar y servir contenido, y la página se ignorará.”
Un Disallow en robots.txt sobre una página que lleva noindex o nosnippet anula la etiqueta. Nuestro propio robots.txt tiene un comentario sobre esto mismo para los archivos de taxonomías, y por eso no los bloqueamos.
¿Qué ajuste de IA de Google usar para cada objetivo?
| Objetivo | Interruptor | Qué bloquea | Qué no bloquea |
|---|---|---|---|
| Fuera de las Vistas creadas con IA, el Modo IA y las funciones generativas de Discover, pero dentro de la Búsqueda | Control de la IA generativa de la Búsqueda en excluir | Enlaces y contenido en esas funciones, la entrada de fundamentación para ellas, el tráfico y las impresiones que generan | El entrenamiento de IA, el resto de la Búsqueda, el posicionamiento, la participación en Merchant Center y Google Ads |
| Fuera del entrenamiento y la fundamentación de Gemini, pero dentro de la Búsqueda y de las Vistas creadas con IA | Google-Extended con un Disallow en robots.txt | El uso del contenido rastreado para entrenar futuros modelos de Gemini y para la fundamentación en las aplicaciones de Gemini y en Vertex AI | La inclusión en la Búsqueda de Google, el posicionamiento y lo que gestiona el control de la Búsqueda |
| Comunicar tu política a todos los rastreadores en un solo lugar | Línea Content-Signal en cada grupo de robots.txt | Nada a nivel técnico | Nada. Es una declaración, y las páginas de Google no la mencionan |
| Sin texto de IA de páginas concretas, con la página aún listada | nosnippet | Fragmento de texto y vista previa de vídeo en todas partes, incluidas las Vistas creadas con IA y el Modo IA como entrada directa | El listado de la página, posiblemente una miniatura estática; también recorta los fragmentos normales |
| Fuera de la Búsqueda de Google por completo | noindex | La página en los resultados de la Búsqueda de Google | No aplica, la página sale de los resultados; el rastreador debe poder acceder a la página para ver la etiqueta |
Los dos objetivos del principio se resuelven así. Fuera de las Vistas creadas con IA pero no de la Búsqueda: el control de la Búsqueda, o nosnippet en páginas concretas. Fuera del entrenamiento pero no de las respuestas de IA: Google-Extended para Google, una línea Content-Signal para el resto, y el control de la Búsqueda en incluir.
¿Qué pasa si una subcarpeta de idioma anula la propiedad de dominio?
La herencia es donde un sitio con varias propiedades se lleva una sorpresa. La regla de Google:
“De forma predeterminada, una propiedad hereda el control de la IA generativa de la Búsqueda de su propiedad superior más cercana que tenga el control cambiado para dejar de heredar.”
Ayuda de Google Search Console, Control de la IA generativa de la Búsqueda
En wppoland.com, la propiedad de dominio está arriba y cada una de /pl/, /en/, /de/, /nb/, /pt-pt/ y /es/ es una propiedad secundaria. Con ajustar la propiedad de dominio una vez, las seis la siguen. Como cada carpeta es su propia propiedad, también se puede excluir un idioma y dejar los otros cinco incluidos. Google lo dice así de las propiedades secundarias:
“Los propietarios de una propiedad secundaria pueden elegir seguir el control de la IA generativa de la Búsqueda de su propiedad superior o cambiarlo para esa propiedad secundaria en concreto y sus subpáginas.”
Ayuda de Google Search Console, Control de la IA generativa de la Búsqueda
Lo nuevo es el aviso. Barry Schwartz informó el 6 de octubre de 2026 de que Google había añadido una línea a la página de ayuda, y la línea dice:
“Los propietarios de la propiedad de dominio de nivel superior verán una notificación en la página del control de la IA generativa de la Búsqueda cuando una de sus propiedades secundarias anule el ajuste de la propiedad superior.”
Ayuda de Google Search Console, según Search Engine Roundtable (traducción propia del original en inglés)
Es útil aquí, porque así se enteraría quien administra la propiedad de dominio de que alguien cambió el ajuste de una carpeta, sin abrir seis páginas. No hemos visto saltar el aviso. Schwartz escribe que tampoco tiene una captura, así que debe tomarse como documentado, no como observado.
Ejemplo de robots.txt con Content-Signal y Google-Extended
El grupo de la estrella y el grupo de Google-Extended de public/robots.txt dicen, literalmente:
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /
Disallow: /cdn-cgi/
# Google-Extended - Gemini grounding + training corpus
User-agent: Google-Extended
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /Dos lecturas. Primera: el conjunto coincide con lo que queremos, es decir, dentro de la búsqueda, dentro de las respuestas de IA, fuera del entrenamiento. También implica que el control de la Búsqueda y el archivo deben moverse a la vez. Un robots.txt con ai-input=yes y un ajuste de exclusión en Search Console se contradirían.
Segunda: el grupo de Google-Extended es la mitad débil. Google documenta ese token mediante líneas allow y disallow, y su propio ejemplo usa ambas. Nuestro grupo dice Allow: /. Leído al pie de la letra frente a la página de Google, el token está abierto al entrenamiento y la fundamentación de Gemini en nuestro sitio, y ai-train=no a su lado es una declaración que ninguna de las dos páginas de Google citadas aquí menciona. Así que, para Google en concreto, nuestra preferencia sobre el entrenamiento está declarada pero no respaldada por un mecanismo que Google documente.
Cerrar eso es una decisión aparte. Un Disallow: / en ese grupo también renunciaría al uso de fundamentación en las aplicaciones de Gemini, porque el token cubre ambos. El comentario al principio del archivo califica además cualquier restricción expresada mediante señales de contenido como una reserva expresa de derechos conforme al artículo 4 de la Directiva europea de derechos de autor 2019/790. Si eso se sostiene es una cuestión para un abogado, no para quien edita robots.txt.
¿Cómo medir el efecto antes de cambiar un ajuste?
No tenemos ningún resultado que comunicar, y el orden importa. Google señala un informe para esto:
“Para medir el rendimiento de tu contenido en las funciones de IA generativa de la Búsqueda, usa el informe “Rendimiento” de la IA generativa. De esta forma, puedes hacerte una idea de cómo puede afectar el cambio del control al tráfico de tu sitio.”
Ayuda de Google Search Console, Control de la IA generativa de la Búsqueda
El plan es corto. Registrar primero el informe de la propiedad de dominio. Cambiar una propiedad y nada más. Esperar los días que Google indica. Comparar con la línea base. Cambiar el control de la Búsqueda, Google-Extended y un despliegue de nosnippet en la misma semana dejaría una cifra que nadie puede atribuir. La misma disciplina vale para el patrón de cero clics que tratamos en nuestro artículo sobre la ampliación de las Vistas creadas con IA, y los motivos por los que queremos que nos citen en las respuestas están en el resumen estratégico de LLMO.
Actualización, . Los primeros datos públicos de una exclusión que he visto van en contra del temor habitual. Cyrus Shepard publicó en LinkedIn lo que él mismo llama un estudio de caso pequeño: un solo sitio retirado de las funciones de IA de Google. La publicación no dice qué mecanismo usó; a Barry Schwartz se lo describió como los controles de exclusión de la IA generativa de la Búsqueda (Search Engine Roundtable). Las impresiones en IA cayeron a cero. Calcula que esas impresiones tenían un CTR de alrededor del 0,9%, estimado a partir del CTR y las impresiones totales del sitio menos las impresiones de IA conocidas durante la prueba, y le dijo a Schwartz que suponían en torno al 8% de todas las impresiones. La sorpresa: los clics orgánicos normales también bajaron mientras las funciones de IA estuvieron desactivadas. Lo interpreta como un efecto halo, en el que aparecer en más lugares de la página de resultados hace más probable el clic, y añade que los resultados no están garantizados y que cada uno debe probar con sus propios datos. Las limitaciones son suyas y van con las cifras: un sitio, sin fechas ni duración de la prueba en la publicación, y las Vistas creadas con IA siguieron saliendo en esas búsquedas todo el tiempo, solo que sin su sitio.
Lo que saco para un sitio en WordPress: un sitio no demuestra un efecto halo, pero desmonta la idea de que excluirse de las funciones de IA solo puede proteger clics. En un sitio multilingüe, las reglas de herencia explicadas arriba permiten una prueba aproximada: excluye una propiedad de idioma, deja las demás en incluir y compara cada una con su propia línea base. Aproximada, porque cada idioma atiende a un mercado distinto, y las búsquedas en España no se comportan como las de México o Alemania. Un sitio en un solo idioma no tiene esa división, así que la decisión afecta a todo el sitio de golpe.
¿Tiene Bing sus propios controles para el entrenamiento de IA y las respuestas de IA?
Actualización, . Sí, desde hoy. Krishna Madhavan, de Microsoft Bing, anunció preferencias que separan el entrenamiento de IA de la fundamentación (grounding), es decir, del uso de una página para construir una respuesta generada (blog de Bing, Your content, your choice). Según Microsoft, ninguna de las dos cambia la elegibilidad para los resultados normales de Bing.
El entrenamiento de IA se fija en robots.txt, para todo el sitio o para una ruta, con un token de user-agent propio. Por defecto está permitido, así que si quieres seguir dentro no tienes que tocar nada. Para salir:
User-Agent: __usage_ai-training
Disallow: /
Por página, una metaetiqueta o una cabecera HTTP tiene prioridad sobre robots.txt en esa página:
<meta name="Bingbot" content="ai-training:disallow">
X-Robots-Tag: Bingbot: ai-training:disallow
La fundamentación solo existe por página, sin forma en robots.txt. Tiene tres valores: permitir (por defecto), ai-grounding:disallow, que deja la página fuera de las respuestas generadas, y ai-grounding:disallowextended, que limita la fundamentación a servicios que opera la propia Microsoft, entre ellos Copilot y Microsoft 365, y excluye los servicios de fundamentación que Microsoft ofrece a terceros, como Web IQ y la fundamentación de Foundry API. Ambos van en la misma metaetiqueta Bingbot o en la cabecera X-Robots-Tag.
Las fechas importan más que la sintaxis. Las nuevas preferencias sustituyen a las antiguas directivas NoArchive y NoCache. Desde el 15 de diciembre de 2026, Bing Webmaster Tools ofrece preferencias temporales de fundamentación a los sitios que usen NoArchive o NoCache en esa fecha. Desde el 1 de febrero de 2027, Bing respeta las nuevas preferencias a medida que rastrea. El 1 de marzo de 2027 vence el plazo para publicar las preferencias de fundamentación en las páginas o registrar las temporales; las páginas sin ninguna de las dos quedan permitidas para fundamentación hasta que se rastreen de nuevo, y NoArchive y NoCache dejan de contar para entrenamiento o fundamentación. Las preferencias temporales caducan el 30 de septiembre de 2027, o antes si un nuevo rastreo encuentra la etiqueta nueva.
| Objetivo | Bing | |
|---|---|---|
| Fuera del entrenamiento de IA, todo el sitio | Google-Extended con Disallow en robots.txt, que también quita la fundamentación en Gemini Apps y Vertex AI | __usage_ai-training con Disallow en robots.txt, solo entrenamiento |
| Fuera de las respuestas de IA en el buscador | Control de la IA generativa de la Búsqueda por propiedad de Search Console, o nosnippet por página | ai-grounding:disallow por página, metaetiqueta o cabecera |
| Fuera solo de la fundamentación para terceros | Sin equivalente | ai-grounding:disallowextended por página |
| Resultado normal en el buscador | No le afecta el control de la Búsqueda ni Google-Extended | No le afecta ninguna de las dos preferencias |
La diferencia útil: Google ata el entrenamiento a la fundamentación de Gemini en un solo token, Bing los separa. La combinación que declara nuestro robots.txt (dentro de las respuestas, fuera del entrenamiento) se expresa a Bing con un único grupo; en Google cuesta además la fundamentación de Gemini. A cambio, el interruptor de fundamentación de Bing va por página y el principal de Google por propiedad.
Qué decidir ahora en un sitio con WordPress:
- Comprueba si tus páginas envían
noarchiveonocache. Algunos plugins de SEO, como Rank Math, ofrecen noarchive como opción avanzada de meta robots. Si lo usabas para limitar el uso de IA de Bing, deja de funcionar el 1 de marzo de 2027 salvo que lo sustituyas. - Entrenamiento: añade el grupo
__usage_ai-traininga robots.txt. WordPress sirve un robots.txt virtual; edítalo en el editor de robots.txt de tu plugin de SEO (Yoast y Rank Math tienen uno) o con el filtrorobots_txt. Un robots.txt físico en la raíz sustituye por completo al virtual. - Fundamentación: Bing lee
<meta name="Bingbot">, noname="robots", así que el filtrowp_robotsdel núcleo no la imprime. Sácala desde un hookwp_headen un plugin pequeño o envía la cabecera desde el servidor. Si quieres que Copilot te cite, no hagas nada: permitir es el valor por defecto. - Con las cifras de Shepard, decide el bloqueo de la fundamentación sección por sección, por ejemplo solo para contenido de pago.
En el robots.txt de wppoland.com ya he añadido el grupo de entrenamiento de Bing, en línea con la señal ai-train=no. Configurar estas preferencias por plantilla en un sitio con WordPress forma parte de mi trabajo de SEO, GEO y AEO para WordPress.
Lista de comprobación
- Decidir primero el objetivo: fuera de las funciones de la Búsqueda, fuera del entrenamiento o ambos.
- Elegir el interruptor en la tabla. Un objetivo, un interruptor.
- Ajustar el control de la Búsqueda en la propiedad de dominio y luego revisar si alguna propiedad de idioma lo anula.
- Mantener coherentes robots.txt y Search Console:
ai-input=yesy una propiedad excluida se contradicen. - No combinar un
Disallowde robots.txt connoindexonosnippeten la misma página. - Usar Google-Extended solo si se acepta que también cubre la fundamentación de Gemini.
- Registrar la línea base del informe “Rendimiento” de la IA generativa antes del cambio y cambiar una sola cosa a la vez.
- Si el sitio limita a Bing con
noarchiveonocache, sustitúyelos por las nuevas preferencias de Bing antes del 1 de marzo de 2027.