Migra de WordPress a Astro en Zaragoza
Muchas empresas en Zaragoza usan WordPress pero enfrentan límites de rendimiento, sobrecarga de seguridad y costes de hosting crecientes. Astro resuelve esto con HTML estático, cero JavaScript por defecto y despliegue en el edge. Migro sitios WordPress existentes a Astro con preservación SEO completa, mapeo de URLs y redirecciones 301.
- PageSpeed 95-100
HTML estático sin JavaScript. Más rápido que cualquier solución WordPress.
- Migración SEO segura
Mapeo de URLs, redirecciones 301, posiciones en Google preservadas.
- Hosting en Cloudflare Pages
CDN global, SSL gratuito, despliegues instantáneos. Costes de hosting cercanos a cero.
Un catálogo industrial empieza en una hoja de cálculo
La web de Aragón Plataforma Logística, consultada el 15 de noviembre de 2026, ofrece un buscador para encontrar la ubicación que encaja con cada necesidad. Es la misma pregunta que se hace el comprador de una empresa del sector ante su catálogo: cuál es la referencia que me sirve. Según la página de características de PLAZA, la plataforma ocupa 13.117.977 metros cuadrados y limita al norte con el Canal Imperial de Aragón y al oeste con el aeropuerto. Su zona de actividad incluye 3.591.262 metros cuadrados de área logística industrial, 759.149 de área logística intermodal ferroviaria y 116.776 de área logística intermodal aeroportuaria.
Quien vende desde ahí componentes, maquinaria o servicios logísticos suele guardar el catálogo en un ERP, un PIM o un Excel, y su web lo copia a mano. Esta página trata de una sola cosa: cómo se convierte ese dato en un catálogo con las colecciones de contenido de Astro, y en qué puntos falla sin avisar.
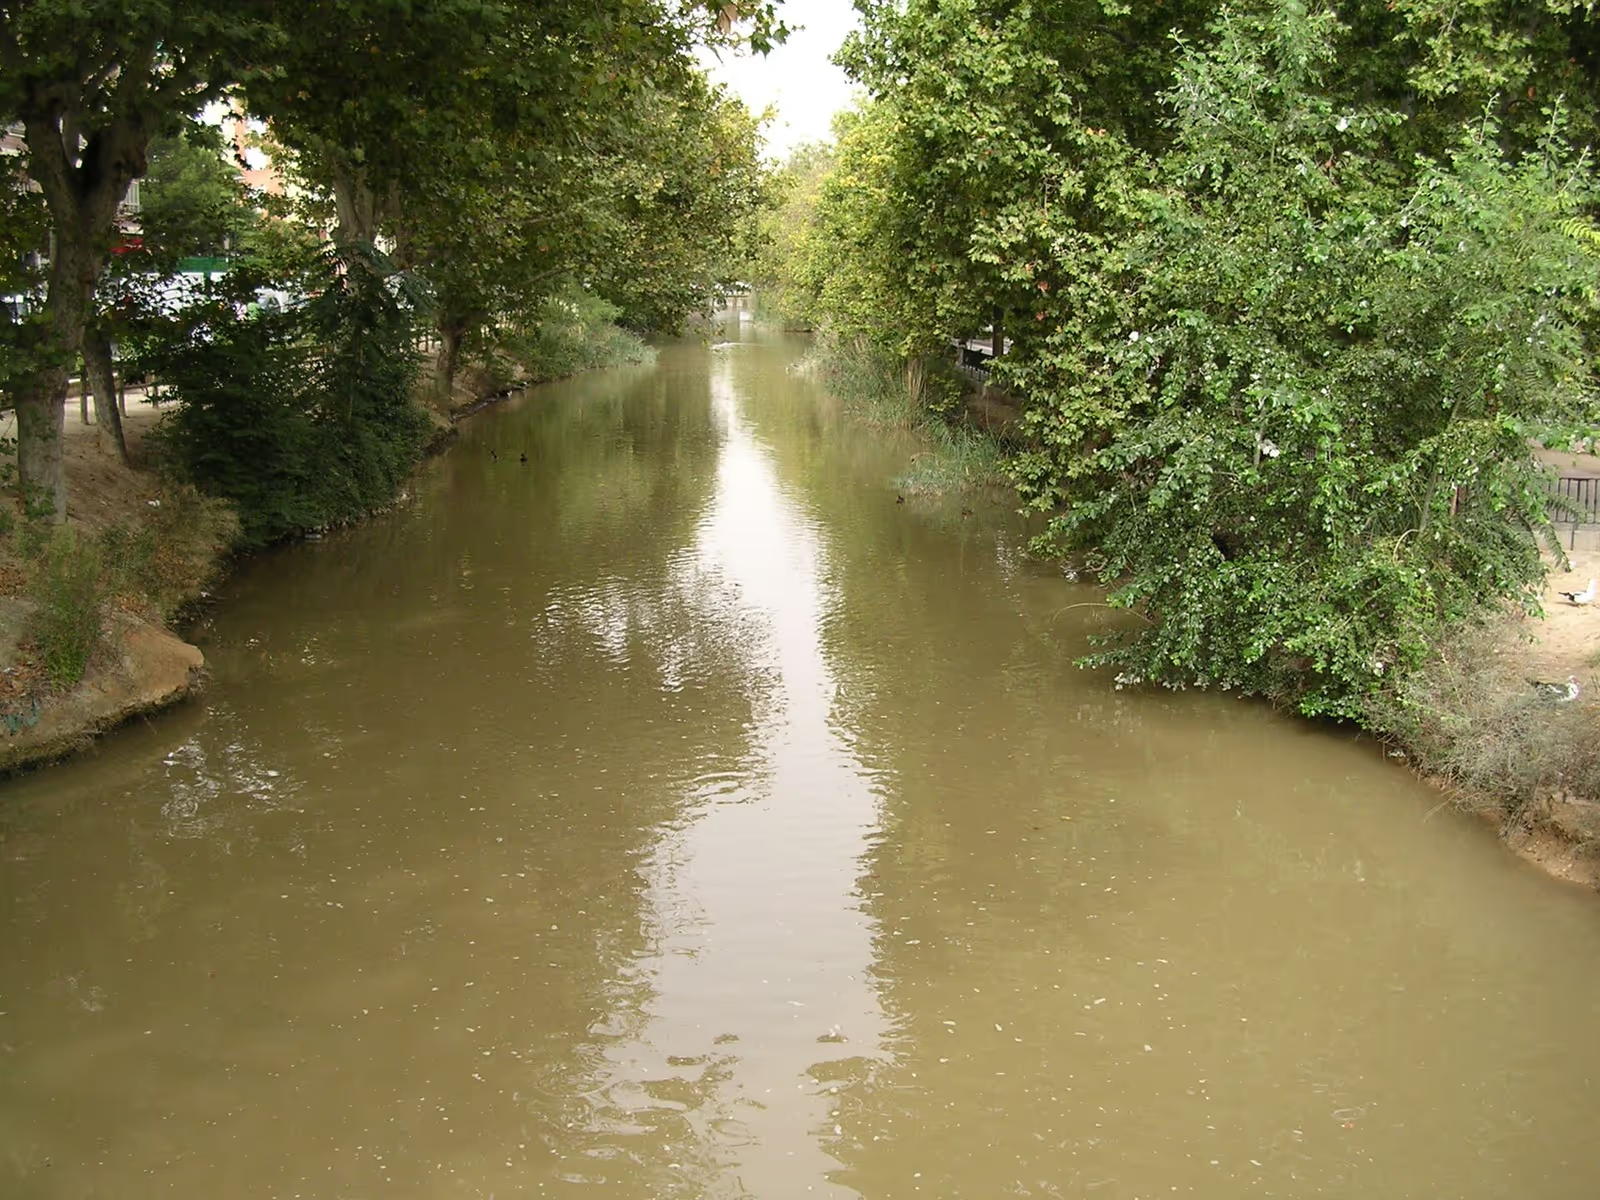
Foto: unknown author, CC BY-SA 3.0, Wikimedia Commons.
De dónde sale el dato y en qué formato
Casi siempre llega como CSV, exportado del ERP o del PIM. Si vendes material técnico, quizá tu sector ya lo clasifica con ETIM, el modelo internacional de clasificación de productos técnicos. ETIM España nació en 2019 dentro de Electronet, sociedad paritaria de ADIME y AFME, las asociaciones de distribuidores y de fabricantes de material eléctrico, según su web.
ETIM International recomendaba antes el formato BMEcat y ahora publica ETIM xChange, un formato basado en JSON. En la página del formato de intercambio, consultada el 15 de noviembre de 2026, figura como vigente la versión 1.1. Si tu PIM exporta ese JSON, Astro puede leerlo con el cargador file(), con un parser cuando el documento es anidado. Para otros sectores la clasificación será otra. La web lee lo que tu sistema ya produce, no impone un formato nuevo.
Una hoja, una colección: file() y un analizador de CSV
Según la documentación de colecciones, el cargador file() lee JSON, YAML y TOML de forma nativa. Para un CSV hace falta una función parser. Cada fila necesita un campo id único, porque file() no genera identificadores. En un catálogo ese id es el SKU.
import { defineCollection, reference } from "astro:content";
import { file } from "astro/loaders";
import { z } from "astro/zod";
import { parse } from "csv-parse/sync";

const opciones = { columns: true, skip_empty_lines: true, bom: true, delimiter: ";", trim: true };

const familias = defineCollection({
  loader: file("src/data/familias.csv", { parser: (t) => parse(t, opciones) }),
  schema: z.object({ nombre: z.string() }),
});

const productos = defineCollection({
  loader: file("src/data/productos.csv", { parser: (t) => parse(t, opciones) }),
  schema: z.object({
    nombre: z.string(),
    familia: reference("familias"),
    peso_kg: z.preprocess((v) => (v === "" ? undefined : v), z.coerce.number().positive().optional()),
    largo_mm: z.coerce.number().int().positive(),
    ficha: z.string().optional(),
  }),
});

export const collections = { familias, productos };
Las opciones vienen de la documentación de csv-parse. bom quita la marca de orden de bytes al inicio, y la documentación recomienda activarla siempre con archivos UTF-8. delimiter vale coma por defecto, así que si tu exportación separa con punto y coma hay que indicarlo. columns: true toma los nombres de la primera línea, y skip_empty_lines ignora las líneas vacías.
Qué hace Astro con un CSV roto
Probé este código con Astro 7.4.12 y csv-parse 7.0.3, con un CSV de tres filas y errores típicos de una exportación. El resultado no es el que cabría esperar:
| Error en el CSV | Qué hizo Astro | Consecuencia |
|---|---|---|
| Un peso escrito con coma decimal (“12,5”) | La compilación se detuvo con un error que nombra la entrada y el campo, pero dice “esperaba number, recibió number” | Es un NaN. Se detiene, pero el mensaje confunde |
Una celda de peso vacía con z.coerce.number() | Pasó como 0 | La ficha muestra un peso de cero sin avisar |
| Dos filas con el mismo SKU | Un aviso en el registro y la compilación terminó | Gana la última fila y la otra referencia desaparece |
Una familia que no existe en reference() | Un error en el registro, pero la compilación terminó y getEntry() devolvió undefined | Una página de producto con la familia vacía |
| Una fila con menos columnas que la cabecera | ”Error reading data”, la colección quedó vacía y la compilación terminó con código de salida 0 | Un sitio publicado sin catálogo |
La última fila es la que más importa. Con una página que solo lista la colección, el resultado fue una página construida y cero productos, con código de salida 0. En un despliegue automático eso significa publicar una web sin catálogo y enterarse por un cliente.
Por eso el esquema del ejemplo trata aparte la celda vacía: z.coerce.number() convierte la cadena vacía en 0, y un peso inventado es peor que uno ausente. Tampoco convierto en silencio la coma decimal en punto. El formato de los números del export se acuerda por escrito, y si no se cumple, la compilación debe fallar.
Una comprobación antes de compilar
Los fallos que Astro deja pasar los atrapa un script corto que se ejecuta antes del build. Lee los mismos CSV, comprueba los tres casos silenciosos y sale con código 1 si encuentra algo:
import { readFileSync, existsSync } from "node:fs";
import { parse } from "csv-parse/sync";

const leer = (f) =>
  parse(readFileSync(f, "utf8"), { columns: true, skip_empty_lines: true, bom: true, delimiter: ";", trim: true });

const familias = new Set(leer("src/data/familias.csv").map((f) => f.id));
const vistos = new Set();
const errores = [];

for (const [i, p] of leer("src/data/productos.csv").entries()) {
  const fila = i + 2;
  if (vistos.has(p.id)) errores.push(`fila ${fila}: SKU duplicado ${p.id}`);
  vistos.add(p.id);
  if (!familias.has(p.familia)) errores.push(`fila ${fila}: familia inexistente ${p.familia}`);
  if (p.ficha && !existsSync(`public/${p.ficha}`)) errores.push(`fila ${fila}: falta public/${p.ficha}`);
}
if (errores.length) {
  console.error(errores.join("\n"));
  process.exit(1);
}
En package.json, el comando de build pasa a ser node scripts/check-catalogo.mjs && astro build. Con un CSV mal formado el propio analizador lanza una excepción y el script también falla. La salida dice la fila, así que quien edita el Excel sabe qué corregir sin abrir un registro de compilación.
Familias, variantes y una página por referencia
La documentación explica que reference() convierte un valor en un objeto con la colección y el id, que luego se resuelve con getEntry(). Así una colección de familias da la página de categoría, y cada producto enlaza con su familia sin repetir su nombre.
Para generar una página por entrada se usa getStaticPaths() con el id como parámetro. Si el SKU puede llevar una barra, el archivo de la ruta necesita un parámetro de resto, como [...id].astro, según la misma documentación. En mi prueba el id llegó tal como estaba en la hoja, con las mayúsculas incluidas, y decido contigo por escrito si la URL se pasa a minúsculas.
Una cuestión que no sale de la documentación sino del oficio: si el ERP renumera los SKU, la URL cambia con ellos. Cuando el catálogo lo permite, conviene un identificador estable en una columna y el SKU comercial como un campo más.
Fichas técnicas en PDF
La documentación de Astro dice que los archivos que Astro no procesa, como los PDF, van en la carpeta public/. La colección guarda solo la ruta en una columna, y la comprobación del apartado anterior verifica que el archivo exista. Un enlace roto a una ficha técnica es el error que más se nota en un catálogo industrial, y se detecta antes de publicar.
Datos estructurados sin precio público
Según la documentación de Google sobre fragmentos de producto, el marcado Product necesita la propiedad name y además una de estas tres: review, aggregateRating u offers. Un catálogo B2B sin precio público ni opiniones no cumple el requisito. No se inventa ninguna de las tres para cumplirlo. La página sigue siendo útil con su tabla de características y su ficha, y si hay un precio público real, el marcado sale del mismo campo que se ve en pantalla.
Filtros alimentados por el mismo catálogo
Un archivo src/pages/catalogo.json.ts genera un /catalogo.json en el build, como describe la guía de endpoints de Astro:
import { getCollection } from "astro:content";

export async function GET() {
  const productos = await getCollection("productos");
  return new Response(JSON.stringify(productos.map((p) => ({ id: p.id, ...p.data }))));
}
Un componente de filtro lee ese JSON, de modo que la lista, la página de producto y el buscador salen de una sola fuente y no pueden discrepar.
El formulario de petición de ficha u oferta
Un catálogo B2B suele acabar en un formulario. La referencia del producto viaja en la petición, y quien la recibe sabe de qué pieza habla. Si el formulario recoge el nombre y el correo de una persona, el artículo 13 del Reglamento (UE) 2016/679 obliga al responsable a facilitar, en el momento de obtener los datos, su identidad y datos de contacto, los fines y la base jurídica del tratamiento, los destinatarios y el plazo de conservación, entre otras informaciones. El texto va junto al formulario, no en una página aparte.
Cuándo no hace falta nada de esto
La propia documentación indica que una colección compensa cuando hay varios elementos que comparten las mismas propiedades, y que con una o pocas páginas distintas basta una página normal. Un catálogo de una decena de referencias que cambian una vez al año puede vivir en páginas sueltas. La colección empieza a pagar cuando la hoja crece, la editan varias personas o los datos vienen de otro sistema. Si tu web actual está en Next.js, lee también la página de migración de Next.js a Astro en Zaragoza. Si el contenido ya está en un CMS, la de desarrollador de CMS headless explica cómo encaja con Astro.
Cómo trabajo
Todo se hace por escrito y a distancia, sin reuniones ni llamadas.
- Briefing. Me envías la dirección de la web actual, el sistema donde vive el dato y un ejemplo real del export, con las filas más sucias incluidas.
- Modelo de datos. Anoto cada campo con su tipo y su significado, y te pregunto por escrito lo que no esté claro. Hasta que lo confirmas, no escribo el cargador.
- Alcance y supuestos. Dejo escrito qué entra, qué no, el formato de los números y quién publica los cambios. La maquetación y el diseño gráfico los aportas tú, y yo los implemento.
- Construcción en un entorno de pruebas. El cargador trabaja primero con datos de prueba y luego con una copia del export completo. Mido el tiempo de compilación con el volumen real.
- Aceptación. Revisas el resultado frente al alcance, incluida una fila errónea que debe detener el despliegue.
- Puesta en marcha y mantenimiento. Si lo quieres, sigo con el mantenimiento. Las horas no usadas de un mes no se acumulan.
Checklist antes de empezar (sirve aunque no me contrates)
| Pregunta | Por qué importa |
|---|---|
| ¿Qué sistema es la fuente del dato? | Solo una fuente manda, las demás son copias |
| ¿El SKU es estable o el ERP lo renumera? | Una URL por SKU cambia con él |
| ¿Cómo se escriben los decimales y los miles? | Un “12,5” detiene el build, un vacío pasa como cero |
| ¿Qué campos son obligatorios? | Lo que no sea obligatorio puede estar vacío en la ficha |
| ¿Dónde están las fichas PDF y cómo se llaman? | La colección guarda la ruta, el archivo vive en public/ |
| ¿Quién edita y cada cuánto? | Decide cuándo se reconstruye la web |
| ¿El export va en UTF-8? | csv-parse lee UTF-8 por defecto, otra codificación hay que declararla |
Preguntas frecuentes
¿Puedo seguir editando el catálogo en Excel?
Sí. El CSV exportado del Excel, del ERP o del PIM es la fuente, y la web se reconstruye al publicar un cambio. Lo que cambia es que antes de reconstruir se comprueba que el archivo no tenga referencias repetidas, familias que no existen ni fichas que falten. Si algo falla, el despliegue se detiene y el mensaje dice qué fila.
¿Qué pasa si una fila del CSV tiene un error?
Depende del error, y por eso hay una comprobación previa. En mis pruebas con Astro 7.4.12, un número mal escrito detiene la compilación, pero una referencia repetida solo genera un aviso y gana la última fila, y un archivo mal formado deja el catálogo vacío con código de salida 0. La comprobación previa convierte los tres casos en un fallo visible antes de publicar.
¿Sirve esto si mi PIM exporta JSON y no CSV?
Sí. El cargador file() de Astro lee JSON, YAML y TOML sin ayuda cuando el archivo es una lista de objetos con un campo id. Si el documento es anidado, se usa la opción parser para elegir la parte que se carga, como describe la documentación de las colecciones de contenido.
¿Cuántos productos aguanta un catálogo así?
Para un catálogo de miles de referencias, la pregunta útil es cuántas páginas quieres y cuánto tarda el build, no cuántas filas tiene la hoja. Lo mido con tus datos reales antes de comprometer un alcance, porque el límite lo ponen el volumen de páginas y el alojamiento elegido.
¿Hay que poner datos estructurados de producto?
No es obligatorio. Google pide para el fragmento de producto el nombre y además review, aggregateRating u offers. Si el catálogo no publica precio ni opiniones, no se inventa ninguno para cumplir el requisito: la página sigue siendo útil con su tabla de características y su ficha técnica.
¿Qué necesito aportar para empezar?
Un ejemplo real del export con las filas más sucias, la lista de campos con su significado, quién edita el dato y cada cuánto cambia. La maquetación la aportas tú en la hoja de cálculo que te envío, y yo la implemento. Todo el trato es por escrito y a distancia.
Escríbeme
Si tu catálogo vive en un Excel, un ERP o un PIM y la web lo copia a mano, escríbeme desde la página de contacto. Indica la dirección de la web actual, el sistema que guarda el dato, un ejemplo del export con sus filas más sucias y la fecha que no puede fallar. La respuesta llega por escrito en un día laborable. La primera estimación, también escrita, no se cobra.
Fuentes: Colecciones de contenido, Astro, Endpoints, Astro, Opciones de csv-parse, Características de PLAZA, ETIM xChange, Fragmentos de producto, Google, Reglamento (UE) 2016/679.
Proyectos seleccionados
Ejemplos de mi trabajo.
Portal de recetas y estilo de vida saludable: terazjemy.pl
Terazjemy.pl fue una plataforma de estilo de vida saludable con recetas, artículos educativos, newsletter, guías interactivas y rendimiento optimizado.
Portal deportivo local: sportostroda.pl
Sportostroda.pl fue un portal deportivo local para Ostróda y alrededores, con noticias, calendario de eventos, galerías, comentarios y SEO local.
Portbrzezno.pl - sitio web del parque de cuerdas Port Brzeźno
El parque de cuerdas Port Brzeźno en Gdańsk es un lugar de aventura para niños y adultos, con recorridos en altura, reservas online y venta de vales.
Soporte y desarrollo WordPress en Zaragoza
¿Buscas el servicio: Desarrollador Astro en Zaragoza?
Describe tu proyecto por e-mail. Respondo en 48 horas.
Describe tu proyectoExplora otros servicios WordPress y base de conocimiento
Migración a Astro, Next.js y headless WordPress.
Sincronización WooCommerce con ERP y mayorista.
Automatización de procesos de negocio en torno a WordPress y sistemas empresariales.
Biblioteca de casos concretos de automatización.
Headless WordPress, Sanity, Strapi y Contentful con Astro o Next.js.
Astro, MDX, edge delivery y Core Web Vitals medidos con tráfico real.
Ingeniería WordPress y arquitectura personalizada.
Arquitectura headless, ERP e IA escalable para enterprise.
Categorías relacionadas
Artículos de apoyo
De seis a dieciséis semanas para proyectos típicos, en cuatro fases: descubrimiento, alcance, construcción y cutover, ajuste. Las variables son el tamaño del catálogo, el número de integraciones, la preservación de URLs y la disposición del equipo editorial, no la elección del framework.
Análisis exhaustivo del coste total de propiedad (TCO) a 4 años, métricas reales de Core Web Vitals, arquitectura Astro 7 GraphQL APQ y matriz de decisión de 10 puntos para directores de tecnología que eligen entre WordPress desacoplado y tradicional.
La decisión entre Shopify Plus y WooCommerce headless en 2026 ya no es un compromiso binario "plataforma vs personalizado". Ambos pueden funcionar en headless, ambos integran IA, ambos sirven en el edge. Los ejes reales son el control, el coste total a lo largo de cinco años y la estrategia de salida. Este artículo recorre la matriz con datos confirmados de cada plataforma.