Joost de Valk publicó el 27 de septiembre de 2026 un artículo sobre por qué casi nadie hace bien los sitemaps XML. Revisó con el plugin Sitemap Inspector seis sitios, de Adobe a GOV.UK, y en todos encontró lo mismo: direcciones con noindex, redirecciones, 404, canónicas que apuntan a otro sitio, una sola fecha para cientos de entradas. Su tesis es: “Un sitemap debería listar las URL que un sitio quiere indexadas, y nada más.” (traducción propia)
Estamos de acuerdo con la tesis y con la lista. La aplicamos a nuestro propio sitio. Entre agosto y octubre de 2026 encontramos en el generador de sitemaps de wppoland.com cinco errores, cada uno medido en producción. Tres de ellos los habría detectado la lista de Joost. Los otros dos no los detectará ningún inspector que lea las entradas del sitemap, porque consistían en lo que no estaba en él. Este artículo trata de ambos tipos.
Contexto técnico: wppoland.com es un sitio Astro en seis idiomas, con unas 6700 direcciones en los sitemaps. Los sitemaps los genera una integración propia, astro-sitemaps.mjs, no un plugin. Esto importa para las conclusiones: cada uno de los errores de abajo estaba en el código que lee los datos y construye la lista, no en la lista misma.
Por qué el lastmod del sitemap muestra la fecha del build
El 24 de agosto de 2026, cinco sitemaps distintos tenían exactamente un valor de lastmod para todas las entradas, el mismo, el del día. La integración calculaba new Date() una vez y lo estampaba en 3079 direcciones. Cada despliegue anunciaba a Google que había cambiado todo.
Google describe la condición sin rodeos: usa <lastmod> si el valor coincide “consistently and verifiably” con el último cambio de la página (Google Search Central, página sobre cómo crear un sitemap, actualizada el 8 de julio de 2026). Una fecha que salta en cada build no cumple esa condición, así que Google deja de fiarse de ella en todo el dominio, también donde sería verdadera. En las muestras de aquel periodo, el último rastreo de algunas páginas se remontaba de tres semanas a tres meses atrás.
La corrección pasó a usar updatedDate del frontmatter y, si falta, pubDate. Efecto en el artefacto: el sitemap del blog en polaco pasó de 1 a 98 fechas distintas.
Con esta corrección es fácil caer en un error de segundo orden. Era tentador usar el campo lastVerified para las páginas de ciudades, porque lo tienen los 4733 archivos. El problema es que 4697 de los 4733 archivos tienen en él el mismo valor. Es un sello masivo, no una señal, y habría trasladado el mismo defecto de “hoy” a otra fecha fija. Antes de que cualquier campo de fecha llegue a lastmod, hay que contar cuántos valores distintos tiene.
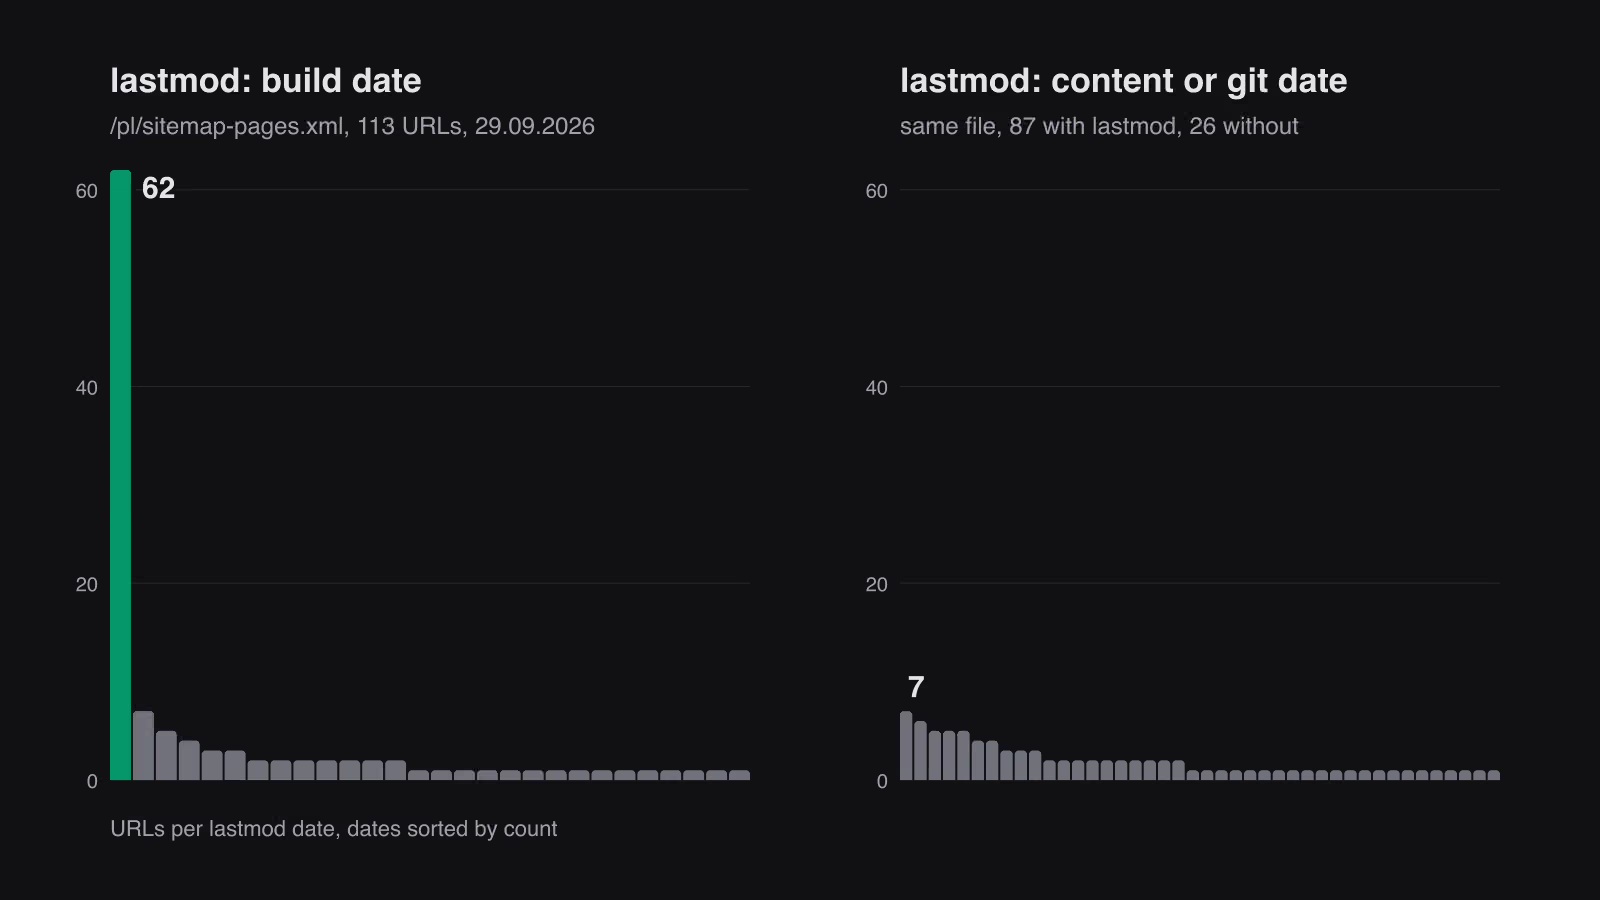
La corrección de agosto cubrió el blog, el portfolio y las páginas de la colección de contenido. No cubrió las rutas .astro escritas a mano. El artículo de Joost nos llevó a revisarlo de nuevo: el 29 de septiembre, en /pl/sitemap-pages.xml, 62 de 113 direcciones seguían teniendo como lastmod la fecha del build, porque para ellas no existe una fecha en el contenido y el código recurría entonces a today. La corrección (commit af97c7a887) toma para esas rutas la fecha del último commit del archivo fuente, con una sola llamada a git log por build, y cuando tampoco existe, omite lastmod. La plantilla compartida [lang]/[slug].astro deliberadamente no cuenta como fuente, porque su fecha no dice nada de ninguna página concreta. El mismo archivo tras la corrección: 87 de 113 direcciones tienen lastmod, 42 fechas distintas, la más frecuente corresponde a 7 direcciones, y 26 direcciones no tienen fecha. En el sitemap polaco de páginas de ciudades, antes de la corrección 684 de 692 entradas tenían la fecha del build; después, 8 entradas tienen una fecha real: la plantilla de ciudades no tiene una fecha que se pueda usar con honestidad, así que el resto no declara ninguna. La corrección está en producción desde el 29 de septiembre de 2026, y el archivo en vivo muestra las mismas cifras.
Por qué aparecen páginas noindex en los alternates hreflang del sitemap
Después de pasar 723 páginas de ciudades a noindex, Search Console seguía mostrándolas como descubiertas. Las propias páginas tenían un noindex correcto. Volvían a Google por otro camino: sitemap-locations.xml las listaba como alternativas de idioma (xhtml:link, también x-default) de páginas que seguían en el índice.
El filtro noindex de la integración solo comprobaba <loc>. Las alternativas proceden de la cabecera de la página, que enumera todas las versiones de idioma, así que el filtro no las veía. La corrección conserva solo las alternativas cuya dirección es a su vez un <loc> del sitemap. Después de ella, el build daba 6407 direcciones y 0 alternativas erróneas.
La conclusión va más allá de los sitemaps: un filtro sobre un campo de la entrada no cubre los demás campos de esa entrada que llevan una dirección. En un sitemap hay varios: loc, alternativas, x-default, image:loc.
Por qué faltan páginas indexables en el sitemap
El 21 de septiembre de 2026, la integración empezó a omitir toda dirección que coincidiera con los prefijos que el middleware de functions/_middleware.ts redirige. Pero el middleware los redirige solo cuando el recurso devuelve 404, y todo candidato al sitemap es una página ya construida, así que nunca devuelve 404. El filtro copió la regla sin su condición.
Resultado: 500 páginas operativas con index, follow salieron del sitemap, incluido el destino de una de las redirecciones (/pl/audyt-bezpieczenstwa-wordpress/ coincidía con el prefijo audyt-bezpieczenstwa-). La corrección entró el 26 de septiembre y el build con sitemap dio +500 direcciones y 0 eliminadas.
Ningún control de entradas detecta este error. Cada una de las direcciones restantes era correcta: se renderizaba, no tenía noindex, no redirigía. Menos direcciones en el sitemap parece limpieza, no un defecto. Solo se detecta comparando el conjunto de direcciones antes y después del cambio.
Errores de image:loc en el sitemap XML
La integración extraía heroImage del frontmatter con una expresión regular, línea a línea. Con un bloque plegado de YAML (heroImage: >-), el valor está en la línea siguiente, así que la regex capturaba el literal >-. El sitemap recibía entradas <image:loc>https://wppoland.com/>-</image:loc>.
El 17 de septiembre de 2026 había en producción 31 entradas así en seis idiomas. Search Console mostraba cinco errores en pl/sitemap-blog.xml, mientras que el XML estaba bien construido y cada <loc> era correcto. El YAML de los archivos también era correcto. Lo que fallaba era el lector.
La corrección analiza el frontmatter con un parser YAML, y exportamos desde la integración la función que extrae los metadatos para que un test pueda llegar a ella sin un build completo. Antes estaba en medio de un archivo de 900 líneas y ningún test tenía acceso a ella.
Qué URL enviar a IndexNow
El script de IndexNow construía las direcciones a partir de los nombres de archivo de src/content/. El 17 de septiembre de 2026 generaba 2328 direcciones, de las que 0 aparecían en el sitemap. Las entradas del blog recibían un segmento /blog/ que las direcciones no tienen, y las páginas conservaban el sufijo de idioma del nombre de archivo (/de/about.de/). Ambas variantes devolvían 301. Además, el patrón de archivos solo capturaba .md, así que los 100 pilares de servicios en .mdx no se enviaban nunca.
La corrección cabe en una frase: la fuente de direcciones para IndexNow es sitemap-index.xml. Ese conjunto ya está comprobado: las páginas se renderizan y no tienen noindex. La heurística basada en nombres de archivo desapareció junto con tres clases de errores.
Search Console no descarga el sitemap
Este caso no fue un defecto del generador, pero pertenece a la misma familia. A principios de septiembre de 2026, tras desbloquear las páginas de ciudades, los seis sitemaps de ubicaciones sumaban 4071 direcciones. Todo estaba bien por nuestra parte: las muestras devolvían 200 e index, follow, y ninguna dirección del sitemap tenía noindex ni era una redirección.
Search Console descargó esos sitemaps por última vez el 1 de septiembre a las 10:08, cuando tenían 2037 direcciones, y durante cinco días no los actualizó. Los sitemaps del blog los leía a diario. Todo lo añadido después de esa hora no existía para Google. El reenvío a través de la API se descargó el mismo día.
La semana siguiente, el número de páginas de ciudades con impresiones subió de 223 a 343, y sus impresiones de 1570 a 4382. Esas 343 páginas son el 8,4 por ciento de 4071 y en siete días dieron 2 clics. Lo que se desbloqueó fue el descubrimiento, no el tráfico, y son dos cifras distintas.
Errores del sitemap que un validador no detecta
| Error | Cómo se veía en el sitemap | ¿Lo detecta el control de entradas? | Qué lo detectó |
|---|---|---|---|
| Fecha del build como lastmod | todas las entradas con una sola fecha | sí, como lastmod repetido | número de fechas distintas en el archivo |
| Alternativas junto a noindex | <loc> correctos, xhtml:link erróneos | en parte, si revisa las alternativas | informe de Search Console sobre noindex |
| 500 páginas fuera del sitemap | cada entrada presente, correcta | no | comparación del conjunto de direcciones antes y después |
>- como imagen | 31 image:loc erróneos | sí, si revisa las imágenes | errores de sitemap en Search Console |
| IndexNow fuera del sitemap | sitemap correcto | no, el error está fuera del sitemap | intersección de la lista de envío con el sitemap |
| Sitemap sin descargar | archivo correcto y actualizado | no | fecha de descarga en Search Console |
Un plugin como el que usó Joost responde a la pregunta “¿es correcto lo que hay en el sitemap?”. Es una buena pregunta y la mayoría de los sitios, como demostró, no la supera. Pero tres de nuestros seis casos iban de otra cosa: qué no está en el sitemap, qué lo utiliza y qué versión ve Google.
Qué significan los estados del sitemap en Search Console
El informe “Sitemaps” de Search Console muestra para cada archivo enviado uno de tres estados, y la página de ayuda de Google sobre ese informe define cada uno. Correcto significa que el sitemap se ha podido obtener y leer sin errores. No se ha podido obtener significa que Google no ha conseguido el archivo. El sitemap tenía X errores significa que el archivo se obtuvo, pero solo se leyó en parte; las URL que se pudieron leer pasan igualmente a la cola de rastreo. Nuestro caso de image:loc pertenecía a esta última categoría: el sitemap se leyó, se rechazaron cinco entradas y el resto pasó.
La misma página enumera las causas de “No se ha podido obtener”: el archivo está bloqueado en robots.txt, el sitio tiene una acción manual sin resolver, la URL devuelve 404, un error general del servidor o una baja demanda de rastreo del propio sitemap. Tras una obtención fallida, Google lo sigue intentando durante unos días y después deja de hacerlo. Un sitemap que estuvo roto una semana hay que volver a enviarlo cuando ya funcione.
Cuatro de los errores de análisis de esa lista vienen del generador, no del contenido. URL not allowed indica una URL situada por encima del directorio del sitemap o en otro dominio o protocolo. Path mismatch indica que el host del sitemap y sus URL no coinciden en el www. Invalid URL cubre caracteres mal formados o sin escapar. Incorrect sitemap index format señala un índice que enumera otro índice.
Un detalle cambia la forma de limpiar: eliminar un sitemap en el informe solo lo quita del informe. Google no olvida ni el sitemap ni las URL que contenía. Para que dejen de producirse las descargas, el archivo tiene que desaparecer del servidor o responder con una cabecera noindex.
Reglas del protocolo de sitemaps que los generadores incumplen
El protocolo de sitemaps.org es breve, y un generador que lo ignora produce archivos que en el navegador parecen correctos. El archivo debe estar en UTF-8. Todo valor, URL incluidas, debe escapar cinco caracteres como entidades: & como &, ' como ', " como ", > como > y < como <. Una sola cadena de consulta con un & sin escapar convierte todo el archivo en XML no válido, y así una única URL se convierte en un error de análisis en Search Console.
Cada <loc> debe ser una URL completa que empiece por el protocolo. La ubicación del archivo limita lo que puede contener: un sitemap en una ruta determinada puede enumerar URL de esa ruta y de las inferiores, y un sitemap en un host no puede enumerar URL de un subdominio. Los límites son 50 000 URL y 50 MB (52 428 800 bytes) sin comprimir por sitemap, y 50 000 sitemaps por archivo de índice. <lastmod> usa el formato W3C Datetime, en el que una fecha simple AAAA-MM-DD es válida.
El 26 de junio de 2023, Google retiró el endpoint de ping para sitemaps y anunció que dejaría de funcionar seis meses después. Las peticiones a ese endpoint devuelven hoy 404; según Google, el código antiguo que aún lo llama no causa daño, pero tampoco hace nada. Los sitemaps se envían con una línea Sitemap: en robots.txt o desde Search Console. En la misma entrada, Google definió lastmod como la fecha de la “última modificación significativa” (traducción propia): un cambio en la barra lateral o en el pie no cuenta, un cambio en el texto principal, en los datos estructurados o en los enlaces sí. Google añade que se puede omitir lastmod en páginas como la de inicio o las de categoría, cuando el software no puede saber cuándo cambiaron de verdad. Nuestra segunda corrección de lastmod sigue exactamente esa regla.
Qué incluye el núcleo de WordPress en wp-sitemap.xml
Desde WordPress 5.5, el núcleo genera sitemaps sin plugin. El anuncio en make.wordpress.org describe los valores por defecto: el índice está en /wp-sitemap.xml, incluye los tipos de contenido y las taxonomías públicos y consultables públicamente, los archivos de autor y la página de inicio, y un sitemap contiene como máximo 2000 entradas. Ese límite se cambia con el filtro wp_sitemaps_max_urls. WordPress también añade el índice al robots.txt que sirve.
Tres valores por defecto explican la mayoría de las dudas. El núcleo no escribe lastmod, solo la URL; el filtro wp_sitemaps_posts_entry permite añadir una fecha a cada entrada. Si en Ajustes, Lectura está marcada la opción “Pedir a los motores de búsqueda que no indexen este sitio”, los sitemaps del núcleo quedan desactivados, de modo que un sitio publicado desde una copia de staging con esa casilla aún marcada no tiene sitemap del núcleo. La función entera se desactiva con el filtro wp_sitemaps_enabled, y se acota con wp_sitemaps_post_types, wp_sitemaps_taxonomies, wp_sitemaps_add_provider (por ejemplo, para quitar los sitemaps de usuarios) y wp_sitemaps_posts_query_args para entradas concretas.
Los plugins de SEO suelen sustituir el sitemap del núcleo. En los comentarios del anuncio, Pascal Birchler, colaborador del núcleo, confirmó que Yoast SEO desactiva el sitemap del núcleo en favor del suyo. Antes de depurar un sitemap de WordPress, conviene averiguar qué índice sirve realmente el sitio y enviar solo ese a Search Console.
Cómo revisar un generador de sitemap XML
El control de entradas es una condición necesaria, no suficiente. Estos cinco puntos revisan el generador, no el archivo en sí:
- Cuenta los valores distintos de
lastmoden cada archivo. Un solo valor para cientos de entradas es un sello, no una fecha. Lo mismo antes de usar un nuevo campo de fecha: si casi todos los archivos tienen en él el mismo valor, el campo no sirve comolastmod. Mejor sinlastmodque con uno falso. - Compara el conjunto de direcciones antes y después de cambiar el generador. Número de direcciones añadidas y eliminadas, con la lista. Una caída en el número de direcciones exige una explicación igual que un aumento.
- Todo campo que lleva una dirección pasa por los mismos filtros.
loc, alternativas de idioma,x-default,image:loc. Un filtro en uno de ellos no protege a los demás. - Una regla copiada de otro componente viene con su condición. Una redirección “si hay 404” no es lo mismo que una redirección siempre.
- El sitemap es la única fuente de direcciones para todo lo que envía direcciones a otra parte: IndexNow, Indexing API, listas para envío manual. Y una vez por semana: la fecha de la última descarga en Search Console y el número de direcciones que se ve allí, junto al número de
<loc>del archivo en vivo.
Dos datos de la documentación de Google que conviene tener a mano: un archivo de sitemap admite como máximo 50 000 direcciones o 50 MB sin comprimir, y los valores de <priority> y <changefreq> se ignoran. No perjudican, pero no merece la pena trabajar en ellos.
Si el sitio funciona como WordPress headless, surge la pregunta de quién genera el sitemap, el front o WordPress. Lo tratamos por separado en el artículo sobre el sitemap y la URL canónica en WordPress headless.