Para 2026, un motor generativo se ha colocado entre tu página y el lector. Gartner proyectó una caída del 25% en el volumen de búsqueda tradicional, y el tráfico de asistentes de IA crece desde una base tan pequeña que cualquier multiplicador citado dice más sobre la base que sobre la tendencia. La pregunta práctica, por tanto, no es cómo adaptarse, sino cómo saber si esto ya te está pasando a ti.
Este artículo va en ese orden: primero el instrumento, después la conclusión. Antes de reescribir un párrafo conviene poder contestar tres preguntas con datos propios. Qué clientes piden tus páginas y cuántos de ellos no son navegadores. Si tu dominio aparece nombrado cuando un modelo responde a las preguntas que te importan. Y qué parte de esas dos cosas puedes medir de verdad frente a qué parte solo puedes muestrear. Las siete secciones siguientes desarrollan cada recomendación junto con la comprobación que la confirmaría o la desmentiría, porque una recomendación de GEO sin instrumento es una opinión con formato de dato.
La transición de SEO a GEO

Lo que cambió es un paso concreto en la cadena de entrega, no una época. Antes, el buscador devolvía una lista de URLs y el clic era el acto que pasaba al lector de un sistema a otro. Ahora el motor recupera primero un conjunto de pasajes, los resume y solo después decide si nombra la fuente. Ese paso intermedio es el que rompe la relación entre posición y visita: puedes estar dentro del conjunto recuperado y no aparecer citado, aparecer citado y no recibir ningún clic, o recibir la petición de un agente que lee la página en nombre de alguien que nunca la verá. La proyección de Gartner de una caída del 25% en el volumen de búsqueda tradicional para 2026 describe el efecto agregado. El paso intermedio describe la causa, y es el único de los dos sobre el que puedes actuar.
Esta es la transición de Search Engine Optimization (SEO) a Generative Engine Optimization (GEO), y su primera consecuencia es de medición, no de estrategia. En el modelo anterior el instrumento estaba integrado: el clic llegaba a tu servidor y quedaba registrado. En el nuevo, el hecho que te interesa ocurre dentro del motor, en una respuesta generada para un usuario que no es tuyo, en una sesión que no puedes consultar. No existe un panel oficial que te diga cuántas veces ChatGPT o Perplexity te nombraron ayer. Cualquiera que te venda esa cifra la ha construido por muestreo.
Hay tres instrumentos disponibles y ninguno cubre lo que falta en los otros dos. El primero son tus propios registros de servidor: ahí ves qué clientes piden tus URLs, con qué user agent, a qué ritmo y qué rutas tocan. Es el único dato censal que posees, y su límite es que registra la recuperación, no la cita; un agente puede leer tu página y el modelo puede acabar citando a otro. El segundo es el muestreo de prompts: preparas un conjunto fijo de preguntas reales de tus clientes, las lanzas contra cada motor con una periodicidad fija y anotas si tu dominio aparece nombrado y en qué posición del texto. Es lo más cercano a medir la cita, y su límite es que la respuesta no es determinista, varía con la sesión, con el país y con la versión del modelo, de modo que una sola pasada no significa nada y lo único interpretable es la frecuencia sobre muchas repeticiones. El tercero es el tráfico referido desde los dominios de los asistentes, que sí llega a tu analítica, y cuyo límite es que mide el residuo: solo a las pocas personas que, tras leer la respuesta, decidieron pulsar la fuente.
Un cuarto instrumento aparece a veces en las propuestas comerciales y conviene descartarlo pronto: preguntarle al propio modelo si conoce tu marca. Un modelo generativo produce una continuación plausible, no una consulta a un índice de lo que ha leído, así que responderá que sí con la misma fluidez tanto si te ha recuperado como si no. Esa respuesta no es una medición, es una redacción.
Las cifras de crecimiento del tráfico referido por IA se citan en todas partes y casi nunca se fuentean, así que no añadimos otra. El motivo para la cautela es la aritmética misma: el tráfico de asistentes de IA parte de una fracción de un por ciento de las visitas, y una fracción que se triplica produce un titular con casi ningún visitante detrás. La medición por la que respondemos es la nuestra. Durante 23 horas en agosto de 2026, el 72,4% de las peticiones a este sitio llevaba un user agent no reconocido, frente al 19,7% de Chrome, y los rastreadores de buscadores con nombre sumaron un 3,5%. El método y las cifras completas están en tráfico de bots medido en un sitio pequeño. Las siete conclusiones de abajo no descansan por tanto en una tasa de crecimiento, sino en lo que ya se ve en los registros del servidor: qué proporción de las peticiones no es una persona, y qué hacen esos clientes con la página una vez la tienen.
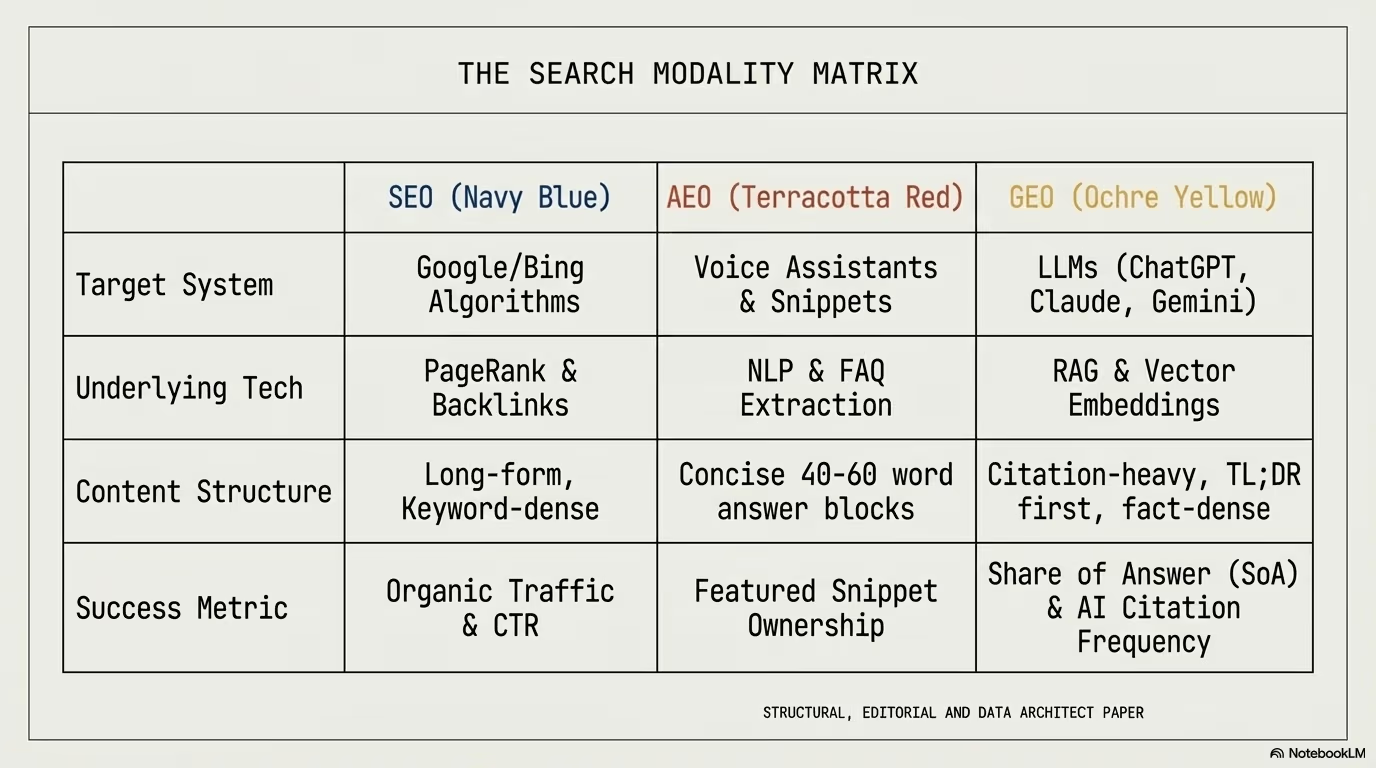
La diferencia crítica entre SEO y GEO radica en lo que cada sistema recompensa. SEO recompensa las páginas que atraen clics humanos a través de títulos y meta descripciones atractivos. GEO recompensa las páginas en las que los sistemas de IA confían lo suficiente como para citarlas como fuentes autoritativas. Estos son objetivos de optimización fundamentalmente diferentes, y tratarlos como iguales deja tu contenido varado entre dos paradigmas.
Hay además una distinción que casi nunca se hace y que cambia lo que puedes concluir de tus registros: no es lo mismo una recuperación para entrenar que una recuperación para responder. El rastreo de entrenamiento pasa por tu sitio de forma amplia y espaciada, recorre secciones enteras y no guarda relación con ninguna pregunta concreta; su efecto sobre ti, si lo tiene, aparecerá meses después y de forma indistinguible. La recuperación en tiempo de respuesta llega en el momento en que alguien pregunta algo: pide una o dos URLs muy concretas, a menudo sin cargar imágenes ni hojas de estilo, y suele venir acompañada de picos que siguen el horario humano. Si mezclas ambos en una sola cifra de “tráfico de IA” obtienes un número grande que no responde a ninguna pregunta útil. Separarlos por user agent y por forma de la petición es el primer trabajo real de analítica que impone esta era.
1. La regla “TLDR”: las citas se ganan en las primeras 200 palabras
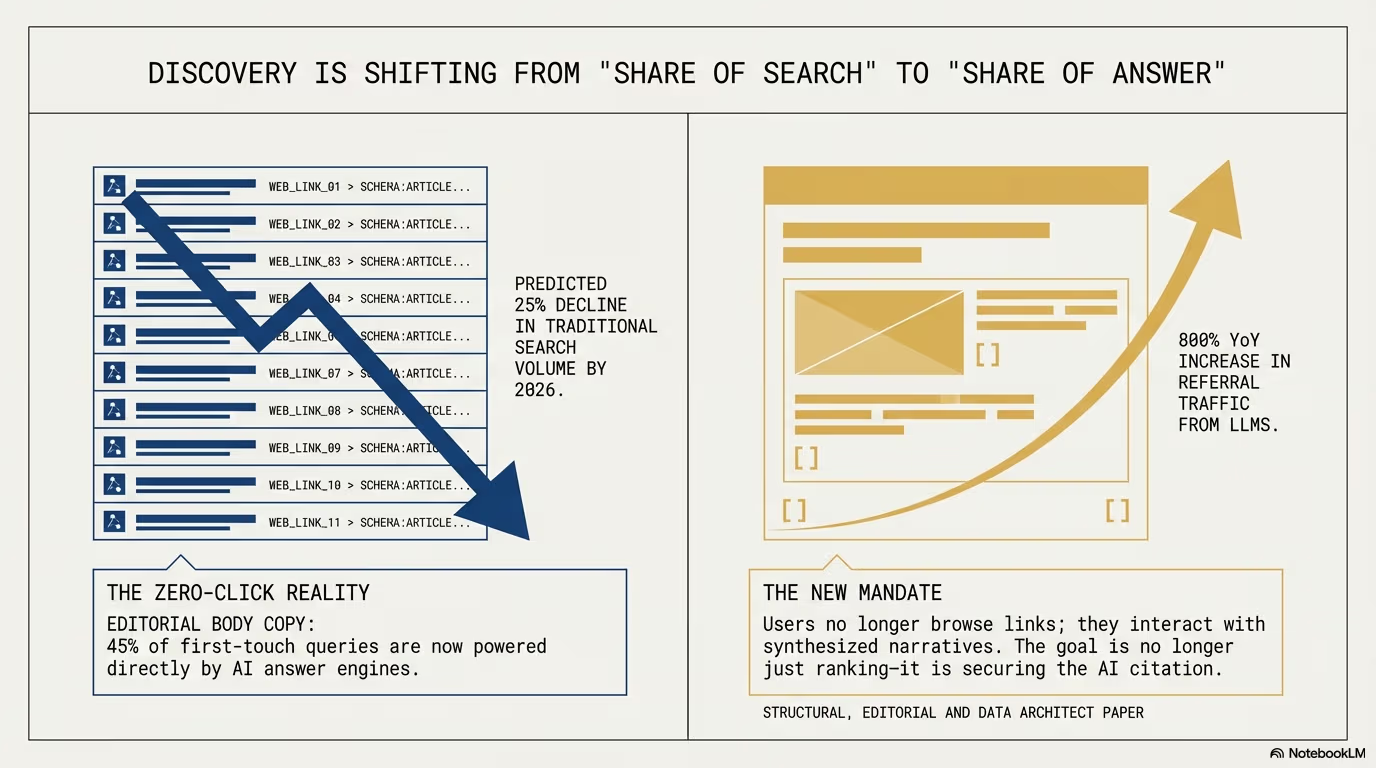
Los días de enterrar lo esencial para inflar métricas de tiempo en página han terminado oficialmente. Los sistemas modernos de recuperación de IA utilizan Retrieval-Augmented Generation (RAG), un proceso construido para la eficiencia extrema. Estos sistemas no leen tu artículo completo de principio a fin. Extraen pasajes específicos para alimentar el contexto del modelo, y el proceso de extracción favorece fuertemente al contenido que aparece al inicio del documento.
En el análisis de Kevin Indig sobre 1,2 millones de respuestas de ChatGPT, el 44,2% de las citas verificadas de LLM provienen del primer 30% de una página. El mecanismo detrás de ese reparto es la segmentación: el documento se trocea en pasajes, cada pasaje compite por entrar en un contexto limitado y los primeros bloques son los que llegan completos y con el título aún cerca. Un párrafo decisivo colocado en la palabra 2400 compite en peor posición que el mismo párrafo en la 200, no por preferencia editorial del modelo, sino por dónde cae el corte.
Esto también se puede comprobar sin fe. Toma una afirmación concreta que solo aparezca en la mitad final de una página tuya, formula la pregunta que esa afirmación responde y lánzala varias veces contra dos motores distintos. Después sube la misma afirmación a la apertura, espera a que el contenido se vuelva a recuperar y repite la tanda con las mismas preguntas. Lo que obtienes no es una prueba limpia, porque entre una tanda y otra el modelo pudo cambiar y el conjunto recuperado también, pero es una señal mucho más honesta que repetir una estadística ajena sobre tu propio sitio.
Para ganar la cita, debes adoptar una arquitectura de “respuesta primero”: comienza con un resumen conciso de menos de 300 palabras que responda directamente a la consulta principal, luego sigue con matices ricos en datos y evidencia de respaldo. Piensa en ello como escribir un resumen ejecutivo que una máquina pueda extraer de forma aislada y aun así entregar una respuesta completa y precisa al usuario.
Esto no significa que tu contenido deba ser superficial. Todo lo contrario. La profundidad debe estar presente, pero la arquitectura debe invertirse. Coloca tus hechos, estadísticas y declaraciones más citables en la sección de apertura. Luego usa el contenido restante para proporcionar el contexto, la evidencia y los matices que construyen autoridad.
“Responde la pregunta primero, luego explica los matices. Así es como debes abordar la escritura para búsqueda con IA en general: claridad primero, profundidad después.”
La implicación práctica es que cada pieza de contenido necesita lo que podría llamarse un “encabezado de citación”: una sección de apertura densa y rica en hechos diseñada específicamente para la extracción RAG. Esta sección debe contener tu palabra clave principal de forma natural, una respuesta directa a la consulta objetivo y al menos dos puntos de datos de respaldo. Todo lo que sigue se construye sobre esta base.
2. La mayoría de las citas de IA provienen de fuera del top 10 orgánico
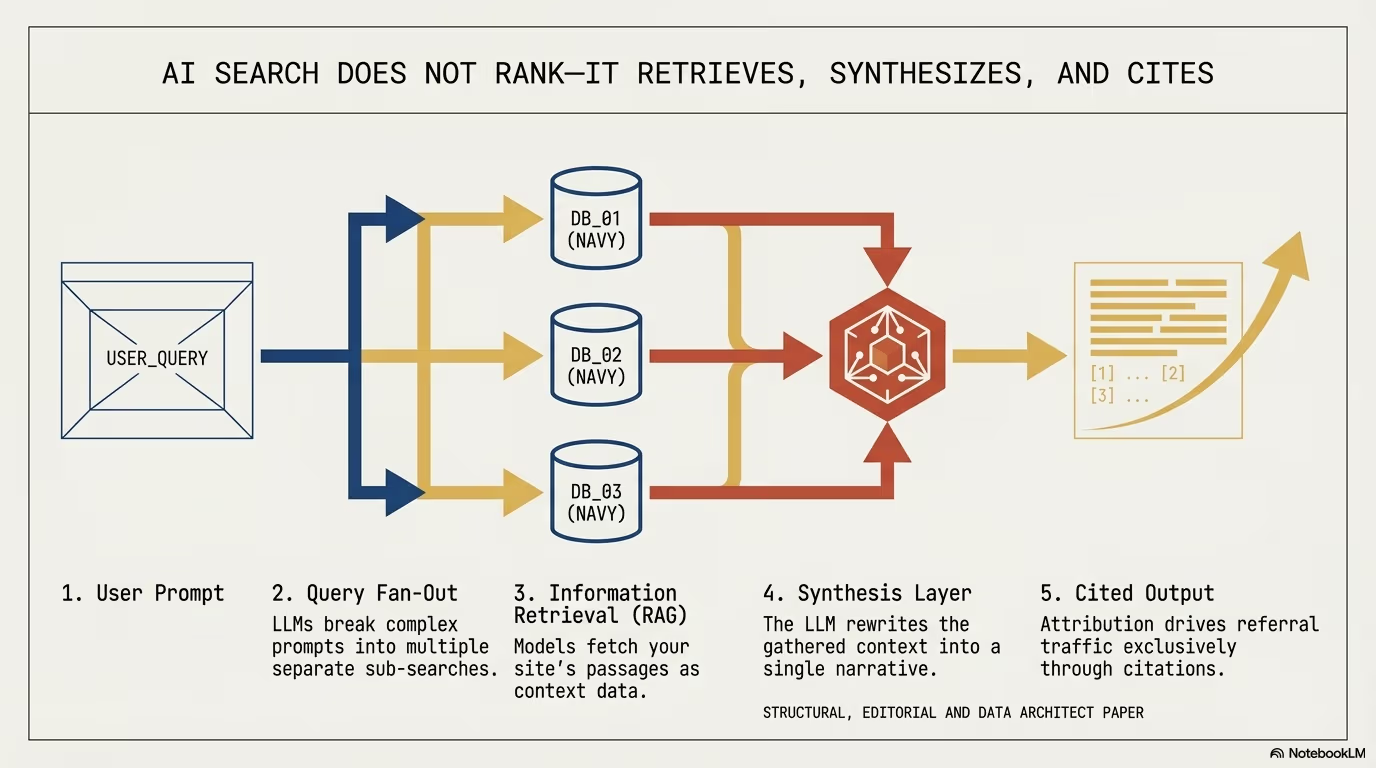
Uno de los descubrimientos más disruptivos para los lideres empresariales es que los rankings tradicionales de Google se han desacoplado de las citas de IA. La superposición entre los enlaces mejor posicionados en Google y las fuentes citadas por motores de IA es parcial, y ambos conjuntos divergen más de lo que asume la planificación habitual de SEO.
Digital Applied analizó 863 412 consultas entre octubre de 2025 y febrero de 2026 y concluyó que el 62% de las citas de AI Overview provienen de páginas en el puesto once o inferior, o de páginas totalmente fuera del top 100. La consecuencia práctica es que tu informe de posiciones no sirve como indicador adelantado de tus citas. Son dos selecciones distintas hechas sobre dos criterios distintos, y la única forma de saber cuánto se solapan en tu caso es medir las dos y compararlas fila a fila: la lista de tus URLs mejor posicionadas frente a la lista de las URLs tuyas que aparecieron nombradas en las respuestas de tu panel de prompts. Si esa comparación te deja páginas citadas que no rankean, has encontrado contenido que funciona para máquinas y no para el buscador; si te deja páginas que rankean y nunca aparecen citadas, tienes candidatas claras para revisar estructura antes que enlaces.
Los modelos de IA priorizan hechos extraíbles por máquinas y claridad estructural sobre las señales basadas en backlinks del SEO clásico. Donde el algoritmo de Google sopesa la autoridad de dominio, la equidad de enlaces y las métricas de engagement del usuario, los sistemas de IA evalúan con que facilidad pueden extraer un hecho verificable, con que claridad esta estructurado el contenido y cuanta confianza pueden tener en la precisión de la información.
Este desacoplamiento significa que tu sitio “perfecto para SEO” podría ser invisible para los mismos modelos de IA que ahora manejan las consultas de tus clientes. También significa oportunidad: un sitio más pequeño con una estructura de contenido excepcional, declaraciones factuales claras y un marcado de entidades solido puede superar a un gigante de autoridad de dominio en citas de IA.
La conclusion práctica es que los negocios necesitan estrategias de optimización paralelas. Tus esfuerzos de SEO deben continuar, pero debes superponer optimizaciones específicas de GEO: marcado de datos estructurados, declaraciones factuales claras en las primeras 200 palabras, implementación de schema a nivel de entidad y actualizaciones regulares de frescura del contenido. Ejecutar SEO sin GEO en 2026 es como optimizar para escritorio en 2015 mientras se ignora el móvil.
3. La autoridad es una red, no una página
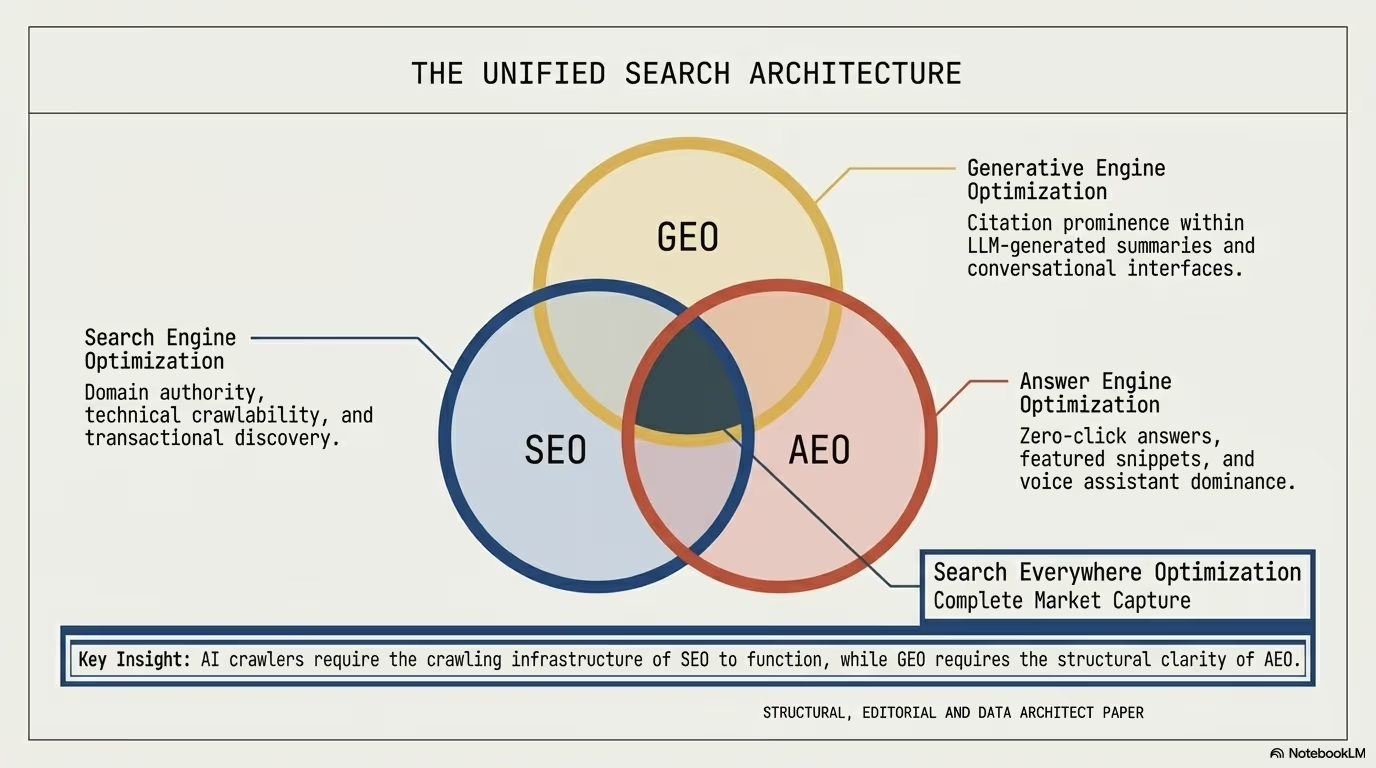
Los motores de IA no solo buscan una buena página. Verifican una autoridad de grafo temático. El cambio a una arquitectura entity-first es ahora la base estructural de GEO, y los datos que lo respaldan son convincentes.
Yext analizó 6,8 millones de citas de IA y comprobó que el 86% de las citas provienen de sitios con cinco o más páginas interconectadas sobre un tema específico. Las páginas aisladas, sin importar lo bien escritas que estén, rara vez obtienen citas de IA porque el modelo generativo no puede verificar la autoridad más amplia de la fuente.
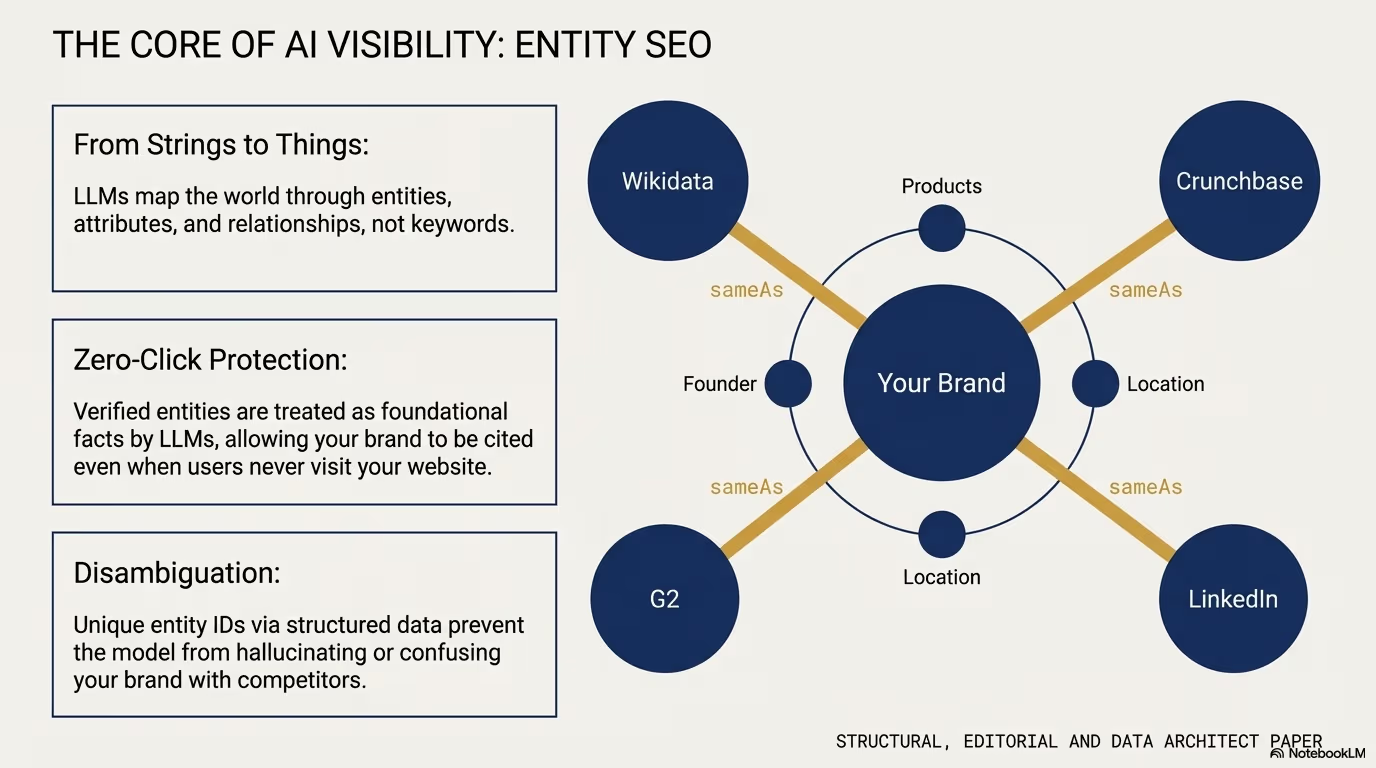
No hemos encontrado ningún estudio publicado que reduzca el valor de una arquitectura pilar-cluster a un único multiplicador, así que no citamos ninguno. El conjunto de datos de Yext sostiene una dirección, no un coeficiente: el umbral de cinco páginas es donde se concentra la cuota de citas, y los sitios que lo superan se sostienen por enlaces internos bidireccionales, no por compartir categoría en el menú. El mecanismo de fondo es la verificación. Un modelo que compone una respuesta tiene que decidir si la fuente que va a nombrar conoce el tema de verdad o solo posicionó para una frase. Una página suelta le da un dato y ninguna forma de contrastarlo. Un pilar con ocho subpáginas, cada una sobre una parte distinta del tema y cada una enlazando de vuelta, le da un grafo que puede recorrer antes de poner tu marca en una respuesta que no podrá retirar. Sin ese grafo la página queda huérfana: indexada en sentido técnico, inverificable en el sentido que aquí importa.
Como se ve esto en la práctica? Significa construir ecosistemas de contenido, no artículos independientes. Una página pilar cubre el tema amplio de forma integral, y las páginas cluster profundizan en subtemas mientras enlazan de vuelta al pilar y entre sí. La estructura de enlaces internos crea una red semántica que la IA puede recorrer para verificar autoridad.
Por ejemplo, un sitio que cubra “seguridad de WordPress” como pilar debería tener páginas cluster interconectadas sobre configuración de firewall, detección de malware, endurecimiento de login, implementación de SSL, escaneó de vulnerabilidades de plugins y respuesta a incidentes. Cada página enlaza a las demás con texto ancla descriptivo, creando un grafo de conocimiento denso que los sistemas de IA pueden navegar y en el que pueden confiar.
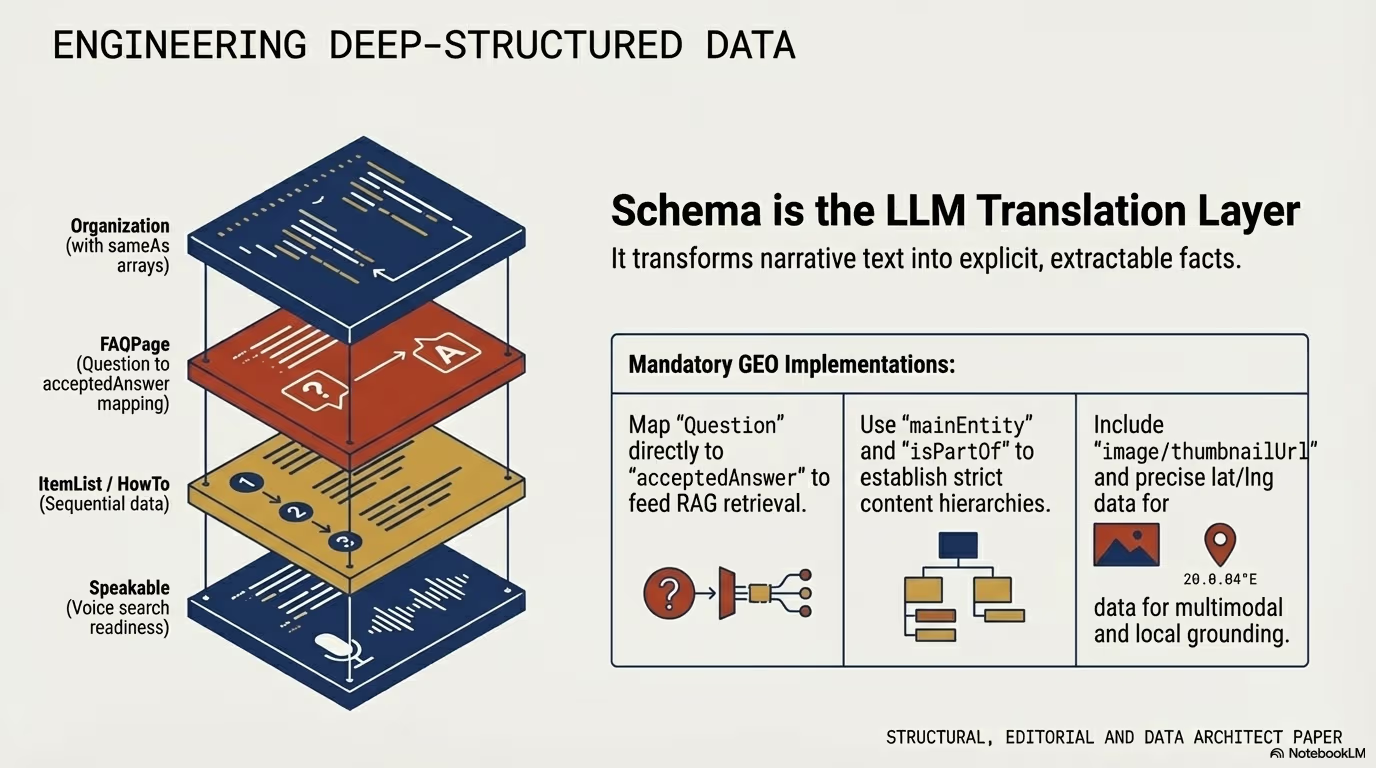
El enfoque entity-first va más allá. Cada concepto clave en tu sitio debe estar vinculado a su entidad correspondiente en Wikidata, y tus datos estructurados deben expresar las relaciones entre entidades de forma clara. Cuando un sistema de IA puede rastrear un grafo de entidades claro a través de tu contenido, trata tu sitio como una base de conocimiento en lugar de una colección de artículos desconectados.
4. El precipicio de frescura de 90 días
En la era de la IA, la fecha de tu contenido deja de ser un dato administrativo y pasa a ser un criterio de desempate. El caso que importa no es el de una fuente aislada, sino el de dos que se contradicen: el sistema recupera un pasaje tuyo con una cifra y otro ajeno con una cifra distinta para lo mismo. No tiene forma de comprobar cuál es cierta, así que se apoya en lo que si puede leer, y ahí la fecha visible en el propio texto, la coherencia con las demás fuentes recuperadas en la misma tanda y la presencia del periodo dentro de la frase pesan más que cualquier autoridad acumulada. Un dato escrito como “el año pasado” no tiene nada con lo que contrastarse, porque depende de cuándo se lea; el mismo dato con el año dentro de la frase entra en la comparación y sobrevive al desempate. De ahí la consecuencia incómoda: una página que fue la referencia del sector durante años puede perder frente a otra más pobre que simplemente nombra su periodo de referencia.
Seer Interactive, en su estudio sobre el impacto de la frescura en la visibilidad en IA, observó que el contenido actualizado en 90 días logra tasas de citación 2x mayores que el material más antiguo. Conviene leer ese dato con la misma cautela que pedimos para el resto: es una correlación medida sobre un conjunto de páginas ajenas, y las páginas que alguien se molesta en actualizar suelen ser también las que a alguien le importan. La fecha no es lo que se recompensa; lo que se recompensa es que el pasaje recuperado contenga una cifra que no contradiga lo que el modelo ve en otras fuentes recientes.
Por el contrario, el contenido que no se ha tocado en más de 18 meses es ampliamente ignorado por los motores generativos, independientemente de su autoridad histórica. Una página que alguna vez gano miles de backlinks y se posiciono en el número uno durante años puede volverse invisible para los sistemas de IA simplemente porque no se ha actualizado con datos actuales y hechos verificados.
El modelo estático de “publicar y olvidar” ha sido reemplazado por un ciclo obligatorio de actualización trimestral. Si tus datos no están frescos, la IA simplemente encontrara un competidor cuyos datos si lo están. Esto representa un cambio fundamental en la economía del contenido: el coste de mantener el contenido es ahora tan importante como el coste de crearlo.
Los pasos prácticos para mantener la frescura incluyen actualizar estadísticas y puntos de datos trimestralmente, agregar nuevas secciones que aborden subtemas emergentes, actualizar las fechas de publicación y última modificación con cambios genuinos de contenido, verificar que todos los enlaces externos sigan funcionando y apunten a recursos actuales, y revisar cualquier recomendación o buena práctica que haya podido cambiar desde la última actualización.
La señal de frescura no se trata solo de cambiar una fecha. Los sistemas de IA son lo suficientemente sofisticados como para detectar actualizaciones sustantivas frente a cambios cosméticos. Una actualización genuina agrega nueva información, actualiza estadísticas obsoletas y refleja el estado actual del tema.
5. Los sistemas de IA prefieren la “capa de legitimidad” (el sesgo de earned media)
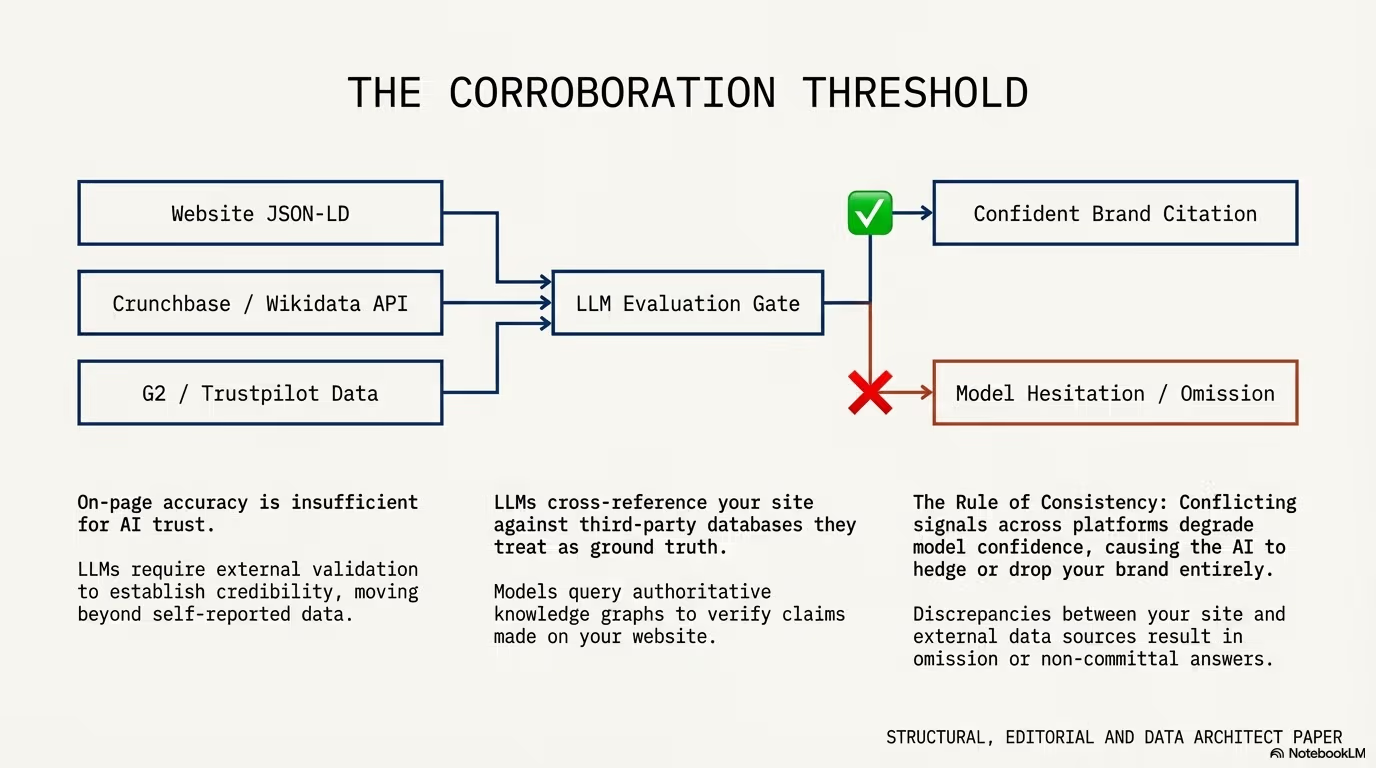
Los motores de búsqueda de IA se apoyan mucho más en lo que otros dicen de ti que en lo que tú dices de ti, y el motivo está en lo que cada texto le permite comprobar al sistema. En tu propio dominio, una afirmación sobre tu experiencia es a la vez la fuente y el objeto de la afirmación: no hay nada con lo que contrastarla, y el modelo lo sabe. En un dominio ajeno, la misma frase aparece firmada por alguien que no gana nada con ella y rodeada de contexto que sí se puede cruzar, como el nombre del producto que se está discutiendo, un hilo con respuestas que matizan o contradicen, o una ficha enciclopédica que enlaza a otras entidades ya conocidas. Esa es la diferencia material entre las dos capas, y explica por qué una página de servicios impecable puede quedarse fuera mientras un comentario de foro entra en la respuesta.
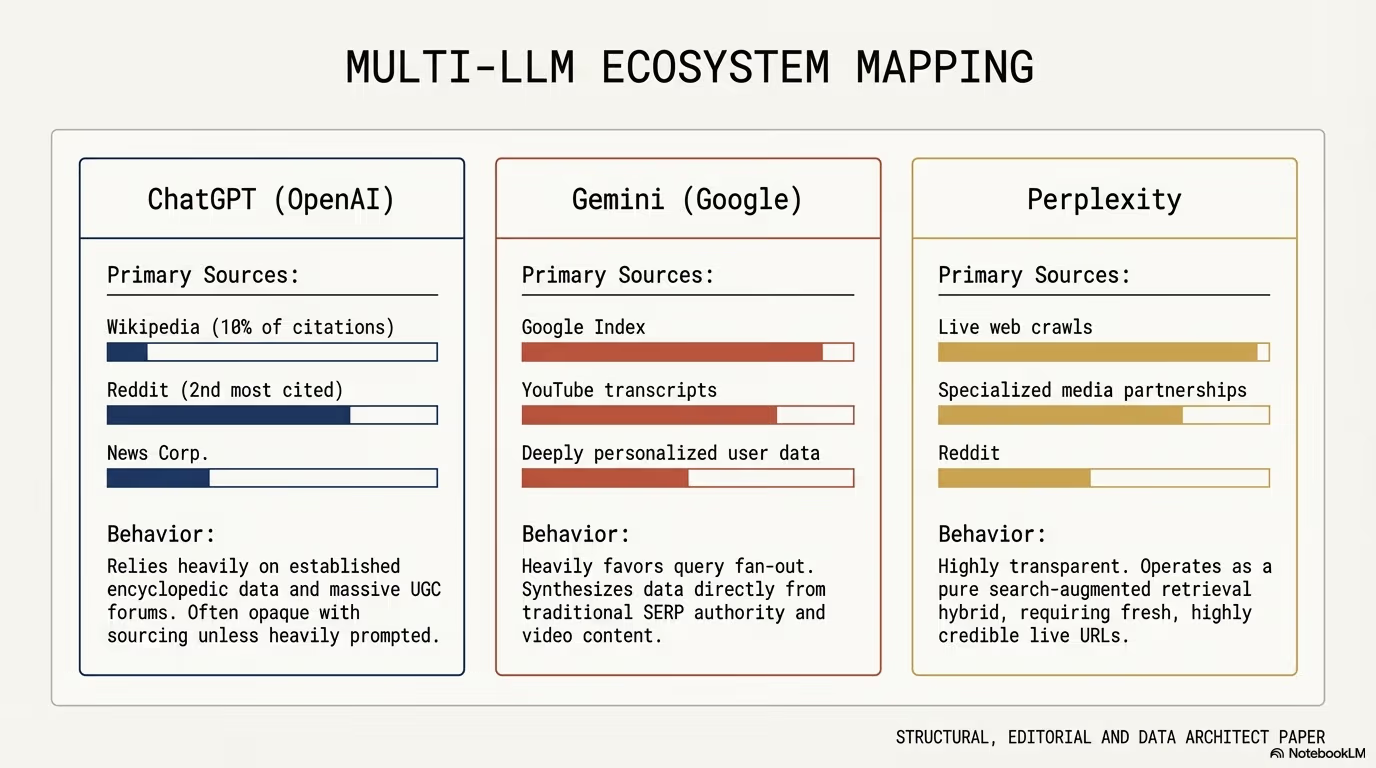
Según el análisis de patrones de citación de Profound, Wikipedia representa el 7,8% de todas las citas de ChatGPT, y la segunda fuente más citada, Reddit, queda por detrás con una distancia considerable. Ese reparto es también una advertencia sobre el denominador: una cuota de cita se calcula sobre el conjunto de preguntas que el estudio lanzó, no sobre las tuyas. En un nicho técnico estrecho, donde Wikipedia apenas tiene artículo, el reparto real que te afecta puede no parecerse en nada al agregado. Por eso el panel de prompts propio, por modesto que sea, vale más para decidir dónde invertir que cualquier cuota publicada.
Para ser citado por IA en tu propio sitio, a menudo debes primero ganar menciones en otros sitios en los que la IA ya confía, como Reddit, YouTube, los principales medios de comunicación, publicaciones de la industria y repositorios académicos. Esto crea un “foso zero-click” donde tu presencia en dominios autoritativos de terceros actúa como la señal de confianza requerida para que una IA eventualmente justifique citar tu dominio principal.
El mecanismo funciona así: cuando un modelo de IA encuentra tu marca mencionada positivamente en Wikipedia, Reddit y publicaciones de la industria, construye una puntuación de confianza interna para tu dominio. Una vez que se cruza ese umbral de confianza, el modelo se vuelve dispuesto a citar contenido directamente de tu sitio web. Sin esa capa de validación de terceros, tu contenido de primera parte existe en un vacio de confianza.
“Wikipedia lidera las citas de ChatGPT, con una participación del 7,8%, mientras que la segunda fuente más citada, Reddit, queda muy atrás… sirve como una ‘capa de legitimidad’ para las empresas.”
De ahí se sigue qué trabajo de comunicación sirve para esto y cuál no. Un artículo invitado que solo consigue un enlace en la firma aporta poco, porque la frase que queda escrita no afirma nada comprobable sobre ti. Una respuesta técnica en un hilo público, donde alguien describe su problema y tú explicas qué hiciste, con qué restricciones y qué no funcionó, deja escrito un pasaje que se puede recuperar entero y que nombra el sujeto dentro del propio texto. Lo mismo vale para una charla cuya descripción queda publicada, para una ficha en un directorio sectorial que enumera atributos, o para una mención en una publicación del ramo que cuenta de qué iba el caso en lugar de limitarse a nombrarte. El criterio para decidir dónde inviertes es sencillo: borra mentalmente el enlace y mira la frase que queda; si sigue afirmando algo concreto sobre lo que haces, esa aparición trabaja para ti.
La estrategia requiere paciencia. Construir la capa de legitimidad es una inversión a largo plazo, pero los retornos compuestos en visibilidad de IA la convierten en una de las actividades de mayor ROI en el marketing digital actual.
6. El /llms.txt: “apretón de maños secreto”
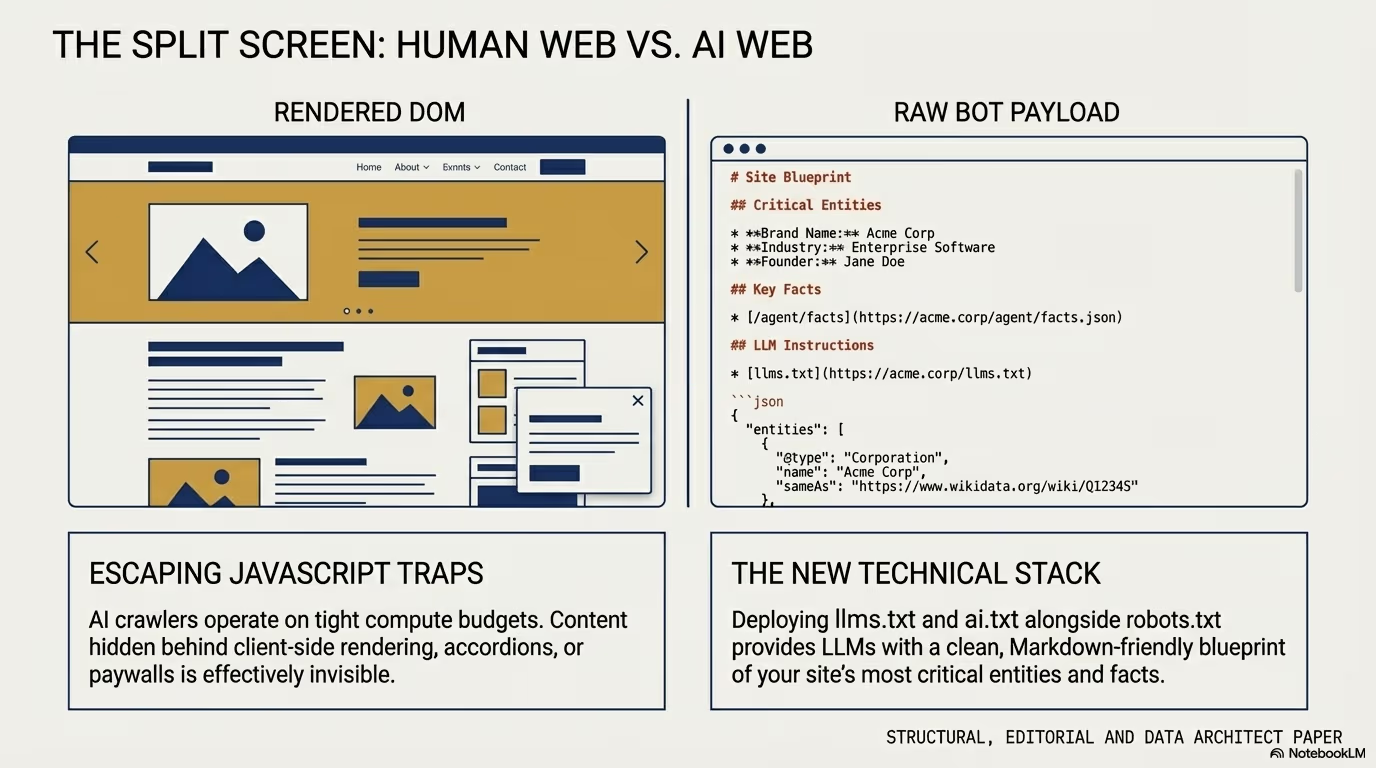
A medida que los sitios web evolucionan para servir tanto a humanos como a máquinas, ha surgido un nuevo estándar técnico: el archivo /llms.txt. La diferencia con robots.txt no está en el formato, sino en el momento en que se pide y en quién lo pide. robots.txt lo consulta un rastreador antes de recorrer el sitio, y lo que contiene son permisos sobre rutas que se aplican a un recorrido que durará horas o días. /llms.txt lo pide un agente mientras redacta una respuesta para alguien que espera delante de la pantalla, con un presupuesto de contexto que se agota y sin margen para atravesar menús, banners y contenido que solo aparece tras ejecutar JavaScript. Lo que necesita en ese instante no es saber adónde puede ir, sino recibir en una sola petición un índice en Markdown que diga de qué responde este dominio y en qué URL está cada cosa. Por eso un archivo que se limita a repetir el menú de navegación no aporta nada, y uno que enumera afirmaciones concretas con el enlace que las respalda le ahorra al agente justo las peticiones que no llegaría a hacer.
Este archivo resuelve el problema de la “ventana de contexto”. Los bots de IA a menudo tienen dificultades para analizar HTML complejo, menús de navegación, contenido renderizado por JavaScript y estructuras de página multicapa. Cuando un agente de IA visita tu sitio durante una conversación en vivo, tiene una ventana de contexto limitada y tiempo limitado para extraer información relevante. Un resumen limpio y legible por máquinas resuelve este problema de forma elegante.
Al proporcionar un archivo /llms.txt estructurado, permites que los agentes de IA ingieran tu información de nivel experto instantáneamente durante una conversación con el usuario. El archivo típicamente incluye las áreas de experiencia principal de tu sitio, afirmaciones factuales clave, categorías de contenido principales y enlaces a tus páginas más autoritativas, todo formateado en Markdown limpio que cualquier LLM puede procesar sin sobrecarga de análisis.
Este apretón de maños secreto se está volviendo tan esencial como el sitemap lo fue en la era anterior. Los sitios con vision de futuro ya están implementando archivos complementarios: /llms.txt para resúmenes de contenido estructurado, /ai-sitemap.xml para el descubrimiento de contenido específico de IA, y feeds JSON estructurados como /ai-training-data.json que proporcionan contenido optimizado para máquinas a cualquier sistema de IA que lo solicite.
La implementación es sencilla. Crea un archivo Markdown en la raíz de tu dominio que describa la experiencia de tu sitio, liste tu contenido más importante con breves resúmenes y proporcione declaraciones factuales claras que los modelos de IA puedan extraer y citar. Actualízalo cada vez que publiques contenido nuevo significativo. Piensa en ello como el curriculum de tu sitio para los sistemas de IA: conciso, factual y estructurado para el consumo por máquinas.
Conviene ser exacto con lo que este archivo hace y con lo que no. /llms.txt es una convención propuesta, no un estándar que ningún motor se haya comprometido a respetar, y no obliga a nadie a leerlo. Tampoco es un mecanismo de control: robots.txt expresa una preferencia que los rastreadores respetuosos cumplen y los demás ignoran sin consecuencia técnica alguna, y bloquear ahí a un rastreador de entrenamiento no impide que un agente de respuesta pida la misma URL en el momento en que alguien pregunta.
La parte buena es que su efecto sí es medible con lo que ya tienes. Publica el archivo y filtra tus registros por esa ruta: verás con nombre y apellidos qué clientes lo piden, con qué frecuencia y si vuelven después a las URLs que el archivo lista. Es una de las pocas señales de esta disciplina que se comporta como un experimento limpio, porque nadie llega a esa ruta por casualidad.
7. Intención sobre precisión: el poder del “query fan-out”
La IA funciona con procesamiento de lenguaje natural (NLP), y eso cambia lo que le llega al buscador que hay debajo. Un buscador clásico recibe los términos que la persona tecleó y los compara contra el texto de las páginas, de modo que las palabras concretas son el puente. Un asistente recibe un párrafo entero con la situación de quien pregunta y lo convierte en una representación del significado antes de buscar nada, así que las palabras exactas dejan de ser el puente y lo que decide es si tu texto describe la misma situación. Un párrafo que repite la frase clave una y otra vez sigue describiendo un solo escenario, y compite con todos los que describen ese escenario con más detalle. La forma más rápida de ver la diferencia es comparar lo que alguien teclea cuando tiene que caber en una caja de búsqueda con lo que le cuenta a un asistente cuando sabe que puede explicarse entero.
Según el SOCi Visibility Index, las búsquedas tradicionales escritas promedian 4 palabras mientras que las consultas dirigidas a un asistente promedian 23 palabras. Un usuario podría escribir “mejores plugins seguridad WordPress 2026” en un buscador. El mismo usuario le dice a una IA: “Tengo una tienda WooCommerce en hosting compartido y me preocupa la seguridad. Que plugins debería instalar para protegerme contra los ataques más comunes sin ralentizar mi sitio?”
Los usuarios ahora proporcionan contexto situacional completo en sus prompts. Describen su situación específica, restricciones, preferencias y objetivos. En respuesta, los motores de IA realizan “query fan-out”, dividiendo una pregunta compleja en múltiples subconsultas para encontrar la mejor respuesta. Esa única pregunta de 23 palabras podría generar cinco o seis subconsultas internas, cada una buscando diferentes aspectos de la respuesta.
El contenido que suena robotico o sobrecargado de palabras clave es penalizado en este proceso. Escribir como una persona real para una persona real es ahora una optimización técnica, no solo una preferencia estilística. Asegura que tu contenido se alinee con la intención semántica que la IA está tratando de satisfacer durante su proceso de fan-out.
En la práctica, esto cambia qué parte de tu texto hace el trabajo. Una frase de palabras clave describe un tema; una situación describe quién pregunta, con qué restricciones y qué ha descartado ya, y son esas restricciones las que el sistema puede cotejar con el prompt que tiene delante. Si tu página recomienda una solución sin decir para quién deja de valer, el modelo no puede saber si aplica al caso que está atendiendo, y prefiere una fuente que sí lo acote. Escribir las condiciones de contorno, incluidos los casos en los que tu recomendación no es la buena, parece que resta alcance y es justo lo que permite que te citen sin riesgo. Un consejo que vale para todo el mundo no resuelve la duda de nadie en concreto, y esa duda concreta es exactamente lo que el usuario acaba de escribir en el chat.
El contenido estructurado en torno a “Si estas en la situación X, entonces el mejor enfoque es Y porque Z” rinde mucho mejor en citaciones de IA que el contenido estructurado en torno a “El mejor enfoque es Y”. El contexto situacional le da a la IA confianza en que tu respuesta aplica a la pregunta específica del usuario que está procesando.
Esto también significa que el contenido long-tail basado en preguntas es más valioso que nunca. Las secciones de FAQ, las guías detalladas de cómo hacerlo y las recomendaciones específicas por escenario dan a los sistemas de IA exactamente el contenido estructurado y consciente de la situación que necesitan para generar respuestas precisas y citadas.
Convertirse en la respuesta
En 2026, la visibilidad ya no se trata de ser uno de diez enlaces en una página. Cuando alguien pregunta a ChatGPT, Gemini o Perplexity, el sistema recupera unos pocos pasajes, redacta una respuesta y después tiene que decidir a qué fuente atribuye cada afirmación. Ese último paso es el que decide si existes. Un pasaje que afirma algo comprobable y nombra el sujeto dentro de la misma frase se puede citar sin que el modelo se exponga; un párrafo que necesita las tres frases anteriores para entenderse se resume y se acaba citando a otro. Por eso dos páginas con la misma información terminan con destinos distintos: la que separa cada hecho en una unidad que sobrevive al recorte aparece con su nombre, y la que lo diluye en prosa continua alimenta la respuesta sin figurar en ella. Puedes comprobarlo con tus propias páginas sin herramienta alguna. Copia el párrafo que consideras tu mejor argumento, pégalo solo, sin título ni contexto alrededor, y pregúntate si sigue sosteniendo la afirmación y si se sabe quién la hace.
La transición a GEO requiere un giro de perseguir clics a poseer la cita, y ese giro se nota primero en trabajo concreto que cambia de manos. El calendario editorial deja de medirse por artículos publicados y empieza a medirse por hechos mantenidos, porque una cifra que aparece en varias páginas necesita un responsable el día que cambia. La infraestructura técnica hereda un requisito que antes no tenía: que el HTML que recibe un agente sin ejecutar JavaScript contenga ya la respuesta, y no el esqueleto que la cargaría después. Las relaciones públicas dejan de valorarse por el enlace conseguido y pasan a valorarse por la frase que queda escrita en un dominio ajeno, porque es esa frase la que el sistema recupera. Y la medición cambia de naturaleza: los registros del servidor dicen de forma censal quién pidió cada URL, mientras que la presencia en respuestas solo se conoce por muestreo, preguntando tú mismo y anotando qué salió. Mezclar ambas cosas en el mismo informe es el error que hace parecer serie temporal lo que es una fotografía.
Cada una de las siete secciones anteriores se puede reducir a una acción y a la comprobación que diría si funcionó:
- Estructura el contenido para la extracción: Coloca tus hechos más citables en las primeras 200 palabras y construye una arquitectura de respuesta primero que los sistemas RAG puedan procesar eficientemente.
- Desacopla tus estrategias: Reconoce que SEO y GEO son objetivos de optimización paralelos pero distintos, e invierte en ambos.
- Construye redes de autoridad temática: Crea ecosistemas de contenido interconectados con cinco o más páginas por cluster temático, conectados por enlaces internos bidirecciónales y marcado de entidades.
- Mantiene un ciclo de actualización de 90 días: Trata cada pieza de contenido como un documento vivo que requiere actualizaciones trimestrales con información genuinamente nueva y datos verificados.
- Invierte en la capa de legitimidad: Construye presencia en plataformas autoritativas de terceros en las que los sistemas de IA ya confían, creando las señales de confianza necesarias para la citación directa.
- Implementa el estándar /llms.txt: Dale a los sistemas de IA un punto de entrada limpio y estructurado a tu experiencia proporcionando resúmenes de contenido optimizados para máquinas.
- Escribe para la intención, no para palabras clave: Crea contenido consciente de la situación que coincida con las consultas conversacionales y contextuales que los usuarios llevan a los sistemas de IA.
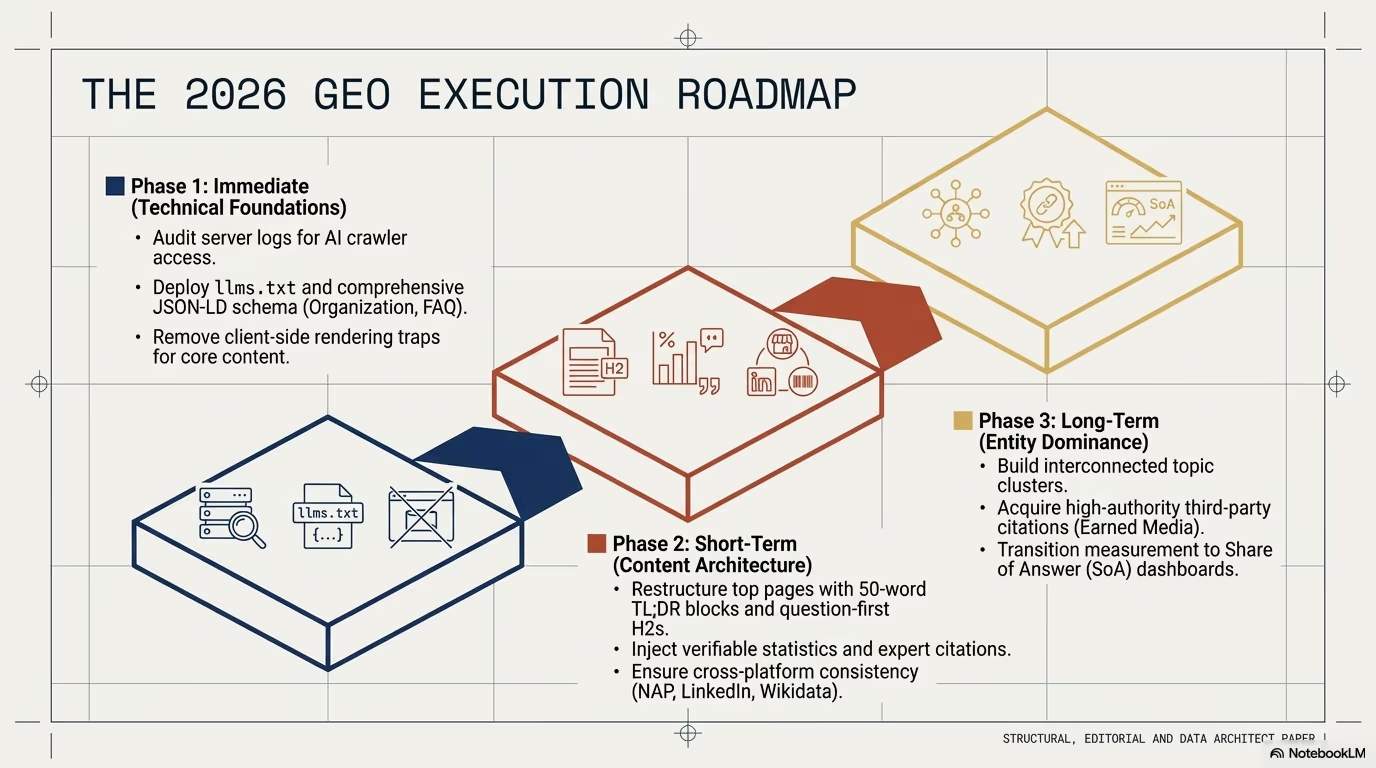
A medida que avanzamos más profundamente en está era AI-first, los lideres empresariales deben enfrentar una nueva realidad de medición y valor. Si un usuario nunca hace clic en tu sitio web pero obtiene la respuesta de tu marca a través de una IA, ganaste de todos modos, y como vas a medirlo?
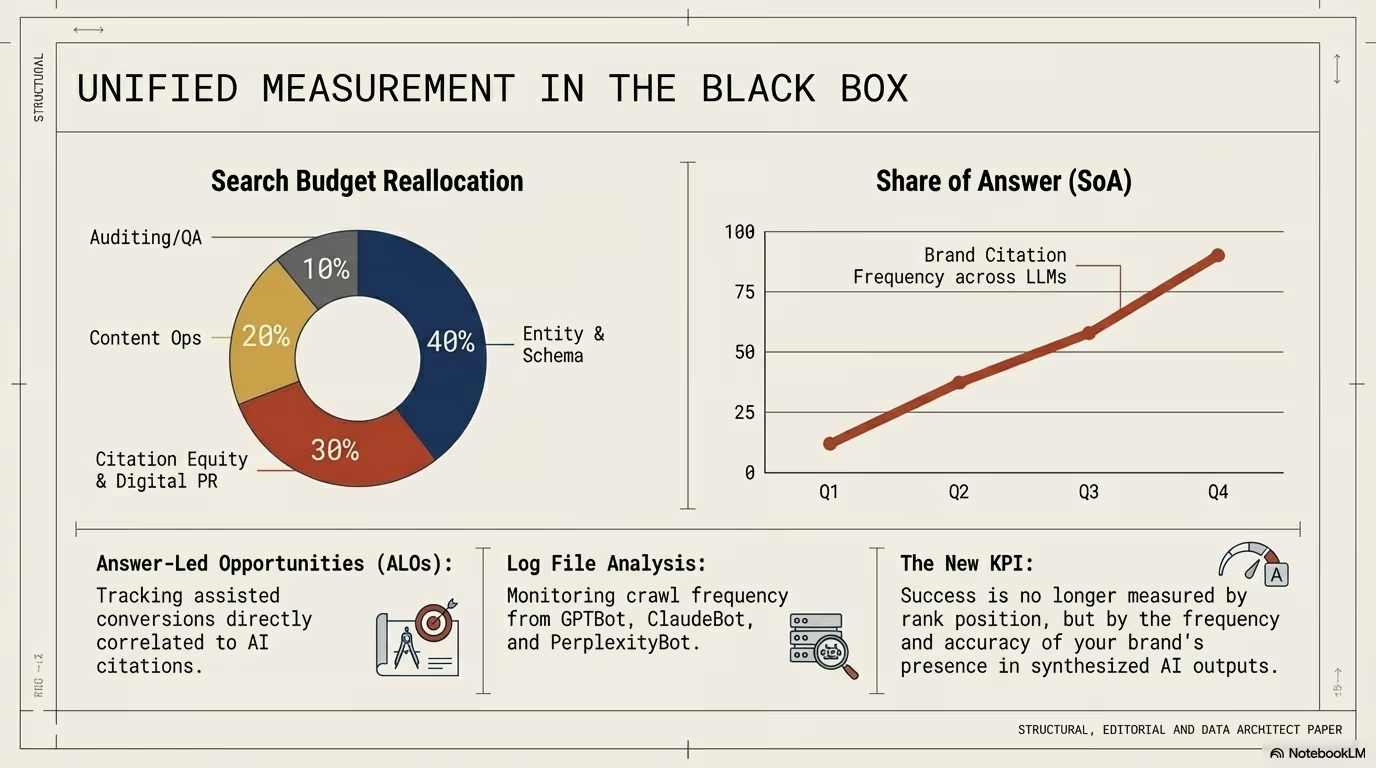
Las métricas que van a llenar ese hueco ya se pueden nombrar, y conviene clasificarlas antes de adoptarlas, porque no todas se obtienen igual. La frecuencia con la que apareces en respuestas, el tono con el que se menciona tu marca y la proporción de preguntas clave en las que eres la fuente citada solo se conocen preguntando: son medidas de muestra, dependen de la redacción exacta de tus prompts y de la versión del modelo que respondía ese día, y se comportan como una encuesta, no como un contador. En cambio, quién pidió cada URL y con qué cabecera lo hizo está en tus registros, y eso es censal: ahí no hay muestra ni azar que corregir. Confundir los dos tipos es lo que produce paneles que suben y bajan sin que haya ocurrido nada en el mundo. Así que la decisión práctica no es cuál de las métricas eliges, sino anotar junto a cada número si viene de tus registros o de tu panel de preguntas, y en qué fecha se tomó.
Antes de adoptar cualquiera de esas métricas conviene fijar por escrito lo que no puede saberse, porque es lo que distingue un cuadro de mando de un adorno. No sabes cuántas veces te citaron: sabes cuántas veces apareciste en tu propia muestra de preguntas. No sabes si un rastreo acabó en una respuesta: sabes que alguien pidió la URL. No puedes atribuir una venta a una cita que ocurrió dentro de un chat ajeno, y la persona que compra después de leerte ahí llegará a ti escribiendo tu nombre, de modo que el mérito se registrará como tráfico de marca.
De ahí sale una regla de trabajo modesta y sostenible. Mide lo censal en tus registros, mide lo muestral con un panel de preguntas fijo y una periodicidad fija, no compares nunca una tanda con otra tomada con distinta redacción, y guarda la fecha y la versión del modelo junto a cada resultado, porque sin ese par el histórico deja de ser comparable en cuanto el proveedor actualiza algo. Aplicada a nuestro propio caso, esa disciplina es la que produjo la única cifra por la que respondemos en este artículo, la proporción de peticiones sin user agent reconocido durante 23 horas de agosto de 2026, y también la que nos impide convertirla en una tendencia: es una ventana, no una serie.