Las predicciones de Thorsten Ball y los datos con que las comprobamos
El 19 de septiembre de 2026, Thorsten Ball publicó en X un mensaje breve: en su opinión, la mayoría de las predicciones que ve siguen siendo demasiado prudentes, así que ofrece las suyas. Adjuntó una nota titulada «What I believe about the future of software development» con 16 tesis. Ball es cofundador y uno de los creadores de Amp, antes trabajó en Sourcegraph y en Zed, y ha autopublicado dos libros sobre programación. No habla alguien ajeno al oficio.
Las tesis son tajantes: la revisión de código morirá, los tests unitarios pueden morir, la terminal está muerta y el open source en su forma actual ya no tiene sentido. Respondemos a cada una por separado, con una valoración: de acuerdo, de acuerdo en parte o en desacuerdo.
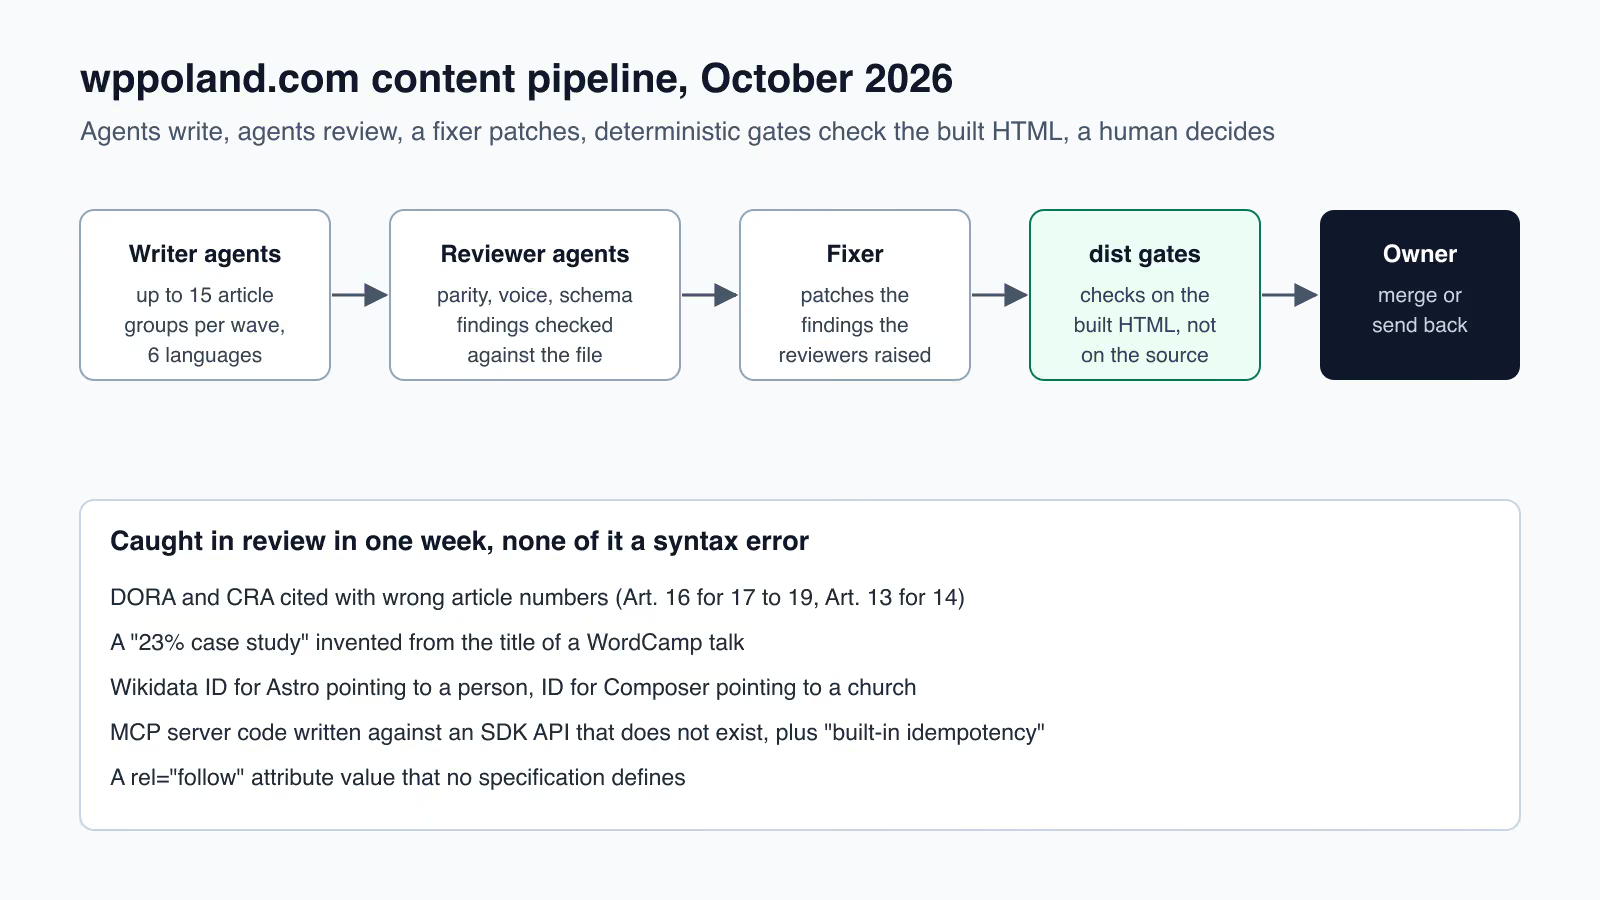
Nuestras pruebas vienen de un único sitio que conocemos de primera mano: el pipeline de agentes de IA que en octubre de 2026 amplía los contenidos de esta web. Los agentes de redacción trabajan en paralelo y en cada oleada se ocupan de hasta 15 grupos de artículos en seis idiomas. Según el historial del repositorio, la oleada 20, del 15 de octubre, abarcó 14 grupos y 85 archivos. Agentes revisores independientes comprueban la coherencia entre versiones lingüísticas, el estilo y los datos estructurados, y otro agente distinto corrige lo que han señalado. Al final, unas comprobaciones automáticas que se ejecutan sobre el HTML generado deciden si el cambio puede seguir adelante. El esquema aparece en la ilustración de la parte superior de la página.
El pipeline trabaja sobre una web en producción con miles de páginas, de modo que un error de un agente que nadie detecte va directo al buscador. Por eso nuestra visión del futuro del desarrollo de software es más estrecha que la de Ball, pero se apoya en lo que hemos visto nosotros mismos durante la última semana.
El futuro del desarrollo de software según Thorsten Ball
A continuación, todas las tesis de la nota en el orden del autor, con nuestra valoración. Cada una se desarrolla más abajo.
| Tesis de Thorsten Ball | Nuestra valoración |
|---|---|
| La revisión de código morirá | En desacuerdo, la revisión cambia de objeto |
| Los tests unitarios pueden morir | En desacuerdo |
| El oficio de escribir código desaparecerá | De acuerdo en parte |
| El oficio de construir software será más importante que nunca | De acuerdo |
| La mayoría de los errores serán del tipo «pediste lo que no era» | De acuerdo |
| El open source en su forma actual ya no tiene sentido | En desacuerdo |
| Las aportaciones humanas al rendimiento seguirán siendo un caso límite | De acuerdo en parte |
| La terminal está muerta | En desacuerdo |
| Los tokens son el nuevo paradigma de computación | De acuerdo en parte |
| La tríada PM, diseño e ingeniería desaparecerá | De acuerdo en parte |
| Crecerá la brecha entre grandes y pequeñas empresas | De acuerdo en parte |
| No hay pruebas de que el «buen código» vaya a importar | De acuerdo en parte |
| Algunas personas no podrán permitirse producir software | De acuerdo en parte |
| Es dudoso que se vayan a usar modelos más baratos | De acuerdo |
| La interfaz se generará sobre la marcha | Sin datos por nuestra parte |
| Llevará una generación | De acuerdo |
Balance: en cuatro puntos damos la razón a Ball, en cuatro discrepamos, en siete vemos la dirección pero no la escala y en uno no tenemos datos.
Tiene sentido la revisión de código con IA
«La revisión de código morirá. Quiero decir: ya está muerta. Pero en el futuro, las personas no encontrarán un fallo ni un problema en el código producido por un modelo, al menos no en un tiempo razonable. Las personas solo revisarán el sistema y su composición, pero no será en PR ni repasando cada línea del código.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: en desacuerdo, aunque la segunda mitad de la tesis acierta.
Ball tiene razón en una cosa: una persona que repase línea a línea cientos de archivos por oleada no tiene ninguna posibilidad. Se equivoca en la conclusión. La revisión no muere, cambia de objeto. En nuestro pipeline ya nadie busca un punto y coma que falta. El revisor busca una afirmación falsa que es sintácticamente correcta.
Lista de una sola semana de octubre de 2026, detectada por los revisores:
- Los agentes dieron números de artículo erróneos en textos sobre normativa: el artículo 16 de DORA donde correspondían los artículos 17 a 19, y el artículo 13 de CRA donde correspondía el artículo 14.
- Un agente construyó un «caso de estudio con un resultado del 23 por ciento» a partir del simple título de una charla en un WordCamp. Ese caso de estudio no existía.
- El identificador de Wikidata indicado para Astro apuntaba a una persona, y el de Composer, a una iglesia.
- Un agente escribió código de servidor MCP para una API del SDK que no existe y atribuyó al protocolo MCP una «idempotencia integrada» que no tiene.
- En un texto sobre enlaces apareció el atributo
rel="follow", que no define ninguna especificación.
Ninguno de estos errores es un error de código en el sentido clásico. Todos habrían pasado la compilación, el parser de YAML y el validador de Markdown. Todos se habrían publicado si la revisión hubiera muerto. Además, varios son afirmaciones que el lector aceptará sin más, porque suenan a datos sacados de la documentación.
La segunda mitad de la tesis de Ball acierta: la revisión se traslada de los PR al sistema. Nuestros revisores no leen diffs, sino que contrastan afirmaciones con las fuentes y comparan las versiones lingüísticas entre sí. La revisión pasa de «¿es correcta esta línea?» a «¿es verdad esta frase y se sostiene el conjunto?». Eso no se hace en la ventana de un pull request, pero se sigue haciendo, y la decisión de si un cambio llega a producción sigue en manos de una persona.
Siguen siendo necesarios los tests unitarios con IA
«Puede que los tests unitarios también mueran. ¿Para qué quieres ruedines si nunca te caes? He tenido modelos que escribieron 900 líneas de C para Arduino, las compilaron sin un solo error y las enviaron al dispositivo, donde el programa funcionó a la perfección. 900 líneas no serán nada en el futuro.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: en desacuerdo.
El ejemplo de Arduino es real e impresiona. Pero demuestra algo distinto de lo que sugiere la tesis. Un programa que compila y funciona cumple un único criterio: hace algo sin fallar. No sabemos si hace lo que el autor quería con cualquier entrada, ni si lo seguirá haciendo después del siguiente cambio.
En nuestra web, los tests más valiosos han resultado ser los que comprueban el resultado del build, no el código fuente. Las comprobaciones que se ejecutan sobre el directorio dist cuentan los encabezados H1 de cada página, verifican que ninguna marca de Markdown se haya colado como texto y que los datos estructurados coincidan con la URL canónica. Estas comprobaciones detectaron regresiones en cambios que habían compilado sin una sola advertencia. El compilador no sabe que la página debía tener un H1 y tiene dos.
Un test no es un ruedín. Es la expectativa escrita en una forma que la máquina comprueba en cada cambio posterior, incluido el que haga un agente dentro de seis meses. Cuanto más código escriben los modelos, más rentable es ese registro, porque nadie va a leer todo lo que generan. Lo que cambia es más bien el nivel de los tests: menos tests de funciones aisladas y más tests del comportamiento del sistema completo y de su resultado.
Merece la pena aprender a programar en 2027
«El oficio de escribir código desaparecerá. Sí, todavía quedan zapateros italianos. Pero mírate los pies.»
«El oficio de construir software será más importante que nunca. Saber cómo resolver problemas de negocio con software, cómo lo hizo otro software y por qué sí y por qué no, cuándo y cómo lanzarlo, cómo obtener feedback: ese es el nuevo juego.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: con la primera tesis, de acuerdo en parte; con la segunda, totalmente de acuerdo.
Escribir código línea a línea pierde peso, eso es cierto. En nuestro pipeline, los agentes escriben contenido, correcciones y scripts auxiliares más rápido que cualquiera de nosotros. Pero para juzgar si el código de un servidor MCP llama a una API que existe, hay que saber leer ese código y saber dónde consultar el SDK. Leer código no desaparece junto con escribirlo. El zapatero de la metáfora de Ball ya no tiene que coser zapatos, pero alguien tiene que darse cuenta de que la suela está pegada torcida.
La segunda tesis es la frase más acertada de toda la nota. Saber qué construir, cómo dividirlo, cuándo lanzarlo y cómo medir el efecto es hoy el cuello de botella. Nuestro repositorio tiene un documento aparte con principios de producto, que empieza diciendo que el problema ya no es «cómo implementarlo», sino «qué debería existir».
A la pregunta de si aprender a programar, respondemos así: hay que aprender a construir software, y tratar la escritura de código como la vía para entender lo que produce el agente. Sobre si la IA quitará el trabajo a quienes desarrollan webs escribimos con más detalle en ¿reemplazará la IA a los desarrolladores de WordPress?, y sobre el trabajo con agentes en equipo, en el artículo sobre agentic engineering.
Los errores del código hecho con IA suelen venir de pedir lo incorrecto
«La mayoría de los errores no serán errores “de código”. Serán errores del tipo “pediste lo que no era”.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: de acuerdo.
Es la tesis que confirma nuestra lección más cara. Lotes anteriores de tareas para agentes pedían ampliar artículos hasta un número determinado de palabras. Los agentes cumplieron exactamente esa orden: añadieron texto que subía el contador sin aportar contenido. El código de los scripts no tenía fallos. Lo erróneo era la petición. Hoy una regla del repositorio prohíbe los scripts que rellenan contenido hasta un número de palabras, y una comprobación aparte detecta bloques de relleno repetidos.
El mismo mecanismo aparece en el caso de estudio inventado con un resultado del 23 por ciento. El agente recibió la tarea «añade una sección basada en fuentes» y una fuente que no era más que el título de una charla. El modelo rellenó el hueco con una cifra. La petición no decía qué hacer cuando la fuente se queda corta.
Conclusión práctica: lo que más tiempo lleva hoy al trabajar con agentes es redactar la tarea, es decir, describir cuál es el resultado, qué está prohibido y qué hacer cuando faltan datos. Eso es una especificación, solo que más corta y escrita con más frecuencia que antes.
Sobrevivirá el open source a la IA
«El open source en su forma actual ya no tiene sentido. “Con suficientes ojos, todos los errores son superficiales” sigue siendo cierto, pero ahora tenemos ojos artificiales.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: en desacuerdo.
Ball alude a la ley de Linus, formulada por Eric S. Raymond: con muchos participantes, los errores se encuentran rápido. La tesis sostiene que, si los modelos pueden mirar el código en lugar de las personas, el modelo abierto de contribución pierde su sentido.
Los datos de uno de los proyectos open source más importantes muestran el efecto contrario. Daniel Stenberg, autor de curl, cerró el programa de bug bounty del proyecto el 31 de enero de 2026. Desde 2019, el programa había dado lugar a 87 vulnerabilidades confirmadas y a más de 100 000 USD en recompensas para investigadores. Según Stenberg, en años anteriores más del 15 por ciento de los informes resultaban ser vulnerabilidades reales, y desde 2025 la proporción cayó por debajo del 5 por ciento ante la avalancha de informes generados por IA. Ni siquiera uno de cada veinte era real.
Los ojos artificiales existen, pero en esta forma producen informes, no parches, y cargan a los mismos mantenedores humanos que debían beneficiarse de ellos. El open source cambia, por tanto, sus filtros de entrada, no su principio. WordPress, con el que trabajamos a diario, sigue viviendo del código abierto y de las personas que deciden qué entra en el núcleo. Esa elección no desaparecerá cuando haya más código. Será más importante.
Importa el rendimiento del código con IA
«Las aportaciones humanas en rendimiento crítico seguirán siendo lo que son: un caso límite. En el 99% del software no importa que hubieras podido escribir un algoritmo más rápido o elegir una estructura de datos mejor. […] Cuando importa, los modelos pueden arreglarlo.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: de acuerdo en parte.
Con la primera parte es difícil discutir. La mayor parte del código no es un cuello de botella ni lo será nunca. La discrepancia está en la frase «los modelos pueden arreglarlo». Un modelo arreglará el rendimiento si alguien sabe por dónde se escapa. En nuestro build, el problema no estaba en un algoritmo que alguien pudiera haber escrito mejor, sino en un paso en el que nadie pensaba hasta que medimos el tiempo de cada fase. La medición la hizo una persona; la corrección pudo escribirla después un modelo.
En la práctica con webs WordPress pasa algo parecido: una tienda lenta rara vez tiene un único algoritmo malo. Tiene demasiados plugins, consultas sin índice o la caché configurada donde no toca. Decidir qué quitar exige entender el negocio del cliente, no solo leer un profiler.
Acabarán los agentes de IA con la terminal
«La terminal está muerta. Los tokens arrasarán con la mayor parte de las herramientas de desarrollo. Las personas ya no usarán shells, editores de texto ni herramientas CLI.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: en desacuerdo, aunque entendemos de dónde sale la tesis.
El propio Ball aclara que lo escribe como amante de la terminal. Tiene razón en que cada vez menos gente recuerda los flags de jq. Pero nuestro pipeline muestra que la terminal no desaparece, sino que cambia de usuario. Los agentes trabajan precisamente en la shell: ejecutan npm run gates:run, leen archivos, llaman a git. Cada comprobación que detecta sus errores es un script de línea de comandos.
La terminal se convierte en la interfaz de los agentes y de la persona que comprueba lo que ha hecho el agente. Cuando un revisor señala un error, la forma más rápida de verificarlo es un solo grep sobre el archivo. La persona escribe menos comandos, pero lee más.
Tokens como nuevo paradigma de computación
«Los tokens son el nuevo paradigma de computación. Todo se volverá a construir sobre ellos. […] Estamos entrando en la era posbinaria.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: de acuerdo en parte.
Ball señala que durante 80 años hemos tenido ordenadores deterministas y confundimos cómo funcionaban con cómo tienen que funcionar. Es una observación honesta. Nuestra experiencia le añade un matiz: cuanto más trabajo hacen los modelos no deterministas, más valor tienen las comprobaciones deterministas que los rodean.
En nuestro pipeline, un agente puede escribir la misma frase de diez maneras, pero la comprobación cuenta los encabezados siempre igual. Esa combinación funciona: el modelo genera, el script verifica. La era posbinaria, si llega, se apoyará en una base binaria de control. Nos cuesta imaginar un despliegue responsable en el que el modelo se compruebe a sí mismo sin un criterio firme.
Reemplazará la IA a product managers y diseñadores
«La tríada PM/Diseño/Ingeniería desaparecerá. […] Los “ingenieros” que actúan como “proxies de carne”, meten tickets en los agentes e informan de vuelta a las personas dejarán de aportar valor.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: de acuerdo en parte.
La tesis de los «proxies de carne» acierta. Un rol que consiste solo en pasar tareas entre una persona y un agente no aporta valor, porque el agente acepta la tarea directamente. En nuestro pipeline no hay intermediario entre el propietario y los agentes.
Las decisiones que se repartía la tríada, sin embargo, no desaparecen junto con el reparto de roles. Alguien sigue teniendo que decidir qué se construye y qué no, cómo debe ser la interfaz y si un cambio está listo. En nuestro caso, esas decisiones se han concentrado en una sola persona, no se han disuelto. Es más una fusión de roles en una sola cabeza que su final. De ahí sale un requisito: quien dirige a los agentes necesita competencias en las tres áreas.
IA en pymes frente a grandes empresas
«La diferencia entre la ingeniería de software en las grandes corporaciones y en las pequeñas aumentará.»
«Algunas personas quedarán fuera de la producción de software por el precio. […] si no consigues suficientes tokens, juegas en segunda división. Tienes que llegar a los tokens.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: de acuerdo en parte con ambas tesis.
Ball escribe que las startups que copian las prácticas de Google parecerán todavía más ridículas, porque pueden construir más rápido y con menos restricciones. Desde la perspectiva de un equipo pequeño es cierto: nuestro pipeline de agentes no tiene comité de arquitectura, y una oleada de cambios en varias decenas de archivos sale en un día. Pero lo que nos protege de los errores es justo una práctica conocida en las grandes empresas: comprobaciones automáticas, revisión independiente y un único responsable de las decisiones. Una pyme puede prescindir del proceso, pero no del control.
En cuanto al coste de los tokens: el acceso a modelos potentes cuesta dinero, y ese coste crece con el número de agentes en paralelo. La frontera, sin embargo, no separa a ricos de pobres, sino a quienes saben convertir tokens en un resultado verificado de quienes pagan por texto que acabará en la papelera. El relleno escrito para alcanzar un recuento de palabras también costó tokens.
Modelo de IA barato o inteligente para programar
«Es discutible que se vayan a usar modelos más baratos. […] un modelo más inteligente comete menos errores y necesita menos turnos. ¿Cuándo piensas de verdad “me parece bien que se equivoque unas cuantas veces”?»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: de acuerdo.
Nuestro pipeline tiene esta regla escrita en las instrucciones del repositorio. El agente que escribe prosa y traducciones trabaja con el modelo por defecto, el más potente. El modelo barato se encarga exclusivamente de revisiones de solo lectura, y cada hallazgo suyo se comprueba en el archivo antes de que nadie corrija nada.
Este reparto responde a la pregunta de Ball de forma directa. Un modelo barato es aceptable donde un fallo cuesta una comprobación. Donde un fallo acaba en un texto en producción en seis idiomas, el ahorro en tokens se convierte en una revisión más larga y más correcciones. Cuenta el coste del ciclo completo, no el precio de una sola llamada.
Importa el código limpio con IA
«No hay ninguna prueba de que el “buen código” vaya a importar en el futuro. La propia noción de “buen código” se basa sobre todo en la idea de que a las personas les resulta fácil, barato y eficiente trabajar con él. Pero las personas no modificarán la mayor parte del código.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: de acuerdo en parte.
El ancho de 80 columnas, efectivamente, no le importa a un agente. Pero parte de las reglas del «código limpio» sobrevivirá por un motivo distinto de la comodidad humana: el código tiene que poder verificarse. Nuestras comprobaciones funcionan solo porque el resultado tiene una estructura predecible. Un frontmatter con un contrato de campos claro, un único propietario para cada identificador en los datos estructurados, una sola función que determina la URL de un servicio. Cuando dos puntos del código emitían el mismo identificador de schema, el problema no era la fealdad, sino que ninguna comprobación sabía cuál de los dos era la fuente de verdad.
El «buen código» deja de significar «agradable de leer». Empieza a significar «cuya corrección se puede verificar automáticamente». Es un desplazamiento, no un final.
Interfaces generadas por IA sobre la marcha
«Los modelos serán tan rápidos que la interfaz se generará sobre la marcha. Mucha interfaz existe porque el software no entiende lo que quieres.»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: no tenemos datos que confirmen ni refuten esta tesis.
Ball escribe que los menús, las pantallas de ajustes, los paneles y los filtros son en buena parte una interfaz entre una persona y una «máquina tonta». La observación es interesante. Nosotros no generamos interfaces sobre la marcha y no tenemos ninguna medición que permita valorar cómo se comporta una interfaz así en accesibilidad, previsibilidad y confianza del usuario. Preferimos decirlo antes que adivinar.
Una observación de nuestro trabajo: los usuarios de las webs que construimos siguen esperando que el botón esté en el mismo sitio en la segunda visita. Una interfaz que cambie en cada visita tendría que satisfacer esa necesidad de algún modo.
Cuándo cambiará la IA el desarrollo de software
«Hará falta una generación para que el “software nuevo” sustituya al “software viejo”. […] dentro de 10 años habrá personas contratadas para escribir código. Pero ¿quieres tener ese trabajo?»
(Thorsten Ball, publicación en X del 19 de septiembre de 2026, traducción propia)
Valoración: de acuerdo.
Incluso medir cuánto aporta la IA a los desarrolladores resulta difícil. La organización METR realizó en 2025 un estudio con grupo de control aleatorizado sobre desarrolladores experimentados de open source que trabajaban en sus propios repositorios. Con herramientas de IA, las tareas les llevaron un 19 por ciento más de tiempo. En febrero de 2026, METR describió un segundo estudio: para los desarrolladores de la primera edición, la estimación del cambio en el tiempo por tarea fue de menos 18 por ciento (intervalo de confianza de menos 38 a más 9 por ciento), y para los nuevos participantes, de menos 4 por ciento. Aun así, el propio METR calificó estos datos como una señal poco fiable, porque cada vez más desarrolladores rechazaban participar al no querer trabajar sin IA.
Es un buen retrato de un periodo de transición: las herramientas están tan arraigadas en el trabajo que cuesta encontrar un grupo de control y, al mismo tiempo, no hay una cifra firme de cuánto aportan. Una generación es una escala de tiempo razonable para un cambio así. La pregunta de Ball al final de la nota se la dejamos al lector.
Qué significa esto para empresas que contratan software
De las 16 tesis sacamos cuatro conclusiones prácticas para las empresas que encargan webs, tiendas e integraciones.
- Pregunte quién revisa las afirmaciones y cómo, no solo el código. El código hecho con IA compila bien. Los errores están en los datos, en los números de los artículos legales, en los nombres de las API y en los supuestos de negocio.
- Exija comprobaciones automáticas sobre el resultado. Un test que verifica la página generada o el funcionamiento de una integración detecta una regresión que no se ve en el código fuente.
- Invierta en la descripción de la tarea. La mayoría de los errores nacen de peticiones mal planteadas. Una buena especificación sale más barata que las correcciones.
- No ahorre en el modelo allí donde el resultado va a producción. Un modelo barato para revisar, con verificación; un modelo potente donde se crea el contenido o el código.
Si tiene una web o una aplicación construida deprisa con ayuda de la IA y no sabe qué hay dentro, nos ocupamos del rescate de webs hechas por IA. Si quiere incorporar agentes a sus propios procesos con el control descrito más arriba, consulte la implementación de IA y el desarrollo de servidores MCP. El contexto más amplio de por qué las ganancias de la IA llegan más despacio de lo que prometen los proveedores lo explicamos en el texto sobre la paradoja de la productividad de la IA.
Última actualización: 15 de octubre de 2026.