Una petición cuyo user agent dice Googlebot solo demuestra que alguien escribió la palabra Googlebot en una cabecera. La prueba que cuenta es la dirección IP: tiene que estar en la lista que publica Google, o superar una consulta de DNS inverso seguida de una directa que devuelva la misma dirección. Esta guía va desde un grep de una línea sobre tu registro de accesos hasta una regla que frena a los impostores sin tocar al rastreador real.
Si tienes una tienda WooCommerce, el caso típico es este: alguien recorre tu catálogo entero, ficha a ficha, para copiar precios y descripciones. Lo has bloqueado por user agent, y el scraper vuelve al día siguiente presentándose como Googlebot, porque sabe que casi nadie se atreve a cerrarle la puerta a Google. Lo que sigue sirve para comprobar si eso está pasando en tu servidor y para cerrar esa puerta solo a quien miente.
El motivo para mirarlo ahora: el 30 de octubre de 2026, Search Engine Roundtable publicó un resumen de una entrevista a Gary Illyes, de Google, en el Odys Podcast, en la que relaciona el aumento de bots que suplantan a otros con la IA. Si tu WordPress está detrás de Cloudflare, lee también mi artículo anterior sobre si Cloudflare bloquea a Googlebot. Ese texto trata de los ajustes de bots de IA, del Bot Fight Mode y de lo que un 403 hace con las páginas indexadas. Este trata del paso previo: saber quién está llamando a la puerta de verdad.
Todos los comandos y configuraciones de abajo los ejecuté el 30 de octubre de 2026 contra los archivos reales de Google, con nginx 1.27.2 y Apache 2.4.63 en una máquina de pruebas. Cuando no he podido probar algo en un servidor real, lo digo.
¿Por qué hay cada vez más Googlebots falsos?
Barry Schwartz, de Search Engine Roundtable, resumió la conversación entre Illyes y la presentadora del podcast, Aneta Samkoff. Ante la pregunta de por qué la suplantación se ha convertido en un problema tan grande, Illyes respondió:
“Creo que es la IA.”
Gary Illyes, citado por Search Engine Roundtable, 30 de octubre de 2026; episodio en YouTube, Odys Podcast (traducción propia)
Su razonamiento, tal como lo cita Search Engine Roundtable: las empresas buscan contenido para entrenar modelos, los cortafuegos y las CDN identifican cada vez mejor a los rastreadores pero siguen sin ser perfectos, y un pequeño motor de IA o un scraper que dice ser Googlebot consigue muchas veces entrar donde, de otro modo, lo bloquearían. Según el mismo resumen, Illyes tiene trampas (honeypots) para rastreadores y ha visto en ellas peticiones que se presentaban como Googlebot desde IP sin ninguna relación con Google. El título del episodio habla de unos 30 segundos para hacerse pasar por Googlebot, y cuadra con la práctica: el user agent es una cabecera que pone el propio cliente.
No he encontrado una transcripción del episodio, así que todo lo que atribuyo a Illyes pasa por el texto de Search Engine Roundtable.
La lógica del impostor es sencilla. Quien bloquea scrapers casi siempre deja una excepción para Googlebot, porque nadie quiere desaparecer de Google. Una regla del tipo “dejar pasar a Googlebot” sin comprobar la IP es, por tanto, una puerta abierta con un cartel encima. La propia ayuda de Search Console lo dice en otro contexto: dejar entrar a Googlebot sin iniciar sesión en una página protegida le quita, en la práctica, la seguridad, porque Googlebot se puede falsificar (Ayuda de Search Console, informe Estadísticas de rastreo).
¿Cómo encuentro en el registro de accesos las peticiones que dicen ser Googlebot?
Empieza por los números. En un servidor nginx con el formato de registro “combined” por defecto, este comando lista las IP que enviaron un user agent con Googlebot, de la más activa a la menos:
grep -i 'googlebot' /var/log/nginx/access.log | awk '{print $1}' | sort | uniq -c | sort -rn | head -20Con Apache, el archivo suele estar en /var/log/apache2/access.log (Debian, Ubuntu) o en /var/log/httpd/access_log (familia RHEL). En un hosting compartido no tienes acceso a esas carpetas, pero el panel permite descargar el registro en bruto: en cPanel se llama Raw Access, dentro de las métricas; en Plesk está en la herramienta de registros del dominio. El formato casi siempre es el mismo. Descarga al menos una semana, porque un solo día esconde patrones, y ejecuta los comandos en tu ordenador cambiando la ruta por el nombre del archivo.
Para ver qué pidió cada una de esas IP, imprime la dirección junto a la línea de la petición:
awk -F'"' 'tolower($6) ~ /googlebot/ {split($1,a," "); print a[1], $2}' /var/log/nginx/access.log | head -50Un ejemplo construido, con direcciones de documentación del RFC 5737 en lugar de tráfico real, muestra el patrón que buscas:
66.249.66.1 GET / HTTP/1.1
203.0.113.7 GET /wp-login.php HTTP/1.1
203.0.113.7 GET /?s=test HTTP/1.1
El Googlebot real rara vez tiene motivos para pedir wp-login.php, xmlrpc.php o una serie interminable de URL de la búsqueda interna. Un “Googlebot” que lo hace merece revisarse primero. En una tienda, otra pista es la misma IP pasando por todas las fichas de producto en pocos minutos, con y sin parámetros de filtro. El patrón de URL solo te dice por dónde empezar; lo que decide es la IP.
Zach Chahalis dice lo mismo en la guía de Moz sobre análisis de registros para la búsqueda con IA, publicada el 29 de octubre de 2026: el user agent no es más que el nombre que se pone quien hace la petición, los scrapers inflan las cifras y las reglas de seguridad pensadas para frenar bots falsos pueden frenar también a los reales (Moz, How To Analyze Server Logs for AI Search). Recomienda activar la verificación de bots al importar los registros, por ejemplo con la opción Verify Bots When Importing Logs del Log File Analyser de Screaming Frog, para que los impostores no lleguen nunca a tus gráficos.
¿Cómo compruebo una IP de Googlebot con host o dig?
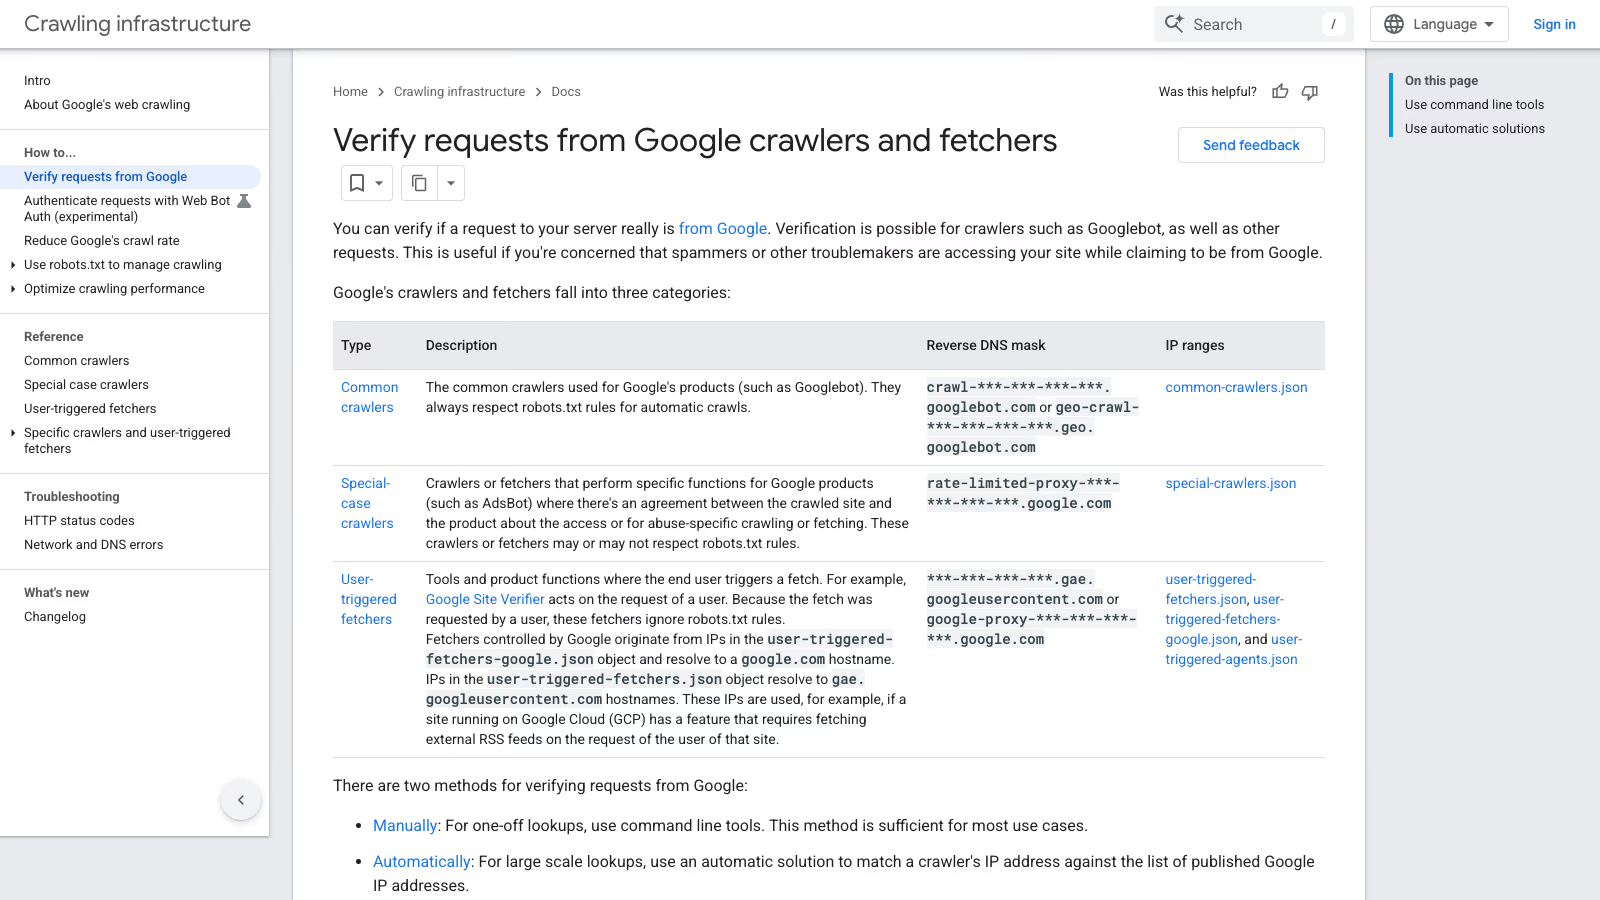
Google documenta una comprobación manual en cuatro pasos (Google Crawling Infrastructure, Verify requests from Google crawlers and fetchers):
- Hacer una consulta de DNS inverso de la IP del registro con el comando
host. - Comprobar que el nombre termina en
googlebot.com,google.comogoogleusercontent.com. - Hacer una consulta de DNS directa sobre ese nombre.
- Comprobar que devuelve la IP original.
Esto es lo que obtuve el 30 de octubre de 2026 con una de las direcciones de ejemplo de la propia Google:
$ host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.
$ host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
El paso directo no es opcional. Quien controla un bloque de IP puede poner en el DNS inverso el nombre que quiera, crawl-1-2-3-4.googlebot.com incluido. Lo que no puede es hacer que los servidores DNS de Google respondan a la consulta directa con su dirección. dig +short -x 66.249.66.1 y dig +short crawl-66-249-66-1.googlebot.com dan las mismas respuestas de forma más corta.
Si tienes más de un puñado de IP, mete la comprobación en un bucle. Este script acepta nombres de Google y de Bing; lo ejecuté el 30 de octubre de 2026 contra direcciones de Google, de Bing y dos que no son rastreadores:
#!/usr/bin/env bash
# Two-way DNS check for an IP that claims to be Googlebot or Bingbot.
# Usage: ./verify_dns.sh 66.249.66.1 [more IPs]
for ip in "$@"; do
  name=$(host "$ip" | awk '/domain name pointer/ {print $NF; exit}')
  name=${name%.}
  case "$name" in
    *.googlebot.com|*.google.com|*.googleusercontent.com|*.search.msn.com) ;;
    *) echo "$ip FAKE: PTR is '${name:-none}'"; continue ;;
  esac
  if host "$name" | grep -qwF -- "$ip"; then
    echo "$ip OK: $name"
  else
    echo "$ip FAKE: $name does not resolve back to $ip"
  fi
done
Resultado de ese día: 66.249.66.1 OK: crawl-66-249-66-1.googlebot.com, 157.55.39.1 OK: msnbot-157-55-39-1.search.msn.com y 8.8.8.8 FAKE: PTR is 'dns.google'. Tiene tres límites. El comando host viene en el paquete dnsutils en Debian y Ubuntu y en bind-utils en la familia RHEL. FAKE solo significa que la IP no es de Google ni de Bing, así que ejecuta el script con IP que se presentaron como rastreador, no con todo el registro. Y las direcciones IPv6 se pueden escribir de varias formas válidas, por lo que la comparación de texto puede fallar; para IPv6, usa el método de las listas de IP que explico más abajo.
¿Qué nombre de host corresponde a cada tipo de rastreador de Google?
Google divide su tráfico en tres grupos, cada uno con su patrón de nombre y su archivo de IP (Google, Verify requests):
| Grupo | Ejemplos | robots.txt | DNS inverso | Archivo de IP |
|---|---|---|---|---|
| Rastreadores comunes | Googlebot, Googlebot-Image, Google-InspectionTool | Siempre respetado en los rastreos automáticos | crawl-***-***-***-***.googlebot.com o geo-crawl-***-***-***-***.geo.googlebot.com | common-crawlers.json |
| Rastreadores especiales | AdsBot | Puede respetarse o no | rate-limited-proxy-***-***-***-***.google.com | special-crawlers.json |
| Peticiones iniciadas por usuarios | Google Site Verifier, Feedfetcher, Google-Agent | Ignorado, porque lo pidió una persona | ***-***-***-***.gae.googleusercontent.com o google-proxy-***-***-***-***.google.com | user-triggered-fetchers.json, user-triggered-fetchers-google.json, user-triggered-agents.json |
La tabla importa por una razón práctica: una petición con user agent de Googlebot debería venir de la primera fila. Si resuelve a gae.googleusercontent.com, ha pasado el segundo paso de la comprobación manual y aun así no es Googlebot. Google explica que las IP de user-triggered-fetchers.json resuelven a gae.googleusercontent.com y se usan, por ejemplo, cuando un sitio alojado en Google Cloud descarga un feed RSS externo a petición de uno de sus usuarios. Es una petición legítima, pero no es el rastreador del buscador.
¿Qué lista de IP de Google uso y qué pasó con googlebot.json?
Google publica cinco archivos JSON en formato CIDR en https://developers.google.com/static/crawling/ipranges/. El 30 de octubre de 2026 tenían estos prefijos (cambian, así que toma las cifras como una foto de ese día):
| Archivo | Prefijos a 30.10.2026 | Para qué sirve |
|---|---|---|
common-crawlers.json | 317 | Googlebot y los demás rastreadores comunes |
special-crawlers.json | 272 | AdsBot y otros rastreadores especiales |
user-triggered-fetchers.json | 1068 | Peticiones de usuarios de sitios en Google Cloud |
user-triggered-fetchers-google.json | 504 | Peticiones iniciadas por usuarios en servicios de la propia Google |
user-triggered-agents.json | 20 | Google-Agent y agentes parecidos |
Si escribiste un script hace unos años, seguramente descarga googlebot.json. El 30 de octubre de 2026, la dirección antigua https://developers.google.com/search/apis/ipranges/googlebot.json devolvía una redirección 301 a common-crawlers.json, mientras que https://developers.google.com/static/crawling/ipranges/googlebot.json devolvía 404. Un script que sigue redirecciones sigue funcionando; uno que se fijó en la ruta nueva, o que trata cualquier respuesta distinta de 200 como lista vacía, deja de funcionar. Revisa el tuyo. Una lista de permitidos vacía convierte “bloquear al Googlebot falso” en “bloquear a Googlebot”.
Para otros servicios de Google que puedan llamar a tu sitio (Apps Script, por ejemplo), Google remite a la lista general en https://www.gstatic.com/ipranges/goog.json.
Bing y OpenAI publican archivos con la misma estructura: un creationTime y una lista prefixes con entradas ipv4Prefix o ipv6Prefix. Por eso un solo script puede comprobarlos todos. Este usa solo la biblioteca estándar de Python:
#!/usr/bin/env python3
"""Check IPs against the crawler IP lists Google, Bing and OpenAI publish.

Usage: python3 verify_bot_ip.py 66.249.66.1 157.55.39.1 1.2.3.4
       awk '{print $1}' access.log | sort -u | python3 verify_bot_ip.py -
"""
import ipaddress
import json
import sys
import urllib.request

LISTS = {
    "google-common": "https://developers.google.com/static/crawling/ipranges/common-crawlers.json",
    "google-special": "https://developers.google.com/static/crawling/ipranges/special-crawlers.json",
    "google-user-fetchers": "https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers.json",
    "google-user-fetchers-google": "https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers-google.json",
    "google-user-agents": "https://developers.google.com/static/crawling/ipranges/user-triggered-agents.json",
    "bingbot": "https://www.bing.com/toolbox/bingbot.json",
    "openai-gptbot": "https://openai.com/gptbot.json",
    "openai-searchbot": "https://openai.com/searchbot.json",
    "openai-chatgpt-user": "https://openai.com/chatgpt-user.json",
}


def load(url):
    with urllib.request.urlopen(url, timeout=20) as r:
        data = json.load(r)
    return [
        ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix"))
        for p in data["prefixes"]
    ]


def main(args):
    ips = [l.strip() for l in sys.stdin] if args == ["-"] else args
    nets = {name: load(url) for name, url in LISTS.items()}
    for raw in filter(None, ips):
        try:
            ip = ipaddress.ip_address(raw)
        except ValueError:
            print(f"{raw}\tnot an IP")
            continue
        hits = [n for n, ranges in nets.items() if any(ip in net for net in ranges)]
        print(f"{ip}\t{', '.join(hits) or 'NOT IN ANY LIST'}")


if __name__ == "__main__":
    main(sys.argv[1:])
Pásale todas las IP que se presentaron como Googlebot:
grep -i 'googlebot' /var/log/nginx/access.log | awk '{print $1}' | sort -u | python3 verify_bot_ip.py -El 30 de octubre de 2026 respondió 66.249.66.1 google-common, 66.249.90.77 google-special, 157.55.39.1 bingbot y 8.8.8.8 NOT IN ANY LIST, y trató bien el IPv6 (2001:4860:4801:10::1 google-common). Descarga nueve archivos en cada ejecución, así que ejecútalo a mano o desde cron. Nunca lo llames en cada petición. En un hosting compartido sin Python, ejecútalo en tu ordenador sobre el registro descargado del panel: el resultado es el mismo.
¿Por qué una IP real de Googlebot a veces falla la comprobación del nombre?
Durante las pruebas ejecuté también el segundo ejemplo de Google, 35.247.243.240. La página de Google dice que resuelve a geo-crawl-35-247-243-240.geo.googlebot.com. El 30 de octubre de 2026, tanto el resolvedor de mi sistema como el 8.8.8.8 público de Google devolvieron 240.243.247.35.bc.googleusercontent.com. La dirección vecina, 35.247.243.241, devolvió el nombre documentado geo-crawl-35-247-243-241.geo.googlebot.com, y 35.247.243.240 está dentro de 35.247.243.240/28 en common-crawlers.json.
No sé por qué esa dirección tiene un registro PTR distinto, y es una sola observación. Una regla que acepte solo nombres *.googlebot.com habría rechazado una IP que Google lista como rastreador común. Una regla que acepte cualquier nombre en googleusercontent.com dejaría pasar peticiones iniciadas por usuarios que no son Googlebot. Para una petición con user agent de Googlebot, la prueba decisiva es estar en common-crawlers.json. Reserva el método DNS para comprobaciones puntuales, que es como lo presenta la propia Google: suficiente para consultas aisladas, con las listas de IP recomendadas para verificar a gran escala.
¿Cómo bloqueo al Googlebot falso en nginx?
El planteamiento: generar un archivo de inclusión a partir de common-crawlers.json, marcar las peticiones cuyo user agent contiene “googlebot” y devolver 403 solo cuando el user agent dice Googlebot y la IP no está en la lista. Primero, el generador:
#!/usr/bin/env python3
# Builds allow lists from Google's common-crawlers.json (Googlebot and friends).
# Usage: python3 make_googlebot_ranges.py nginx  > /etc/nginx/googlebot-ranges.conf
#        python3 make_googlebot_ranges.py apache > /etc/apache2/googlebot-ranges.conf
import json, sys, urllib.request

URL = "https://developers.google.com/static/crawling/ipranges/common-crawlers.json"
with urllib.request.urlopen(URL, timeout=20) as r:
    nets = [p.get("ipv4Prefix") or p.get("ipv6Prefix") for p in json.load(r)["prefixes"]]
if not nets:
    sys.exit("empty list from Google, refusing to write")

if sys.argv[1:] == ["nginx"]:
    print("\n".join(f"{n} 1;" for n in nets))
elif sys.argv[1:] == ["apache"]:
    for i in range(0, len(nets), 20):
        print("Require ip " + " ".join(nets[i:i + 20]))
else:
    sys.exit("usage: make_googlebot_ranges.py nginx|apache")
Después, la parte de nginx. Los bloques geo y map van en el contexto http; el if, en el bloque server de tu WordPress:
# http { ... }
geo $googlebot_ip {
    default 0;
    include /etc/nginx/googlebot-ranges.conf;
}
map $http_user_agent $claims_googlebot {
    default 0;
    ~*googlebot 1;
}
map "$claims_googlebot:$googlebot_ip" $fake_googlebot {
    default 0;
    "1:0"   1;
}

# server { ... }
if ($fake_googlebot) {
    return 403;
}
Probé exactamente este bloque: una petición normal del navegador recibió 200, una petición con user agent de Googlebot desde una IP ajena a Google recibió 403 y, después de añadir la dirección de la máquina de pruebas al archivo incluido, esa misma petición recibió 200. Repite este último paso en tu servidor con una IP real de Googlebot sacada de tus registros antes de fiarte de la regla.
Actualiza la lista desde cron escribiendo primero en un archivo temporal, para que una descarga fallida nunca deje a nginx con una inclusión vacía:
python3 make_googlebot_ranges.py nginx > /tmp/googlebot-ranges.conf \
  && mv /tmp/googlebot-ranges.conf /etc/nginx/googlebot-ranges.conf \
  && nginx -t && systemctl reload nginx
El generador y nginx -t están probados; la línea con mv y la recarga no las ejecuté en un servidor real. La trampa que vuelve la regla en tu contra es un proxy inverso delante de nginx. Detrás de Cloudflare, de un balanceador de carga o del proxy de tu proveedor, $remote_addr es la dirección del proxy y nunca la de Google, y todas las peticiones reales de Googlebot reciben 403. Configura primero el módulo realip (set_real_ip_from para cada rango del proxy y real_ip_header CF-Connecting-IP; en el caso de Cloudflare) y comprueba en el registro de accesos que ves IP de visitantes, no del proxy, antes de activar el bloqueo.
¿Cómo bloqueo al Googlebot falso en Apache o en el .htaccess?
Apache 2.4 hace lo mismo con mod_setenvif y mod_authz_host. En el virtual host o en un bloque <Directory>:
SetEnvIfNoCase User-Agent "googlebot" claims_googlebot
<RequireAny>
    <RequireAll>
        Require all granted
        Require not env claims_googlebot
    </RequireAll>
    Include /etc/apache2/googlebot-ranges.conf
</RequireAny>
La lógica se lee así: entra todo el que no dice ser Googlebot y, además, cualquiera que venga de una IP de la lista. Mi prueba dio lo mismo que en nginx: 200 para un navegador, 403 para un Googlebot falso y 200 para un user agent de Googlebot desde una dirección añadida al archivo incluido.
En un hosting compartido la regla va en el .htaccess, donde Include no está permitido. Ejecuta el generador de la sección de nginx con el argumento apache y pega las líneas Require ip que imprime (16 líneas el 30 de octubre de 2026) directamente dentro del bloque:
SetEnvIfNoCase User-Agent "googlebot" claims_googlebot
<RequireAny>
    <RequireAll>
        Require all granted
        Require not env claims_googlebot
    </RequireAll>
    # Paste the "Require ip ..." lines printed by
    # python3 make_googlebot_ranges.py apache
    # Without them every real Googlebot gets 403.
</RequireAny>
También probé esta variante de .htaccess, con los mismos tres resultados. Necesita que el hosting permita las directivas de tipo AuthConfig y FileInfo: solo con AuthConfig, mi servidor de pruebas respondió a todas las peticiones con un error 500 y registró SetEnvIfNoCase not allowed here. Abre la portada en el navegador justo después de subir el archivo. Y recuerda que la lista se queda congelada en el momento en que la pegas: apúntate una actualización mensual, o Google añadirá rangos nuevos que tu regla empezará a bloquear.
La trampa del proxy también vale aquí: detrás de Cloudflare hace falta mod_remoteip con RemoteIPHeader CF-Connecting-IP y los rangos de Cloudflare como proxies de confianza, o la regla bloquea al rastreador real. Muchos hostings compartidos usan LiteSpeed en lugar de Apache. LiteSpeed lee la mayoría de las directivas del .htaccess, pero no he probado este bloque en él, así que comprueba el resultado con un user agent falso desde tu propio ordenador antes de fiarte.
¿Cómo bloqueo al Googlebot falso en Cloudflare?
Si el sitio está detrás de Cloudflare, el borde de la red es mejor sitio para la regla, porque Cloudflare ya verifica los bots por ti, y es la única capa realista si tu hosting compartido no te deja tocar la configuración del servidor. El campo cf.client.bot indica si la petición procede de un bot o rastreador conocido y fiable (Cloudflare Docs, cf.client.bot). Cloudflare considera verificado un bot cuando se identifica con una firma Web Bot Auth, con una lista de IP publicada y un user agent estable, o por DNS inverso, y además se comporta dentro de límites razonables (Cloudflare Docs, Verified bots).
Una regla personalizada para Googlebots falsos:
(lower(http.user_agent) contains "googlebot" and not cf.client.bot)El lower() está ahí porque en el lenguaje de reglas de Cloudflare la comparación de texto distingue mayúsculas y minúsculas (Cloudflare Docs, Functions). El propio ejemplo de Cloudflare para este patrón combina un filtro por país con not cf.client.bot y un Managed Challenge (Cloudflare Docs, Allow traffic from search engine bots).
No he desplegado esta expresión en una zona en producción, así que tómala como punto de partida. Antes de elegir la acción de bloqueo, usa la expresión como filtro en Security Analytics o empieza con Managed Challenge, y confirma que no coincide ninguna petición desde una IP de common-crawlers.json. Si algún día Cloudflare no reconoce una petición real de Googlebot y tu regla dice bloquear, Google recibe un 403, y Google afirma que las URL indexadas que devuelven códigos 4xx distintos de 429 se eliminan del índice (Google, HTTP status codes).
Cloudflare expone también cf.verified_bot_category, un texto con la finalidad de un bot verificado. Valores antiguos como Search Engine Crawler y AI Crawler siguen funcionando en las reglas personalizadas. La referencia del campo no dice en qué planes está disponible, así que comprueba si tu editor de reglas lo ofrece antes de diseñar nada a su alrededor. Las reglas personalizadas se ejecutan antes que Super Bot Fight Mode (Cloudflare Docs, Challenge bad bots). Cómo se relacionan el Bot Fight Mode gratuito y las categorías de bots de IA con Googlebot lo explico en el artículo sobre Cloudflare.
¿Bloquean bien los plugins de seguridad de WordPress al Googlebot falso?
Algunos sí, si está elegida la opción correcta. Wordfence es un buen ejemplo porque su documentación explica las dos caras. En sus opciones de limitación de peticiones (rate limiting), el ajuste Verified Google crawlers have unlimited access to this site usa una consulta de DNS inverso, y un visitante que falsifica la cabecera de Googlebot no supera esa prueba de PTR. La alternativa, Anyone claiming to be Google has unlimited access, hace lo que dice: un Googlebot falso también obtiene acceso ilimitado (Wordfence Help, Rate limiting). Si usas la limitación de peticiones de Wordfence, mira cuál de las dos tienes marcada.
Para cualquier plugin o regla propia, tres preguntas separan lo fiable de lo arriesgado:
- ¿Comprueba la IP o solo el user agent? Una regla que bloquea o deja pasar solo por user agent es justo con lo que cuentan los impostores.
- ¿Usa una lista actual o una consulta DNS en vivo? Una lista de IP fija, copiada de un foro en 2019, no conoce los rangos nuevos de Google y acabará bloqueando al rastreador real.
- ¿Se ejecuta antes o después de la caché de páginas? Un plugin en PHP solo ve las peticiones que llegan a PHP. Si tu hosting o un plugin de caché sirven el HTML guardado directamente, un Googlebot falso que lee páginas en caché nunca se cruza con el plugin. Para proteger un catálogo frente al scraping eso pesa mucho; para la fuerza bruta contra
wp-login.phppesa menos, porque esa URL no se cachea.
Las reglas que “bloquean bots” con una lista de user agents en el .htaccess tienen el problema contrario: frenan a los rastreadores honestos que se identifican y dejan pasar a todos los que mienten. Cuando encuentro una de esas listas en un sitio que llevo dentro del mantenimiento de WordPress, la sustituyo por una regla basada en la IP o llevo la decisión a Cloudflare. Cuando la lógica de bloqueo tiene que vivir dentro de la aplicación, por ejemplo en un plugin a medida en un hosting sin acceso al servidor, eso ya es trabajo de desarrollo WordPress y usa la misma lista de IP como fuente.
¿Cómo compruebo Bingbot y los rastreadores de OpenAI?
Bingbot. El método de Microsoft es la misma comprobación DNS en los dos sentidos: el DNS inverso debe terminar en search.msn.com y la consulta directa de ese nombre debe devolver la misma IP (Bing Webmaster Blog, How to Verify that Bingbot is Bingbot). El 30 de octubre de 2026:
$ host 157.55.39.1
1.39.55.157.in-addr.arpa domain name pointer msnbot-157-55-39-1.search.msn.com.
$ host msnbot-157-55-39-1.search.msn.com
msnbot-157-55-39-1.search.msn.com has address 157.55.39.1
Bing ofrece además una herramienta pública de verificación en bing.com/toolbox/verify-bingbot, y la misma dentro de Bing Webmaster Tools. Su lista de IP, bing.com/toolbox/bingbot.json, tenía un creationTime del 3 de enero de 2024 cuando la descargué, con 28 prefijos. Una lista que no se regenera desde hace casi tres años puede seguir siendo correcta, pero yo no montaría un bloqueo rígido sobre ella. Por eso las reglas de nginx y Apache de arriba solo cubren a Googlebot. Para Bing, comprueba primero las IP de tu registro con el script DNS y decide después.
OpenAI. OpenAI documenta cuatro rastreadores, cada uno con su archivo de IP (OpenAI, Overview of OpenAI crawlers):
| User agent | Para qué sirve | Lista de IP |
|---|---|---|
OAI-SearchBot | Muestra sitios en las respuestas de búsqueda de ChatGPT | openai.com/searchbot.json |
GPTBot | Rastrea contenido que puede usarse para entrenar modelos | openai.com/gptbot.json |
ChatGPT-User | Descarga una página cuando lo pide un usuario; OpenAI dice que las reglas de robots.txt pueden no aplicarse | openai.com/chatgpt-user.json |
OAI-AdsBot | Revisa las páginas de destino de anuncios en ChatGPT | openai.com/adsbot.json |
El script de Python de arriba ya comprueba las tres primeras listas. El mismo patrón de nginx sirve para ellas si lo quieres: una inclusión geo aparte, generada a partir del archivo correcto, y una coincidencia de user agent con el nombre correcto.
¿Qué no debo bloquear nunca al limpiar el tráfico de bots?
Una limpieza demasiado agresiva puede costar más que los propios impostores, porque los rastreadores reales pierden el acceso. Deja estos fuera de cualquier regla de bloqueo:
- Google-Extended. Es un token de robots.txt, no un rastreador. Google dice que no tiene user agent propio: el rastreo se hace con los user agents habituales de Google y el token solo controla si el contenido puede usarse para entrenar a Gemini y para la fundamentación (grounding) de sus respuestas. Según Google, no afecta a la inclusión del sitio en la Búsqueda de Google (Google, common crawlers). Una regla de servidor que busque Google-Extended en el user agent solo puede atrapar impostores. Si quieres salir del entrenamiento de Gemini, la herramienta es una línea Disallow en robots.txt, que comparé con los demás interruptores de Google en los controles de IA de Google.
- Peticiones iniciadas por usuarios. Google Site Verifier descarga tu token de verificación de Search Console, Feedfetcher lee tu feed RSS, Google Read Aloud lee páginas en voz alta a los usuarios y GoogleMessages genera vistas previas de enlaces. Ignoran robots.txt por diseño, porque los ha pedido una persona (Google, user-triggered fetchers). Si los bloqueas, rompes la verificación y las vistas previas, no el rastreo.
- Google-InspectionTool. Lo usan la inspección de URL de Search Console y la prueba de resultados enriquecidos. Sus IP están en la lista de rastreadores comunes; su user agent no contiene “Googlebot”, así que las reglas de arriba no lo tocan.
- Google-Agent. Lo usan los agentes de Google que actúan a petición de un usuario, con IP de
user-triggered-agents.json. Google está experimentando con Web Bot Auth en parte de estas peticiones, con la identidadhttps://agent.bot.goog. Su propia documentación dice que no firma todas las peticiones y que la verificación debe recurrir a la IP, al DNS inverso y al user agent (Google, Web Bot Auth). Las peticiones firmadas llevan la cabeceraSignature-Agent: g="https://agent.bot.goog"y se verifican con las claves deagent.bot.goog/.well-known/http-message-signatures-directory, según el RFC 9421. Para un WordPress, la respuesta práctica es dejar esa verificación a tu CDN si la soporta, y no bloquear lo que todavía no sabe verificar.
robots.txt ni siquiera entra en la lista de herramientas contra impostores. Illyes, en el resumen de Search Engine Roundtable, lo describió como una sugerencia y no como una restricción que se pueda imponer. Los rastreadores honestos lo leen; un Googlebot falso lo ignora, o lee la sección de Googlebot y la toma como permiso.
¿Bloquear Googlebots falsos cambia las estadísticas de rastreo de Search Console?
No debería, y eso convierte el informe en un buen control. El informe Estadísticas de rastreo muestra el historial de rastreo de Google en tu sitio (Ayuda de Search Console, informe Estadísticas de rastreo). Las peticiones de los impostores nunca aparecen en él, porque no las hizo Google. Google añade que el informe recoge la mayoría de las peticiones de rastreo, pero puede no contarlas todas, así que pequeñas diferencias con tus registros son normales.
De ahí sale una comprobación aproximada. Si tu registro muestra muchas más peticiones “Googlebot” que Estadísticas de rastreo para los mismos días, el excedente es candidato a suplantación, y el script de IP te lo confirma. Esa lectura es mía, no de Google. El caso contrario tiene explicación oficial: si Estadísticas de rastreo muestra mucho más que tus registros, Google dice que puede pasar cuando robots.txt estuvo inaccesible demasiado tiempo y Google contó los rastreos que habría hecho.
Después de activar un bloqueo, vigila dos cosas en Estadísticas de rastreo durante una o dos semanas. El total de peticiones debería mantenerse, y el desglose por respuesta no debería mostrar 403 nuevos. Una subida de respuestas 403 justo después de cambiar una regla significa que la regla está alcanzando al Googlebot real. Google también deja claro que 401 y 403 no sirven para limitar la frecuencia de rastreo (Google, HTTP status codes). Si el problema de carga viene del rastreo real, un 429 o un 503 hacen que Google frene temporalmente sin perder URL.
Solución de problemas: ¿qué significa cada resultado?
| Lo que ves | Qué significa | Qué hacer |
|---|---|---|
| User agent de Googlebot, IP fuera de todas las listas, PTR ausente o ajeno | Impostor | Bloquear en el borde o en el servidor; sin riesgo SEO |
El PTR termina en googlebot.com, la consulta directa devuelve otra IP | Alguien configuró un PTR falso | Tratarlo como falso; para eso existe el paso directo |
User agent de Googlebot, PTR en gae.googleusercontent.com | Petición iniciada por un usuario, no el rastreador del buscador | Comprobar en user-triggered-fetchers.json; no contarla como Googlebot |
IP en common-crawlers.json, PTR fuera del patrón documentado | Rastreador real de Google con un PTR raro (vi uno el 30.10.2026) | Fiarse de la lista |
| El registro muestra muchas más visitas de Googlebot que Estadísticas de rastreo | Probablemente hay impostores en el registro | Pasar el script de IP por esas direcciones |
| Estadísticas de rastreo muestra muchas más peticiones que el registro | Según Google, robots.txt estuvo inaccesible demasiado tiempo | Revisar el estado de robots.txt en Search Console |
| Suben las respuestas 403 en Estadísticas de rastreo tras una regla nueva | La regla alcanza al Googlebot real | Revisar la IP del proxy, la actualidad de la lista y el orden de las reglas |
Error 500 en todo el sitio nada más subir el .htaccess | El hosting no permite FileInfo en el .htaccess | Restaurar el archivo anterior y llevar la regla a Cloudflare |
| Tu propio rastreador SEO, configurado con user agent de Googlebot, recibe 403 | La regla funciona: tu IP no es de Google | Usar otro user agent en las auditorías o permitir tu IP |
| La regla no bloquea nada, ni siquiera un falso evidente | El servidor ve la IP del proxy, o la caché respondió antes | Corregir realip o remoteip, o llevar la regla a la CDN |
Lista de comprobación para un sitio WordPress
- Cuenta las IP que se presentaron como Googlebot en la última semana de registros de acceso.
- Pasa el script de IP por ellas y anota cuántas salen como
NOT IN ANY LIST. - Compara el total del registro con Estadísticas de rastreo para los mismos días.
- Si bloqueas, hazlo por IP más user agent, nunca solo por user agent.
- Detrás de un proxy o CDN, confirma que el servidor registra las IP de los visitantes antes de activar cualquier regla por IP.
- Genera las listas de permitidos a partir de
common-crawlers.jsony actualízalas con una protección contra descargas vacías; en el.htaccess, apúntate una actualización manual cada mes. - Deja Google-Extended, las peticiones iniciadas por usuarios, Google-InspectionTool y Google-Agent fuera de las reglas de bloqueo.
- Vigila las respuestas 403 en Estadísticas de rastreo durante dos semanas después de cada cambio.
Si tus registros muestran mucho tráfico de impostores contra wp-login.php y xmlrpc.php, el Googlebot falso suele ser el menor de los problemas del servidor. Una auditoría de seguridad de WordPress parte de esos mismos registros de acceso y analiza qué intentaban hacer esas peticiones.