Introducción
Tu sitio posiciona en Google. Los Core Web Vitals están en verde. El schema valida. Y aun así, cuando alguien pregunta a ChatGPT, Claude, Perplexity o Google AI Overviews sobre tu sector, tu marca no aparece. Ese hueco entre el SEO clásico y lo que las búsquedas con AI realmente citan es el problema que existe para resolver la Generative Engine Optimization.
GEO no sustituye al SEO. Es una disciplina paralela, centrada en cómo los grandes modelos de lenguaje recuperan, interpretan y citan contenido, no en cómo los crawlers de búsqueda lo indexan y ordenan. Las técnicas se solapan en algunos puntos y divergen en otros, y el campo avanza más rápido que cualquier norma publicada. Esta guía recoge lo que funciona en la práctica, lo que es mito y el orden en el que un equipo de ingeniería solvente debería abordar cada palanca.
Por qué importa la visibilidad en LLMs en 2026
En el primer trimestre de 2026, el tráfico mediado por AI es una fracción medible y creciente de los accesos cualificados en la mayoría de sitios con contenido relevante. ChatGPT Search está integrado en la barra de direcciónes de Safari en iOS para quienes tienen la app instalada. Perplexity ha pasado de herramienta para power users a producto mainstream. Claude lee la web abierta a través de su herramienta de búsqueda. Google AI Overviews aparece en una gran parte de las búsquedas informativas en mercados anglófonos y se extiende a más idiomas cada trimestre.
La consecuencia económica es directa. Incluso cuando un prospecto acaba comprando, registrándose o reservando consulta por búsqueda clásica, su lista corta fue filtrada antes por un LLM. Si no entras en esa lista, no compites. El SEO clásico sigue importando porque alimenta la misma infraestructura de crawling que usan muchos sistemas de AI. Pero el SEO solo ya no basta.
¿Qué diferencia hay entre la búsqueda con IA y un LLM?
Ambos términos se usan en la práctica y la coherencia importa más que la elección. “Búsqueda con AI” es el término más amplio y orientado al usuario. Cubre chatbots, herramientas de RAG, AI Overviews y sistemas híbridos. “LLM” se refiere específicamente a los modelos de lenguaje que hay detrás. En esta guía usamos “AI” para la superficie de descubrimiento y “LLM” para la tecnología que la mueve. El objetivo de optimización es el mismo.
Lista de crawlers de IA y user agents en 2026
Antes de tocar código, sabe a quién estás optimizando. A abril de 2026, los principales user agents son:
GPTBot, OpenAI, entrenamiento y retrieval offline.OAI-SearchBot, búsqueda en vivo de ChatGPT.ChatGPT-User, peticiones bajo demanda disparadas por un prompt.ClaudeBotyClaude-User, Anthropic.PerplexityBotyPerplexity-User, Perplexity AI.Google-Extended, control de opt-out para el entrenamiento de Gemini.CCBot, Common Crawl, alimenta a muchos LLMs menores.Applebot-Extended, opt-out para el entrenamiento de Apple Intelligence.Bytespider, ByteDance.Meta-ExternalAgent, Meta AI.
Ninguno ejecuta JavaScript. Todos respetan robots.txt. La mayoría se identifican con honestidad. Una parte recoge contenido en el instante en que el usuario envía el prompt, lo que reduce el ciclo de días a segundos.
¿Qué técnicas GEO no funcionan?
El espacio GEO está lleno de folklore. La mayor parte carece de respaldo empírico.
Meta tags personalizados como <meta name="ai-content-url"> o <meta name="llms"> no tienen implementación conocida en ningún producto LLM en producción. Archivos como /.well-known/ai.txt y /ai.txt tienen propuestas competidoras y cero adopción. Los comentarios HTML dirigidos a bots son eliminados por todos los crawlers mainstream antes del procesamiento. Los conmutadores humano-o-AI exigen un clic, y los bots no hacen clic. El sniffing de user agent para servir contenido distinto a los LLMs vulnera la política de cloaking de Google y puede disparar acciones manuales. Las páginas dedicadas a AI no muestran trato diferenciado en citas. El JSON-LD y Schema.org puros los lee Microsoft Copilot a través de Bing y siguen influyendo en el SEO clásico, pero pruebas controladas muestran que ChatGPT, Claude y Perplexity ignoran en gran medida los datos estructurados al sintetizar respuestas.
El patrón se repite siempre. Alguien propone una especificación, escribe un post, y otros posts lo citan. Antes de adoptar una técnica GEO, pregúntate si hay prueba de consumo real o solo prueba de que la propuesta existe.
Siguen funcionando las listas autopromocionales de los mejores en AI Overviews
El artículo “Las 10 mejores herramientas para X”, en el que el editor se pone a sí mismo en primer lugar, fue la táctica GEO más barata de 2025. Está perdiendo fuerza. En su actualización del 4 de octubre de 2026, Lily Ray repitió su análisis con 100 búsquedas en inglés sobre el mejor software B2B. Frente a junio, los AI Overviews de Google citan ahora un 38% menos de listas autopromocionales de “los mejores” y dejan a la marca que las publica fuera de la recomendación “el 83% de las veces, frente al 69% de junio” (Lily Ray, traducción propia).
Ray cuenta también, citando el resumen de John Campbell del Search Central Live de Barcelona, que Gary Illyes dijo que el contenido producido a escala se está convirtiendo en un problema mayor que el spam de enlaces. Añade que en un Search Central Live anterior, en mayo, Illyes habría comparado comprar menciones con comprar enlaces.
Aun así, ha surgido un mercado. Ray enumera colocaciones pagadas en listas ajenas, con precio según el Domain Rating del sitio y a menudo desde unos 135 a 250 USD cada una, y paquetes de “menciones de marca en IA”, por ejemplo 5 menciones por 1500 USD. Son precios de mercado de terceros citados en su artículo, no tarifas nuestras, y no vendemos ni recomendamos estos servicios. Si trabajas el mercado español, ten presente que la advertencia sobre el contenido a escala salió de una conferencia de Google en Barcelona. Si la comparación de Illyes se mantiene, una mención comprada conlleva el mismo riesgo que un enlace comprado.
Por qué la IA y otros sitios citan estadísticas inventadas
Metehan Yesilyurt, de Peec AI, llevó al absurdo la idea de publicar estadísticas para que te citen (7 de octubre de 2026). Compró un dominio nuevo y generó en un solo día, con GPT-4.1, 50 000 páginas de estadísticas por unos 30 USD; con 15 000 listicles añadidos después, el experimento costó unos 50 USD en total. Él mismo escribe: “Todas y cada una eran falsas” (Peec AI, traducción propia). El sitio consiguió más de 330 dominios de referencia, entre ellos Shopify, Bluehost y DHL. En los últimos 30 días recibió más de 600 000 peticiones de bots, unas 72 000 de ellas de ChatGPT-User. Dos actualizaciones de Google justo después del lanzamiento hundieron su visibilidad en Google, pero el 7 de octubre seguía segundo en visibilidad en los prompts que seguía, solo por detrás de Statista.
Hay dos consecuencias. Un número repetido por ChatGPT y por una marca conocida no lo ha verificado ninguno de los dos. Antes de citar una estadística, sigue su rastro hasta el estudio original, su método y su muestra, y descártala si el rastro acaba en un sitio sin metodología. Y no copies la táctica: la visibilidad en Google no sobrevivió a dos actualizaciones, y cada persona que repite un número inventado lo difunde más. La palanca de las “estadísticas verificables” que verás más abajo solo funciona cuando las estadísticas son reales.
Cómo hacer visible tu sitio para la IA
Ordenadas por impacto para un sitio de contenido típico.
1. Audita primero el robots.txt
Ninguna otra cosa funciona si estás bloqueando a los crawlers sin querer. Muchos sitios heredaron reglas disallow agresivas del pánico de 2023 sobre entrenamiento de AI. Decidir a quién permites y a quién bloqueas es tu decisión, pero debe ser explícita. Una base razonable para un negocio que quiere visibilidad en AI:
User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: CCBot
Allow: /
Si quieres visibilidad en ChatGPT sin que tu contenido sirva para entrenar modelos, permite OAI-SearchBot y ChatGPT-User y bloquea GPTBot. OpenAI documenta está separación. Apple, Google y Anthropic ofrecen controles equivalentes.
2. Sirve hermanos Markdown para cada página
El cambio técnico con mayor palanca de la lista. Expón una versión Markdown limpia de cada página en la misma URL con .md añadido, por ejemplo /blog/post y /blog/post.md. La versión Markdown elimina navegación, pies, scripts de analítica, banners de cookies y todo lo que infla tokens sin aportar información.
Mediciones independientes en varios sitios de contenido muestran de forma consistente reducciones de tokens del 70 al 85 por ciento cuando el Markdown sustituye al HTML renderizado. Un post de 15.000 tokens cae típicamente a 3.000. Importa porque, cuando un LLM descarga tu página para responder a un prompt, tiene un presupuesto de contexto finito. El contenido más pequeño y limpio cabe más íntegro y se cita con más fidelidad.
En Astro, Next.js o cualquier framework static-first, generar endpoints .md desde la misma content collection que alimenta la vista HTML es una mañana de trabajo. El Markdown debe incluir título, fecha de publicación, autor, un resumen breve, el cuerpo y las fuentes claramente marcadas.
3. Anuncia la versión Markdown
Un crawler de LLM que aterriza en tu HTML necesita descubrir que existe un hermano Markdown. Dos mecanismos complementarios cubren las dos clases de clientes.
En la head del HTML:
<link rel="alternate" type="text/markdown" href="/blog/post.md" />En la cabecera de respuesta HTTP:
Link: </blog/post.md>; rel="alternate"; type="text/markdown"La etiqueta HTML llega a parsers que leen el DOM. La cabecera HTTP llega a agentes headless que hacen HEAD o GET y no parsean markup. Coste: una línea en el layout y una entrada en la configuración de cabeceras del CDN. Beneficio: los crawlers dejan de adivinar tu patrón de URL.
4. Negociación de contenido en Accept: text/markdown
La negociación de contenido HTTP está en el estándar desde 1997. Cuando un cliente envía Accept: text/markdown, devuelve la representación Markdown desde la misma URL. Emparéjalo con Vary: Accept para que los CDNs cacheen cada representación correctamente. Claude Code, Cursor y varios agentes de investigación ya envían está cabecera por defecto. La negociación de contenido es el estándar de largo plazo más probable porque no exige nuevas especificaciones y reutiliza la pila HTTP existente. En Cloudflare Workers la implementación cabe en menos de veinte líneas.
5. Publica llms.txt y llms-full.txt
Dos archivos en la raíz del sitio hacen el trabajo.
/llms.txt es un índice Markdown curado. Lista las páginas más importantes agrupadas por tema con descripciones de una línea. Piénsalo como un README para un LLM al que le preguntaron por tu sitio.
/llms-full.txt concatena el contenido Markdown completo de tus páginas clave en un solo archivo. La analítica de varios editores muestra que recibe bastante más tráfico de LLM que el índice corto. Genera los dos en tiempo de build desde la misma content collection que ya mantienes y regenera en cada despliegue. Ningún gran proveedor de LLM se ha comprometido formalmente a leer estos archivos, pero aparecen en los logs con frecuencia suficiente para justificar el tiempo.
6. Invierte en la calidad del contenido visible
La mayor palanca y la más olvidada. Los LLMs sintetizan respuestas ponderando frases candidatas de páginas que recuperan. Las frases con información concreta y atribuible pesan más que las afirmaciones vagas. “Los estudios muestran que la visibilidad en AI importa” es casi inútil. “Pruebas independientes en 2026 encontraron que las citas directas de expertos nombrados elevan la tasa de cita alrededor del 43 por ciento” es lo que se cita.
Tres movimientos elevan de forma consistente la tasa de cita en contenido antes poco citado:
- Citas directas de expertos nombrados.
- Estadísticas verificables con fuente claramente atribuida.
- Enlaces salientes autoritativos a fuentes primarias.
Los tres son señales de contenido visibles. Ninguno está oculto. Para una agencia WordPress, una empresa SaaS o cualquier negocio con experiencia sectorial, la traducción práctica es: deja de escribir listados genéricos y empieza a escribir artículos que nombran versiones, fechas, personas y números concretos. Cita fuentes en el texto. Cita a tu equipo por nombre. Incluye el año y la versión de cada herramienta que menciones. Es buen periodismo y es GEO.
Checklist de SEO y GEO para 2026
Rastreabilidad e indexación:
- El robots.txt permite tanto a crawlers clásicos como a los user agents de AI en los que quieras ser visible.
- Sitemap XML fresco y enviado a Google Search Console y Bing Webmaster Tools.
- Enlazado interno con estructura temática clara. Hub y spoke o mapas temáticos.
- Etiquetas canonical correctas en URLs duplicados o parametrizados.
On-page, sigue importando para personas y para el retrieval del LLM:
- Títulos y H1 descriptivos y alineados con la intención, en sentence case.
- Un H1 por página, jerarquía lógica de H2 y H3.
- Meta descripciones escritas para personas, sin keyword stuffing.
- Tipos Schema.org que encajen con el contenido, incluidos Article, FAQPage, Product, Organization, Person y HowTo.
- Alt de imagen describiendo la imagen, no la palabra clave.
Core Web Vitals. Los crawlers de AI no ejecutan JavaScript, pero la búsqueda clásica sí:
- LCP por debajo de 2,5 segundos en móvil.
- CLS por debajo de 0,1.
- INP por debajo de 200 milisegundos.
Específico de GEO:
- Endpoints Markdown para cada página de contenido.
<link rel="alternate" type="text/markdown">en cada layout.- Cabecera HTTP
Link:a nivel de CDN. - Negociación de contenido en
Accept: text/markdown. /llms.txty/llms-full.txten la raíz, regenerados en cada despliegue.- Citas, fragmentos y estadísticas visibles en el propio contenido.
- Entidades nombradas, incluidas personas, productos, empresas, versiones y fechas, usadas de forma consistente.
Medición:
- Logging server-side de User-Agent y Referer en el edge.
- Un dashboard que segmente el tráfico de crawlers de AI frente al humano y al de búsqueda clásica.
- Prompts de prueba mensuales en ChatGPT, Claude, Perplexity y Gemini para seguir menciones de marca.
¿En qué orden implementar GEO?
Para un sitio que no tiene nada de esto, trabaja en este orden. Cada paso aporta por sí solo.
- Auditar y corregir el robots.txt. Sin esto nada funciona.
- Añadir
<link rel="alternate" type="text/markdown">apuntando al futuro endpoint Markdown. Puede desplegarse antes de que el endpoint exista. - Construir la pipeline de renderizado Markdown. Empieza por el tipo de contenido con más tráfico y amplía.
- Añadir la cabecera de respuesta
Link:y negociación de contenido enAccept: text/markdownen el CDN. - Generar
/llms.txty/llms-full.txtdesde la content collection en tiempo de build. - Reescribir los artículos bandera con entidades nombradas, citas directas y estadísticas con fuente. Trabajo editorial continuo y con mayor impacto a largo plazo.
- Instrumentar analítica server-side para el tráfico de crawlers de AI.
Los pasos uno a cinco son ingeniería pura y caben en un sprint. El paso seis es editorial y compone a lo largo de trimestres. El paso siete te dice si algo de esto funciónó.
Cómo medir la visibilidad en AI
La analítica tradicional no ve la mayor parte del tráfico de crawlers de AI. Al no ejecutar JavaScript, GA4 y Plausible se los pierden. Necesitas logging server-side.
Captura en el edge: User-Agent completo, cabecera Referer, ruta solicitada, status HTTP devuelto y tamaño de respuesta. Segmenta por patrones de user agent como GPTBot, ClaudeBot, PerplexityBot, OAI-SearchBot, Bytespider, CCBot, Applebot-Extended y Google-Extended para construir un dashboard semanal.
Complementa con tracking de menciones de marca. Una vez por semana, ejecuta un conjunto fijo de prompts en ChatGPT, Claude, Perplexity y Gemini y registra si se cita tu marca, en qué posición y con qué fragmento. Herramientas como Profound, Peec AI y Otterly automatizan ese trabajo. Una hoja de cálculo disciplinada cumple la misma función.
Si un crawler descarga tu endpoint Markdown pero tu marca nunca aparece en el set de citas, el contenido es alcanzable pero no competitivo. Vuelve a la palanca editorial.
Cómo distinguir una mención de marca de una recomendación en IA
Un recuento de menciones solo responde si la marca apareció. No dice si la respuesta envió al lector hacia ti. El artículo de Seer sobre KPI de visibilidad en AI describe el caso malo:
“En la búsqueda con IA es totalmente posible aparecer y ser ANTI-recomendado.”
Seer Interactive, AI visibility KPIs, traducción propia
En español: puedes aparecer y que te desaconsejen de forma explícita. El ejemplo es una respuesta de ChatGPT que decía mirar más allá de dos marcas conocidas de alquiler. Las dos eran visibles y ninguna fue recomendada. La base son anécdotas, no un conjunto de datos, así que es un aviso sobre la métrica y no una tasa medida.
Por eso conviene registrar dos columnas por prompt: citada y recomendada, con una nota cuando la respuesta desvía al lector.
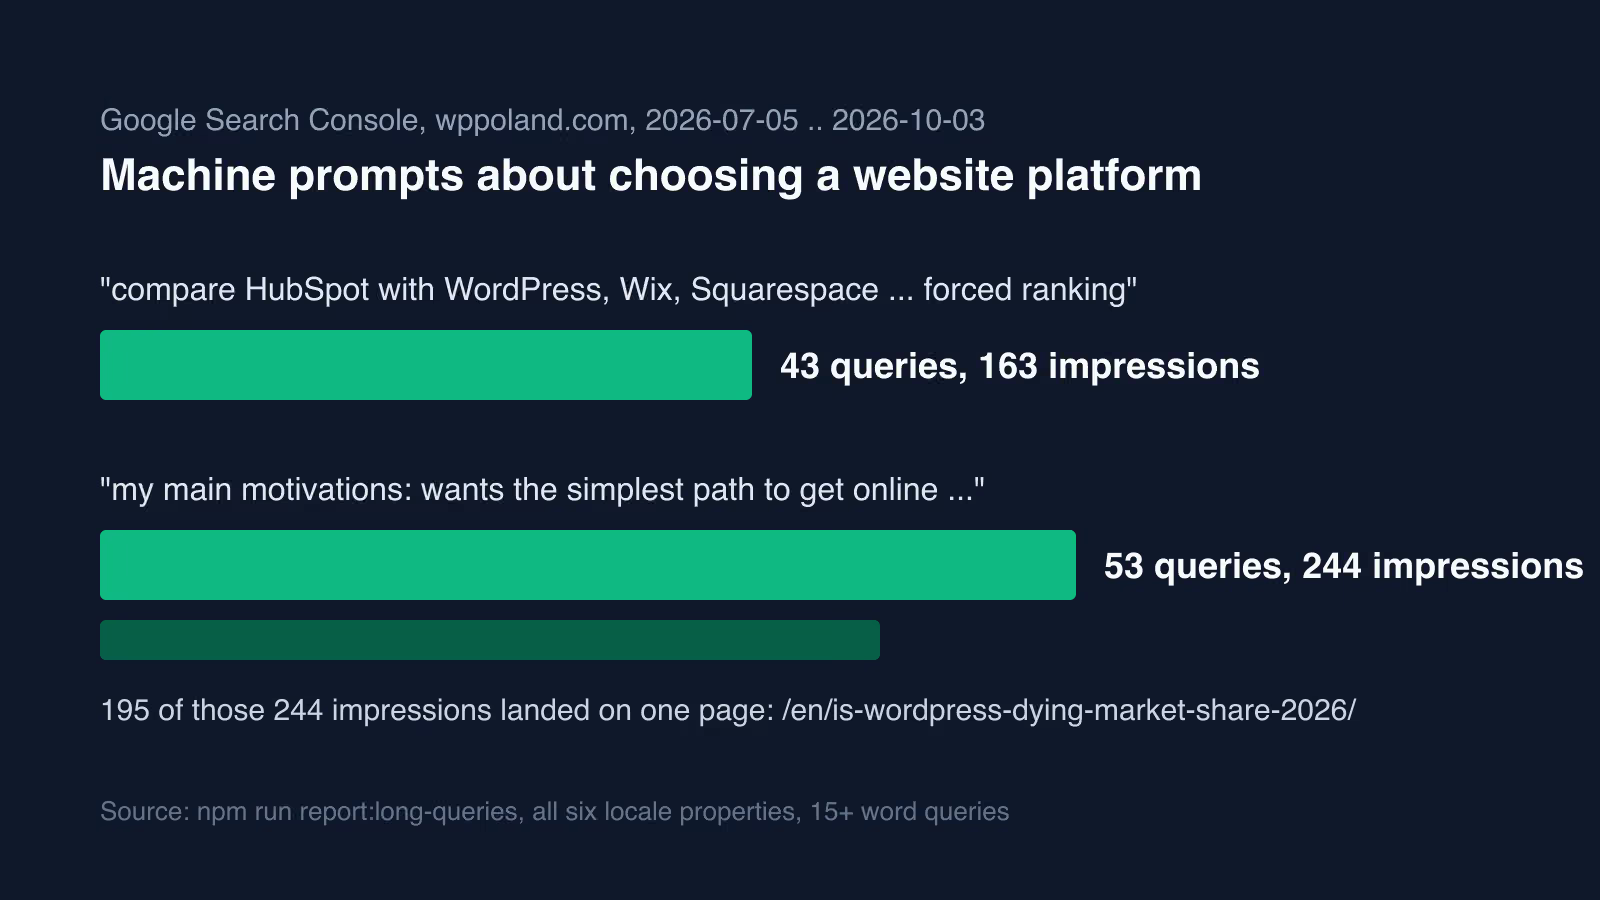
Nuestros números muestran por qué una columna engaña. En la prueba de Geoboard con prompts polacos de intención de compra, wppoland.com tuvo 47 % de menciones y 0 % de autoridad: presente, nunca primero. La consulta de identidad (“quién atiende a empresas extranjeras que necesitan WordPress”) sí nos citó en 5 de 6 modelos, pero las transaccionales dieron cero. El 5 de octubre de 2026 lanzamos 24 prompts de dolor con 60 ejecuciones por modelo, 2.878 respuestas de gpt-4o-mini y gemini-2.5-flash-lite. Ninguna mencionó wppoland. Ante “a quién contratar”, los modelos señalaron marketplaces como freelancer.com, no empresas. Ambas pruebas consultan los modelos sin búsqueda en vivo: miden la memoria del modelo, no lo que encuentra ChatGPT con navegación.
¿Qué son las consultas fan-out y de grounding?
El resumen de SearchPilot, asistido por AI, de un webinar con Cyrus Shepard no es una transcripción. Se apoya en su revisión de 54 estudios sobre citas en AI y separa dos tipos de búsqueda. Las consultas fan-out investigan la petición: un prompt puede lanzar muchas búsquedas de fondo. Las de grounding validan una afirmación que el sistema ya quiere hacer. Según el resumen, muchas citas visibles salen de la fase de grounding. Una web puede influir en la investigación sin ser citada, o ser citada por validar un dato sin influir en la recomendación.
Tampoco las verás en tus informes. La crónica de ROAST sobre Google Search Central Live en Barcelona lo dice sin rodeos:
“Las consultas fan-out de Google no aparecen en Search Console, ya que no proceden de usuarios.”
ROAST, Google Search Central Live Deep Dive Barcelona, day 3 recap, traducción propia
Qué métricas de visibilidad en IA medir
- Repite cada prompt. Seer propone ejecutar los diez prompts principales 10, 20 o 30 veces al mes y llama al resultado métrica de impulso, “no un KPI final que pones en el panel de la dirección” (Seer Interactive, traducción propia).
- Mira el tráfico de Google junto al de LLM. El resumen de SearchPilot describe una prueba de Omio en la que un resumen estructurado al inicio de la página subió el tráfico de LLM mientras Google orgánico iba en sentido contrario.
Preguntas sobre Markdown, bloqueo de crawlers y resultados
¿Servir Markdown va a canibalizar mi tráfico SEO? No. Google indexa el HTML canónico. El hermano Markdown se anuncia como representación rel="alternate", lo que le dice a Google que no lo trate como duplicado.
¿Esto se va a abusar? Los LLMs evalúan candidatos a fuente por señales de confianza percibida, no por formato de archivo. Publicar Markdown no convierte contenido flojo en citable. La inversión protege del riesgo de ser ilegible, sin garantizar el retorno de ser citado.
¿Debo bloquear los crawlers de AI? Es una decisión de negocio. Si vives del tráfico directo, bloquear entrenamiento y permitir retrieval es un punto intermedio razonable. Si vives de la descubribilidad, no bloquees nada.
¿Cuánto tardan los resultados? La capa de ingeniería actúa en días, tan pronto como los crawlers vuelven a pasar. La capa editorial compone a lo largo de trimestres. Espera cambios medibles en las citas de AI entre cuatro y ocho semanas tras desplegar ambas capas a la vez.
Cómo seguir las citas de IA de tu propio sitio
Todo lo anterior asume que hay que adivinar si toda esta instalación funciona de verdad. No hay que adivinar. Hicimos correr wppoland.com como sujeto de prueba durante todo un trimestre y publicamos el método bruto, no solo la conclusión.
Cómo seguimos las citas de IA de wppoland.com durante 90 días es el registro de ese experimento: captura de User-Agent en el edge, un conjunto fijo de prompts semanales en cuatro asistentes, y la curva de citas semana a semana. Es la implementación de referencia del paso siete del orden pragmático de arriba, hecha sobre nuestra propia infraestructura en lugar de descrita en abstracto.
Monitoreo de citaciones de IA: qué seguir y con qué frecuencia convierte ese experimento puntual en una cadencia repetible. Fija qué campos registrar en el edge, con qué frecuencia relanzar el conjunto de prompts sin quemar el presupuesto de un trimestre en ruido, y el umbral a partir del cual una caída en las citas es señal y no varianza normal semana a semana.
Por qué Perplexity cita tu marca y ChatGPT no explica la división que aparece primero en cuanto empiezas a medir: la misma página se cita con fiabilidad en un asistente y nunca en otro, por razones estructurales que no tienen nada que ver con la calidad del contenido. Perplexity y ChatGPT no siempre distinguen entre español de España y español latinoamericano al citar, así que conviene revisar el conjunto de prompts con variantes regionales del idioma antes de sacar conclusiones sobre tu mercado. Saber qué asistente premia qué señal cambia dónde inviertes la hora editorial del paso seis.
Lee estos tres juntos antes de construir un dashboard desde cero. El patrón de ingeniería ya está hecho. La pregunta abierta es qué dicen tus propios registros sobre tu propio dominio.
Estrategia GEO a largo plazo para la búsqueda con IA
El campo GEO es inestable. Cada mes aparece una norma propuesta, un crawler nuevo o un cambio en cómo uno de los grandes LLMs pondera las citas. La estrategia que envejece bien no es perseguir cada tendencia, sino invertir en la capa que cualquier sistema de retrieval necesita: contenido limpio, bien estructurado y rico en citas, entregado en un formato barato de procesar.
La fontanería técnica, es decir, hermaños Markdown, negociación de contenido y llms.txt, es coste de entrada. El trabajo editorial, es decir, entidades nombradas, citas directas, estadísticas verificables y fuentes autoritativas, es el foso. La competencia copia tu infraestructura en una semana. Cinco años de texto sustancioso firmado por expertos nombrados en tu empresa no los copia nadie.
Monta la fontanería una vez. Dedica el resto del tiempo a escribir cosas que merezca la pena citar.
La misma lista es la que usamos al integrar IA en WordPress para editores que necesitan citas, no otro plugin de chatbot.