Cada uno de los ocho defectos descritos a continuación pasó por un script o un agente que terminó su trabajo con un mensaje de éxito. Ninguno lanzó una excepción. Todos llegaron a producción en la web multilingüe que construimos y mantenemos desde hace años, y todos los encontramos solo cuando empezamos a comparar el resultado con algo distinto del informe de la propia herramienta.
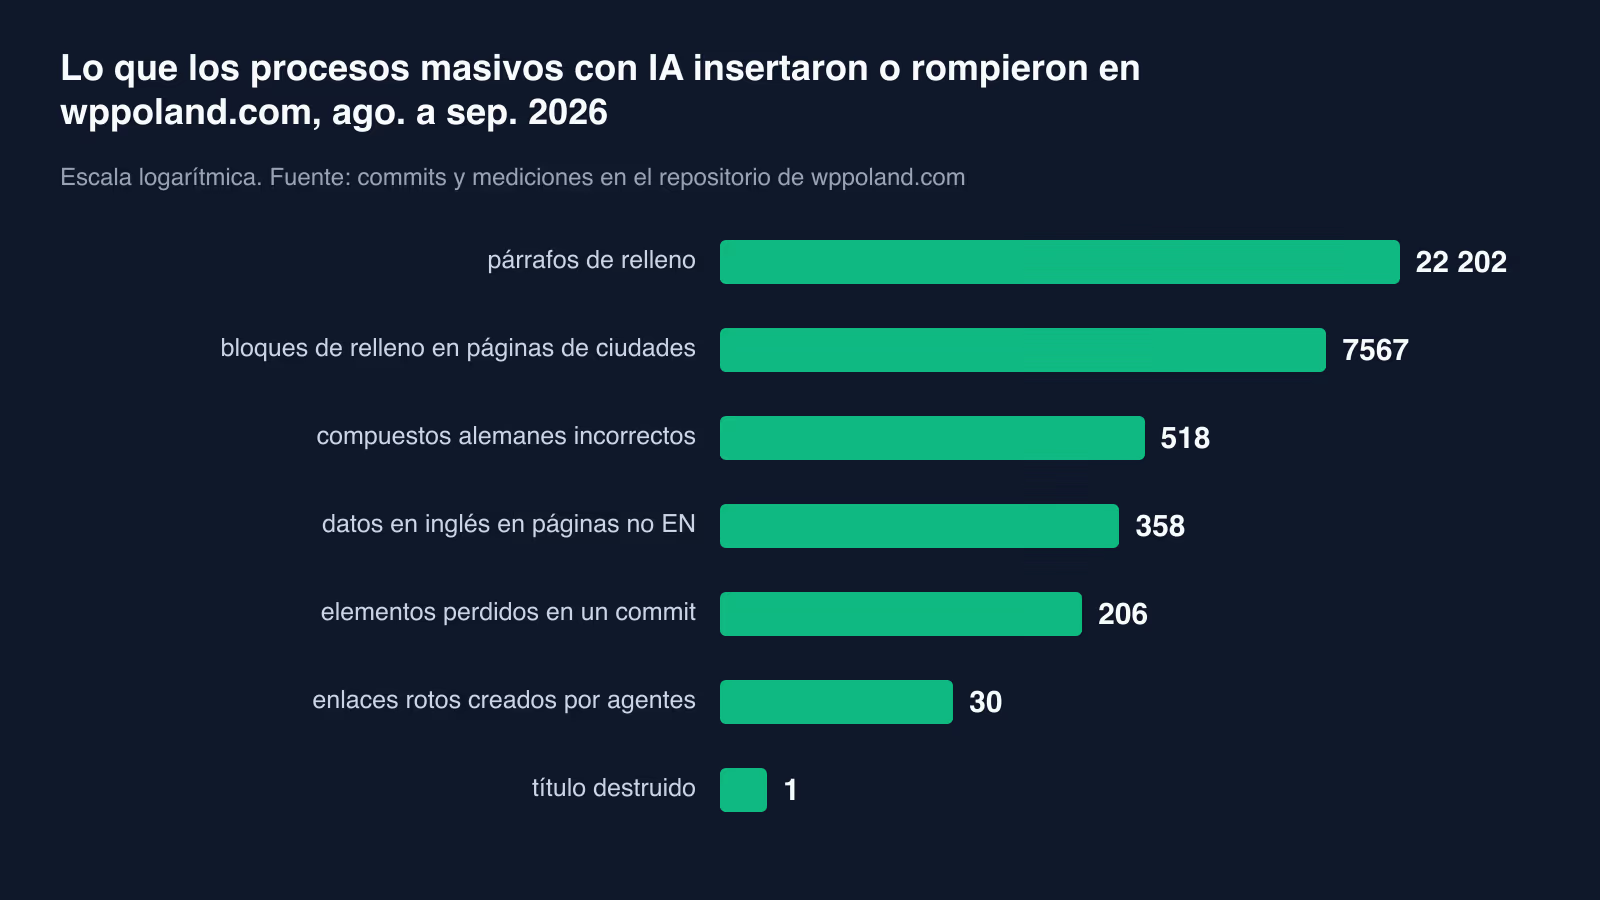
Entre agosto y septiembre de 2026, las pasadas masivas de IA insertaron en nuestra web 22 202 párrafos de relleno, destrozaron un encabezado, dejaron 358 frases en inglés en páginas de otros cinco idiomas y 518 compuestos alemanes incorrectos. Los agentes que escribían páginas de ciudades añadieron casos de estudio inventados y 30 enlaces a páginas que no existen. Describimos el mecanismo de cada defecto y el control que lo detecta hoy.
Escribimos sobre nuestra propia web porque solo aquí tenemos los datos completos: el commit, el número de archivos, el estado antes y después. Search Engine Land publicó esta semana un texto sobre diez maneras en que Claude puede descarrilar el SEO si nadie revisa su trabajo. Esta es la versión con los recibos.
Escala y contexto
wppoland.com funciona con Astro y se genera de forma estática en seis idiomas: polaco, inglés, alemán, noruego, portugués y español. La última build de producción, del 29 de septiembre de 2026, generó 13 733 páginas. El contenido lo crean y corrigen agentes de programación y scripts de Node que recorren miles de archivos a la vez. Tenemos más de 70 controles de calidad en CI y en local.
Aun así, cada uno de los defectos descritos superó todos los controles. El motivo es siempre el mismo, y volvemos a él al final.
| Defecto | Qué llegó a producción | Cómo lo encontramos | Control hoy |
|---|---|---|---|
| Inflado hasta un número de palabras | 22 202 párrafos en 873 archivos | 59 copias de un párrafo en una página en vivo | check:no-batch-filler |
| Relleno de páginas de ciudades | 7567 bloques en 2621 archivos | Encabezados numerados de “Ateny (1)” a “Ateny (26)“ | el mismo, ampliado a las ciudades |
| Regex de precios | 1 encabezado destrozado | Escáner de palabras pegadas | check:glued-words |
| Traducción solo de conjunciones | 358 frases en inglés en 104 archivos | Comparación con el equivalente inglés | detector basado en wpId |
| Sustitución de un término sin compuestos | 518 compuestos en 356 archivos | Lectura manual de la página | búsqueda por clase, no por literal |
| Casos de estudio inventados | 13 páginas, 30 enlaces rotos | Revisión de los agentes antes de publicar | validación de enlaces internos |
| Despliegue que recalentó la caché antigua | 5 de 6 portadas con contenido antiguo | Comparación del contenido, no de los códigos HTTP | segunda purga tras el smoke test |
| Ampliación que sustituía el contenido | 142 a 206 elementos por commit | Comparación con la versión anterior del archivo | check:element-loss |
1. Inflado hasta un número de palabras: 22 202 párrafos
Nuestras pautas editoriales dicen que una entrada de blog tiene unas 2500 palabras. Era una orientación para una persona. Una serie de scripts por lotes la trató como un objetivo que cumplir e infló los textos más cortos con relleno generado.
El resultado, medido durante la limpieza del 29 de agosto: 22 202 párrafos numerados del tipo “Notatka wdrożeniowa 47” (en polaco, “nota de implementación 47”) en 873 archivos, hasta 60 copias idénticas en una sola entrada, más 4 144 secciones de plantilla rotadas a partir de un repertorio de cinco por idioma. Dos de esas secciones eran instrucciones editoriales internas publicadas como cuerpo del artículo. En la página en vivo sobre actualizaciones de seguridad de WordPress, el mismo párrafo aparecía 59 veces.
El script no tenía ningún fallo. Hacía exactamente lo que se le pidió: subir el número de palabras. El error fue tomar el número de palabras, una medida auxiliar, por el objetivo.
Control hoy: check:no-batch-filler en cada ejecución de npm run check. La primera versión buscaba los literales del generador y dejó pasar el relleno que volvió con otro texto. La actual mira la forma: el mismo encabezado de segundo nivel tres veces en un archivo es un error, sean cuales sean las palabras.
2. Páginas de ciudades: el mismo relleno, otro directorio
Durante semanas, la colección de páginas de ciudades esquivó todos los controles, porque ninguno la escaneaba. Las pasadas 11 a 14 inflaron esas páginas hasta 2200 y luego 2500 palabras. En la limpieza del 30 de agosto eliminamos 7567 bloques numerados y unas 21 mil secciones repetidas de 2621 archivos. La página /pl/woocommerce-programista-ateny/ mostraba secciones de “Ateny (1)” a “Ateny (26)”.
Peor aún: una de las pasadas añadía bloques en español a todos los idiomas salvo el noruego. Es decir, las páginas de ciudades en polaco, alemán y portugués, que no son páginas en español, tenían secciones tituladas “Entrega y seguimiento”.
La segunda lección llegó con la limpieza. La primera versión del script de limpieza comparaba literales completos e informó de un éxito dejando 9642 secciones, porque scripts de corrección posteriores habían retocado ese relleno en su sitio (por ejemplo, la concordancia de género en español en 1506 archivos). La comparación exacta de bytes no veía ningún bloque que hubiera tocado un corrector. Ahora comparamos el encabezado más las cuatro primeras palabras.
Tras eliminar el relleno, 724 páginas cayeron por debajo del umbral de 2000 palabras. Las revisamos en Google Search Console antes de decidir nada: solo 2 tenían algún clic en 90 días y 575 tenían cero impresiones. Pasamos 723 a noindex en lugar de volver a inflarlas.
3. La regex de precios que se comió un encabezado
Las páginas de servicios no muestran precios fuera de la página de tarifas, así que un script sustituía los importes en zlotys por “wycena indywidualna” (en polaco, “presupuesto individual”). “Zł” es el símbolo de la moneda polaca, el zloty, y la regex buscaba “zł” sin distinguir mayúsculas y minúsculas y sin límite de palabra detrás.
En la página polaca de auditoría de seguridad, el encabezado “2. Złośliwe przekierowania” (en polaco, “2. Redirecciones maliciosas”) le parecía a esa regex un precio: “2. Zł”. En producción quedó como “wycena indywidualna ośliwe przekierowania”, es decir, “presupuesto individual” seguido del resto de la palabra cortada. La misma regex estaba en un segundo script, el de los precios de las páginas de ciudades.
Lo encontramos por casualidad, al construir un escáner de encabezados con palabras pegadas, que de paso detectó 13 encabezados sin espacio antes de una preposición (“Is AMP deadin 2026?”). La corrección es una búsqueda anticipada negativa en ambos scripts. En todo el corpus solo cayó un encabezado, pero era el de una página comercial.
4. La traducción que solo cambiaba las conjunciones
El campo de datos (llmCard) se muestra de forma visible bajo los artículos y llega a los datos destinados a los modelos de lenguaje. En las páginas de los cinco idiomas distintos del inglés, 358 de esas frases estaban en inglés, en 104 archivos. Algunas estaban traducidas a medias: un script antiguo solo había cambiado la conjunción, así que una página alemana del portfolio decía “Contact und inquiry forms” y una polaca “granite, conglomerate, i marble countertops” (con la “i” polaca en lugar de “and”).
Lo más interesante fue la detección. El primer detector, basado en la proporción de palabras funcionales inglesas, encontró 172 frases. Los propios agentes traductores avisaron de que en esos mismos archivos quedaban otras frases en inglés, y tenían razón. La segunda pasada comparaba cada frase con los datos del equivalente inglés de la misma página (el mismo wpId). Sin un filtro adicional devolvía 4004 coincidencias, sobre todo listas de tecnologías en las páginas de ciudades y el “for” noruego. Exigiendo al menos dos palabras funcionales inglesas quedaron 170 reales. Las últimas 12 las corregimos a mano.
Cada una de las cinco traducciones la comprobamos con un script, no con el informe del agente: en cada archivo solo cambiaron las posiciones indicadas, todas las cifras sobrevivieron y no hay rayas largas.
5. La sustitución de un término que no conocía los compuestos
Una pasada de unificación del vocabulario sustituyó un término alemán por “laufende Betreuung”. No trató los compuestos, así que las páginas decían “laufende Betreuung-Commitments”, “laufende Betreuung-Übergabe” y “Wartungs-laufende Betreuung”. Eso no es alemán. En total, 518 apariciones en 356 archivos, todas en páginas indexadas.
La entrada de nuestro backlog tenía un comando de verificación que solo buscaba la forma con guion después del término. Corregir exactamente lo que señalaba lo habría puesto en verde y habría dejado 157 compuestos con la segunda forma en 118 archivos. Así que buscamos la clase de defecto (cualquier guion pegado al término), no el literal que alguien había escrito en la tarea.
El método de corrección fue sencillo: 497 de las 518 apariciones venían de cuatro frases de plantilla. Reescribimos cada una una sola vez, a mano, en alemán correcto (“Übergabe in die laufende Betreuung”, “Wartungsbetreuung”) y la sustituimos como frase exacta. Las 21 restantes las corregimos una por una.
6. Agentes que se inventan referencias
Trece páginas de ciudades curadas las escribieron agentes. La revisión previa a la publicación, el 26 de agosto, encontró en ellas secciones como “Case Study 1: Dystrybutor B2B z Bielan Wrocławskich” (un distribuidor B2B de Bielany Wrocławskie) con cifras precisas: +52% de consultas, LCP de 4,5 s a 0,7 s, 100/100 en PageSpeed. Ninguno de esos clientes existe. Las mismas cifras estaban también en el campo de datos y en los datos speakable, no solo en el texto.
Además, las secciones “Inne lokalizacje” (otras ubicaciones) enlazaban a ciudades elegidas a ojo por cercanía geográfica: Lübeck, Kiel, Ratisbona, Girona, Tromsø. 30 enlaces rotos en 8 archivos.
Ningún control de texto lo detecta, porque un caso de estudio inventado es sintácticamente correcto. Lo detecta una regla de proceso: el agente recibe en la instrucción la lista de URL existentes, y toda afirmación numérica sobre un cliente necesita una fuente en el repositorio o desaparece.
7. Un despliegue con éxito, una producción con contenido antiguo
El script de despliegue del 8 de septiembre terminó limpio: subida, purga de la caché, smoke test 81/81 OK, código de salida 0. En la web en vivo, cinco de las seis portadas mostraban las tarjetas antiguas.
El orden era: subida, purga, 8 segundos de pausa, smoke test. Cloudflare Pages no llegó a activar el nuevo despliegue, así que las 81 peticiones del test dieron con la build anterior y llenaron con ella la caché durante una hora. El paso de verificación anuló la purga hecha un momento antes. Ninguna señal era falsa. Ninguna medía lo que salió mal: el test comprobaba códigos HTTP, no contenido.
Hoy: el script purga la caché una segunda vez, después del test, y confirmamos el despliegue con una frase de un cambio concreto en la web en vivo, con un parámetro que evita la caché.
8. La ampliación que sustituía el contenido
Las pasadas que “ampliaban” las entradas cortas debían añadir contenido. En la práctica, algunas sustituían el cuerpo entero del artículo. Nueve entradas las restauramos desde el historial de git.
Después construimos un control que compara cada archivo modificado con su versión base y señala la pérdida de un elemento: tabla, componente, iframe, imagen, bloque de código, pregunta FAQ, paso howTo, enlace interno. Ejecutado hacia atrás sobre los últimos 60 commits de contenido, marcó cada pasada de ampliación de la 128 a la 185, y cada una perdía entre 142 y 206 elementos, entre ellos tablas, vídeos incrustados y bloques de código.
La primera versión de ese control reconocía los encabezados por su texto. En la rama actual señaló 17 encabezados perdidos y los 17 eran correcciones: palabras pegadas separadas, un encabezado devorado restaurado. Cambiar un nombre no es perder algo. Por eso los encabezados, los enlaces y las FAQ los contamos por cantidad, y la identidad la reservamos para imágenes, componentes e iframes.
El mecanismo común: éxito desde la perspectiva de la herramienta
Los ocho casos tienen la misma forma. La herramienta medía lo que ella misma había hecho y, con eso, informaba de un éxito. El script de inflado medía el número de palabras. El script de limpieza medía si había encontrado sus literales. La verificación del backlog medía una sola forma del compuesto. El smoke test medía códigos HTTP.
Cada defecto lo encontramos solo cuando comparamos el resultado con algo externo:
- con la versión anterior del mismo archivo (tablas y secciones perdidas),
- con el equivalente en otro idioma (frases en inglés en páginas alemanas),
- con la web en vivo en lugar del registro de despliegue (caché antigua),
- con la clase de defecto en lugar del literal de la tarea (la segunda forma de los compuestos),
- con los datos de demanda (723 páginas de ciudades sin una sola impresión).
De ahí sale la regla práctica que aplicamos desde septiembre: el informe de un agente o de un script es una hipótesis. El resultado lo comprueba un script aparte, que no sabe qué pretendía hacer la herramienta y compara el estado antes con el estado después.
Qué cambiaría antes de la primera pasada masiva
- Ningún objetivo numérico para un script que escribe prosa. El número de palabras, de enlaces y de FAQ son medidas para leer, no para cumplir.
- Un control que compare con la versión anterior del archivo antes del primer commit por lotes, no después del trigésimo.
- Toda regex sobre texto probada con encabezados y con palabras con caracteres polacos, porque “Zł” es el comienzo de muchas palabras polacas.
- Traducciones verificadas mediante comparación con el equivalente en el idioma de origen, no con una lista de palabras.
- El comando que verifica una tarea busca la clase de defecto. Si la tarea nombra un ejemplo, busca también sus variantes.
- Despliegue confirmado por el contenido de la web en vivo, en cada idioma.
Lo que este texto no demuestra
No afirmamos que estos defectos nos costaran tráfico, porque no lo hemos medido de una forma que lo resuelva. Parte de las páginas con relleno tampoco tenían impresiones antes de él.
La actualización de spam de Google de septiembre empezó el 25 de septiembre de 2026 y debe durar unas dos semanas. Según el resumen de Search Engine Roundtable del 28 de septiembre, golpeó a páginas programáticas y a contenido generado por IA, y Google publicó esa misma semana un trabajo sobre el sistema SAFE para detectar el “AI slop” masivo. Nuestras páginas de ciudades son exactamente esa categoría. Haremos la lectura en Search Console, por separado para las páginas de ciudades, el blog y las páginas de servicios, cuando termine la actualización, y la publicaremos sea cual sea el resultado.
Una última nota sobre nosotros mismos: este texto también se escribió con ayuda de un agente. Cada cifra procede de un commit o de una medición en nuestro repositorio y pasó por los mismos controles que describimos aquí.