El candidato que no quiere que le vean buscando
En un tablero de empleo técnico, la persona más valiosa del sistema es la que ya tiene trabajo. Es la que tiene experiencia, certificados vigentes y ninguna urgencia, y es también la que más arriesga al publicar un perfil: si su empleador actual ve que está mirando ofertas, la conversación en su empresa cambia antes de que exista ninguna oferta real.
De ahí sale la decisión que gobierna toda la parte de candidatos de esta plataforma, y no es una funcionalidad sino un valor por defecto. La visibilidad del perfil, la posibilidad de presentar una candidatura de forma anónima y la definición exacta de qué ve una empresa antes del contacto están bajo control del usuario, y los valores iniciales son conservadores. Un sitio que por defecto lo enseña todo a todos reúne más perfiles el primer mes y pierde justamente a los candidatos más demandados, porque son los que más tienen que perder.
La protección de datos deja de ser entonces un apartado legal y pasa a ser producto. La gestión de consentimientos, la portabilidad, el derecho de supresión y el almacenamiento dentro de la Unión Europea son los requisitos que deciden si alguien llega a crear una cuenta, no un anexo que se redacta al final del proyecto.
Qué es Jobsin.co
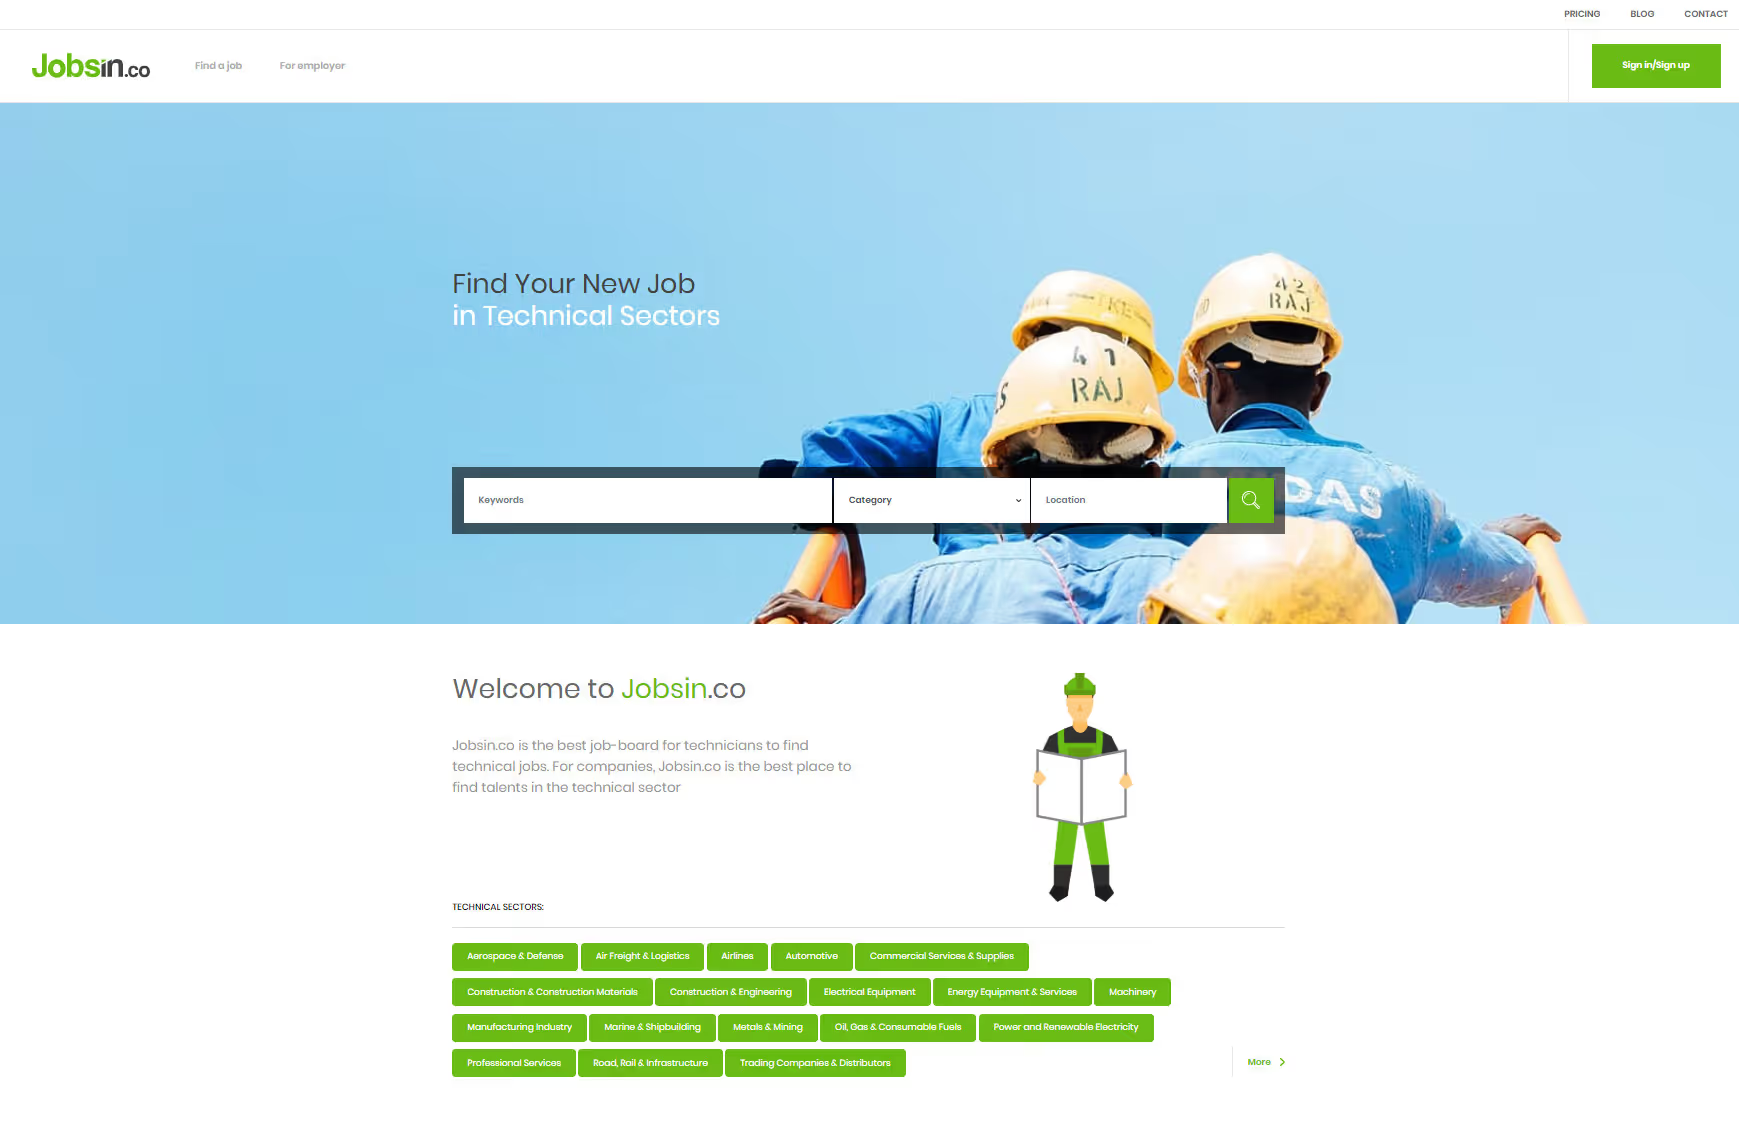
Jobsin.co es un tablero de empleo para especialistas técnicos cualificados de construcción, mecánica, ingeniería y sectores industriales afines, que conecta profesionales con empleadores en varios mercados nacionales. El proyecto llegó en 2019 y la implementación duró alrededor de seis semanas. La maquetación la aportó el cliente, así que el tiempo que en otros proyectos se va en iteraciones de diseño se dedicó aquí a las dos piezas que deciden si un tablero de empleo aguanta: la taxonomía de competencias y el flujo que mueve una candidatura entre estados.
Los sectores técnicos tienen rasgos que el resto del mercado laboral no comparte. Faltan especialistas a escala global, de modo que el candidato tiene la posición fuerte y no va a rellenar un formulario de veinte campos. Buena parte de los puestos implica traslado a otro país, lo que mete en el alcance visados, reconocimiento de titulaciones y diferencias de derecho laboral. Los requisitos son estrechos y una proporción alta del trabajo es por contrato y temporal, lo que cambia toda la lógica de los avisos: una vacante abierta tres semanas tiene que llegar a la persona adecuada en los primeros días.
Una oferta caduca en una fecha
Casi todo el contenido de una web envejece despacio. Una oferta de empleo no: caduca un día concreto y a partir de ahí es dañina. Quien presenta su candidatura a un puesto que ya no existe pierde su tiempo, y el sitio pierde credibilidad más deprisa que con cualquier fallo técnico.
De esa propiedad salen tres decisiones. El estado de la oferta es un campo de valores cerrados con su propio ciclo de vida, independiente del texto. La caducidad no borra el registro, cambia su estado, porque el historial de candidaturas tiene que sobrevivir a la oferta a la que se refiere. Y una oferta caducada tiene que dejar de ser visible para los buscadores, lo cual es trabajo aparte y no un efecto colateral: una página ya indexada sigue viva en los resultados durante semanas y continúa enviando visitas a una vacante que no existe.
Los datos estructurados para ofertas de empleo no son aquí un adorno sino el canal principal de distribución, porque los buscadores muestran las vacantes en un módulo propio. El marcado tiene por tanto que coincidir con el estado del registro al día, y esa es la única razón por la que la fecha de caducidad vive en los datos y no en un párrafo escrito por un reclutador.
La taxonomía es el producto
En un tablero generalista la búsqueda por palabras clave basta, porque candidato y empleador usan las mismas palabras. En contratación técnica ese mecanismo falla de inmediato, porque la misma competencia tiene una docena de nombres: unos son la marca comercial de un fabricante, otros una abreviatura del gremio y otros dependen del país y de quién redactó el anuncio.
Un soldador con homologación para un procedimiento concreto, un operador de una máquina de un fabricante determinado y un ingeniero que trabaja con una norma vigente en un solo país son tres casos en los que la búsqueda por texto devuelve o cero resultados o varios cientos sin relación. La base de esta plataforma no es, por tanto, un motor de búsqueda, sino un vocabulario ordenado de competencias: una jerarquía donde cada habilidad tiene categoría superior, enlaces a competencias afines, indicación de requisitos previos y un nivel que va de básico a experto.
Construir ese vocabulario es trabajo de dominio y no de programación, y es la parte que más se subestima en proyectos de esta categoría. El código de emparejamiento escrito sobre un vocabulario todavía en movimiento hay que reescribirlo cada vez que se renombra una categoría. Por eso el orden aquí fue el inverso al habitual: primero el vocabulario, después la búsqueda y los avisos sobre él. La consecuencia práctica es que añadir un sector tras la salida a producción es trabajo de datos y no de código.
Búsqueda, emparejamiento y lo que el emparejamiento no promete
La búsqueda funciona sobre ese vocabulario y sobre atributos cerrados: ubicación dividida en país, región y ciudad, sector, nivel de experiencia, tipo de contrato, horquilla y moneda, y modalidad remota. El emparejamiento pondera la coincidencia de competencias, el peso de la preferencia de ubicación, el nivel de experiencia y las expectativas económicas.
Conviene decir con claridad qué no hace ese mecanismo. No evalúa al candidato ni predice si funcionará en el puesto. Ordena una lista según la coincidencia entre lo que ambas partes han escrito sobre sí mismas, y nada más. Las plataformas de esta clase se describen a menudo con un lenguaje que sugiere más, y la diferencia importa, porque decide si el reclutador trata el resultado como una sugerencia o como un veredicto. El porcentaje junto a una vacante es legible para el candidato y a la vez es el elemento más arriesgado de la interfaz, porque un número parece una medición y es una suma de pesos ajustados a mano.
En lo técnico, la búsqueda pasa por Elasticsearch y no por consultas a MySQL. El motivo es prosaico: filtrar por una docena de atributos a la vez sobre decenas de miles de registros es, en una base relacional, una consulta con muchas uniones que responde al instante en una instalación vacía y tarda segundos contra un archivo completo. MySQL sigue siendo la fuente de verdad, porque el índice de búsqueda es una estructura derivada y tiene que poder reconstruirse desde cero.
Avisos, o el tráfico que uno se genera en contra
Los avisos de nuevas vacantes son el mecanismo de retorno de un tablero de empleo y a la vez la forma más fácil de arruinar la propia reputación como remitente. Un sitio que envía un correo a todos los candidatos compatibles con cada nueva oferta acaba en la carpeta de correo no deseado en un mes y deja de llegar incluso a quienes pidieron los avisos.
La respuesta tiene tres capas. El envío pasa por una cola, así que publicar una oferta genera tareas procesadas al ritmo que acepta el proveedor de correo y no cientos de mensajes en un instante. El candidato elige la frecuencia, inmediata, diaria o semanal, con el resumen diario como valor por defecto, porque en contratación técnica una vacante rara vez exige reacción en una hora. La agrupación se hace por relevancia y no por fecha, de modo que un mensaje lleve unas pocas ofertas que merezca la pena abrir en lugar de veinte arbitrarias.
La cola hace además algo que se menciona poco: separa las operaciones pesadas de la petición del usuario. Publicar una oferta, recalcular el índice de búsqueda y enviar los avisos son tres tareas distintas y solo la primera tiene que terminar antes de que el reclutador vea una confirmación.
Una candidatura es un estado, no un formulario enviado
En la mayoría de sitios, un formulario acaba cuando se envía el mensaje. En un tablero de empleo, una candidatura es un objeto que vive semanas y atraviesa estados: presentada, revisada, convocada a entrevista, descartada, cerrada junto con la oferta. Tratarla como un correo parece una simplificación y provoca dos problemas a la vez.
El primero es el silencio hacia el candidato. Quien ha enviado diez candidaturas y no sabe qué ha pasado con ninguna abandona el sitio antes que quien recibe negativas. Una vista de estado y un aviso en cada cambio no cuestan casi nada y deciden si el candidato vuelve. El segundo es el trabajo del reclutador: sin estados no hay forma de decir cuántas candidaturas están esperando, ni informe alguno que no sea contar mensajes a mano.
Los estados importan también para la conservación de datos. Una candidatura contiene datos personales y debe borrarse o anonimizarse pasado el plazo consentido. Sin un estado explícito y una fecha eso no se puede automatizar, y hacerlo a mano significa que al cabo de un año ya no lo hace nadie.
El lado del empleador y la honestidad de las ofertas
El reclutador dispone de un editor de ofertas con lista estructurada de requisitos, varias ubicaciones, horquillas, plazos y biblioteca de plantillas, y del lado de los candidatos un seguimiento de candidaturas, comparación de perfiles, agenda de entrevistas y plantillas de comunicación. El acceso por equipos implica que varias personas trabajan sobre una misma vacante, así que un cambio de estado tiene que quedar atribuido a una persona y no a la cuenta de la empresa.
La confianza es un asunto aparte. En mercados internacionales una oferta falsa es un peligro real para el candidato, porque hay de por medio trabajo en el extranjero, costes de traslado y a veces pagos exigidos por adelantado. La verificación del empleador es por eso de varias etapas, las ofertas pasan por moderación y los avisos de los usuarios van a revisión manual. La detección automática de patrones propios del fraude es una ayuda y no una decisión: el último paso lo da una persona, porque el coste de equivocarse en un sentido lo paga el candidato y en el otro un empleador honesto al que se ha retenido la publicación.
Cumplimiento sin la ficción de un único reglamento
Una plataforma que opera en varios países se topa con derecho laboral distinto, requisitos de datos distintos y reglas distintas sobre publicar horquillas salariales. La peor respuesta posible es un reglamento único redactado para la jurisdicción más permisiva, porque parece orden y en realidad traslada el riesgo al usuario.
En su lugar, la capa de cumplimiento es modular: las condiciones y las cláusulas están asociadas a un país, los datos se encaminan a la ubicación correcta y las diferencias se describen como configuración y no como código. Añadir otro mercado consiste entonces en completar un conjunto de reglas y obtener una revisión jurídica para esa jurisdicción, no en auditar la aplicación entera.
Rendimiento y pila tecnológica
La plataforma se apoya en WordPress con un tema propio de tablero de empleo, un motor de ofertas muy adaptado, un conjunto de extensiones propias y Advanced Custom Fields Pro. La capa de datos es MySQL con replicación, Redis para caché de sesión y de objetos, Elasticsearch para la búsqueda y un almacén aparte para analítica. Alrededor están las integraciones de distribución y datos estructurados, las pasarelas de pago y los proveedores de correo, sobre alojamiento en la nube con CDN, balanceo, workers de cola y monitorización.
El trabajo de rendimiento se concentra en los listados, porque son los que soportan la mayor parte del tráfico y los más caros de calcular. La caché guarda resultados para las combinaciones de filtros más frecuentes, los recursos estáticos salen de la red de distribución y las consultas a la base de datos se revisaron buscando las que crecen linealmente con el número de ofertas.
Desarrollo de la implementación
El orden del trabajo fue lo que decidió el resto, y salía de una sola observación: los dos errores caros de esta categoría, una taxonomía sin cerrar y un envío de avisos sin cola, solo se manifiestan con volumen, de modo que hay que resolverlos antes de la salida a producción y no después del primer mes.
Las pruebas de carga se ejecutan contra una copia de los datos reales y no sobre una instalación vacía, porque una consulta instantánea sobre un conjunto de demostración se comporta de otro modo sobre un archivo de ofertas con años de candidaturas colgando de él. Tras la salida a producción el proyecto pasó a mantenimiento: copias de seguridad, actualizaciones de seguridad, revisión periódica del rendimiento y pruebas de carga antes de los periodos en que sube el volumen de contratación. El mantenimiento incluye además el control de calidad de las ofertas y la moderación, que en un tablero de empleo no es trabajo editorial sino defensa directa de la credibilidad del sitio.
Conclusión
Jobsin.co demuestra que un tablero de empleo técnico no es una lista de vacantes con un buscador. Es un vocabulario de competencias, un mecanismo de avisos, una capa de cumplimiento para varios mercados y un proceso de verificación de empleadores, y la interfaz es la última capa sobre todo eso. Las decisiones técnicas anteriores salen de ese orden: el vocabulario antes que el emparejamiento, el índice de búsqueda separado de la fuente de verdad, la cola delante del envío, valores de privacidad conservadores por defecto y una persona en el último paso de la moderación.
Lo que pasa a la siguiente implementación es la forma de trabajar. El vocabulario y las integraciones no pasan, porque se construyeron para un mercado y para los datos de un cliente. El proyecto siguiente empieza por un análisis de alcance, y el presupuesto viene después.
Preguntas frecuentes
Respuestas prácticas para aplicar el tema en la ejecución real.
¿Qué alcance tuvo el proyecto Jobsin.co?
#¿Cómo fue la entrega de Jobsin.co?
#¿Qué fue lo más difícil técnicamente en Jobsin.co?
#¿Qué parte de Jobsin.co se puede reutilizar en otro proyecto?
#¿Necesitas un FAQ adaptado a tu sector y mercado? Preparamos una versión alineada con tus objetivos de negocio.
Hablemos