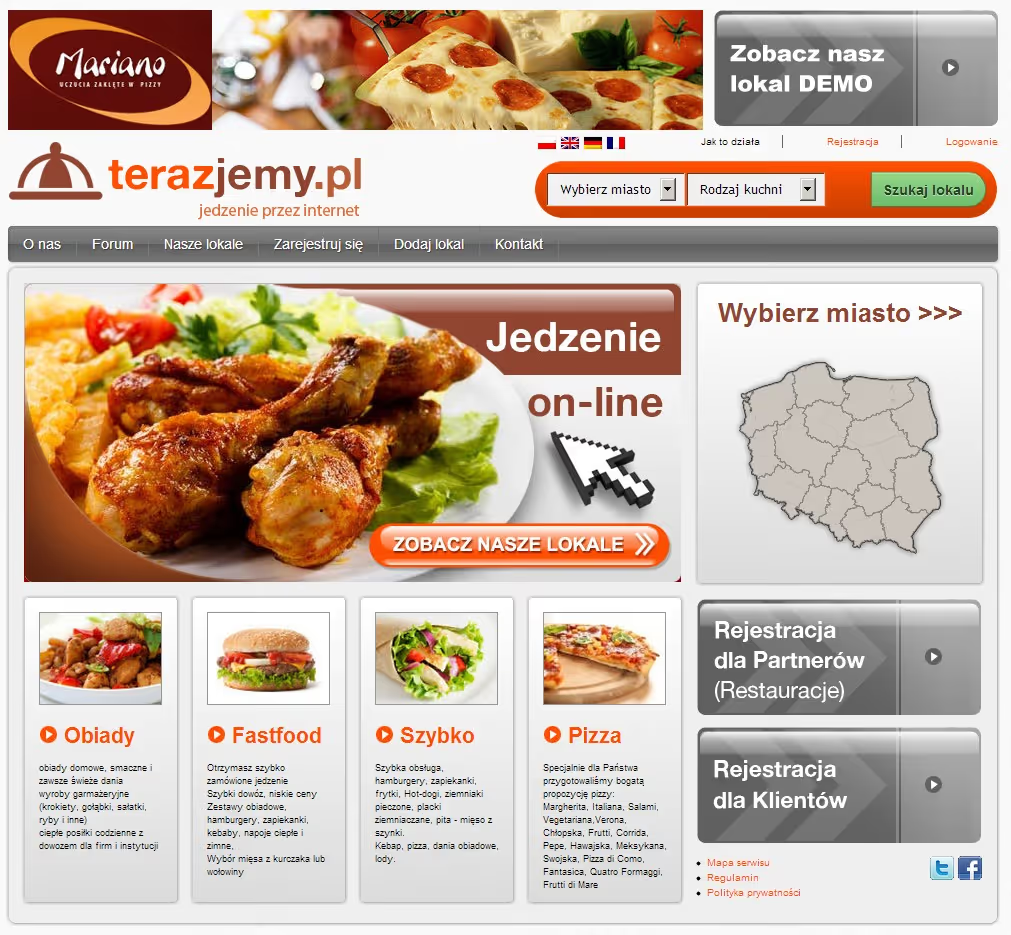
Las fotos de comida son la carga real de un sitio de recetas
Terazjemy.pl fue una plataforma dedicada a la alimentación saludable y a la actividad física, con recetas, artículos educativos y guías interactivas. El sitio dejó de funcionar hace tiempo, así que lo que sigue describe decisiones de proyecto y no un estado actual. La entrega fue en 2012 y el trabajo llevó unas seis semanas.
Empiezo por las imágenes porque en este tipo de sitio son contenido y no decoración. Una receta sin foto prácticamente no funciona: el lector decide con la vista antes de leer la lista de ingredientes. Y la fotografía gastronómica es, además, de las más caras de transmitir que existen. Tiene mucha textura, pocas zonas planas y se comprime mal, y casi nunca viene sola, porque un plato bien documentado trae el resultado final y a veces también los pasos intermedios.
Por eso el trabajo de rendimiento se concentró donde estaba la masa. Los archivos se procesan al subirlos hacia un juego de tamaños que corresponde a los sitios donde realmente aparecen: la miniatura del listado, la imagen principal de la receta y las tomas de los pasos. La miniatura del listado nunca es la imagen principal reescalada por el navegador, porque ese reescalado ahorra píxeles en pantalla y no ahorra ni un byte de transferencia.
Las imágenes por debajo de la primera pantalla se cargan al acercarse a la vista. Conviene marcar el límite de esa técnica, porque se aplica con demasiada frecuencia sin pensarla: la foto principal de una receta suele ser el elemento más importante de la primera pantalla, así que retrasar precisamente esa empeora la percepción de la página en lugar de mejorarla. La carga diferida tiene sentido por debajo del pliegue, no en el elemento que el lector está esperando.
Una receta se comporta como datos, no como un artículo
La primera decisión de este proyecto es menos evidente de lo que parece. Una receta se parece a un artículo: tiene título, foto y texto. Se comporta de forma completamente distinta.
Un artículo se lee una vez, de arriba abajo. Una receta se lee dos veces: primero en el supermercado, por la lista de ingredientes, y después en la cocina, por el orden de las operaciones, y esa segunda lectura ocurre con las manos sucias y con la pantalla apagándose sola. Un artículo tiene un autor y una fecha. Una receta tiene tiempo de preparación, número de raciones, nivel de dificultad, ingredientes con cantidades y un juego de etiquetas dietéticas, y todas esas cosas son preguntas de búsqueda y no adorno.
De ahí que una receta no pudiera ser una entrada de texto. Necesitaba estructura propia: los ingredientes como una lista de posiciones con cantidad y unidad, los pasos como una secuencia ordenada, y el tiempo, las raciones y las categorías dietéticas en campos separados. Solo con esa estructura se puede responder a una pregunta del tipo cena sin gluten en menos de treinta minutos, y solo con esa estructura se puede describir el contenido con datos estructurados de una forma que el buscador entienda de verdad.
Unidades, escalado de raciones y lo que no se debe multiplicar
Cuando los ingredientes son posiciones separadas aparece un problema que el texto libre no tiene: hay que decidir qué es una unidad.
En la cocina polaca conviven gramos y mililitros con el vaso, la cuchara, la cucharadita, la pizca y el decagramo, y este último es una unidad que fuera de ese contexto casi nadie usa, mientras que en recetas domésticas antiguas aparece con total normalidad. El vaso, por su parte, no tiene una capacidad única y significa una cosa con harina y otra con sémola, porque en ambos casos se está midiendo volumen mientras el lector piensa en peso.
Hay dos salidas obvias y las dos tienen precio. Se pueden forzar unidades métricas y convertirlo todo, lo que da datos coherentes y recetas que se leen como un protocolo de laboratorio. Se pueden dejar las unidades tal como las escribió la autora, lo que da lenguaje natural e imposibilita cualquier conversión automática. Elegimos una tercera: la unidad es un campo tomado de una lista cerrada, y en aquellas que admiten equivalencia métrica el factor queda guardado al lado. Así la receta se muestra tal como fue escrita, y el escalado de raciones funciona allí donde tiene con qué operar y se abstiene de forma visible allí donde no.
El escalado merece un párrafo propio porque parece trivial y casi nunca está bien hecho. Duplicar las raciones no duplica el tiempo de horno y no duplica una pizca de sal. Un mecanismo que multiplica todo por dos produce recetas imposibles de ejecutar, así que la conversión se aplica solo a las posiciones con cantidad numérica y unidad de medida, mientras que los tiempos y las indicaciones descriptivas quedan intactos.
Datos estructurados y una única fuente de entrada
La receta es uno de los pocos tipos de contenido para los que los buscadores tienen un tratamiento propio y detallado. La descripción estructurada abarca ingredientes, pasos, tiempo de preparación y de cocción, raciones e información nutricional.
Lo decisivo aquí, sin embargo, es organizativo y no técnico. Los datos estructurados solo tienen sentido si salen de la misma fuente que el contenido visible. Si la redacción escribe los ingredientes dentro del texto y otra persona rellena aparte los campos para el buscador, los dos juegos divergen en cuestión de meses, y divergen en silencio, porque nadie lee datos estructurados con los ojos. Por eso los campos de la receta son el único punto de entrada, y tanto la vista para personas como la descripción para máquinas se generan a partir de ellos.
El mismo principio evita un segundo error habitual. La información nutricional expresada como número es una afirmación sobre un plato concreto y depende de los productos que se hayan usado, así que el campo correspondiente es opcional y queda vacío mientras nadie lo rellene a conciencia. Un campo que inserta por defecto un valor calculado produce datos con aspecto de medición que no son una medición.
El tráfico de un portal de recetas sigue un calendario
Un sitio de recetas no tiene tráfico uniforme. Tiene picos claros alrededor de las fiestas, y en el contexto polaco el mayor de todos es la cena de Nochebuena, con un interés por platos que nadie busca durante los otros once meses. El segundo pico llega a principios de enero, cuando lo que cambia no es el plato sino la intención: la gente busca los mismos platos en versión ligera.
Esto tiene dos consecuencias técnicas. La primera es de capacidad: la carga no se reparte por el año, así que una configuración que sobra en marzo puede quedarse corta la semana antes de las fiestas, y además en unas pocas direcciones concretas y no en todo el sitio. El tráfico entra entonces en un chorro estrecho sobre una docena de páginas, lo que por un lado es peligroso y por otro es fácil de resolver, porque esa misma docena de páginas se puede precalentar en caché antes de que llegue.
La segunda consecuencia es editorial. El material de temporada que pasa el año en el sitio no está muerto, está dormido, así que borrarlo al acabar la temporada es un error. Las recetas de temporada llevan fecha de primera publicación y fecha de última actualización, y durante el periodo en que se buscan vuelven a posiciones visibles a través de relaciones temáticas, no republicando el mismo texto bajo una fecha nueva.
Qué se cachea realmente
Un sitio de contenido es, desde el punto de vista de la caché, un caso agradecido: casi todo lo que muestra es igual para cualquier visitante y cambia poco. La ganancia, por tanto, viene sobre todo de que una petición de una receta ya publicada no llegue a ejecutar PHP.
Los elementos que sí cambian son pocos y se pueden enumerar: el contador de comentarios, el bloque de últimas entradas, el estado de sesión. Cualquiera de ellos, insertado directamente en el documento, invalida la caché de la página entera. Por eso van separados y se piden aparte, lo que suena a complicación y es exactamente lo contrario: permite mantener el resto de la página en caché durante mucho tiempo en lugar de refrescarla cada vez que alguien comenta.
Redis se ocupa de la capa de debajo, es decir, de los resultados de consultas que se repiten en muchas páginas: listados de categorías, relaciones entre recetas, agregados de etiquetas dietéticas. No son cosas caras una a una, son cosas calculadas en cada visualización, y ese coste solo se ve bajo tráfico real y nunca en pruebas sobre una instalación vacía. Varnish se encarga del nivel de página y Cloudflare de la capa de borde y de los ficheros.
Invalidar la caché es en este montaje más difícil que llenarla. Publicar una receta no cambia solo su página: cambia el listado de su categoría, la portada, el bloque de relacionadas y el mapa del sitio. Si se limpia únicamente la primera, el resto del sitio finge durante una hora que la receta no existe. Si se limpia todo, cada publicación tira el trabajo de caché del sitio entero. El punto razonable está en limpiar lo que de verdad depende del objeto modificado, y eso hay que escribirlo explícitamente durante la construcción, porque por defecto ningún mecanismo lo sabe.
Newsletter, y la parte que no se ve en el formulario
El sitio recogía direcciones para un boletín, y esta es la parte donde más a menudo se toma un atajo. Un campo de correo y un botón se levantan en un cuarto de hora. El problema empieza por debajo.
Una dirección escrita en un formulario no es un consentimiento, es una declaración, y mientras no se confirme con un clic en un enlace enviado a esa dirección ni siquiera se sabe si pertenece a quien la escribió. Por eso el alta es en dos pasos: escribir la dirección crea un registro pendiente y solo la confirmación lo convierte en suscripción. Sin ese paso cualquiera puede dar de alta la dirección de otro, y la lista crece con entradas que en el primer envío se transforman en denuncias por abuso.
La salida importa tanto como la entrada. El enlace de baja tiene que funcionar sin iniciar sesión y sin formulario, en un solo clic, porque cada obstáculo puesto en ese camino traslada la baja al botón de marcar como spam del cliente de correo, y eso cuesta mucho más que perder una dirección.
El envío tampoco puede ocurrir dentro de la petición del usuario. Mandar correo a una lista tarda y falla por motivos sobre los que no tiene ninguna influencia quien está delante del formulario. Tareas de ese tipo van a una cola, con RabbitMQ, y se ejecutan fuera de la petición con posibilidad de reintento, porque un rechazo temporal del servidor de correo no debería significar que el mensaje se perdió.
Copias de seguridad y continuidad
Las copias se hacían de forma automática hacia Amazon S3, fuera del servidor del sitio, con versionado, de modo que se pudiera volver no solo al estado anterior a una avería sino también al anterior a un error de redacción de hace unos días. Son dos escenarios distintos y solo el segundo ocurre con frecuencia.
Conviene repetir aquí lo que en las descripciones de proyectos no suele decirse. Una copia que nadie ha restaurado nunca es una hipótesis y no una salvaguarda. La restauración hay que hacerla al menos una vez, en un entorno aparte, para saber cuánto tarda y qué le falta, porque las carencias de una copia tienen la costumbre de manifestarse exclusivamente durante una restauración.
Mantenimiento y caminos que no se llegaron a construir
El mantenimiento cubría actualizaciones del núcleo, del tema y de las extensiones, revisión de registros, seguimiento de la indexación y limpieza de las consultas que crecían con el número de recetas. Las pruebas pasaban por un entorno con copia de datos reales, porque un sitio con varios cientos de recetas y taxonomías amplias se comporta de forma muy distinta a una instalación limpia con contenido de demostración.
Entre los planes que nunca se realizaron estaban un módulo de planificación de comidas, la integración con aplicaciones de dieta y una sección de comunidad. Los menciono como direcciones y no como funciones, porque ninguna llegó a existir. Cada una de las tres habría cambiado además el carácter del proyecto: la planificación introduce datos que pertenecen a una persona concreta, la integración introduce dependencia de una interfaz ajena, y la comunidad introduce moderación, es decir, trabajo humano permanente que un sitio de contenido hasta entonces no necesitaba.
Lo que sí se traslada de aquí es el método: tratar la receta como datos y no como texto, una sola fuente para la vista y para los datos estructurados, separar el contenido estable de los elementos variables al planificar la caché, mandar a una cola todo lo que sale del sitio, y probar sobre una copia de producción. Lo que no se traslada es el modelo de contenido de este proyecto, escrito para una redacción concreta y un briefing de la categoría Sitios web. Un segundo proyecto arranca con un análisis de alcance, y el presupuesto va después.
Preguntas frecuentes
Respuestas prácticas para aplicar el tema en la ejecución real.
¿Qué alcance tuvo el proyecto terazjemy.pl?
#¿Cómo fue la entrega de terazjemy.pl?
#¿Qué fue lo más difícil técnicamente en terazjemy.pl?
#¿Qué parte de Portal de recetas y estilo de vida saludable: terazjemy.pl se puede reutilizar en otro proyecto?
#¿Necesitas un FAQ adaptado a tu sector y mercado? Preparamos una versión alineada con tus objetivos de negocio.
Hablemos