El despliegue de agentes autónomos de inteligencia artificial, arquitecturas de generación aumentada por recuperación (RAG) y asistentes operativos en entornos corporativos de comercio electrónico y gestión de contenidos plantea una superficie de ataque completamente inédita. Durante décadas, la ingeniería de software seguro se fundamentó en una frontera inequívoca: los datos facilitados por el usuario permanecían rígidamente separados del código ejecutable. En el ecosistema clásico de PHP y bases de datos relacionales, las consultas preparadas mediante $wpdb->prepare() neutralizaban la inyección SQL porque el motor interpretaba los parámetros exclusivamente como literales pasivos.
En los sistemas gobernados por modelos de lenguaje de gran tamaño (LLM), este límite desaparece. Un modelo procesa las instrucciones directivas del sistema (system prompt), la información corporativa recuperada de bases de datos vectoriales y las entradas externas sin filtrar dentro de una misma ventana de contexto (context window). Esta coincidencia implica que cualquier fragmento de texto suministrado por terceros tiene la capacidad potencial de secuestrar la toma de decisiones del modelo. Cuando conectas ese asistente a herramientas autónomas, al protocolo Model Context Protocol (MCP) y a permisos de escritura sobre la base de datos de WooCommerce, una inyección de instrucciones (prompt injection) deja de ser un ejercicio teórico para convertirse en una amenaza crítica contra la continuidad del negocio, el cumplimiento de la Directiva NIS2 y la custodia de datos personales según el RGPD.
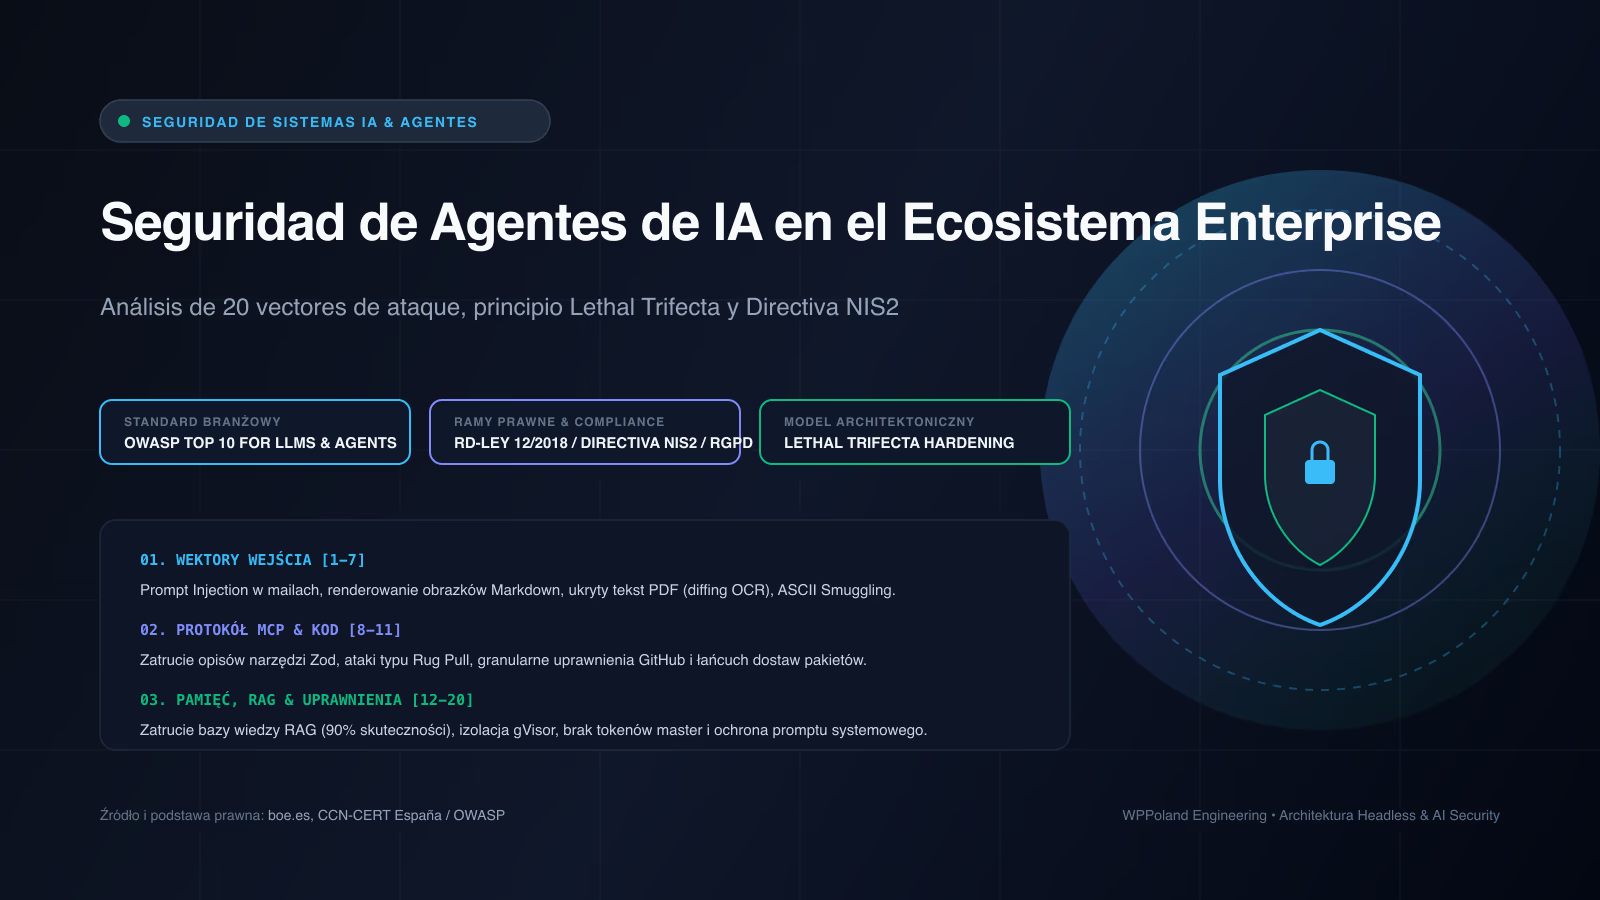
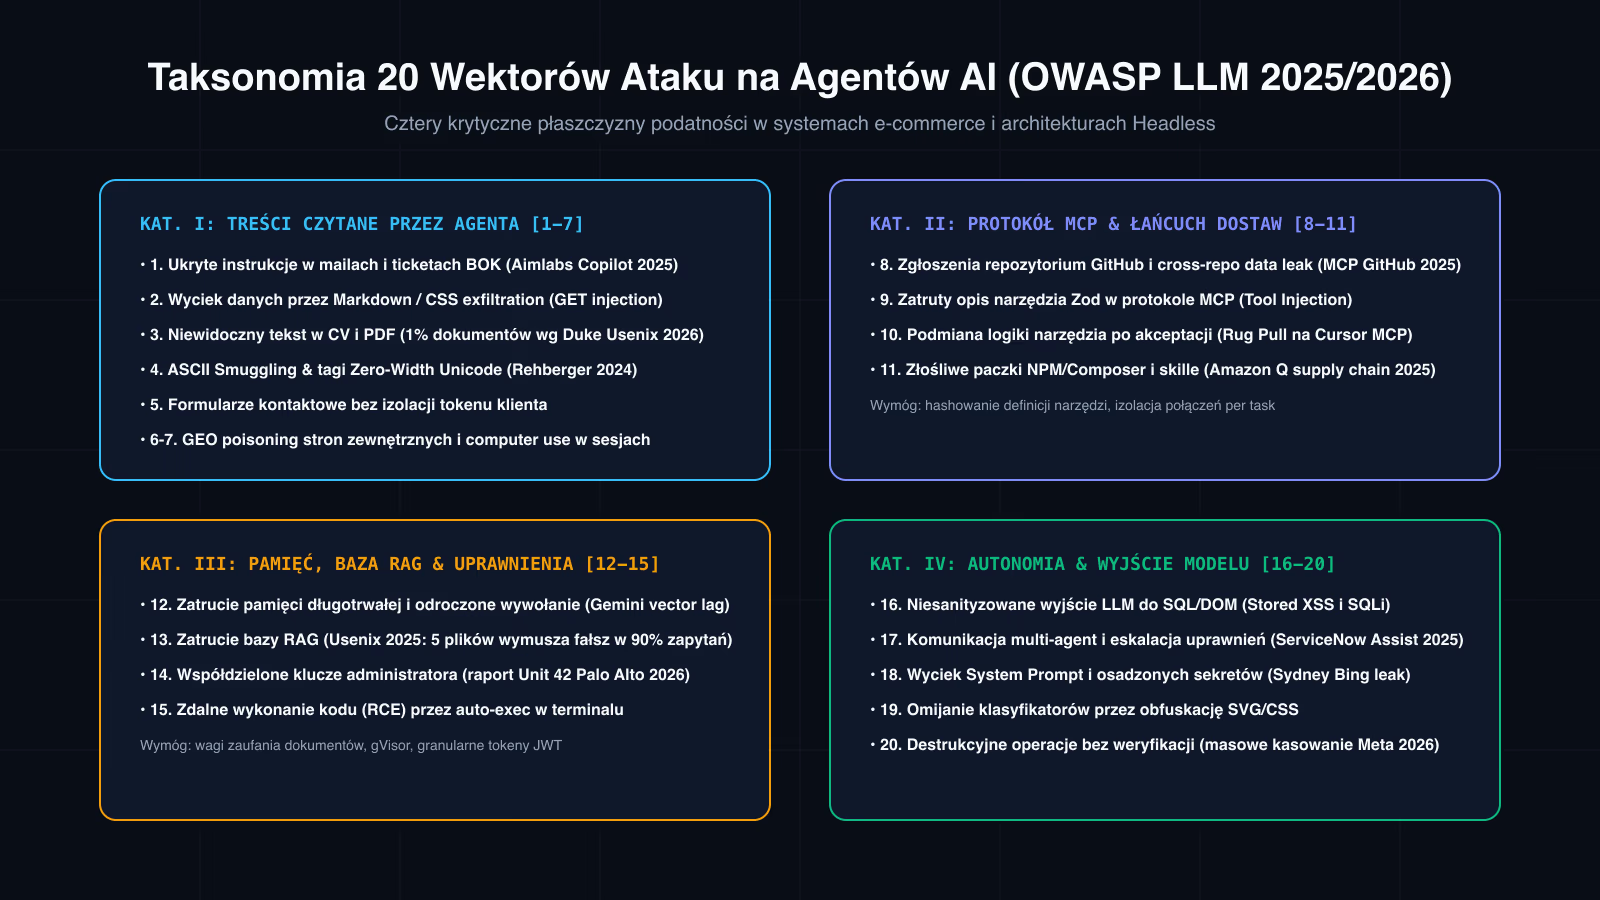
Como arquitecto de sistemas web e integraciones de IA en plataformas empresariales, audito periódicamente despliegues en los que las prisas por automatizar han desplazado las normas esenciales de higiene del código. En este análisis detallo los 20 vectores de ataque más críticos contra agentes de IA, clasificados con arreglo a las directrices de OWASP Top 10 for LLM Applications & Agents y fundamentados en incidentes reales registrados entre 2024 y 2026.
Cómo opera la tríada letal en la seguridad de los agentes de IA
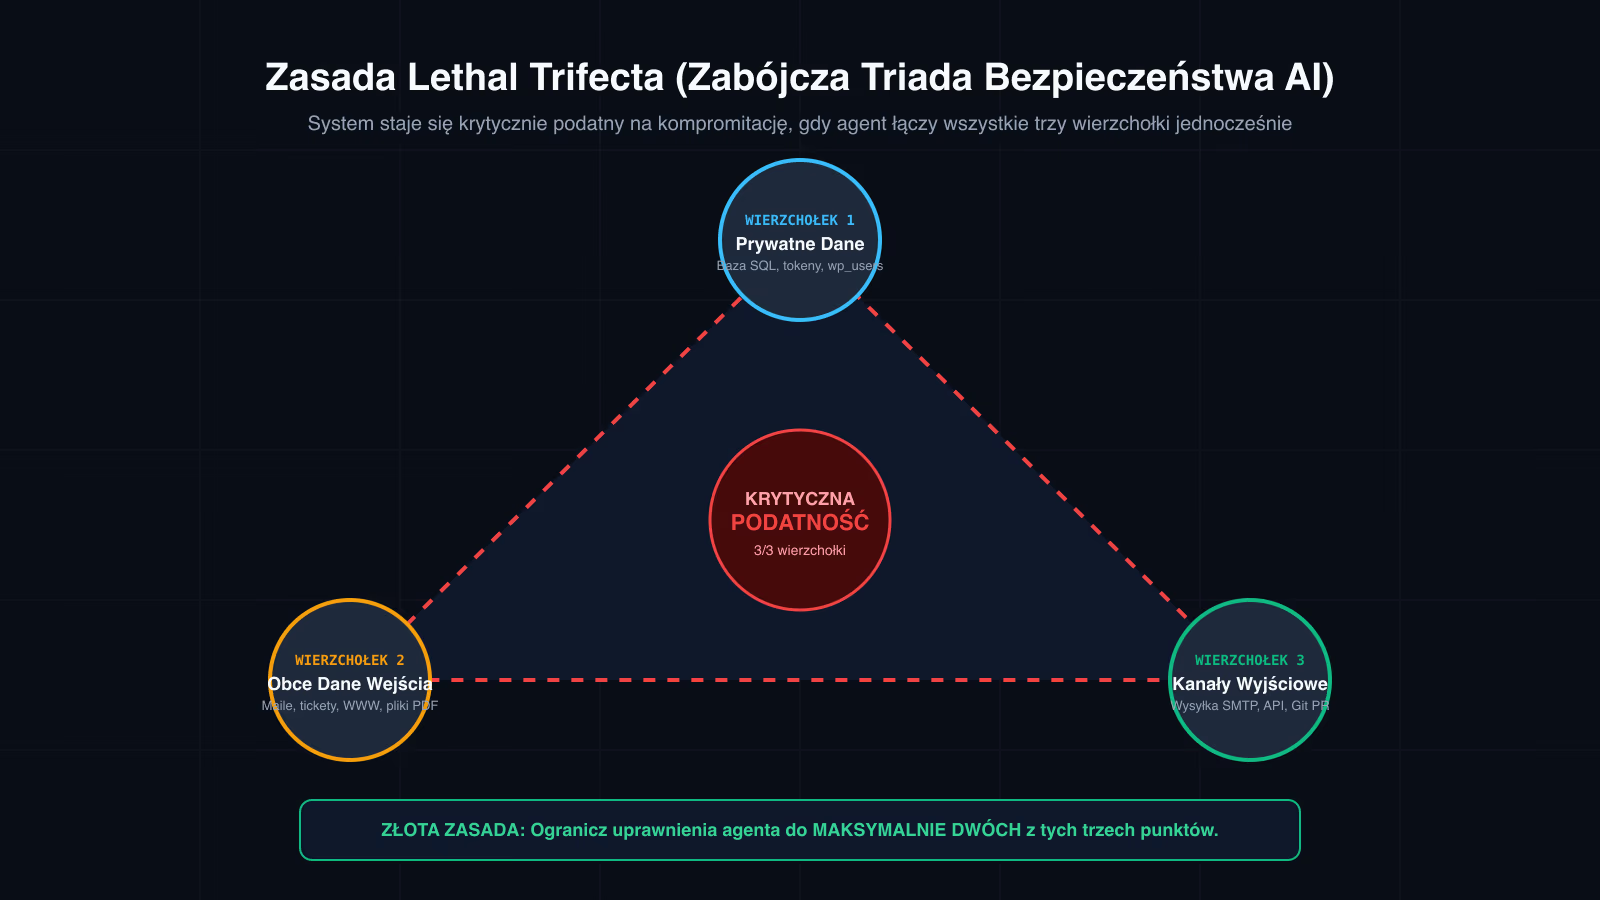
Antes de evaluar cada vulnerabilidad técnica, conviene asimilar el modelo formal de riesgo conocido en ciberseguridad como triada letal (Lethal Trifecta). Un agente autónomo de inteligencia artificial queda expuesto a un secuestro completo si, y solo si, tres condiciones coinciden en su flujo de trabajo:
- Primer vértice: Acceso a datos corporativos privados (Private Data). El agente cuenta con permisos de lectura sobre información confidencial: registros de clientes en WooCommerce, historiales de pedidos, márgenes comerciales, secretos de autenticación o repositorios Git internos.
- Segundo vértice: Ingesta de contenidos externos no verificados (Untrusted Input). El agente procesa textos redactados por terceros: mensajes de correo entrantes, formularios públicos de contacto, páginas web de competidores o documentos PDF adjuntos.
- Tercer vértice: Canales externos de salida con impacto directo (External Output Channels). El agente tiene la potestad de ejecutar acciones hacia el exterior: emitir correos vía SMTP, lanzar peticiones HTTP POST hacia APIs externas, generar cambios en repositorios o escribir directamente en la base de datos de producción.
La regla de oro de blindaje que impongo en los desarrollos de WPPoland es tajante: un mismo agente autónomo jamás debe acumular más de dos de estos tres vértices de forma simultánea. Si un asistente analiza correos de clientes (vértice 2) y consulta el historial de pedidos (vértice 1), bajo ningún concepto debe poseer una herramienta de envío directo por SMTP (vértice 3). Su respuesta debe quedar confinada en una cola de validación donde un supervisor humano o un motor determinista autorice el envío. Ignorar este principio desencadena los 20 vectores que desgloso a continuación.
Categoría I: Ingesta de contenidos y entradas externas no confiables
Esta primera categoría engloba situaciones en las que el modelo de lenguaje incorpora datos ajenos como contexto de trabajo. Los atacantes aprovechan la capacidad semántica del modelo para colar órdenes ocultas que desautorizan las directivas originales del sistema.
1. Cómo frenar el prompt injection en correos de soporte y tickets
Cuando conectas agentes de IA a bandejas de entrada de atención al cliente o gestores de incidencias, estos leen mensajes sin depurar. Un atacante puede remitir una consulta aparentemente legítima que contenga órdenes camufladas pidiendo al modelo que adjunte el historial confidencial de otras conversaciones o revele datos de otros usuarios.
En enero de 2025, el equipo de investigación de Aimlabs comprobó este fallo frente a Microsoft Copilot: un correo con directivas escritas en Markdown forzó al asistente a filtrar datos privados en los parámetros de una imagen remota, esquivando los filtros perimetrales.
En plataformas WooCommerce, desacoplo de raíz la clasificación semántica del canal de envío. El agente solo cataloga el ticket en la base de datos; la contestación al cliente se elabora exclusivamente con plantillas predefinidas y verificadas.
2. Cómo impedir la fuga de datos mediante el renderizado de imágenes Markdown
Si el panel de control o la interfaz de chat admite Markdown, el modelo puede generar etiquetas de imagen vinculadas a servidores ajenos. Si una instrucción maliciosa obliga al asistente a generar una etiqueta de imagen con variables de contexto como parámetros de URL, el navegador del administrador descargará esa imagen en cuanto renderice la pantalla.
Esa simple petición GET traslada datos confidenciales (claves de sesión, nombres de clientes o correos) directamente a los registros del atacante.
En las interfaces web, aplico una estricta política de seguridad de contenidos (Content Security Policy o CSP) que limita la carga de recursos a dominios de confianza, elimino cualquier parámetro de consulta en los enlaces creados por la IA y desactivo la visualización automática de imágenes remotas.
3. Cómo detectar texto invisible en archivos PDF y currículums
Los sistemas de selección de personal, homologación de proveedores y recepción de facturas emplean IA para valorar documentos PDF. Investigadores de Duke University presentaron en Usenix Security 2026 un estudio sobre casi 200.000 currículums: cerca del 1% albergaba instrucciones imperceptibles para el ojo humano (letras blancas sobre fondo blanco, tipografías de 0,1 puntos o metadatos ocultos) ordenando al modelo situar al aspirante en primera posición.
Para contrarrestar esto en flujos de subida de archivos, implanto una verificación cruzada (diffing): el texto digital extraído del PDF se confronta con la salida de un motor de reconocimiento óptico de caracteres (OCR) aplicado sobre el renderizado visual de la página. Si aparecen discordancias notables en el volumen o contenido del texto, el archivo se traslada a cuarentena.
4. Qué es el ASCII smuggling y la explotación de caracteres Unicode invisibles
El estándar Unicode cuenta con caracteres especiales de control y marcado que carecen de anchura gráfica en pantalla, tales como espacios de ancho cero (zero-width spaces) o etiquetas invisibles. El método de ASCII Smuggling, documentado por Johan Rehberger en 2024, aprovecha estos símbolos para ocultar cargas maliciosas dentro de frases legibles.
Una persona solo observa un párrafo normal, pero el modelo de lenguaje lee la totalidad de los tokens y ejecuta las directivas invisibles.
Cualquier dato recibido mediante formularios web o endpoints REST debe procesarse con expresiones regulares que eliminen caracteres no imprimibles antes de inyectar el texto en el contexto del modelo.
5. Cómo restringir los permisos del agente en formularios de contacto
Los formularios abiertos al público son una puerta de entrada para inyectar instrucciones. Un atacante puede utilizar los campos de texto libre para dictar comandos de modificación de base de datos o solicitar el restablecimiento de credenciales de otros usuarios. Si el agente asignado a la lectura dispone de privilegios globales, ejecutará los cambios en todo el sistema.
La solución reside en la compartimentación de accesos: el agente debe operar con credenciales limitadas en el tiempo que solo permitan consultar los registros asociados al correo electrónico verificado del remitente, sin ningún acceso a tablas globales como wp_users.
6. Cómo resguardar agentes de investigación frente a webs envenenadas
Los agentes autónomos programados para rastrear el mercado o supervisar precios consultan el código HTML de páginas externas. El analista Nick Evers evidenció en 2024 que etiquetas CSS ocultas (display: none) o directivas en el archivo robots.txt bastan para secuestrar el flujo del rastreador.
Si más tarde ese agente confecciona un informe ejecutivo interno, arrastra las instrucciones maliciosas al corazón de la red corporativa.
Los agentes de rastreo deben aislarse en un entorno estanco (sandbox), y sus salidas tienen que normalizarse en estructuras JSON estrictas sin admitir fragmentos HTML.
7. Por qué los agentes de navegación no deben tocar sesiones autenticadas
Los asistentes que interactúan con navegadores web (mediante herramientas como Playwright o Puppeteer) para realizar tareas en nombre del usuario pueden verse comprometidos por sitios maliciosos. En 2025 se detectaron brechas donde una web hostil logró que un asistente leyera cookies de sesión y ejecutara operaciones administrativas en la cuenta del usuario.
Los agentes de navegación jamás deben compartir perfiles de navegador ni cookies con sesiones administrativas. Toda interacción debe transcurrir en instancias temporales, aisladas de la red interna y sin contraseñas almacenadas.
Categoría II: Arquitectura de integración, red y protocolo MCP
La segunda categoría analiza los puentes de comunicación e integración entre el modelo y los sistemas externos, con especial foco en el Model Context Protocol (MCP).
8. Cómo blindar agentes de código frente a la fuga de credenciales
Los agentes de asistencia técnica en programación con acceso a repositorios Git examinan código y registros de fallos. Si una incidencia pública o una petición de incorporación de código (pull request) ajena incorpora una inyección, el agente puede ser engañado para extraer variables de entorno (.env) o credenciales de otros proyectos.
Un fallo documentado en Amazon Q en 2025 demostró cómo un asistente podía exponer secretos de repositorios privados ante usuarios no autorizados a través de sus respuestas.
Los agentes de desarrollo deben trabajar con claves acotadas a un único repositorio, bloqueando por sistema operativo el acceso a ficheros que contengan credenciales.
9. Qué riesgos entrañan las descripciones envenenadas en herramientas MCP
El estándar Model Context Protocol (MCP) promovido por Anthropic permite al modelo descubrir e invocar herramientas de manera dinámica. El asistente decide qué herramienta ejecutar basándose en la descripción textual incluida en el manifiesto del servicio.
Si un servidor MCP comprometido altera esa descripción, puede inducir al modelo a transferir parámetros confidenciales hacia un destino externo. En 2025 se localizaron diversos paquetes MCP de código abierto concebidos deliberadamente para interceptar claves API fingiendo ser funciones accesorias legítimas.
Todo servidor MCP implementado en la empresa debe estar firmado digitalmente y auditado en su esquema. No se deben aceptar descripciones dinámicas sin previa validación humana.
10. Cómo evitar ataques de sustitución rug pull al actualizar servidores MCP
Un servidor MCP que hoy resulta inofensivo puede volverse dañino tras una actualización desatendida (Rug Pull). Si el agente carga la definición de herramientas desde un repositorio externo cada vez que arranca, la toma de control del proyecto de origen basta para comprometer toda la red de agentes.
A lo largo de 2025 se produjeron varios incidentes de este tipo en entornos de desarrollo, donde extensiones conocidas pasaron a requerir permisos desproporcionados de forma repentina.
En las infraestructuras que configuro en WPPoland, los manifiestos MCP se bloquean mediante firmas hash SHA-256. Si la definición descargada difiere en un solo byte respecto a la versión aprobada, el middleware interrumpe el arranque de inmediato.
11. Cómo auditar la cadena de suministro de módulos y skills para agentes
Entornos de desarrollo como LangChain y CrewAI ofrecen catálogos de habilidades de terceros para conectar servicios externos. Muchos de estos módulos proceden de repositorios mantenidos por programadores individuales.
Un análisis de estas dependencias en 2025 destapó casos con telemetría no declarada y puertos de depuración expuestos sin autenticación.
Las organizaciones deben someter los módulos de IA a los mismos filtros de cadena de suministro aplicados al software empresarial: clonación en registros privados y escaneos periódicos contra bases de datos de vulnerabilidades.
Categoría III: Infraestructura de datos, memoria y privilegios
La tercera categoría se centra en los almacenes de información: bases de datos vectoriales, sistemas RAG, memoria a largo plazo y entornos de computación.
12. Cómo proteger la memoria persistente del agente contra el envenenamiento
Los agentes que conservan memoria a largo plazo almacenan datos de usuarios e interacciones en bases de datos o almacenes clave-valor. Un usuario hostil puede, a través de sucesivas conversaciones aparentemente normales, inyectar datos manipulados o directivas permanentes (Memory Poisoning).
Días después, cuando un directivo haga una consulta al sistema, el modelo recuperará esa memoria envenenada y ejecutará la orden oculta del atacante.
La memoria persistente debe estructurarse en compartimentos estancos según el nivel de confianza. La información captada en la atención al cliente jamás debe combinarse con la memoria utilizada en procesos administrativos. Además, cada registro de memoria debe contar con caducidad temporal (TTL) y verificación de integridad.
13. Por qué cinco documentos maliciosos pueden desestabilizar una base RAG
En los sistemas RAG, el modelo rescata fragmentos de texto en función de su afinidad semántica. Investigadores de Unit 42 de Palo Alto Networks demostraron en 2026, utilizando Google Vertex AI, que introducir cinco archivos diseñados con precisión en una colección de decenas de miles de documentos bastaba para situarlos de manera consistente en la cima de los resultados para términos clave.
Si esos cinco archivos esconden comandos maliciosos, el atacante toma el mando de las respuestas que la IA ofrezca sobre esa temática.
Las arquitecturas RAG exigen control de accesos a nivel documental. Los contenidos no verificados no pueden compartir la misma colección vectorial que los protocolos internos y los datos estratégicos.
14. Por qué compartir tokens de administrador es una temeridad
Es habitual que varios procesos compartan un mismo token con permisos de administrador por comodidad técnica. Si un atacante secuestra un agente secundario de lectura, consigue acceso ilimitado para modificar o borrar registros en toda la base de datos debido a los permisos heredados del token compartido.
Un incidente reportado en ServiceNow Assist en 2025 mostró cómo un asistente de soporte técnico modificó registros protegidos a raíz del uso de credenciales conjuntas con permisos excesivos.
Cada función del ecosistema debe operar con una cuenta de servicio específica bajo el criterio de mínimo privilegio (least privilege). Un agente destinado a consultas jamás debe contar con credenciales que admitan modificaciones.
15. Cómo aislar la ejecución en terminales mediante sandboxes gVisor
Cuando permites que un agente ejecute código o comandos de shell, se genera el riesgo de escape del entorno de ejecución (Container Escape). Los contenedores Docker convencionales comparten el kernel de Linux con la máquina física, lo que resulta insuficiente frente a fallos del núcleo.
Para agentes que ejecutan procesos, recurro a entornos estancos como gVisor de Google o micro-máquinas virtuales Firecracker. Estas tecnologías interceptan las llamadas al sistema en el espacio de usuario e impiden que un proceso secuestrado salte al servidor físico o a otras instancias vecinas.
Categoría IV: Autonomía del modelo y tratamiento de respuestas
La cuarta categoría atiende al tratamiento de los datos devueltos por el modelo, la gestión de la incertidumbre y la colaboración entre múltiples agentes.
16. Por qué nunca se debe confiar en la respuesta directa del modelo para SQL o DOM
Un modelo de lenguaje elabora textos basándose en distribuciones probabilísticas. Si trasladas sus respuestas de forma directa a consultas de base de datos o las integras sin depurar en el DOM de una página web, abres la puerta a inyecciones SQL y ataques de secuencias de comandos en sitios cruzados (XSS).
Las salidas del modelo no pueden considerarse información saneada. Cualquier interacción con la base de datos debe instrumentarse mediante sentencias parametrizadas, y las respuestas renderizadas en pantalla deben codificarse como texto sin formato o procesarse con bibliotecas de escape contrastadas.
17. Cómo evitar la escalada de privilegios en la comunicación entre subagentes
En entornos con múltiples agentes, un coordinador asigna misiones a diversos subagentes especializados. Si un asistente subordinado se ve comprometido por una entrada maliciosa, puede enviar confirmaciones fraudulentas al planificador y provocar acciones que dicho subagente no tendría autorización para ejecutar (Privilege Escalation).
El intercambio de datos entre agentes debe respetar esquemas tipados con rigor (como Zod o Pydantic). Cada componente debe revalidar de forma independiente si el solicitante posee atribuciones para pedir esa acción.
18. Cómo salvaguardar los prompts de sistema y los secretos embebidos
Muchos programadores intentan proteger claves de acceso o instrucciones confidenciales añadiendo al prompt: “No compartas bajo ninguna circunstancia esta información con el usuario”.
Este método carece de eficacia ante técnicas de extracción mediante rol o ingeniería de contexto (Prompt Leaking). Las directivas de sistema deben considerarse información expuesta. Las claves de acceso y la lógica empresarial crítica deben residir en servidores seguros alejados del prompt.
19. Cómo evitar la evasión de filtros mediante ofuscación
Los atacantes recurren a técnicas de enmascaramiento como Base64, combinación de idiomas o paráfrasis matemáticas para sortear los filtros de palabras prohibidas.
Un filtro por expresiones regulares no basta para contener estas variantes. Una arquitectura defensiva solvente combina filtros heurísticos con modelos de análisis semántico dedicados a identificar la intención del texto antes y después de su procesamiento.
20. Por qué las acciones irreversibles exigen aprobación humana
La autonomía absoluta para ejecutar acciones críticas desemboca tarde o temprano en incidencias operativas. En 2026, los equipos de ciberseguridad de Meta expusieron cómo un asistente en fase de pruebas eliminó correos administrativos esenciales de forma irreversible al desorientarse en el contexto de una conversación.
Cualquier operación que implique destrucción de información (borrado de filas, devoluciones económicas o cancelaciones) debe contar con mecanismos de eliminación lógica (soft delete), registros de auditoría y la autorización obligatoria de una persona cualificada (Human-in-the-Loop).
Marco regulatorio: Transposición NIS2, Esquema Nacional de Seguridad (ENS) y RGPD
Para las empresas que operan en España, la protección de los sistemas de inteligencia artificial constituye una obligación jurídica indiscutible. El Real Decreto-ley 12/2018 y el nuevo marco normativo de transposición de la Directiva NIS2 imponen a las entidades esenciales e importantes el deber de adoptar medidas técnicas y organizativas adecuadas y proporcionadas para gestionar los riesgos que afecten a la seguridad de sus redes y sistemas de información.
Asimismo, el Esquema Nacional de Seguridad (ENS, Real Decreto 311/2022) exige a las entidades del sector público y a sus proveedores tecnológicos garantías contrastadas en la gestión de accesos y la trazabilidad de operaciones. En el plano de la privacidad, el artículo 32 del RGPD demanda medidas técnicas que garanticen la resiliencia y confidencialidad permanente de los sistemas de tratamiento. Organismos como el Centro Criptológico Nacional (CCN-CERT), el Instituto Nacional de Ciberseguridad (INCIBE) y la Agencia Española de Protección de Datos (AEPD) consideran la falta de blindaje en sistemas generativos una negligencia grave sujeta a sanciones de peso.
Cómo diseña WPPoland arquitecturas corporativas seguras para IA
Abordo la inteligencia artificial con el rigor de la ingeniería de sistemas. Planifico, blindo y audito arquitecturas basadas en WordPress Headless, WooCommerce y agentes autónomos de IA:
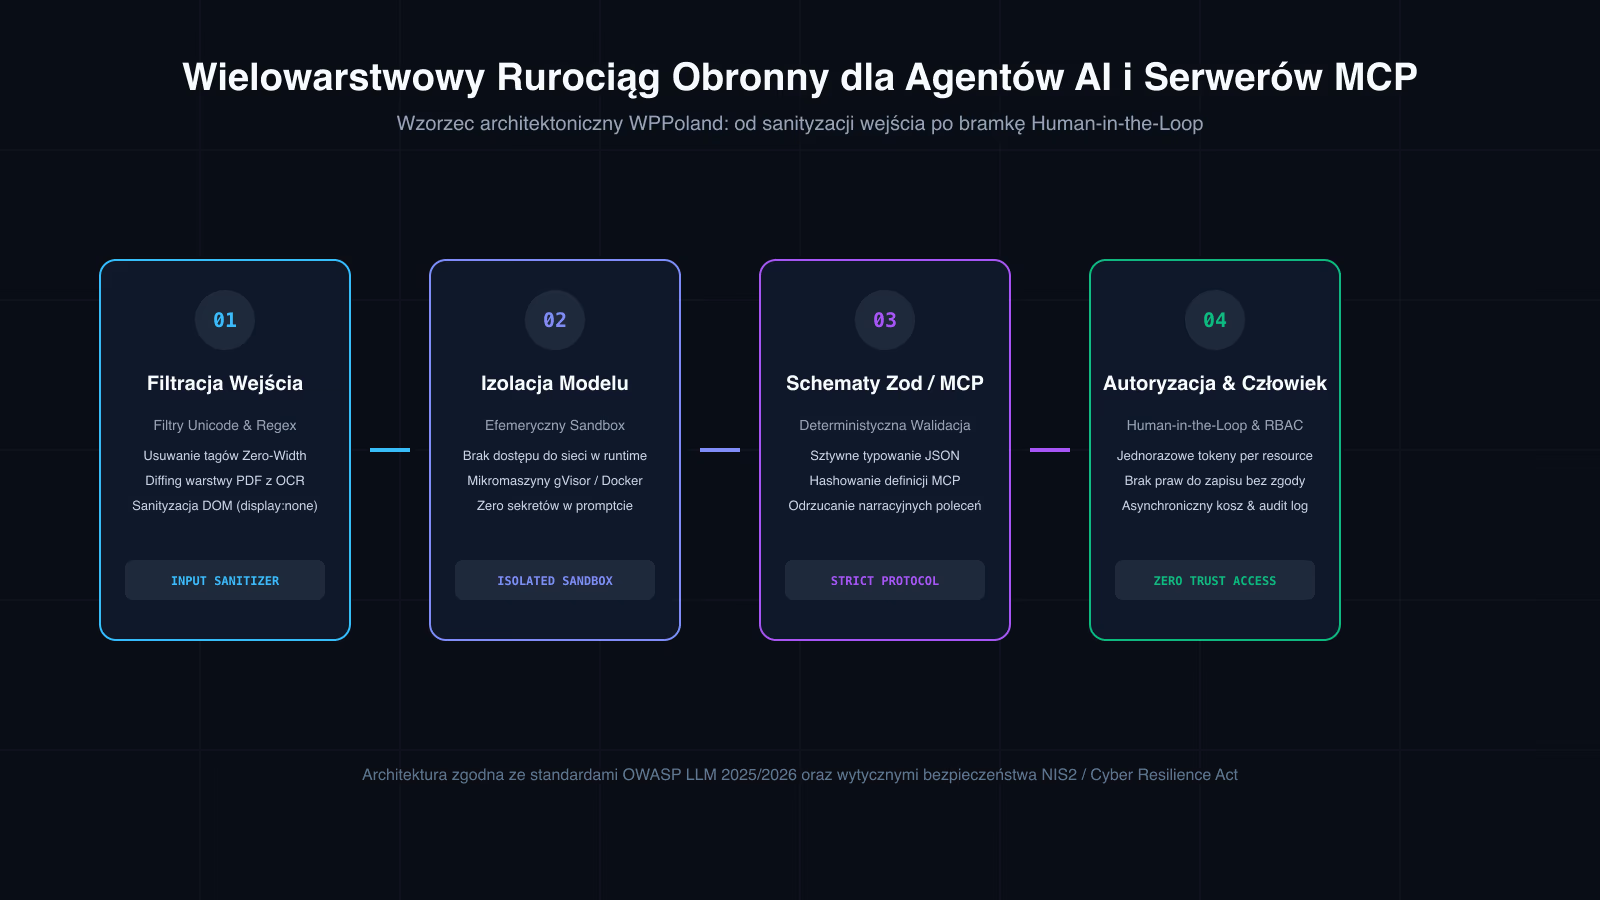
- Depuración de entradas por fases: filtro caracteres Unicode invisibles, estructuras Markdown fraudulentas y PDF manipulados antes de que lleguen al contexto del modelo.
- Servidores MCP blindados: conectores Model Context Protocol con tipado Zod, hashes criptográficos y credenciales compartimentadas.
- Infraestructura aislada en Europa: servidores dedicados Hetzner, sandboxes gVisor y Cloudflare WAF, para soberanía de datos en la UE.
- Supervisión humana en procesos sensibles: doble confirmación en transacciones críticas, no autonomía ciega.
Cómo se desarrolla el encargo
Consultoría, auditoría y desarrollo los cobro según la página de precios de WordPress; este artículo no publica tarifas.
- Ad-hoc y soporte ante incidentes: auditorías urgentes, análisis de prompt injection, endurecimiento inmediato de endpoints REST o GraphQL.
- Proyectos de mayor recorrido: modernización arquitectónica, servidores MCP seguros, paso a Headless, preparación para auditorías NIS2.
La seguridad en los ecosistemas de inteligencia artificial responde a una ingeniería rigurosa. Si tienes previsto implementar agentes autónomos o deseas someter tus sistemas actuales a una auditoría técnica, ponte en contacto conmigo a través del formulario.