Mantengo yo solo una web en seis idiomas y escribo buena parte de ella con ayuda de Claude Code. Cada texto pasa por el skill humanizer, los textos en polaco también por miodkuj, y después por un conjunto de comprobaciones deterministas que viven en el mismo repositorio. Si tu equipo publica documentación, archivos README, notas de versión o un blog de empresa con Claude Code, Codex o Cursor, esta guía te explica qué hace cada skill antislop, qué prueban sus evaluaciones, por qué ninguno revisa tu español y cómo montar una comprobación en CI que bloquee lo que debe bloquear.
¿Qué es un skill antislop y qué hace cada uno?
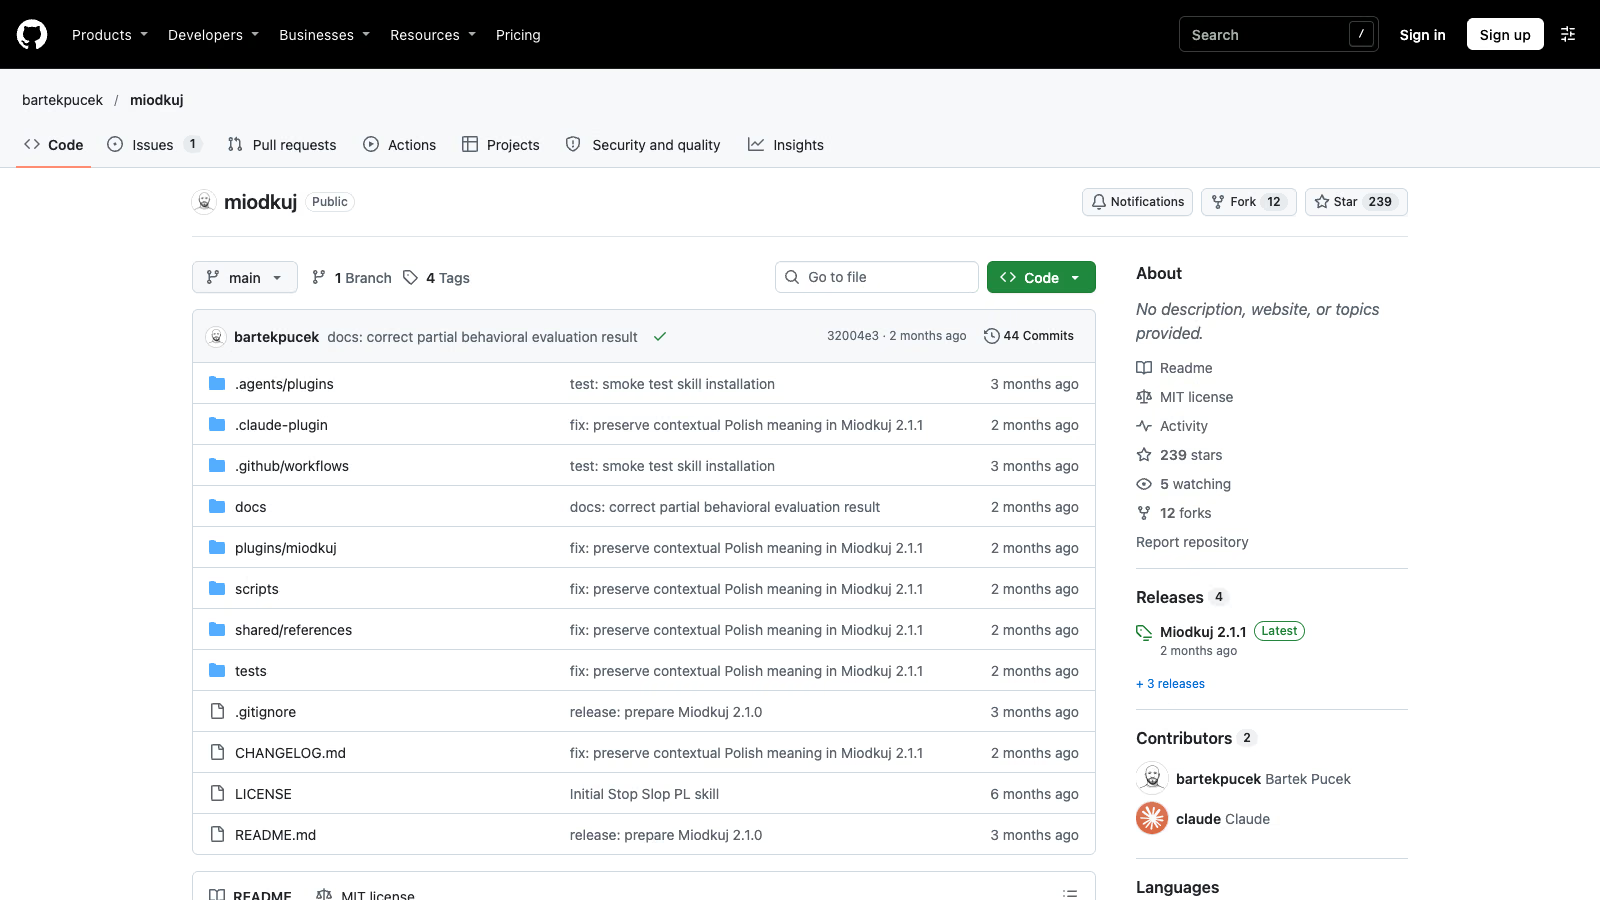
Un skill es una carpeta con un archivo SKILL.md que el agente carga cuando la tarea lo pide. Los skills antislop contienen instrucciones para detectar y reescribir los rasgos típicos de un texto generado por un modelo: aperturas que anuncian lo que viene, contrastes del tipo «no es esto, es aquello», tríadas forzadas, frases de cierre que repiten la idea y vocabulario inflado. Revisé tres en su fuente original en GitHub.
| Skill | Qué hace | Evidencia publicada | Cuándo usarlo |
|---|---|---|---|
| humanizer (v3.1.0, MIT) | Revisa 26 patrones en seis secciones (puesta en escena, ritmo, inflación, formato, restos de chat, lector equivocado) y reescribe | Sin batería de evaluaciones; una prueba a ciegas abierta por un usuario | Pasada final de cualquier texto en inglés; como lista de patrones, también fuera del inglés |
| unslop (v2.3.0, sin archivo LICENSE) | Cuatro modos (teach, cleanup, rewrite, mimic) y cuatro scripts en Python que devuelven JSON | Evaluaciones propias; último resultado público: no-ship | Inglés, cuando quieres escáneres en CI y una comprobación de conservación de datos |
| miodkuj (v2.1.1, MIT) | Edición mínima de textos en polaco: lenguaje burocrático, cadenas de sustantivos, afirmaciones sin respaldo | Prueba de comportamiento propia: 12 de 13 casos y 1 parcial | Solo polaco |
humanizer es el más popular de los tres: 65.532 estrellas el 6 de noviembre de 2026, frente a 949 de unslop y 239 de miodkuj. Su SKILL.md ocupa 31,6 KiB y no trae ni escáner ni línea de comandos; el script validate-package.py del repositorio solo comprueba los archivos del paquete. unslop necesita Python 3.8 o superior y solo la biblioteca estándar, y su CI prueba las versiones 3.8 y 3.11.
¿Qué demuestran de verdad las evaluaciones de estos skills?
Menos de lo que sugieren las cifras de estrellas. Lo comprobé en los archivos de evaluación de cada repositorio.
unslop es el único con un marcador público de producto. El README dice que el último resultado independiente es un no-ship y que la beta actual no afirma una mejora comparativa validada. La prueba v9 usó el mismo modelo en ambos brazos (gpt-5.6-luna), un juez a ciegas (gpt-5.6-sol), tres documentos sucios y uno limpio, con 31 problemas anotados:
| Métrica | Luna + unslop | Luna sola | Umbral exigido |
|---|---|---|---|
| Precisión de detección | 81,25 % | 83,33 % | 90 % o más |
| Exhaustividad de detección | 83,87 % | 32,26 % | 90 % o más |
| Reparación correcta | 87,10 % | 58,06 % | 90 % o más |
| Conservación | 100 % | 100 % | 100 % |
| Tasa de daño | 11,11 % | 0 % | 0 % |
| Documentos sucios mejorados con seguridad | 0 de 3 | 0 de 3 | 80 % o más |
Con unslop el modelo encuentra muchos más problemas, pero también estropea texto que estaba bien, y ninguno de los tres documentos sucios quedó mejor sin daños. Los datos están en el archivo CORE-RESULTS.md del commit que revisé.
humanizer no tiene directorio de evaluaciones. Su README cita una prueba a ciegas en la que los jueces prefirieron la reescritura 16 veces de 16. Esa prueba es la issue 229, abierta por un usuario y no por el mantenedor, y la propia issue reconoce que todos los jueces son modelos de una misma familia y que solo se ejecutaron 77 de las 144 comparaciones previstas por fallos de infraestructura. El README es claro sobre los detectores: «Superar los detectores de IA no es un objetivo, y los detectores siguen marcando la mayor parte de su salida» (traducción propia).
miodkuj publica una prueba de comportamiento de la v2.1.1: cada versión se ejecutó una vez con un subagente de Codex sobre gpt-5.6-sol. La 2.1.1 pasó 12 de 13 casos con 1 parcial, y la 2.1.0 falló 3 de los 12 casos compartidos. El caso parcial se publicó primero como aprobado y el autor lo corrigió el mismo día. La sección de límites lo dice sin rodeos: los resultados «no establecen ninguna tasa general de fiabilidad ni mejora entre modelos» (traducción propia).
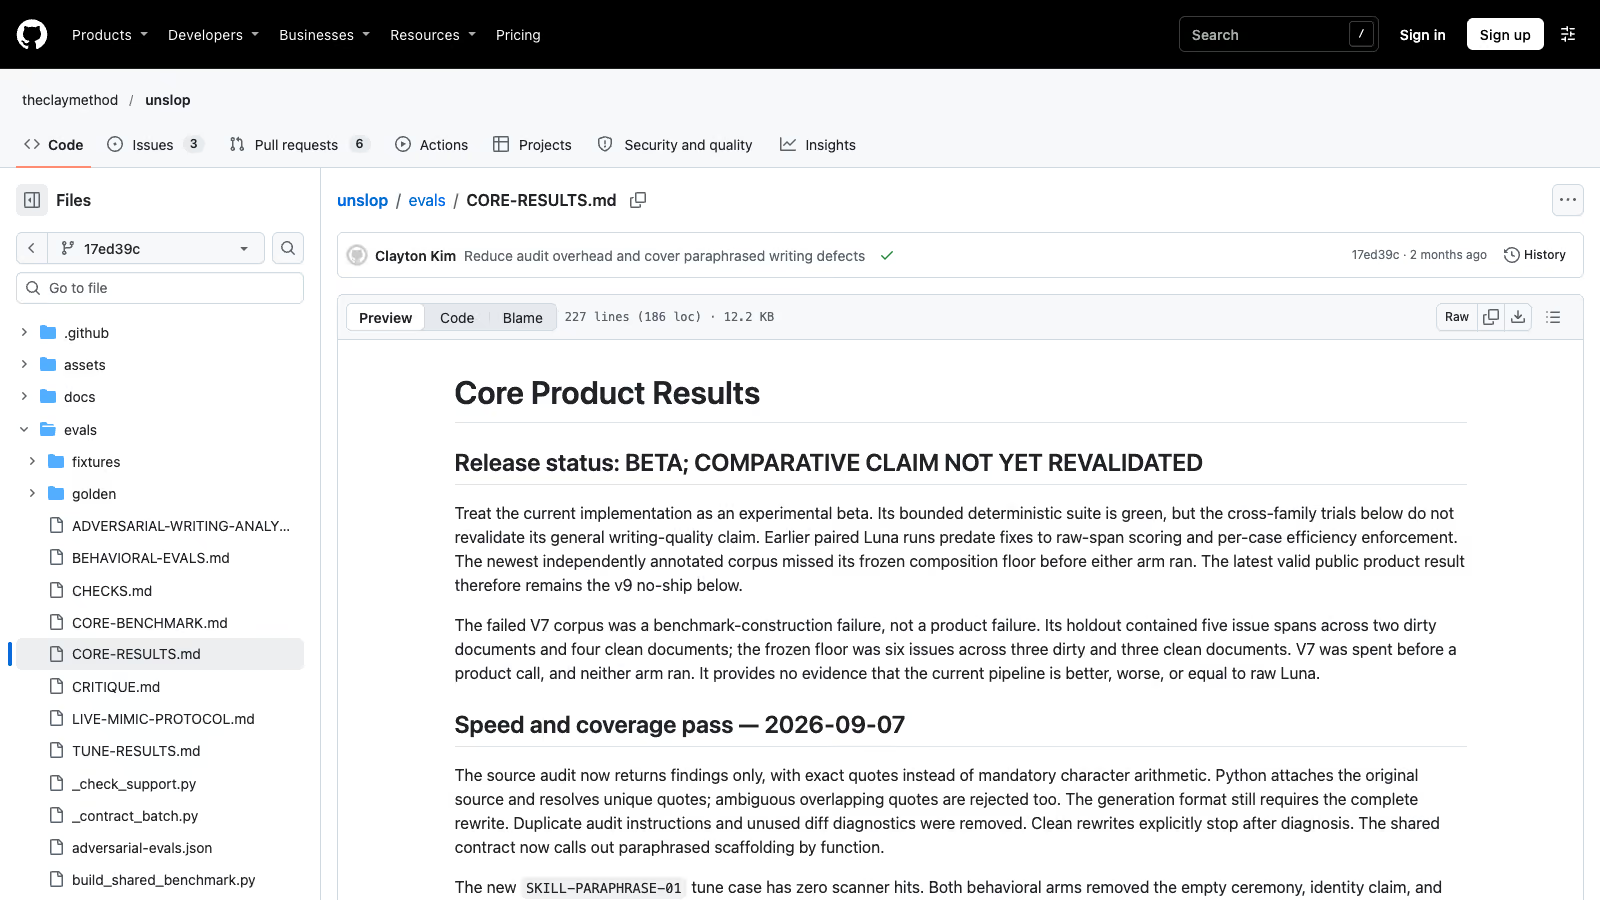 La página de evaluación de unslop en el commit 17ed39c: beta, la afirmación comparativa aún no se ha revalidado (captura del 6 de noviembre de 2026).
¿Revisan humanizer y unslop los textos en español?
No. Los escáneres de unslop llaman a una función que mide la proporción de palabras funcionales inglesas en el texto. Si el texto no supera ese umbral y no ha generado ningún hallazgo, el script imprime {"non_english": true, ...}, escribe un aviso en stderr y sale con código 0. El README lo resume así: «Solo inglés. La entrada en otro idioma recibe una detección barata y un rechazo claro» (traducción propia).
En CI esto tiene una consecuencia concreta. Si pasas los escáneres sobre tu documentación en español y el job sale en verde, ese verde quiere decir que nadie ha revisado el texto. Hay un segundo matiz: las entradas de menos de 15 palabras siempre se tratan como inglés, así que un fragmento corto en español sí se escanea con listas pensadas para el inglés.
humanizer no tiene escáner. Sus 26 patrones están escritos en inglés y con ejemplos en inglés. Yo lo uso sobre los textos en español como lista de comprobación para el modelo, porque varios patrones (la apertura que anuncia, la tríada forzada, la frase final que resume) aparecen igual en cualquier idioma, pero el skill no promete nada sobre el español y no conozco ninguna evaluación que lo mida.
Tampoco encontré un skill antislop específico para el español con una fuente verificable. Para el polaco existe miodkuj; para el español no tengo ninguno comprobado que recomendarte.
¿Qué compruebo yo en los textos en español de esta web?
Como no hay skill verificado para el español, el trabajo lo hacen comprobaciones deterministas que escribí para errores que ya me habían llegado a producción. Todas son scripts de Node en el repositorio de esta web. Estas son las que afectan a un texto en español, con las cifras sacadas del código:
| Comprobación | Qué busca | Tamaño | Cuándo bloquea |
|---|---|---|---|
check-reader-address.mjs | Trato de usted en páginas en español (aquí se tutea), du en alemán, tu en portugués europeo | Presupuesto 0 para el español | En npm run check, si supera el presupuesto |
check-diacritic-wordlist.mjs | Palabras españolas sin tilde conocidas (tambien, codigo, auditoria) | 1351 pares en es-diacritic-pairs.json | Con --check |
check-loanword-density.mjs | Jerga de agencia en inglés dentro de un texto que no es inglés | Falla con 12 apariciones y 5 por cada 1000 palabras | En npm run check, sobre los archivos cambiados |
check-voice-rules.mjs | Rayas largas, verbos de relleno, nombres de ejemplo genéricos, estadísticas redondas inventadas, encabezados en Title Case | 42 reglas | Con --fail-on-findings |
check-slop-rhetoric.mjs | Forma de la frase: aperturas que anuncian sinceridad, frases que inflan la importancia, atribuciones vagas a expertos, con variantes en español para varios patrones | 12 patrones, 11 activos por defecto | Con presupuesto 0 en npm run check |
Las dos primeras nacieron de fallos reales en español. El comentario de check-reader-address.mjs recuerda que unas 60 entradas en español seguían en usted hasta el 23 de octubre de 2026, porque las pasadas de traducción volvían una y otra vez a ese registro. La lista de tildes existe porque un commit tuvo que restaurar unas 10.400 palabras sin acento en 367 archivos en español y portugués, y la comprobación de densidad de acentos que había entonces dio por buenos esos archivos antes y después del arreglo.
La lista de tildes también enseña dónde está el límite de una lista de palabras. numero, practica, publico o pagina son formas verbales correctas, así que el script solo las marca como aviso y nunca bloquea por ellas. Una herramienta que no distingue entre «la página» y «él pagina» no puede corregir sola.
Ejecuté hoy estas comprobaciones sobre todo el contenido de la web. check-reader-address.mjs dio 0 apariciones de usted en las páginas en español, con presupuesto 0. check-diacritic-wordlist.mjs revisó 7316 archivos traducidos y encontró 0 palabras sin tilde de su lista de errores conocidos. check-slop-rhetoric.mjs revisó 8681 archivos con un total de 0 hallazgos.
¿Por qué un escáner en verde no certifica que el texto está bien?
Porque mide palabras y formas de frase, y un buen texto depende de si cada frase hace su trabajo. La página de Wikipedia Signs of AI writing (WP:AISIGNS) lo advierte de forma explícita: «Por favor, no trates estas señales simplemente como los problemas que hay que arreglar; eso solo podría hacer más difícil la detección» (traducción propia). Si eliminas las marcas visibles y dejas el vacío de fondo, el texto sigue igual de vacío y además ya no lo delata nada.
unslop dice lo mismo desde el lado de la herramienta. Su README afirma que «los escáneres sugieren candidatos; el agente comprueba cada uso en su contexto», y añade que «ni un escaneo limpio ni una frase conocida demuestran quién escribió el texto, y las comprobaciones no pueden garantizar que haya desaparecido todo defecto» (traducción propia).
Mis propias cifras van en la misma línea. Que las tres comprobaciones salgan a cero en toda la web demuestra que las listas de palabras prohibidas están limpias. No demuestra que la prosa sea buena. Por eso el orden en mi repositorio es fijo: primero escribo, después paso humanizer en modo archivo, en polaco también miodkuj, y al final las comprobaciones. La regla del repositorio prohíbe publicar una entrada nueva o ampliada sin las dos pasadas, y ninguna comprobación sustituye a leer el texto.
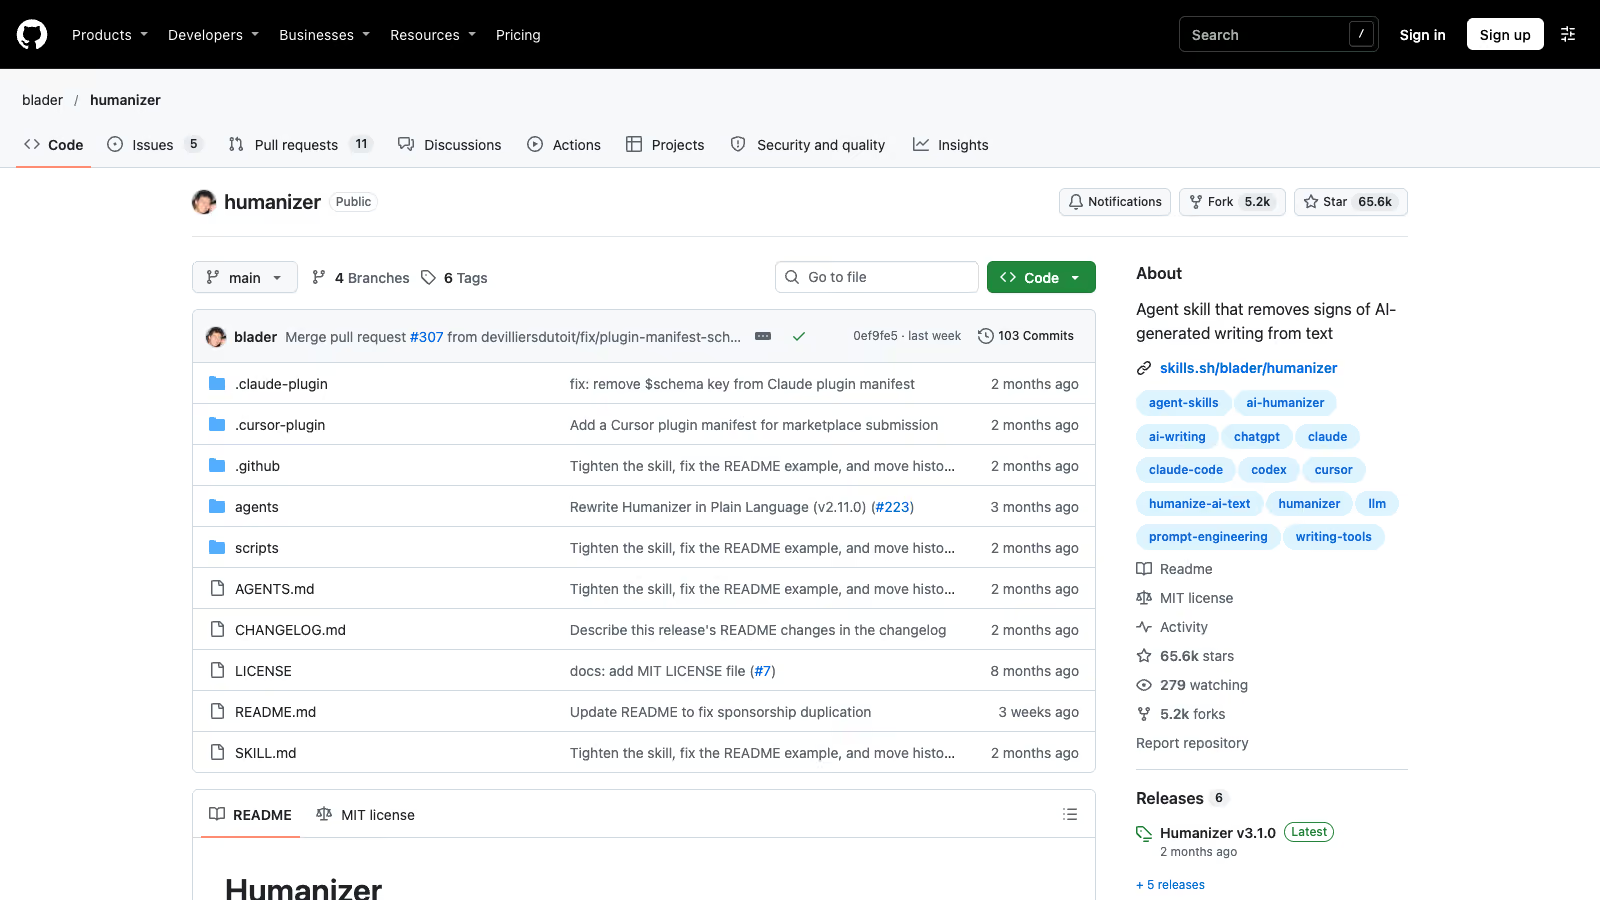 El repositorio blader/humanizer: licencia MIT, versión v3.1.0 (captura del 6 de noviembre de 2026).
¿Cómo bloqueo en CI solo los hallazgos graves de unslop?
Los cuatro scripts de unslop devuelven JSON y salen con un código distinto de cero cuando encuentran algo. La trampa está en la gravedad. banned_phrase_scan.py sale con 1 ante cualquier violación, sea hard o soft; en su código hay 38 entradas graves y 14 leves. structure_scan.py y silhouette_scan.py marcan todos sus hallazgos como soft y aun así salen con 1. Si tu job se fía del código de salida, bloqueará por sugerencias de estilo.
La solución es leer el JSON. Este workflow de GitHub Actions revisa los archivos Markdown cambiados en un pull request, falla solo con violaciones hard, trata el código 2 como error de lectura y avisa cuando el texto no se ha revisado por estar en otro idioma:
name: anti-slop
on:
  pull_request:
    paths: ["docs/**/*.md", "README.md", "CHANGELOG.md"]

jobs:
  scan:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
      - uses: actions/setup-python@v5
        with:
          python-version: "3.11"
      - name: Block only hard findings
        run: |
          fail=0
          for f in $(git diff --name-only --diff-filter=AM "origin/${{ github.base_ref }}...HEAD" -- '*.md'); do
            code=0
            python3 tools/unslop/scripts/banned_phrase_scan.py "$f" > scan.json || code=$?
            if [ "$code" -ge 2 ]; then
              echo "::error file=$f::scanner could not read the file"
              fail=1
              continue
            fi
            python3 - "$f" <<'PY' || fail=1
          import json, sys
          path = sys.argv[1]
          r = json.load(open("scan.json"))
          if r.get("non_english"):
              print(f"::warning file={path}::NOT CHECKED: scanner is English-only")
              sys.exit(0)
          hard = [v for v in r.get("violations", []) if v.get("severity") == "hard"]
          for v in hard:
              print(f"::error file={path},line={v['line_number']}::{v['phrase']}: {v['suggestion']}")
          sys.exit(1 if hard else 0)
          PY
          done
          exit $fail
Tres detalles antes de copiarlo. La ruta tools/unslop supone que guardas una copia del repositorio dentro del tuyo, y eso choca con el problema de licencia que explico más abajo. Un archivo vacío también sale con 1, así que conviene filtrar los archivos sin contenido. Y structure_scan.py acepta --genre docs, que según el README permite las listas con etiqueta en negrita que usa la documentación de referencia; si lo añades, recuerda que todos sus hallazgos son leves y que con este script solo informarán.
¿Cómo compruebo que la reescritura no ha cambiado los hechos?
Un skill que reescribe puede borrar una cifra, una negación o una condición sin que nadie lo note. unslop trae validate_preservation.py para eso: compara el original con la versión transformada y devuelve passed, el número de restricciones conservadas y la lista de las que faltan.
python3 tools/unslop/scripts/validate_preservation.py --strict original.md reescrito.mdHay una trampa de posición. El script solo reconoce --strict cuando va como primer argumento; en cualquier otro sitio lo interpreta como nombre de archivo. Con --strict, los avisos de deriva semántica (negaciones, alcance, condicionales) también hacen fallar la comprobación. Sale con 0 si todo se conserva, con 1 si falta algo y con 2 si no puede leer un archivo.
El script está pensado para inglés. Para mis textos en español hago la misma comprobación de otra forma: miro el diff entre la versión anterior y la reescrita y compruebo que cada número, nombre propio, fecha y enlace sigue en su sitio. Es manual y lento, y hasta hoy no he encontrado nada mejor para el español.
Actualización, . La reescritura compara el texto nuevo con el borrador, así que conserva una cifra falsa con la misma fidelidad que una correcta. Si la cifra la aportó un asistente de IA, abre su cita y síguela hasta el estudio que la midió. Trakkr, que vende monitorización de la visibilidad de marcas en la búsqueda con IA, publicó el 28 de octubre de 2026 el estudio Zombie stats. Hizo a ChatGPT, Perplexity, Gemini, Claude y Google AI Overviews 200 preguntas cuya respuesta es un número y siguió 1285 estadísticas citadas hasta cinco páginas de profundidad. El 40 % llegó a un estudio que dice lo mismo, el 8 % llegó al estudio con la cifra o el contexto cambiados, otro 40 % se quedó en una fuente que no pudieron comprobar y el 11 % no llevó a ninguna parte. Los cinco asistentes repetían que el 44 % de los comerciales abandona tras un solo seguimiento, un dato que procede de un artículo de muestra de un redactor freelance publicado en la red ya en 2017 y que no cita ninguna investigación. Si el rastro acaba en una página sin fuente comprobable, quita la cifra o di en el texto que no la has podido verificar.
¿Cómo comparto un mismo skill entre Claude Code, Codex y Cursor?
Con una sola copia del skill y enlaces simbólicos relativos que apunten a ella. Kris Geusebroek lo explica en un artículo de Xebia del 3 de abril de 2026, Don’t Repeat Yourself: Sharing Skills Across Claude Code Plugins: crea un directorio skills en la raíz del proyecto, usa rutas relativas como destino del enlace y comprueba en Git que el archivo tiene el modo 120000, que es como Git marca un enlace simbólico.
mkdir -p skills .claude/skills .cursor/skills
# copia aquí la carpeta del skill: skills/humanizer/SKILL.md
ln -s ../../skills/humanizer .claude/skills/humanizer
ln -s ../../skills/humanizer .cursor/skills/humanizer
git add skills/humanizer .claude/skills/humanizer .cursor/skills/humanizer
git ls-files --stage .claude/skills .cursor/skills
# cada enlace debe empezar por 120000
La documentación de skills de Claude Code confirma que una entrada en la ubicación personal (~/.claude/skills/) o de proyecto (.claude/skills/) puede ser un enlace simbólico a otro directorio: Claude Code lee el SKILL.md del destino y carga el skill una sola vez aunque varias ubicaciones apunten al mismo sitio. Los skills de proyecto se versionan con el repositorio, así que todo tu equipo los recibe con un git pull.
Los plugins funcionan distinto. Según la documentación sobre marketplaces, un enlace dentro del directorio del propio plugin se conserva como relativo, uno que apunta a otra parte del mismo marketplace se desreferencia y su contenido se copia a la caché, y uno que sale del marketplace se omite por seguridad.
En Windows, crear enlaces simbólicos exige el modo de desarrollador o permisos elevados (mklink /D desde un símbolo del sistema con privilegios de administrador). Apúntalo en el README del repositorio, porque quien clone sin esos permisos recibirá archivos de texto en lugar de carpetas.
En el repositorio de esta web, .cursor/skills/ contiene seis enlaces relativos a ../../.claude/skills/<nombre>, el mismo patrón que propone Xebia. Mis skills personales viven en una carpeta sincronizada y ~/.claude/skills es un enlace a ella; humanizer y miodkuj están instalados a mano como carpetas normales, lo que me da los nombres cortos /humanizer y /miodkuj sin prefijo de plugin.
Para instalarlos por la vía oficial, el README de humanizer da estos comandos:
# Claude Code 2.1.142 o posterior
/plugin marketplace add blader/humanizer
/plugin install humanizer@humanizer
# se invoca como /humanizer:humanizer

# Codex
npx skills add blader/humanizer --global --agent codex
Con la instalación como plugin, Claude Code antepone el nombre del plugin al del skill. El README de miodkuj lo advierte: instalado así se invoca como /miodkuj:miodkuj, y el nombre corto solo se consigue copiando la carpeta del skill a ~/.claude/skills/miodkuj.
¿Qué licencia tienen estos skills?
humanizer y miodkuj tienen licencia MIT con su archivo LICENSE. unslop declara license: MIT en la cabecera de su SKILL.md, pero el repositorio no tiene archivo LICENSE y la API de GitHub devuelve 404 al pedir su licencia. Mientras no exista ese archivo, la licencia no está concedida de forma clara. Si tu empresa quiere copiar los scripts de unslop dentro de su repositorio para usarlos en CI, como en el workflow de arriba, pide antes al autor que publique el archivo o consulta a quien lleve los temas legales en tu empresa.
¿Qué prompts puedo copiar para la pasada final?
Estos son los que uso, adaptados a un equipo que escribe en español. Van en un bloque para que los pegues tal cual en Claude Code:
Pasa /humanizer en modo archivo sobre docs/guia-instalacion.md.
No toques el frontmatter, los bloques de código, las URL ni los números.
Edición mínima: cambia solo las frases que tengan un patrón de la lista.
Al terminar, enumera cada cambio con la frase original y la nueva.
Revisa docs/notas-version-2.4.md con los patrones de humanizer como lista de comprobación.
El texto está en español: no traduzcas ejemplos del inglés, busca el equivalente español del patrón.
Si una frase no tiene datos que la sostengan, márcala y pregúntame; no inventes cifras ni ejemplos.La última instrucción viene de miodkuj, que la formula como regla: no inventes nunca un número, un ejemplo, un cliente ni una fuente para que la prosa suene humana. Vale para cualquier idioma.
¿Por dónde empiezo si mi equipo publica documentación con IA?
Por el orden de las piezas. Elige un skill para la pasada final, y para el español eso significa usar humanizer como lista de patrones, sabiendo que no garantiza nada. Añade al CI solo comprobaciones que bloqueen errores concretos que ya hayas visto en tus textos, igual que mis listas de tildes y de trato de usted. Si usas los escáneres de unslop sobre inglés, lee la gravedad del JSON y trata non_english como «sin revisar». Y deja una persona leyendo el resultado, porque ninguna de estas herramientas certifica un texto.
Si quieres ver cómo limpio después el contenido ya publicado en WordPress, lo cuento en limpieza de contenido AI slop en WordPress. Las herramientas que adopto o descarto quedan registradas en mi radar tecnológico. Y si quieres montar este flujo en tu equipo, con los skills, los enlaces compartidos y las comprobaciones de CI adaptadas a tus idiomas, en implementación de IA describo cómo trabajo y puedes enviarme por escrito qué publica tu equipo y en qué idiomas.