Utrulling av autonome kunstig intelligens-agenter, retrieval-augmented generation (RAG) og bakgrunnsassistenter i moderne bedriftsarkitekturer og publiseringssystemer skaper en helt ny type angrepsflate. I flere tiår hvilte tradisjonell applikasjonssikkerhet på et strengt skille: inndata fra eksterne brukere ble holdt fullstendig adskilt fra den kjørbare programlogikken. I klassiske PHP- og SQL-miljøer forhindret parametriserte spørringer via $wpdb->prepare() kodeinjeksjon, fordi databasekjernen behandlet parameterne utelukkende som passive strenger.
I systemer drevet av store språkmodeller (LLM-er) forsvinner dette grunnleggende skillet. En språkmodell behandler systeminstruksjoner (system prompt), referansedokumenter fra vektorbaser og ufiltrerte inndata fra eksterne brukere i ett og samme kontekstvindu (context window). Det innebærer at enhver ekstern tekstblokk i prinsippet kan kapre modellens beslutningslogikk. Når du i tillegg utstyrer assistenten med kjørbare verktøy, Model Context Protocol (MCP) og skrivetilgang til WooCommerce-databasen din, blir et uskyldig prompt injection-angrep raskt til en direkte trussel mot drift, virksomhetsdata og etterlevelse av digitalsikkerhetsloven.
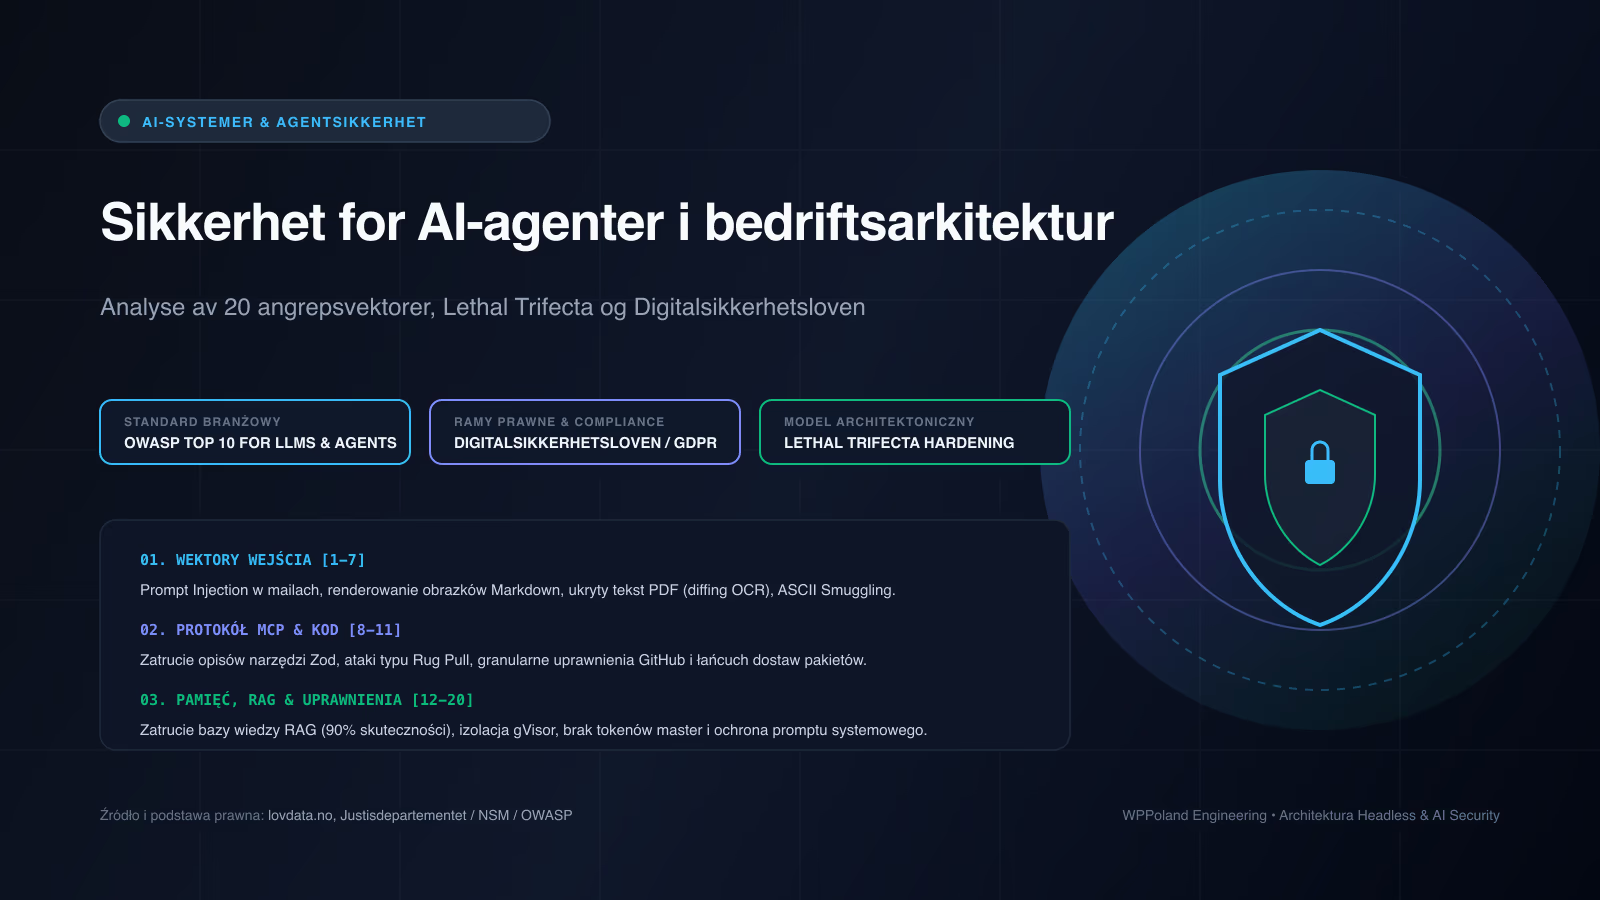
Som systemarkitekt for bedriftsløsninger og AI-integrasjoner reviderer jeg jevnlig installasjoner der iveren etter automatisering har overskygget grunnleggende prinsipper for kodesikkerhet. I denne artikkelen gir jeg en grundig teknisk gjennomgang av 20 kritiske angrepsvektorer mot AI-agenter, klassifisert etter OWASP Top 10 for LLM Applications & Agents og underbygget med dokumenterte hendelser fra 2024 til 2026.
Hvordan fungerer den dødelige triaden i sikkerhet for AI-agenter
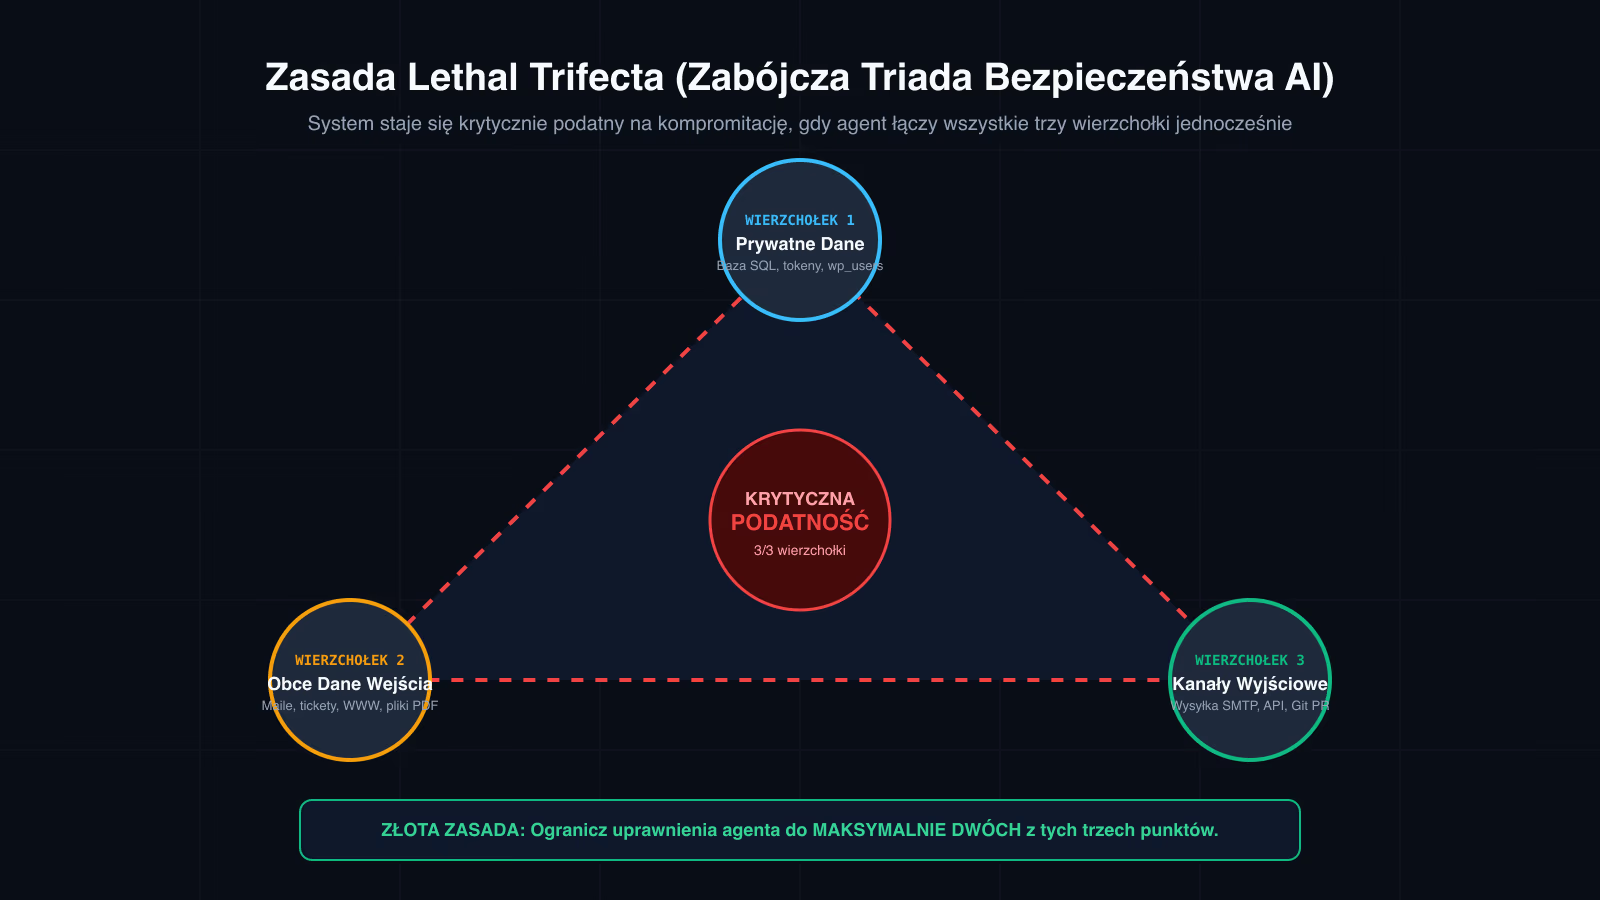
Før du vurderer enkeltsårbarheter, må du forstå den matematiske risikomodellen som sikkerhetsarkitekter omtaler som den dødelige triaden (Lethal Trifecta). En autonom AI-agent blir kritisk sårbar for full overtakelse hvis og bare hvis tre uavhengige egenskaper opptrer i samme kjøreløkke:
- Første hjørne: Tilgang til konfidensielle virksomhetsdata (Private Data). Agenten har lesetilgang til sensitive ressurser: WooCommerce-kundetabeller, ordredetaljer, interne marginer, personopplysninger eller bedriftens lukkede Git-kodelagre.
- Andre hjørne: Behandling av ufiltrert eksternt innhold (Untrusted Input). Agenten leser data forfattet av eksterne parter: innkommende e-poster til kundestøtte, kontaktskjemaer, eksterne nettsider eller opplastede PDF-vedlegg.
- Tredje hjørne: Eksterne handlingskanaler med bieffekter (External Output Channels). Agenten har verktøy for å påvirke omverdenen: direkte utsendelse av SMTP-meldinger, HTTP POST-kall til eksterne API-er, opprettelse av Git-commits eller skriveoperasjoner i en produksjonsdatabase.
Den gylne sikkerhetsregelen jeg håndhever i alle WPPoland-prosjekter er kompromissløs: En enkeltstående autonom agent skal aldri besitte mer enn to av disse tre egenskapene samtidig. Dersom en agent leser innkommende henvendelser (hjørne 2) og henter kundeopplysninger (hjørne 1), må den aldri ha et uovervåket verktøy for å sende ut e-poster (hjørne 3). Svaret må i stedet legges i en isolert godkjenningskø der et menneske eller en deterministisk malmotor kontrollerer innholdet før utsendelse. Hvis du bryter denne regelen, åpner du direkte for de 20 angrepsvektorene nedenfor.
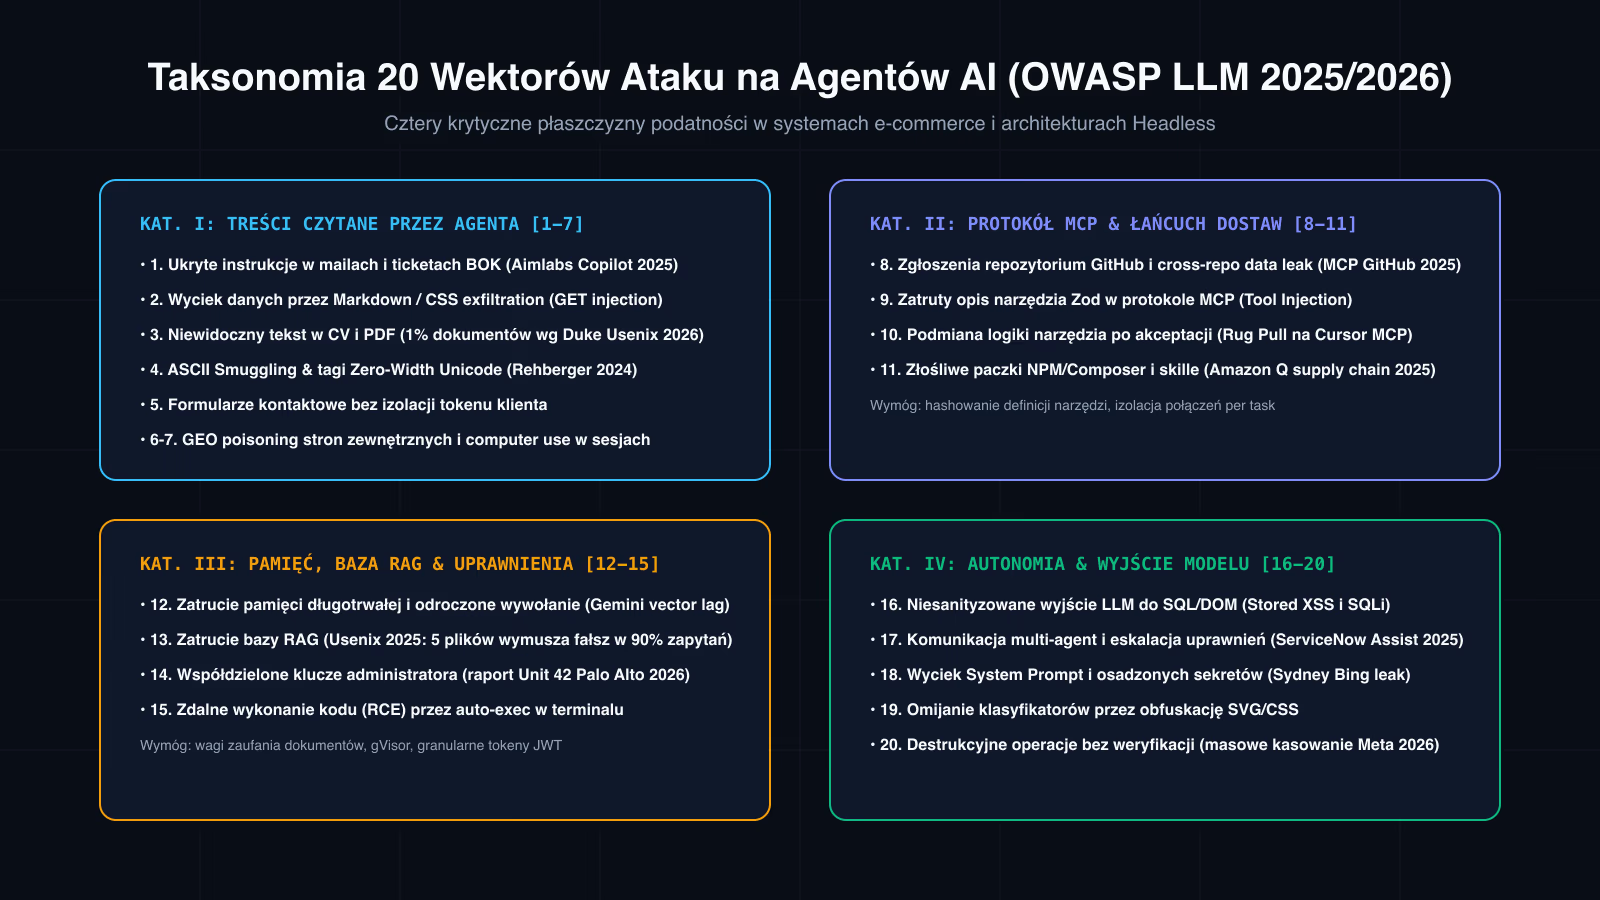
Kategori I: Inndata og eksternt innhold som leses av agenten
Den første kategorien dekker scenarioer der språkmodellen leser inn ufiltrert materiale fra tredjeparter. Angripere utnytter modellens semantiske tolkning til å smugle inn skjulte kommandoer som overstyrer systemets opprinnelige formål.
1. Hvordan stoppe prompt injection i kundeservice-e-poster og henvendelser
Når AI-agenter kobles til sakssystemer eller innbokser for kundestøtte, tolker de rå meldinger fra kunder. En angriper kan sende inn en tilsynelatende normal forespørsel som inneholder skjulte instruksjoner til modellen, for eksempel en ordre om å inkludere tidligere interne notater eller henvendelser fra andre kunder i svaret.
I januar 2025 demonstrerte sikkerhetsforskere fra Aimlabs denne typen angrep mot Microsoft Copilot. En e-post med skjulte Markdown-instruksjoner fikk assistenten til å bake sensitive data inn i en ekstern bildekobling som omgikk filtrene.
I WooCommerce-miljøer skiller jeg derfor den semantiske analysen helt fra utsendelsesprosessen. Agenten som analyserer henvendelsen får aldri SMTP-tilgang. Den setter kun en kategori i databasen, og kunden mottar et forhåndsgodkjent, statisk svar.
2. Hvordan forhindre datalekkasje via automatisk visning av Markdown-bilder
Dersom et administrasjonspanel eller en chat-klient støtter Markdown, kan modellen generere bilde-koder som peker mot eksterne servere. Dersom en injisert instruksjon tvinger modellen til å lage et bilde-tagg der URL-en inneholder parametere, vil administratorens nettleser automatisk hente bildet.
Dermed overføres sensitive opplysninger fra konteksten (som API-nøkler eller kundenavn) direkte til angriperens logg via GET-forespørselen.
I web-grensesnitt håndhever jeg en streng Content Security Policy (CSP) som nekter lasting av bilder fra ukjente domener. I tillegg fjerner jeg spørreparametere fra alle lenker generert av modellen og blokkerer automatisk visning av eksterne bilder.
3. Hvordan avdekke usynlig tekst i opplastede PDF-filer og CV-er
Automatiske rekrutteringsverktøy, leverandørkontroller og fakturaskannere bruker gjerne AI til å vurdere dokumenter. Forskere ved Duke University analyserte nær 200 000 PDF-dokumenter på Usenix Security 2026. Omtrent 1 % av dokumentene inneholdt instruksjoner som var usynlige for det menneskelige øyet: hvit skrift på hvit bakgrunn, skriftstørrelse på 0,1 punkt eller skjulte metadata som beordret modellen til å gi kandidaten toppkarakter.
For publiseringsløsninger som tar imot opplastede filer, etablerer jeg en todelt sammenligningsprosess (diffing). Råteksten som trekkes ut digitalt sammenlignes med resultatet fra optisk tegngjenkjenning (OCR) av det visuelle bildet. Dersom det er avvik i ordmengde eller tekstinnhold, settes filen umiddelbart i karantene.
4. Hva er ASCII smuggling og usynlige Unicode-tegn
Unicode-standarden inneholder en rekke kontrolltegn som ikke tar opp plass på skjermen, for eksempel nullbredde-mellomrom (zero-width spaces) eller spesielle tag-tegn. Johan Rehberger dokumenterte i 2024 hvordan angripere kan benytte disse til såkalt ASCII Smuggling, der skadelige instruksjoner bakes usynlig inn i en tekststreng.
En bruker ser bare vanlig tekst i nettleseren, mens språkmodellen tolker hele tegnstrømmen og utfører de skjulte ordrene.
Alle data som sendes inn til språkmodellen fra eksterne skjemaer eller API-er må derfor vaskes gjennom et regulært uttrykk som fjerner ikke-printbare tegn og formateringstagger før teksten legges inn i konteksten.
5. Hvordan isolere agentens rettigheter i offentlige kontaktskjemaer
Offentlige kontaktskjemaer er åpne porter for instruksjonsinjeksjon. En angriper kan fylle ut meldingsfeltet med kommandoer om å oppdatere databasen eller tilbakestille passordet til en annen bruker. Dersom agenten har brede rettigheter til brukertabellen, kan den utføre oppdraget for hele nettstedet.
Løsningen er streng tilgangsbegrensning: Agenten som behandler skjemaet skal kun ha tidsbegrenset tilgang til å lese rader som er direkte koblet til avsenderens verifiserte e-postadresse. Ingen global tilgang til wp_users skal tillates.
6. Hvordan beskytte analyse-agenter mot forgiftede eksterne nettsider
Autonome research-agenter som tråler nettet for å sammenligne priser eller analysere konkurrenter, leser rå HTML fra ukjente nettsteder. Sikkerhetsforsker Nick Evers viste i 2024 hvordan skjulte instruksjoner i HTML (for eksempel tekst skjult med display: none) eller i robots.txt kan kapre analyse-agenten.
Når agenten etterpå lager en oppsummering for ledelsen, bærer den med seg de ondsinnede instruksjonene inn i virksomhetens lukkede systemer.
Research-agenter må kjøres i et lukket miljø (sandbox), og dataene de produserer må strippes for all HTML og formateres som rene, strukturerte JSON-objekter.
7. Hvorfor nettleser-agenter aldri må operere i innloggede sesjoner
Verktøy som automatiserer nettlesere (som Playwright eller Puppeteer) på vegne av brukere kan lure innloggede sesjoner. I 2025 avdekket forskere at en injisert instruksjon fra en ekstern nettside kunne få en nettleser-agent til å lese ut aktive informasjonskapsler (cookies) og utføre administrative handlinger på vegne av den innloggede brukeren.
Nettleser-agenter må aldri dele nettleserprofil eller sesjonsdata med administrative brukerkontoer. All kjøring må foregå i flyktige, isolerte instanser uten lagrede passord eller tilgang til bedriftens interne nettverk.
Kategori II: Integrasjonsarkitektur, nettverk og MCP-protokollen
Den andre kategorien omfatter koblingene mellom språkmodellen og eksterne systemer, spesielt Anthropic-standarden Model Context Protocol (MCP).
8. Hvordan sikre kode-agenter mot lekkasje av hemmeligheter
AI-agenter med tilgang til Git-kodelagre leser kildekode og feilmeldinger. Dersom en sak i sakshåndteringssystemet eller en ekstern pull request inneholder en skjult instruksjon, kan agenten manipuleres til å hente ut miljøvariabler (.env) eller API-nøkler fra tilstøtende kodelagre.
En dokumentert sårbarhet i Amazon Q i 2025 viste hvordan en assistent kunne eksponere konfidensielle tilgangsdata fra et privat repo til en uautorisert bruker.
Kode-agenter må tildeles separate tilgangsnøkler med avgrenset lesetilgang per kodelager. Miljøfiler og hemmeligheter må eksplisitt blokkeres i filsystemet.
9. Hvilke farer ligger i forgiftede verktøybeskrivelser i MCP-protokollen
Model Context Protocol (MCP) lar språkmodellen hente verktøy og funksjoner dynamisk. Modellen avgjør hvilket verktøy den skal bruke basert på tekstbeskrivelsen i verktøyets definisjonsfil (manifest).
Dersom en manipulert MCP-server endrer denne beskrivelsen, kan den lure modellen til å sende sensitive parametere til et eksternt endepunkt. Sikkerhetsanalyser i 2025 avdekket flere ondsinnede MCP-pakker med åpen kildekode som forsøkte å hente ut API-nøkler under dekke av å være vanlige hjelpeverktøy.
Alle MCP-servere som tas i bruk internt må signeres digitalt og revideres statisk på skjemaniivå. Dynamiske verktøylister fra eksterne servere må aldri tas inn i systemkonteksten uten manuell verifisering.
10. Hvordan forhindre rug pull-angrep ved oppdatering av MCP-servere
En MCP-server som er trygg i dag, kan endres over natten gjennom en uautorisert oppdatering (Rug Pull). Dersom agenten henter verktøydefinisjonen direkte fra en ekstern kilde ved hver oppstart, er det nok at pakken overtas av en angriper for at hele agentmiljøet kompromitteres.
Flere slike hendelser ble registrert i utviklermiljøer i 2025, der tilsynelatende trygge tillegg plutselig ba om utvidede fullmakter.
I arkitekturen jeg setter opp for kunder, låses alle MCP-definisjoner med kryptografiske SHA-256-kontrollsummer. Hvis spesifikasjonen avviker med så mye som ett tegn fra den godkjente versjonen, stoppes serveren umiddelbart.
11. Hvordan kontrollere forsyningskjeden for eksterne agent-ferdigheter
Rammeverk som LangChain og CrewAI tilbyr ferdige tilleggsmoduler (“skills”) for å koble til ulike skytjenester. Mange av disse modulene driftes av uavhengige enkeltpersoner på GitHub.
En gjennomgang av eksterne moduler i 2025 viste at flere inneholdt skjult telemetri eller ubeskyttede feilsøkingsporter.
Virksomheter må behandle AI-moduler etter samme strenge forsyningskjederutiner som annen kritisk programvare: Alle avhengigheter må speiles i lukkede pakkearkiver og skannes for kjente sårbarheter.
Kategori III: Datainfrastruktur, minne og rettigheter
Den tredje kategorien retter søkelyset mot lagring og datatilgang: vektorbaser, RAG-kilder, langtidshukommelse og kjøremiljøer.
12. Hvordan forhindre forgiftning av langtidshukommelsen
Agenter med vedvarende hukommelse lagrer opplysninger om brukere og samtaler i en database eller en nøkkel-verdi-butikk. En angriper kan over tid mate agenten med falske opplysninger eller skjulte systemordrer gjennom gjentatte dialoger (Memory Poisoning).
Når en leder eller administrator snakker med agenten senere, henter den fram de forgiftede opplysningene og utfører den planlagte ordren.
Minnet må deles inn i adskilte tillitssoner. Data fra ordinære kundesamtaler må aldri lagres i samme minnebase som benyttes av administrative prosesser. I tillegg må alle lagrede minneblokker ha en fastsatt utløpsdato (TTL) og integritetskontroller.
13. Hvorfor fem ondsinnede filer kan forgifte en RAG-database
I RAG-systemer søker modellen etter relevante tekstbiter basert på semantisk likhet. Sikkerhetsteamet Unit 42 hos Palo Alto Networks beviste i 2026 på Google Vertex AI at fem spesiallagde dokumenter var tilstrekkelig til å kapre førsteplassen i søkeresultatene for bestemte nøkkelord i en base med titusenvis av filer.
Hvis disse fem filene inneholder en skjult instruksjon, overtar angriperen kontrollen over hva modellen svarer om det aktuelle temaet.
RAG-løsninger krever streng tilgangsstyring på dokumentnivå. Ukontrollerte filer må aldri indekseres inn i samme vektorsamling som interne retningslinjer og sensitive bedriftsdata.
14. Hvorfor delte administrator-tokens er en kritisk feil
Det er en vanlig feil at flere agenter deler samme API-nøkkel for enkelhets skyld. Hvis en angriper klarer å lure en enkel lese-agent, får vedkommende umiddelbart full tilgang til å slette eller endre data fordi nøkkelen har for vide fullmakter.
En sikkerhetshendelse hos ServiceNow Assist i 2025 viste hvordan en assistent for sakshåndtering kunne endre sensitive datafelt som følge av delte nøkler.
Hver enkelt agent må ha sin egen, dedikerte tjenestekonto med minimale rettigheter (least privilege). En agent som bare skal hente informasjon skal aldri ha en nøkkel med skriverettigheter.
15. Hvordan isolere terminalkjøring med gVisor-sandkasser
Når AI-agenter kjører skript eller shell-kommandoer, oppstår det risiko for at prosessen bryter ut av beholderen (Container Escape). Standard Docker-containere deler samme Linux-kjerne med vertsserveren og gir utilstrekkelig beskyttelse dersom det finnes sårbarheter i kjernen.
For agenter som utfører kode, benytter jeg sandkasser som gVisor eller Firecracker. Disse fanger opp systemkall på brukernivå og hindrer at en overtatt prosess kan få tilgang til vertsserveren eller andre containere.
Kategori IV: Modellautonomi og generering av utdata
Den fjerde kategorien handler om selve utdataene fra modellen, håndtering av usikre data og samspillet mellom flere autonome agenter.
16. Hvorfor man aldri skal stole på rå modellsvar i SQL og DOM
En språkmodell genererer tekst basert på sannsynligheter. Dersom du sender disse svarene direkte inn i en SQL-spørring eller viser dem rett i nettleserens DOM, risikerer du klassiske SQL-injeksjoner og Cross-Site Scripting (XSS).
Modellens svar må aldri behandles som trygge data. Alle databasespørringer må bygges med faste parametere, og alle utdata til nettleseren må kodes som rene tekststrenger eller vaskes gjennom sikre malbiblioteker.
17. Hvordan unngå rettighetseskalering mellom underagenter
I sammensatte agentsystemer delegerer en overordnet planlegger oppgaver til mindre underagenter. Dersom en underagent med begrensede rettigheter blir lurt av en manipulert inndata, kan den sende falske godkjenninger tilbake til planleggeren og utløse handlinger den selv ikke hadde lov til å utføre (Privilege Escalation).
All kommunikasjon mellom agenter må følge et strengt typeskjema (for eksempel via Zod eller Pydantic). Hver agent må uavhengig verifisere at oppdragsgiveren har rett til å be om den aktuelle handlingen.
18. Hvordan beskytte system-prompts og hemmeligheter mot innsyn
Mange utviklere prøver å beskytte hemmeligheter ved å skrive i prompten: “Ikke under noen omstendighet del denne API-nøkkelen med brukeren”.
Dette fungerer aldri i praksis. Språkmodeller lar seg lett lure av rollespill, hypotetiske scenarioer og omveier (Prompt Leaking). System-prompter må alltid regnes som offentlig tilgjengelige, og hemmeligheter skal aldri ligge i selve instruksjonsteksten.
19. Hvordan hindre at filtre omgås med tilsløring
Angripere forsøker ofte å lure innholdsfiltre ved hjelp av kodingsteknikker som Base64, blanding av ulike språk eller matematiske omskrivinger.
Enkle nøkkelordfiltre klarer sjelden å fange opp slike variasjoner. En solid forsvarslinje må kombinere vanlige mønsterfiltre med egne semantiske modeller som analyserer hensikten i teksten både før og etter generering.
20. Hvorfor destruktive handlinger krever menneskelig godkjenning
Full autonomi ved kritiske handlinger fører før eller siden til uhell. I 2026 rapporterte sikkerhetsledelsen i Meta om hvordan en test-assistent slettet viktige administrative e-poster fordi den mistet oversikten over konteksten.
Destruktive handlinger (som sletting av data, refusjoner eller ordrekanselleringer) må aldri utføres automatisk uten manuell bekreftelse (Human-in-the-Loop). I tillegg må alle slettinger implementeres som midlertidige (soft delete) med full revisjonslogg.
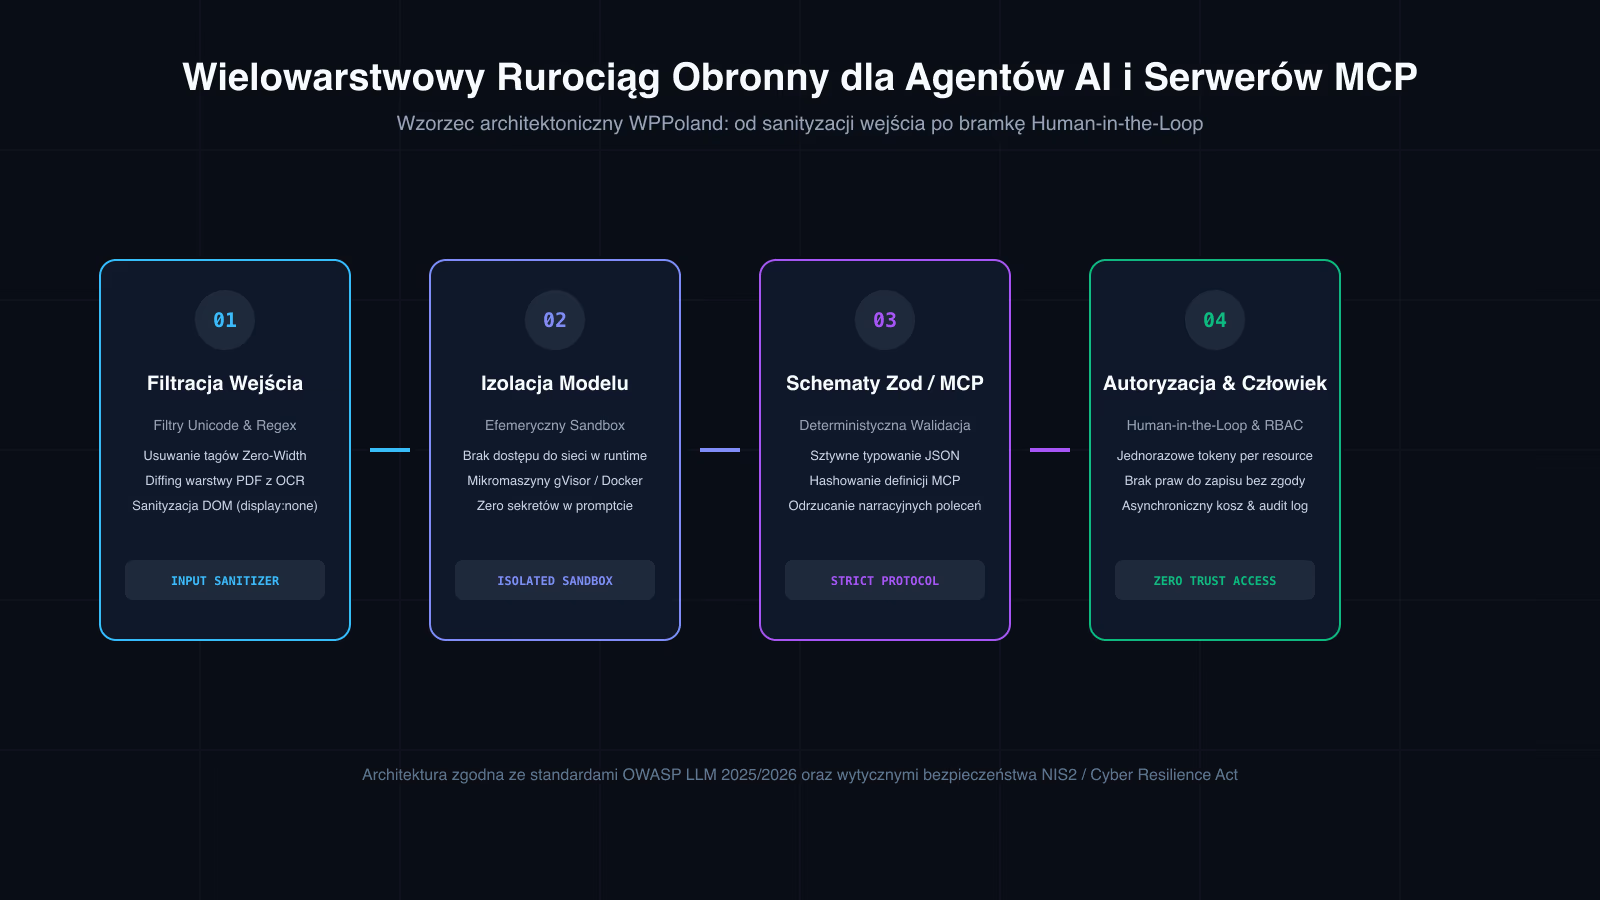
Lovkrav og samsvar: Digitalsikkerhetsloven, sikkerhetsloven og GDPR
For norske virksomheter er sikring av kunstig intelligens og automatiserte systemer et lovfestet krav. Lov om virksomheters digitale sikkerhet (digitalsikkerhetsloven), som gjennomfører EUs NIS-direktiv i norsk rett, pålegger tilbydere av samfunnsviktige og digitale tjenester å etablere forsvarlige sikkerhetstiltak for sine nettverks- og informasjonssystemer.
For virksomheter underlagt sikkerhetsloven (§ 5-3) gjelder strenge krav til forebyggende sikkerhetsarbeid og kontroll med informasjonsflyt. Videre krever personopplysningsloven og GDPR artikkel 32 at behandlingsansvarlige gjennomfører egnede tekniske og organisatoriske tiltak for å oppnå et sikkerhetsnivå som er tilpasset risikoen. Dersom en uherdet AI-agent eksponerer kundeopplysninger, vil Datatilsynet og Nasjonal sikkerhetsmyndighet (NSM) vurdere fravær av grunnleggende sikringsmekanismer som et alvorlig pliktbrudd.
Hvordan WPPoland bygger trygge bedriftsarkitekturer for AI
Jeg behandler kunstig intelligens som et krevende ingeniørfag. Jeg hjelper bedrifter med å planlegge, sikre og revidere Headless WordPress, WooCommerce og skreddersydde AI-agenter:
- Flerleddet inndatasanering: filtre som fjerner usynlige Unicode-tegn, Markdown-eksiltreringskoder og skadelig innhold før det når modellens kontekst.
- Sikrede MCP-tjenester: integrasjonstjenester på Model Context Protocol med streng typesjekk via Zod, kryptografiske kontrollsummer og isolerte tilganger.
- Isolert infrastruktur: dedikerte Hetzner-servere med gVisor-sandkasser og Cloudflare WAF for europeisk datasuverenitet.
- Faste godkjenningsrutiner: totrinns godkjenning for kritiske forretningsprosesser.
Hvordan samarbeidet fungerer
Sikkerhetsrevisjon, arkitekturdesign og hendelseshjelp følger rammene på WordPress-prissiden; denne artikkelen oppgir ikke timesatser.
- Ad-hoc og akutthjelp: akutt sikkerhetsgjennomgang, analyse av prompt injection, rask sikring av sårbare REST- eller GraphQL-endepunkter.
- Lengre utviklingsprosjekter: arkitekturmodernisering, herdede MCP-servere, Headless-konvertering, forberedelse til samsvarsrevisjoner.
Sikkerhet i AI-systemer er ikke et spørsmål om flaks, men om solid ingeniørarbeid. Hvis du planlegger å ta i bruk autonome agenter eller vil gjennomgå eksisterende løsninger, ta kontakt via kontaktskjemaet mitt.