Endringsloggen for Google Search Central-dokumentasjonen 1. oktober 2026 viser én endring: veiledningen om bruk av generativt KI-innhold ble oppdatert med informasjon fra Search Quality Raters guidelines. Siden med spam-retningslinjene ble sist oppdatert 28. august 2026. I markedsføringskretser ble dette raskt tolket som slutten på KI-assisterte tekster. Fakta og tilgjengelige markedsdata viser et annet bilde. Spam-regelen rammer mange sider som lages først og fremst for å manipulere rangeringen, uansett hvordan de er laget. Bruk av en språkmodell er ikke utløseren.
Rettelse, 20. november 2026. En tidligere versjon av denne artikkelen datofestet Googles endringer feil og beskrev mekanismer Google aldri har publisert. Endringsloggen for 1. oktober 2026 viser én endring i veiledningen om KI-generert innhold. Beskrivelsen av hvordan contentEffort beregnes og påstandene om bildeklassifisering er fjernet.
Dersom du drifter et bedriftsnettsted på WordPress, en nettbutikk på WooCommerce eller en moderne frontend på Astro, må du forstå de tekniske vurderingsmekanismene bak Googles indeksering. I denne veiledningen går vi i dybden på parameteren contentEffort fra Googles lekkede dokumentasjon, sammenholder offisielle påstander med empiriske studier fra Ahrefs og Lily Ray, og gir deg konkrete prosedyrer for å sikre lokale bysider, tekniske ordlister og forfatterprofiler mot trafikkfall.
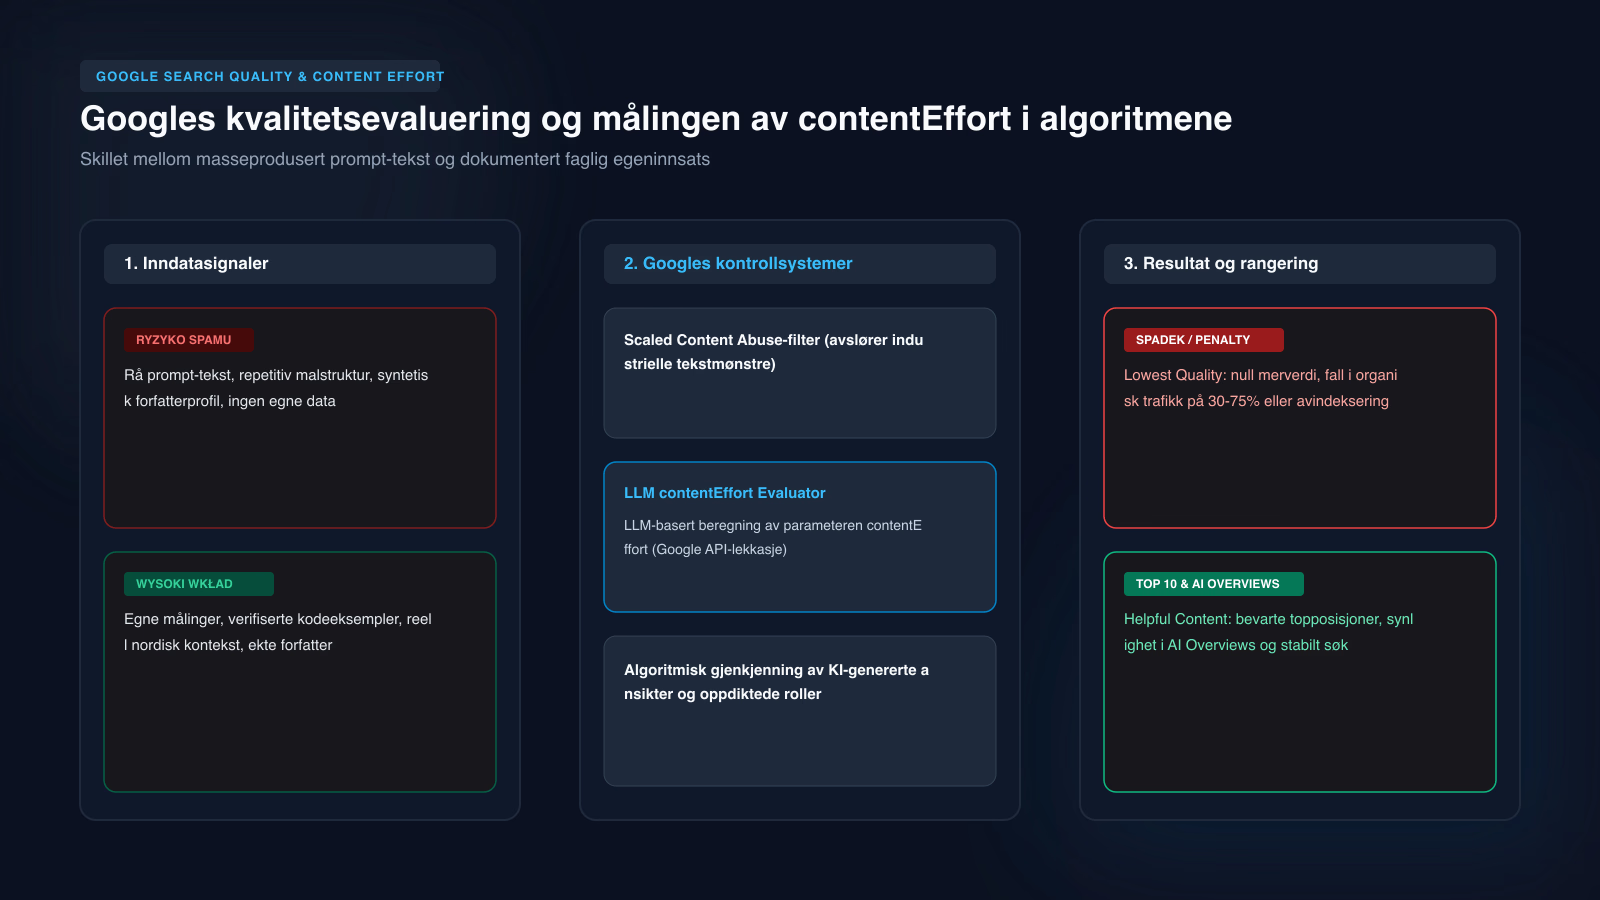
Flyten i Googles kvalitetsevaluering: Fra inndatasignaler via beregningen av contentEffort og spam-klassifisering til endelig synlighet i søkeresultatene. Kilde: Teknisk analyse fra wppoland.com basert på Google Search Essentials, per 1. november 2026.
Får AI-tekster straff i Google?
Det vanligste spørsmålet blant bedriftsledere og utviklere er om tekster generert av ChatGPT, Claude eller interne API-rørgater automatisk fører til straff fra Google. Det tekniske svaret er nei, forutsatt at innholdet faktisk løser brukerens problem og representerer en reell arbeidsinnsats.
I sine offisielle retningslinjer for søkesøppel (Spam Policies for Google Web Search) forbyr ikke Google automatisering i seg selv. Den avgjørende presiseringen ligger i definisjonen av skalert innholdsmisbruk (scaled content abuse):
Skalert innholdsmisbruk foreligger når mange sider genereres med det primære formålet å manipulere søkerangeringer fremfor å hjelpe brukere. Denne uærlige praksisen kjennetegnes typisk ved produksjon av store mengder uoriginalt innhold som gir brukerne liten eller ingen verdi, uavhengig av hvordan det ble skapt.
Google Search Central, Spam Policies, avsnittet Scaled content abuse (egen oversettelse)
Legg merke til ordlyden: “uavhengig av hvordan det ble skapt.” Regelen skiller ikke mellom lavtlønnede tekstforfattere, automatiserte RSS-skrapere og språkmodeller. Det avgjørende er om mange sider finnes først og fremst for å manipulere rangeringen, i stedet for å hjelpe brukerne. Dersom nettstedet serverer generiske tekstblokker som bare gjentar de ti øverste konkurrentene, er det utsatt for denne regelen.
På vurderersiden nevner Search Quality Rater Guidelines (datert 11. september 2025) sidefunksjoner som kalkulatorer og spill som hovedinnhold (Main Content). Dette er veiledning for menneskelige vurderere, ikke en endring gjort 1. oktober. En nettside med 300 ord presis forklaring og en interaktiv kalkulator kan hjelpe en bruker bedre enn 3000 ord overfladisk tekst uten praktisk nytte.
Hvis du vil kartlegge hvordan ditt nettsted presterer i henhold til de nye kravene, anbefales en teknisk gjennomgang. Hos WPPoland utfører vi fullstendige analyser gjennom vår tjeneste WordPress nettstedsjekk, hvor vi gransker både ytelse, kodekvalitet og innholdsarkitektur.
Hva betyr parameteren contentEffort i Googles algoritmelekkasje?
I mai 2024 ble tusenvis av sider med intern API-dokumentasjon fra Googles søkeavdeling lekket til offentligheten. Uavhengige spesialister, blant dem SparkToro og iPullRank, gikk gjennom parametere som Google aldri hadde omtalt offentlig.
Én av dem heter contentEffort. I den lekkede dokumentasjonen (modulen QualityNsrPQData) er den bare beskrevet som “LLM-basert estimering av innsats for artikkelsider” (egen oversettelse). Det er hele den verifiserte beskrivelsen. Google har ikke publisert hvordan verdien beregnes, hvilke data den bruker eller hvor stor vekt den har i rangeringen.
Se på den som en pekepinn om retning, ikke som et tall du kan måle og optimalisere. Sider som tilfører egne bevis (egne målinger, skjermbilder, kode, prosjektdata) står bedre enn sider som gjentar det som allerede står på første resultatside, uansett hva feltet gjør internt.
Retningslinjene for vurderere peker samme vei. Gjeldende Search Quality Rater Guidelines (datert 11. september 2025) bruker i avsnitt 4.6.6 formuleringen “liten eller ingen innsats” (egen oversettelse) om hovedinnhold uten synlig egeninnsats.
Hvor mye KI-innhold rangerer faktisk i topp 10 på Google?
For å etablere en realistisk strategi må vi se på empiriske undersøkelser av faktiske søkeresultater.
En omfattende studie utført av analyseselskapet Ahrefs undersøkte tusenvis av konkurranseutsatte søkefraser for å kartlegge utbredelsen av KI-generert tekst på Googles førsteside:
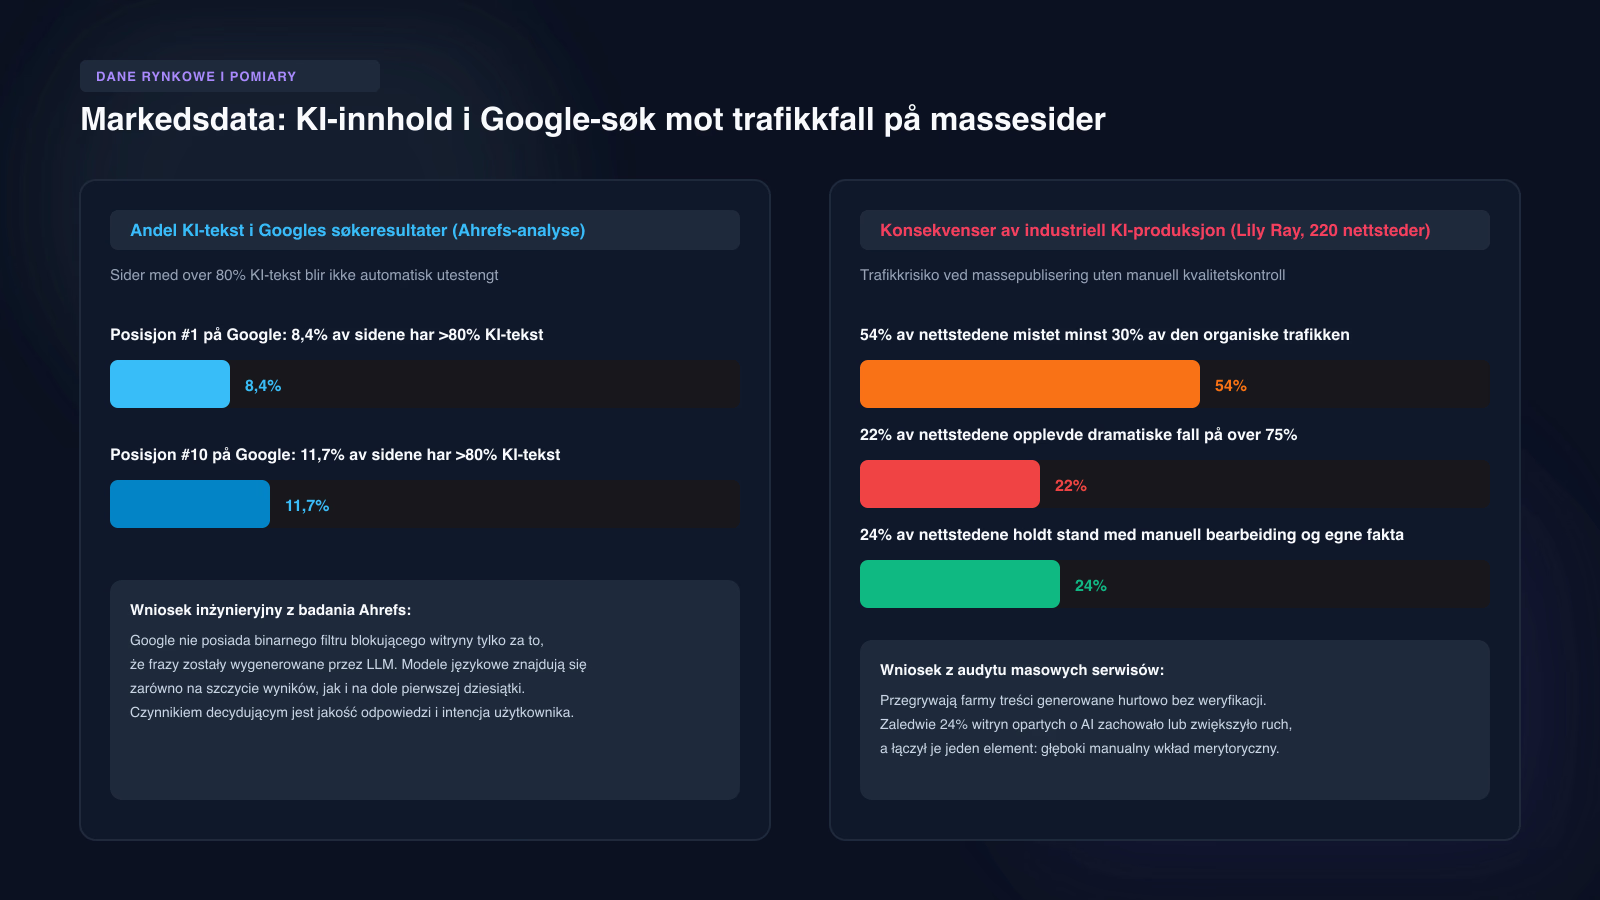
Andel KI-dominert innhold i Googles topp 10 ifølge Ahrefs, samt trafikkfall for nettsteder med KI-innholdsstrategier rapportert av Lily Ray. Kilder: Ahrefs-studien om KI-innhold og Lily Ray i Search Engine Journal.
På posisjon 1 i Googles organiske søkeresultater hadde 8,4% av de undersøkte nettsidene minst 80% KI-generert innhold. På posisjon 10 var andelen 11,7%.
Disse målingene viser at en språkmodell alene ikke holder en side utenfor topp 10. De viser ikke hvorfor sidene ligger der: domeneautoritet, lenkeprofil, sideopplevelse og treff på søkehensikten er plausible faktorer som studien ikke skiller fra hverandre.
Bildet er et annet for prosjekter som har brukt språkmodeller som helautomatiserte innholdsfabrikker. Lily Ray omtalte i Search Engine Journal 220 nettsteder med KI-innholdsstrategier:
- 54% mistet minst 30% av den organiske trafikken.
- 22% mistet minst 75% av den organiske trafikken.
Risikoen ligger altså ikke i verktøyet, men i forestillingen om at algoritmer kan lures med ubehandlet maskintekst. Hos WPPoland hjelper vi virksomheter som har opplevd slike fall gjennom tjenesten redning av AI-bygde nettsider, hvor vi rydder opp i skalerte tekstsamlinger og gjør dem om til solide digitale verdier.
Hvilke sidetyper mister mest trafikk etter Google-oppdateringer?
Ved analyse av nettsteder som har mistet store deler av synligheten sin, peker åtte strukturelle mønstre seg ut. Hvert av disse mønstrene fanges enkelt opp av Googles algoritmer for skalert innholdsmisbruk:
Parvise produktsammenligninger (Verktøy A mot Verktøy B). Tilknyttede nettsteder genererer ofte tusenvis av kombinasjoner via skript. Fordi modellen spytter ut identiske sammenligningstabeller og overfladiske tekster for hvert par, får brukeren ingen reelle testresultater eller praktiske målinger.
Isolerte ordlister og enkle definisjonssider. Masseopprettelse av korte 300-ords sider for bransjebegreper (som “hva er et API” eller “hva betyr headless CMS”). Google nedprioriterer disse fordi definisjonene besvares direkte i søkegrensesnittet via AI Overviews eller Wikipedia.
Kåringer som ukritisk plasserer eget selskap på førsteplass. Lister av typen “Topp 10 webbyråer”, der forfatteren alltid gir seg selv høyeste score og tildeler konkurrentene tilfeldige minuspunkter. Uten åpen testmetodikk vurderes dette som upålitelig markedsføring.
Maler for “alternativer til [konkurrent]”. Landingssider rettet mot kjente merkevarer. Dersom siden bare omskriver konkurrentens prisliste uten å vurdere API-begrensninger, migrasjonsutfordringer eller reell driftsstøtte, stemples innholdet som verdiløst.
Masseproduserte bysider i lokal søkeoptimalisering. En utbredt praksis der én og samme tjenestetekst kopieres over 200 norske kommuner eller byer ved kun å endre stedsnavnet i overskriften og teksten.
Spørsmål-og-svar-samlinger tilpasset GEO og AEO. Massepublisering av korte svar på vanlige spørsmål for å tiltrekke seg siteringer i Perplexity eller SearchGPT. Uten egne kilder blir disse sidene raskt avindeksert.
Uvedkommende fyllstoff (parasitt-SEO). Publisering av artikler om forbrukslån eller helse på domenet til en håndverkerbedrift for å fange opp tilfeldig trafikk. Google håndhever prinsippet om tematisk kjerneautoritet (Topical Authority) strengt.
Automatisert varekatalogisering uten produkttesting. Dropshipping-butikker som importerer varelinjer fra grossister og kjører produkttekstene gjennom enkle omskrivingsmodeller. Uten egne bilder, spesifikasjoner eller monteringserfaring er den oppfattede innsatsen lik null.
Felles for disse formatene er at de er bygget for å manipulere indekseringssystemer snarere enn å betjene et menneske med et reelt behov.
Hvordan sikre lokale bysider mot filter for duplisert innhold?
Lokale landingssider (for eksempel /webutvikling-oslo/, /webutvikling-bergen/ eller /webutvikling-trondheim/) er essensielle for å skaffe lokale oppdrag. Hvis hundrevis av slike undersider deler nesten identisk tekst og bare stedsnavnet byttes, passer det med definisjonen av skalert innholdsmisbruk sitert over. Google har ikke publisert en mekanisme for domenedekkende straff, så det trygge utgangspunktet er at hele nettstedet kan bli rammet.
For å sikre lokale bysider i det nordiske markedet må du bygge en struktur basert på ekte lokale forskjeller:
For det første: Vis til reelle prosjekter fra det aktuelle distriktet. I stedet for generelle påstander må du dokumentere faktiske oppdrag: Hvilken lokal bedrift utførte dere arbeid for, hvilke integrasjoner mot lokale lagersystemer ble levert, og hvilke tekniske utfordringer ble løst?
For det andre: Knytt innholdet til relevante lover og administrative instanser. I Norge reguleres markedsføring og forbrukerforhold av markedsføringsloven (lov om kontroll med markedsføring og avtalevilkår mv. av 2009), håndhevet av Forbrukertilsynet. Ved netthandel gjelder angrerettloven (lov om opplysningsplikt og angrerett ved fjernsalg mv. av 2014) og Datatilsynets retningslinjer for personvern under EØS-avtalen. Henvis aldri til utenlandske lover som ikke gjelder for det norske markedet.
For det tredje: Beskriv konkrete logistikkforhold. For handelsløsninger bør du spesifisere reelle fraktalternativer, for eksempel integrasjoner mot Bring eller PostNord, hentepunkter i regionen og lokale utkjøringsfrister.
For det fjerde: Bruk strukturerte data som stemmer med virkeligheten. Beskriv et fysisk sted bare hvis virksomheten faktisk har ett. En virksomhet som jobber helt eksternt skal ikke finne på kontoradresse, telefonnummer eller koordinater, og kan bruke areaServed med en entydig Wikidata-referanse.
Her er et eksempel på JSON-LD for en lokal tjenesteside. Alle verdier er plassholdere (example.com), bytt dem ut med dine egne data:
{
  "@context": "https://schema.org",
  "@type": "ProfessionalService",
  "name": "Eksempel Webbyrå",
  "url": "https://example.com/oslo/",
  "areaServed": {
    "@type": "City",
    "name": "Oslo",
    "sameAs": "https://www.wikidata.org/wiki/Q585"
  }
}
Når lokale sider fylles med ekte data og korrekte entitetskoblinger, oppnår de en faglig dybde som ikke kan gjenskapes med en enkel prompt.
Hvordan hindre at ordlister og definisjoner mister synlighet i Google?
Tekniske ordlister ble lenge benyttet som en enkel oppskrift for å bygge hundrevis av rangerende undersider. Etter de siste algoritmejusteringene har mange slike seksjoner mistet mesteparten av trafikken sin.
En grunnleggende definisjon fra en lærebok har lav verdi i Googles beregninger. Dersom en bruker søker etter “hva er en REST API”, viser Google svaret direkte i søkefeltet fremfor å sende trafikk videre til et overfladisk oppslagsverk.
For å redde og styrke en teknisk ordliste må du bygge inn et praktisk gjennomføringsbevis (production proof) i hver eneste definisjon:
- Presis definisjon: En til to faglige setninger, tilpasset semantiske Speakable-markører.
- Faktisk kodeeksempel eller terminalkommando: Vis hvordan mekanismen settes opp i praksis. Definerer du “Object Cache i WordPress”, må du vise det faktiske oppsettet i
wp-config.phpmed Redis og forklare minnehåndtering. - Feilsøking og grensetilfeller: Beskriv hva som skjer ved systemfeil, for eksempel minnelekkasjer eller transaksjonslåsing i travle WooCommerce-butikker.
| Element | Sårbar Mal (Høy Risiko) | Robust Dokumentasjon (Høy contentEffort) |
|---|---|---|
| Begrepsforklaring | Tre avsnitt med generelle vendinger om at databaseindekser er viktige for nettsteder. | Én teknisk setning som definerer indekser som interne B-Tree-datastrukturer for raskere oppslag. |
| Kodeeksempel | Ingen kode eller en overfladisk SQL-snutt hentet fra en grunnleggende veiledning. | Reell SQL-analyse ved bruk av EXPLAIN ANALYZE på spørringer mot WooCommerce wp_postmeta. |
| Feildiagnostikk | Generell advarsel om at trege databaser gir dårlig brukeropplevelse. | Konkret analyse av låsetilstander og CPU-belastning ved over 100 samtidige spørringer. |
| Regelverk | Ingen henvisning til datahåndtering eller regelverk. | Tekniske krav til sletting av personopplysninger i feillogger etter personvernforordningen (GDPR). |
Gjennom denne faglige forankringen fungerer ordlisten som et solid oppslagsverk for utviklere, noe som sikrer varig indeksering.
Hvorfor er KI-genererte forfatterbilder og falske biografier et problem?
For å tilfredsstille E-E-A-T-kravene har mange aktører funnet på fiktive eksperter utstyrt med portretter fra bildegeneratorer.
Search Quality Rater Guidelines ber menneskelige vurderere lete etter KI-genererte bilder i falske forfatterprofiler. Google har ikke publisert om og hvordan slike bilder avdekkes automatisk. Utsagn om pupillgeometri eller ørefipper er gjetning, ikke dokumentasjon.
Problemet er praktisk. Hvis en påstått ekspert innen IT-sikkerhet eller jus ikke har noe etterprøvbart spor (ingen oppføring i Enhetsregisteret, ingen profil på LinkedIn eller GitHub, ingen eksterne omtaler), har lesere og vurderere ingen grunn til å tro på rådene.
I Norge reguleres dette også av markedsføringsloven § 6 og § 7 om villedende handelspraksis. Å tillegge seg selv eller skribenter fiktive titler og ekspertroller for å selge varer eller tjenester kan rammes av sanksjoner fra Forbrukertilsynet.
Slik implementerer du forfattere korrekt i WordPress:
- Oppgi ekte ansatte eller innleide konsulenter som har skrevet eller kvalitetssikret artikkelen.
- Bruk ekte fotografier tatt i naturlige arbeidsomgivelser, komprimert til AVIF uten manipulerende filtre.
- Knytt artikkelen til et strukturert
Person-schema i JSON-LD med eksterne lenker. Alle verdier i eksemplet er plassholdere (example.com), bytt dem ut med dine egne data:
{
  "@context": "https://schema.org",
  "@type": "Person",
  "name": "Eksempel Forfatter",
  "worksFor": {
    "@type": "Organization",
    "name": "Eksempel AS",
    "url": "https://example.com"
  },
  "url": "https://example.com/forfatter/eksempel-forfatter/",
  "sameAs": [
    "https://github.com/eksempel-forfatter",
    "https://www.linkedin.com/in/eksempel-forfatter/"
  ]
}
Ekte forfatterskap skjermer nettstedet mot algoritmiske straffer og bygger avgjørende tillit hos krevende bedriftskunder.
Hva er testen med en enkelt prompt og hvordan tester du eget nettsted?
Testen med en enkelt prompt (single prompt test) er en praktisk metode utviklet av søkemotoringeniører for å vurdere innholdets holdbarhet mot automatisert devaluering.
Prinsippet er enkelt: Hvis en konkurrent kan taste overskriften på artikkelen din inn i ChatGPT eller Claude som en enkel prompt, og svaret har samme struktur, resonnement og dybde som teksten på nettstedet ditt, har innholdet ingen varig forsvarsverdi i søkeindeksen.
Slike sider vil tape terreng over tid fordi de mangler unik informasjonsverdi:
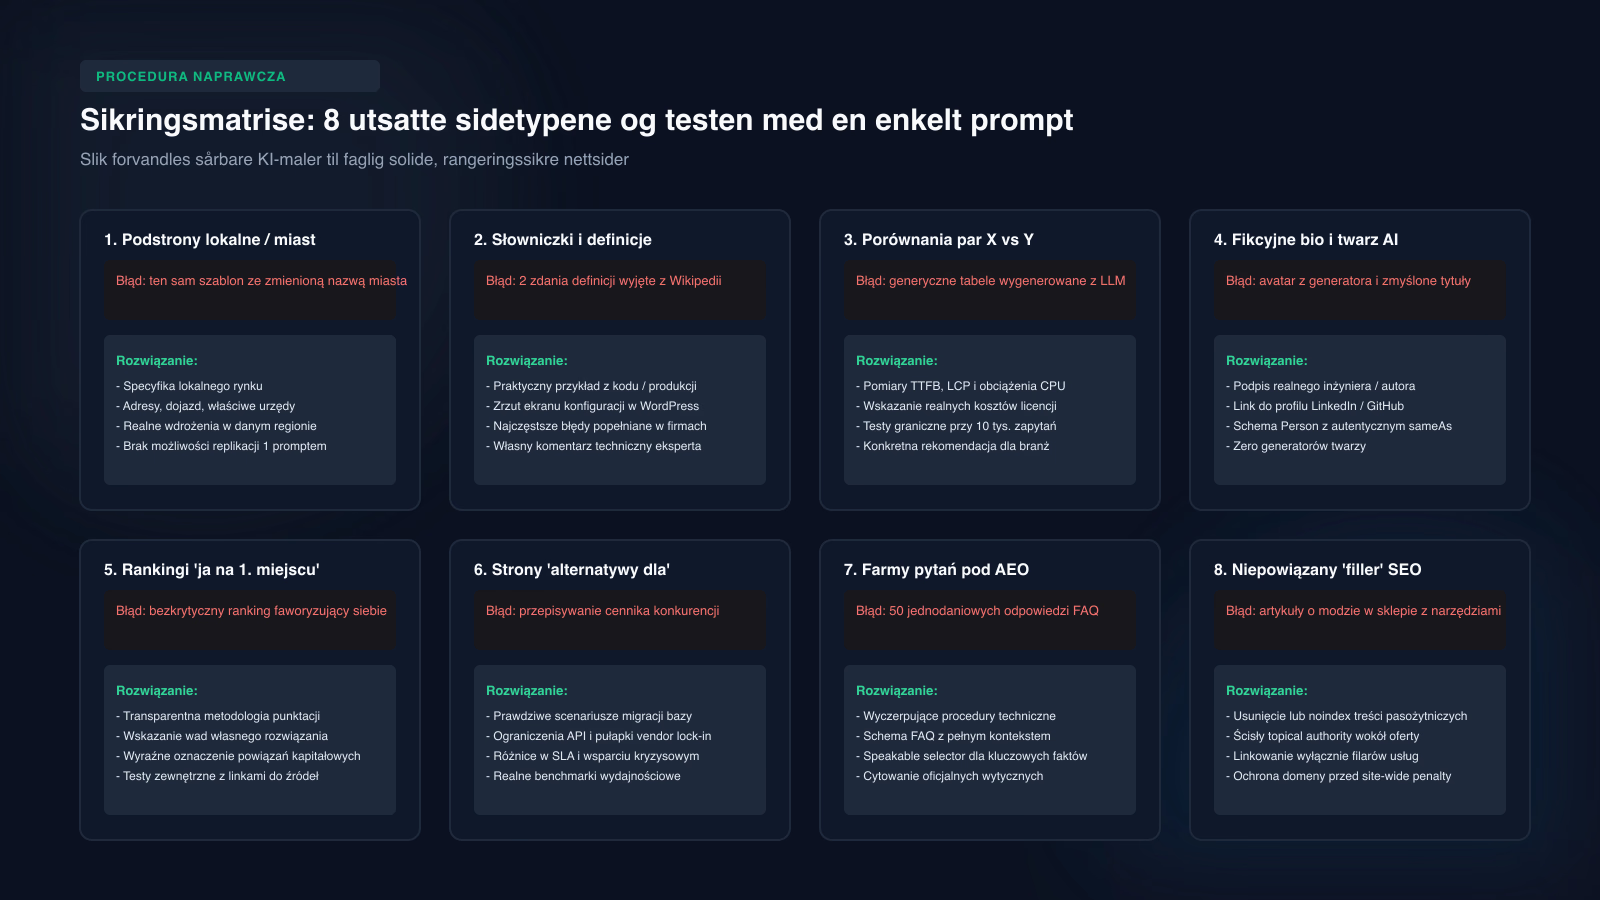
Sikringsmatrise for åtte sårbare nettstedstrukturer med konkrete tekniske tiltak for å bestå testen med en enkelt prompt. Kilde: WPPoland rammeverk for innholdsarkitektur, 2026.
Slik gjennomfører du testen på ditt eget nettsted:
Trinn 1: Velg ut fem tilfeldige fagartikler eller kategorisider fra nettløsningen din. Trinn 2: Tast inn den eksakte overskriften i en moderne språkmodell uten ekstra føringer. Trinn 3: Vurder resultatet opp mot din publiserte artikkel ut fra fire kontrollspørsmål:
- Inneholder teksten din konkrete tall, datoer, målinger eller maskinvarekrav som modellen ikke oppga?
- Har artikkelen skjermbilder, kodeeksempler eller arkitekturdiagrammer fra dine egne produksjonsmiljøer?
- Formidler artikkelen et tydelig faglig standpunkt (for eksempel en begrunnet advarsel mot en spesifikk utvidelse) i stedet for vage avveininger?
- Viser teksten til konkrete lover, administrative instanser eller offisielle standarder?
Hvis du må svare nei på disse punktene, består ikke artikkelen testen.
For å bestå må du legge til elementer som en språkmodell ikke kan dikte opp:
- Målinger fra en reell belastningstest (for eksempel en k6-test av 500 samtidige handlekurver i WooCommerce).
- Analyse av webserverlogger for å kartlegge hvordan søkeroboter traverserer nettstedet.
- Dokumenterte kundecaser med faktiske tall for lastetidsforbedringer (LCP).
- Egenutviklet programkode som løser spesifikke integrasjonsproblemer.
Dette sikrer at nettstedet ditt forblir den opprinnelige kilden (source of truth). I våre leveranser innen GEO- og LLMO-optimalisering implementerer vi semantiske strukturer som sikrer at denne informasjonen fanges opp av både tradisjonelle søkemotorer og nye KI-modeller.
Hva gjør du når nettstedet mister 70% av trafikken?
Dersom et nettsted eller en nettbutikk har opplevd dramatisk trafikkfall etter en oppdatering, er panisk sletting av innhold sjelden løsningen. En varig gjenoppbygging krever en strukturert ingeniørtilnærming i fem faser:
Fase 1: Segmentering i Google Search Console
Analyser dataene i Google Search Console og sammenlign de siste 28 dagene med perioden før fallet. Del adressene inn i tre kategorier:
- Sider som har mistet over 70% av visninger og klikk.
- Stabile sider som bærer den tematiske autoriteten videre.
- Helt avindekserte sider som tyder på inngripen fra spam-filtre.
Undersøk hvilke maler som ble hardest rammet: Var det automatiserte bysider, tynne blogginnlegg eller importerte produkttekster?
Fase 2: Opprydding i perifert innhold
Dersom nettstedet tidligere publiserte store mengder artikler uten relevans for kjernevirksomheten, må denne ballasten fjernes:
- Etabler 301-omdirigeringer til relevante kjerneartikler dersom sidene har gode eksterne lenker.
- Legg på HTTP-headeren
X-Robots-Tag: noindexhvis innholdet må være tilgjengelig for eksisterende kunder, men skal ut av søkeindeksen. - Returner statuskoden HTTP 410 Gone for verdiløse sider, slik at søkerobotene fjerner dem raskt fra indeksen.
Fase 3: Oppgradering av de viktigste forretningssidene
Plukk ut de 20% viktigste sidene blant dem som falt, som historisk har skapt henvendelser eller salg:
- Fjern intetsigende KI-avsnitt og erstatt dem med tekniske fakta.
- Legg inn egne illustrasjoner, systemskisser og ekte produktbilder.
- Sett opp Schema.org-data med entitetskoblinger mot Wikidata.
- Tildel sidene til ekte forfattere med verifiserbar fagbakgrunn.
Fase 4: Fjerning av teknisk gjeld og sikring av indekseringsbudsjettet
Nettsteder med store innholdsmengder sliter ofte med skjult teknisk gjeld. Treg databasedrift i WordPress, manglende hurtigbufring og unødvendige skript gjør at søkeroboter gir opp før viktige sider blir besøkt.
Tiltak for ytelsesforbedring:
- Aktiver Redis objektbufring for å avlaste databasen i WooCommerce.
- Konfigurer Cloudflare Workers for hurtigbufring i kanten av nettverket (Edge Caching).
- Juster
robots.txtfor å blokkere unødvendige filtreringsadresser som sløser bort indekseringskapasitet.
Fase 5: Ny innsending og observasjon
Send inn oppdaterte XML-nettstedskart i Google Search Console. En helhetlig kvalitetsvurdering endres ikke umiddelbart. Søkemotoren må traversere de oppdaterte sidene flere ganger for å bekrefte forbedringene, en prosess som vanligvis tar mellom 4 og 12 uker.
| Fase | Tiltak | Forventet Resultat |
|---|---|---|
| Uke 1-2 | Search Console-analyse, opprydding med 410 og noindex på svake sider. | Avlastet indekseringsbudsjett, stopp i videre fall. |
| Uke 3-6 | Manuell oppgradering av kjerneartikler med egne data og strukturerte data. | Sidene bærer egne bevis, posisjoner begynner å stabilisere seg. |
| Uke 7-10 | Ytelsesoptimalisering, innføring av Edge Caching og forfatterprofiler. | Bedre E-E-A-T-score, hyppigere besøk fra søkeroboter. |
| Uke 11-16 | Fullført reindeksering, gjenvunnet synlighet i AI Overviews og søkeresultater. | Stabil gjenoppbygging av trafikk på kjernefraser. |
Google stenger ikke døren for kunstig intelligens, men har hevet listen for teknisk kvalitet. De som lykkes bruker verktøyene til å støtte dyktige fagfolk, ikke til å erstatte genuin kompetanse.