Jeg driver WPPoland alene og publiserer et nettsted på seks språk, skrevet med hjelp fra KI. Hver tekst går gjennom skillen humanizer, polske tekster i tillegg gjennom miodkuj, og deretter gjennom deterministiske sjekker i repoet før noe går ut. Her viser jeg hvordan et team som skriver dokumentasjon, README-filer, utgivelsesnotater eller en bedriftsblogg med Claude Code, Codex eller Cursor kan sette opp det samme: hvilken skill som gjør hva, hva evalueringene deres faktisk viser, hvordan du bygger en port i CI som bare stopper harde funn, og hvorfor en grønn skanning av norsk tekst ofte betyr at ingenting ble sjekket.
Alle tall om tredjepartsverktøy er lest i kildene 6. november 2026. Tallene om mine egne sjekker kommer fra skriptene i repoet og fra kjøringer samme dag.
Hva er en anti-slop-skill, og hvorfor er den ikke en detektor
En skill i Claude Code er en mappe med en SKILL.md, altså instruksjoner modellen leser før den skriver eller redigerer. En anti-slop-skill beskriver mønstrene som gjør tekst gjenkjennelig som maskinskrevet: oppblåste påstander, kunstige motsetninger, tretall som er tvunget fram, avslutninger på én linje, fet skrift som etikett foran hvert avsnitt. Modellen bruker beskrivelsen til å skrive om.
Det er en redigeringshjelp. Ingen av verktøyene under lover å avgjøre hvem som skrev en tekst. humanizer sier det rett ut i sin README: å komme forbi KI-detektorer er ikke et mål, og detektorene flagger fortsatt mesteparten av det verktøyet leverer. Wikipedia, som har samlet slike tegn på siden Signs of AI writing, advarer mot å lese listen som en oppskrift:
Ikke behandle disse tegnene bare som problemene som skal fikses; det kan bare gjøre det vanskeligere å oppdage. (egen oversettelse)
Samme side kaller mønstrene mulige tegn på et problem, ikke selve problemet. Slik bør alt under leses: en regel finner et sted du bør se på, og en person avgjør om setningen gjør jobben sin.
Hvilke skills finnes, og hva viser evalueringene
Her ser jeg nærmere på tre verktøy. Tabellen viser hva de gjør og hva som finnes av dokumentert testing, slik det står i repoene.
| Skill | Hva den gjør | Evidens | Når jeg ville brukt den |
|---|---|---|---|
| blader/humanizer 3.1.0, MIT | 26 mønstre i seks grupper (oppbygging, rytme, oppblåsing, formatering, chat-rester, feil leser). Modellen skriver om. | Ingen evalueringspakke i repoet. En blindtest fra en bruker i issue 229: 16 av 16 foretrakk omskrivingen, alle dommere var språkmodeller fra én familie. | Siste pass på all engelsk prosa før publisering. |
| theclaymethod/unslop 2.3.0 | Fire kommandoer pluss fire Python-skannere som skriver JSON. | Siste uavhengige offentlige resultat er «no-ship». Ingen validert sammenlignende forbedring. | Skannerne i CI for engelske dokumenter; validate_preservation.py for å sjekke at fakta overlevde. |
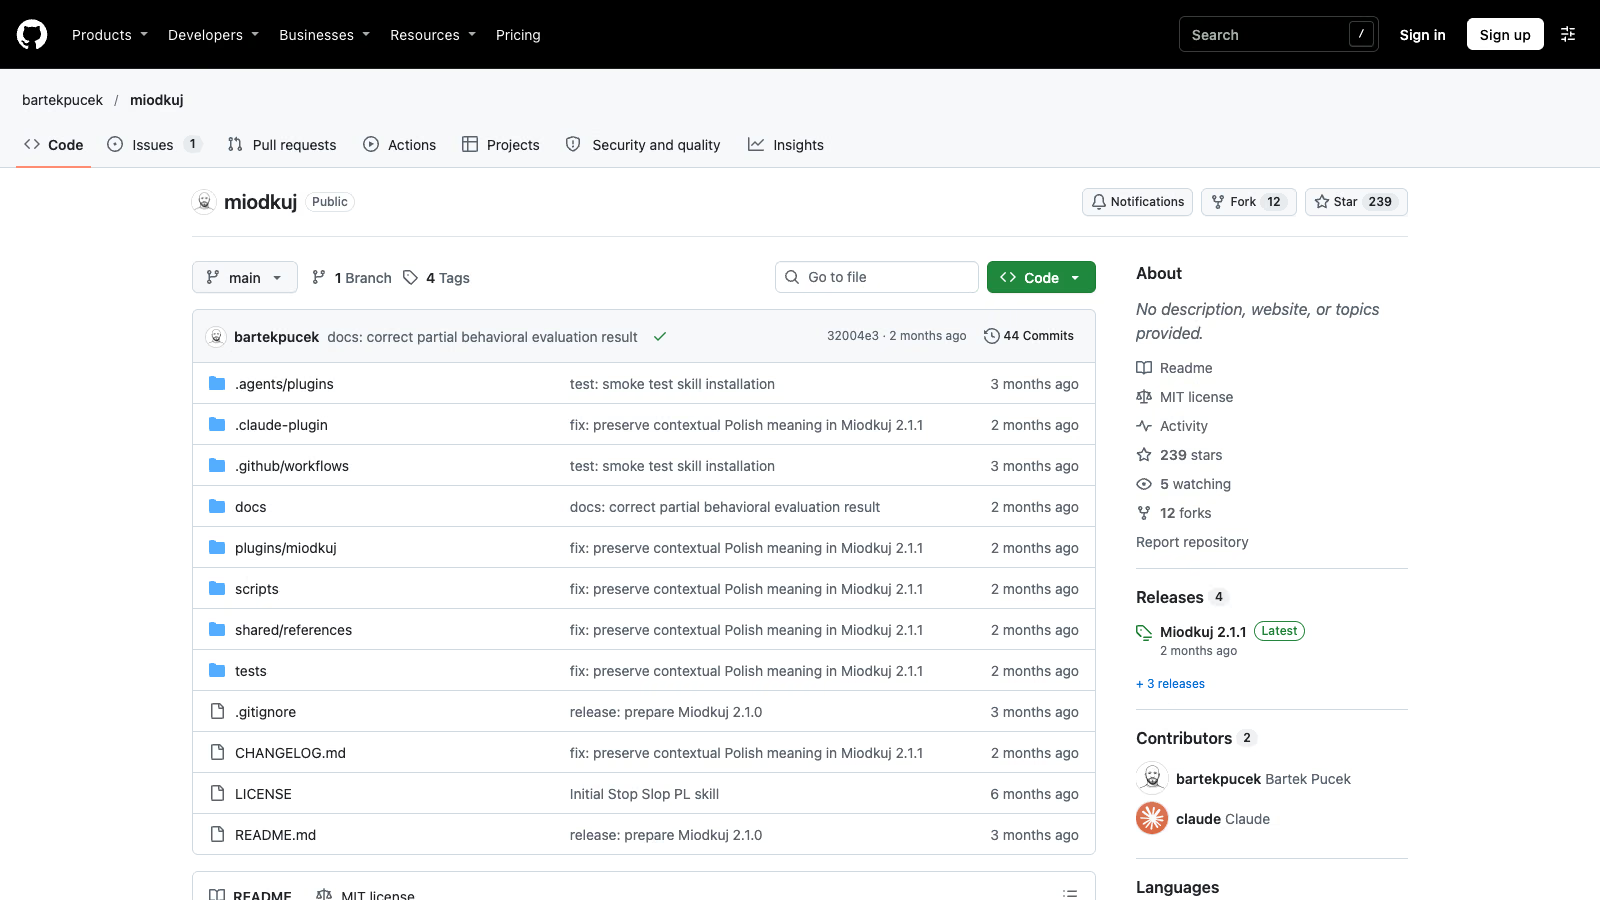
| bartekpucek/miodkuj 2.1.1, MIT | Minste effektive redigering av polsk tekst: byråkratspråk, substantivkjeder, påstander uten dekning. | Egen atferdstest: 12 av 13 bestått, ett delvis. Kjørt én gang på én modell. | Bare polsk tekst. |
Hva gjør humanizer
humanizer er én SKILL.md på 31,6 KiB. Versjon 3.0.0 slo sammen 35 mønstre til 25, og 3.1.0 la til nummer 26. Det finnes ingen skanner og ingen kommandolinje; skriptet validate-package.py sjekker bare pakkefilene. Effekten er altså så god som modellen som leser instruksjonene.
Blindtesten i issue 229 er ofte sitert, og den bør leses med forbeholdene som står i selve issuen: alle dommerne var språkmodeller fra samme familie, og kvalitetsstudien kjørte 77 av 144 planlagte parvise forsøk etter infrastrukturfeil. Detektorresultatet i samme issue gikk fra 100 til 98,6 og 97,8 prosent KI. Testen sier noe om hva språkmodeller foretrekker som lesere. Om menneskelige lesere sier den ingenting.
Installasjon i Claude Code etter README:
/plugin marketplace add blader/humanizer
/plugin install humanizer@humanizer
# kalles da som /humanizer:humanizer (krever Claude Code 2.1.142 eller nyere)

# eldre Claude Code, Codex eller alle agenter:
npx skills add blader/humanizer --global --agent claude-code
npx skills add blader/humanizer --global --agent codex
npx skills add blader/humanizer --global --agent '*'Hva gjør unslop
unslop har fire kommandoer. /unslop teach bygger en stemme fra dine egne tekstprøver. /unslop cleanup merker KI-tegn som forslag og endrer ingenting selv. /unslop rewrite er standard og bygger utkastet opp på nytt. /unslop mimic skriver i en innlært stemme. Skriptene krever Python 3.8 eller nyere og bare standardbiblioteket, og CI i repoet tester 3.8 og 3.11.
README er ærlig om grensene:
Skannere foreslår kandidater; agenten sjekker hver bruk i sin sammenheng. (egen oversettelse)
Rett etter står det at verken en ren skanning eller en kjent frase beviser hvem som skrev teksten, og at sjekkene ikke kan garantere at alle feil er borte.
Evalueringen er det mest interessante med prosjektet, fordi den viser et nei. På et frosset offentlig testsett med tre skitne og ett rent dokument og 31 merkede problemer (CORE-RESULTS.md) ga modellen med unslop disse tallene mot samme modell uten:
| Måling | Med unslop | Uten | Krav |
|---|---|---|---|
| Presisjon i deteksjon | 81,25 % | 83,33 % | minst 90 % |
| Treff i deteksjon (recall) | 83,87 % | 32,26 % | minst 90 % |
| Vellykket reparasjon | 87,10 % | 58,06 % | minst 90 % |
| Bevaring | 100 % | 100 % | 100 % |
| Skadeandel | 11,11 % | 0 % | 0 % |
| Skitne dokumenter trygt forbedret | 0 av 3 | 0 av 3 | minst 80 % |
Skillen fant langt flere problemer og reparerte flere, men skadet også tekst i 11 prosent av tilfellene, og ingen av de tre skitne dokumentene ble trygt bedre. Prosjektet konkluderer selv med «no-ship» og skriver at betaversjonen ikke påstår en validert forbedring. Jeg stoler mer på et prosjekt som publiserer et slikt resultat enn på et som bare viser vinnertall.
Lisensen er en felle. SKILL.md oppgir license: MIT, men repoet har ingen LICENSE-fil, og GitHubs lisens-API svarer 404. Skal du kopiere skriptene inn i et bedriftsrepo, bør du få en lisensfil på plass hos forfatteren først.
Hva gjør miodkuj
miodkuj er skrevet på engelsk og retter polsk tekst. Den bygger på tre regler: gjør den minste effektive endringen, klatre ned en «Specificity Ladder» fra fakta som allerede står i kilden til å gjøre påstanden mindre eller fjerne den, og bruk en flyttbarhetstest. Den siste lyder slik:
Hvis en setning kan flyttes uendret til et annet selskap, departement, produkt, prosjekt eller en annen person, er den sannsynligvis fyllstoff. (egen oversettelse)
Skillen forbyr også å finne på tall, eksempler, kunder eller kilder for å få prosaen til å virke menneskelig. Testen i evalueringen for 2.1.1 ga 12 av 13 bestått og ett delvis tilfelle, som først ble rapportert som bestått og rettet samme dag. Forfatteren skriver selv at resultatet ikke gir noen generell pålitelighetsrate.
For norsk tekst finnes det ingen tilsvarende skill som jeg har kunnet verifisere. Jeg nevner miodkuj fordi den viser hva en språkspesifikk skill bør gjøre: kjenne byråkratspråket i ett bestemt språk og nekte å dikte opp. Alle mine polske tekster går gjennom den; det er en fast regel hos meg siden 2. november 2026.
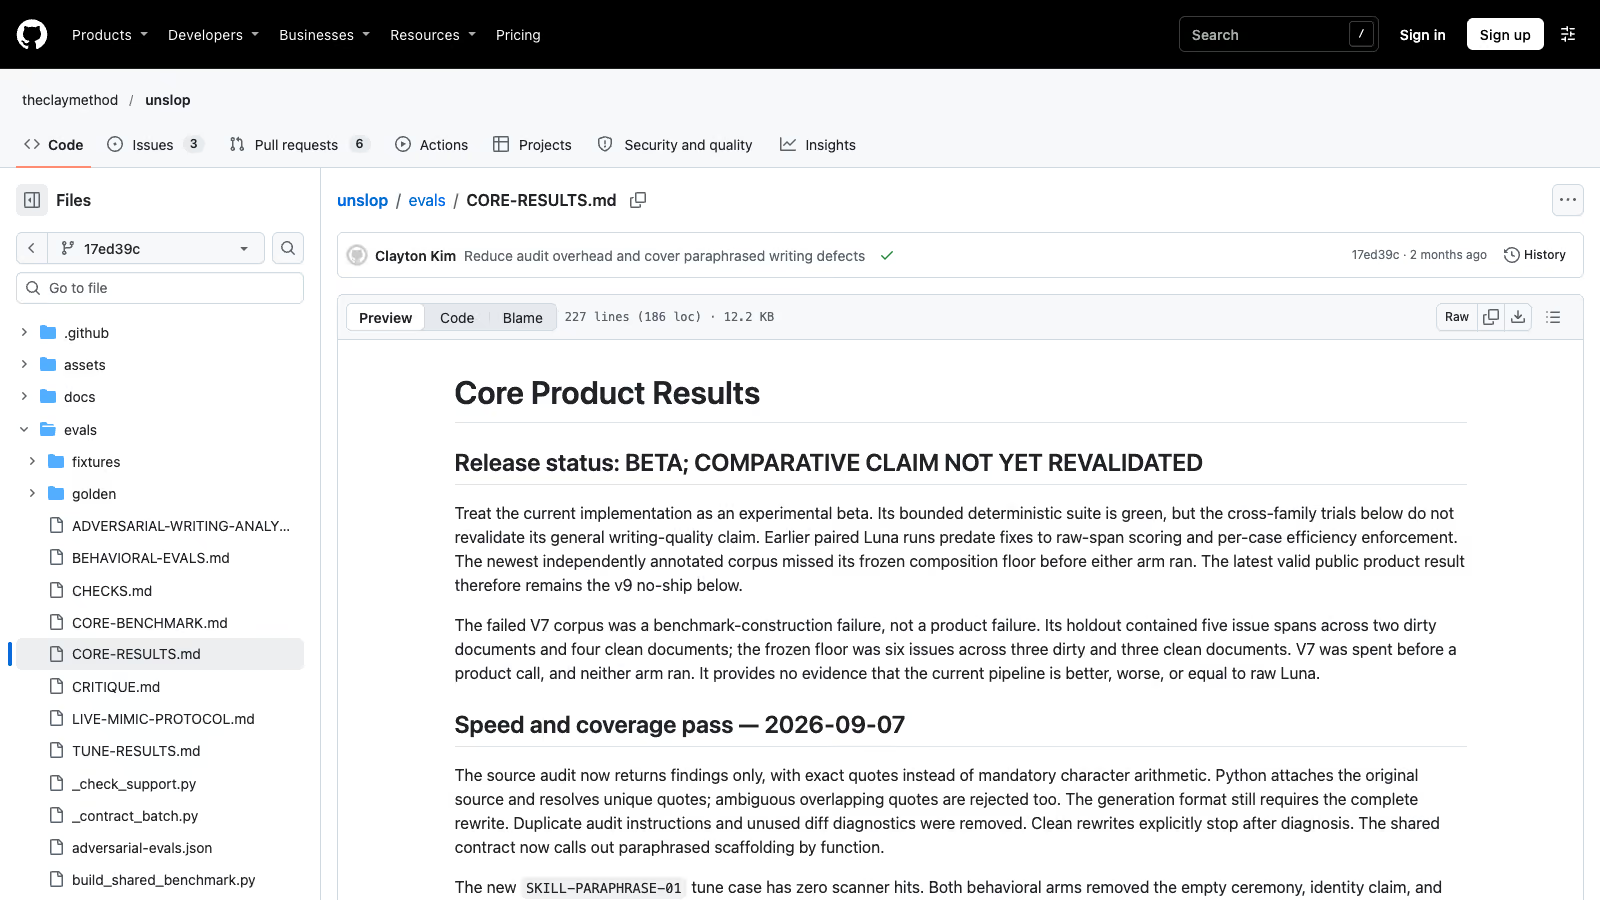 Evalueringssiden til unslop i commit 17ed39c: beta, sammenligningspåstanden er ikke bekreftet på nytt (skjermbilde 6. november 2026).
Hvorfor betyr grønt på norsk ofte «ikke sjekket»
Alle tre unslop-skannerne kaller en funksjon som anslår om teksten er engelsk, ut fra andelen engelske funksjonsord (grensen er 10 prosent, og tekster under 15 ord regnes alltid som engelske). Når teksten ikke består den testen og ingen treff er funnet, skriver skanneren {"non_english": true, ...}, en merknad på stderr om at den avslo, og avslutter med kode 0.
For et norsk team betyr det at en dokumentasjonsside på bokmål passerer porten uten at én regel er brukt. README sier det rett ut: bare engelsk, ikke-engelsk tekst får en billig gjenkjenning og et tydelig avslag. Avslaget er bare tydelig hvis noen leser JSON. En CI-jobb som bare ser på avslutningskoden, rapporterer suksess.
humanizer har samme begrensning på en annen måte. Mønstrene er beskrevet med engelske eksempler. En sterk modell kan overføre noen av dem til norsk, men ingen har testet hvor godt, og jeg har ikke funnet noen måling.
Hva sjekker jeg selv i norske tekster
Fordi de engelske verktøyene ikke dekker bokmål, har repoet mitt egne deterministiske sjekker. De er enkle ordlister og regulære uttrykk, og jeg kaller dem kandidatfinnere. Tallene under er fra kildekoden 6. november 2026.
| Sjekk | Hva den ser etter i nb-filer | Omfang |
|---|---|---|
check-voice-rules.mjs | Lange tankestreker, fyllverb, plassholdernavn, kinesiske tegn etter oversettelse, Title Case i overskrifter, engelsk generatortekst i strukturerte data | 42 regler totalt, to av dem nevner nb-filer eksplisitt |
check-slop-rhetoric.mjs | Setningsform: oppvarming før poenget, oppblåst betydning, anonym autoritet, falske motsetninger, oppsummeringsåpninger | 12 mønstre, 11 aktive som standard; 7 av dem har norske formuleringer |
check-diacritic-wordlist.mjs | Ord der æ, ø eller å er strippet bort | 74 sikre feilformer for nb og 9 tvetydige som bare gir advarsel |
check-loanword-density.mjs | Engelsk byråsjargong i ikke-engelske filer, og overskriftslister som ser ut som en mal | 29 uttrykk; feiler ved minst 12 treff og minst 5 per 1000 ord; advarer ved 15 H2-er der ett ord går igjen i 75 % |
Flere av mønstrene i retorikkskriptet er hentet fra skillen no-ai-slop (petergyang) og bygget for flere språk, fordi en detektor som bare kan engelsk ville slippe fem av mine seks språk gjennom. Det er likevel ikke symmetrisk. Fire av de elleve aktive mønstrene har ingen norsk variant: falsk innsikt, negativ oppramsing, retorisk oppsett og falske sterke verb. En grønn kjøring på en nb-fil har altså sjekket sju av elleve former. Det er samme problem som non_english hos unslop, bare i mindre skala og hjemme hos meg selv.
Diakritikk-listen kom etter en reell regresjon: en reparasjonscommit for bokmål rettet 4452 forekomster av strippede tegn. Listen inneholder bare ord der den strippede formen ikke er et eget ord. Derfor står mal (mål eller mal som i maltekst), sa og for på den tvetydige listen og stopper ingenting.
Tiltale er et hull. Skriptet check-reader-address.mjs teller feil pronomen for tysk (Sie), spansk (tú) og europeisk portugisisk. Norsk mangler. Regelen hos meg er du på bokmål, og den håndheves bare ved gjennomlesing.
Kjøringene fra 6. november: check-voice-rules på tre engelske innlegg ga 0 brudd med 42 regler, check:slop-rhetoric på hele korpuset (8681 filer) ga totalt 0, og check-ai-slop-copy --check fant ingen kalker. Det sier at ordlistene er rene. Om prosaen er god, sier det ingenting om; det avgjør humanizer-passet og en person som leser.
Hvordan bygger jeg en CI-port som bare stopper harde funn
Fire ting fra kildekoden til unslop bestemmer hvordan steget må se ut:
banned_phrase_scan.pyavslutter med 1 ved ethvert funn, uansett alvorlighetsgrad. Kilden har 38 harde og 14 myke oppføringer.structure_scan.pyogsilhouette_scan.pymerker alle funn som myke og avslutter likevel med 1.- Ikke-engelsk tekst gir
non_english: trueog kode 0. - Koden 2 betyr at filen ikke kunne leses.
Avslutningskoden kan derfor ikke skille hardt fra mykt. Steget må lese by_severity fra JSON, og non_english må bli en synlig advarsel i stedet for et stille grønt resultat. For et norsk team vokter denne porten bare de engelske filene, typisk README og API-dokumentasjon.
name: docs-slop-gate
on: pull_request

jobs:
  scan:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
      - uses: actions/setup-python@v5
        with:
          python-version: "3.11"
      - name: Fetch unslop at a pinned commit
        run: |
          git clone https://github.com/theclaymethod/unslop /tmp/unslop
          git -C /tmp/unslop checkout 17ed39c9d0b522f44190ff0c6233867eadee192a
      - name: Block hard findings, report soft ones
        run: |
          fail=0
          for f in $(git diff --name-only --diff-filter=AM "origin/${{ github.base_ref }}"... -- '*.md'); do
            out=$(python3 /tmp/unslop/scripts/banned_phrase_scan.py "$f") && code=0 || code=$?
            if [ "$code" -eq 2 ]; then echo "::error file=$f::unreadable"; fail=1; continue; fi
            if echo "$out" | jq -e '.non_english == true' >/dev/null 2>&1; then
              echo "::warning file=$f::not checked (non-English input)"; continue
            fi
            hard=$(echo "$out" | jq '(.by_severity.hard // 0) | if type == "array" then length else . end')
            soft=$(echo "$out" | jq '(.by_severity.soft // 0) | if type == "array" then length else . end')
            [ "$soft" != "0" ] && echo "::notice file=$f::$soft soft finding(s), review"
            if [ "$hard" != "0" ]; then
              echo "::error file=$f::$hard hard finding(s)"
              echo "$out" | jq -r '.violations[] | select(.severity == "hard") | "\(.line_number): \(.phrase)"'
              fail=1
            fi
          done
          exit $fail
      - name: Structure report (never blocks, every flag is soft)
        run: |
          for f in $(git diff --name-only --diff-filter=AM "origin/${{ github.base_ref }}"... -- 'docs/*.md'); do
            python3 /tmp/unslop/scripts/structure_scan.py "$f" --genre docs || true
          done
Lås skriptene til en commit, fordi en skanner som endrer seg mellom to kjøringer, gir grønne og røde bygg uten at teksten er endret. --genre docs tillater lister med fet etikett, som ekte referansedokumentasjon bruker. Lisensspørsmålet over gjelder også her: steget henter kode uten lisensfil inn i bygget ditt.
Mitt eget repo gjør det samme med egne skript. check:slop-rhetoric:gate kjører med --check --budget=0 som del av npm run check, og den kjøres ved push til master. check-voice-rules.mjs rapporterer og avslutter med 0 som standard, og stopper bare med --fail-on-findings.
 Repositoriet blader/humanizer: MIT-lisens, versjon v3.1.0 (skjermbilde 6. november 2026).
Hvordan sjekker jeg at omskrivingen beholdt fakta
Den største risikoen ved en anti-slop-omskriving er at et tall, en nektelse eller et vilkår forsvinner. unslop-tabellen over viser 11 prosent skade selv med en god modell. validate_preservation.py sammenligner original og omskrevet tekst:
# --strict MUST be the first argument; anywhere else it is read as a file name
python3 scripts/validate_preservation.py --strict original.md rewritten.md constraints.json
Utdata er JSON med passed, total_constraints, preserved, missing og warnings. Uten --strict gir semantisk drift i nektelser, omfang og vilkår bare advarsler. Med --strict blir de til feil. For utgivelsesnotater, der «støttes ikke lenger» og «støttes» er to helt forskjellige meldinger, ville jeg alltid kjørt strengt.
Skriptet sjekker engelsk best. For norsk tekst anbefaler jeg en enkel diff av tall, URL-er og kode før og etter, og at noen leser hver endret setning som inneholder ordet «ikke».
Oppdatering, . En omskriving sammenligner den nye teksten med utkastet, så et feil tall overlever like trofast som et riktig. Kommer tallet fra en KI-assistent, følg kildehenvisningen helt til studien som målte det. Trakkr, som selger overvåking av merkevaresynlighet i KI-søk, publiserte Zombie stats 28. oktober 2026. De stilte ChatGPT, Perplexity, Gemini, Claude og Google AI Overviews 200 spørsmål der svaret er et tall, og fulgte 1285 siterte statistikker opptil fem sider bakover. 40 prosent nådde en studie som sier det samme, 8 prosent nådde studien med endret tall eller sammenheng, 40 prosent stoppet ved en kilde Trakkr ikke kunne kontrollere, og 11 prosent førte ingen steder. Bare 21 prosent av sidene som ble sitert for et tall, var selve forskningen. Ender sporet på en side uten etterprøvbar kilde, stryk tallet eller skriv i teksten at du ikke har fått det bekreftet.
Hvordan deler jeg én skill mellom Claude Code, Cursor og plugins
Når et team bruker flere agenter, ender den samme skillen fort i tre kopier som glir fra hverandre. Kris Geusebroek hos Xebia beskriver løsningen i Don’t Repeat Yourself: Sharing Skills Across Claude Code Plugins: én skills-mappe øverst i prosjektet og symbolske lenker dit.
Husk å bruke en relativ sti som mål for den symbolske lenken, ikke en absolutt sti. (egen oversettelse)
Claude Code-dokumentasjonen om skills bekrefter at det virker:
En
<skill-name>-oppføring på det sentrale, personlige eller prosjektnivået kan være en symbolsk lenke til en mappe et annet sted på disken. Claude Code leserSKILL.mdfra målet og laster skillen én gang selv om flere steder peker på samme mål. (egen oversettelse)
Plugins oppfører seg annerledes. Etter dokumentasjonen for markedsplasser beholdes en lenke inne i pluginens egen mappe som relativ, en lenke til et annet sted i samme markedsplass blir løst opp og kopiert inn i hurtigbufferen, og en lenke ut av markedsplassen hoppes over av sikkerhetshensyn.
# the skill lives once, in skills/humanizer
mkdir -p .claude/skills .cursor/skills
ln -s ../../skills/humanizer .claude/skills/humanizer
ln -s ../../skills/humanizer .cursor/skills/humanizer

# git must store a link, not a copy: expect mode 120000
git ls-files --stage .claude/skills/humanizer .cursor/skills/humanizer
I mitt repo ligger det seks slike relative lenker i .cursor/skills/, alle inn i ../../.claude/skills/<navn>. På Windows krever det Developer Mode eller utvidede rettigheter å lage lenkene (mklink /D fra et ledetekstvindu med administratorrettigheter); skriv det i README, ellers sjekker en kollega ut repoet og får tekstfiler med en sti i stedet for mapper.
Personlige skills ligger i ~/.claude/skills/<navn>/SKILL.md og gjelder alle prosjekter på maskinen, men ikke Cowork eller skyøkter. Prosjektskills i .claude/skills/ kan sjekkes inn, slik at hele teamet får dem. En skill installert som plugin kalles med navnerom, for eksempel /humanizer:humanizer. Jeg har lagt humanizer og miodkuj inn manuelt for å få de korte navnene.
Hvilke instruksjoner kan teamet kopiere
Disse kan du kopiere og tilpasse. De fungerer i Claude Code, Codex og Cursor, så lenge skillen er installert.
For et engelsk dokument før publisering:
Run humanizer in file mode on docs/release-notes.md. Keep code blocks, URLs, version
numbers and frontmatter unchanged. Do not add numbers, customers, examples or sources
that are not already in the text. List every sentence you changed with the reason.
For en norsk tekst, der ingen skanner hjelper:
Les docs/brukerveiledning.nb.md. Finn setninger som kunne stått uendret i et annet
selskaps dokumentasjon, påstander uten dekning i teksten, og overskrifter som gjentar
samme ord. Foreslå den minste endringen for hver. Ikke finn på fakta. Behold kode og
lenker. Skriv til leseren med «du».
For å kontrollere en omskriving:
Compare original.md and rewritten.md. List every number, negation, condition and named
product in the original and say whether each survived with the same meaning.
Den siste er en manuell variant av validate_preservation.py for språk skriptet ikke er laget for.
Hva er rekkefølgen jeg anbefaler
- Skriv utkastet med agenten, med kilder i konteksten.
- Kjør humanizer på engelske tekster, og et språkspesifikt pass på resten (miodkuj for polsk; for norsk en instruksjon som den over).
- Sjekk at fakta overlevde, med
--strictfor engelsk og en diff for norsk. - La deterministiske sjekker i CI stoppe harde funn og rapportere resten.
- Les teksten selv. Ingen av sjekkene over avgjør om en setning gjør jobben sin.
Hvis porten er grønn på en norsk fil, spør hvilke regler som faktisk kjørte. Mine egne sjekker for opprydding i eldre innhold har jeg skrevet om i opprydding av AI-slop i WordPress, og hvilke verktøy jeg bruker nå, står på teknologiradaren.
Hva er neste steg for teamet ditt
Begynn med ett repo og én filtype, for eksempel README-filene. Legg humanizer inn som prosjektskill med en relativ lenke, sett opp CI-steget over med låst commit, og la det kjøre en uke i rapportmodus før du lar harde funn stoppe en pull request. Skriv ned hvilke språk som ikke blir sjekket, slik at grønt ikke blir lest som godkjent.
Vil du ha dette satt opp i en eksisterende kjede med Claude Code, Codex eller Cursor, med porter tilpasset språkene dere publiserer på, beskriver jeg hvordan jeg jobber på siden om AI-implementering. Send en beskrivelse av repoet og hvilke tekster som skrives med KI, så svarer jeg skriftlig med et forslag til oppsett.