En frisørsalong, en klinikk eller et oppussingsfirma får en henvendelse via skjemaet på nettsiden fredag klokka 21. Eieren leser den på mandag, og siden lørdag har kunden allerede snakket med noen andre. Derav ideen om å la en automatikk håndtere henvendelsene: svar innen ett minutt, fordeling til riktig person, ingenting forsvinner i innboksen.
De fleste veiledninger begynner med en språkmodell som svarer kunden. Jeg begynner i den andre enden, fordi det på mitt eget skjema på wppoland.com er lagene før og etter modellen som gjør mesteparten av jobben. Her er fem lag i den rekkefølgen en henvendelse går gjennom dem, med det som fungerer hos meg og der KI faktisk er til nytte.
Hvordan filtrere spam fra WordPress-skjemaet før KI ser det
En automatikk som svarer på spam, gjør to skader samtidig: Du betaler for hvert modellkall, og du sender svar til adresser som bare venter på det. Filteret må derfor stå foran modellen. Hos meg har det tre lag.
Det første er et usynlig lokkefelt. Et menneske ser det ikke, mens en enkel bot fyller ut alle felt. Et utfylt felt betyr bot.
Det andre er Cloudflare Turnstile verifisert på serveren. Tokenet fra nettleseren går til funksjonen min, og først den spør Cloudflare om det er gyldig. Aldri fra nettleseren: Hemmeligheten ville blitt offentlig og resultatet lett å forfalske. Jeg avviser henvendelser uten token eller med ugyldig token. Når selve verifiseringen hos Cloudflare ikke svarer, slipper henvendelsen gjennom, fordi et avbrudd i en annens tjeneste ikke skal sluke ekte kunder.
Det tredje er innholdssignaturer som aldri finnes i en ekte henvendelse: en HTML-lenke skrevet inn for hånd i prosjektbeskrivelsen, BBCode-koder, en Telegram-lenke i feltet for nettside. Jeg la også navnet på et verktøy for skjemaspam til lista, fordi en serie kasinohenvendelser 29. juli 2026 kom fra en adresse som inneholdt navnet på det verktøyet.
Turnstile alene er ikke alltid nok. Forfatteren av bloggen elszczepano beskrev i august 2026 at Cloudflare merket omtrent halvparten av trafikken på WordPress-siden hans som sannsynlig bot, og likevel havnet hundrevis av spamkommentarer i kommentarfeltet (When SIMPLER means BETTER?). Det som hjalp, var et eget lokkefelt koblet inn i functions.php: En innsending slipper bare gjennom når feltet finnes og er tomt. Ifølge forfatteren har ingen kommentar havnet i spam siden november 2025. Konklusjonen hans passer også for skjemaer: Spambotene er generiske, så selv en enkel mekanisme de ikke venter seg, siler ut de fleste.
På spam svarer jeg akkurat som på en ekte henvendelse: en bekreftelse og et nummer. En avsender som får vite at den ble avvist, bytter adresse og prøver videre.
Hvilke skjemafelt sparer KI-modellen for arbeid
En del henvendelser kan fordeles helt uten modell. Skjemaet mitt har tre felt med faste valg: prosjekttype (ny nettside, reparasjon, drift, migrering, annet), tidsramme og budsjettintervall. Hvert av dem kan fordeles med en vanlig betingelse i koden, for eksempel reparasjon av en nettbutikk til hastekøen og en migrering til personen som tar seg av migreringer.
Én detalj kostet meg litt tid. Skjemaet sender budsjettintervallet som en kode, for eksempel band-3, og intervallene er ikke i samme valuta på alle språk (den polske versjonen i złoty, de andre i euro). En e-post med bare koden var uleselig, så funksjonen legger til en etikett med beløpet på skjemaets språk. Den samme etikettlista finnes to steder, og derfor sjekker en test ved hvert bygg at begge er identiske.
Først fritekstbeskrivelsen av prosjektet krever mer enn en betingelse.
Hvordan fordele en skjemahenvendelse med en beslutningsmodell
Til fordeling trenger du ikke en modell som skriver lange tekster. En beslutningsmodell holder: Den får en tekst og en liste med alternativer og returnerer ett av dem. For eksempel: “hvilket team skal få denne henvendelsen: nettbutikk, bedriftsside, integrasjon, annet” eller “haster denne henvendelsen: ja, nei”.
Det finnes minst to slike modeller på markedet. Jev, som jeg bruker i kvalitetskontrollen av tekster i dette repositoryet, og Clef, som Cloudflare publiserte i begynnelsen av oktober 2026 i Workers AI og på Hugging Face, med lisensen Apache 2.0 og kompatibel med API-et til Jev. Ifølge Cloudflares egne målinger er medianforsinkelsen 209,3 ms for Clef, 38,8 ms for den mindre Clef-flash og 524,1 ms for Jev (Cloudflare). Dette er leverandørens egne tall, så uavhengige sammenligninger kan gi et annet resultat.
For et polsk firma finnes et tredje alternativ, basal av Remek Kinas: den fungerer på polsk og engelsk, har åpne vekter under Apache 2.0 og kjører lokalt, også på Mac med Apple Silicon eller via Ollama, så innholdet i henvendelsene forlater aldri firmaet. Den svarer på de samme spørsmålstypene som Jev via et endepunkt med samme navn. Fra versjon 2.2 har den basal-calibrate, som tilpasser modellens sikkerhet til noen hundre merkede eksempler fra din egen prosess, og spørsmål med satt maksimal feil markerer usikre tilfeller som utsatt, altså til et menneske. Forfatteren måler kvaliteten med sin egen benchmark Werdykt, så test modellen på dine egne henvendelser før du stoler på den. Norsk støttes ikke.
Kostnaden med mine tall: Å vurdere 300 avsnitt med Jev kostet én cent, og å kjøre hele tekstsamlingen gjennom den, rundt 134 000 avsnitt, ville kostet 3,32 USD og tatt 100 minutter. Med noen titalls henvendelser i måneden er kostnaden for en beslutningsmodell ubetydelig. Det som koster mer, er tiden det tar å sette den opp og å sjekke at fordelingen stemmer.
Når bør beslutningsmodellen gi henvendelsen til et menneske
Lagene over danner et hierarki som Parth Parikh sammenligner med datamaskinens minne i essayet To Make, or to Buy: The Economics of Decision Models fra oktober 2026: regler tar det de kan, en beslutningsmodell tar neste del, en språkmodell de vanskeligere sakene og et menneske resten. Hvert nivå svarer bare der det er sikkert, og sender resten videre til neste nivå. I skjemaet mitt er feltene med faste valg reglene, beslutningsmodellen fordeler den frie prosjektbeskrivelsen, språkmodellen skriver svarutkastet og et menneske godkjenner det.
Spørsmålet er hvor sikker beslutningsmodellen må være. Parikh bruker Chows regel (han daterer den til 1970): svar når sjansen for feil, altså 1 minus den høyeste sannsynligheten, er lavere enn kostnaden ved å sende videre. Den kostnaden, målt i enheter av ett feil svar, er feilraten på neste nivå pluss prisen der delt på kostnaden ved én feil.
Et hypotetisk eksempel i abstrakte kostnadsenheter. En henvendelse som havner hos feil person, koster 50 enheter (forsinkelse, en tapt dag). Et menneske som leser og fordeler den, koster 5 enheter og tar feil i 2 % av tilfellene. Terskelen blir 0,02 + 5/50 = 0,12, så modellen fordeler selv bare når det beste alternativet har sannsynlighet over 0,88. Kontroll på 100 henvendelser der modellen er 70 % sikker: fordeler den alle selv, havner 30 feil, altså 30 × 50 = 1500 enheter. Fordeler et menneske alle: 100 × 5 + 2 × 50 = 600 enheter. Mennesket er billigst. Ved 95 % sikkerhet er modellen billigst: 5 × 50 = 250 enheter mot de samme 600.
Koster en feilfordelt henvendelse 500 enheter, for eksempel en reklamasjon med frist, synker terskelen til 0,02 + 5/500 = 0,03, og modellen må være mer enn 97 % sikker. Da endrer prisen på menneskets arbeid nesten ikke resultatet, det som avgjør, er hvor ofte mennesket selv tar feil. Lar modellen deg sette en maksimal feil, slik basal gjør, gir dette regnestykket verdien du skal bruke i stedet for en gjetning.
Parikh legger til to forbehold. En modell kan ta feil med høy sikkerhet, så send et lite tilfeldig utvalg, for eksempel 1 % av de sikre avgjørelsene, til neste nivå likevel. Da ser du også den faktiske feilraten. Og ikke alle feil koster like mye: en juridisk sak hos feil team koster mer enn en forveksling mellom to tekniske køer, så feilkostnaden bør avhenge av kategorien.
Hva er de reelle begrensningene og feilene til klassifiserere som Jev i praksis
Oppdatering . Uavhengige ytelsestester og målinger av klassifiseringsmodeller (gjennomgått i analysen JEV uten hype: KI-klassifiserere mot klassiske LLM-er) nyanserer markedsføringspåstander om null hallusinasjoner eller et intuitivt System 1. I praksis bygger modeller som Jev på etablert zero-shot NLI (Natural Language Inference) på enkoderarkitekturer (beslektet med BERT). I stedet for å generere tekst tegn for tegn, beregner modellen sannsynligheten for hver svarkategori i én enkelt kjøring. Det gir 20 til 200 ganger høyere fart enn chatmodeller, men medfører fire konkrete begrensninger:
- Tvunget feil når ingen alternativer passer: Klassifikatoren finner ikke på egne ord, men når en henvendelse faller utenfor de oppgitte kategoriene, velger Jev sjelden manglende match. I uavhengige tester ble “ingen av disse” bare valgt i 7 % av tilfellene; i 93 % av forsøkene ble henvendelsen feilaktig tildelt en tilfeldig kategori fra listen.
- Følsomhet for rekkefølgen på kategoriene: Å endre rekkefølgen på svaralternativene reduserer treffsikkerheten fra 91 % til 76,5 %. For å sikre stabil ruting i produksjon må du rotere rekkefølgen over flere kjøringer og regne ut gjennomsnittet (ensemble averaging), eller låse en fast alfabetisk rekkefølge med en sikkerhetsmargin.
- Mangel på tallforståelse og budsjettlogikk: Når kunden oppgir et budsjett i løpende tekst (for eksempel 150 000 kr), feiler NLI-modellen i over 90 % av tilfellene med å plassere tallet i riktig beløpsintervall. Tall, tidsfrister og strukturerte data må du alltid hente ut med deterministiske regulære uttrykk eller skjemavalidering med Zod før teksten sendes til modellen.
- Sårbarhet for prompt injection i skjematekst: Siden teksten går rett inn i oppmerksomhetskonteksten til enkoderen, kan ondsinnede instruksjoner i skjemaet forstyrre vektingen og tvinge frem feil prioritering.
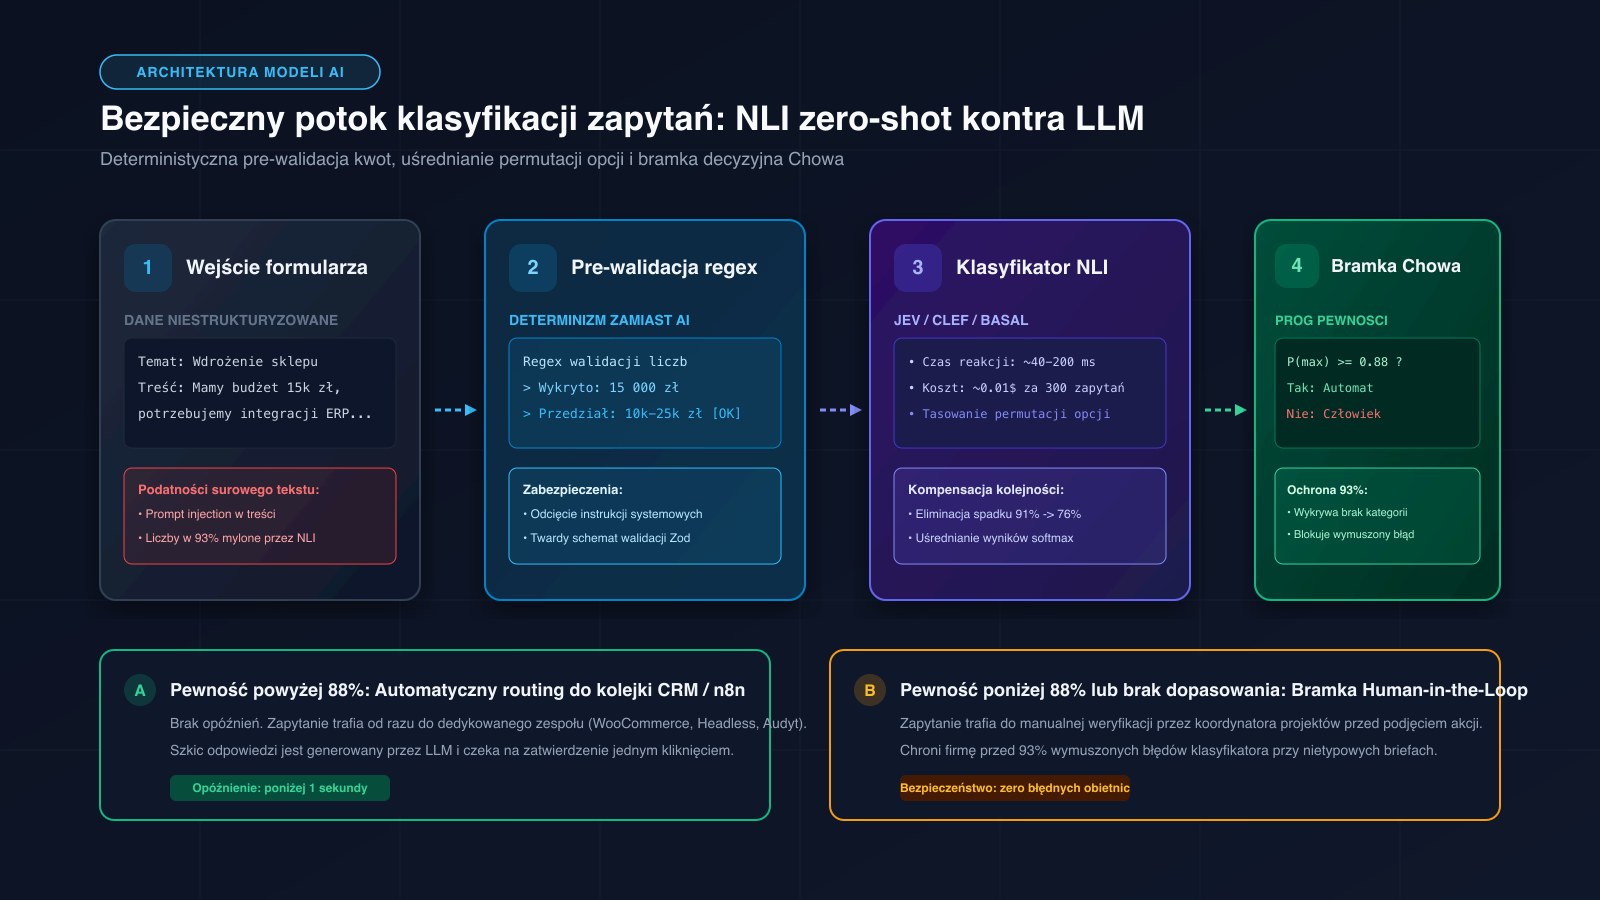 Sikker beslutningsflyt: deterministisk talluthenting med regex, utjevning av alternativrekkefølge og sjekk mot Chows regel før manuell vurdering.
Kan KI svare kunder fra kontaktskjemaet på egen hånd
Teknisk sett, ja. I praksis nevner det første svaret på en henvendelse som regel en frist, et omfang eller en pris, altså et løfte på vegne av bedriften. En modell som skriver “vi gjør det på en uke” til en kunde med et prosjekt på to måneder, koster mer enn den sparer.
Det samme prinsippet beskriver Anthropic i sin veiledning om agenter for handel: Ingen verktøykall fra modellen flytter penger eller endrer noe i bedriften, og det verste modellen kan gjøre, er å foreslå en endring som et menneske eller en regel godkjenner (A guide to the anatomy of effective commerce agents). Bestillinger, betalinger, refusjoner og prisendringer går der gjennom den samme godkjenningen som bedriften bruker for slike endringer uten KI. Et svar med pristilbud til en kunde er samme type endring.
Et tryggere oppsett: Modellen lager et utkast, og et menneske sender det. Utkastet får kontekst fra skjemafeltene og beskrivelsen av tjenesten henvendelsen gjelder. Godkjenningen tar ett minutt, og kunden får svar samme dag i stedet for på mandag. Det eneste som bør gå ut uten et menneske, er mottaksbekreftelsen med referansenummer. Hos meg ser kunden dette nummeret, i et format med dato og et tilfeldig suffiks, rett etter at skjemaet er sendt.
Hvordan koble et WordPress-skjema til n8n og Claude
Det finnes to veier. Den første er n8n: Skjemaet sender data til en Webhook-node, som starter flyten. Noden har egen test- og produksjonsadresse, så du kan teste flyten uten å røre skjemaet som er i drift (dokumentasjonen til n8n). Videre i den samme flyten har n8n en ferdig Anthropic-node for svarutkast i Claude, og noder for e-post, Slack eller et CRM.
Den andre veien er egen kode. Skjemaet mitt håndteres av en funksjon på Cloudflare Pages: validering av felt, spamfilter, Turnstile, utsendelse og telemetri i én fil. Færre deler å vedlikeholde og full kontroll over hva som havner i loggene, men hver endring krever en utvikler.
Valget avhenger av hvem som skal endre reglene. Vil eieren selv legge til en ny kategori henvendelser, vinner n8n. Endres reglene én gang i kvartalet, er egen kode enklere å vedlikeholde.
Hva gjør du når e-posten fra skjemaet ikke blir sendt
En automatikk som tok imot en henvendelse og ikke leverte den, er verre enn ingen automatikk, fordi kunden tror meldingen kom fram. Hos meg går henvendelsen først gjennom Resend, og når den svikter, gjennom Web3Forms. Hos den andre leverandøren dukket det opp en detalj som er lett å overse: Web3Forms svarer med status 200 også når den avviser meldingen, og beskjeden om avvisningen ligger i innholdet i svaret. En sjekk av bare HTTP-statusen ville regnet en slik utsendelse som vellykket.
Den andre lærdommen gjelder feil. Hver feilvei returnerer sin egen kode, ikke bare en melding. To av dem har den samme HTTP-statusen 422 og helt ulik betydning: et feil utfylt skjema og et utløpt antispam-token. Så lenge nettleseren samlet alle feil under ett navn, var feilen med utløpt token usynlig i telemetrien.
Hva koster automatisk håndtering av henvendelser, og når lønner det seg
Modellkostnaden er ubetydelig i liten skala, det som teller, er tiden til oppsett og vedlikehold. Det lønner seg når henvendelsene kommer utenfor arbeidstid, når de går til flere personer, eller når noen av dem i dag forsvinner i innboksen. Med noen få henvendelser i måneden går det raskere å sette opp et varsel på telefonen.
Dine egne tall regner du ut i kalkulatoren for lønnsomhet ved automatisering. En slik flyt på en WordPress-side setter jeg opp som en del av automatisering av forretningsprosesser og AI-integrasjon med WordPress: først filteret og feltene, så fordelingen, til slutt svarutkastet, og hvert steg testes på ekte henvendelser før jeg går videre til det neste.