Nei, Cloudflare blokkerer ikke Googlebot som standard. Men fra 15. september 2026 gjør ett valg i innstillingene for AI-roboter noe mange ikke regner med: “Block” stopper Googlebot ved inngangen, søkemotoren inkludert, og ikke bare AI-treningen. Står WordPress-siden din bak Cloudflare, og noen har “slått av AI” de siste ukene, bør du sjekke det i dag.
- oktober 2026 dukket det opp en setning fra et innlegg på X i dagsoppsummeringen på Search Engine Roundtable: “Cloudflare gikk over til å blokkere Google som standard 9/15” (Search Engine Roundtable, 7. oktober 2026, egen oversettelse). Selve innlegget på X lot seg ikke åpne uten innlogging, så nedenfor bygger jeg bare på kilder fra Cloudflare. Alle sitatene er kontrollert 8. oktober 2026.
Hva endret Cloudflare 15. september 2026
Før fantes det én bryter, “Block AI bots”. Nå er det tre kategorier, og hver har sin egen innstilling. Cloudflare definerer dem slik:
- Search: “gjennomsøking for å bygge en søkeindeks.” (egen oversettelse)
- Training: “gjennomsøking for å trene eller finjustere en modell.” (egen oversettelse)
- Agent: “brukerstyrte agenter som besøker en side på vegne av et menneske, for eksempel chat-henteboter og nettleseragenter.” (egen oversettelse)
Kilde for definisjonene: Cloudflare Blog, 15. september 2026.
Du kan velge mellom fire alternativer: Allow, Disallow AI Training, Block on pages with ads og Block. Disallow AI Training finnes bare i kategorien Training. Cloudflare oppgir at de nye innstillingene er tilgjengelige “for alle kunder, på alle planer” (egen oversettelse), altså også på gratisplanen.
Hvorfor stopper Block Googlebot
Fordi Googlebot er en blandet crawler. Cloudflare bruker det begrepet om en robot som håndterer både søk og trening med én og samme user agent:
“En blandet crawler er én enkelt crawler som håndterer både Search og Training.”
Cloudflare Blog, 15. september 2026, egen oversettelse
Cloudflare nevner tre slike crawlere: Applebot, Bingbot og Googlebot. Siden det ikke går an å stoppe bare “den delen av Googlebot som trener”, rammer blokkeringen hele roboten. Cloudflare skriver det rett ut:
“Det vil hindre Applebot, Bingbot og Googlebot i å nå nettstedet ditt […] søk inkludert.”
Cloudflare Blog, 15. september 2026, egen oversettelse
Det samme gjelder Block on pages with ads, bare i mindre omfang: Ifølge Cloudflare blokkeres crawlere, også de blandede, da på sider der det er oppdaget annonser. For en WordPress-blogg med AdSense kan det bety at Google slutter å se nettopp de innleggene som tjener penger.
Det trygge valget for søkemotoren er Disallow AI Training. Det publiserer bare en preferanse i robots.txt, og Cloudflare understreker at Googlebot “kan fortsette å crawle nettstedet ditt for søk” (egen oversettelse). Å reservere seg mot at Google trener modeller på innholdet ditt styres av et eget token, Google-Extended, som jeg har skrevet om i innlegget om Googles tre AI-brytere.
Hva skjedde med den gamle bryteren Block AI bots
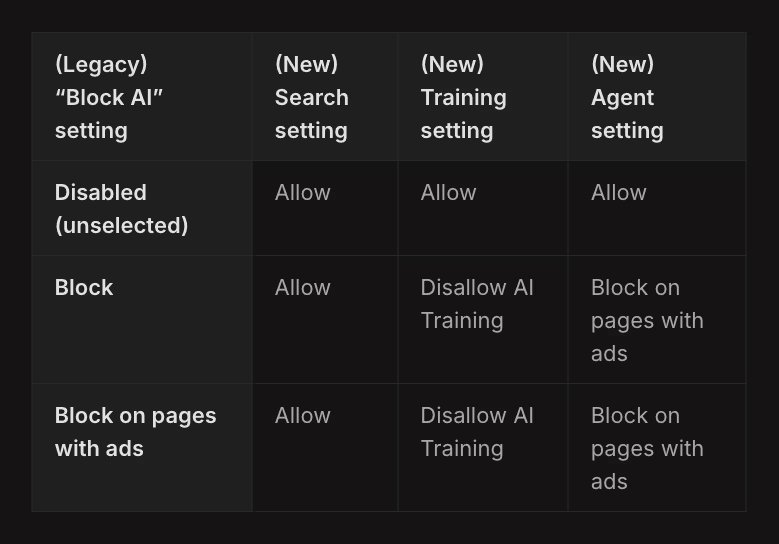
Cloudflare fjerner den og flytter eksisterende soner over til de nye innstillingene. Migreringstabellen i blogginnlegget ser slik ut:
| Gammel “Block AI” | Search | Training | Agent |
|---|---|---|---|
| Av | Allow | Allow | Allow |
| Block | Allow | Disallow AI Training | Block on pages with ads |
| Block on pages with ads | Allow | Disallow AI Training | Block on pages with ads |
Ifølge denne tabellen har ingen som brukte den gamle bryteren, fått Googlebot blokkert automatisk. Search går alltid over til Allow, og Training til Disallow AI Training, altså varianten som bygger på robots.txt.
Nye domener, lagt til fra 15. september, får ved oppsett ett av to ferdige oppsett. Nettsted uten annonser: alt på Allow. Nettsted med annonser: Search Allow, Training Disallow AI Training, Agent Block on pages with ads. I begge oppsettene er Preference Sync slått på, som ifølge Cloudflare “publiserer den aktuelle preferansen mot trening i robots.txt” (egen oversettelse) og erstatter den tidligere Managed Robots.txt.
Blokkerer Cloudflare Googlebot når AI-trening blokkeres
Dokumentasjonssiden om blokkering av AI-roboter inneholder en setning som ikke stemmer med tabellen:
“Crawlere med blandet formål som kombinerer Search og Training, vil også bli blokkert av alle konfigurasjoner for å blokkere AI-trening”
Cloudflare Docs, Block AI bots, egen oversettelse
Tar man den bokstavelig, blokkerer enhver konfigurasjon som stopper trening, den gamle bryteren inkludert, også Googlebot. Migreringstabellen sier det motsatte. Hvilken versjon som beskriver hva Cloudflares servere faktisk gjør med trafikken din, avgjøres bare av din egen sone og dine egne logger, ikke av noen av disse to tekstene.
Dokumentasjonen oppgir også at den gamle bryteren er “utfases 15. september 2026”, og at for nye domener “vil Search fortsatt være tillatt” (egen oversettelse). Verken innlegget eller dokumentasjonen nevner Cloudflare Pages.
Hvorfor Cloudflare kan blokkere GPTBot uten å røre søket, men ikke Googlebot
Det samme innlegget forklarer hvorfor Google, Apple og Microsoft behandles annerledes enn andre AI-selskaper. Cloudflare har innført betegnelsen “Accountable” for operatører av crawlere. For å få den må en operatør oppfylle, eller forplikte seg til å oppfylle, fire krav: en måte å reservere seg mot AI-trening på (via robots.txt eller en lignende standard), en måte å reservere seg mot AI-sammendrag på, innsyn på URL-nivå i hvilke sider som er gjort tilgjengelige for trening, og en forsikring om at reservasjon mot trening ikke påvirker vanlige søkeresultater (Cloudflare Blog, 15. september 2026).
Cloudflare regner Applebot, Googlebot og Bingbot som blandede crawlere med betegnelsen Accountable. Treningscrawlerne til Amazon, Anthropic, Meta og OpenAI er klassifisert annerledes: Disse selskapene har egne crawlere for søk og for trening, så Cloudflare kan blokkere treningsboten og la søkeboten være. Det er hele grunnen til at Disallow AI Training virker slik den gjør. Crawlere som bare trener blir blokkert, mens blandede crawlere med betegnelsen Accountable fortsatt slipper inn for søk og får reservasjonen mot trening gjennom robots.txt.
Reservasjonen virker bare hvis operatøren leser den. Google respekterer Disallow for tokenet Google-Extended, og Apple respekterer det for Applebot-Extended. Microsoft er et unntak: Ifølge det samme innlegget bygger Bing fortsatt støtte for en reservasjon mot trening i robots.txt på domenenivå, med mål om tidlig 2027, og fram til da sender ikke Disallow AI Training denne preferansen automatisk videre til Bing. I mellomtiden viser Cloudflare til metataggen NOARCHIVE og verktøyet Block URLs i Bing.
Hvordan sjekke om Googlebot kommer inn på WordPress-siden din
Tre steg, rundt tre minutter, hvis du har tilgang til Search Console og Cloudflare-kontoen.
- URL-inspeksjon i Search Console. Lim inn adressen til forsiden og kjør en live-test. Du ser etter en vellykket henting av siden og en siste gjennomsøking etter 15. september. Gjenta for ett innlegg med annonse, hvis du viser annonser, for det er der Block on pages with ads virker.
- Gjennomsøkingsstatistikk. Åpne gjennomsøkingsstatistikken under innstillingene i Search Console og se på fordelingen etter svar. En brå økning i 403-svar fra midten av september er et tegn på at noe i kanten stopper Googlebot.
- Soneinnstillingene i Cloudflare. Cloudflare skriver at de nye kontrollene “kan konfigureres i Security Settings for domenet (sonen)” (egen oversettelse). Sjekk hva som er valgt under Search, Training og Agent. Ser du Block under Training eller Search, og vil bli værende i Google, endrer du det til Disallow AI Training eller Allow.
Ta samtidig en titt på robots.txt. Er Preference Sync aktiv, legger Cloudflare inn sin preferanse der. På WordPress lages robots.txt ofte også av en SEO-utvidelse, så sjekk den ferdige filen på adressen /robots.txt, ikke bare innstillingene i utvidelsen. Vår egen Content-Signal-linje viser hvor lett robots.txt glir bort fra det vi tror står der.
Fjerner Google-Extended i robots.txt nettstedet fra Google-søk
Nei. Googles dokumentasjon om de vanlige crawlerne sier at Google-Extended ikke har en egen user agent-streng i HTTP-forespørsler. Gjennomsøkingen gjøres av Googles eksisterende user agents, og tokenet fungerer bare som en innstilling i robots.txt. Google skriver at det ikke påvirker om nettstedet er med i Google-søk, og at det ikke brukes som rangeringssignal. Det styrer bare om innhold som er hentet, kan brukes til å trene framtidige Gemini-modeller og til grounding i Gemini-apper og Vertex AI (Google Search Central, Googles vanlige crawlere).
Den samme siden forklarer en detalj som betyr noe når du tester. Live-testen i Search Console og testen for utvidede resultater henter siden som Google-InspectionTool, en crawler for Googles testverktøy som ikke har noen effekt på Google-søk. En vellykket live-test viser altså at sonen slipper inn en Google-crawler akkurat nå. Hvordan selve Googlebot er blitt behandlet de siste ukene, ser du i gjennomsøkingsstatistikken, og derfor bruker sjekken over begge deler.
Hva skjer med indekserte sider når Googlebot får 403
En blokkering i Cloudflare svarer Googlebot med en feilside i stedet for innholdet ditt, og derfor ser sjekken over etter 403-svar. Google beskriver hvordan crawlerne reagerer. Alle 4xx-statuskoder unntatt 429 behandles likt, de påvirker ikke gjennomsøkingstakten, og i Google-søk fjerner indekseringen en URL fra indeksen hvis den var indeksert fra før (Google Search Central, HTTP-statuskoder og nettverksfeil).
En blokkering setter altså ikke bare ny gjennomsøking på pause. Sider som allerede rangerer, kan falle ut av indeksen så lenge blokkeringen varer. Den samme siden advarer mot å bruke 401 og 403 for å begrense gjennomsøkingstakten. Er målet egentlig å avlaste en WordPress-server, er det 429 og 5xx Google leser som signal om å senke farten: Da gjennomsøker Googles crawlere midlertidig saktere i stedet for å fjerne URL-er.
Hvordan sjekke om en forespørsel i loggen virkelig kommer fra Googlebot
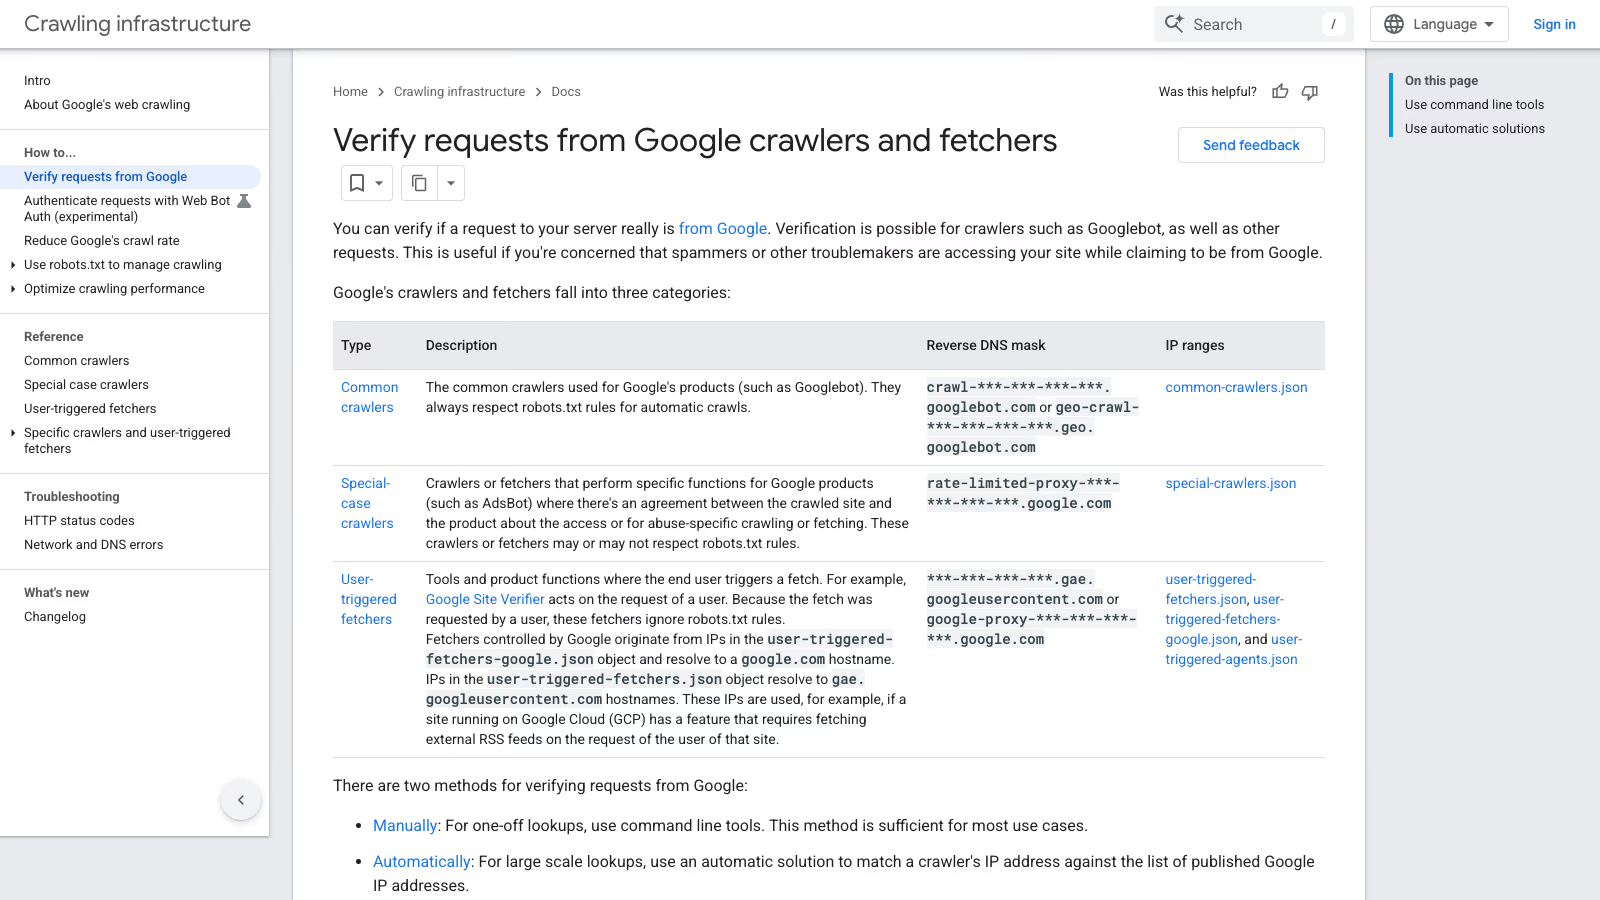
Hvem som helst kan sende en forespørsel med “Googlebot” i user agent, så en logglinje alene beviser ingenting. Googles metode er en DNS-sjekk begge veier: Kjør et omvendt DNS-oppslag på IP-adressen fra loggen med kommandoen host, bekreft at vertsnavnet slutter på googlebot.com, google.com eller googleusercontent.com, og kjør så et vanlig oppslag på vertsnavnet og sjekk at det gir samme IP. Google publiserer også IP-områdene til crawlerne sine som JSON-filer, delt i vanlige crawlere, spesialcrawlere, brukerutløste hentere og brukerutløste agenter (Google Search Central, verifisere Googlebot).
Vertsnavnet forteller også hva slags crawler du ser på. Googlebot og andre vanlige crawlere har navn som crawl-***-***-***-***.googlebot.com (eller en variant under geo.googlebot.com) og respekterer alltid robots.txt ved automatisk gjennomsøking. Brukerutløste hentere har navn under gae.googleusercontent.com eller google-proxy-***.google.com og ignorerer robots.txt, fordi et menneske ba om hentingen.
Cloudflare gjør en lignende sjekk på sin side. Verifiserte boter er boter som Cloudflare har bekreftet gjennom en kryptografisk Web Bot Auth-signatur, en publisert IP-liste med fast user agent eller omvendt DNS, og ifølge dokumentasjonen har de hittil vært unntatt fra standard botkonfigurasjoner på alle planer (Cloudflare Docs, Verified bots). I en WAF-regel viser feltet cf.client.bot om forespørselen kom fra en kjent, god bot eller crawler (Cloudflare Docs, cf.client.bot). En felle på gratisplanen: Bot Fight Mode kjører i en egen prosess, og Cloudflare skriver at den ikke kan omgås eller hoppes over med WAF-regler eller Page Rules (Cloudflare Docs, Bot Fight Mode). En skip-regel skrevet “for å beskytte Googlebot” endrer ikke det Bot Fight Mode gjør.
Hvilken innstilling bør en bedriftsside på WordPress ha
For et nettsted som lever av søk fra Google, ser et fornuftig oppsett slik ut:
| Kategori | Innstilling | Hvorfor |
|---|---|---|
| Search | Allow | Dette er trafikken fra søkemotoren du vil ha |
| Training | Allow eller Disallow AI Training | Disallow AI Training uttrykker et nei via robots.txt uten å blokkere Googlebot |
| Agent | Allow | AI-agenter besøker siden på vegne av et bestemt menneske, ofte en mulig kunde |
Spar Block til situasjoner der du virkelig vil forsvinne fra søkemotorene, for eksempel et testmiljø eller et administrasjonspanel som ikke skal indekseres. Til det fungerer noindex og passordbeskyttelse uansett bedre.
Vil du heller at innholdet ikke havner i AI-svar, er det en egen beslutning. Den har egne verktøy hos Google, og jeg tar dem for meg innenfor GEO- og LLMO-optimalisering. En blokkering i kanten hos Cloudflare er ikke laget for det, for den kutter søkemotoren sammen med AI.
Før du blokkerer en crawler, bør du telle hvor mange forespørsler den gjør per besøkende den sender deg. Nick Gray beskrev 7. august 2026 nettstedet sitt PatronView med 1,5 millioner sider: én dag kom det 3,6 millioner forespørsler fra kinesiske boter, Google crawlet 46 ganger per besøkende det sendte, og Bingbot gjorde 158 610 forespørsler for 680 besøkende. Skip-regelen for verifiserte boter, (cf.client.bot), ligger hos ham etter blokkeringsreglene og før utfordringsreglene, slik at en blokkert bot forblir blokkert, mens Googlebot aldri får en utfordring. Bare 0,24 % av utfordringene hans blir løst, noe han tolker som at de nesten bare treffer boter.
Den juridiske siden er fortsatt åpen. I juni 2025 publiserte Brian Williamson i Communications Chambers rapporten AI, Copyright and the Public Good, som ifølge sin egen ansvarsfraskrivelse er uavhengig og finansiert av Google. Rapporten foreslår at AI-trening på opphavsrettsbeskyttede verk skal regnes som fair use, mener at reservasjonsordninger (opt-out) og åpenhetskrav blir kostbare, og vil at opphavsretten skal handle om hvorvidt det modellene produserer krenker rettigheter. Det er et politisk forslag, ikke gjeldende rett. Inntil videre er det bot-innstillingene i nettverkskanten du faktisk kontrollerer, så sett dem opp slik at Googlebot ikke blir stengt ute sammen med AI-crawlerne.
Eksempel på AI-bot-innstillinger i Cloudflare på en ekte side
wppoland.com står på Cloudflare, så jeg testet dette på oss selv 8. oktober 2026. Cloudflares API returnerer for vår sone ai_training, ai_search og ai_user med verdien disabled, og den gamle bryteren ai_bots_protection står også på disabled. Ingen blokkering av AI-roboter er slått på.
Search Console bekrefter det fra den andre siden: URL-inspeksjon for /pl/ viser siste gjennomsøking 8. oktober 2026 kl. 12:12, vellykket henting av siden og en robots.txt som tillater tilgang. Det er én sone med én innstilling, og hele problemet er nettopp at innstillingene varierer fra sone til sone.
Sjekkliste for AI-bot-innstillinger i Cloudflare
- Kjør en live-test i Search Console for forsiden og ett innlegg med annonse.
- Gå gjennom gjennomsøkingsstatistikken og se etter 403-svar fra 15. september 2026.
- Åpne Security Settings for sonen i Cloudflare og sjekk Search, Training og Agent.
- Ikke bruk Block hvis du vil bli værende i Google. For å si nei til trening finnes Disallow AI Training.
- Sjekk den ferdige filen
/robots.txt, for både Cloudflare og SEO-utvidelsen skriver til den. - Ble domenet ditt lagt til i Cloudflare etter 15. september, sjekker du hvilket standardoppsett som ble valgt ved oppsett.