En forespørsel med Googlebot i brukeragenten beviser bare at noen har skrevet ordet Googlebot i en header. Det som avgjør, er IP-adressen. Den må stå i listen Google publiserer, eller tåle et omvendt DNS-oppslag fulgt av et vanlig oppslag. Denne guiden går fra en grep på én linje i tilgangsloggen din til en brannmurregel som stenger ute falske roboter uten å røre den ekte.
Anledningen er en artikkel fra Search Engine Roundtable 30. oktober 2026 om et intervju med Gary Illyes fra Google i Odys Podcast, der han knytter økningen i falske roboter til AI. Står WordPress-nettstedet ditt bak Cloudflare, bør du også lese innlegget mitt om hvorvidt Cloudflare blokkerer Googlebot. Der går jeg gjennom AI-bot-innstillingene, Bot Fight Mode og hva en 403 gjør med indekserte sider. Her handler det om steget før alt det: å vite hvem som faktisk banker på.
Alle kommandoer og oppsett nedenfor kjørte jeg 30. oktober 2026 mot Googles gjeldende filer, med nginx 1.27.2 og Apache 2.4.63 på en testmaskin. Der jeg ikke kunne teste noe på en produksjonsserver, sier jeg det.
Hvorfor er det blitt så mange falske Googlebots?
Barry Schwartz i Search Engine Roundtable har oppsummert samtalen mellom Illyes og programlederen, Aneta Samkoff. På spørsmålet om hvorfor det har blitt et slikt problem at roboter utgir seg for å være andre, svarte Illyes:
“Jeg tror det er AI.”
Gary Illyes, sitert av Search Engine Roundtable, 30. oktober 2026, egen oversettelse; episoden på YouTube, Odys Podcast
Begrunnelsen hans, slik artikkelen gjengir den: Selskaper leter etter innhold å trene modeller på. Brannmurer og CDN-er har blitt flinkere til å kjenne igjen crawlere, men de er ikke perfekte. En liten AI-søkemotor eller en skraper som sier at den er Googlebot, slipper derfor ofte inn der den ellers ville blitt stoppet. Ifølge samme artikkel har Illyes satt opp honningkrukker, feller for crawlere, og sett forespørsler som utga seg for å være Googlebot fra IP-adresser som ikke har noe med Google å gjøre. Tittelen på episoden anslår innsatsen til omtrent 30 sekunder. Det stemmer med det alle som har drevet et nettsted vet: brukeragenten er en header klienten setter selv.
Jeg har ikke funnet en transkripsjon av episoden. Alt jeg tilskriver Illyes her, kommer derfor via Search Engine Roundtable.
Logikken til den som forfalsker, er enkel. Den som stenger ute skrapere, gjør nesten alltid et unntak for Googlebot, fordi ingen vil falle ut av Google. En regel av typen “slipp inn Googlebot” uten IP-sjekk er dermed en åpen dør med skilt på. Googles egen hjelpeside for Search Console sier det samme i en annen sammenheng: Gir du Googlebot tilgang uten innlogging, fjerner du i praksis sikkerheten på siden, fordi Googlebot kan forfalskes (Search Console-hjelp, rapporten om gjennomsøkingsstatistikk).
Jeg har webhotell. Hva kan jeg gjøre uten servertilgang?
Mange små WordPress-nettsteder i Norge ligger på webhotell. Der kan du ikke endre nginx-oppsettet, SSH er ikke alltid med, og tilgangsloggen laster du ned som en fil fra kontrollpanelet. Det holder for å finne ut hva som skjer. Alle analysekommandoene nedenfor kan du kjøre på din egen maskin, med den nedlastede loggen i stedet for /var/log/nginx/access.log. På macOS og Linux har du grep, awk og host fra før, på Windows bruker du Linux-undersystemet (WSL).
For selve blokkeringen har du tre realistiske nivåer på et webhotell:
.htaccess, hvis webhotellet kjører Apache eller en kompatibel server og tillater de nødvendige overstyringene. Den testede varianten står lenger ned.- Cloudflare eller et annet CDN foran nettstedet. Der er robotverifiseringen allerede gjort, og du skriver bare én regel.
- En sikkerhetsutvidelse, hvis den sjekker IP-en og ikke bare brukeragenten. Hvilken innstilling i Wordfence som utgjør forskjellen, viser jeg nedenfor.
Sjekk likevel først om du har et problem i det hele tatt. Et titalls falske besøk om dagen på et bedriftsnettsted trenger ingen blokkering. Flere tusen forespørsler mot den interne WordPress-søkefunksjonen fra en “Googlebot” i et datasenter som ikke tilhører Google, gjør det, fordi hvert søk som ikke ligger i hurtigbufferen belaster PHP og databasen.
Hvordan finner jeg forespørsler i tilgangsloggen som utgir seg for å være Googlebot?
Begynn med tall. På en nginx-server med det vanlige combined-formatet lister denne kommandoen IP-adressene som sendte en Googlebot-brukeragent, de mest aktive først:
grep -i 'googlebot' /var/log/nginx/access.log | awk '{print $1}' | sort | uniq -c | sort -rn | head -20På Apache ligger filen vanligvis i /var/log/apache2/access.log (Debian, Ubuntu) eller /var/log/httpd/access_log (RHEL-familien). På webhotell bytter du inn stien til filen du lastet ned. Formatet er nesten alltid det samme combined-formatet.
For å se hva hver av dem ba om, skriver du ut IP-en ved siden av forespørselslinjen:
awk -F'"' 'tolower($6) ~ /googlebot/ {split($1,a," "); print a[1], $2}' /var/log/nginx/access.log | head -50Eksemplet nedenfor er konstruert, med dokumentasjonsadresser fra RFC 5737 i stedet for ekte trafikk, men det viser mønsteret du leter etter:
66.249.66.1 GET / HTTP/1.1
203.0.113.7 GET /wp-login.php HTTP/1.1
203.0.113.7 GET /?s=test HTTP/1.1
Den ekte Googlebot har sjelden grunn til å besøke wp-login.php, xmlrpc.php eller en endeløs rekke interne søkeadresser. En “Googlebot” som gjør det, sjekker du først. URL-mønsteret sier bare hvor du skal begynne. Det er IP-en som avgjør.
Zach Chahalis sier det samme i Moz-guiden sin om logganalyse for AI-søk, publisert 29. oktober 2026: En brukeragent er et navn den som spør gir seg selv, skrapere kan blåse opp tallene dine, og sikkerhetsregler som skal stoppe falske roboter kan ved et uhell stoppe ekte roboter også (Moz, How To Analyze Server Logs for AI Search). Han anbefaler å slå på robotverifisering allerede når loggene importeres, for eksempel valget Verify Bots When Importing Logs i Log File Analyser fra Screaming Frog. Da havner de falske aldri i diagrammene dine.
Hvordan sjekker jeg en Googlebot-IP med host eller dig?
Google beskriver en manuell sjekk i fire steg (Google, Verify requests from Google crawlers and fetchers):
- Gjør et omvendt DNS-oppslag på IP-en fra loggen med
host. - Sjekk at vertsnavnet ender på
googlebot.com,google.comellergoogleusercontent.com. - Gjør et vanlig DNS-oppslag på det vertsnavnet.
- Sjekk at svaret er den opprinnelige IP-en.
Slik så det ut 30. oktober 2026 for en av Googles egne eksempeladresser:
$ host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.
$ host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Steget tilbake er ikke valgfritt. Den som kontrollerer en IP-blokk, kan sette det omvendte DNS-navnet til hva som helst, også crawl-1-2-3-4.googlebot.com. Å få Googles DNS-servere til å svare med sin adresse når noen spør etter det navnet, klarer han ikke. dig +short -x 66.249.66.1 og dig +short crawl-66-249-66-1.googlebot.com gir de samme svarene i kortere form.
Har du mer enn en håndfull adresser, er en løkke greiere. Dette skriptet godtar vertsnavn fra Google og Bing. Jeg kjørte det 30. oktober 2026 mot adresser fra Google, Bing og to adresser som ikke har noe med crawlere å gjøre:
#!/usr/bin/env bash
# Two-way DNS check for an IP that claims to be Googlebot or Bingbot.
# Usage: ./verify_dns.sh 66.249.66.1 [more IPs]
for ip in "$@"; do
  name=$(host "$ip" | awk '/domain name pointer/ {print $NF; exit}')
  name=${name%.}
  case "$name" in
    *.googlebot.com|*.google.com|*.googleusercontent.com|*.search.msn.com) ;;
    *) echo "$ip FAKE: PTR is '${name:-none}'"; continue ;;
  esac
  if host "$name" | grep -qwF -- "$ip"; then
    echo "$ip OK: $name"
  else
    echo "$ip FAKE: $name does not resolve back to $ip"
  fi
done
Resultatet den dagen: 66.249.66.1 OK: crawl-66-249-66-1.googlebot.com, 157.55.39.1 OK: msnbot-157-55-39-1.search.msn.com, 8.8.8.8 FAKE: PTR is 'dns.google'. Tre begrensninger gjelder. host kommer fra pakken dnsutils på Debian og Ubuntu og fra bind-utils i RHEL-familien. “FAKE” betyr bare “verken Google eller Bing”, så kjør skriptet på adresser som utga seg for å være en crawler, ikke på hele loggen. Og IPv6-adresser kan skrives på flere gyldige måter, så tekstsammenligningen kan gå glipp av et treff. For IPv6 bruker du listemetoden lenger ned.
Hvilket vertsnavn hører til hvilken type Google-crawler?
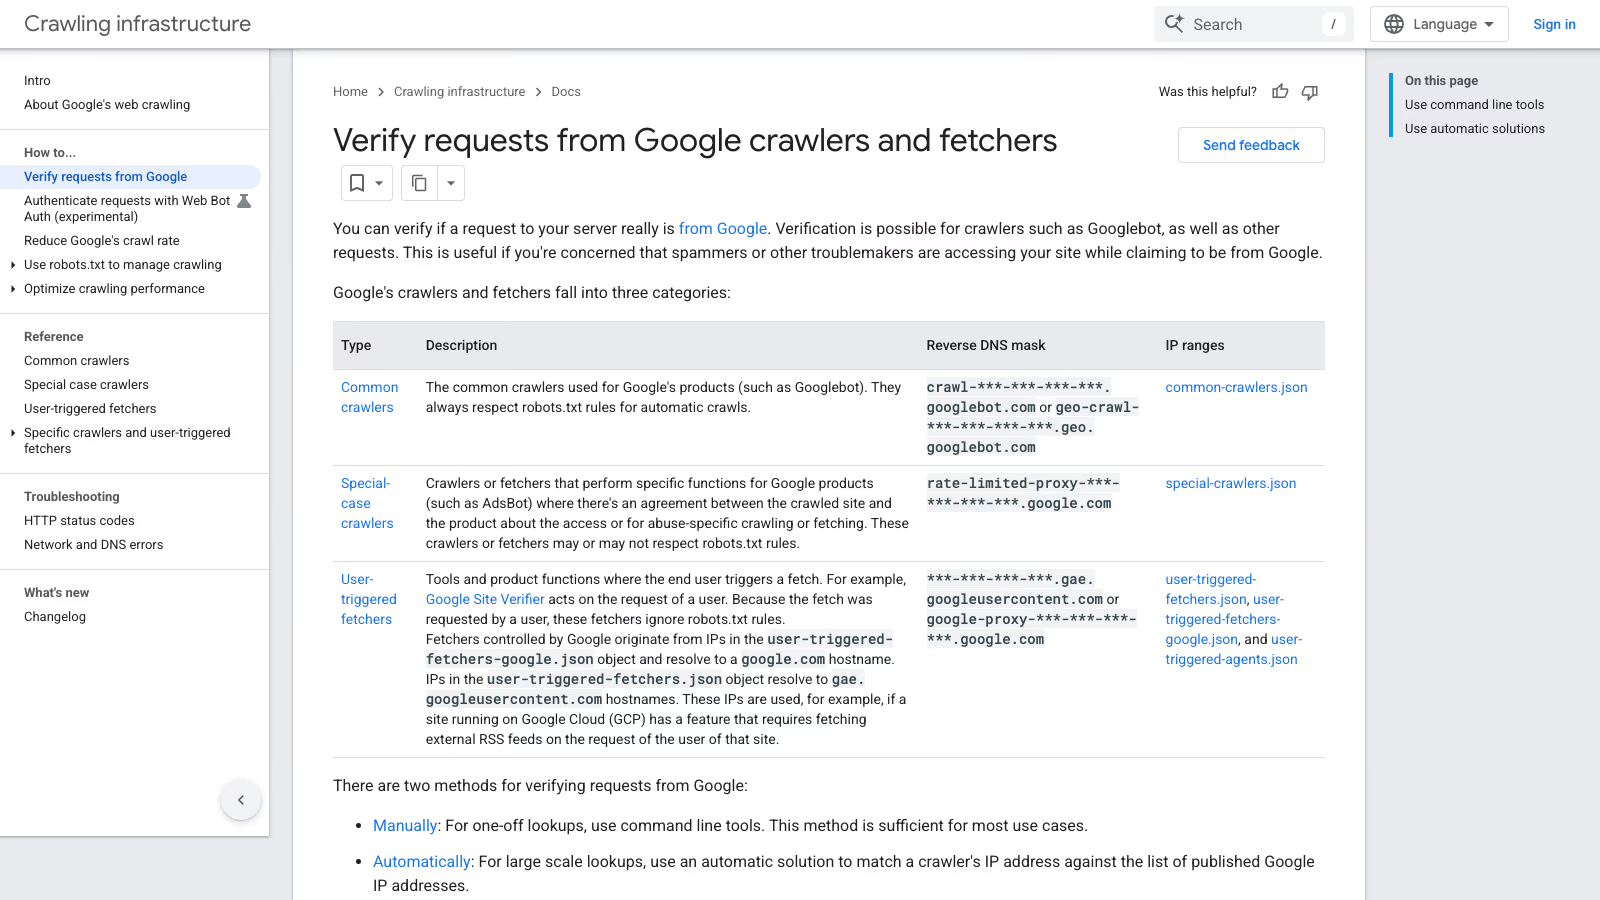
Google deler trafikken sin i tre grupper, hver med sitt eget mønster for vertsnavn og sin egen IP-fil (Google, Verify requests):
| Gruppe | Eksempler | robots.txt | Omvendt DNS | IP-fil |
|---|---|---|---|---|
| Vanlige crawlere | Googlebot, Googlebot-Image, Google-InspectionTool | Følges alltid ved automatisk gjennomsøking | crawl-***-***-***-***.googlebot.com eller geo-crawl-***-***-***-***.geo.googlebot.com | common-crawlers.json |
| Spesialcrawlere | AdsBot | Følges eller ikke, avhengig av crawleren | rate-limited-proxy-***-***-***-***.google.com | special-crawlers.json |
| Brukerutløste fetchere | Google Site Verifier, Feedfetcher, Google-Agent | Ignoreres, fordi et menneske ba om hentingen | ***-***-***-***.gae.googleusercontent.com eller google-proxy-***-***-***-***.google.com | user-triggered-fetchers.json, user-triggered-fetchers-google.json, user-triggered-agents.json |
Tabellen betyr noe av én praktisk grunn: En forespørsel med Googlebot-brukeragent skal komme fra første rad. Slår den opp til gae.googleusercontent.com, har den bestått steg 2 i den manuelle sjekken, og likevel er den ikke Googlebot. Google forklarer at IP-ene i user-triggered-fetchers.json slår opp til gae.googleusercontent.com og brukes for eksempel når et nettsted på Google Cloud henter en ekstern RSS-feed på vegne av en av sine brukere. En legitim henting, bare ikke søkeroboten.
Hvilken IP-liste fra Google skal jeg bruke, og hva skjedde med googlebot.json?
Google publiserer fem JSON-filer i CIDR-format under https://developers.google.com/static/crawling/ipranges/. 30. oktober 2026 inneholdt de dette antallet prefikser (tallene endrer seg, så se på dem som et øyeblikksbilde):
| Fil | Prefikser 30.10.2026 | Brukes til |
|---|---|---|
common-crawlers.json | 317 | Googlebot og de andre vanlige crawlerne |
special-crawlers.json | 272 | AdsBot og andre spesialcrawlere |
user-triggered-fetchers.json | 1068 | Hentinger på vegne av brukere av nettsteder på Google Cloud |
user-triggered-fetchers-google.json | 504 | Brukerutløste fetchere som Google selv driver |
user-triggered-agents.json | 20 | Google-Agent og lignende agenter |
Skrev du et skript for noen år siden, laster det sannsynligvis ned googlebot.json. 30. oktober 2026 svarte den gamle adressen https://developers.google.com/search/apis/ipranges/googlebot.json med en 301-videresending til common-crawlers.json, mens https://developers.google.com/static/crawling/ipranges/googlebot.json svarte 404. Et skript som følger videresendinger, virker fortsatt. Et som er låst til den nyere stien, eller som behandler alle svar unntatt 200 som en tom liste, gjør det ikke. Sjekk ditt. En tom tillatelsesliste gjør “blokker falsk Googlebot” om til “blokker Googlebot”.
For andre Google-tjenester som kan besøke nettstedet ditt, for eksempel Apps Script, viser Google til den generelle listen på https://www.gstatic.com/ipranges/goog.json.
Bing og OpenAI publiserer filer i samme form: et felt creationTime og en tabell prefixes med oppføringer ipv4Prefix eller ipv6Prefix. Ett skript kan derfor sjekke alle. Dette bruker bare Pythons standardbibliotek:
#!/usr/bin/env python3
"""Check IPs against the crawler IP lists Google, Bing and OpenAI publish.

Usage: python3 verify_bot_ip.py 66.249.66.1 157.55.39.1 1.2.3.4
       awk '{print $1}' access.log | sort -u | python3 verify_bot_ip.py -
"""
import ipaddress
import json
import sys
import urllib.request

LISTS = {
    "google-common": "https://developers.google.com/static/crawling/ipranges/common-crawlers.json",
    "google-special": "https://developers.google.com/static/crawling/ipranges/special-crawlers.json",
    "google-user-fetchers": "https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers.json",
    "google-user-fetchers-google": "https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers-google.json",
    "google-user-agents": "https://developers.google.com/static/crawling/ipranges/user-triggered-agents.json",
    "bingbot": "https://www.bing.com/toolbox/bingbot.json",
    "openai-gptbot": "https://openai.com/gptbot.json",
    "openai-searchbot": "https://openai.com/searchbot.json",
    "openai-chatgpt-user": "https://openai.com/chatgpt-user.json",
}


def load(url):
    with urllib.request.urlopen(url, timeout=20) as r:
        data = json.load(r)
    return [
        ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix"))
        for p in data["prefixes"]
    ]


def main(args):
    ips = [l.strip() for l in sys.stdin] if args == ["-"] else args
    nets = {name: load(url) for name, url in LISTS.items()}
    for raw in filter(None, ips):
        try:
            ip = ipaddress.ip_address(raw)
        except ValueError:
            print(f"{raw}\tnot an IP")
            continue
        hits = [n for n, ranges in nets.items() if any(ip in net for net in ranges)]
        print(f"{ip}\t{', '.join(hits) or 'NOT IN ANY LIST'}")


if __name__ == "__main__":
    main(sys.argv[1:])
Gi det hver IP som utga seg for å være Googlebot:
grep -i 'googlebot' /var/log/nginx/access.log | awk '{print $1}' | sort -u | python3 verify_bot_ip.py -- oktober 2026 svarte det
66.249.66.1 google-common,66.249.90.77 google-special,157.55.39.1 bingbotog8.8.8.8 NOT IN ANY LIST, og det håndterte IPv6 (2001:4860:4801:10::1 google-common). Skriptet laster ned ni filer hver gang det kjører, så kjør det for hånd eller fra cron. Aldri per forespørsel.
Hvorfor består en ekte Googlebot-IP noen ganger ikke navnesjekken?
Under testingen kjørte jeg også Googles andre eksempel, 35.247.243.240. Ifølge Google slår den opp til geo-crawl-35-247-243-240.geo.googlebot.com. 30. oktober 2026 svarte både systemoppslaget mitt og Googles offentlige 8.8.8.8 i stedet med 240.243.247.35.bc.googleusercontent.com. Naboadressen 35.247.243.241 ga det dokumenterte navnet geo-crawl-35-247-243-241.geo.googlebot.com, og 35.247.243.240 ligger innenfor 35.247.243.240/28 i common-crawlers.json.
Jeg vet ikke hvorfor akkurat den adressen har en annen PTR-post, og det er én enkelt observasjon. En regel som bare godtar *.googlebot.com, ville ha avvist en IP som Google selv oppgir som vanlig crawler. En regel som godtar alle googleusercontent.com-navn, ville sluppet inn brukerutløste fetchere som ikke er Googlebot. For en forespørsel med Googlebot-brukeragent er medlemskap i common-crawlers.json testen som avgjør. Bruk DNS-metoden til enkeltsjekker, som er slik Google selv beskriver den: tilstrekkelig i de fleste tilfeller ved enkeltoppslag, med IP-listene som anbefaling når du sjekker i stor skala.
Hvordan blokkerer jeg falske Googlebots i nginx?
Fremgangsmåten: Lag en include-fil fra common-crawlers.json, merk forespørsler der brukeragenten inneholder “googlebot”, og svar 403 bare når brukeragenten påstår Googlebot og IP-en ikke står på listen. Først generatoren:
#!/usr/bin/env python3
# Builds allow lists from Google's common-crawlers.json (Googlebot and friends).
# Usage: python3 make_googlebot_ranges.py nginx  > /etc/nginx/googlebot-ranges.conf
#        python3 make_googlebot_ranges.py apache > /etc/apache2/googlebot-ranges.conf
import json, sys, urllib.request

URL = "https://developers.google.com/static/crawling/ipranges/common-crawlers.json"
with urllib.request.urlopen(URL, timeout=20) as r:
    nets = [p.get("ipv4Prefix") or p.get("ipv6Prefix") for p in json.load(r)["prefixes"]]
if not nets:
    sys.exit("empty list from Google, refusing to write")

if sys.argv[1:] == ["nginx"]:
    print("\n".join(f"{n} 1;" for n in nets))
elif sys.argv[1:] == ["apache"]:
    for i in range(0, len(nets), 20):
        print("Require ip " + " ".join(nets[i:i + 20]))
else:
    sys.exit("usage: make_googlebot_ranges.py nginx|apache")
Testdagen ga den 317 linjer for nginx og 16 linjer for Apache. Med feil argument avslutter den med feilkode og skriver ingenting.
Så nginx-delen. Blokkene geo og map hører hjemme i http-konteksten, if i server-blokken for WordPress-nettstedet ditt:
# http { ... }
geo $googlebot_ip {
    default 0;
    include /etc/nginx/googlebot-ranges.conf;
}
map $http_user_agent $claims_googlebot {
    default 0;
    ~*googlebot 1;
}
map "$claims_googlebot:$googlebot_ip" $fake_googlebot {
    default 0;
    "1:0"   1;
}

# server { ... }
if ($fake_googlebot) {
    return 403;
}
Jeg testet nøyaktig denne blokken: En vanlig nettleser fikk 200, en forespørsel med Googlebot-brukeragent fra en IP utenfor Google fikk 403, en Bingbot-brukeragent fikk 200, og etter at jeg la adressen til testmaskinen inn i include-filen, fikk den samme Googlebot-forespørselen 200. Det siste steget bør du gjenta på din egen server med en ekte Googlebot-IP fra loggene dine før du stoler på regelen.
Oppdater listen fra cron, og skriv først til en midlertidig fil, slik at en mislykket nedlasting aldri etterlater nginx med en tom include-fil:
python3 make_googlebot_ranges.py nginx > /tmp/googlebot-ranges.conf \
  && mv /tmp/googlebot-ranges.conf /etc/nginx/googlebot-ranges.conf \
  && nginx -t && systemctl reload nginx
Generatoren og nginx -t har jeg kjørt, men linjen med mv og reload som helhet har jeg ikke kjørt på en produksjonsserver. Sjekk første gang at brukeren cron kjører som, har rettigheter til begge stegene.
Fellen som snur regelen mot deg, er en omvendt proxy foran nginx. Bak Cloudflare, en lastbalanserer eller en proxy hos vertsleverandøren er $remote_addr adressen til proxyen, aldri Googles, og hver ekte Googlebot får 403. Sett opp realip-modulen først (set_real_ip_from for hvert proxyområde og real_ip_header CF-Connecting-IP; for Cloudflare), og kontroller i tilgangsloggen at du ser besøkendes IP-er og ikke proxyens, før du slår på blokkeringen.
Hvordan blokkerer jeg falske Googlebots i Apache eller .htaccess?
Apache 2.4 gjør det samme med mod_setenvif og mod_authz_host. I den virtuelle verten eller en <Directory>-blokk:
SetEnvIfNoCase User-Agent "googlebot" claims_googlebot
<RequireAny>
    <RequireAll>
        Require all granted
        Require not env claims_googlebot
    </RequireAll>
    Include /etc/apache2/googlebot-ranges.conf
</RequireAny>
Logikken er: Slipp inn alle som ikke påstår at de er Googlebot, pluss alle fra en IP på listen. Testen min ga samme resultat som med nginx: 200 for nettleseren, 403 for den falske Googlebot, 200 for en Googlebot-brukeragent fra en adresse jeg hadde lagt inn i include-filen.
På webhotell havner regelen i .htaccess, og der er Include ikke tillatt (resultatet blir en 500-feil). Lim i stedet inn Require ip-linjene som generatoren fra nginx-delen skriver ut, rett i blokken. 30. oktober 2026 var det 16 linjer med 20 områder hver:
SetEnvIfNoCase User-Agent "googlebot" claims_googlebot
<RequireAny>
    <RequireAll>
        Require all granted
        Require not env claims_googlebot
    </RequireAll>
    # Lim inn "Require ip ..."-linjene som
    # python3 make_googlebot_ranges.py apache skriver ut.
    # Uten dem får hver ekte Googlebot 403.
</RequireAny>
Denne .htaccess-varianten testet jeg også, med de samme tre resultatene. Den krever at webhotellet tillater både AuthConfig- og FileInfo-overstyringer. Med bare AuthConfig svarte testserveren min på hver forespørsel med en 500-feil og skrev SetEnvIfNoCase not allowed here i feilloggen. Åpne derfor forsiden i nettleseren rett etter at du har lastet opp filen. Mange webhotell kjører LiteSpeed i stedet for Apache. LiteSpeed leser de fleste .htaccess-direktiver, men denne blokken har jeg ikke testet der. Sjekk resultatet fra din egen maskin med en falsk brukeragent:
curl -s -o /dev/null -w "%{http_code}\n" -A "Googlebot/2.1 (+http://www.google.com/bot.html)" https://ditt-domene.no/Du skal få 403, og uten valget -A en vanlig 200. Får du 403 i begge tilfellene, blokkerer regelen alle, og den må fjernes med en gang.
Samme proxyfelle gjelder for Apache. Bak Cloudflare må mod_remoteip med RemoteIPHeader CF-Connecting-IP og Cloudflare-områdene som klarerte proxyer være på plass, ellers blokkerer regelen den ekte roboten. På et webhotell har du sjelden kontroll over det. Står nettstedet bak Cloudflare og du ikke kan sette opp mod_remoteip selv, hører regelen hjemme i Cloudflare, som er neste avsnitt.
Hvordan blokkerer jeg falske Googlebots i Cloudflare?
Står nettstedet bak Cloudflare, er nettverkskanten det beste stedet, fordi Cloudflare allerede verifiserer roboter for deg. Feltet cf.client.bot viser ifølge dokumentasjonen om forespørselen kom fra en kjent god robot eller crawler (Cloudflare Docs, cf.client.bot). Cloudflare regner en robot som verifisert når den identifiserer seg med en Web Bot Auth-signatur, en publisert IP-liste med stabil brukeragent eller omvendt DNS, og i tillegg oppfører seg ordentlig, det vil si følger robots.txt og holder et rimelig tempo (Cloudflare Docs, Verified bots).
En egendefinert regel mot falske Googlebots:
(lower(http.user_agent) contains "googlebot" and not cf.client.bot)lower() står der fordi strengsammenligning i Cloudflares regelspråk skiller mellom store og små bokstaver (Cloudflare Docs, Functions). Cloudflares eget eksempel på mønsteret kombinerer et landfilter med not cf.client.bot og en Managed Challenge (Cloudflare Docs, Allow traffic from search engine bots).
Dette uttrykket har jeg ikke tatt i bruk på en produksjonssone, så se på det som et utgangspunkt. Før du velger Block, kjør uttrykket som et filter i Security Analytics eller start med Managed Challenge, og bekreft at ingenting fra en IP i common-crawlers.json treffer. Hvis Cloudflare en gang ikke kjenner igjen en ekte Googlebot og regelen din sier Block, får Google en 403. Google skriver at URL-er som svarer med andre 4xx-koder enn 429, fjernes fra indeksen hvis de var indeksert (Google, HTTP status codes).
Cloudflare har også feltet cf.verified_bot_category, en streng med formålet til en verifisert robot. Eldre verdier som Search Engine Crawler og AI Crawler virker fortsatt i egendefinerte regler. Feltreferansen sier ikke hvilke planer som har feltet, så sjekk om regelbyggeren din tilbyr det før du bygger på det. Egendefinerte regler kjører før Super Bot Fight Mode (Cloudflare Docs, Challenge bad bots). Hvordan den gratis Bot Fight Mode og AI-bot-kategoriene påvirker Googlebot, står i innlegget om Cloudflare.
Blokkerer sikkerhetsutvidelser for WordPress falske Googlebots riktig?
Noen gjør det, hvis riktig innstilling er valgt. Wordfence er et tydelig eksempel, fordi dokumentasjonen viser begge sider. Blant valgene for hastighetsbegrensning bruker Verified Google crawlers have unlimited access to this site et omvendt DNS-oppslag, og en besøkende med falsk Googlebot-header stryker ifølge Wordfence på PTR-testen. Alternativet Anyone claiming to be Google has unlimited access gjør det navnet sier: Også en falsk Googlebot får ubegrenset tilgang (Wordfence Help, Rate limiting). Bruker du hastighetsbegrensningen i Wordfence, sjekk hvilket av de to som er valgt.
For enhver utvidelse eller egen regel skiller tre spørsmål det brukbare fra det risikable:
- Sjekker den IP-en, eller bare brukeragenten? En regel som blokkerer eller slipper inn basert på brukeragent alene, er akkurat det forfalskerne regner med.
- Bruker den en oppdatert liste eller et DNS-oppslag i sanntid? En fast IP-liste kopiert fra et forum i 2019 mangler Googles nyere områder og blokkerer den ekte crawleren.
- Kjører den før eller etter sidebufferen? En PHP-utvidelse ser bare forespørsler som når PHP. Leverer webhotellet eller en bufferutvidelse ferdig HTML direkte, møter en falsk Googlebot som leser bufrede sider aldri utvidelsen. For beskyttelse mot skraping betyr det mye, for innloggingsforsøk mot
wp-login.phpmindre, fordi den adressen ikke bufres.
Regler som “blokkerer roboter” ved å matche en liste brukeragenter i .htaccess, har det motsatte problemet: De stopper ærlige crawlere som presenterer seg, og slipper alle løgnere gjennom. Finner jeg en slik liste på et nettsted jeg tar meg av gjennom vedlikehold av WordPress, bytter jeg den ut med en IP-basert regel eller flytter avgjørelsen ut til nettverkskanten. Må blokkeringslogikken ligge i selve applikasjonen, for eksempel i en egen utvidelse hos en leverandør uten servertilgang, er det et oppdrag for WordPress-utvikling, og samme IP-liste er kilden.
Hvordan sjekker jeg Bingbot og crawlerne til OpenAI?
Bingbot. Microsofts metode er den samme DNS-sjekken begge veier: Det omvendte oppslaget må ende på search.msn.com, og det vanlige oppslaget på det navnet må gi samme IP (Bing Webmaster Blog, How to Verify that Bingbot is Bingbot). 30. oktober 2026:
$ host 157.55.39.1
1.39.55.157.in-addr.arpa domain name pointer msnbot-157-55-39-1.search.msn.com.
$ host msnbot-157-55-39-1.search.msn.com
msnbot-157-55-39-1.search.msn.com has address 157.55.39.1
Bing har også et offentlig verktøy for å verifisere Bingbot på bing.com/toolbox/verify-bingbot, og det samme verktøyet i Bing Webmaster Tools. IP-listen bing.com/toolbox/bingbot.json hadde en creationTime fra 3. januar 2024 da jeg hentet den. En liste som ikke er generert på nytt på nesten tre år, kan godt være riktig, men jeg ville ikke bygget en hard blokkering på den. Derfor dekker nginx- og Apache-reglene ovenfor bare Googlebot. For Bing sjekker du adressene fra din egen logg med DNS-skriptet først, og bestemmer deg etterpå.
OpenAI. OpenAI dokumenterer fire crawlere, hver med sin egen IP-fil (OpenAI, Overview of OpenAI crawlers):
| Brukeragent | Formål | IP-liste |
|---|---|---|
OAI-SearchBot | Viser nettsteder i søkesvarene i ChatGPT | openai.com/searchbot.json |
GPTBot | Henter innhold som kan brukes til å trene modeller | openai.com/gptbot.json |
ChatGPT-User | Henter en side når en bruker ber om det; OpenAI skriver at reglene i robots.txt kanskje ikke gjelder | openai.com/chatgpt-user.json |
OAI-AdsBot | Sjekker landingssider som er sendt inn som annonser i ChatGPT | openai.com/adsbot.json |
Python-skriptet ovenfor sjekker allerede de tre første listene. Samme nginx-mønster fungerer for dem om du vil: en egen geo-include laget fra riktig fil og et søk i brukeragenten etter riktig navn.
Hva skal jeg aldri blokkere når jeg rydder i robottrafikken?
En for ivrig opprydding kan koste mer enn de falske robotene gjorde, fordi de ekte mister tilgangen. Hold disse utenfor alle blokkeringsregler:
- Google-Extended. Et token i robots.txt, ikke en crawler. Google skriver at det ikke har en egen brukeragent. Gjennomsøkingen skjer med de vanlige brukeragentene til Google, og tokenet styrer bare om innholdet kan brukes til trening og grounding av Gemini. Det påvirker ikke om nettstedet tas med i Google-søk, og det er ikke et rangeringssignal (Google, common crawlers). En serverregel som ser etter Google-Extended i brukeragenten, kan bare treffe falske roboter. Vil du ut av Gemini-treningen, er verktøyet en Disallow-linje i robots.txt, som jeg sammenlignet med Googles andre brytere i Googles tre AI-brytere.
- Brukerutløste fetchere. Google Site Verifier henter verifiseringstokenet ditt for Search Console, Feedfetcher leser RSS-feeden din, Google Read Aloud leser sider høyt for brukere, GoogleMessages lager forhåndsvisninger av lenker. De ignorerer robots.txt med vilje, fordi et menneske ba om hentingen (Google, user-triggered fetchers). Blokkerer du dem, ødelegger du verifiseringen og forhåndsvisningene, ikke gjennomsøkingen.
- Google-InspectionTool. URL-inspeksjon i Search Console og testen for rike resultater bruker den. IP-ene står i listen over vanlige crawlere, men brukeragenten inneholder ikke “Googlebot”, så reglene ovenfor lar den være i fred.
- Google-Agent. Googles agenter som handler på vegne av en bruker, bruker den, med IP-er fra
user-triggered-agents.json. Google eksperimenterer med Web Bot Auth for en del av disse forespørslene under identitetenhttps://agent.bot.goog. Dokumentasjonen sier at ikke alle forespørsler signeres, og at verifiseringen da skal falle tilbake på IP-adresser, omvendt DNS og brukeragent (Google, Web Bot Auth). Signerte forespørsler har headerenSignature-Agent: g="https://agent.bot.goog"og verifiseres mot nøklene påagent.bot.goog/.well-known/http-message-signatures-directoryetter RFC 9421. For et WordPress-nettsted er det praktiske svaret å la CDN-et ditt gjøre den verifiseringen hvis det støtter den, og ikke blokkere det det ennå ikke kan verifisere.
Selve Googlebot beskriver ikke Google som en crawler som signerer forespørsler. For den gjelder fortsatt IP-liste og DNS.
robots.txt hører ikke hjemme i denne verktøykassen mot falske roboter i det hele tatt. Illyes kalte den, ifølge oppsummeringen i Search Engine Roundtable, et forslag og ikke en begrensning som kan håndheves. Ærlige crawlere leser den. En falsk Googlebot ignorerer den, eller leser Googlebot-delen og tar den som en tillatelse.
Endrer blokkering av falske Googlebots gjennomsøkingsstatistikken i Search Console?
Det skal den ikke, og nettopp derfor er rapporten en nyttig kontroll. Rapporten om gjennomsøkingsstatistikk viser ifølge Google historikken over Googles gjennomsøking av nettstedet ditt (Search Console-hjelp, rapporten om gjennomsøkingsstatistikk). Forespørsler fra falske roboter dukker aldri opp der, fordi Google aldri sendte dem. Google legger til at rapporten i dag tar med de fleste forespørslene, men ikke nødvendigvis alle, så små avvik mot loggene dine er normalt.
Det gir deg en grov sjekk. Viser loggen din langt flere “Googlebot”-forespørsler enn gjennomsøkingsstatistikken for de samme dagene, er overskuddet en kandidat for forfalskning, og IP-skriptet gir deg svaret. Det er min slutning, ikke noe Google sier. Det motsatte tilfellet har en offisiell forklaring: Viser statistikken mye mer enn loggene, kan det ifølge Google skje når robots.txt har vært utilgjengelig for lenge og Google har telt med gjennomsøkinger den ville ha gjort.
Etter at du har slått på en blokkering, følger du med på to ting i gjennomsøkingsstatistikken i en uke eller to. Totalt antall forespørsler skal holde seg der det var, og fordelingen etter svarkode skal ikke vise nye 403-svar. Øker 403-svarene rett etter en regelendring, treffer regelen den ekte Googlebot. Google skriver tydelig at 401 og 403 ikke skal brukes til å begrense gjennomsøkingstakten (Google, HTTP status codes). Er det ekte gjennomsøking som er belastningsproblemet, får 429 eller 503 Google til å senke farten midlertidig uten at URL-er forsvinner med en gang.
Feilsøking: hva betyr hvert resultat?
| Det du ser | Hva det betyr | Hva du gjør |
|---|---|---|
| Googlebot-brukeragent, IP i ingen liste, PTR mangler eller er fremmed | Forfalskning | Blokker i kanten eller på serveren, ingen SEO-risiko |
PTR ender på googlebot.com, vanlig oppslag gir en annen IP | Noen har satt en falsk PTR-post | Behandle som falsk, det er dette steget tilbake er til for |
Googlebot-brukeragent, PTR under gae.googleusercontent.com | En brukerutløst henting, ikke søkeroboten | Sjekk user-triggered-fetchers.json, ikke tell den som Googlebot |
IP i common-crawlers.json, PTR utenfor det dokumenterte mønsteret | Ekte Google-crawler med uvanlig PTR (jeg så én 30.10.2026) | Stol på listen |
| Loggen viser mange flere Googlebot-treff enn gjennomsøkingsstatistikken | Sannsynligvis falske roboter i loggen | Kjør IP-skriptet på de adressene |
| Gjennomsøkingsstatistikken viser mange flere forespørsler enn loggen | Ifølge Google var robots.txt utilgjengelig for lenge | Sjekk hentestatusen for robots.txt i Search Console |
| 403-svar i gjennomsøkingsstatistikken øker etter en ny regel | Regelen treffer den ekte Googlebot | Sjekk håndteringen av proxy-IP, hvor fersk listen er og rekkefølgen på reglene |
| Din egen SEO-crawler med Googlebot-brukeragent får 403 | Regelen virker: IP-en din tilhører ikke Google | Bruk en annen brukeragent til revisjoner, eller tillat din egen IP eksplisitt |
| Regelen blokkerer ikke engang en åpenbar forfalskning | Serveren ser proxyens IP i stedet for den besøkendes, eller sidebufferen svarte først | Rett opp realip eller remoteip, eller flytt regelen til CDN-et |
Sjekkliste for et WordPress-nettsted
- Tell IP-ene som utga seg for å være Googlebot i tilgangsloggen den siste uken.
- Kjør IP-skriptet på dem og noter hvor mange som er
NOT IN ANY LIST. - Sammenlign totalen i loggen med gjennomsøkingsstatistikken for de samme dagene.
- Blokkerer du, så blokker på IP pluss brukeragent, aldri brukeragent alene.
- Bak en proxy eller et CDN: bekreft at serveren logger besøkendes IP-er før du slår på en IP-regel.
- Lag tillatelseslister fra
common-crawlers.jsonog oppdater dem fra cron med en sperre mot tomme nedlastinger. - Hold Google-Extended, brukerutløste fetchere, Google-InspectionTool og Google-Agent utenfor alle blokkeringsregler.
- Følg med på 403-svar i gjennomsøkingsstatistikken i to uker etter hver endring.
Viser loggene dine mye falsk trafikk mot wp-login.php og xmlrpc.php, er den falske Googlebot som regel det minste problemet på serveren. En sikkerhetsrevisjon av WordPress starter i de samme tilgangsloggene og ser på hva de forespørslene egentlig prøvde å oppnå.