Thorsten Balls spådommer og dataene vi tester dem mot
- september 2026 publiserte Thorsten Ball et kort innlegg på X: de fleste spådommene han ser, er etter hans syn fortsatt altfor forsiktige, så han kommer med sine egne. Innlegget hadde vedlagt et notat med tittelen “What I believe about the future of software development” og 16 påstander. Ball er medgründer av og med på å bygge Amp, har tidligere jobbet i Sourcegraph og Zed, og har gitt ut to bøker om programmering på eget forlag. Dette er ikke en stemme fra utsiden av bransjen.
Påstandene er skarpe: kodegjennomgang vil dø, enhetstester kan dø, terminalen er død, og åpen kildekode i sin nåværende form gir ikke mening. Vi svarer på hver av dem for seg, med en vurdering: enig, delvis enig eller uenig.
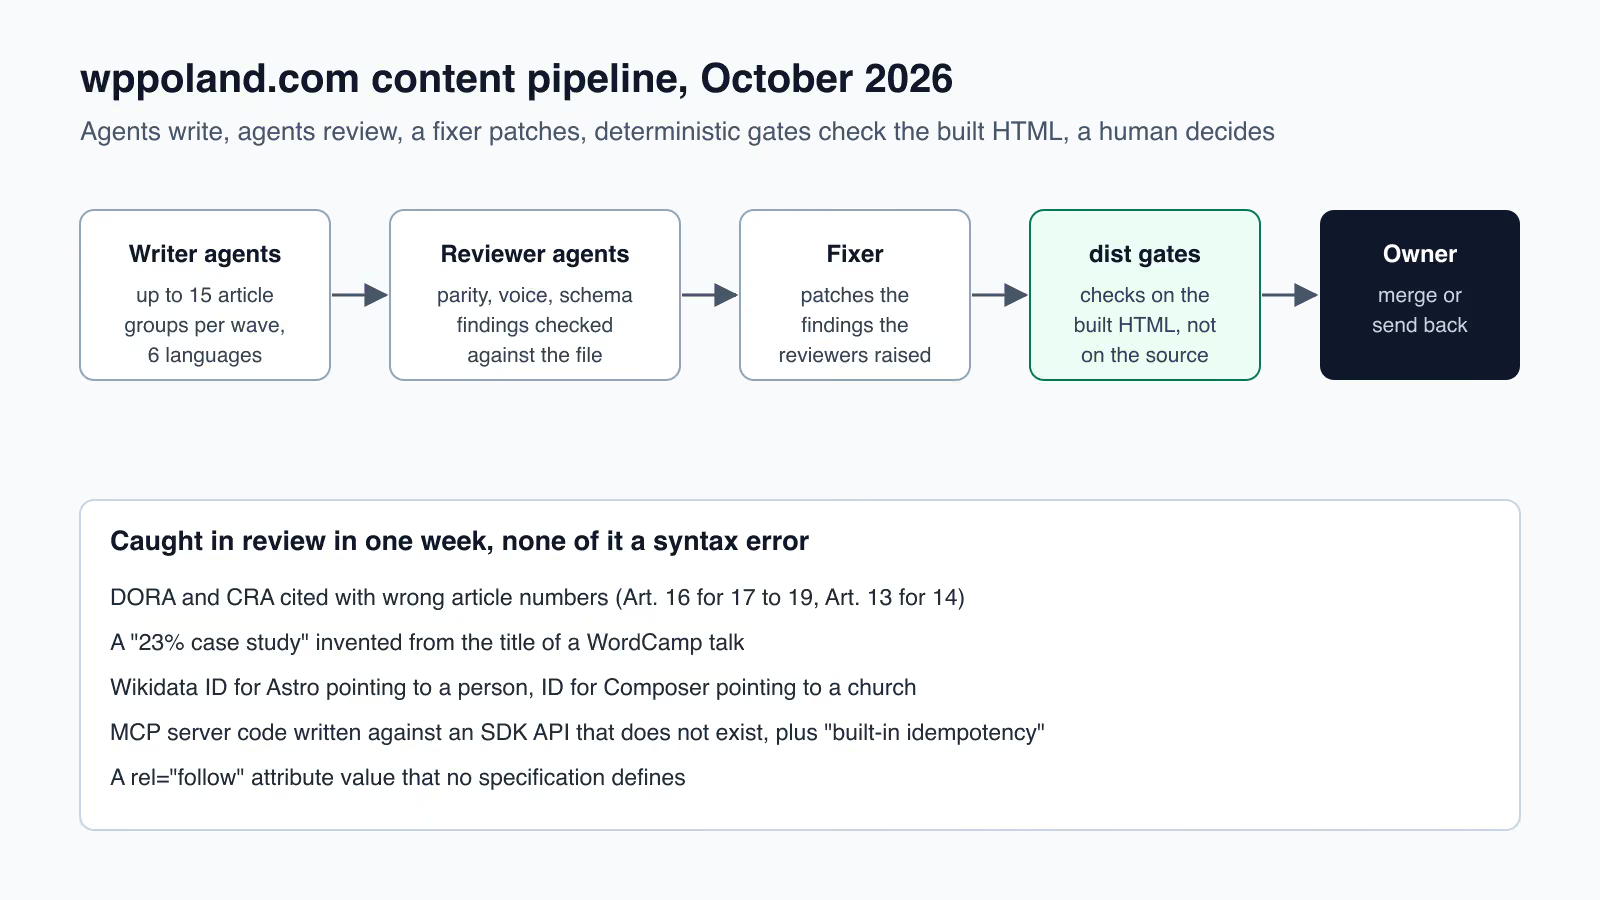
Bevisene våre kommer fra ett sted vi kjenner på nært hold: KI-agentpipelinen som i oktober 2026 bygger ut innholdet på dette nettstedet. Skriveagentene jobber parallelt og håndterer opptil 15 artikkelgrupper på seks språk i én bølge. Ifølge historikken i repositoriet omfattet bølge 20 den 15. oktober 14 grupper og 85 filer. Uavhengige gjennomgangsagenter sjekker samsvaret mellom språkversjonene, stilen og de strukturerte dataene, og en egen agent retter det de har rapportert. Til slutt avgjør kontroller som kjøres på den bygde HTML-en om endringen i det hele tatt får gå videre. Flyten er vist i illustrasjonen øverst på siden.
Pipelinen jobber på et levende nettsted med tusenvis av sider, så en agentfeil som ingen fanger opp, går rett til søkemotoren. Derfor er vårt syn på fremtiden for programvareutvikling smalere enn Balls, men det bygger på det vi selv har sett den siste uken.
Fremtiden for programvareutvikling ifølge Thorsten Ball
Her er alle påstandene fra notatet i forfatterens rekkefølge, med vår vurdering. Hver av dem utdyper vi lenger ned i teksten.
| Thorsten Balls påstand | Vår vurdering |
|---|---|
| Kodegjennomgang vil dø | Uenig, gjennomgangen skifter gjenstand |
| Enhetstester kan dø | Uenig |
| Håndverket å skrive kode vil forsvinne | Delvis enig |
| Håndverket å bygge programvare blir viktigere enn noensinne | Enig |
| De fleste feil blir «du ba om feil ting»-feil | Enig |
| Åpen kildekode i nåværende form gir ikke mening | Uenig |
| Menneskelige bidrag til ytelse forblir et kanttilfelle | Delvis enig |
| Terminalen er død | Uenig |
| Tokens er det nye paradigmet for databehandling | Delvis enig |
| Triaden PM, design og utvikling vil forsvinne | Delvis enig |
| Avstanden mellom store og små selskaper vil øke | Delvis enig |
| Det finnes ikke noe bevis for at «god kode» vil ha betydning | Delvis enig |
| Noen vil bli priset ut av å lage programvare | Delvis enig |
| Det er tvilsomt om billigere modeller blir brukt | Enig |
| Brukergrensesnitt vil genereres i sanntid | Ingen data på vår side |
| Det vil ta en generasjon | Enig |
Regnskapet: på fire punkter gir vi Ball rett, på fire er vi uenige, på sju ser vi retningen, men ikke omfanget, og på ett har vi ingen data.
Er kodegjennomgang død med KI
«Kodegjennomgang vil dø. Jeg mener: den er allerede død. Men i fremtiden vil mennesker ikke finne en feil eller et problem i kode produsert av en modell, i hvert fall ikke innen rimelig tid. Mennesker vil bare gå gjennom systemet og sammensetningen av det, men det vil ikke skje i PR-er, og det vil ikke skje ved å se gjennom hver eneste kodelinje.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: uenig, selv om andre halvdel av påstanden treffer.
Ball har rett i én ting: et menneske som leser linje for linje gjennom hundrevis av filer per bølge, har ingen sjanse. Konklusjonen er likevel feil. Gjennomgangen dør ikke, den skifter gjenstand. I pipelinen vår leter ingen lenger etter et manglende semikolon. Den som går gjennom, leter etter en falsk påstand som er syntaktisk korrekt.
Dette fanget gjennomgangsagentene opp i løpet av én uke i oktober 2026:
- Agentene oppga feil artikkelnumre i tekster om regelverk: artikkel 16 i DORA der artiklene 17 til 19 var de riktige, og artikkel 13 i CRA der artikkel 14 var den riktige.
- En agent laget en «casestudie med et resultat på 23 prosent» ut av tittelen på et foredrag på en WordCamp. Noen slik studie fantes ikke.
- Wikidata-identifikatoren som var oppgitt for Astro, pekte på en person, og den for Composer pekte på en kirke.
- En agent skrev kode for en MCP-server mot et SDK-API som ikke finnes, og tilskrev MCP-protokollen «innebygd idempotens», som den ikke har.
- I en tekst om lenker dukket attributtet
rel="follow"opp, som ingen spesifikasjon definerer.
Ingen av disse er kodefeil i klassisk forstand. Alle ville ha passert kompilering, YAML-parseren og Markdown-validatoren. Alle ville ha blitt publisert hvis gjennomgangen var død. I tillegg er flere av dem påstander leseren tar for god fisk, fordi de høres ut som fakta fra dokumentasjonen.
Andre halvdel av Balls påstand treffer: gjennomgangen flytter seg fra PR-er til systemet. Våre gjennomgangsagenter leser ikke differ, de sammenligner påstander med kildene og språkversjonene med hverandre. Spørsmålet endrer seg fra «er denne linjen riktig» til «er denne setningen sann, og henger helheten sammen». Det skjer ikke i et pull request-vindu, men det skjer fortsatt, og det er mennesket som til slutt bestemmer om endringen går i produksjon.
Trengs enhetstester fortsatt med KI
«Enhetstester kan også dø. Hvorfor ha støttehjul hvis du aldri faller? Jeg har fått modeller til å skrive 900 linjer Arduino C, kompilere dem uten en eneste feil og sende dem til enheten, der programmet kjørte perfekt. 900 linjer blir ingenting i fremtiden.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: uenig.
Arduino-eksempelet er ekte og imponerende. Men det beviser noe annet enn det påstanden antyder. Et program som kompilerer og kjører, oppfyller ett kriterium: det gjør noe uten å krasje. Det sier ikke om det gjør det forfatteren ville for hver mulige inndata, eller om det fortsatt vil gjøre det etter neste endring.
På nettstedet vårt har de mest verdifulle testene vist seg å være de som sjekker resultatet av bygget, ikke kildekoden. Kontrollene som kjøres på dist-katalogen teller H1-overskrifter på hver side, sjekker om Markdown-syntaks har lekket ut som tekst, og om de strukturerte dataene stemmer med den kanoniske adressen. Disse kontrollene fanget opp regresjoner i endringer som kompilerte uten en eneste advarsel. Kompilatoren vet ikke at siden skulle ha én H1-overskrift, men har to.
En test er ikke et støttehjul. Den er en nedskrevet forventning i en form som maskinen sjekker ved hver ny endring, også den en agent gjør om et halvt år. Jo mer kode modellene skriver, desto mer lønner en slik forventning seg, fordi ingen mennesker leser alt de har generert. Det som endrer seg, er heller testnivået: færre tester av enkeltfunksjoner, flere tester av hvordan hele systemet oppfører seg og hva det leverer.
Lønner det seg å lære programmering i 2027
«Håndverket å skrive kode vil forsvinne. Ja, det finnes fortsatt italienske skomakere. Men se på føttene dine.»
«Håndverket å bygge programvare blir viktigere enn noensinne. Å vite hvordan man løser forretningsproblemer med programvare, hvordan annen programvare har gjort det og hvorfor og hvorfor ikke, når og hvordan man skal levere det, hvordan man får tilbakemeldinger på det: det er det nye spillet.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: delvis enig i den første påstanden, helt enig i den andre.
Å skrive kode linje for linje betyr faktisk mindre. I pipelinen vår skriver agentene innhold, rettelser og hjelpeskript raskere enn noen av oss. Men for å vurdere om koden til en MCP-server kaller et API som faktisk finnes, må man kunne lese koden og vite hvor i SDK-et man skal sjekke. Å lese kode forsvinner ikke sammen med å skrive den. Skomakeren i Balls bilde trenger ikke lenger sy sko, men noen må se at sålen er limt på skjevt.
Den andre påstanden er den mest treffende setningen i hele notatet. Å vite hva som skal bygges, hvordan det skal deles opp, når det skal lanseres og hvordan effekten skal måles, er i dag flaskehalsen. Repositoriet vårt har et eget dokument med produktprinsipper for dette, og det starter med at problemet ikke lenger er «hvordan implementerer vi det», men «hva bør i det hele tatt lages».
På spørsmålet om man bør lære programmering, er svaret vårt derfor: lær å bygge programvare, og se på kodeskriving som veien til å forstå hva agenten produserer. Om KI tar jobben fra dem som utvikler nettsider, skriver vi mer om i teksten vil KI erstatte WordPress-utviklere, og om å jobbe med agenter i et team i artikkelen om agentic engineering.
Feil i KI-kode skyldes ofte feil bestilling
«De fleste feil vil ikke være ‘kode’-feil. De vil være ‘du ba om feil ting’-feil.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: enig.
Denne påstanden bekreftes av vår dyreste lærepenge. Tidligere oppgavepartier for agentene ba om å utvide artikler til et bestemt antall ord. Agentene gjorde nøyaktig det de ble bedt om: de la til tekst som drev telleren opp uten å tilføre innhold. Koden i skriptene var feilfri. Det var bestillingen som var feil. I dag forbyr en regel i repositoriet skript som fyller på tekst for å nå et ordantall, og en egen kontroll fanger opp gjentatte blokker med fyllstoff.
Den samme mekanismen ser vi i den oppdiktede casestudien med resultatet på 23 prosent. Agenten fikk oppgaven «legg til en seksjon basert på kilder» og en kilde som bare var tittelen på et foredrag. Modellen fylte hullet med et tall. Bestillingen sa ikke hva agenten skulle gjøre når kilden var for tynn.
Den praktiske lærdommen: det som tar mest tid i arbeidet med agenter i dag, er å skrive oppgaven, altså å beskrive hva resultatet skal være, hva som ikke er tillatt, og hva som skal skje når data mangler. Det er en spesifikasjon, bare kortere og skrevet oftere enn før.
Vil åpen kildekode overleve KI
«Åpen kildekode i sin nåværende form gir ikke mening lenger. ‘Med nok øyne blir alle feil grunne’ er fortsatt sant, men nå har vi kunstige øyne.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: uenig.
Ball viser til Linus’ lov, formulert av Eric S. Raymond: med mange deltakere blir feil funnet raskt. Påstanden er at når modeller kan se på koden i stedet for mennesker, mister den åpne bidragsmodellen mening.
Data fra et av de viktigste prosjektene innen åpen kildekode viser motsatt effekt. Daniel Stenberg, som står bak curl, avsluttet prosjektets bug bounty-program 31. januar 2026. Siden 2019 hadde programmet gitt 87 bekreftede sårbarheter og over 100 000 USD i belønninger til forskere. Ifølge Stenberg viste over 15 prosent av rapportene seg tidligere å være reelle sårbarheter, mens andelen fra 2025 falt under 5 prosent under en flom av KI-genererte rapporter. Ikke engang én av tjue var ekte.
Kunstige øyne finnes, men i denne formen produserer de rapporter, ikke rettelser, og de belaster de samme menneskelige vedlikeholderne som skulle tjene på dem. Åpen kildekode endrer altså filtrene ved inngangen, ikke prinsippet. WordPress, som vi jobber med hver dag, lever fortsatt av åpen kode og av mennesker som bestemmer hva som kommer inn i kjernen. Det valget forsvinner ikke når det blir mer kode. Det blir viktigere.
Betyr ytelse i koden noe med KI
«Ytelseskritiske bidrag fra mennesker vil forbli det de er: et kanttilfelle. I 99 % av all programvare spiller det ingen rolle at du kunne ha skrevet en raskere algoritme eller valgt en bedre datastruktur. […] Når det betyr noe, kan modellene fikse det.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: delvis enig.
Den første delen er vanskelig å argumentere mot. Mesteparten av koden er ikke en flaskehals og vil aldri bli det. Uenigheten gjelder setningen «modellene kan fikse det». En modell fikser ytelsen hvis noen vet hvor den lekker. I bygget vårt lå ikke problemet i en algoritme noen kunne ha skrevet bedre, men i et steg ingen tenkte på før vi målte tiden for hvert enkelt trinn. Målingen gjorde et menneske, rettelsen kunne en modell skrive etterpå.
I WordPress-prosjekter ser det likt ut: en treg nettbutikk har sjelden én dårlig algoritme. Den har for mange utvidelser, spørringer uten indeks eller cache satt opp på feil sted. Avgjørelsen om hva som skal fjernes, krever at man forstår kundens virksomhet, ikke bare en profiler.
Vil KI-agenter ta livet av terminalen
«Terminalen er død. Det meste av utviklerverktøyene vil bli vasket bort av tokens. Skall, teksteditorer og CLI-verktøy vil ikke lenger bli brukt av mennesker.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: uenig, selv om vi forstår hvor påstanden kommer fra.
Ball påpeker selv at han skriver dette som en som er glad i terminalen. Han har rett i at mennesker stadig sjeldnere husker flaggene til jq. Pipelinen vår viser likevel at terminalen ikke forsvinner, den får en ny bruker. Agentene jobber nettopp i skallet: de kjører npm run gates:run, leser filer og kaller git. Hver kontroll som fanger opp feilene deres, er et kommandolinjeskript.
Terminalen blir grensesnittet for agentene og for mennesket som sjekker hva agenten har gjort. Når en gjennomgangsagent rapporterer en feil, er én grep-kommando på filen den raskeste måten å verifisere den på. Mennesket skriver færre kommandoer, men leser flere.
Tokens som nytt paradigme for databehandling
«Tokens er det nye paradigmet for databehandling. Alt vil bli bygget på nytt oppå dem. […] Vi går inn i den postbinære æraen.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: delvis enig.
Ball påpeker at vi i 80 år har hatt deterministiske datamaskiner, og at vi forveksler hvordan de fungerte med hvordan de må fungere. Det er et rimelig poeng. Erfaringen vår legger til ett forbehold: jo mer arbeid ikke-deterministiske modeller gjør, desto mer verdt er de deterministiske kontrollene rundt dem.
I pipelinen vår kan en agent skrive den samme setningen på ti måter, men kontrollen teller overskrifter likt hver gang. Den kombinasjonen fungerer: modellen genererer, skriptet sjekker. Den postbinære æraen, hvis den kommer, vil stå på et binært fundament av kontroll. Vi har vanskelig for å se for oss en ansvarlig utrulling der modellen sjekker seg selv uten et fast kriterium.
Vil KI erstatte produktledere og designere
«Triaden PM/design/utvikling vil forsvinne. […] ‘Utviklere’ som fungerer som ‘kjøttproxyer’, dytter tickets inn i agenter og rapporterer tilbake til mennesker, vil ikke lenger være verdifulle.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: delvis enig.
Påstanden om «kjøttproxyer» treffer. En rolle som bare går ut på å sende oppgaver mellom et menneske og en agent, har ingen verdi, fordi agenten kan ta imot oppgaven direkte. I pipelinen vår finnes det ingen mellomledd mellom eieren og agentene.
Beslutningene triaden delte på, forsvinner likevel ikke sammen med rollefordelingen. Noen må fortsatt bestemme hva vi bygger og ikke bygger, hvordan grensesnittet skal se ut, og om endringen er klar. Hos oss har disse beslutningene samlet seg hos én person, ikke løst seg opp. Det handler mer om å samle rollene i ett hode enn om at de tar slutt. Det gir et krav: den som leder agentene, trenger kompetanse fra alle tre områdene.
KI i små bedrifter og store konsern
«Forskjellen mellom programvareutvikling i store konsern og i små selskaper vil øke.»
«Noen vil bli priset ut av å lage programvare. […] hvis du ikke får nok tokens, spiller du i andredivisjon. Du må få tak i tokens.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: delvis enig i begge påstandene.
Ball skriver at oppstartsselskaper som kopierer Googles praksis, vil se enda mer latterlige ut, fordi de kan bygge raskere og med færre begrensninger. Sett fra et lite team stemmer det: agentpipelinen vår har ingen arkitekturkomité, og en bølge med endringer i flere titalls filer går gjennom i løpet av en dag. Men det som beskytter oss mot feil, er nettopp en praksis kjent fra store selskaper: automatiske kontroller, uavhengig gjennomgang og én eier av beslutningene. Et lite selskap kan droppe prosessen, men ikke kontrollen.
Når det gjelder kostnaden for tokens: tilgang til sterke modeller koster faktisk penger, og kostnaden vokser med antall parallelle agenter. Skillelinjen går likevel ikke mellom rike og fattige, men mellom dem som klarer å gjøre tokens om til et verifisert resultat, og dem som betaler for tekst som havner i søpla. Fyllstoffet som ble skrevet for å nå et ordantall, kostet også tokens.
Billig eller smart KI-modell til programmering
«Det er tvilsomt om billigere modeller vil bli brukt. […] en smartere modell gjør færre feil og trenger færre runder. Når tenker du egentlig ‘det går fint om den tar feil noen ganger’?»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: enig.
Pipelinen vår har denne regelen skrevet inn i instruksjonene til repositoriet. Agenten som skriver tekst og oversettelser, kjører på standardmodellen, som er den sterkeste. Den billigere modellen tar bare skrivebeskyttede gjennomganger, og hvert funn den rapporterer, sjekkes i filen før noen retter noe.
Den fordelingen svarer direkte på Balls spørsmål. En billig modell er akseptabel der en feil koster én kontroll. Der en feil havner i tekst i produksjon på seks språk, blir sparte tokens til lengre gjennomgang og flere rettelser. Det som teller, er kostnaden for hele syklusen, ikke prisen på ett kall.
Betyr ren kode noe med KI
«Det finnes ikke noe bevis for at ‘god kode’ vil ha betydning i fremtiden. Selve begrepet ‘god kode’ bygger i hovedsak på ideen om at det er enkelt, billig og effektivt for mennesker å jobbe med den. Men mennesker vil ikke endre mesteparten av koden.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: delvis enig.
En linjebredde på 80 kolonner betyr virkelig ingenting for en agent. En del av prinsippene for «ren kode» vil likevel overleve av en annen grunn enn menneskelig komfort: koden må kunne sjekkes. Kontrollene våre fungerer bare fordi resultatet har en forutsigbar struktur. Frontmatter med en tydelig kontrakt for feltene, én eier for hver identifikator i de strukturerte dataene, én funksjon som bestemmer adressen til en tjeneste. Da to steder i koden sendte ut den samme schema-identifikatoren, var problemet ikke at det var stygt, men at ingen kontroll visste hvilket av dem som var sannhetskilden.
«God kode» slutter å bety «behagelig å lese». Den begynner å bety «kode der riktigheten kan verifiseres automatisk». Det er en forskyvning, ikke en slutt.
KI-generert brukergrensesnitt i sanntid
«Modellene vil bli så raske at brukergrensesnitt genereres i sanntid. Mye brukergrensesnitt finnes fordi programvaren ikke forstår hva du vil.»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: vi har ingen data som bekrefter eller avkrefter påstanden.
Ball skriver at menyer, innstillingsskjermer, dashbord og filtre i stor grad er et grensesnitt mellom mennesket og en «dum maskin». Observasjonen er interessant. Vi genererer ikke grensesnitt i sanntid og har ingen måling som lar oss vurdere hvordan et slikt grensesnitt klarer seg når det gjelder tilgjengelighet, forutsigbarhet og brukertillit. Vi sier heller det enn å gjette.
Én observasjon fra arbeidet vårt: brukerne av nettstedene vi bygger, forventer fortsatt at knappen er på samme sted ved neste besøk. Et grensesnitt som endres ved hvert besøk, måtte på en eller annen måte dekke det behovet.
Når vil KI endre programvareutvikling
«Det vil ta en generasjon før den ‘nye programvaren’ erstatter den ‘gamle programvaren’. […] det vil være folk ansatt for å skrive kode om 10 år. Men vil du ha den jobben?»
(Thorsten Ball, innlegg på X, 19. september 2026, egen oversettelse)
Vurdering: enig.
Selv å måle hvor mye KI gir utviklere, viser seg å være vanskelig. Organisasjonen METR gjennomførte i 2025 en studie med randomisert kontrollgruppe blant erfarne utviklere i åpen kildekode som jobbet i sine egne repositorier. Med KI-verktøy tok oppgavene dem 19 prosent lengre tid. I februar 2026 beskrev METR en andre studie: for utviklerne fra den første runden ble endringen i oppgavetid anslått til minus 18 prosent (konfidensintervall fra minus 38 til pluss 9 prosent), og for de nye deltakerne til minus 4 prosent. METR selv kalte likevel disse dataene et upålitelig signal, fordi stadig flere utviklere takket nei til å delta, ettersom de ikke ville jobbe uten KI.
Det er et godt bilde på overgangsperioden: verktøyene er allerede så innvevd i arbeidet at det er vanskelig å finne en kontrollgruppe, og samtidig finnes det ikke noe hardt tall for hvor mye de gir. En generasjon er en rimelig tidsskala for en slik endring. Balls spørsmål på slutten av notatet overlater vi til leseren.
Hva dette betyr for bedrifter som kjøper programvare
Av de 16 påstandene trekker vi fire praktiske lærdommer for bedrifter som bestiller nettsider, nettbutikker og integrasjoner.
- Spør hvem som går gjennom påstandene og hvordan, ikke bare koden. KI-kode kompilerer som den skal. Feilene sitter i fakta, paragrafnumre, API-navn og forretningsantakelser.
- Krev automatiske kontroller av resultatet. En test som sjekker den bygde siden eller at integrasjonen fungerer, fanger opp regresjoner som ikke synes i kildekoden.
- Invester i oppgavebeskrivelsen. De fleste feil skyldes dårlige bestillinger. En god spesifikasjon er billigere enn rettelser.
- Ikke spar på modellen der resultatet går i produksjon. Billig modell til gjennomgang med verifisering, sterk modell der innholdet eller koden blir til.
Har du en nettside eller app som er bygget raskt med KI, og vet ikke hva som skjuler seg i den, hjelper vi med redning av KI-bygde nettsider. Vil du ta agenter inn i egne prosesser med den typen kontroll som er beskrevet over, se KI-implementering og utvikling av MCP-servere. Den bredere bakgrunnen for hvorfor gevinstene av KI kommer saktere enn leverandørene lover, beskriver vi i teksten om KI-produktivitetsparadokset.
Sist oppdatert: 15. oktober 2026.