Tre innstillinger blir blandet sammen når en nettstedeier sier “jeg vil ut av AI”. Én ligger i Search Console, én i robots.txt under tokenet Google-Extended, og én i robots.txt som en Content-Signal-linje. De svarer på ulike spørsmål, og ingen av dem er en generell AI-av-bryter.
Googles sider trekker skillelinjene tydelig nok. Problemet er at linjene er spredt over fire sider. Dette innlegget setter dem side om side, siterer hver side der det trengs, og ender i en tabell for å velge bryter. Alle sitater ble lest 6. oktober 2026.
wppoland.com er et nyttig testtilfelle fordi oppsettet er tungvint: seks språkmapper, hver verifisert som sin egen URL-prefiksegenskap under én domeneegenskap, og en robots.txt som allerede har en Content-Signal-linje. Vi har ikke målt noen trafikkeffekt av disse bryterne, og ingenting nedenfor hevder det.
Hvilken Google-bryter fjerner nettstedet mitt fra AI-oversikter og AI Mode
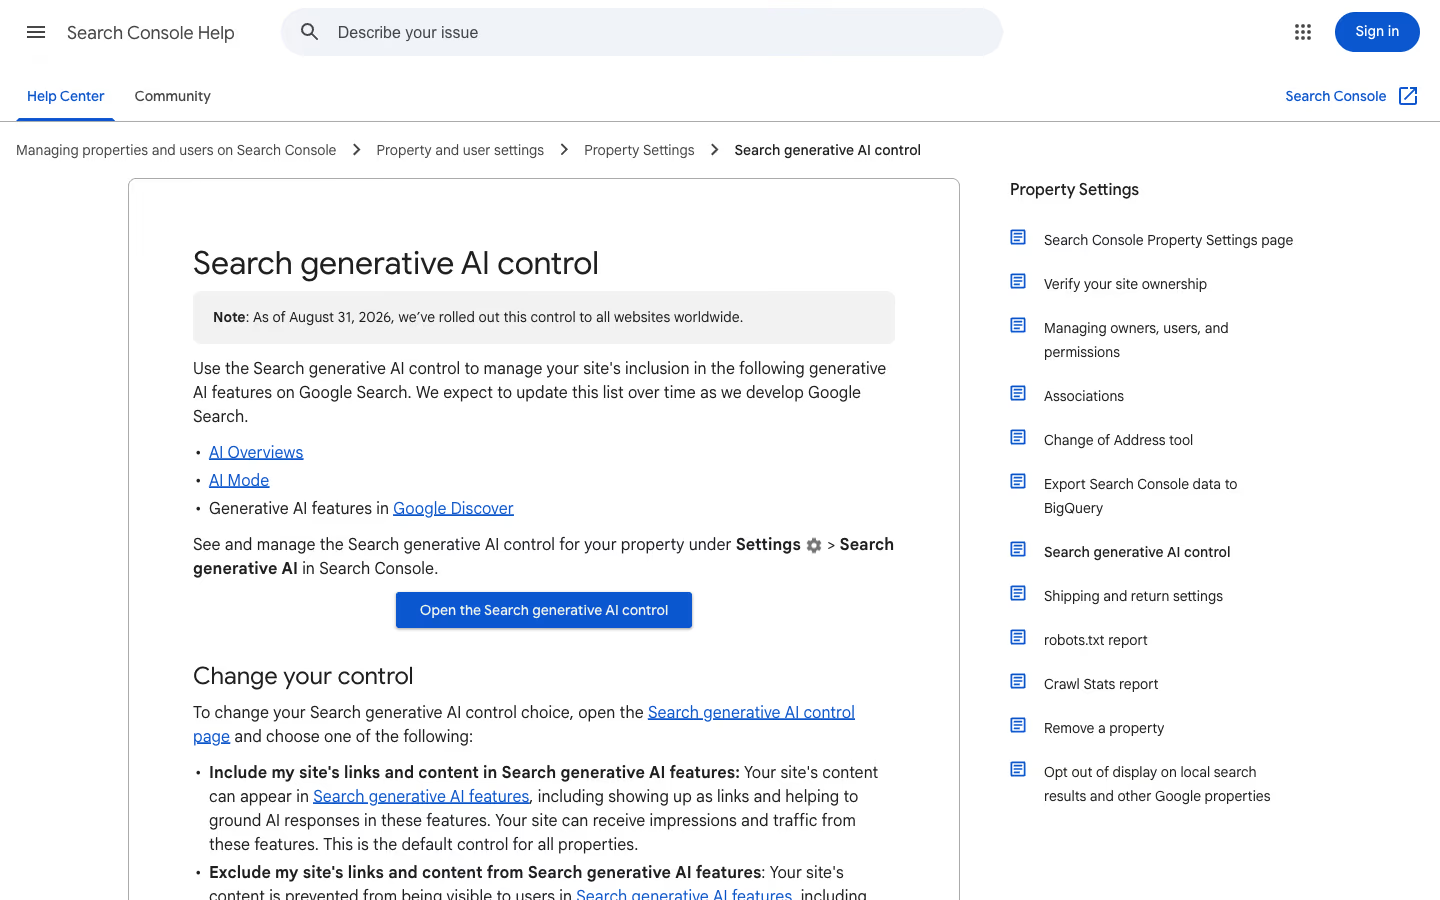
Search generative AI control i Search Console. I det engelske grensesnittet ligger den under Settings, deretter Search generative AI. Googles hjelpeside lister opp hva den styrer: AI-oversikter (AI Overviews), AI Mode og generative AI-funksjoner i Google Discover, og sier at listen ventes oppdatert over tid. Om innføringen:
“Fra 31. august 2026 har vi innført denne kontrollen for alle nettsteder over hele verden.”
Google Search Console Help, Search generative AI control (vår oversettelse av den engelske originalen)
Det finnes ingen norsk etikett å sitere her. Da hjelpesiden ble hentet med hl=nb 6. oktober 2026, leverte Google den på dansk (tittel “Styring af generativ AI-funktioner i Søgning”), mens dokumentasjonen om crawlere og robots meta kom på engelsk. Vi bruker derfor det engelske navnet “Search generative AI control” og den engelske stien “Settings > Search generative AI”. En Search Console-bruker med norsk språkvalg kan få se engelske eller danske etiketter.
Du velger mellom å inkludere, ekskludere og arve fra overordnet egenskap. Inkludere er standard for alle egenskaper, og arve er standard for en egenskap som har en overordnet. Slik beskriver Google hva ekskludere gjør:
“Hvis du ekskluderer nettstedet ditt, vil lenker til nettstedet og innholdet på det ikke vises i generative AI-funksjoner i Søk. Innhold fra andre nettsteder vil fortsatt være tilgjengelig i disse funksjonene, og det kan ligne ditt. Innhold hentet fra nettstedet ditt vil ikke kunne brukes som input til å generere et AI-svar eller en forhåndsvisning i generative AI-funksjoner i Søk.”
Google Search Console Help, Search generative AI control (vår oversettelse av den engelske originalen)
To detaljer teller. Lenkene forsvinner også, ikke bare teksten, så dette er ingen måte å bli nevnt uten å bli klikket på. Og input til forankring er dekket, så ekskludert innhold brukes ikke til å bygge et svar i disse funksjonene.
Google sier også klart hva kontrollen ikke er:
“Denne kontrollen påvirker bare om innholdet ditt kan vises i enkelte generative AI-funksjoner i Søk. Kontrollen brukes ikke som et rangerings- eller inkluderingssignal for andre deler av Søk.”
Google Search Console Help, Search generative AI control (vår oversettelse av den engelske originalen)
“Denne kontrollen påvirker ikke AI-trening. Bruk Google-Extended for å begrense trening av modellene som brukes til å generere svar i generative AI-funksjoner i Søk. Bruk noindex for å blokkere innholdet ditt fra å vises i Google Søk helt.”
Google Search Console Help, Search generative AI control (vår oversettelse av den engelske originalen)
Om tidsbruk sier siden at en endring vanligvis tar noen dager. Innhold blir ekskludert 1 til 2 dager etter at kontrollen er aktiv, og noe av det senere på grunn av hurtigbuffer og spredning.
Fjerner Google-Extended nettstedet mitt fra AI-oversikter
Nei. Google-Extended er dokumentert på oversiktssiden om crawlere, og produktområdene den nevner er Gemini og Vertex AI, ikke Søk:
“Google-Extended er et eget produkttoken som nettstedutgivere kan bruke til å styre om innhold Google henter fra nettstedene deres, kan brukes til å trene fremtidige generasjoner av Gemini-modeller som driver Gemini Apps og Vertex AI API for Gemini, og til forankring (å gi modellen innhold fra Googles søkeindeks når spørsmålet stilles, for å bedre faktariktighet og relevans) i Gemini Apps og Grounding with Google Search på Vertex AI.”
Google crawlers documentation, Google-Extended (vår oversettelse av den engelske originalen)
“Google-Extended påvirker ikke om et nettsted er med i Google Søk, og brukes heller ikke som rangeringssignal i Google Søk.”
Google crawlers documentation, Google-Extended (vår oversettelse av den engelske originalen)
Leser man dette sammen med forrige seksjon, deler de to sidene arbeidet mellom seg. Søkekontrollen styrer forankring og visning inne i Søk-funksjonene. Google-Extended styrer trening og den forankringen Gemini Apps og Vertex AI gjør. Ingen av sidene hevder å dekke den andres område, og siden for Søk-kontrollen viser til Google-Extended for trening.
En praktisk følge kommer av hvordan tokenet virker:
“Google-Extended har ingen egen user agent-streng i HTTP-forespørsler. Crawlingen skjer med Googles eksisterende user agent-strenger, og user agent-tokenet i robots.txt brukes som en kontroll.”
Google crawlers documentation, Google-Extended (vår oversettelse av den engelske originalen)
Vår lesning: det finnes ingen Google-Extended-linje å lete etter i tilgangsloggene, så robots.txt-gruppen er det eneste stedet valget finnes.
Hva gjør Content-Signal i robots.txt for Google
Content-Signal er noe helt annet. Det er et robots.txt-direktiv publisert av Cloudflare, med tre signaler. Nettstedet definerer ai-input slik:
“Å mate innhold inn i én eller flere AI-modeller (for eksempel retrieval augmented generation, forankring eller annen sanntidshenting av innhold til generative AI-søkesvar).”
contentsignals.org (vår oversettelse av den engelske originalen)
Og ai-train i én linje:
“Trening eller finjustering av AI-modeller.”
contentsignals.org (vår oversettelse av den engelske originalen)
Det tredje signalet, search, gjelder bygging av en søkeindeks og visning av lenker og korte utdrag, og nettstedet presiserer at det “ikke omfatter å levere AI-genererte søkesammendrag”. Samme nettsted er rett fram om grensene:
“Content-Signal-direktivet virker ved at du signaliserer om du tillater (yes) eller ikke tillater (no) bestemte kategorier av AI-handlinger. Ikke alle automatiserte systemer følger robots.txt-filer, og noen kan ignorere disse Content-Signal-direktivene.”
contentsignals.org (vår oversettelse av den engelske originalen)
“robots.txt-filer uttrykker hva du foretrekker. De hindrer likevel ikke crawler-operatører i å ta innholdet ditt på teknisk nivå.”
contentsignals.org (vår oversettelse av den engelske originalen)
Verken hjelpesiden i Search Console eller Googles crawlerdokumentasjon som er sitert her, nevner Content-Signal. Vi søkte i teksten på begge sidene og fant ingen forekomst. Det er en påstand om disse to sidene, ikke om hva et Google-system gjør. I planleggingen betyr det at en Content-Signal-linje er en erklæring rettet til alle crawlere, og ikke en Google-kontroll. Hvordan linjen oppfører seg i robots.txt-grupper, er omtalt i innlegget vårt om Content-Signal-feilen med virkeområde.
Blokkerer noindex og nosnippet AI-oversikter
Begge virker, begge er grove, og de er ikke grove på samme måte.
noindex tar siden ut av Google Søk, og det er den veien siden for Søk-kontrollen selv peker på. Prisen er den åpenbare: siden mister de organiske resultatene også.
nosnippet er smalere, og Googles dokumentasjon om robots meta sier at det rekker helt inn i AI-funksjonene:
“Ikke vis tekstutdrag eller videoforhåndsvisning i søkeresultatene for denne siden. Et statisk miniatyrbilde (hvis tilgjengelig) kan fortsatt vises når det gir en bedre brukeropplevelse. Dette gjelder alle former for søkeresultater (hos Google: nettsøk, Google Images, Discover, AI-oversikter, AI Mode) og vil også hindre at innholdet brukes som direkte input til AI-oversikter og AI Mode.”
Google robots meta tag documentation, nosnippet (vår oversettelse av den engelske originalen)
Haken ligger i første setning. nosnippet fjerner utdraget fra vanlige blå lenker også, og det settes per side, så det kan koste klikk som Søk-kontrollen ikke ville gjort. Den siste delen er vår slutning fra de to sidene, ikke en måling.
Det finnes enda en felle, og den rammer nettsteder som kombinerer verktøy. Google skriver:
“Husk at disse innstillingene bare kan leses og følges hvis crawlere har tilgang til sidene som inneholder dem.”
Google robots meta tag documentation (vår oversettelse av den engelske originalen)
En Disallow i robots.txt på en side som har noindex eller nosnippet, opphever taggen. Vår egen robots.txt har en kommentar om akkurat dette for taksonomiarkiver, og derfor sperrer vi dem ikke.
Hvilken bryter passer til hvilket mål
| Mål | Bryter | Hva den blokkerer | Hva den ikke blokkerer |
|---|---|---|---|
| Ut av AI-oversikter, AI Mode og generative Discover-funksjoner, men fortsatt med i Søk | Search generative AI control satt til ekskludere | Lenker og innhold i disse funksjonene, input til forankring for dem, trafikk og visninger fra dem | AI-trening, resten av Søk, rangering, deltakelse i Merchant Center og Google Ads |
| Ut av Gemini-trening og Gemini-forankring, men fortsatt med i Søk og i AI-oversikter | Google-Extended med en Disallow i robots.txt | Bruk av hentet innhold til å trene fremtidige Gemini-modeller og til forankring i Gemini Apps og Vertex AI | Plass i Google Søk, rangering, og det Søk-kontrollen styrer |
| Fortelle alle crawlere retningslinjen din ett sted | Content-Signal-linje i hver robots.txt-gruppe | Ingenting teknisk | Ingenting. Det er en erklæring, og Googles sider nevner den ikke |
| Ingen AI-tekst fra bestemte sider, siden fortsatt oppført | nosnippet | Tekstutdrag og videoforhåndsvisning overalt, også AI-oversikter og AI Mode som direkte input | Selve oppføringen av siden, eventuelt et statisk miniatyrbilde. Vanlige utdrag blir også kortere |
| Helt ut av Google Søk | noindex | Siden i Google Søk-resultatene | Ikke relevant, siden forlater resultatene. Crawleren må likevel kunne hente siden for å se taggen |
De to målene fra starten av innlegget faller slik: ut av AI-oversikter, men ikke ut av Søk, gir Søk-kontrollen eller nosnippet på enkeltsider. Ut av trening, men ikke ut av AI-svar, gir Google-Extended for Google, en Content-Signal-linje for resten, og Søk-kontrollen stående på inkludere.
Hva skjer når en språkmappe overstyrer domeneegenskapen
Arv er stedet der et nettsted med flere egenskaper får en overraskelse. Googles regel:
“Som standard arver en egenskap Search generative AI control fra den nærmeste overordnede egenskapen som har endret kontrollen sin til å slutte å arve.”
Google Search Console Help, Search generative AI control (vår oversettelse av den engelske originalen)
For wppoland.com betyr det at domeneegenskapen ligger øverst, og at hver av /pl/, /en/, /de/, /nb/, /pt-pt/ og /es/ er en underegenskap. Sett domeneegenskapen én gang, så følger alle seks. Fordi hver mappe er sin egen egenskap, kan ett språk også ekskluderes mens de fem andre forblir inkludert. Google sier det slik om underegenskaper:
“Eiere av en underegenskap kan velge å følge Search generative AI control til den overordnede egenskapen, eller endre den for den aktuelle underegenskapen og dens undersider.”
Google Search Console Help, Search generative AI control (vår oversettelse av den engelske originalen)
Det nye er varselet. Barry Schwartz rapporterte 6. oktober 2026 at Google hadde lagt til en linje på hjelpesiden, og linjen lyder:
“Eiere av domeneegenskapen på toppnivå vil se et varsel på siden for Search generative AI control når en av underegenskapene deres overstyrer innstillingen til den overordnede.”
Google Search Console Help, omtalt i Search Engine Roundtable (vår oversettelse av den engelske originalen)
Det er nyttig her, for slik kan den som eier domeneegenskapen få vite at noen har endret innstillingen for én mappe, uten å åpne seks sider. Vi har ikke sett varselet utløst. Schwartz skriver at han heller ikke har noe skjermbilde av det, så behandle det som dokumentert, ikke observert.
Hva sier robots.txt på wppoland.com i dag
Stjernegruppen og Google-Extended-gruppen i public/robots.txt lyder, nøyaktig:
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /
Disallow: /cdn-cgi/
# Google-Extended - Gemini grounding + training corpus
User-agent: Google-Extended
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /To lesninger. For det første stemmer settet med det vi vil: med i søk, med i AI-svar, ute av trening. Det betyr også at Søk-kontrollen og filen må flyttes sammen. En robots.txt som sier ai-input=yes og en Search Console-innstilling på ekskludere ville motsi hverandre.
For det andre er Google-Extended-gruppen den svakeste halvdelen. Google dokumenterer tokenet gjennom allow- og disallow-linjer, og eksempelet bruker begge. Gruppen vår sier Allow: /. Leser man det bokstavelig mot Googles side, er tokenet åpent for Gemini-trening og forankring på nettstedet vårt, og ai-train=no ved siden av er en uttalelse som ingen av de to Google-sidene sitert her nevner. For Google spesifikt er altså treningspreferansen vår erklært, men ikke båret av en mekanisme Google dokumenterer.
Å lukke dette er en egen beslutning. En Disallow: / i den gruppen ville også gi fra seg forankringsbruken i Gemini Apps, fordi tokenet dekker begge deler. Kommentaren øverst i filen kaller dessuten enhver begrensning uttrykt gjennom content signals et uttrykkelig forbehold om rettigheter etter artikkel 4 i EUs opphavsrettsdirektiv 2019/790. Om det holder, er et spørsmål for en jurist, ikke for den som redigerer robots.txt.
Hvordan måle effekten før en innstilling endres
Vi har ikke noe resultat å rapportere, og rekkefølgen er viktig. Google viser til en rapport for dette:
“For å måle hvordan innholdet ditt presterer i generative AI-funksjoner i Søk, bruk Generative AI performance report. Den kan gi deg en pekepinn på hvordan en endring av kontrollen kan påvirke trafikken til nettstedet ditt.”
Google Search Console Help, Search generative AI control (vår oversettelse av den engelske originalen)
Planen er kort. Ta opp rapporten for domeneegenskapen først. Endre én egenskap og ingenting annet. Vent ut dagene Google oppgir. Sammenlign med utgangspunktet. Hvis Søk-kontrollen, Google-Extended og en nosnippet-utrulling endres i samme uke, står man igjen med et tall ingen kan tilskrive noe. Samme disiplin gjelder for mønsteret med null klikk som er omtalt i innlegget vårt om utvidede AI-oversikter, og grunnene til at vi i det hele tatt vil siteres i svar, står i det strategiske sammendraget om LLMO.
Sjekkliste
- Bestem målet først: ut av Søk-funksjoner, ut av trening, eller begge deler.
- Velg bryteren fra tabellen. Ett mål, én bryter.
- Sett Søk-kontrollen på domeneegenskapen, og sjekk deretter hver språkegenskap for overstyring.
- Hold robots.txt og Search Console konsistente:
ai-input=yesog en ekskludert egenskap motsier hverandre. - Ikke kombiner en
Disallowi robots.txt mednoindexellernosnippetpå samme side. - Bruk Google-Extended bare hvis du godtar at det også dekker Gemini-forankring.
- Ta utgangspunkt i Generative AI performance report før endringen, og endre én ting om gangen.