Hver av de åtte feilene nedenfor gikk gjennom et skript eller en agent som avsluttet med en melding om suksess. Ingen av dem kastet et unntak. Alle havnet i produksjon på et flerspråklig nettsted som vi har bygget og driftet i årevis, og alle fant vi først da vi begynte å sammenligne resultatet med noe annet enn verktøyets egen rapport.
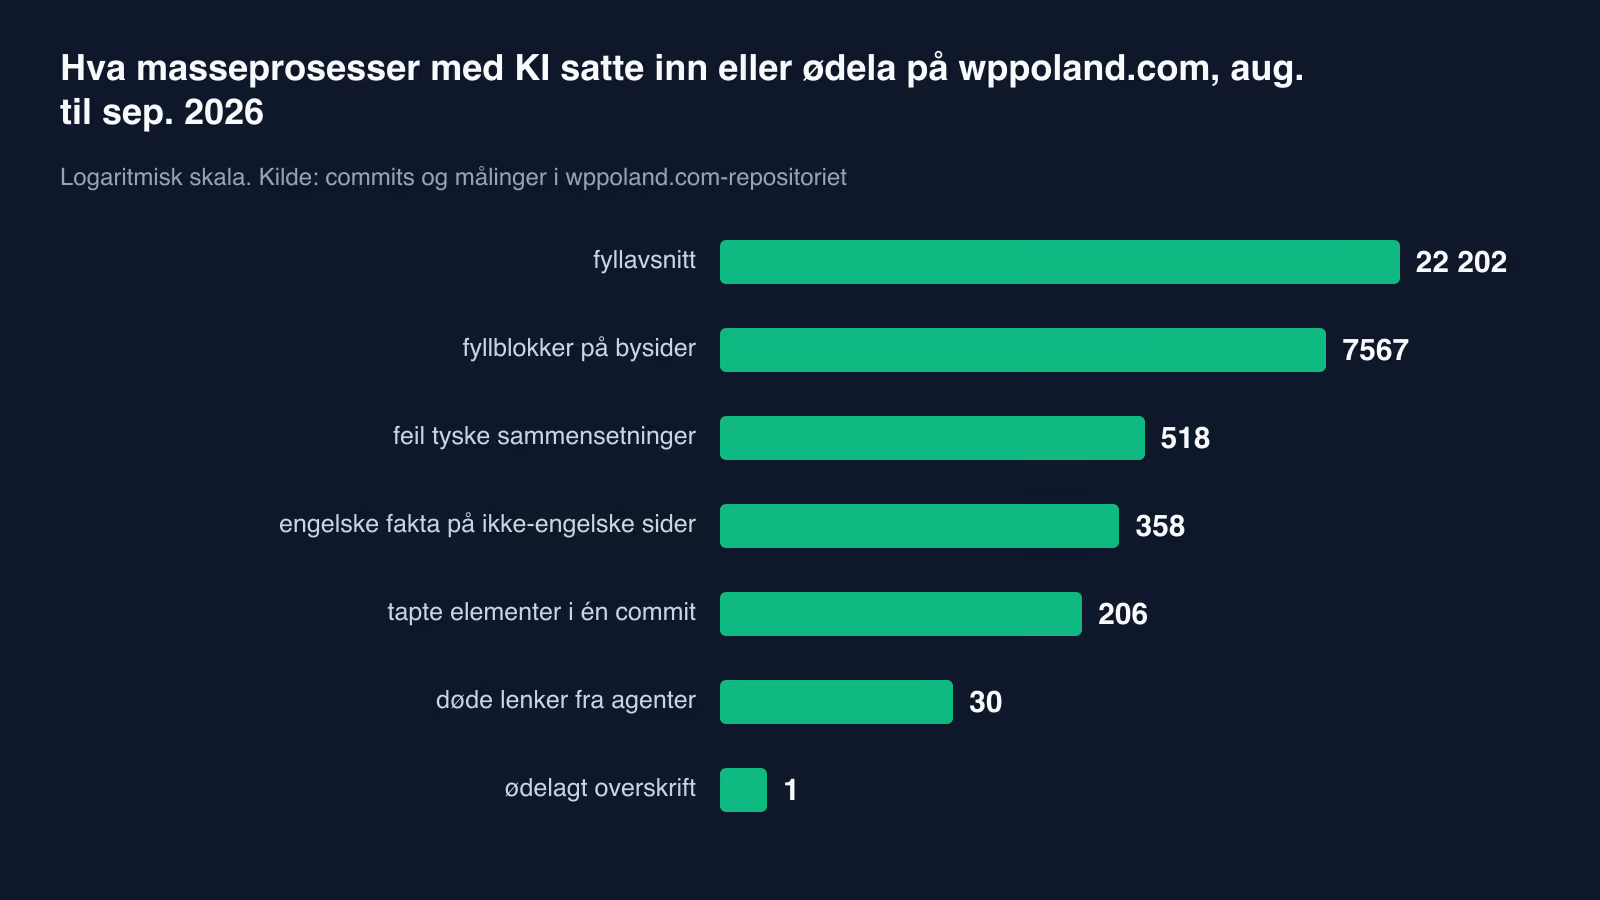
Kort sagt: mellom august og september 2026 satte KI-masseprosesser inn 22 202 fyllavsnitt på nettstedet vårt, ødela en overskrift, etterlot 358 engelske setninger på sider på fem andre språk og 518 ukorrekte tyske sammensetninger. Agenter som skrev bysider, la til oppdiktede kundecaser og 30 lenker til sider som ikke finnes. Vi beskriver mekanismen bak hver feil og kontrollen som fanger den i dag.
Vi skriver dette om vårt eget nettsted, fordi det bare er her vi har fullstendige data: commit, antall filer, tilstand før og etter. Search Engine Land publiserte denne uken en tekst om ti måter Claude kan spore av SEO-arbeidet på hvis ingen kontrollerer det den gjør. Dette er versjonen med kvitteringer.
Omfang og kontekst
wppoland.com kjører på Astro og bygges statisk på seks språk: polsk, engelsk, tysk, norsk, portugisisk og spansk. Siste produksjonsbygg fra 29. september 2026 genererte 13 733 sider. Innholdet skrives og rettes av kodeagenter og av Node-skript som går gjennom tusenvis av filer på én gang. Vi har over 70 kvalitetskontroller i CI og lokalt.
Likevel slapp hver av de beskrevne feilene gjennom alle kontrollene. Årsaken er den samme hver gang, og vi kommer tilbake til den til slutt.
| Feil | Hva som gikk ut i produksjon | Hvordan vi fant det | Kontroll i dag |
|---|---|---|---|
| Oppfylling til ordantall | 22 202 avsnitt i 873 filer | 59 kopier av ett avsnitt på en levende side | check:no-batch-filler |
| Fylltekst på bysider | 7567 blokker i 2621 filer | Nummererte overskrifter “Ateny (1)” til “Ateny (26)“ | den samme, utvidet til bysider |
| Prisregex | 1 ødelagt overskrift | Skanner for sammenklistrede ord | check:glued-words |
| Oversettelse av bare konjunksjoner | 358 engelske setninger i 104 filer | Sammenligning med den engelske motparten | detektor basert på wpId |
| Begrepsbytte uten sammensetninger | 518 sammensetninger i 356 filer | Manuell lesing av siden | søk etter feilklassen, ikke etter en litteral |
| Oppdiktede kundecaser | 13 sider, 30 døde lenker | Gjennomgang av agentene før publisering | validering av interne lenker |
| Deploy som varmet opp gammel cache | 5 av 6 forsider med gammelt innhold | Sammenligning av innhold, ikke HTTP-koder | ny purge etter smoketesten |
| Utdyping som byttet ut innhold | 142 til 206 elementer per commit | Sammenligning med forrige versjon av filen | check:element-loss |
1. Oppfylling til ordantall: 22 202 avsnitt
Redaksjonelle retningslinjer hos oss sier at et blogginnlegg skal ha rundt 2500 ord. Det var en rettesnor for et menneske. En serie batchskript behandlet den som et mål som måtte nås, og fylte opp kortere tekster med generert fyll.
Resultatet, målt under oppryddingen 29. august: 22 202 nummererte avsnitt av typen “Notatka wdrożeniowa 47” (implementeringsnotat 47) i 873 filer, opptil 60 identiske kopier i ett innlegg, pluss 4 144 malseksjoner rotert fra en pool på fem per språk. To av disse seksjonene var interne redaksjonelle instrukser, publisert som artikkeltekst. På en levende side om sikkerhetsoppdateringer i WordPress sto det samme avsnittet 59 ganger.
Skriptet hadde ingen feil. Det gjorde nøyaktig det det ble bedt om: økte ordantallet. Feilen lå i at ordantallet, et hjelpemål, ble gjort til selve målet.
Kontroll i dag: check:no-batch-filler i hver kjøring av npm run check. Den første versjonen lette etter generatorens litteraler og slapp gjennom fyll som kom tilbake med annen tekst. Den nåværende ser på formen: den samme andrenivåoverskriften tre ganger i én fil er en feil, uansett ordene.
2. Bysider: samme fyll, annen katalog
Samlingen med bysider slapp i ukevis unna alle kontroller, fordi ingen av dem skannet den. Kjøringene 11 til 14 fylte opp disse sidene til 2200 og deretter 2500 ord. Under oppryddingen 30. august fjernet vi 7567 nummererte blokker og rundt 21 tusen gjentatte seksjoner fra 2621 filer. Siden /pl/woocommerce-programista-ateny/ viste seksjoner fra “Ateny (1)” til “Ateny (26)”.
Verre: én av kjøringene la til blokker på spansk på alle språk unntatt norsk. Polske, tyske og portugisiske bysider hadde seksjoner med “Entrega y seguimiento”.
Den andre lærdommen kom under fjerningen. Den første versjonen av ryddeskriptet sammenlignet hele litteraler og meldte suksess, men etterlot 9642 seksjoner, fordi senere reparasjonsskript hadde rettet fyllet på stedet (for eksempel spansk kjønnsbøyning i 1506 filer). En eksakt bytesammenligning så ikke en eneste blokk som reparatøren hadde rørt. Nå matcher vi overskriften pluss de fire første ordene.
Etter at fyllet var fjernet, falt 724 sider under terskelen på 2000 ord. Vi sjekket dem i Google Search Console før vi bestemte noe: bare 2 hadde et eneste klikk på 90 dager, 575 hadde null visninger. 723 satte vi til noindex i stedet for å fylle dem opp igjen.
3. Prisregexen som spiste en overskrift
Tjenestesidene oppgir ikke priser utenfor prissiden, så et skript byttet ut beløp i polske złoty med “wycena indywidualna” (individuelt tilbud). Regexen matchet “zł”, det polske valutasymbolet, uten å skille mellom store og små bokstaver og uten ordgrense etter det.
På den polske siden om sikkerhetsrevisjon så overskriften “2. Złośliwe przekierowania” (2. Ondsinnede omdirigeringer) for denne regexen ut som prisen “2. Zł”. I produksjon sto den som “wycena indywidualna ośliwe przekierowania”. Den samme regexen satt også i et annet skript, det for priser på bysidene.
Vi fant det ved en tilfeldighet, da vi bygde en skanner for overskrifter med sammenklistrede ord, som ved samme anledning oppdaget 13 overskrifter uten mellomrom foran en preposisjon (“Is AMP deadin 2026?”). Rettelsen er et negativt lookahead i begge skriptene. I hele korpuset ble én overskrift rammet, men det var overskriften på en salgsside.
4. Oversettelse som bare byttet konjunksjoner
Faktafeltet (llmCard) vises synlig under artiklene og går inn i dataene for språkmodeller. På sidene på de fem språkene som ikke er engelsk, var 358 slike setninger på engelsk, i 104 filer. Noen var halvveis oversatt: et gammelt skript hadde bare byttet konjunksjonen, så en tysk porteføljeside skrev “Contact und inquiry forms”, og en polsk “granite, conglomerate, i marble countertops”.
Det mest interessante var deteksjonen. Den første detektoren, basert på andelen engelske funksjonsord, fant 172 setninger. Oversetteragentene meldte selv at det var andre engelske setninger igjen i de samme filene, og de hadde rett. Den andre kjøringen sammenlignet hver setning med faktaene i den engelske motparten til samme side (samme wpId). Uten ekstra filter ga den 4004 treff, mest lister over teknologier på bysider og det norske “for”. Med krav om minst to engelske funksjonsord gjensto 170 ekte. De siste 12 rettet vi for hånd.
Hver av de fem oversettelsene kontrollerte vi med et skript, ikke med agentens rapport: i hver fil var bare de angitte postene endret, hvert tall hadde overlevd, og det fantes ingen lange tankestreker.
5. Begrepsbytte som ikke kjente sammensetninger
En kjøring som skulle ensrette terminologien, byttet et tysk begrep ut med “laufende Betreuung”. Den håndterte ikke sammensetninger, så sidene skrev “laufende Betreuung-Commitments”, “laufende Betreuung-Übergabe” og “Wartungs-laufende Betreuung”. Det er ikke tysk. Til sammen 518 forekomster i 356 filer, alle på indekserte sider.
Posten i backloggen vår hadde en verifiseringskommando som bare søkte etter formen med bindestrek etter begrepet. Å rette nøyaktig det den pekte på, ville gjort den grønn og etterlatt 157 sammensetninger i den andre formen i 118 filer. Vi søkte derfor etter feilklassen (enhver bindestrek som berører begrepet), ikke etter litteralen noen hadde skrevet inn i oppgaven.
Reparasjonsmetoden var enkel: 497 av 518 forekomster kom fra fire malsetninger. Hver av dem skrev vi om én gang, for hånd, på korrekt tysk (“Übergabe in die laufende Betreuung”, “Wartungsbetreuung”), og byttet dem ut som eksakte setninger. De resterende 21 rettet vi enkeltvis.
6. Agenter som dikter opp referanser
Tretten kuraterte bysider ble skrevet av agenter. Gjennomgangen før publisering 26. august fant seksjoner som “Case Study 1: Dystrybutor B2B z Bielan Wrocławskich” (B2B-distributør fra Bielany Wrocławskie) med presise tall: +52% forespørsler, LCP fra 4,5 s til 0,7 s, 100/100 i PageSpeed. Ingen av disse kundene finnes. De samme tallene sto også i faktafeltet og i speakable-dataene, ikke bare i teksten.
I tillegg lenket seksjonene “Inne lokalizacje” (andre steder) til byer som var gjettet geografisk: Lübeck, Kiel, Regensburg, Girona, Tromsø. 30 døde lenker i 8 filer.
Dette fanger ingen tekstkontroll, fordi en oppdiktet kundecase er syntaktisk korrekt. Det som fanger det, er en prosessregel: agenten får en liste over eksisterende adresser i instruksen, og enhver tallfestet påstand om en kunde krever en kilde i repositoriet, ellers forsvinner den.
7. Deploy fullført med suksess, produksjon med gammelt innhold
Deployskriptet 8. september avsluttet rent: opplasting, cachetømming, smoketest 81/81 OK, avslutningskode 0. På det levende nettstedet viste fem av seks forsider gamle fliser.
Rekkefølgen var: opplasting, purge, 8 sekunders pause, smoketest. Cloudflare Pages rakk ikke å aktivere den nye deployen, så testens 81 forespørsler traff det forrige bygget og fylte cachen med det i en time. Verifiseringssteget opphevet purgen som var utført et øyeblikk før. Ingen signaler var falske. Ingen av dem målte det som gikk galt: testen sjekket HTTP-koder, ikke innhold.
I dag: skriptet tømmer cachen en gang til, etter testen, og vi bekrefter deployen med en frase fra en konkret endring på det levende nettstedet, med en parameter som omgår cachen.
8. Utdyping som byttet ut innhold
Kjøringene som skulle “utdype” korte innlegg, skulle legge til innhold. I praksis byttet noen av dem ut hele artikkelteksten. Ni innlegg måtte vi gjenopprette fra git-historikken.
Etter det bygde vi en kontroll som sammenligner hver endret fil med grunnversjonen og melder tap av et element: tabell, komponent, iframe, bilde, kodeblokk, FAQ-spørsmål, howTo-steg, intern lenke. Kjørt bakover over de siste 60 innholdscommitene flagget den hver utdypingskjøring fra 128 til 185, som hver mistet fra 142 til 206 elementer, blant dem tabeller, innebygde videoer og kodeblokker.
Den første versjonen av denne kontrollen gjenkjente overskrifter på teksten. På den aktuelle grenen meldte den 17 tapte overskrifter, og alle 17 var rettelser: sammenklistrede ord som var skilt, en spist overskrift som var gjenopprettet. En navneendring er ikke et tap. Overskrifter, lenker og FAQ teller vi derfor i antall, og identitet sjekker vi bare for bilder, komponenter og iframe.
Felles mekanisme: suksess sett fra verktøyet
Alle de åtte tilfellene har samme form. Verktøyet målte det det selv hadde gjort, og meldte suksess på det grunnlaget. Oppfyllingsskriptet målte ordantallet. Ryddeskriptet målte om det fant sine egne litteraler. Verifiseringen i backloggen målte én form av sammensetningen. Smoketesten målte HTTP-koder.
Hver feil fant vi først da vi sammenlignet resultatet med noe eksternt:
- med forrige versjon av samme fil (tapte tabeller og seksjoner),
- med motparten på et annet språk (engelske setninger på tyske sider),
- med det levende nettstedet i stedet for deployloggen (gammel cache),
- med feilklassen i stedet for litteralen fra oppgaven (den andre formen av sammensetningene),
- med data om etterspørsel (723 bysider uten en eneste visning).
Av dette følger en praktisk regel som vi har brukt siden september: rapporten fra en agent eller et skript er en hypotese. Resultatet kontrolleres av et separat skript som ikke vet hva verktøyet hadde til hensikt, og som sammenligner tilstanden før med tilstanden etter.
Hva jeg ville endret før den første masseprosessen
- Ingen tallmål for et skript som skriver prosa. Ordantall, antall lenker og antall FAQ er mål å lese, ikke å oppfylle.
- En kontroll som sammenligner med forrige versjon av filen før den første batchcommiten, ikke etter den trettiende.
- Hver regex på tekst testet på overskrifter og på ord med polske tegn, fordi “Zł” er begynnelsen på mange polske ord.
- Oversettelser verifisert ved sammenligning med motparten på kildespråket, ikke med en ordliste.
- Kommandoen som verifiserer en oppgave, søker etter feilklassen. Hvis oppgaven nevner ett eksempel, søk også etter variantene.
- Deploy bekreftet med innhold på det levende nettstedet, på hvert språk.
Hva denne teksten ikke beviser
Vi hevder ikke at disse feilene kostet oss trafikk, fordi vi ikke har målt det på en måte som kunne avgjort det. Noen av sidene med fylltekst hadde heller ingen visninger før fyllet kom.
Googles spamoppdatering for september startet 25. september 2026 og skal vare rundt to uker. Ifølge oppsummeringen fra Search Engine Roundtable 28. september traff den programmatiske sider og KI-generert innhold, og Google publiserte samme uke en artikkel om systemet SAFE for å oppdage masseprodusert “AI slop”. Bysidene våre hører til nettopp denne kategorien. Avlesningen i Search Console, separat for bysider, bloggen og tjenestesidene, gjør vi når oppdateringen er ferdig, og vi skriver om den uansett resultat.
En siste merknad gjelder oss selv: denne teksten ble også skrevet med hjelp fra en agent. Hvert tall i den kommer fra en commit eller fra en måling i repositoriet vårt, og har gått gjennom de samme kontrollene som vi beskriver her.