Innen 2026 går en voksende del av informasjonssøkene gjennom et system som leser siden din i stedet for å vise den fram. Gartner anslo et fall på 25 prosent i tradisjonelt søkevolum, og over 23 timer i august 2026 hadde 72,4 % av forespørslene til dette nettstedet en ukjent user agent. Denne artikkelen handler om det mekaniske spørsmålet bak begge tallene: hva en generativ motor må finne på siden din for i det hele tatt å kunne sitere den, og hvordan du sjekker om den finner det, på ditt eget domene, i dine egne logger.
Overgangen fra SEO til GEO

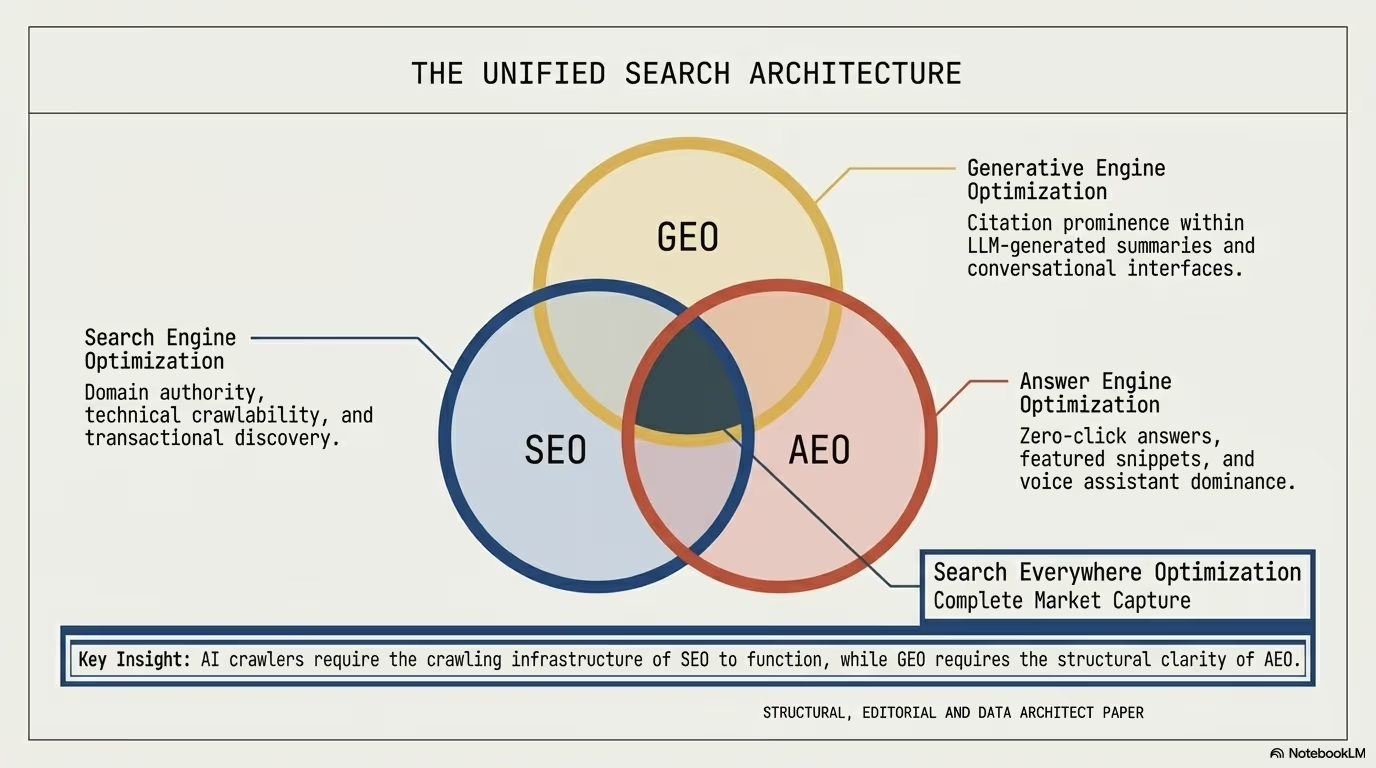
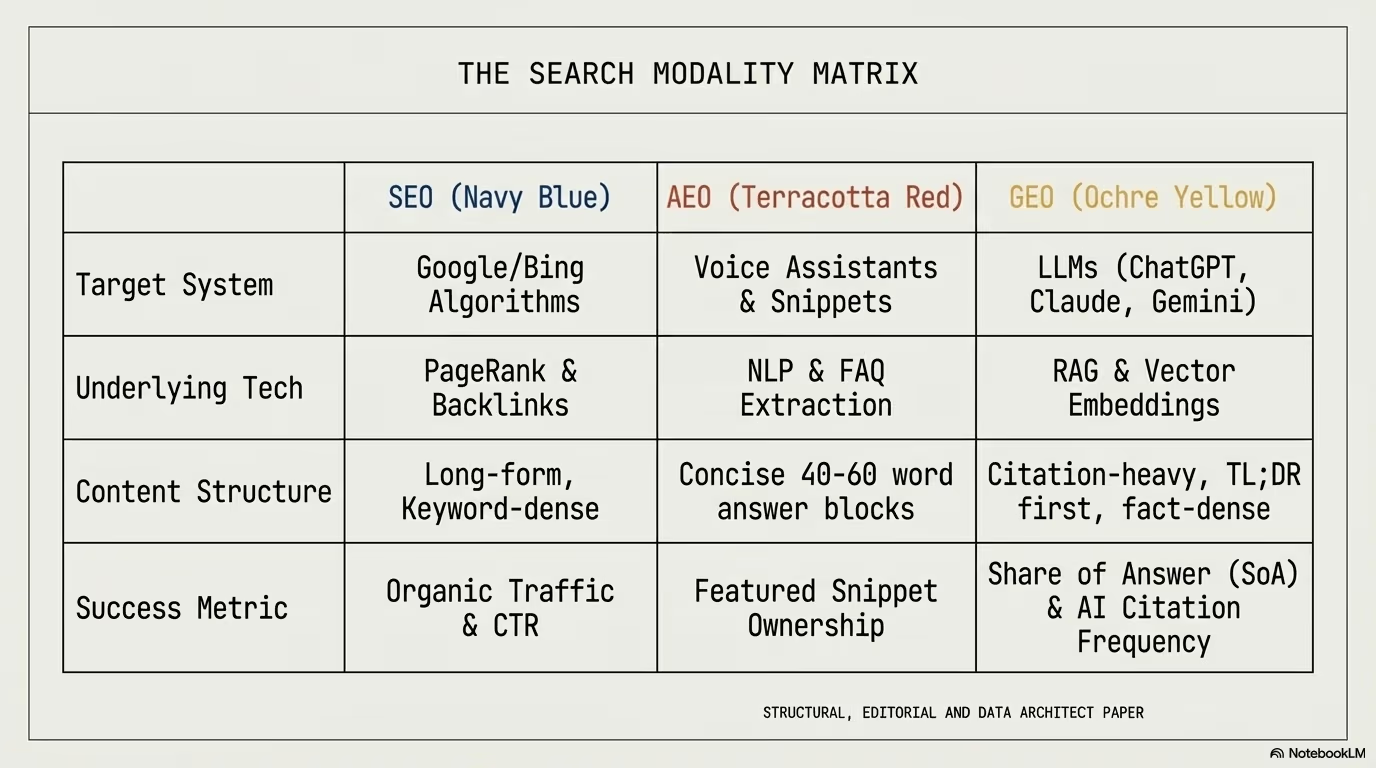
Forskjellen mellom SEO og Generative Engine Optimization er ikke et stemningsskifte i bransjen. Den er en forskjell i hvem som leser siden, og hva leseren gjør med den. En søkemotorcrawler henter siden din for å plassere den i en indeks, og resultatet er en rad i en liste som et menneske kan klikke på. En generativ motor henter siden din midt i en samtale, klipper den opp i passasjer, velger noen av dem, og skriver et svar som skal stå på egne bein. Den blå lenken er da en fotnote under svaret, ikke selve leveransen.
Det er tre forskjellige hentinger i sving samtidig, og de blandes ofte sammen. Den første er treningshenting: en crawler som samler tekst som senere blir vekter i en modell. Den gir deg ingen sitering og ingen trafikk, og den skjer måneder før noen stiller et spørsmål. Den andre er indekshenting for et retrieval-lag, altså den bygger opp søkeindeksen som motoren spør mot når den trenger ferske fakta. Den tredje er sanntidshenting: agenten åpner nettadressen din mens brukeren venter, leser den, og bruker det den rekker å lese. Bare de to siste kan gi deg et sitat, og bare den tredje er følsom for hvor raskt siden svarer.
Denne inndelingen er grunnen til at robots.txt gir mindre kontroll enn folk tror. Filen er en instruks til veloppdragne crawlere om hva de kan hente, den er ikke en tilgangskontroll, den håndheves ikke av serveren, og den skiller i utgangspunktet ikke mellom trening og svargenerering. Flere leverandører har derfor skilt ut egne user agent-navn for de to formålene, slik at du kan si nei til det ene og ja til det andre. Blokkerer du bredt, forsvinner du fra svarene like sikkert som fra treningsdataene. Vil du ha reell kontroll, ligger den i serverkonfigurasjonen eller i kanten foran nettstedet, ikke i en tekstfil som klienten selv velger om den vil lese.
Tallene for vekst i AI-henvist trafikk siteres overalt og kildefestes nesten aldri, så vi legger ikke til enda ett. Regnestykket er grunnen til forsiktigheten: trafikk fra AI-assistenter starter på en brøkdel av en prosent av besøkene, og en brøkdel som tredobles gir en overskrift med nesten ingen besøkende bak seg. Målingen vi kan stå for er vår egen. Over 23 timer i august 2026 hadde 72,4 % av forespørslene til dette nettstedet en ukjent user agent, mot 19,7 % fra Chrome, og navngitte søkemotorcrawlere utgjorde 3,5 % til sammen. Metode og fullstendige tall står i bot-trafikk målt på en liten nettside.
Den målingen forteller også hvorfor listen under er ordnet slik den er. Det som dominerer loggen er ikke en navngitt AI-crawler, det er klienter uten selvangitt identitet. Du kan ikke optimalisere mot et navn du ikke kjenner. Du kan optimalisere mot det alle disse klientene har til felles: de laster en nettadresse, de leser den serverleverte HTML-en, og de gir opp hvis fakta ikke lar seg plukke ut av den.
Hva som faktisk skjer mellom spørsmålet og sitatet
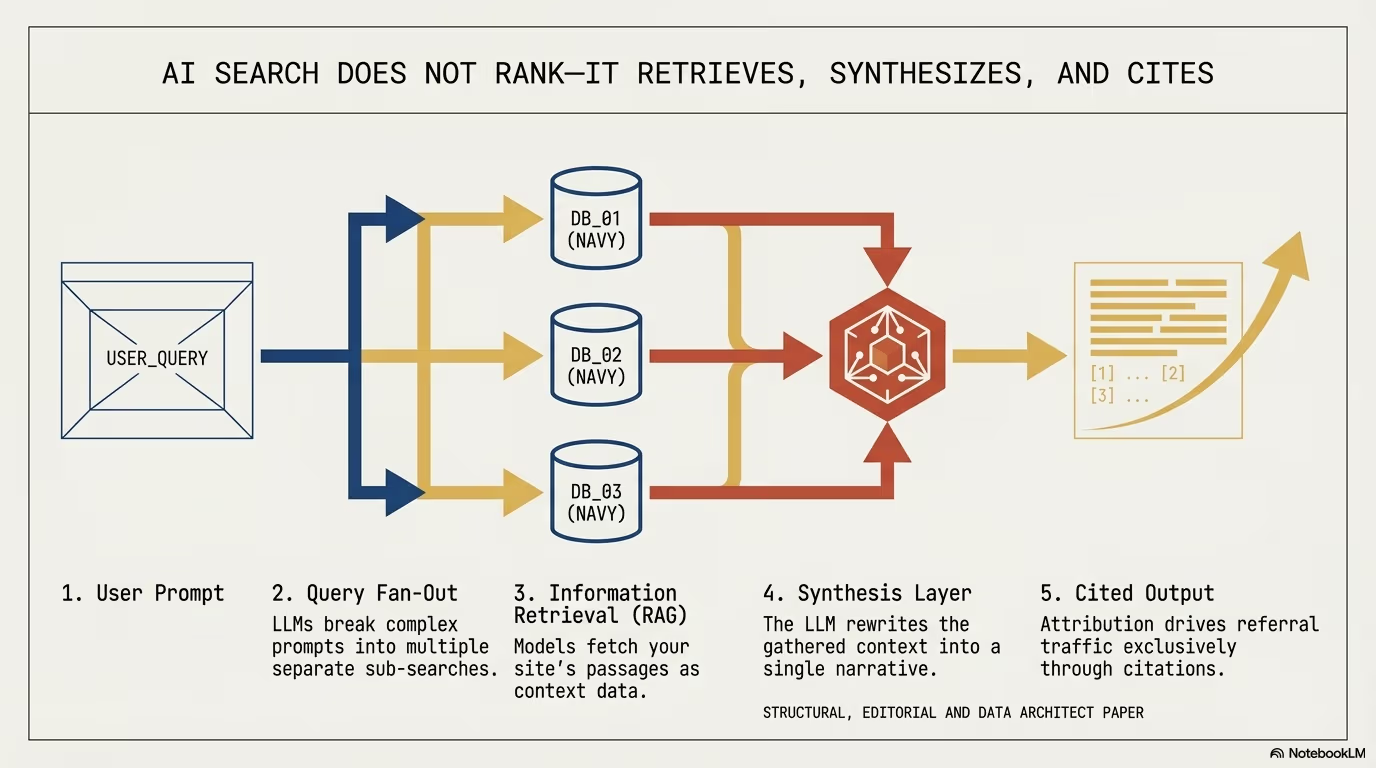
Et generativt svar bygges i fire steg, og innholdet ditt kan falle ut i hvert av dem. Steg én er omskriving av spørsmålet. Brukerens setning blir til flere interne søk, fordi et spørsmål på tjue ord som regel inneholder tre eller fire deloppgaver. Steg to er henting: hvert delsøk går mot en indeks eller mot åpent nett, og kommer tilbake med et titalls kandidatdokumenter. Steg tre er utvelgelse av passasjer, der dokumentene klippes i biter og bitene rangeres etter hvor godt de svarer på delsøket. Steg fire er generering med forankring, der modellen skriver svaret og knytter setninger til de bitene den faktisk brukte.
Sitatet ditt avgjøres i steg tre, ikke i steg to. Å bli hentet er billig og sier lite. Å bli valgt som passasje krever at en avgrenset bit av siden din, typisk noen få avsnitt, gir et fullstendig svar uten resten av artikkelen rundt seg. Det er den egenskapen alle rådene lenger nede peker mot, og det er derfor de ser ut som redaksjonelle råd selv om de er tekniske.
Klippingen er verdt å forstå konkret, for den er dummere enn folk antar. Den følger som regel dokumentets egen struktur: overskrifter, avsnitt, listepunkter, tabellrader. En bit som begynner midt i et resonnement og slutter midt i et annet blir sjelden valgt, fordi den ikke gir mening alene. Et avsnitt som åpner med subjektet, sier hva som gjelder, og navngir kilden i samme setning, er derimot en ferdig byggekloss. Dette er også grunnen til at pronomen koster deg sitater. Skriver du «den håndterer dette raskere», vet ikke biten hva «den» er når den løsrives fra avsnittet over.
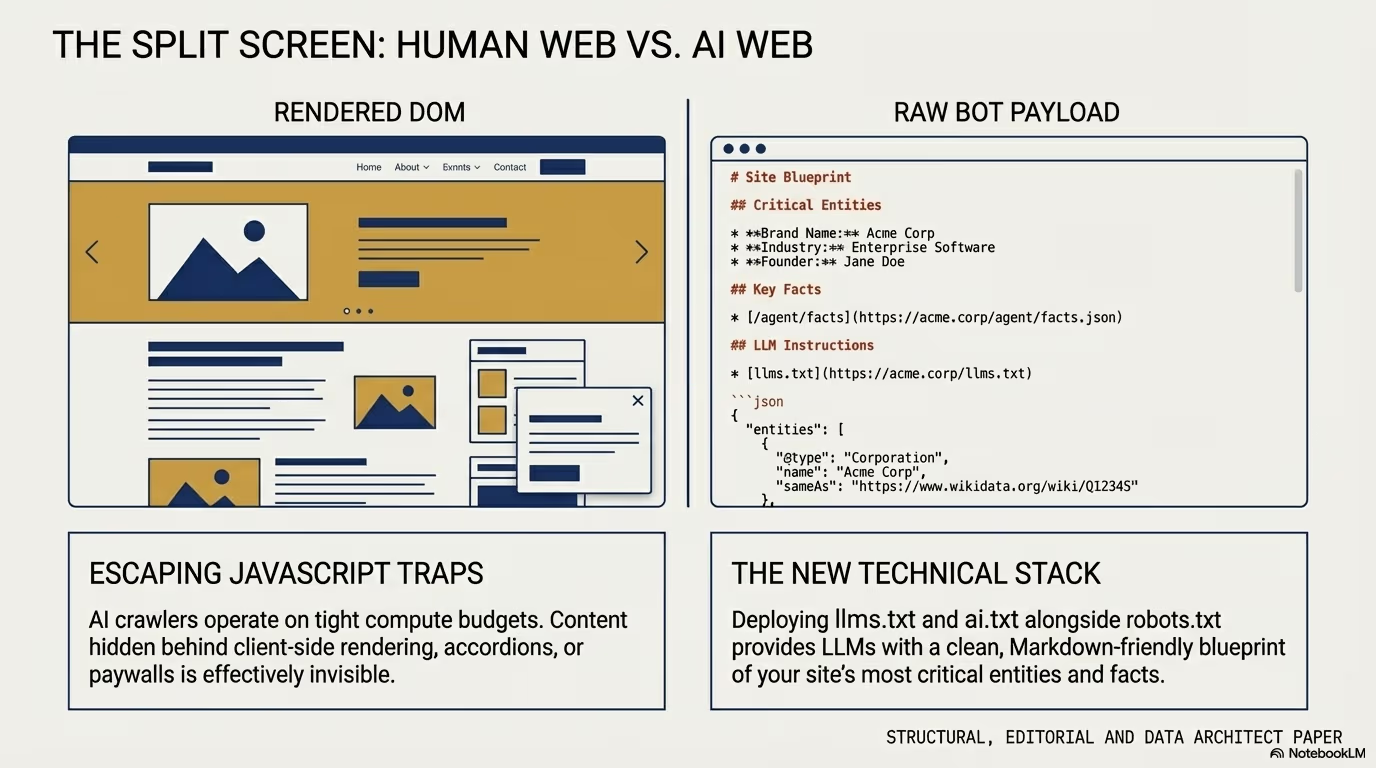
Så er det spørsmålet om hva klienten i det hele tatt får se. En agent som henter siden din under en samtale kjører som regel ingen JavaScript, har en tidsfrist på noen sekunder, og leser det serveren sendte. Er hovedinnholdet satt inn av et skript etter lasting, er siden tom for den leseren, uansett hvor fin den er i en nettleser. Er fakta låst inne i et bildeutsnitt eller en widget som hentes fra et annet domene, finnes de ikke. Testen er triviell og bør gjøres før alt annet arbeid på denne listen: hent din egen side uten nettleser og se hva som kommer tilbake.
1. “TLDR”-regelen: sitater vinnes i de første 200 ordene
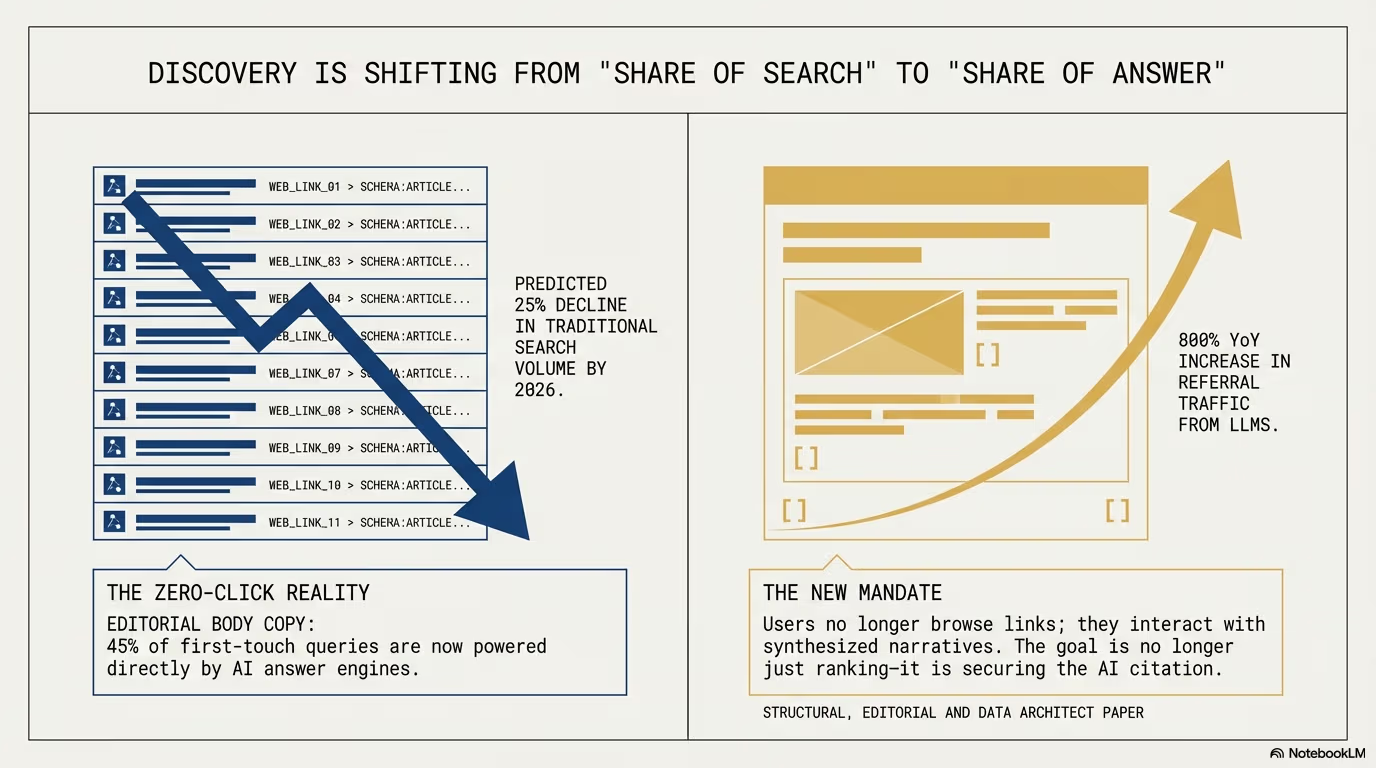
Retrieval-Augmented Generation leser ikke artikkelen din fra topp til bunn. Den plukker passasjer, og plukkingen har en posisjonsskjevhet som er målt. Kevin Indigs gjennomgang av 1,2 millioner ChatGPT-svar fant at 44,2 % av de verifiserte sitatene kommer fra de første 30 % av en side. Mekanismen bak er ikke mystisk. De første bitene av et dokument er de som oftest inneholder definisjonen, og et delsøk som spør «hva er X» treffer definisjonen, ikke utdypingen i avsnitt nitten.
Dette betyr ikke at du skal skrive kortere. Det betyr at rekkefølgen må snus. Svar på spørsmålet i åpningen, med nok kontekst til at avsnittet står alene, og bruk resten av artikkelen til bevis, forbehold og eksempler. En leser som allerede har svaret leser videre for å finne ut om hun kan stole på det, og en modell som allerede har hentet svaret henter gjerne et forbehold i tillegg hvis forbeholdet er like lett å plukke ut.
I praksis har hvert innholdsstykke bruk for det du kan kalle et siteringshode: en tett åpningsseksjon som inneholder det direkte svaret, navnet på den enheten teksten handler om, og minst ett datapunkt med kilde i samme setning som tallet. Det siste er det leddet folk hopper over. Et tall uten navngitt opphav er et tall en modell ikke kan forsvare å gjenta, og en modell som ikke kan forsvare det velger heller en kilde som kan.
En praktisk kontroll på om åpningen holder: kopier de første 200 ordene inn i et tomt dokument og les dem som om du aldri hadde sett resten. Er det noe der som bare gir mening i lys av avsnitt fem, er den bindingen en feil, ikke en stil. Er det et «dette» eller et «som nevnt over» i åpningen, er den biten ødelagt for gjenbruk.
Motargumentet mot å legge alt først er reelt og verdt å si høyt. Du gir bort poenget uten å få klikket. Det er nettopp bytteforholdet i denne eraen, og det er ikke nytt: en side som ikke blir sitert, får verken klikket eller omtalen. Valget står mellom å bli gjengitt med navn og å bli forbigått, ikke mellom å bli sitert og å beholde trafikken.
2. De fleste AI-sitater kommer fra sider utenfor organisk topp 10
Digital Applied analyserte 863 412 søk mellom oktober 2025 og februar 2026 og fant at 62 % av sitatene i AI Overviews kommer fra sider på ellevte plass eller lavere, eller fra sider helt utenfor topp 100. Overlappet mellom det som rangerer og det som siteres er altså delvis, og det spriker mer enn vanlig SEO-planlegging forutsetter.
Grunnen ligger i hva de to systemene faktisk rangerer. En søkemotor rangerer dokumenter mot et søk, og den bruker signaler om dokumentet som helhet: lenker inn, historikk, engasjement. Et retrieval-lag rangerer passasjer mot et delsøk, og en passasje har verken lenkeprofil eller klikkhistorikk. Den har bare tekst. Derfor kan en side på plass førti bidra med den ene avgrensede passasjen som svarer best på ett av fem delsøk, mens siden på førsteplass svarer bredt og upresist på alle fem.
Det er i den forskjellen mulighetsrommet ligger for små nettsteder. Du konkurrerer ikke mot et helt domene, du konkurrerer om ett delsøk om gangen, og et delsøk er smalt nok til at et presist avsnitt kan vinne det. Den samme forskjellen er grunnen til at generiske oversiktsartikler gjør det dårlig: de har ingen passasje som er best på noe spesielt.
Konsekvensen for arbeidsmåten er at du bør slutte å måle bare på sidenivå. Spør hvilke spørsmål hver seksjon i en artikkel svarer ferdig på, og om svaret står samlet i seksjonen. En artikkel med ni overskrifter som hver besvarer sitt eget spørsmål er ni kandidater i hentelaget. Den samme teksten med ni overskrifter som alle henger sammen i ett resonnement er én kandidat, og den mister mot ni.
Å kjøre SEO uten GEO i 2026 koster deg ikke rangeringen. Det koster deg de sitatene som aldri gikk gjennom en rangering i det hele tatt.
3. Autoritet er et nett, ikke en side
Yext analyserte 6,8 millioner AI-sitater og fant at 86 % av sitatene kommer fra nettsteder med fem eller flere sammenkoblede sider om et spesifikt emne. Vi har ikke funnet noen publisert studie som koker verdien av en pilar-klynge-arkitektur ned til én multiplikator, så vi oppgir ingen. Datasettet bærer en retning, ikke en koeffisient: terskelen på fem sammenkoblede sider er der siteringsandelen samler seg.
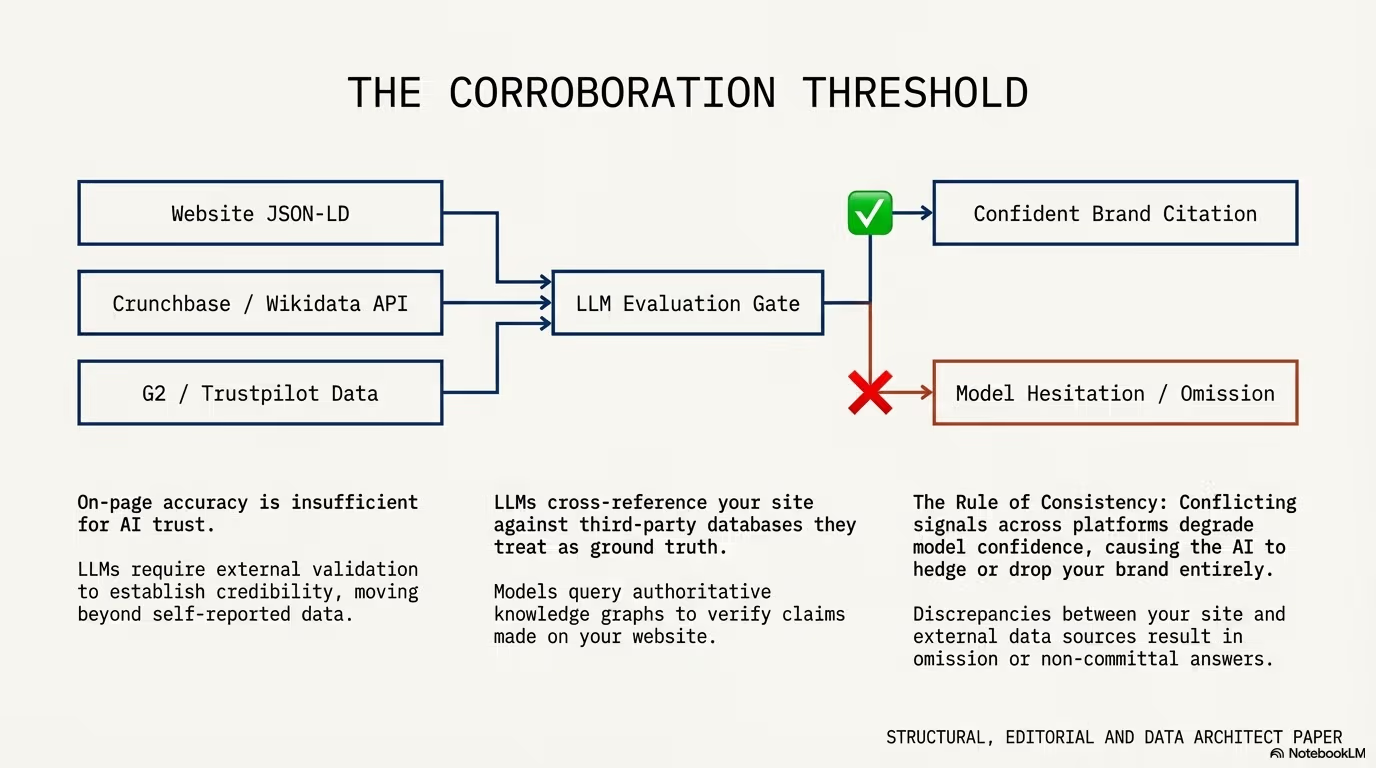
Mekanismen under er verifisering. En modell som setter sammen et svar må avgjøre om kilden den er i ferd med å navngi faktisk kan emnet, eller bare traff på én frase. En enkelt side gir den ett datapunkt og ingen måte å etterprøve det på. En pilarside med åtte undersider, hver om sin del av emnet og hver med lenke tilbake, gir den en graf den kan gå gjennom før den setter merkenavnet ditt inn i et svar den ikke kan trekke tilbake. Uten den grafen blir siden foreldreløs: indeksert i teknisk forstand, uetterprøvbar i den forstanden som teller.
Legg merke til hva som binder nettet sammen i det datasettet. Det er toveis interne lenker med beskrivende ankertekst, ikke felles menykategori. En meny er navigasjon for mennesker og sier ingenting om hva sidene har med hverandre å gjøre. En lenke midt i et avsnitt, med ankertekst som navngir emnet den peker på, er en påstand om en relasjon, og det er relasjoner en graf kan gås gjennom.
Konkret for et nettsted som dekker WordPress-sikkerhet: pilarsiden tar hele emnet, og klyngesidene tar brannmurkonfigurasjon, oppdagelse av skadevare, herding av innlogging, sertifikathåndtering, sikkerhetsgjennomgang av utvidelser og hendelsesrespons. Hver av dem lenker til pilaren og til minst to søsken. Det som skiller dette fra en vanlig kategoriside er at hver underside svarer ferdig på sitt eget spørsmål, slik at den kan siteres alene, samtidig som den kan etterprøves gjennom naboene.
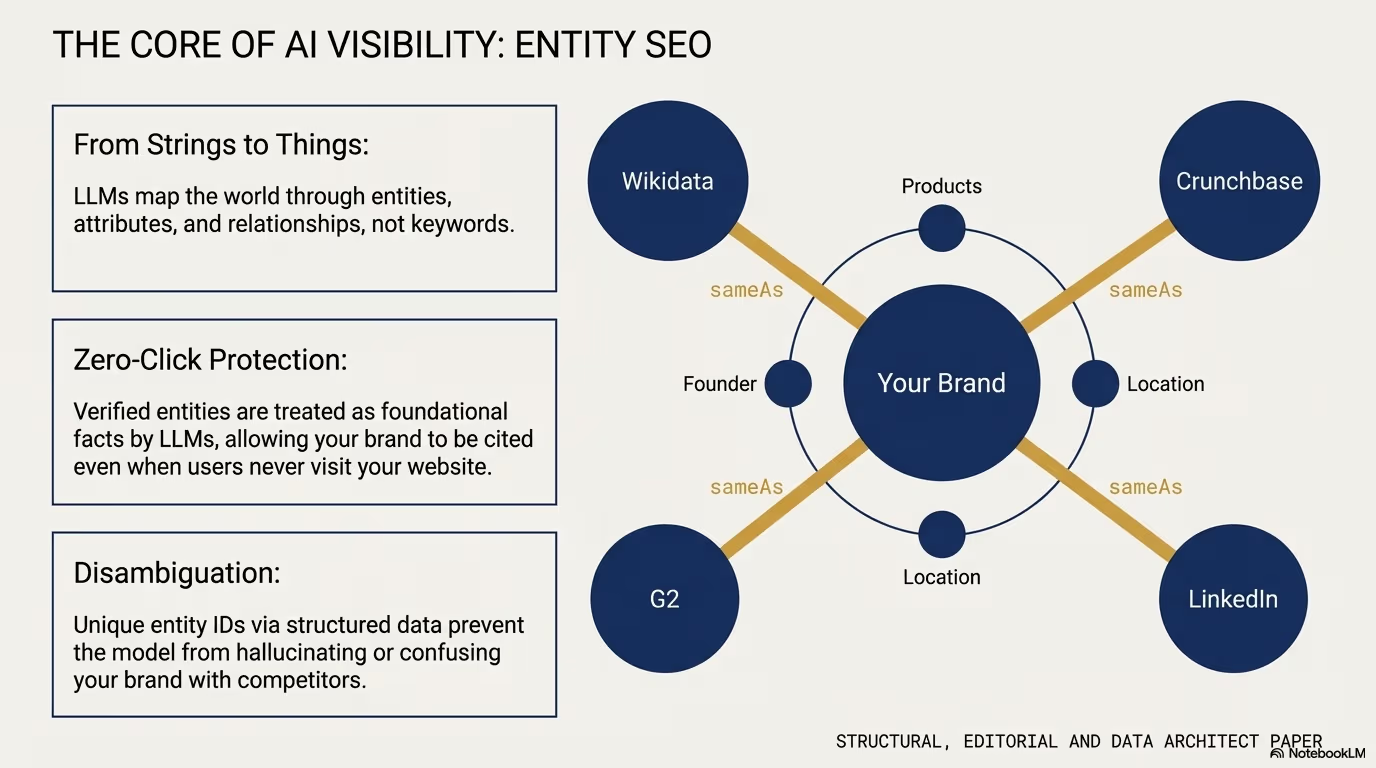
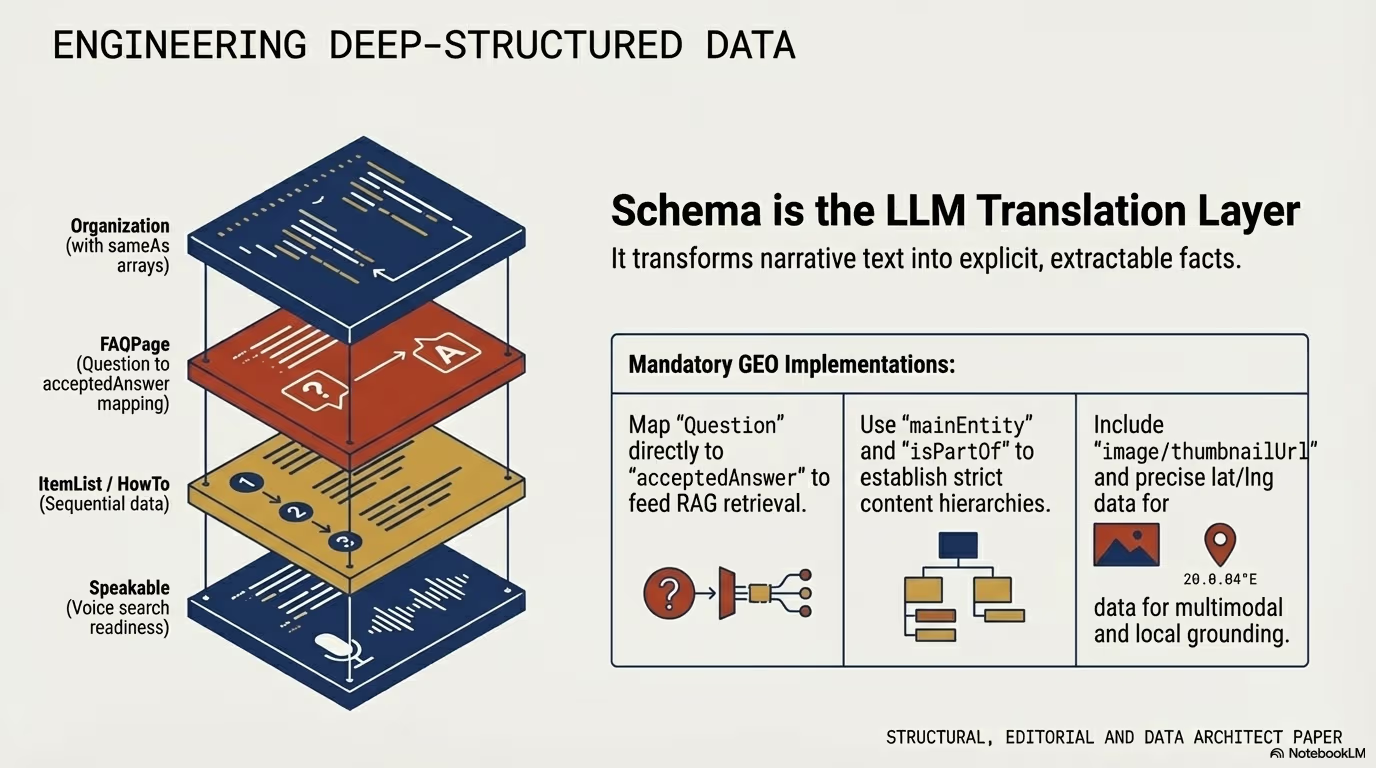
Entitetsleddet er den delen som oftest mangler. Hvert nøkkelbegrep på nettstedet bør knyttes til den enheten det faktisk er, med en sameAs-peker til en kjent oppføring, slik at «WooCommerce» i teksten din og «WooCommerce» i modellens verdensbilde er det samme objektet og ikke to strenger som ligner. Uten den koblingen må modellen gjette ut fra kontekst, og den gjetter dårligst på akkurat de fagbegrepene du vil bli sitert på.
En rimelig innvending er at fem sider er en vilkårlig terskel, og den er det. Poenget er ikke tallet, det er at én side ikke kan bekrefte seg selv. Alt som gir en ekstern kontroll av samme påstand teller i samme retning.
4. 90-dagers ferskhetsklippet
Innhold oppdatert innen 90 dager oppnår omtrent dobbelt så høy siteringsrate sammenlignet med eldre materiale, ifølge Seer Interactives gjennomgang av innholdsferskhet. Innhold som ikke har vært rørt på over atten måneder blir i stor grad forbigått av generative motorer, uavhengig av historisk autoritet.
Grunnen er risikohåndtering, ikke smak. En modell som svarer på et spørsmål med en påstand, eier påstanden overfor brukeren. Alderen på kilden er den billigste indikatoren den har på om påstanden fortsatt stemmer, særlig i emner der versjonsnumre, priser og regelverk endrer seg. Når to kilder sier omtrent det samme, og den ene er fra i fjor, er valget enkelt og det koster modellen ingenting.
Det er verdt å si hva ferskhet ikke er. En endret dato i frontmatter er ikke en oppdatering. Systemene sammenligner innholdet over tid, og en side der bare datoen beveger seg er et signal om det motsatte av vedlikehold. En reell oppdatering bytter ut et tall mot et nyere tall fra samme kilde, legger til en seksjon om noe som ikke fantes sist, fjerner et råd som ikke lenger gjelder, og sier hva som ble endret.
Konsekvensen for økonomien i innholdsarbeid er den delen folk liker minst. Vedlikehold av et arkiv koster nå like mye oppmerksomhet som produksjon av nytt, og et arkiv som er for stort til å vedlikeholdes er en forpliktelse, ikke en eiendel. Praktisk håndtering er å sortere sidene i tre bøtter: de som må være ferske fordi de inneholder tall, de som tåler å ligge fordi de forklarer noe stabilt, og de som bør slås sammen eller avpubliseres fordi ingen av delene gjelder. Bøtte én får en fast runde i kvartalet, bøtte to en gang i året, bøtte tre en beslutning.
5. AI-systemer foretrekker legitimitetslaget
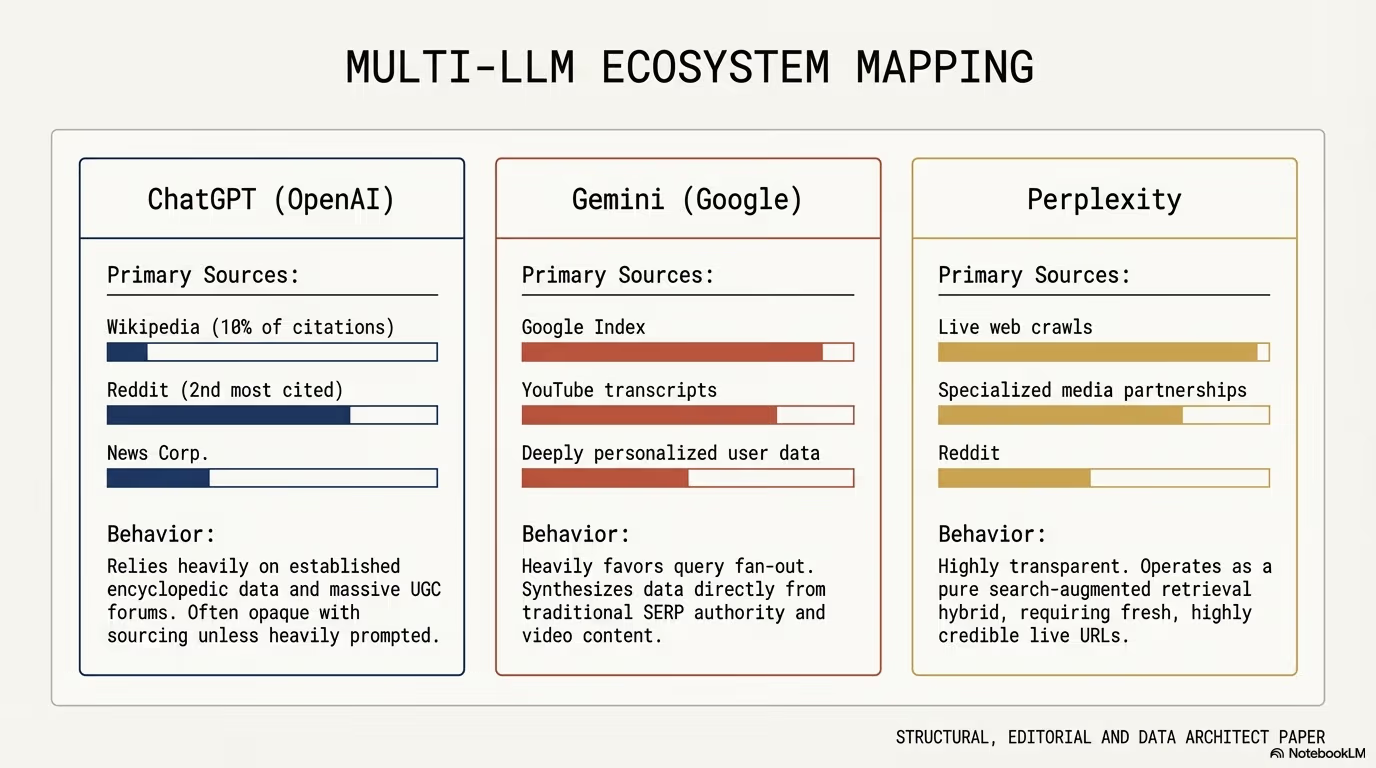
Profounds analyse av siteringsmønstre fant at Wikipedia står for 7,8 % av alle ChatGPT-sitater, med Reddit som nest mest siterte kilde et godt stykke bak. En enkelt plattform står altså for mer av siteringsvolumet enn de fleste bedriftsnettsteder til sammen.
Det er fristende å lese dette som at modellene liker bestemte merkevarer. Mekanismen er kjedeligere. Begge plattformene har to egenskaper som passer et hentelag usedvanlig godt: innholdet er strukturert på en forutsigbar måte, og påstandene bærer sin egen uenighet. En Wikipedia-artikkel har fotnoter på setningsnivå. En Reddit-tråd har flere svar som motsier hverandre, med stemmetall som sier hvilket de fleste mente holdt. Begge deler gir en modell noe å veie. Din egen produktside gir den én stemme som er enig med seg selv.
Det er dette som gjør omtale på tredjepart til et strukturelt krav og ikke en merkevareaktivitet. Når navnet ditt opptrer i en tekst du ikke kontrollerer, blir påstanden om deg etterprøvbar på akkurat den måten et hentelag kan bruke. Det er også grunnen til at en omtale i en fagdiskusjon, der noen sier hva som gikk galt og hva som gikk bra, er verdt mer enn en pressemelding som blir gjengitt ordrett tolv steder. Tolv identiske tekster er ett datapunkt, ikke tolv.
Praktisk betyr det at arbeidet ligger der fagfolk faktisk skriver: svar i tekniske fora, dokumentasjon og feilrapporter i åpne prosjekter, foredrag som blir referert, bidrag til prosjektene du bygger på. Det er tregt, og det er ikke noe du kan kjøpe ferdig i en kampanje. Det tåler til gjengjeld en modelloppdatering, noe et kjøpt lenkenettverk ikke gjør.
6. /llms.txt og grensen for hva en fil kan gjøre
/llms.txt er en foreslått standard: en Markdown-fil på domeneroten som beskriver hva nettstedet kan, lister det viktigste innholdet med korte sammendrag, og peker videre til rene tekstversjoner av sidene. Der robots.txt handler om hva en klient har lov til å hente, handler /llms.txt om hva den bør lese først når den har dårlig tid.
Problemet filen adresserer er reelt. En agent som åpner forsiden din i en samtale bruker kontekstvinduet sitt på navigasjon, bunntekst, samtykkebanner og skriptrester før den kommer til innholdet. En kuratert fil kutter den kostnaden. Men det er verdt å være tydelig på statusen: dette er et forslag, ikke en vedtatt standard, og ingen stor leverandør har forpliktet seg til å lese den. Verdien i dag ligger mest i disiplinen den tvinger fram. Klarer du ikke å skrive ned hva nettstedet ditt kan på én side, i klartekst, med lenker til den siden som beviser hver påstand, er det et innholdsproblem og ikke et filproblem.
Rekkefølgen på arbeidet bør derfor være motsatt av den folk velger. Først sørger du for at den serverleverte HTML-en inneholder svaret uten at et skript må kjøre. Så sørger du for at hver seksjon står alene. Så merker du opp entitetene. Filen kommer sist, som en snarvei for klienter som velger å bruke den, ikke som erstatning for noe av det foregående. En /llms.txt foran et nettsted som rendrer innholdet i nettleseren er en innholdsfortegnelse til en tom bok.
Det samme forbeholdet gjelder nabofilene som dukker opp i samme diskusjon, som egne AI-sitemaps og JSON-strømmer med innhold. De koster lite å lage og skader ingenting. De erstatter bare ikke arbeidet med selve siden, og et nettsted som har rekkefølgen feil får som regel ikke noe igjen for dem.
7. Intensjon over presisjon: kraften i query fan-out
Tradisjonelle skrevne søk er forkortede fragmenter på i snitt 4 ord, mens AI-spørringer i snitt er på 23 ord, ifølge SOCi Visibility Index. Forskjellen er ikke bare lengde. Et fire ords søk er et stikkord brukeren tror vil treffe et dokument. Et tjuetre ords spørsmål er en situasjonsbeskrivelse med begrensninger i.
En bruker skriver ikke lenger «beste WordPress sikkerhetsutvidelser 2026». Hun forteller: «Jeg driver en WooCommerce-butikk på delt hosting og er bekymret for sikkerheten. Hvilke utvidelser bør jeg installere for å beskytte mot de vanligste angrepene uten å gjøre nettstedet tregere?» Det spørsmålet inneholder minst fire deloppgaver: hvilke angrep som er vanligst mot WooCommerce, hva delt hosting begrenser, hvilke utvidelser som dekker de angrepene, og hva de koster i ytelse.
Fan-out betyr at motoren deler spørsmålet i nettopp slike deler og henter mot hver av dem for seg. Konsekvensen for teksten din er konkret. Innhold som svarer bredt på hele spørsmålet vinner ingen av delene. Innhold som har ett avsnitt om ytelseskostnaden ved sikkerhetsutvidelser på delt hosting vinner den ene delen det avsnittet handler om, og blir sitert i et svar som ellers er bygget av fire andre kilder.
Det er derfor forbehold og begrensninger er blitt et konkurransefortrinn i stedet for en svakhet. Setningen «dette gjelder ikke hvis du kjører på delt hosting med begrenset PHP-minne» er akkurat den typen passasje som vinner et delsøk, fordi den er den eneste teksten som tar opp nettopp den begrensningen. En tekst som bare anbefaler, uten å si når anbefalingen ikke gjelder, har ingenting å tilby i den delen av fan-outen.
Nøkkelordtetthet er i denne sammenhengen ikke bare ubrukelig, den er aktivt skadelig. Gjentatte fraser gjør at flere passasjer i samme dokument ligner på hverandre, og et hentelag som allerede har valgt én av dem har ingen grunn til å velge den neste. Variasjon i formulering gir deg flere ulike biter i stedet for tolv kopier av den samme.
Slik sjekker du det på ditt eget nettsted
Alt over er etterprøvbart på ditt eget domene, uten noe verktøy du må betale for. Rekkefølgen under går fra det som oftest er ødelagt til det som sjelden er det.
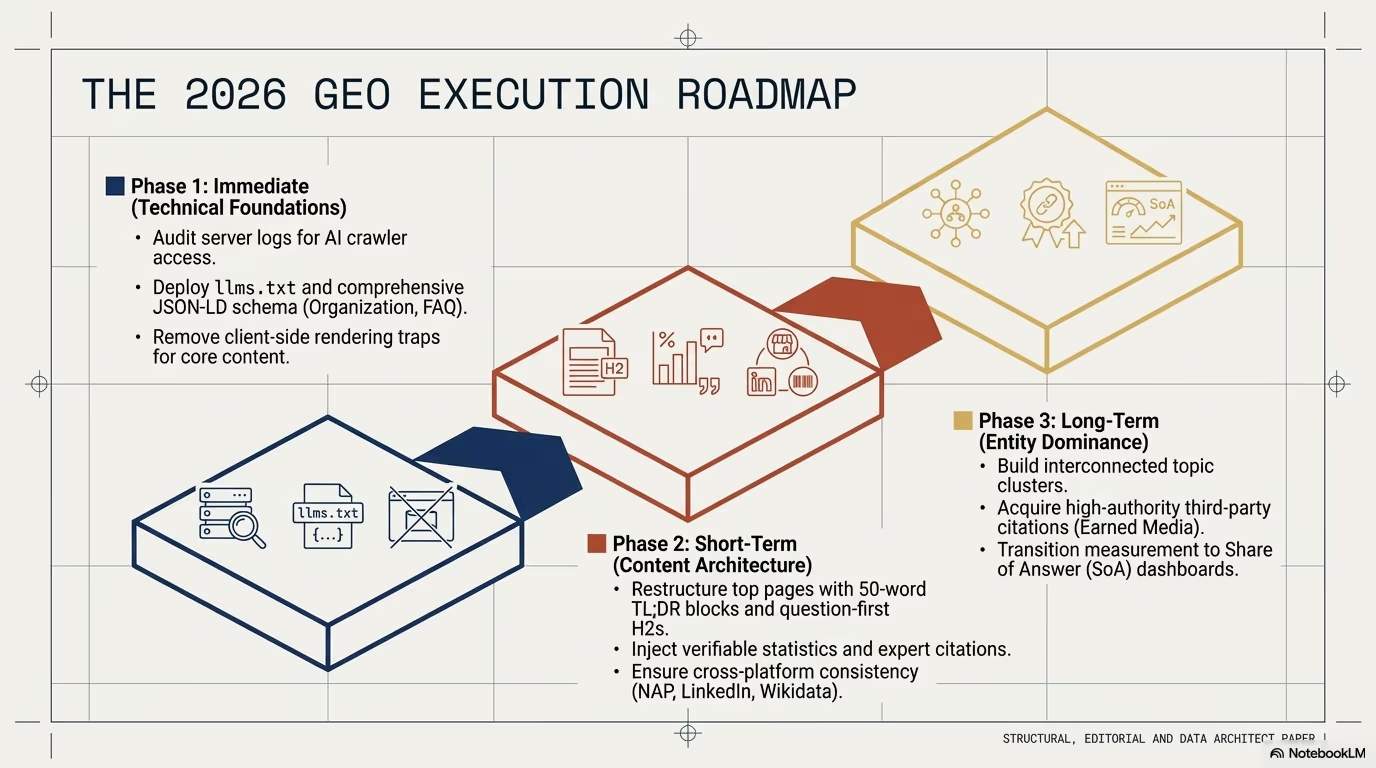
Begynn med hva klienten får. Hent din egen side med curl og se på det som kommer tilbake, ikke på det nettleseren viser. Finner du ikke hovedteksten i svaret, er den ikke der for en agent heller, og ingenting annet på listen spiller noen rolle før det er rettet. Gjør samme henting med en user agent som utgir seg for å være en AI-klient, og sammenlign. Får du en annen respons, er det som regel et sikkerhetslag eller en kantregel som blokkerer, og det skjer oftere enn folk tror uten at noen har bestemt det.
Gå så til loggene. Grupper forespørslene på user agent over et døgn og se på fordelingen. Vår egen måling er beskrevet i lenken lenger oppe, og det interessante der var ikke de navngitte crawlerne, det var andelen som ikke oppga noe navn. Se på hvilke nettadresser de gruppene henter, om de kommer tilbake, og om de får 200 eller noe annet. En klient som får 403 forteller deg at du har tatt en beslutning du kanskje ikke visste at du hadde tatt.
Så tester du passasjene. Ta en artikkel, kopier ut én seksjon om gangen, og les hver av dem uten resten. Noter hvilket spørsmål seksjonen svarer ferdig på. Seksjoner du ikke får notert et spørsmål til er kandidater til omskriving, ikke til sletting: de mangler som regel bare subjektet og kilden i åpningssetningen.
Til slutt sjekker du oppmerkingen mot det siden faktisk sier. Strukturerte data som lover en FAQ siden ikke har, eller en forfatter som ikke står noe sted i teksten, er verre enn ingen oppmerking, fordi avviket er lett å oppdage og gir en grunn til å behandle hele domenet med forsiktighet. Sjekk også at datoene i oppmerkingen stemmer med reelle endringer, siden det er det ene ferskhetssignalet som er trivielt å motbevise.
Bli svaret
Synlighet i 2026 avgjøres ikke av plassen i en liste, men av om en avgrenset bit av teksten din kan stå alene i et svar noen andre har skrevet. Det er en mindre romantisk beskrivelse enn de fleste liker, og den er lettere å jobbe etter, fordi hvert punkt under er noe du kan se etter i en fil.
- Skriv seksjoner som står alene: hver seksjon svarer ferdig på ett spørsmål, med subjekt og kilde i åpningssetningen, uten pronomen som peker ut av biten.
- Lever svaret i HTML-en: hovedinnholdet skal finnes i responsen fra serveren, ikke settes inn av et skript etter lasting.
- Behandle SEO og GEO som to lag: rangering handler om dokumenter mot søk, sitering handler om passasjer mot delsøk, og det andre laget vinnes ikke av det første.
- Bygg nettet, ikke siden: fem eller flere sammenkoblede sider per emne, bundet med toveis lenker og beskrivende ankertekst, slik at en påstand kan etterprøves av naboene.
- Vedlikehold arkivet i bøtter: kvartalsvis for sider med tall, årlig for sider som forklarer noe stabilt, en beslutning om sammenslåing for resten.
- Tjen omtale du ikke kontrollerer: der fagfolk skriver om arbeidet, ikke der pressemeldinger gjengis ordrett.
- Skriv forbeholdene ut: setningen som sier når rådet ikke gjelder er ofte den ene passasjen ingen andre har.
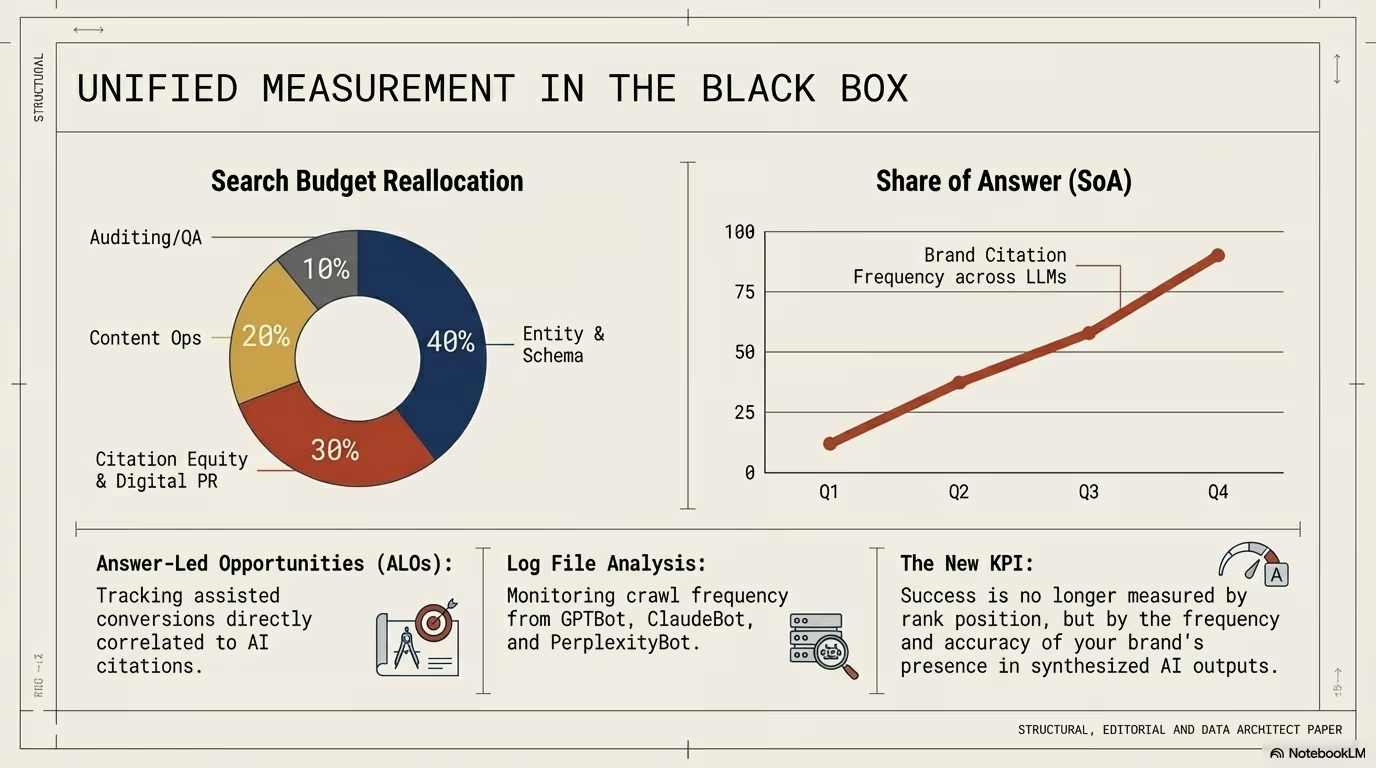
Målingen er den uløste delen, og det er ærligere å si det enn å foreslå en metrikk som later som den er ferdig. Hvis en bruker får svaret ditt fra en assistent uten å besøke nettstedet, finnes hendelsen i ingen av de vanlige rapportene. Det du kan måle i dag er hentingen: hvem som ber om sidene dine, hvor ofte, hvilke, og med hvilket svar. Det er en svakere måling enn en siteringsrapport, men den kommer fra din egen server og kan ikke selges deg som et estimat.
Slutten på klikket er ikke slutten på synlighet. Den flytter arbeidet fra å lokke et menneske inn på siden til å skrive setninger et system kan gjenta med navnet ditt på. Det er mindre glamorøst, det er mer redigering enn markedsføring, og det er etterprøvbart på en måte rangering aldri var.