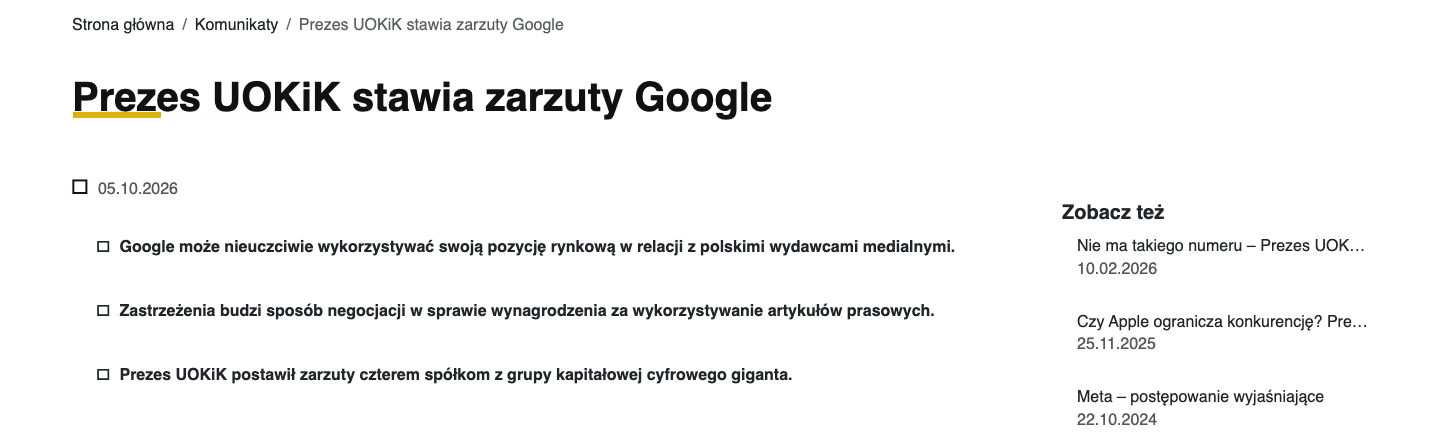
- oktober 2026 reiste lederen av det polske konkurranse- og forbrukertilsynet UOKiK anklager mot fire selskaper i Google-konsernet. Saken gjelder måten Google har forhandlet med presseutgivere om vederlag for bruk av artiklene deres, og den omfatter Google-søket, Google News og Google Discover. Saken handler om det polske markedet og polske presseutgivere, men innstillingene som beskrives nedenfor, fungerer likt for alle nettsteder. For en utgiver som driver et nettsted på WordPress, endrer ingenting seg i dag når det gjelder trafikk eller indeksering. Det som endres, er rammen rundt forhandlingene om vederlag. Samtidig er det verdt å gå gjennom noen innstillinger utgiveren styrer selv, før noen begynner å endre dem på grunn av overskriftene.
Hva UOKiK anklager Google for
Anklagen gjelder data utgiverne aldri fikk. Tilsynets melding beskriver det slik:
“Ut fra informasjonen tilsynet har, la Google, da selskapet tilbød utgiverne vederlag, ikke frem de lovpålagte dataene som gjør det mulig å vurdere de tilbudte satsene.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5. oktober 2026, egen oversettelse
Tilsynet lister opp hva som manglet: opplysninger om hvordan Google bruker pressepublikasjoner og hvilke inntekter selskapet har av dem, en forklaring av parameterne i beregningen og dokumenter som gjør det mulig å etterprøve forutsetningene. UOKiK kaller resultatet informasjonsasymmetri: utgiveren kan ikke vurdere om tilbudet lønner seg, og kan heller ikke legge frem et eget forslag basert på data.
Den rettslige anklagen er mistanke om misbruk av dominerende stilling. Å ha en slik stilling er ikke forbudt. Det som er forbudt, er å bruke den til å presse vilkår på avtaleparter som er avhengige av plattformen. Meldingen understreker at utgiverne er avhengige av Google som kanal til leserne og ikke har full oversikt over verdien av innholdet som brukes.
Anklagene gjelder fire selskaper:
| Selskap | Rolle ifølge UOKiKs melding |
|---|---|
| Alphabet Inc | morselskapet i Google-konsernet |
| Google LLC | annonsetjenester, drev tidligere Google-søket i EØS |
| Google Ireland Limited | driver og forvalter i dag Google-søket i EØS |
| Google Poland | salg av annonseplass på internett |
UOKiKs leder Tomasz Chróstny vurderer følgene av de manglende dataene slik i en uttalelse som følger meldingen:
“Mangelen på disse dataene førte til en situasjon der forhandlingene ble skinnforhandlinger og tok sikte på at den dominerende aktøren skulle diktere vilkårene.”
Tomasz Chróstny, leder av UOKiK, UOKiKs melding, 5. oktober 2026, egen oversettelse
Hvilket grunnlag utgivere har for å kreve vederlag fra Google
Grunnlaget er den polske endringen av opphavsrettsloven fra 2024, som gjennomførte direktiv (EU) 2019/790, kjent som DSM-direktivet. Presseutgiveres rettighet følger av artikkel 15. Ifølge UOKiKs melding gir reglene nettjenester adgang til å bruke pressepublikasjoner mot vederlag, og plattformen har plikt til å gi utgiveren opplysningene som trengs for å fastsette beløpet. Det er nettopp denne opplysningsplikten tilsynet mener ikke ble oppfylt.
Artikkel 15 har flere grenser en utgiver med et WordPress-nettsted bør kjenne, fordi de avgjør om du i det hele tatt er part i denne samtalen:
- retten omfatter ikke hyperlenker eller bruk av enkeltord eller svært korte utdrag av en publikasjon,
- den omfatter ikke privat eller ikke-kommersiell bruk hos enkeltbrukere,
- den utløper to år etter publisering, regnet fra 1. januar året etter publiseringen,
- forfatterne av tekstene skal få en rimelig andel av inntektene utgiveren får fra denne retten.
Et eget spørsmål er definisjonen. Artikkel 2 nr. 4 i direktivet regner som pressepublikasjon en samling som hovedsakelig består av litterære verk av journalistisk art, utgitt som en enkeltutgave av en periodisk eller jevnlig oppdatert publikasjon under én tittel, med formål å informere allmennheten, på initiativ og under redaksjonelt ansvar av en tjenesteyter. Vitenskapelige tidsskrifter er uttrykkelig unntatt. I praksis passer et jevnlig drevet lokalt nyhetsnettsted med redaksjon lettere inn i definisjonen enn en bedriftsblogg som publiserer salgsartikler. Grensene i en konkret sak vurderes av en jurist, ikke av den som konfigurerer WordPress.
Hvis forhandlingene med plattformen ikke fører til enighet, har reglene en mekanisme for å avgjøre saken. UOKiK presiserer at tilsynet selv ikke har den rollen:
“Det er verdt å merke seg at lederen av UOKiK ikke er part i forhandlingene eller i tvisten mellom Google og presseutgiverne.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5. oktober 2026, egen oversettelse
Ifølge samme melding vurderer tilsynet ikke om den tilbudte satsen er rimelig. Blir partene ikke enige, kan lederen av det polske kommunikasjonstilsynet UKE fastsette vederlaget. UOKiK-saken gjelder altså måten forhandlingene føres på, ikke beløpet.
Gjelder UOKiKs anklager AI Overviews
Nei, og det går fram av meldingen selv. Innledningen beskriver fenomenet bredere: leserne stopper ved utdrag i søkeresultatene eller ved en oppsummering av artikler laget av kunstig intelligens, og klikker ikke på lenken. Men tilsynet avgrenser saken snevert. Googles tjenester basert på kunstig intelligens undersøkes av EU-kommisjonen, som i desember 2025 åpnet en formell sak om Google bruker utgiveres innhold i slike tjenester uten rimelig vederlag og uten mulighet til å reservere seg. UOKiK skriver:
“Gjenstanden for Kommisjonens sak er samtidig en annen enn i konkurransesaken UOKiKs leder har innledet.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5. oktober 2026, egen oversettelse
Den polske saken gjelder bruk av utgiveres innhold i Googles søkeresultater og i Google News og Discover. De to sakene er uavhengige av hverandre, og ifølge meldingen ble dette avtalt med Kommisjonen før selve saken ble åpnet.
Hva anklagene endrer for en utgiver på WordPress i dag
Teknisk sett ingenting. Anklagene er et trinn i en konkurransesak, ikke et vedtak. En bot på opptil 10 prosent av omsetningen er den øvre grensen loven setter, og meldingen presiserer at ansvaret til hvert enkelt selskap først skal vurderes i løpet av saken. Rangering, indeksering, Discover og trafikk fra søk fungerer i morgen som i går.
Det som endres, er rammen rundt samtalene om penger. Ifølge meldingen har Google ikke inngått avtaler med de fleste polske presseutgivere, og tilsynet reagerer på måten selskapet forhandlet med organisasjonene som representerer utgiverne. En utgiver som er medlem av en slik organisasjon, har nå tilsynets offentlige standpunkt på at et krav om data om bruk av publikasjoner og om inntekter er et krav som følger av loven. En utgiver som ikke er med i noen organisasjon, bør i det minste vite hvem som forhandler på vegne av den, og om noen gjør det.
Den andre endringen er risikoen for forhastede beslutninger. Etter en profilert sak mot Google er det fristende å “stenge ute Google” i robots.txt eller legge på noindex i stor skala. Utgiveren mister da trafikk og får ikke et eneste argument i forhandlingene. Vederlaget etter artikkel 15 gjelder bruk av publikasjoner i søk, News og Discover. En side som er fjernet fra søket, er ikke lenger en del av denne samtalen.
Hva utgiveren styrer selv: Content-Signal, Google-Extended og Search Console
En utgiver har i dag tre separate mekanismer for å påvirke hva Google gjør med innholdet, og en fjerde som slår av alt på én gang.
| Mekanisme | Hvor den settes | Hva den påvirker | Hva den ikke påvirker |
|---|---|---|---|
| Kontrollen for Search generative AI | Search Console, Innstillinger | AI Overviews, AI Mode, generative funksjoner i Discover | rangering, AI-trening |
| Google-Extended | robots.txt | trening og forankring av Gemini-modeller utenfor søket | synlighet i Google Search, rangering |
| Content-Signal | robots.txt | erklæring om samtykke til search, ai-input, ai-train | blokkerer ingenting teknisk |
| noindex | meta robots eller HTTP-header | fjerner adressen helt fra Google Search | ingenting blir igjen i søket |
Kontrollen for Search generative AI i Search Console
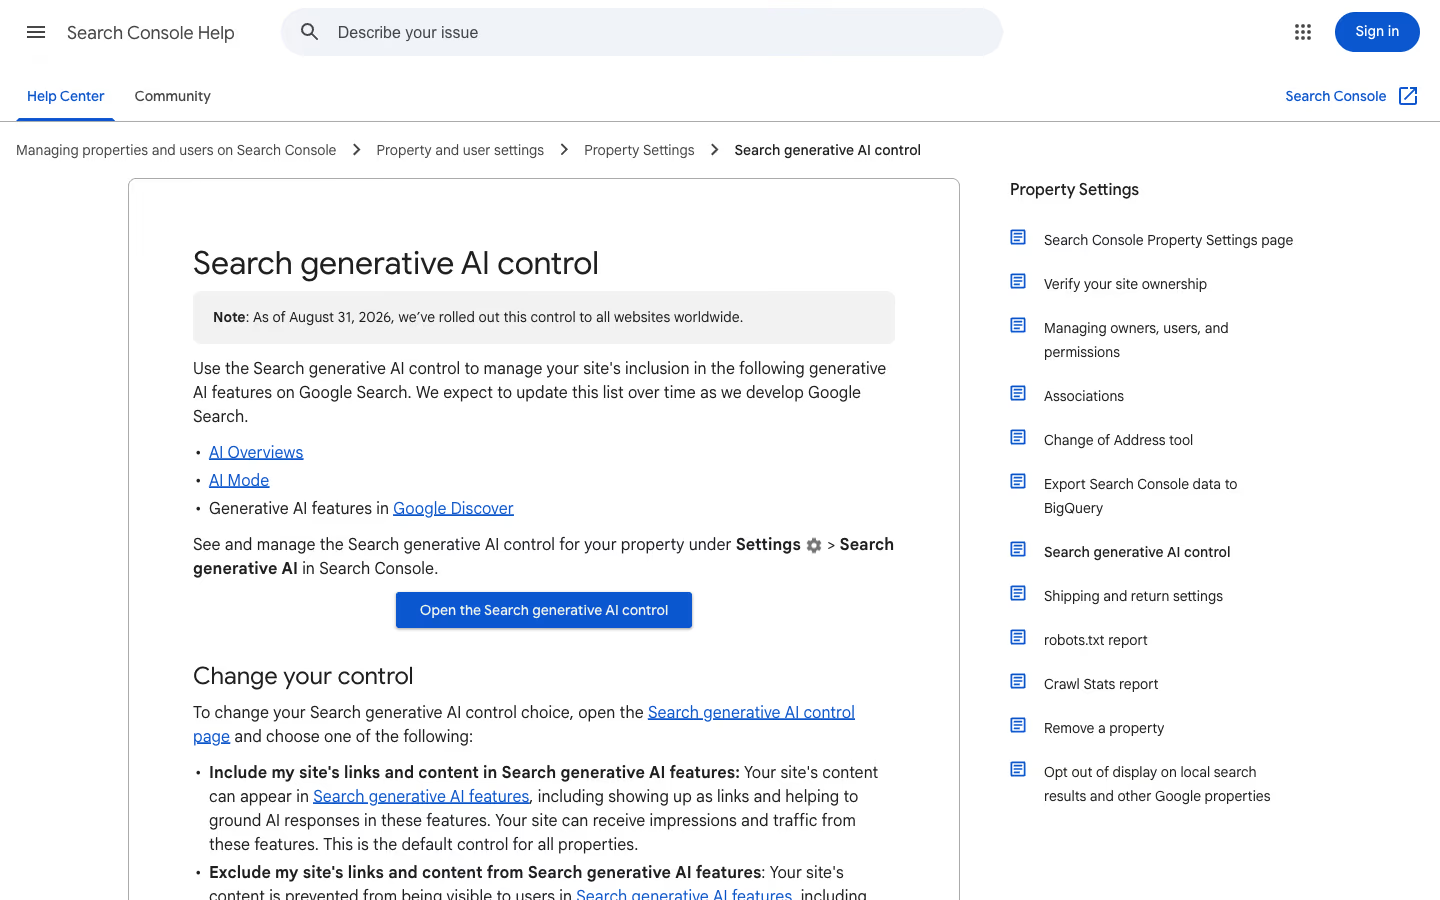
Dette er den nyeste av innstillingene. Google beskriver den i hjelpesidene for Search Console og oppgir når den ble tilgjengelig:
“Fra 31. august 2026 har vi rullet ut denne kontrollen til alle nettsteder i hele verden.”
Google, Search generative AI control, Search Console-hjelp, egen oversettelse
Kontrollen omfatter AI Overviews, AI Mode og generative funksjoner i Google Discover. Som standard er nettstedet inkludert. Etter at det er ekskludert, vises ikke innholdet i disse funksjonene, verken som lenke eller som kilde for forankring av svar. Google opplyser at endringen vanligvis slår inn etter noen dager, i noen tilfeller senere på grunn av hurtigbuffer. Innstillingen arves: en eiendom med URL-prefiks, for eksempel en egen del av nettstedet, arver den fra den overordnede eiendommen, med mindre eieren setter den særskilt for denne eiendommen.
Den viktigste begrensningen står i den samme dokumentasjonen:
“Denne kontrollen påvirker ikke AI-trening. For å begrense treningen av modellene som brukes til å generere svar i generative AI-funksjoner i Søk, bruker du Google-Extended.”
Google, Search generative AI control, Search Console-hjelp, egen oversettelse
Sjekk resultatrapporten for generative AI-funksjoner i Search Console før du endrer innstillingen. Uten tall fra før endringen kan du ikke vurdere hvor mye trafikk beslutningen kostet.
Google-Extended i robots.txt
Google-Extended er et token i robots.txt, ikke en egen robot. Ifølge Googles dokumentasjon om crawlere har det ingen egen User-Agent-streng i HTTP-forespørsler, så du ser det ikke i serverloggene. Gjennomsøkingen gjøres av Googles vanlige roboter, og tokenet fungerer som en innstilling. Det gjelder trening av fremtidige Gemini-modeller og forankring av svar i Gemini-appene og i Vertex AI. Google opplyser at det ikke påvirker om nettstedet vises i Google Search, og at det ikke er et rangeringssignal.
På WordPress er robots.txt enten en fysisk fil i rotkatalogen eller en fil som WordPress genererer via funksjonen do_robots(). Den fysiske filen har forrang, så sjekk hvilken av dem serveren faktisk leverer før du legger inn noe i panelet til en SEO-utvidelse. For en generert fil holder det med et filter:
add_filter( 'robots_txt', function ( $output, $public ) {
    if ( $public ) {
        $output .= "\nUser-agent: Google-Extended\nDisallow: /\n";
    }
    return $output;
}, 10, 2 );Content-Signal og artikkel 4 i direktivet
Vår egen robots.txt bruker linjen Content-Signal: search=yes, ai-input=yes, ai-train=no, og en kommentar over den sier at begrensninger uttrykt med disse signalene er et uttrykkelig rettighetsforbehold etter artikkel 4 i direktiv 2019/790. Artikkel 4 er unntaket for tekst- og datautvinning, som rettighetshaveren kan reservere seg mot i maskinlesbar form. Det er en annen bestemmelse enn artikkel 15, som utgivernes tvist med Google bygger på. Den første gjelder om det er lov å kopiere innhold til analyse og trening. Den andre gjelder om og hvor mye en plattform betaler for å bruke publikasjoner i tjenestene sine. En linje i robots.txt er verken en avtale eller et krav om vederlag.
Content-Signal har også en teknisk begrensning som vi har beskrevet med vår egen fil som eksempel: en linje som bare står i stjernegruppen, når ikke fram til crawlere som har egne seksjoner i filen. I vår fil står signalet nå separat i gruppene for de enkelte crawlerne, også i gruppen for Google-Extended. Vi har ikke målt hvilke operatører som respekterer det, og vi påstår det ikke.
noindex som eneste fulle utmelding av Google-søket
Googles dokumentasjon sier at du må bruke noindex for å hindre at innhold vises i Google Search i det hele tatt. I WordPress settes meta-taggen robots fra versjon 5.7 med filteret wp_robots, og de fleste SEO-utvidelser gjør det per innlegg eller per innholdstype. noindex fjerner siden fra resultatene, fra News og fra Discover, altså fra nettopp de tjenestene utgiveren kan kreve vederlag for, så i forhandlinger gir det ingenting. Det gir mening for taggarkiver, søkesider og teknisk innhold, ikke for redaksjonelle artikler.
Slik går du gjennom innstillingene etter UOKiKs anklager
Gjennomgang av et nyhetsnettsted på WordPress i fem trinn:
- Hent
robots.txtfra produksjon medcurlog sjekk om serveren leverer en fysisk eller en generert fil. Hurtigbufferutvidelser og CDN kan levere en gammel versjon. - List opp User-agent-gruppene og kontroller at erklæringene du bryr deg om, står i hver gruppe de skal gjelde for.
- Noter tallene i resultatrapporten for generative AI-funksjoner i Search Console. Uten et utgangspunkt kan du ikke vurdere effekten av en endring.
- Bestem kontrollen for Search generative AI separat for domeneeiendommen og for deler av nettstedet som er satt opp som egne eiendommer.
- Sjekk hvor noindex står. En mal som ved en feil legger noindex på nyhetskategorier, koster mer enn noen beslutning om AI.
Hvis du også publiserer med tanke på generative svar, har vi beskrevet sammenhengen i guiden om GEO. Å ekskludere nettstedet fra generative funksjoner og samtidig optimalisere for siteringer i de samme funksjonene er to motstridende mål, så velg ett av dem bevisst.
Hva som skjer videre i UOKiKs sak mot Google
Saken fortsetter, og meldingen oppgir ingen frist for vedtak. Tre spor er verdt å følge. Det første er UOKiK-saken selv og et eventuelt vedtak med bot. Det andre er forhandlingene mellom utgiverne og Google og den mulige rollen til lederen av UKE hvis det ikke blir enighet. Det tredje er EU-kommisjonens sak om AI-tjenester, som kan berøre AI Overviews direkte, noe den polske saken ikke gjør.
Meldingen plasserer saken i en større sammenheng: UOKiK avslutter en konkurransesak mot Apple og fører en forundersøkelse mot Meta om endringen i hvordan lenker til pressepublikasjoner vises. De tekniske innstillingene på nettstedet endrer utgiveren selv, i løpet av en time, og effekten kan måles i Search Console. Retten til vederlag følger av loven og avgjøres i forhandlinger, hos lederen av UKE eller indirekte gjennom UOKiK-saken.