Salon, klinika albo firma remontowa dostaje zapytanie przez formularz na stronie w piątek o 21:00. Właściciel czyta je w poniedziałek, a klient od soboty rozmawia już z kimś innym. Stąd pomysł, żeby zapytania obsługiwał automat: odpowiedź w minutę, przydział do właściwej osoby, nic nie ginie w skrzynce.
Większość poradników zaczyna od modelu językowego, który odpisuje klientowi. Ja zaczynam od drugiej strony, bo na moim własnym formularzu na wppoland.com najwięcej pracy wykonują warstwy przed modelem i po nim. Poniżej pięć warstw w kolejności, w jakiej przechodzi przez nie zapytanie, z tym, co działa u mnie, i z tym, gdzie AI faktycznie się przydaje.
Jak odfiltrować spam z formularza WordPress, zanim zobaczy go AI
Automat, który odpowiada na spam, robi dwie szkody naraz: płacisz za każde wywołanie modelu i wysyłasz odpowiedzi na adresy, które tylko na to czekają. Filtr musi więc stać przed modelem. U mnie ma trzy warstwy.
Pierwsza to niewidoczne pole pułapka. Człowiek go nie widzi, a prosty bot wypełnia każde pole. Wypełnione pole oznacza bota.
Druga to Cloudflare Turnstile weryfikowany po stronie serwera. Token z przeglądarki trafia do mojej funkcji, a dopiero ona pyta Cloudflare, czy jest ważny. Nigdy z przeglądarki: sekret byłby publiczny, a wynik łatwy do podrobienia. Odrzucam zapytania bez tokenu albo z tokenem nieważnym. Gdy sama weryfikacja Cloudflare nie odpowiada, zapytanie przechodzi, bo awaria cudzej usługi nie może zjadać prawdziwych klientów.
Trzecia to sygnatury treści, których nie ma w żadnym prawdziwym zapytaniu: link HTML wpisany ręcznie w opis projektu, znaczniki BBCode, link do Telegrama w polu ze stroną internetową. Do listy dopisałem jeszcze nazwę narzędzia do spamowania formularzy, bo 29 lipca 2026 roku seria zapytań kasynowych przyszła z adresu, który zawierał nazwę tego narzędzia.
Sam Turnstile nie zawsze wystarcza. Autor bloga elszczepano opisał w sierpniu 2026 roku, że Cloudflare oznaczał jako prawdopodobnego bota mniej więcej połowę ruchu na jego WordPressie, a w komentarzach i tak lądowały setki wpisów ze spamem (When SIMPLER means BETTER?). Pomogło dopiero niestandardowe pole pułapka podpięte w functions.php: zgłoszenie przechodzi tylko wtedy, gdy to pole jest obecne i puste. Według autora od listopada 2025 roku żaden komentarz nie trafił do spamu. Jego wniosek pasuje do formularzy: boty spamerów są generyczne, więc nawet prosty mechanizm, którego się nie spodziewają, odsiewa większość z nich.
Spamowi odpowiadam tak samo jak prawdziwemu zapytaniu: komunikat o przyjęciu i numer. Nadawca, który dowie się, że został odrzucony, zmienia adres i próbuje dalej.
Jakie pola formularza oszczędzają pracę modelowi AI
Część zapytań da się przydzielić bez żadnego modelu. Mój formularz ma trzy pola zamkniętej listy: typ projektu (nowa strona, naprawa, opieka, migracja, inne), termin i przedział budżetu. Każde z nich da się przydzielić zwykłym warunkiem w kodzie, na przykład naprawę sklepu do kolejki pilnej, a migrację do osoby, która zajmuje się migracjami.
Jeden szczegół kosztował mnie trochę czasu. Formularz wysyła przedział budżetu jako kod, na przykład band-3, a przedziały nie są w tej samej walucie we wszystkich językach (polska wersja w złotówkach, pozostałe w euro). Mail z samym kodem był nieczytelny, więc funkcja dopisuje do kodu etykietę z kwotą w języku formularza. Ta sama lista etykiet istnieje w dwóch miejscach, dlatego test sprawdza przy każdym buildzie, czy obie są identyczne.
Dopiero opis projektu w wolnym tekście wymaga czegoś więcej niż warunku.
Jak przydzielić zapytanie z formularza modelem decyzyjnym
Do przydziału nie potrzebujesz modelu, który pisze elaboraty. Wystarczy model decyzyjny: dostaje tekst i listę opcji, zwraca jedną z nich. Na przykład: “któremu zespołowi przekazać to zapytanie: sklep, strona firmowa, integracja, inne” albo “czy to zapytanie jest pilne: tak, nie”.
Na rynku są co najmniej dwa takie modele. Jev, którego używam w bramce jakości tekstów w tym repozytorium, i Clef, który Cloudflare opublikowało na początku października 2026 roku w Workers AI i na Hugging Face, na licencji Apache 2.0, zgodny z API Jeva. Według pomiarów samego Cloudflare mediana opóźnienia to 209,3 ms dla Clef, 38,8 ms dla mniejszego Clef-flash i 524,1 ms dla Jev (Cloudflare). To benchmarki producenta, więc niezależne porównania mogą wyjść inaczej.
Dla polskiej firmy ciekawy jest trzeci model, basal Remka Kinasa: działa po polsku i po angielsku, ma otwarte wagi na licencji Apache 2.0 i uruchamia się lokalnie, także na Macu z Apple Silicon albo przez Ollama, więc treść zapytań nie wychodzi poza firmę. Odpowiada na te same typy pytań co Jev, przez endpoint o tej samej nazwie. Od wersji 2.2 ma narzędzie basal-calibrate, które dopasowuje pewność modelu do kilkuset oznaczonych przykładów z własnego procesu, a pytania z ustawionym dopuszczalnym błędem oznaczają niepewne przypadki jako odłożone, czyli do decyzji człowieka. Autor mierzy jakość własnym benchmarkiem Werdykt, więc przed wdrożeniem sprawdź model na swoich zapytaniach.
Koszt na moich liczbach: ocena 300 akapitów modelem Jev kosztowała jeden cent, a przepuszczenie przez niego całego korpusu, około 134 000 akapitów, kosztowałoby 3,32 USD i trwało 100 minut. Przy kilkudziesięciu zapytaniach miesięcznie koszt modelu decyzyjnego jest pomijalny. Droższy jest czas na ustawienie i sprawdzanie, czy przydział się zgadza.
Kiedy model decyzyjny powinien oddać zapytanie człowiekowi
Warstwy opisane wyżej układają się w hierarchię, którą Parth Parikh w eseju z października 2026 roku To Make, or to Buy: The Economics of Decision Models porównuje do pamięci komputera: reguły załatwiają to, co potrafią, model decyzyjny bierze kolejną część, model językowy trudniejsze przypadki, a człowiek resztę. Każdy poziom odpowiada tylko tam, gdzie jest pewny, a resztę przekazuje do następnego poziomu. W moim formularzu regułami są pola z listą wyboru, model decyzyjny przydziela wolny opis projektu, model językowy pisze szkic odpowiedzi, a człowiek go zatwierdza.
Zostaje pytanie, jak pewny musi być model decyzyjny. Parikh sięga po regułę Chowa (datuje ją na 1970 rok): odpowiadaj, gdy szansa pomyłki, czyli 1 minus najwyższe prawdopodobieństwo, jest mniejsza niż koszt przekazania dalej. Ten koszt, liczony w jednostkach jednej błędnej odpowiedzi, to odsetek błędów następnego poziomu plus jego cena podzielona przez koszt pomyłki.
Przykład hipotetyczny, w umownych jednostkach kosztu. Zapytanie przydzielone złej osobie kosztuje 50 jednostek (opóźnienie, stracony dzień). Człowiek, który je przeczyta i przydzieli, kosztuje 5 jednostek i myli się w 2% przypadków. Próg wynosi 0,02 + 5/50 = 0,12, więc model przydziela sam tylko wtedy, gdy jego najlepsza opcja ma prawdopodobieństwo powyżej 0,88. Sprawdzenie na 100 zapytaniach, przy których model jest pewny na 70%: jeśli przydzieli wszystkie, 30 trafi pod zły adres, czyli 30 × 50 = 1500 jednostek. Jeśli wszystkie przydzieli człowiek: 100 × 5 + 2 × 50 = 600 jednostek. Taniej wychodzi człowiek. Przy pewności 95% taniej wychodzi model: 5 × 50 = 250 jednostek wobec tych samych 600.
Gdy źle przydzielone zapytanie kosztuje 500 jednostek, na przykład reklamacja z terminem, próg spada do 0,02 + 5/500 = 0,03 i model potrzebuje pewności powyżej 97%. Cena pracy człowieka wtedy prawie nie zmienia wyniku, decyduje to, jak często on sam się myli. Jeśli twój model pozwala ustawić dopuszczalny błąd, jak basal, ten rachunek daje wartość do wpisania zamiast strzału.
Parikh dodaje dwa zastrzeżenia. Model potrafi mylić się z dużą pewnością, więc małą losową próbkę, na przykład 1% pewnych decyzji, i tak wysyłaj do następnego poziomu; przy okazji zobaczysz prawdziwy odsetek błędów. Poza tym nie każda pomyłka kosztuje tyle samo: sprawa prawna wysłana do złego zespołu kosztuje więcej niż pomyłka między dwiema kolejkami technicznymi, więc koszt błędu powinien zależeć od kategorii.
Jakie są ograniczenia i błędy klasyfikatorów typu Jev w praktyce
Aktualizacja, . Niezależne testy i pomiary inżynieryjne modeli klasyfikacyjnych (przeanalizowane w materiale JEV bez hype’u: klasyfikatory AI kontra klasyczne LLM-y) weryfikują hasła marketingowe o braku halucynacji czy działaniu w trybie intuicyjnego Systemu 1. W praktyce architektura modeli typu Jev bazuje na znanym od lat mechanizmie wnioskowania zero-shot NLI (Natural Language Inference) na modelach koderowych (architektury zbliżone do BERT-a). Zamiast generować odpowiedź token po tokenie, model ocenia prawdopodobieństwo przypisania tekstu do listy etykiet w jednym przebiegu sieci. To daje szybkość od 20 do 200 razy większą niż w modelach czatowych, ale wiąże się z kilkoma twardymi ograniczeniami:
- Wymuszony błąd przy zapytaniach spoza listy: Model klasyfikacyjny nie dopisuje zmyślonych słów, ale gdy zapytanie nie pasuje do żadnej ze zdefiniowanych opcji, Jev rzadko wybiera brak dopasowania. W niezależnych testach poprawny wybór kategorii brakującej nastąpił tylko w 7% prób. W pozostałych 93% przypadków klasyfikator przypisuje zapytanie do błędnej etykiety ze sztywnej listy.
- Wrażliwość na kolejność podanych etykiet: Zamiana kolejności opcji na liście klasyfikacyjnej obniża dokładność dopasowania z 91% do 76,5%. Aby utrzymać powtarzalność routingu na produkcji, konieczne jest losowanie kolejności opcji w kilku zapytaniach i uśrednianie prawdopodobieństw (ensemble averaging) albo stałe sortowanie alfabetyczne z kontrolą marginesu pewności.
- Brak rozumowania numerycznego i budżetowego: Gdy klient wpisuje budżet w treści wiadomości (na przykład 15 000 zł), klasyfikator NLI gubi się w ponad 90% przypadków i nie potrafi powiązać liczby z przedziałem kwotowym. Wartości liczbowe, terminy i dane strukturalne musisz zawsze wyciągać deterministycznym wyrażeniem regularnym lub walidacją schematu Zod przed przekazaniem tekstu do modelu.
- Podatność na wstrzykiwanie instrukcji (prompt injection): Ponieważ treść formularza trafia bezpośrednio do kontekstu enkodera, złośliwy ciąg znaków wpisany przez użytkownika może zaburzyć wagi uwagi i wymusić fałszywy priorytet zgłoszenia.
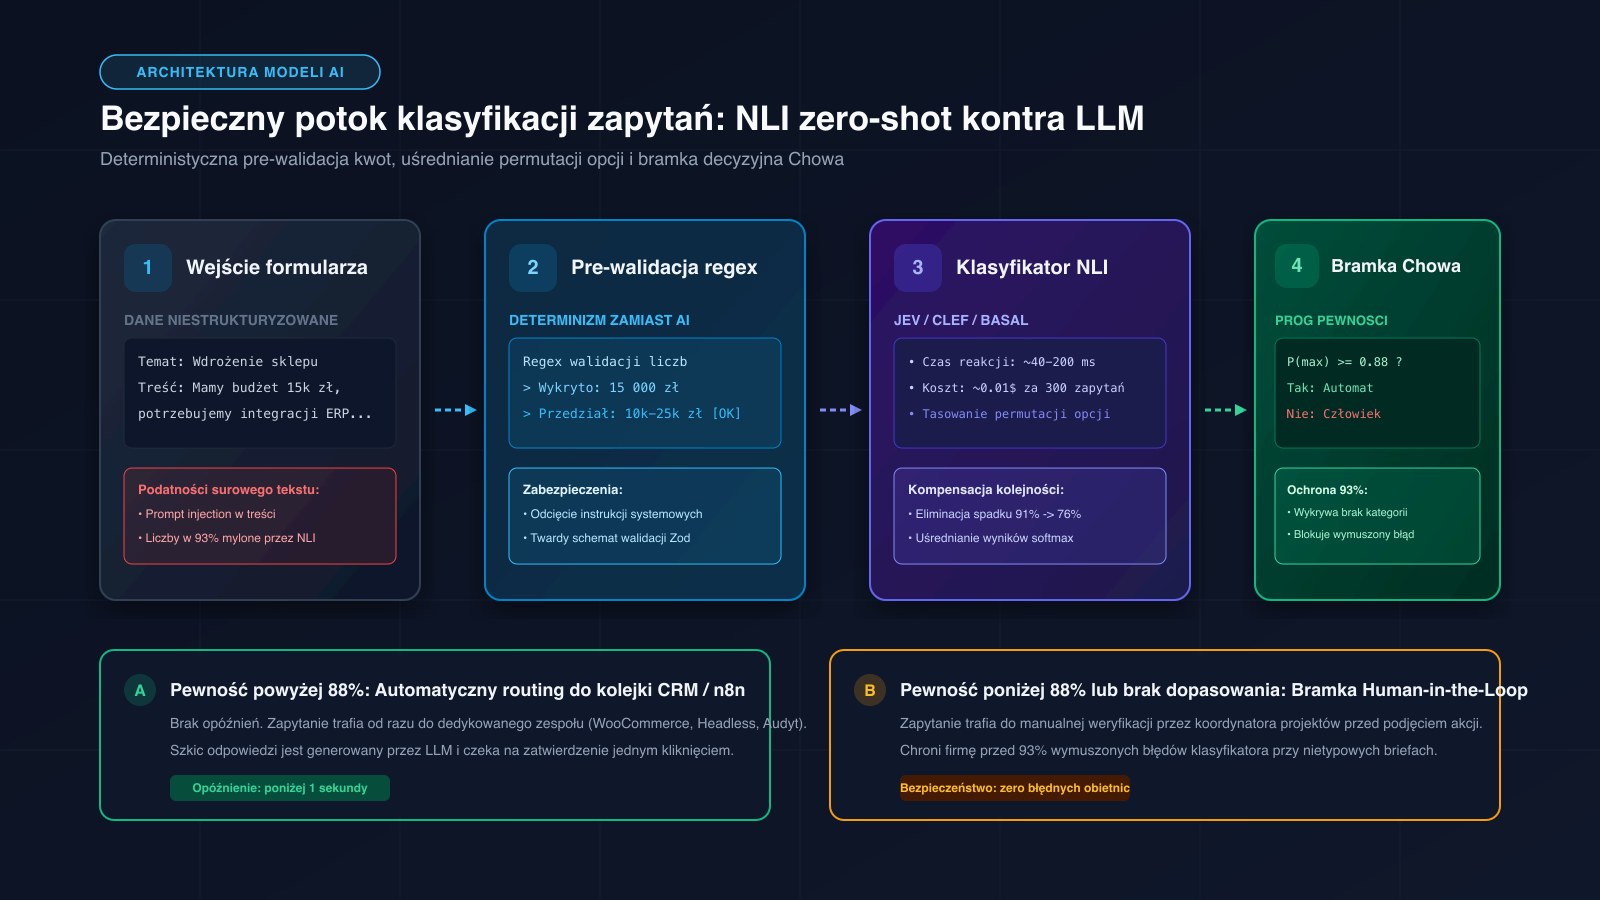 Schemat bezpiecznego potoku decyzyjnego: deterministyczna pre-walidacja kwot wyrażeniem regularnym, odporność na kolejność opcji i weryfikacja progu Chowa przed przekazaniem do człowieka.
Czy AI może samo odpisywać klientom z formularza
Technicznie tak. W praktyce pierwsza odpowiedź na zapytanie to zwykle termin, zakres albo cena, czyli obietnica w imieniu firmy. Model, który napisze klientowi “zrobimy to w tydzień” przy projekcie na dwa miesiące, kosztuje więcej, niż oszczędza.
Tę samą zasadę opisuje Anthropic w przewodniku po agentach dla handlu: żadne wywołanie narzędzia przez model nie przesuwa pieniędzy ani nie zmienia niczego w firmie, a najgroźniejsze, co model może zrobić, to zaproponować zmianę, którą zatwierdza człowiek albo reguła (A guide to the anatomy of effective commerce agents). Zamówienia, płatności, zwroty i zmiany cen przechodzą tam przez to samo zatwierdzenie, którego firma używa dla takich zmian bez AI. Odpowiedź z wyceną dla klienta to ten sam rodzaj zmiany.
Bezpieczniejszy układ: model przygotowuje szkic, a wysyła człowiek. Szkic dostaje kontekst z pól formularza i opis usługi, której dotyczy zapytanie. Zatwierdzenie zajmuje minutę, a klient dostaje odpowiedź tego samego dnia zamiast w poniedziałek. Bez udziału człowieka powinno wychodzić tylko potwierdzenie przyjęcia z numerem referencyjnym. U mnie ten numer, w formacie z datą i losowym sufiksem, klient widzi od razu po wysłaniu formularza.
Jak połączyć formularz WordPress z n8n i Claude
Są dwie drogi. Pierwsza to n8n: formularz wysyła dane do węzła Webhook, który uruchamia przepływ. Węzeł ma osobny adres testowy i produkcyjny, więc przepływ da się sprawdzić bez ruszania działającego formularza (dokumentacja n8n). Dalej w tym samym przepływie n8n ma gotowy węzeł Anthropic do szkicu odpowiedzi w Claude i węzły do poczty, Slacka albo CRM.
Druga droga to własny kod. Mój formularz obsługuje funkcja na Cloudflare Pages: walidacja pól, filtr spamu, Turnstile, wysyłka i telemetria w jednym pliku. Mniej elementów do utrzymania i pełna kontrola nad tym, co trafia do logów, ale każda zmiana wymaga programisty.
Wybór zależy od tego, kto będzie zmieniał reguły. Jeśli właściciel chce sam dopisać nową kategorię zapytań, n8n wygrywa. Jeśli reguły zmieniają się raz na kwartał, własny kod jest prostszy w utrzymaniu.
Co zrobić, gdy wysyłka maila z formularza zawiedzie
Automat, który przyjął zapytanie i go nie dostarczył, jest gorszy niż brak automatu, bo klient myśli, że wiadomość doszła. U mnie zapytanie idzie najpierw przez Resend, a gdy ten zawiedzie, przez Web3Forms. Przy drugim dostawcy wyszedł szczegół, który łatwo przeoczyć: Web3Forms odpowiada kodem 200 także wtedy, gdy odrzuca wiadomość, a informacja o odrzuceniu siedzi w treści odpowiedzi. Sprawdzanie samego kodu HTTP uznałoby taką wysyłkę za udaną.
Druga lekcja dotyczy błędów. Każda ścieżka niepowodzenia zwraca własny kod, nie tylko komunikat. Dwa z nich mają ten sam status HTTP 422 i zupełnie inne znaczenie: niepoprawnie wypełniony formularz i wygasły token antyspamowy. Dopóki przeglądarka zbierała wszystkie błędy pod jedną nazwą, błąd z wygasłym tokenem był w telemetrii niewidoczny.
Ile kosztuje automatyczna obsługa zapytań i kiedy się opłaca
Koszt modeli przy małej skali jest pomijalny, liczy się czas wdrożenia i utrzymania. Opłaca się, gdy zapytania przychodzą poza godzinami pracy, gdy trafiają do kilku osób albo gdy część z nich ginie dziś w skrzynce. Przy kilku zapytaniach miesięcznie szybciej będzie ustawić powiadomienie na telefon.
Własne liczby policzysz w kalkulatorze opłacalności automatyzacji. Wdrożenie takiego przepływu na stronie WordPress robię w ramach automatyzacji procesów biznesowych i integracji AI z WordPressem: najpierw filtr i pola, potem przydział, na końcu szkic odpowiedzi, każdy krok sprawdzony na prawdziwych zapytaniach, zanim przejdzie do następnego.