Każdy z ośmiu defektów opisanych niżej przeszedł przez skrypt albo agenta, który zakończył pracę komunikatem o sukcesie. Żaden nie rzucił wyjątku. Wszystkie trafiły na produkcję wielojęzycznej strony, którą budujemy i utrzymujemy od lat, i wszystkie znaleźliśmy dopiero wtedy, gdy zaczęliśmy porównywać wynik z czymś innym niż raport samego narzędzia.
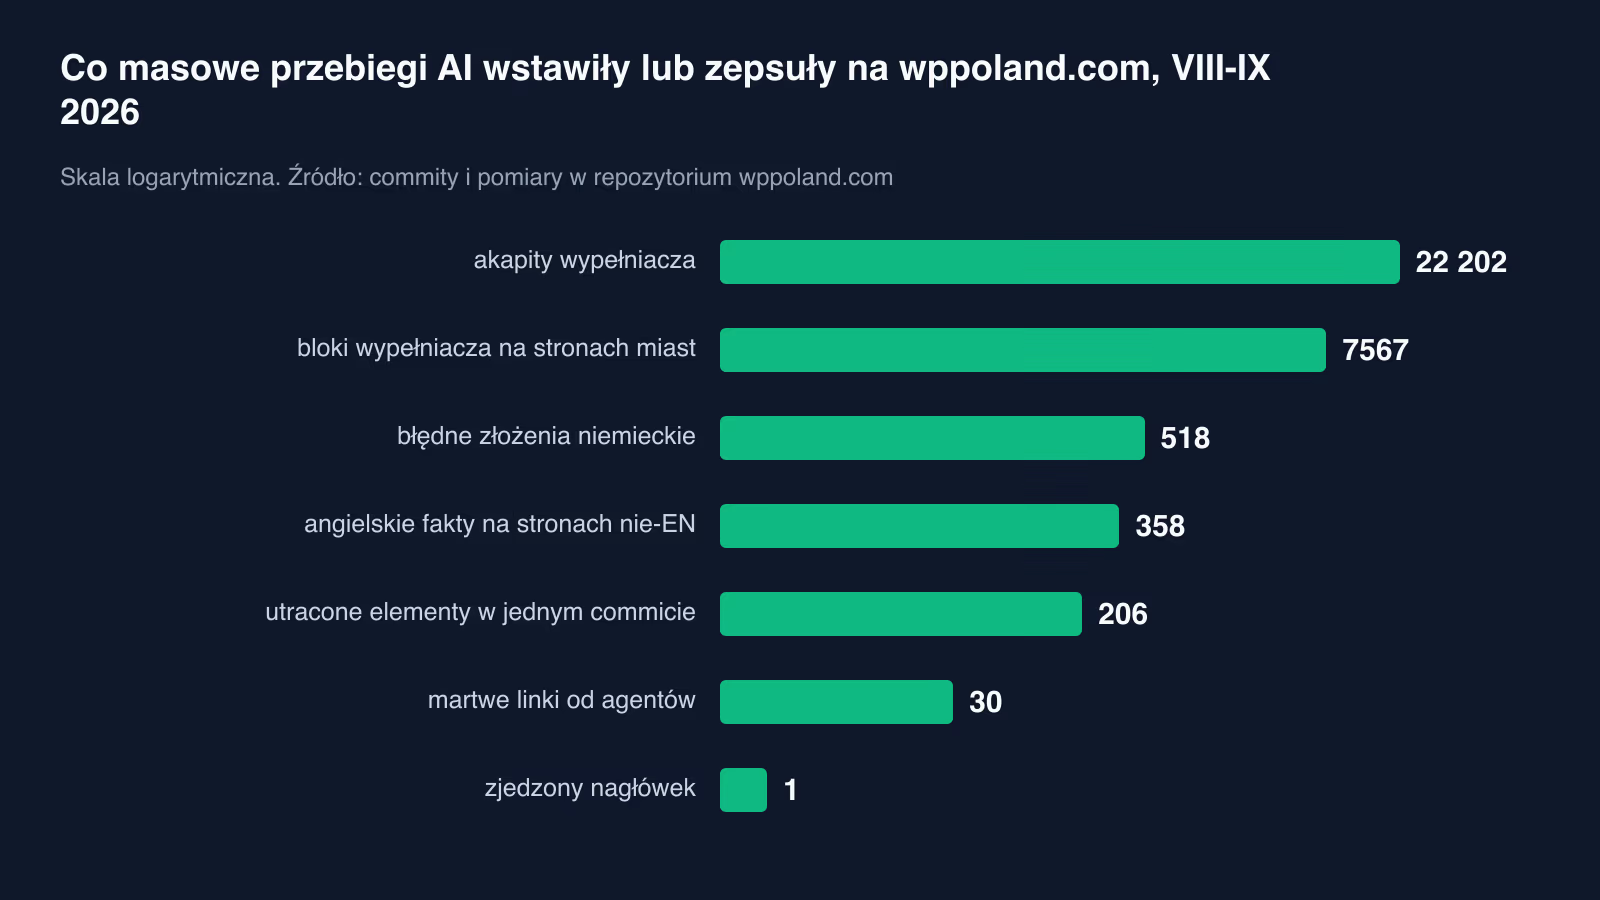
W skrócie: między sierpniem a wrześniem 2026 masowe przebiegi AI wstawiły na naszą stronę 22 202 akapity wypełniacza, zniszczyły nagłówek, zostawiły 358 angielskich zdań na stronach w pięciu innych językach i 518 niepoprawnych niemieckich złożeń. Agenci piszący strony miast dopisali zmyślone case studies i 30 linków do stron, które nie istnieją. Opisujemy mechanizm każdego defektu i bramkę, która łapie go dzisiaj.
Piszemy to o własnej stronie, bo tylko tu mamy pełne dane: commit, liczbę plików, stan przed i po. Search Engine Land opublikował w tym tygodniu tekst o dziesięciu sposobach, na jakie Claude może wykoleić SEO, jeśli nie sprawdza się jego pracy. To jest wersja z paragonami.
Defekty treści AI na stronie z 13 733 podstronami
wppoland.com działa na Astro i jest budowana statycznie w sześciu językach: polskim, angielskim, niemieckim, norweskim, portugalskim i hiszpańskim. Ostatni build produkcyjny z 29 września 2026 wygenerował 13 733 strony. Treść powstaje i jest poprawiana przez agentów kodujących oraz przez skrypty Node, które przechodzą przez tysiące plików naraz. Mamy ponad 70 bramek jakości w CI i lokalnie.
Mimo to każdy z opisanych defektów przeszedł przez wszystkie bramki. Powód jest za każdym razem ten sam i wracamy do niego na końcu. Liczby w tabeli to nasze pomiary z historii repozytorium wppoland.com.
| Defekt | Co trafiło na produkcję | Jak to znaleźliśmy | Bramka dzisiaj |
|---|---|---|---|
| Dopychanie do liczby słów | 22 202 akapity w 873 plikach | 59 kopii jednego akapitu na żywej stronie | check:no-batch-filler |
| Wypełniacz stron miast | 7567 bloków w 2621 plikach | Numerowane nagłówki “Ateny (1)” do “Ateny (26)“ | ta sama, rozszerzona na miasta |
| Regex cen | 1 zniszczony nagłówek | Skaner sklejonych słów | check:glued-words |
| Tłumaczenie tylko spójników | 358 angielskich zdań w 104 plikach | Porównanie z angielskim odpowiednikiem | detektor oparty na wpId |
| Zamiana terminu bez złożeń | 518 złożeń w 356 plikach | Ręczny odczyt strony | wyszukiwanie klasy, nie literału |
| Zmyślone case studies | 13 stron, 30 martwych linków | Przegląd agentów przed publikacją | walidacja linków wewnętrznych |
| Deploy, który rozgrzał stary cache | 5 z 6 stron głównych ze starą treścią | Porównanie treści, nie kodów HTTP | drugi purge po smoke teście |
| Pogłębianie, które podmieniało treść | 142 do 206 elementów na commit | Porównanie z poprzednią wersją pliku | check:element-loss |
1. Wypełniacz AI dopychający wpisy do liczby słów
Nasze wytyczne redakcyjne mówią, że wpis na blogu ma około 2500 słów. To była wskazówka dla człowieka. Seria skryptów wsadowych potraktowała ją jak cel do spełnienia i dopychała krótsze teksty wygenerowanym wypełniaczem.
Efekt, zmierzony przy sprzątaniu 29 sierpnia: 22 202 numerowane akapity typu “Notatka wdrożeniowa 47” w 873 plikach, do 60 identycznych kopii w jednym wpisie, plus 4 144 szablonowe sekcje rotowane z puli pięciu na język. Dwie z tych sekcji były wewnętrznymi instrukcjami redakcyjnymi, opublikowanymi jako treść artykułu. Na żywej stronie o aktualizacjach bezpieczeństwa WordPressa ten sam akapit stał 59 razy.
Skrypt nie miał błędu. Robił dokładnie to, o co go poproszono: podnosił liczbę słów. Błąd był w tym, że liczbę słów, miarę pomocniczą, uznano za cel.
Bramka dzisiaj: check:no-batch-filler w każdym przebiegu npm run check. Pierwsza wersja szukała literałów generatora i przepuściła wypełniacz, który wrócił z innym tekstem. Obecna patrzy na kształt: ten sam nagłówek drugiego poziomu trzy razy w jednym pliku to błąd, niezależnie od słów.
2. Programatyczne strony miast z powielonym wypełniaczem
Kolekcję stron miast przez tygodnie omijała każda bramka, bo żadna jej nie skanowała. Przebiegi 11 do 14 dopychały te strony do 2200, a potem 2500 słów. Przy sprzątaniu 30 sierpnia usunęliśmy 7567 numerowanych bloków i około 21 tysięcy powtórzonych sekcji z 2621 plików. Strona /pl/woocommerce-programista-ateny/ podawała sekcje od “Ateny (1)” do “Ateny (26)”.
Gorzej: jeden z przebiegów dopisywał bloki po hiszpańsku do każdego języka poza norweskim. Polskie, niemieckie i portugalskie strony miast miały sekcje “Entrega y seguimiento” (po hiszpańsku: dostawa i śledzenie), choć żadna z nich nie jest stroną hiszpańską.
Druga lekcja przyszła przy usuwaniu. Pierwsza wersja skryptu czyszczącego porównywała całe literały i zgłosiła sukces, zostawiając 9642 sekcje, bo późniejsze skrypty naprawcze poprawiły ten wypełniacz na miejscu (na przykład hiszpańską odmianę rodzaju w 1506 plikach). Dokładne porównanie bajtów nie widziało żadnego bloku, którego dotknął naprawiacz. Teraz dopasowujemy nagłówek plus pierwsze cztery słowa.
Po usunięciu wypełniacza 724 strony spadły poniżej progu 2000 słów. Sprawdziliśmy je w Google Search Console, zanim cokolwiek zdecydowaliśmy: tylko 2 miały jakiekolwiek kliknięcie w 90 dni, 575 miało zero wyświetleń. 723 przenieśliśmy na noindex, zamiast dopychać je z powrotem.
3. Regex cen bez granicy słowa niszczy nagłówek
Strony usług nie podają cen poza cennikiem, więc skrypt zamieniał kwoty w złotych na “wycena indywidualna”. Regex dopasowywał “zł” bez rozróżniania wielkości liter i bez granicy słowa po nim.
Na polskiej stronie audytu bezpieczeństwa nagłówek “2. Złośliwe przekierowania” wyglądał dla tego regexa jak cena “2. Zł”. Na produkcji stał jako “wycena indywidualna ośliwe przekierowania”: regex zjadł numer razem z “Zł”, wstawił w to miejsce frazę zastępczą i zostawił resztę uciętego słowa. Ten sam regex siedział w drugim skrypcie, od cen na stronach miast.
Znaleźliśmy to przypadkiem, budując skaner nagłówków ze sklejonymi słowami, który przy tej samej okazji wykrył 13 nagłówków bez spacji przed przyimkiem (“Is AMP deadin 2026?”). Poprawka to negatywne dopasowanie wprzód w obu skryptach: po symbolu waluty wzorzec wymaga teraz (?![\p{L}]), czyli braku jakiejkolwiek litery w dowolnym alfabecie. Działa to tylko z flagą u, bo bez niej JavaScript nie rozpoznaje klas Unicode typu \p{L}. W całym korpusie ofiarą padł jeden nagłówek, ale był to nagłówek strony sprzedażowej.
4. Częściowe tłumaczenie zostawiło angielskie zdania
Pole faktów (llmCard) wyświetla się widocznie pod artykułami i trafia do danych dla modeli językowych. Na stronach w pięciu językach innych niż angielski 358 takich zdań było po angielsku, w 104 plikach. Część była przetłumaczona w połowie: dawny skrypt zamienił tylko spójnik, więc niemiecka strona portfolio pisała “Contact und inquiry forms”, a polska “granite, conglomerate, i marble countertops”.
Najciekawsze było wykrywanie. Pierwszy detektor, oparty na udziale angielskich słów funkcyjnych, znalazł 172 zdania. Agenci tłumaczący sami zgłosili, że w tych samych plikach zostały inne angielskie zdania, i mieli rację. Drugi przebieg porównywał każde zdanie z faktami angielskiego odpowiednika tej samej strony (to samo wpId). Bez dodatkowego filtra zwracał 4004 trafienia, głównie listy technologii na stronach miast i norweskie “for”. Z wymogiem co najmniej dwóch angielskich słów funkcyjnych zostało 170 prawdziwych. Ostatnie 12 poprawiliśmy ręcznie.
Każde z pięciu tłumaczeń sprawdziliśmy skryptem, nie raportem agenta: w każdym pliku zmieniły się tylko wskazane pozycje, każda liczba przetrwała, nie ma długich myślników.
5. Błędne niemieckie złożenia po masowej zamianie terminu
Przebieg ujednolicający słownictwo zamienił niemiecki termin na “laufende Betreuung”. Nie obsłużył złożeń, więc strony pisały “laufende Betreuung-Commitments”, “laufende Betreuung-Übergabe” i “Wartungs-laufende Betreuung”. To nie jest niemiecki. Razem 518 wystąpień w 356 plikach, wszystkie na stronach indeksowanych.
Pozycja w naszym backlogu miała komendę weryfikującą, która szukała tylko formy z łącznikiem po terminie. Poprawienie dokładnie tego, co wskazała, zmieniłoby ją na zieloną i zostawiło 157 złożeń w drugiej formie w 118 plikach. Szukaliśmy więc klasy defektu (dowolny łącznik stykający się z terminem), a nie literału, który ktoś wpisał do zadania.
Metoda naprawy była prosta: 497 z 518 wystąpień pochodziło z czterech zdań szablonowych. Każde przepisaliśmy raz, ręcznie, poprawnym niemieckim (“Übergabe in die laufende Betreuung”, “Wartungsbetreuung”) i podmieniliśmy jako dokładne zdanie. Pozostałe 21 poprawialiśmy pojedynczo.
6. Agenci AI zmyślający case studies i linki
Trzynaście kuratorskich stron miast napisali agenci. Przegląd przed publikacją, 26 sierpnia, znalazł w nich sekcje “Case Study 1: Dystrybutor B2B z Bielan Wrocławskich” z precyzyjnymi liczbami: +52% zapytań, LCP z 4,5 s do 0,7 s, 100/100 w PageSpeed. Żaden z tych klientów nie istnieje. Te same liczby siedziały też w polu faktów i w danych speakable, nie tylko w treści.
Do tego sekcje “Inne lokalizacje” linkowały do miast, które zgadywano geograficznie: Lubeka, Kilonia, Ratyzbona, Girona, Tromsø. 30 martwych linków w 8 plikach.
Tego nie łapie żadna bramka tekstowa, bo zmyślone case study jest poprawne składniowo. Łapie to reguła procesu: agent dostaje w poleceniu listę istniejących adresów, a każde twierdzenie liczbowe o kliencie wymaga źródła w repozytorium albo znika.
7. Cloudflare Pages pokazuje starą treść po deployu
Skrypt wdrożeniowy 8 września zakończył się czysto: wgranie, czyszczenie cache, smoke test 81/81 OK, kod wyjścia 0. Na żywej stronie pięć z sześciu stron głównych pokazywało stare kafle.
Kolejność była: wgranie, purge, 8 sekund przerwy, smoke test. Cloudflare Pages nie zdążył aktywować nowego wdrożenia, więc 81 zapytań testu trafiło w poprzedni build i wypełniło nim cache na godzinę. Krok weryfikacyjny unieważnił purge, który wykonano chwilę wcześniej. Żaden sygnał nie był fałszywy. Żaden nie mierzył tego, co poszło źle: test sprawdzał kody HTTP, nie treść.
Dzisiaj: skrypt czyści cache drugi raz, po teście, a wdrożenie potwierdzamy frazą z konkretnej zmiany na żywej stronie, z parametrem omijającym cache.
8. Przepisywanie treści przez AI usuwało tabele i kod
Przebiegi “pogłębiające” krótkie wpisy miały dopisywać treść. W praktyce część z nich podmieniała całe ciało artykułu. Dziewięć wpisów przywracaliśmy z historii gita.
Po tym zbudowaliśmy bramkę, która porównuje każdy zmieniony plik z jego wersją bazową i zgłasza utratę elementu: tabeli, komponentu, iframe, obrazu, bloku kodu, pytania FAQ, kroku howTo, linku wewnętrznego. Puszczona wstecz po ostatnich 60 commitach z treścią oznaczyła każdy przebieg pogłębiania od 128 do 185, z których każdy gubił od 142 do 206 elementów, w tym tabele, osadzone wideo i bloki kodu.
Pierwsza wersja tej bramki rozpoznawała nagłówki po tekście. Na bieżącej gałęzi zgłosiła 17 utraconych nagłówków i wszystkie 17 były naprawami: rozdzielone sklejone słowa, przywrócony zjedzony nagłówek. Zmiana nazwy to nie utrata. Nagłówki, linki i FAQ liczymy więc ilościowo, a tożsamość zostawiamy tylko obrazom, komponentom i iframe.
Dlaczego skrypty AI zgłaszają sukces mimo błędów
Wszystkie osiem przypadków ma ten sam kształt. Narzędzie mierzyło to, co samo zrobiło, i na tej podstawie zgłaszało sukces. Skrypt dopychający mierzył liczbę słów. Skrypt czyszczący mierzył, czy znalazł swoje literały. Weryfikacja z backlogu mierzyła jedną formę złożenia. Smoke test mierzył kody HTTP.
Każdy defekt znaleźliśmy dopiero wtedy, gdy wynik porównaliśmy z czymś zewnętrznym:
- z poprzednią wersją tego samego pliku (utracone tabele i sekcje),
- z odpowiednikiem w innym języku (angielskie zdania na stronach niemieckich),
- z żywą stroną zamiast z logiem wdrożenia (stary cache),
- z klasą defektu zamiast z literałem z zadania (druga forma złożeń),
- z danymi o popycie (723 strony miast bez jednego wyświetlenia).
Z tego wynika praktyczna reguła, którą stosujemy od września: raport agenta albo skryptu to hipoteza. Wynik sprawdza osobny skrypt, który nie wie, co narzędzie zamierzało zrobić, i porównuje stan przed ze stanem po.
Aktualizacja, 18 października 2026. 8 października iPullRank opublikował WARRANT-SEO, benchmark autorstwa Patricka Schofielda, który mierzy ten sam błąd w modelach językowych. Autorzy sprawdzili 27 modeli na 27 scenariuszach diagnostyki SEO, każde pytanie w trzech wersjach, a cały zestaw puścili trzy razy. Gdy w danych była jedna rozstrzygająca obserwacja, modele stawiały trafną diagnozę w 99% przypadków. Po usunięciu tej jednej linijki odsetek odpowiedzi, w których model słusznie przyznawał, że danych jest za mało, spadł do 51,5%. To 47,5 punktu procentowego różnicy: mniej więcej w połowie przypadków model i tak wskazywał konkretną przyczynę. Według autorów pewna siebie diagnoza wygląda tak samo, niezależnie od tego, czy stoi za nią dowód, czy zgadywanie.
To wzorzec naszych ośmiu defektów, tylko w miejscu skryptu stoi model. Dla weryfikacji liczy się jeden szczegół z badania: część modeli przy każdym powtórzeniu podawała tę samą nieuzasadnioną diagnozę, a powtarzalność wygląda jak potwierdzenie. Dwukrotne zapytanie tego samego narzędzia niczego nie sprawdza. iPullRank radzi żądać obserwacji, która wspiera diagnozę, konkurencyjnych przyczyn i listy tego, czego jeszcze brakuje. U nas ta sama reguła dotyczy każdego raportu: sprawdzamy artefakt, nie raport.
Jak bezpiecznie puszczać masowe zmiany treści AI
- Żadnego celu liczbowego dla skryptu, który pisze prozę. Liczba słów, liczba linków i liczba FAQ to miary do czytania, nie do spełniania.
- Bramka porównująca z poprzednią wersją pliku przed pierwszym commitem wsadowym, nie po trzydziestym.
- Każdy regex na tekście testowany na nagłówkach i na słowach z polskimi znakami, bo “Zł” jest początkiem wielu słów.
- Tłumaczenia weryfikowane porównaniem z odpowiednikiem w języku źródłowym, nie listą słów.
- Komenda weryfikująca zadanie szuka klasy defektu. Jeśli zadanie nazywa jeden przykład, szukaj też jego wariantów.
- Wdrożenie potwierdzone treścią na żywej stronie, w każdym języku.
Aktualizacja spamowa Google z września 2026 a treści AI
Nie twierdzimy, że te defekty kosztowały nas ruch, bo tego nie zmierzyliśmy w sposób, który by to rozstrzygał. Część stron z wypełniaczem nie miała wyświetleń także przed nim.
Wrześniowa aktualizacja Google dotycząca spamu trwała od 24 września do 8 października 2026 według panelu stanu wyszukiwarki Google. Według podsumowania Search Engine Roundtable z 28 września uderzyła w strony programatyczne i treści generowane przez AI, a Google w tym samym tygodniu opublikował pracę o systemie SAFE do wykrywania masowego “AI slop”. Nasze strony miast to dokładnie ta kategoria. Odczyt w Search Console, osobno dla stron miast, bloga i stron usług, zrobimy po zakończeniu aktualizacji i opiszemy go, niezależnie od wyniku.
Ostatnia uwaga dotyczy nas samych: ten tekst też powstał z pomocą agenta. Każda liczba w nim pochodzi z commita albo z pomiaru w naszym repozytorium i przeszła przez te same bramki, które tu opisujemy.
Te osiem defektów to powód, dla którego integrację AI z WordPressem zaczynamy od bramek i testów litmus, a nie od kolejnego masowego przepisywania treści bez nadzoru.