Nie, Cloudflare nie blokuje Googlebota domyślnie. Od 15 września 2026 jedna opcja w ustawieniach botów AI robi jednak coś, czego wiele osób się nie spodziewa: “Block” zatrzymuje Googlebota na wejściu, razem z wyszukiwarką, a nie tylko z trenowaniem AI. Jeśli Twój WordPress stoi za Cloudflare i ktoś w ostatnich tygodniach “wyłączył AI”, warto to sprawdzić dziś.
7 października 2026 w podsumowaniu dnia na Search Engine Roundtable pojawiło się zdanie z wpisu na X: “Cloudflare 9/15 przełączył się na domyślne blokowanie Google” (Search Engine Roundtable, 7 października 2026, tłumaczenie własne). Samego wpisu na X nie dało się otworzyć bez logowania, więc poniżej opieram się wyłącznie na źródłach Cloudflare. Wszystkie cytaty sprawdziłem 8 października 2026.
Co Cloudflare zmienił 15 września 2026
Dotychczas był jeden przełącznik “Block AI bots”. Teraz są trzy kategorie, a każda ma własne ustawienie. Cloudflare definiuje je tak:
- Search: “crawlowanie w celu zbudowania indeksu wyszukiwania.”
- Training: “crawlowanie w celu trenowania lub dostrajania modelu.”
- Agent: “agenci kierowani przez użytkownika, odwiedzający stronę w imieniu człowieka, na przykład boty pobierające strony dla czatów i agenci obsługujący przeglądarkę.”
Źródło definicji: Cloudflare Blog, 15 września 2026, tłumaczenie własne.
Do wyboru są cztery opcje: Allow, Disallow AI Training, Block on pages with ads oraz Block. Disallow AI Training istnieje tylko w kategorii Training. Cloudflare podaje, że nowe ustawienia są dostępne “dla wszystkich klientów, we wszystkich planach” (tłumaczenie własne), czyli także na darmowym planie.
Dlaczego opcja Block zatrzymuje Googlebota
Bo Googlebot jest crawlerem mieszanym. Cloudflare nazywa tak bota, który jednym user agentem obsługuje i wyszukiwanie, i trenowanie:
“Crawler mieszany to jeden crawler, który zajmuje się zarówno wyszukiwaniem (Search), jak i trenowaniem (Training).”
Cloudflare Blog, 15 września 2026, tłumaczenie własne
Cloudflare wymienia trzy takie crawlery: Applebota, Bingbota i Googlebota. Skoro nie da się zatrzymać “tej części Googlebota, która trenuje”, blokada uderza w całego bota. Cloudflare pisze to wprost:
“Zatrzyma to Applebota, Bingbota i Googlebota przed dotarciem do Twojej strony […] łącznie z wyszukiwaniem.”
Cloudflare Blog, 15 września 2026, tłumaczenie własne
To samo dotyczy opcji Block on pages with ads, tylko w węższym zakresie: według Cloudflare crawlery, także mieszane, są wtedy blokowane na stronach, na których wykryto reklamę. Dla bloga na WordPressie z AdSense to może oznaczać, że Google przestaje widzieć właśnie te wpisy, które zarabiają.
Bezpieczna dla wyszukiwarki jest opcja Disallow AI Training. Publikuje jedynie preferencję w robots.txt, a Cloudflare zaznacza, że Googlebot “może dalej indeksować Twoją stronę na potrzeby wyszukiwania” (tłumaczenie własne). Rezygnację z trenowania modeli Google obsługuje osobny token Google-Extended, który opisałem we wpisie o trzech przełącznikach AI w Google.
Co stało się ze starym przełącznikiem Block AI bots
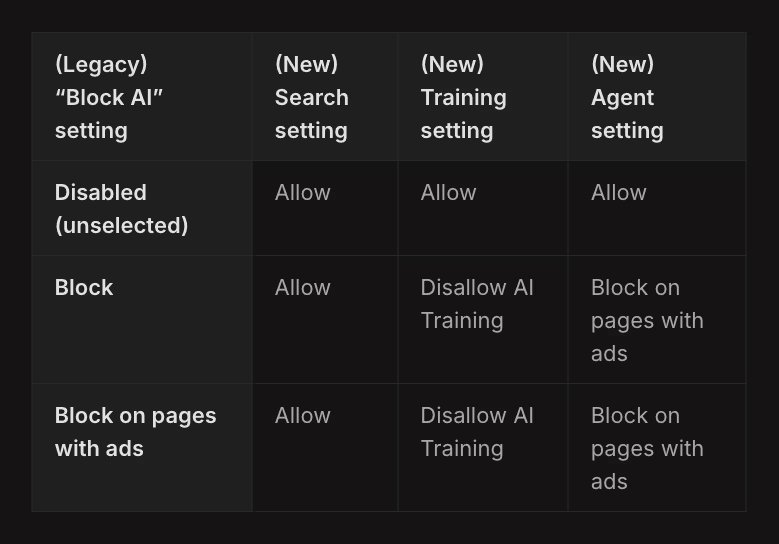
Cloudflare go wycofuje i przenosi istniejące strefy na nowe ustawienia. Tabela migracji z wpisu na blogu wygląda tak:
| Stary “Block AI” | Search | Training | Agent |
|---|---|---|---|
| Wyłączony | Allow | Allow | Allow |
| Block | Allow | Disallow AI Training | Block on pages with ads |
| Block on pages with ads | Allow | Disallow AI Training | Block on pages with ads |
Według tej tabeli nikt, kto miał stary przełącznik, nie dostał blokady Googlebota z automatu. Search zawsze przechodzi na Allow, a Training na Disallow AI Training, czyli wariant oparty na robots.txt.
Nowe domeny, dodawane od 15 września, dostają przy dodawaniu domeny jeden z dwóch zestawów. Strona bez reklam: wszystko na Allow. Strona z reklamami: Search Allow, Training Disallow AI Training, Agent Block on pages with ads. W obu zestawach włączone jest Preference Sync, które według Cloudflare “publikuje w robots.txt odpowiednią preferencję zakazu trenowania” (tłumaczenie własne) i zastępuje dotychczasowe Managed Robots.txt.
Czy blokada trenowania AI w Cloudflare blokuje Googlebota
Strona dokumentacji o blokowaniu botów AI zawiera zdanie, które nie gra z tabelą:
“Crawlery o mieszanym przeznaczeniu, łączące Search i Training, również zostaną zablokowane przez wszystkie konfiguracje blokujące trenowanie AI”
Cloudflare Docs, Block AI bots, tłumaczenie własne
Jeśli brać je dosłownie, każda konfiguracja blokująca trenowanie, łącznie ze starym przełącznikiem, blokuje też Googlebota. Tabela migracji mówi coś odwrotnego. Która wersja opisuje to, co serwer Cloudflare naprawdę robi z Twoim ruchem, rozstrzyga tylko Twoja własna strefa i Twoje własne logi, a nie żaden z tych dwóch tekstów.
Dokumentacja podaje też, że stary przełącznik jest “wycofywany 15 września 2026” (tłumaczenie własne), a dla nowych domen “wyszukiwanie pozostanie dozwolone” (tłumaczenie własne). Ani wpis, ani dokumentacja nie wspominają o Cloudflare Pages.
Dlaczego Cloudflare może zablokować GPTBota bez szkody dla wyszukiwarki, a Googlebota nie
Ten sam wpis wyjaśnia, dlaczego Google, Apple i Microsoft są traktowani inaczej niż pozostałe firmy AI. Cloudflare wprowadził dla operatorów crawlerów oznaczenie “Accountable”. Żeby je dostać, operator musi spełnić albo zobowiązać się do spełnienia czterech warunków: dać możliwość rezygnacji z trenowania AI (przez robots.txt lub podobny standard), dać możliwość rezygnacji z podsumowań AI, pokazać na poziomie adresów URL, które strony udostępniono do trenowania, i zagwarantować, że rezygnacja z trenowania nie wpłynie na zwykłe wyniki wyszukiwania (Cloudflare Blog, 15 września 2026).
Cloudflare zalicza Applebota, Googlebota i Bingbota do crawlerów mieszanych z oznaczeniem Accountable. Crawlery treningowe Amazona, Anthropic, Mety i OpenAI są sklasyfikowane inaczej: te firmy mają osobne boty do wyszukiwania i do trenowania, więc Cloudflare może zablokować bota treningowego i zostawić w spokoju bota wyszukiwarki. Właśnie dlatego Disallow AI Training działa tak, jak działa. Crawlery służące wyłącznie do trenowania są blokowane, a crawlery mieszane z oznaczeniem Accountable zostają wpuszczone do wyszukiwania i dostają preferencję “bez trenowania” przez robots.txt.
Preferencja działa tylko wtedy, gdy operator ją czyta. Google respektuje Disallow dla tokenu Google-Extended, a Apple dla Applebot-Extended. Z Microsoftem jest inaczej: według tego samego wpisu Bing dopiero buduje obsługę preferencji “bez trenowania” w robots.txt na poziomie domeny, z terminem na początek 2027 roku, i do tego czasu Disallow AI Training nie przekazuje tej preferencji Bingowi automatycznie. Na ten czas Cloudflare wskazuje meta tag NOARCHIVE i narzędzie Block URLs w Bingu.
Jak sprawdzić, czy Googlebot wchodzi na Twojego WordPressa
Trzy kroki, około trzech minut, jeśli masz dostęp do Search Console i do konta Cloudflare.
- Sprawdzanie adresu URL w Search Console. Wklej adres strony głównej i uruchom test na żywo. Szukasz pobrania strony zakończonego sukcesem i daty ostatniego indeksowania po 15 września. Powtórz dla jednego wpisu z reklamą, jeśli je wyświetlasz, bo tam działa wariant Block on pages with ads.
- Statystyki indeksowania. W ustawieniach Search Console otwórz statystyki indeksowania i podział według odpowiedzi. Nagły przyrost odpowiedzi 403 od połowy września to sygnał, że coś na brzegu zatrzymuje Googlebota.
- Ustawienia strefy w Cloudflare. Cloudflare pisze, że nowe kontrolki “można skonfigurować w Security Settings domeny (strefy)” (tłumaczenie własne). Sprawdź, co jest ustawione w Search, Training i Agent. Jeśli w Training albo Search widzisz Block, a chcesz zostać w Google, zmień to na Disallow AI Training albo Allow.
Przy okazji zajrzyj do robots.txt. Jeśli działa Preference Sync, Cloudflare dopisuje tam swoją preferencję. Na WordPressie robots.txt często generuje też wtyczka SEO, więc sprawdź gotowy plik pod adresem /robots.txt, a nie ustawienia samej wtyczki. Nasza własna linia Content-Signal pokazuje, jak łatwo robots.txt rozjeżdża się z tym, co zakładamy.
Czy Google-Extended w robots.txt usuwa stronę z wyszukiwarki Google
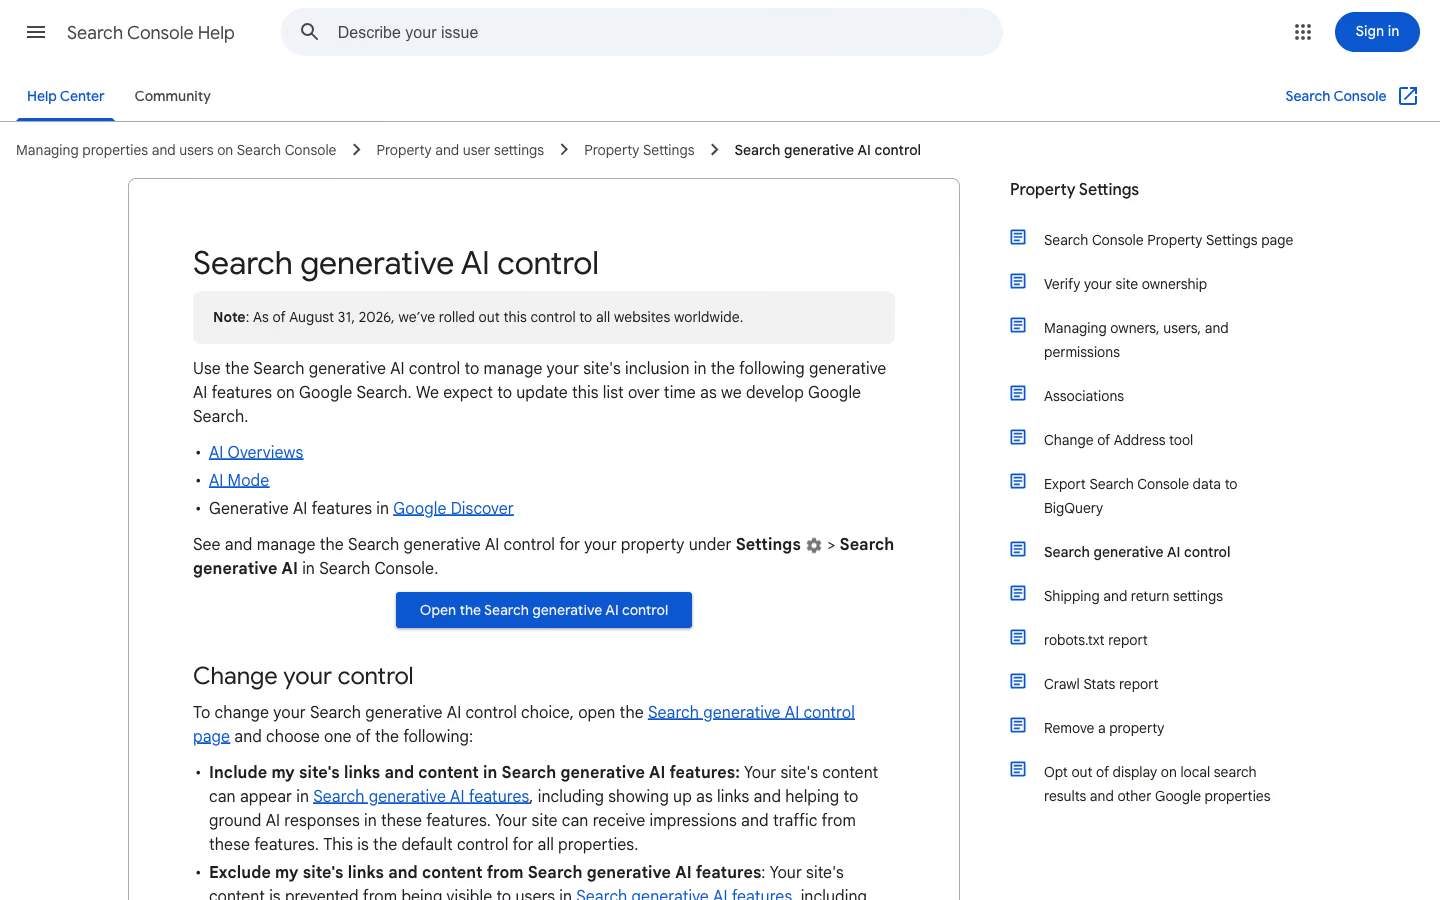
Nie. Dokumentacja Google o typowych crawlerach mówi, że Google-Extended nie ma osobnego ciągu user agent w żądaniach HTTP. Stronę pobierają istniejące boty Google, a token działa wyłącznie jako ustawienie w robots.txt. Google zaznacza, że nie wpływa on na obecność strony w wyszukiwarce i nie jest czynnikiem rankingowym. Kontroluje tylko to, czy pobrane treści mogą posłużyć do trenowania przyszłych modeli Gemini i do groundingu w aplikacjach Gemini oraz Vertex AI (Google Search Central, typowe crawlery Google).
Ta sama strona wyjaśnia szczegół ważny przy testach. Przycisk testu na żywo w Search Console i Test wyników z elementami rozszerzonymi pobierają stronę jako Google-InspectionTool, czyli crawler narzędzi testowych, który nie ma wpływu na wyszukiwarkę Google. Udany test na żywo mówi więc, że strefa wpuszcza teraz crawler Google. To, jak w ostatnich tygodniach traktowany był sam Googlebot, pokazują statystyki indeksowania i dlatego sprawdzenie powyżej korzysta z obu.
Co dzieje się z zaindeksowanymi stronami, gdy Googlebot dostaje 403
Blokada w Cloudflare odpowiada Googlebotowi stroną błędu zamiast treści i z tego powodu sprawdzenie powyżej szuka odpowiedzi 403. Google opisuje, jak reagują jego crawlery. Wszystkie kody 4xx poza 429 są traktowane tak samo, nie wpływają na tempo indeksowania, a w wyszukiwarce Google proces indeksowania usuwa adres URL z indeksu, jeśli był wcześniej zaindeksowany (Google Search Central, kody stanu HTTP i błędy sieci).
Blokada nie tylko wstrzymuje nowe pobieranie. Strony, które już mają pozycje, mogą wypaść z indeksu na czas jej trwania. Ta sama strona ostrzega przed używaniem kodów 401 i 403 do ograniczania tempa indeksowania. Jeśli naprawdę chodzi o odciążenie serwera z WordPressem, sygnałem do zwolnienia są dla Google kody 429 i 5xx: crawlery Google tymczasowo pobierają wtedy wolniej, zamiast usuwać adresy.
Jak sprawdzić, czy żądanie w logach naprawdę pochodzi od Googlebota
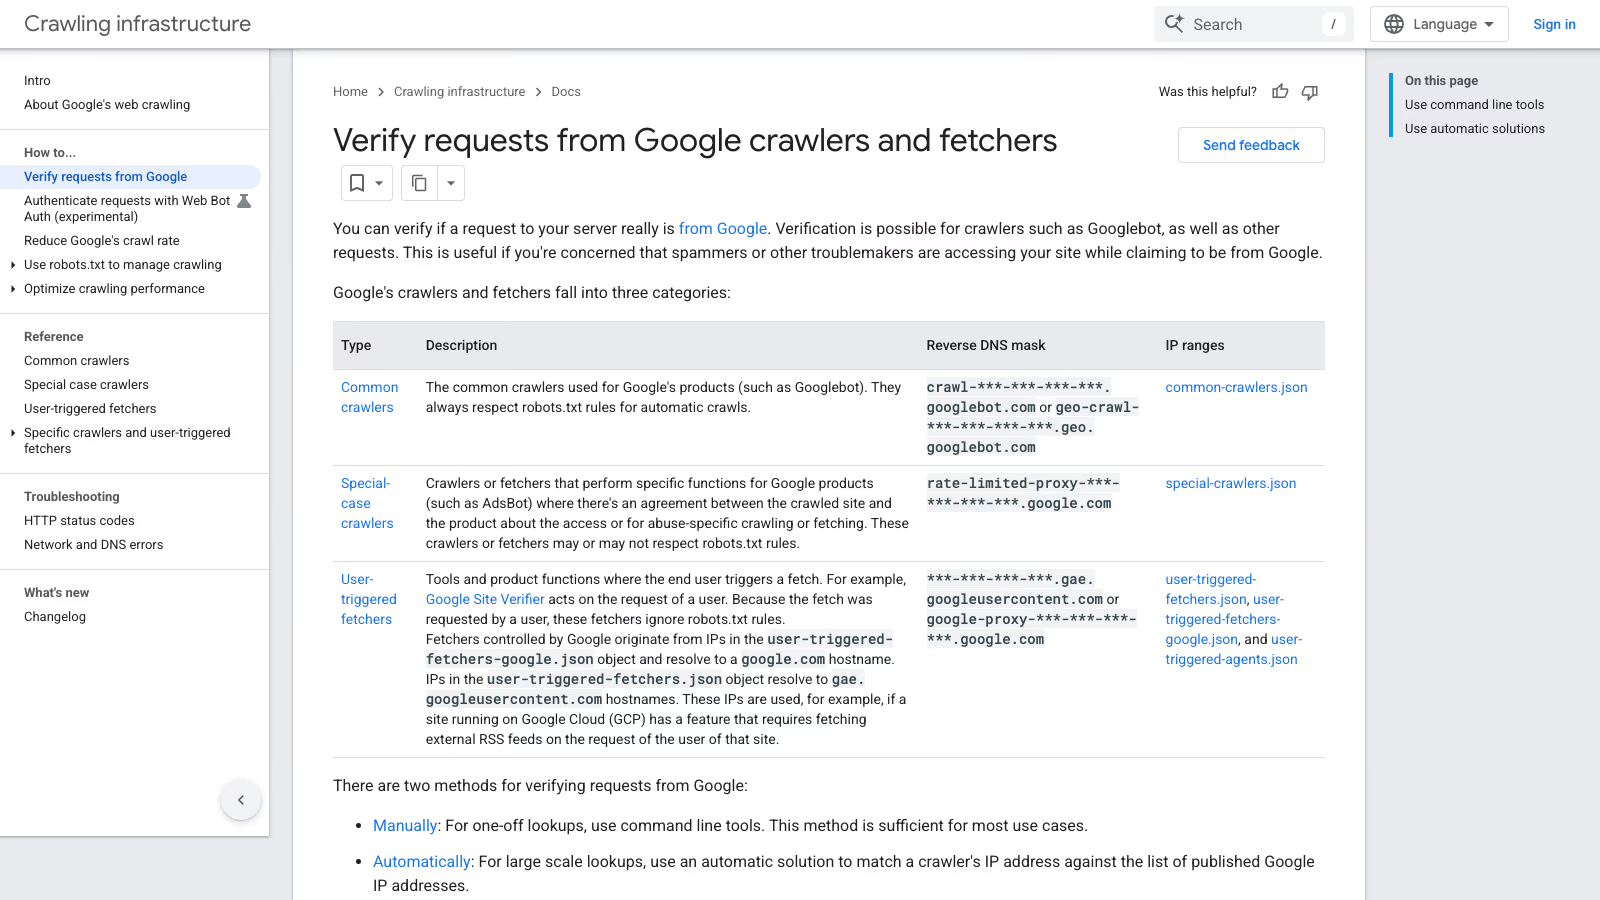
Każdy może wysłać żądanie z “Googlebot” w user agencie, więc sama linia w logu niczego nie dowodzi. Metoda Google to sprawdzenie DNS w dwie strony: zrób odwrotne zapytanie DNS dla adresu IP z logów poleceniem host, upewnij się, że nazwa hosta kończy się na googlebot.com, google.com albo googleusercontent.com, a potem zrób zwykłe zapytanie dla tej nazwy i sprawdź, czy zwraca ten sam adres IP. Google publikuje też zakresy IP swoich crawlerów w plikach JSON, osobno dla typowych crawlerów, crawlerów specjalnych, fetcherów uruchamianych przez użytkownika i agentów uruchamianych przez użytkownika (Google Search Central, weryfikacja Googlebota).
Nazwa hosta mówi też, z jakim rodzajem crawlera masz do czynienia. Googlebot i inne typowe crawlery mają nazwy crawl-***-***-***-***.googlebot.com (albo wariant geo.googlebot.com) i przy automatycznym pobieraniu zawsze respektują robots.txt. Fetchery uruchamiane przez użytkownika mają nazwy w gae.googleusercontent.com albo google-proxy-***.google.com i ignorują robots.txt, bo o pobranie poprosił człowiek.
Cloudflare robi podobne sprawdzenie po swojej stronie. Jego zweryfikowane boty to takie, których tożsamość Cloudflare potwierdził kryptograficznym podpisem Web Bot Auth, opublikowaną listą IP ze stałym user agentem albo odwrotnym DNS, i według dokumentacji były dotąd wyłączone z domyślnych konfiguracji botów we wszystkich planach (Cloudflare Docs, Verified bots). W regule WAF pole cf.client.bot mówi, czy żądanie pochodzi od znanego, dobrego bota lub crawlera (Cloudflare Docs, cf.client.bot). Pułapka w darmowym planie: Bot Fight Mode działa w osobnym procesie, a Cloudflare pisze, że nie da się go obejść ani pominąć regułami WAF ani Page Rules (Cloudflare Docs, Bot Fight Mode). Reguła pomijająca napisana “dla ochrony Googlebota” nie zmieni tego, co robi Bot Fight Mode.
Jakie ustawienie wybrać dla firmowej strony na WordPressie
Dla strony, która żyje z zapytań z Google, rozsądny układ wygląda tak:
| Kategoria | Ustawienie | Dlaczego |
|---|---|---|
| Search | Allow | To jest ruch z wyszukiwarki, którego chcesz |
| Training | Allow albo Disallow AI Training | Disallow AI Training wyraża sprzeciw przez robots.txt, nie blokując Googlebota |
| Agent | Allow | Agenci AI odwiedzają stronę w imieniu konkretnego człowieka, często potencjalnego klienta |
Block zostaw na sytuacje, w których naprawdę chcesz zniknąć z wyszukiwarek, na przykład dla środowiska testowego albo panelu, który nie powinien być indeksowany. Do tego i tak lepiej sprawdza się noindex i ochrona hasłem.
Jeśli wolisz, żeby treści nie trafiały do odpowiedzi AI, to jest osobna decyzja. Ma osobne narzędzia w Google i omawiam je w ramach optymalizacji GEO i LLMO. Blokada na brzegu w Cloudflare do tego nie służy, bo razem z AI wycina wyszukiwarkę.
Zanim zablokujesz jakiegokolwiek crawlera, policz, ile żądań przypada na jednego odwiedzającego, którego ci przysłał. Nick Gray opisał 7 sierpnia 2026 swój serwis PatronView z 1,5 miliona stron: jednego dnia dostał 3,6 miliona żądań od chińskich botów, Google crawlował u niego 46 razy na każdego przysłanego odwiedzającego, a Bingbot wysłał 158 610 żądań przy 680 odwiedzających. Regułę pomijania dla zweryfikowanych botów, (cf.client.bot), ustawił po regułach blokujących, a przed regułami wyzwań, więc zablokowany bot zostaje zablokowany, a Googlebot nigdy nie trafia na wyzwanie. Jego wyzwania rozwiązuje 0,24% klientów, co według autora oznacza, że trafiają one prawie wyłącznie w boty.
Strona prawna wciąż jest otwarta. W czerwcu 2025 Brian Williamson z Communications Chambers opublikował raport AI, Copyright and the Public Good, który według własnego zastrzeżenia jest niezależny i sfinansowany przez Google. Raport proponuje, by trenowanie AI na utworach chronionych prawem autorskim uznać za dozwolony użytek (fair use), uważa mechanizmy opt-out i obowiązki przejrzystości za kosztowne, a prawo autorskie chce skupić na tym, czy naruszają je odpowiedzi modeli. To propozycja polityczna, nie obowiązujące prawo. Na razie realną kontrolę dają ci ustawienia botów na brzegu sieci, więc ustaw je tak, żeby razem z crawlerami AI nie odciąć Googlebota.
Przykład ustawień botów AI w Cloudflare na działającej stronie
wppoland.com stoi na Cloudflare, więc sprawdziłem to na sobie 8 października 2026. API Cloudflare zwraca dla naszej strefy ai_training, ai_search i ai_user z wartością disabled, a stary przełącznik ai_bots_protection też ma disabled. Żadna blokada botów AI nie jest włączona.
Search Console potwierdza to od drugiej strony: sprawdzenie adresu URL dla /pl/ pokazuje ostatnie indeksowanie 8 października 2026 o 12:12, pobranie strony zakończone sukcesem i robots.txt zezwalający na dostęp. To jest jedna strefa z jednym ustawieniem, a cały problem polega na tym, że ustawienia różnią się między strefami.
Lista kontrolna ustawień botów AI w Cloudflare
- Uruchom test na żywo w Search Console dla strony głównej i jednego wpisu z reklamą.
- Przejrzyj statystyki indeksowania pod kątem odpowiedzi 403 od 15 września 2026.
- Otwórz Security Settings strefy w Cloudflare i sprawdź Search, Training i Agent.
- Nie używaj Block, jeśli chcesz zostać w Google. Do sprzeciwu wobec trenowania służy Disallow AI Training.
- Sprawdź gotowy plik
/robots.txt, bo piszą do niego i Cloudflare, i wtyczka SEO. - Jeśli Twoja domena została dodana do Cloudflare po 15 września, sprawdź, który zestaw domyślny wybrano przy dodawaniu domeny.