Napis Googlebot w nagłówku User-Agent dowodzi tylko tego, że ktoś go tam wpisał. Rozstrzyga adres IP: musi być na liście, którą publikuje Google, albo przejść odwrotne zapytanie DNS i zapytanie w przód. Reszta tego tekstu to praktyka: jak znaleźć takie wejścia w logach WordPressa, jak je sprawdzić i jak odciąć podróbki tak, żeby prawdziwy robot Google dalej wchodził bez przeszkód.
Temat wrócił 30 października 2026. Search Engine Roundtable opisał rozmowę Gary’ego Illyesa z Google w Odys Podcast, w której Illyes wiąże rosnącą liczbę podszywających się botów z AI. Jeśli twoja strona stoi za Cloudflare, przeczytaj też mój wcześniejszy tekst o tym, czy Cloudflare blokuje Googlebota. Tam są ustawienia botów AI, Bot Fight Mode i skutki kodu 403 dla zaindeksowanych stron. Tutaj zajmuję się krokiem wcześniejszym: ustaleniem, kto naprawdę puka do serwera.
Wszystkie polecenia i konfiguracje uruchomiłem 30 października 2026 na aktualnych plikach Google, z nginx 1.27.2 i Apache 2.4.63 na maszynie testowej. Tam, gdzie nie mogłem czegoś sprawdzić na produkcyjnym serwerze, piszę to wprost.
Skąd nagle tyle fałszywych Googlebotów?
Barry Schwartz z Search Engine Roundtable streścił rozmowę Illyesa z prowadzącą podcast Anetą Samkoff. Na pytanie, dlaczego podszywanie się pod boty stało się takim problemem, Illyes odpowiedział:
“Myślę, że to przez AI.”
Gary Illyes, cytowany przez Search Engine Roundtable, 30 października 2026, odcinek na YouTube, Odys Podcast (tłumaczenie własne)
Według cytatu w tym samym artykule Illyes tłumaczy to tak: firmy potrzebują treści do trenowania modeli, firewalle i CDN-y coraz lepiej rozpoznają roboty, ale nie są doskonałe, a mała wyszukiwarka AI albo zwykły scraper, który przedstawi się jako Googlebot, często zostanie wpuszczony tam, gdzie inaczej dostałby blokadę. Illyes ma też własne pułapki na roboty (honeypoty) i widział w nich zapytania podpisane jako Googlebot z adresów IP, które nie mają nic wspólnego z Google. Tytuł odcinka mówi o 30 sekundach potrzebnych na podróbkę. To się zgadza z praktyką: User-Agent to nagłówek, który klient ustawia sam.
Nie znalazłem transkrypcji odcinka, więc wszystko, co tu przypisuję Illyesowi, pochodzi z relacji Search Engine Roundtable.
Mechanizm jest prosty. Kto blokuje scrapery, prawie zawsze robi wyjątek dla Googlebota, bo nikt nie chce wypaść z wyników wyszukiwania. Reguła “przepuść Googlebota” bez sprawdzenia IP to więc otwarte drzwi z wywieszką. Google mówi to samo w pomocy Search Console przy stronach chronionych hasłem: wpuszczenie Googlebota bez logowania w praktyce zdejmuje z takiej strony zabezpieczenie, bo Googlebota da się podrobić (Pomoc Search Console, raport Statystyki indeksowania).
Mam hosting współdzielony. Co mogę zrobić bez dostępu do serwera?
Większość małych stron na WordPressie w Polsce stoi na hostingu współdzielonym. Nie edytujesz tam konfiguracji nginx, często nie masz SSH, a log dostępu pobierasz z panelu jako plik. To wystarczy, żeby zrobić wszystko poza blokadą na poziomie serwera:
- Pobierz surowy log dostępu z panelu hostingu, z ostatnich kilku dni. Format to prawie zawsze standardowy “combined”: IP, data, zapytanie, kod, rozmiar, referer, User-Agent.
- Sprawdź adresy u siebie, na laptopie z macOS albo Linuksem, poleceniami i skryptem z dalszej części tekstu. Python i
hostsą tam zwykle dostępne od ręki. - Zdecyduj, gdzie blokować. Jeśli domena przechodzi przez Cloudflare, najlepszym miejscem jest reguła WAF. Jeśli hosting działa na Apache i pozwala na dyrektywy
Requirew.htaccess, możesz zablokować tam. Wtyczka bezpieczeństwa to trzecia opcja, z zastrzeżeniami opisanymi niżej.
Najpierw jednak sprawdź, czy problem w ogóle istnieje. Kilkanaście fałszywych wejść dziennie na stronę firmową nie wymaga żadnej blokady. Kilka tysięcy zapytań do wyszukiwarki wewnętrznej WordPressa z “Googlebota” z jednego adresu to już inna rozmowa, bo każde takie zapytanie omija cache i obciąża bazę.
Jak znaleźć fałszywego Googlebota w logach?
Zacznij od liczb. To polecenie wypisuje adresy IP, które przedstawiły się jako Googlebot, od najaktywniejszego:
grep -i 'googlebot' /var/log/nginx/access.log | awk '{print $1}' | sort | uniq -c | sort -rn | head -20Na Apache log leży zwykle w /var/log/apache2/access.log (Debian, Ubuntu) albo /var/log/httpd/access_log (rodzina RHEL). Z hostingu współdzielonego podstaw ścieżkę do pobranego pliku. Żeby zobaczyć, o co każdy z nich prosił, wypisz IP razem z linią zapytania:
awk -F'"' 'tolower($6) ~ /googlebot/ {split($1,a," "); print a[1], $2}' /var/log/nginx/access.log | head -50Przykład poniżej jest skonstruowany na adresach dokumentacyjnych z RFC 5737, a nie na prawdziwym ruchu, ale pokazuje wzór, którego szukasz:
66.249.66.1 GET / HTTP/1.1
203.0.113.7 GET /wp-login.php HTTP/1.1
203.0.113.7 GET /?s=test HTTP/1.1
Prawdziwy Googlebot rzadko ma powód, żeby pukać do wp-login.php, xmlrpc.php albo przeglądać setki adresów wyszukiwarki wewnętrznej /?s=. “Googlebot”, który to robi, sprawdzasz w pierwszej kolejności. Wzór adresów podpowiada jednak tylko, od czego zacząć. Decyduje IP.
Zach Chahalis pisze o tym samym w poradniku Moz o analizie logów pod kątem wyszukiwania AI z 29 października 2026: User-Agent to nazwa, którą wysyłający nadaje sobie sam, scrapery potrafią zawyżyć statystyki, a reguły bezpieczeństwa pisane przeciw fałszywym botom potrafią przy okazji odciąć prawdziwe (Moz, How To Analyze Server Logs for AI Search). Dlatego radzi włączać weryfikację botów już przy imporcie logów, na przykład opcję “Verify Bots When Importing Logs” w Screaming Frog Log File Analyser.
Jak sprawdzić, czy to prawdziwy Googlebot, poleceniem host?
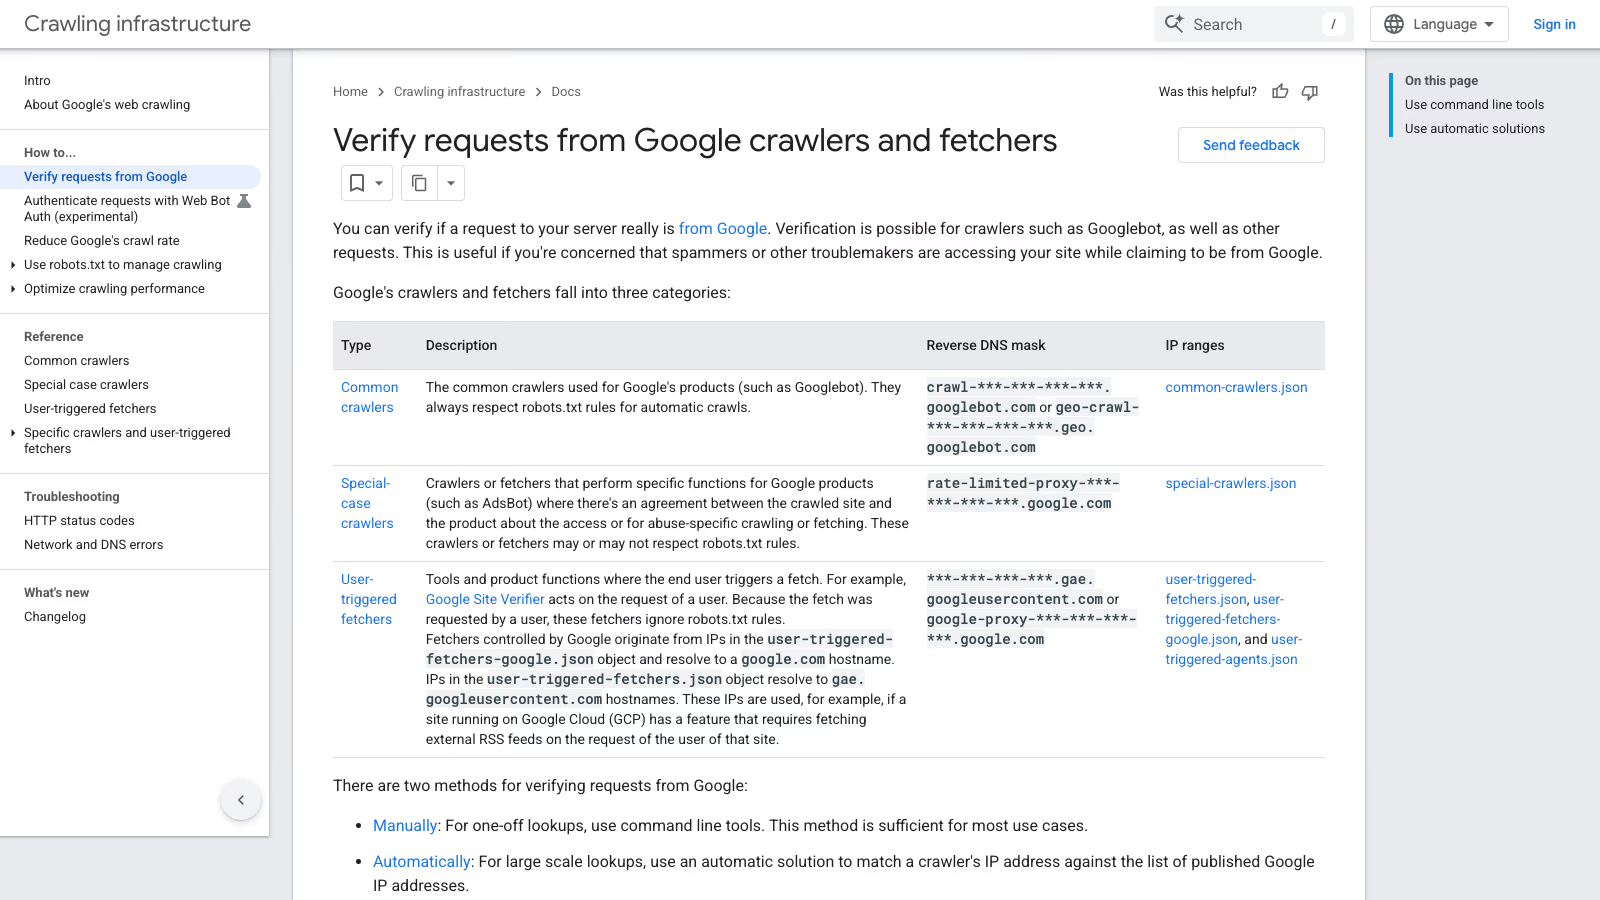
Google opisuje ręczne sprawdzenie w czterech krokach (Google, Verify requests from Google crawlers and fetchers):
- Odwrotne zapytanie DNS na adres IP z logu, poleceniem
host. - Nazwa hosta musi kończyć się na
googlebot.com,google.comalbogoogleusercontent.com. - Zwykłe zapytanie DNS (w przód) na tę nazwę.
- Wynik musi być tym samym adresem IP, co w logu.
Tak to wyglądało 30 października 2026 dla jednego z przykładowych adresów Google:
$ host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.
$ host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Krok w przód jest obowiązkowy. Kto ma pulę adresów IP, może ustawić jej rekord PTR na dowolną nazwę, także crawl-1-2-3-4.googlebot.com. Nie zmusi jednak serwerów DNS Google, żeby na pytanie o tę nazwę odpowiedziały jego adresem. Krótsza wersja tego samego to dig +short -x 66.249.66.1 i dig +short crawl-66-249-66-1.googlebot.com.
Przy większej liczbie adresów przyda się pętla. Ten skrypt akceptuje nazwy Google i Bing. Uruchomiłem go 30 października 2026 na adresach Google, Bing i dwóch adresach spoza świata robotów:
#!/usr/bin/env bash
# Two-way DNS check for an IP that claims to be Googlebot or Bingbot.
# Usage: ./verify_dns.sh 66.249.66.1 [more IPs]
for ip in "$@"; do
  name=$(host "$ip" | awk '/domain name pointer/ {print $NF; exit}')
  name=${name%.}
  case "$name" in
    *.googlebot.com|*.google.com|*.googleusercontent.com|*.search.msn.com) ;;
    *) echo "$ip FAKE: PTR is '${name:-none}'"; continue ;;
  esac
  if host "$name" | grep -qwF -- "$ip"; then
    echo "$ip OK: $name"
  else
    echo "$ip FAKE: $name does not resolve back to $ip"
  fi
done
Wynik tego dnia: 66.249.66.1 OK: crawl-66-249-66-1.googlebot.com, 157.55.39.1 OK: msnbot-157-55-39-1.search.msn.com, 8.8.8.8 FAKE: PTR is 'dns.google'. Trzy ograniczenia. Polecenie host na Debianie i Ubuntu pochodzi z pakietu dnsutils, na rodzinie RHEL z bind-utils. “FAKE” znaczy tylko “nie Google i nie Bing”, więc uruchamiaj skrypt na adresach, które podawały się za robota, a nie na całym logu. Adresy IPv6 można zapisać na kilka poprawnych sposobów, więc porównanie tekstowe może przeoczyć zgodność. Dla IPv6 użyj metody z listami IP opisanej niżej.
Która nazwa hosta należy do którego robota Google?
Google dzieli swój ruch na trzy grupy. Każda ma własny wzór nazwy i własny plik z adresami (Google, Verify requests):
| Grupa | Przykłady | robots.txt | Odwrotny DNS | Plik IP |
|---|---|---|---|---|
| Zwykłe roboty (common crawlers) | Googlebot, Googlebot-Image, Google-InspectionTool | Zawsze respektują przy automatycznym indeksowaniu | crawl-***-***-***-***.googlebot.com lub geo-crawl-***-***-***-***.geo.googlebot.com | common-crawlers.json |
| Roboty specjalne | AdsBot | Mogą respektować albo nie | rate-limited-proxy-***-***-***-***.google.com | special-crawlers.json |
| Pobierania na żądanie użytkownika | Google Site Verifier, Feedfetcher, Google-Agent | Ignorują, bo pobranie zlecił człowiek | ***-***-***-***.gae.googleusercontent.com lub google-proxy-***-***-***-***.google.com | user-triggered-fetchers.json, user-triggered-fetchers-google.json, user-triggered-agents.json |
Z tabeli wynika jedna praktyczna rzecz. Zapytanie z nagłówkiem Googlebota powinno pochodzić z pierwszego wiersza. Jeśli rozwiązuje się do gae.googleusercontent.com, przeszło krok 2 ręcznego sprawdzenia, a mimo to nie jest Googlebotem. Google wyjaśnia, że adresy z user-triggered-fetchers.json mają nazwy w gae.googleusercontent.com i służą na przykład stronom działającym w Google Cloud, które na prośbę swojego użytkownika pobierają zewnętrzny kanał RSS. To uczciwe pobranie, tyle że nie robot wyszukiwarki.
Gdzie jest googlebot.json i którą listę IP sprawdzać?
Google publikuje pięć plików JSON w formacie CIDR pod adresem https://developers.google.com/static/crawling/ipranges/. 30 października 2026 miały tyle prefiksów (liczby się zmieniają, traktuj je jako stan z tego dnia):
| Plik | Prefiksy 30.10.2026 | Do czego |
|---|---|---|
common-crawlers.json | 317 | Googlebot i pozostałe zwykłe roboty |
special-crawlers.json | 272 | AdsBot i inne roboty specjalne |
user-triggered-fetchers.json | 1068 | Pobrania zlecane przez użytkowników stron w Google Cloud |
user-triggered-fetchers-google.json | 504 | Pobrania na żądanie obsługiwane przez Google |
user-triggered-agents.json | 20 | Google-Agent i podobni agenci |
Jeśli masz skrypt sprzed kilku lat, pewnie pobiera googlebot.json. 30 października 2026 stary adres https://developers.google.com/search/apis/ipranges/googlebot.json zwracał przekierowanie 301 na common-crawlers.json, a https://developers.google.com/static/crawling/ipranges/googlebot.json zwracał 404. Skrypt, który podąża za przekierowaniami, działa dalej. Skrypt przypięty do nowszej ścieżki albo taki, który przy błędzie przyjmuje pustą listę, przestał działać. Sprawdź swój. Pusta lista dozwolonych adresów zamienia regułę “blokuj fałszywego Googlebota” w “blokuj Googlebota”.
Dla innych usług Google, które mogą odwiedzać stronę (na przykład Apps Script), Google odsyła do ogólnej listy https://www.gstatic.com/ipranges/goog.json.
Bing i OpenAI publikują pliki w tym samym kształcie: pole creationTime i tablica prefixes z wpisami ipv4Prefix albo ipv6Prefix. Jeden skrypt sprawdzi więc wszystkie naraz. Ten korzysta tylko z biblioteki standardowej Pythona:
#!/usr/bin/env python3
"""Check IPs against the crawler IP lists Google, Bing and OpenAI publish.

Usage: python3 verify_bot_ip.py 66.249.66.1 157.55.39.1 1.2.3.4
       awk '{print $1}' access.log | sort -u | python3 verify_bot_ip.py -
"""
import ipaddress
import json
import sys
import urllib.request

LISTS = {
    "google-common": "https://developers.google.com/static/crawling/ipranges/common-crawlers.json",
    "google-special": "https://developers.google.com/static/crawling/ipranges/special-crawlers.json",
    "google-user-fetchers": "https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers.json",
    "google-user-fetchers-google": "https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers-google.json",
    "google-user-agents": "https://developers.google.com/static/crawling/ipranges/user-triggered-agents.json",
    "bingbot": "https://www.bing.com/toolbox/bingbot.json",
    "openai-gptbot": "https://openai.com/gptbot.json",
    "openai-searchbot": "https://openai.com/searchbot.json",
    "openai-chatgpt-user": "https://openai.com/chatgpt-user.json",
}


def load(url):
    with urllib.request.urlopen(url, timeout=20) as r:
        data = json.load(r)
    return [
        ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix"))
        for p in data["prefixes"]
    ]


def main(args):
    ips = [l.strip() for l in sys.stdin] if args == ["-"] else args
    nets = {name: load(url) for name, url in LISTS.items()}
    for raw in filter(None, ips):
        try:
            ip = ipaddress.ip_address(raw)
        except ValueError:
            print(f"{raw}\tnot an IP")
            continue
        hits = [n for n, ranges in nets.items() if any(ip in net for net in ranges)]
        print(f"{ip}\t{', '.join(hits) or 'NOT IN ANY LIST'}")


if __name__ == "__main__":
    main(sys.argv[1:])
Na pobranym z panelu logu uruchamiasz go tak:
grep -i 'googlebot' access.log | awk '{print $1}' | sort -u | python3 verify_bot_ip.py -30 października 2026 skrypt odpowiedział 66.249.66.1 google-common, 66.249.90.77 google-special, 157.55.39.1 bingbot i 8.8.8.8 NOT IN ANY LIST, a adres IPv6 2001:4860:4801:10::1 rozpoznał jako google-common. Przy każdym uruchomieniu pobiera dziewięć plików, więc odpalaj go ręcznie albo z crona, nigdy przy każdym zapytaniu do strony.
Dlaczego prawdziwy adres Google czasem nie przechodzi sprawdzenia nazwy?
W trakcie testów sprawdziłem drugi przykład z dokumentacji Google, 35.247.243.240. Według Google powinien rozwiązywać się do geo-crawl-35-247-243-240.geo.googlebot.com. 30 października 2026 zarówno mój systemowy resolver, jak i publiczny 8.8.8.8 zwróciły 240.243.247.35.bc.googleusercontent.com. Sąsiedni adres 35.247.243.241 dał udokumentowaną nazwę geo-crawl-35-247-243-241.geo.googlebot.com, a 35.247.243.240 mieści się w zakresie 35.247.243.240/28 z common-crawlers.json.
Nie wiem, skąd ta różnica w rekordzie PTR, i to tylko jedna obserwacja. Reguła przepuszczająca wyłącznie nazwy *.googlebot.com odrzuciłaby adres, który Google sam wymienia jako zwykłego robota. Reguła przepuszczająca każdą nazwę w googleusercontent.com wpuściłaby pobrania na żądanie użytkownika, które Googlebotem nie są. Dla zapytania z nagłówkiem Googlebota rozstrzyga obecność w common-crawlers.json. Metodę DNS zostaw do pojedynczych sprawdzeń, do czego przeznacza ją sam Google: według jego dokumentacji wystarcza w większości przypadków jednorazowych, a do sprawdzania na dużą skalę zaleca listy IP.
Jak zablokować fałszywego Googlebota w .htaccess?
Jeśli hosting działa na Apache 2.4, wystarczą moduły mod_setenvif i mod_authz_host. Logika: wpuść każdego, kto nie podaje się za Googlebota, oraz każdego z adresu na liście Google. W konfiguracji serwera (vhost albo blok <Directory>) wygląda to tak:
SetEnvIfNoCase User-Agent "googlebot" claims_googlebot
<RequireAny>
    <RequireAll>
        Require all granted
        Require not env claims_googlebot
    </RequireAll>
    Include /etc/apache2/googlebot-ranges.conf
</RequireAny>
Ten blok przetestowałem dokładnie w tej postaci: przeglądarka dostała 200, fałszywy Googlebot z adresu spoza listy 403, a nagłówek Googlebota z adresu dopisanego do listy znowu 200.
W .htaccess dyrektywa Include nie działa i daje błąd 500. Tam wklejasz same linie Require ip ... wygenerowane skryptem z następnej sekcji (30 października 2026 było ich 16, po 20 zakresów w linii):
SetEnvIfNoCase User-Agent "googlebot" claims_googlebot
<RequireAny>
    <RequireAll>
        Require all granted
        Require not env claims_googlebot
    </RequireAll>
    # Wklej tu linie "Require ip ..." z wyniku polecenia
    # python3 make_googlebot_ranges.py apache
    # Bez nich każdy prawdziwy Googlebot dostanie 403.
</RequireAny>
Ten wariant też sprawdziłem w .htaccess, z tymi samymi trzema wynikami. Hosting musi pozwalać na nadpisywanie zarówno AuthConfig, jak i FileInfo. Przy samym AuthConfig mój serwer testowy odpowiadał na każde zapytanie błędem 500 z wpisem “SetEnvIfNoCase not allowed here” w logu błędów, więc zaraz po wgraniu pliku otwórz stronę główną w przeglądarce. Sporo polskich hostingów współdzielonych działa na LiteSpeed zamiast Apache. LiteSpeed czyta większość dyrektyw z .htaccess, ale tego bloku na nim nie testowałem. Po wgraniu sprawdź wynik z własnego komputera, wysyłając fałszywy nagłówek:
curl -s -o /dev/null -w "%{http_code}\n" -A "Googlebot/2.1 (+http://www.google.com/bot.html)" https://twoja-domena.pl/Powinieneś dostać 403, a bez opcji -A zwykłe 200. Jeśli 403 dostajesz w obu przypadkach, reguła blokuje wszystkich i trzeba ją od razu zdjąć.
Druga pułapka: Cloudflare albo inny serwer pośredniczący przed Apache. Wtedy Apache widzi adres pośrednika, nigdy adres Google, i odcina każdego prawdziwego Googlebota. Bez mod_remoteip z RemoteIPHeader CF-Connecting-IP i zakresami Cloudflare jako zaufanymi pośrednikami ta reguła nie może działać. Na hostingu współdzielonym za Cloudflare blokuj więc w Cloudflare, nie w .htaccess.
Jak zablokować fałszywego Googlebota w nginx na VPS?
Na własnym serwerze najpierw generujesz plik z zakresami z common-crawlers.json. Ten sam skrypt tworzy wersję dla nginx i dla Apache:
#!/usr/bin/env python3
# Builds allow lists from Google's common-crawlers.json (Googlebot and friends).
# Usage: python3 make_googlebot_ranges.py nginx  > /etc/nginx/googlebot-ranges.conf
#        python3 make_googlebot_ranges.py apache > /etc/apache2/googlebot-ranges.conf
import json, sys, urllib.request

URL = "https://developers.google.com/static/crawling/ipranges/common-crawlers.json"
with urllib.request.urlopen(URL, timeout=20) as r:
    nets = [p.get("ipv4Prefix") or p.get("ipv6Prefix") for p in json.load(r)["prefixes"]]
if not nets:
    sys.exit("empty list from Google, refusing to write")

if sys.argv[1:] == ["nginx"]:
    print("\n".join(f"{n} 1;" for n in nets))
elif sys.argv[1:] == ["apache"]:
    for i in range(0, len(nets), 20):
        print("Require ip " + " ".join(nets[i:i + 20]))
else:
    sys.exit("usage: make_googlebot_ranges.py nginx|apache")
Bloki geo i map trafiają do kontekstu http, a if do bloku server strony z WordPressem:
# http { ... }
geo $googlebot_ip {
    default 0;
    include /etc/nginx/googlebot-ranges.conf;
}
map $http_user_agent $claims_googlebot {
    default 0;
    ~*googlebot 1;
}
map "$claims_googlebot:$googlebot_ip" $fake_googlebot {
    default 0;
    "1:0"   1;
}

# server { ... }
if ($fake_googlebot) {
    return 403;
}
Wynik testu tego bloku był taki sam jak w Apache: 200 dla przeglądarki, 403 dla podróbki, 200 dla nagłówka Googlebota z adresu dopisanego do listy. Zanim zaufasz regule, powtórz ostatni krok na swoim serwerze z prawdziwym adresem Googlebota z logów.
Listę odświeżaj z crona, zapisując najpierw do pliku tymczasowego. Nieudane pobranie nie zostawi wtedy nginx z pustą listą:
python3 make_googlebot_ranges.py nginx > /tmp/googlebot-ranges.conf \
  && mv /tmp/googlebot-ranges.conf /etc/nginx/googlebot-ranges.conf \
  && nginx -t && systemctl reload nginx
Ta sama pułapka z pośrednikiem dotyczy nginx. Za Cloudflare albo load balancerem zmienna $remote_addr zawiera adres pośrednika. Najpierw skonfiguruj moduł realip (set_real_ip_from dla każdego zakresu pośrednika i real_ip_header CF-Connecting-IP; dla Cloudflare), sprawdź w logu, że widzisz adresy odwiedzających, i dopiero wtedy włącz blokadę.
Jak zablokować fałszywego Googlebota w Cloudflare?
Jeśli domena przechodzi przez Cloudflare, to najlepsze miejsce na blokadę, bo Cloudflare sam weryfikuje boty. Pole cf.client.bot mówi, czy zapytanie pochodzi od znanego dobrego bota lub robota (Cloudflare Docs, cf.client.bot). Cloudflare uznaje bota za zweryfikowanego, gdy ten przedstawia się podpisem Web Bot Auth, opublikowaną listą IP ze stałym nagłówkiem User-Agent albo przez odwrotny DNS, i zachowuje się w granicach rozsądku (Cloudflare Docs, Verified bots).
Reguła niestandardowa (custom rule) na fałszywe Googleboty:
(lower(http.user_agent) contains "googlebot" and not cf.client.bot)Funkcja lower() jest potrzebna, bo porównania tekstu w języku reguł Cloudflare rozróżniają wielkość liter (Cloudflare Docs, Functions). Sam Cloudflare pokazuje ten wzór w przykładzie, gdzie filtr krajów łączy się z not cf.client.bot i akcją Managed Challenge (Cloudflare Docs, Allow traffic from search engine bots).
Tego wyrażenia nie wdrożyłem na produkcyjnej strefie, więc traktuj je jako punkt wyjścia. Zanim wybierzesz akcję Block, przepuść wyrażenie jako filtr w Security Analytics albo zacznij od Managed Challenge i sprawdź, że nie łapie niczego z adresów z common-crawlers.json. Gdyby Cloudflare kiedyś nie rozpoznał prawdziwego Googlebota, a twoja reguła mówi Block, Google dostaje 403. Według Google adresy zwracające kody 4xx inne niż 429 wypadają z indeksu, jeśli były zaindeksowane (Google, HTTP status codes).
Cloudflare udostępnia też pole cf.verified_bot_category z przeznaczeniem zweryfikowanego bota. Starsze wartości, na przykład “Search Engine Crawler” i “AI Crawler”, dalej działają w regułach. Dokumentacja pola nie mówi, w których planach jest dostępne, więc sprawdź w edytorze reguł, zanim na nim oprzesz konfigurację. Reguły niestandardowe działają przed Super Bot Fight Mode (Cloudflare Docs, Challenge bad bots). Jak darmowy Bot Fight Mode i kategorie botów AI traktują Googlebota, opisałem w tekście o Cloudflare.
Czy wtyczka bezpieczeństwa do WordPressa poradzi sobie z fałszywym Googlebotem?
Niektóre tak, pod warunkiem że wybrane jest właściwe ustawienie. Dobrym przykładem jest Wordfence, bo jego dokumentacja opisuje obie strony. W ograniczaniu liczby zapytań (rate limiting) opcja “Verified Google crawlers have unlimited access to this site” sprawdza odwiedzającego odwrotnym zapytaniem DNS, a ktoś, kto podrobi nagłówek Googlebota, nie przejdzie testu rekordu PTR. Druga opcja, “Anyone claiming to be Google has unlimited access”, robi dokładnie to, co mówi nazwa: nielimitowany dostęp dostaje także podróbka (Wordfence Help, Rate limiting). Jeśli używasz tej funkcji Wordfence, sprawdź, która z nich jest zaznaczona.
Przy każdej wtyczce i każdej regule zadaj trzy pytania:
- Sprawdza IP czy tylko nagłówek? Reguła, która blokuje albo przepuszcza po samym User-Agent, to dokładnie to, na co liczą podszywające się boty.
- Korzysta z aktualnej listy albo z DNS na żywo? Lista adresów skopiowana z forum kilka lat temu nie zna nowszych zakresów Google i zablokuje prawdziwego robota.
- Działa przed cache stron czy po nim? Wtyczka w PHP widzi tylko zapytania, które docierają do PHP. Jeśli hosting albo wtyczka cache podaje gotowy HTML z pominięciem PHP, fałszywy Googlebot czytający strony z cache w ogóle się z nią nie spotka. Przy ochronie przed kopiowaniem treści ma to znaczenie, przy atakach na
wp-login.phpmniejsze, bo tego adresu nikt nie cache’uje.
Listy “złych botów” w .htaccess blokujące po nazwie w nagłówku mają odwrotny problem: zatrzymują uczciwe roboty, które się przedstawiają, i przepuszczają każdego, kto skłamie. Kiedy w ramach opieki nad WordPressem trafiam na taką listę, zamieniam ją na regułę opartą na IP albo przenoszę decyzję do Cloudflare. Gdy logika blokady musi siedzieć w samej aplikacji, na przykład we własnej wtyczce na hostingu bez dostępu do konfiguracji serwera, to już zadanie dla programisty WordPress, a źródłem adresów i tak zostaje lista Google.
Jak sprawdzić Bingbota i roboty OpenAI?
Bingbot. Microsoft stosuje to samo podwójne sprawdzenie DNS: odwrotne zapytanie musi zwrócić nazwę kończącą się na search.msn.com, a zapytanie w przód o tę nazwę musi dać ten sam adres (Bing Webmaster Blog, How to Verify that Bingbot is Bingbot). 30 października 2026:
$ host 157.55.39.1
1.39.55.157.in-addr.arpa domain name pointer msnbot-157-55-39-1.search.msn.com.
$ host msnbot-157-55-39-1.search.msn.com
msnbot-157-55-39-1.search.msn.com has address 157.55.39.1
Bing ma też publiczne narzędzie Verify Bingbot pod bing.com/toolbox/verify-bingbot i to samo narzędzie w Bing Webmaster Tools. Jego lista IP, bing.com/toolbox/bingbot.json, miała w dniu pobrania creationTime z 3 stycznia 2024. Lista nieodświeżana od prawie trzech lat może być nadal poprawna, ale nie oparłbym na niej twardej blokady. Dlatego reguły dla nginx i Apache powyżej obejmują tylko Googlebota. Adresy Bingbota z własnego logu sprawdź najpierw skryptem DNS.
OpenAI. OpenAI opisuje cztery roboty, każdy z własnym plikiem IP (OpenAI, Overview of OpenAI crawlers):
| User-Agent | Do czego służy | Lista IP |
|---|---|---|
OAI-SearchBot | Pokazywanie stron w wynikach wyszukiwania ChatGPT | openai.com/searchbot.json |
GPTBot | Zbieranie treści, które mogą posłużyć do trenowania modeli | openai.com/gptbot.json |
ChatGPT-User | Pobranie strony na prośbę użytkownika; według OpenAI zasady robots.txt mogą go nie dotyczyć | openai.com/chatgpt-user.json |
OAI-AdsBot | Sprawdzanie stron docelowych reklam w ChatGPT | openai.com/adsbot.json |
Pierwsze trzy listy skrypt w Pythonie już sprawdza. Ten sam wzór z nginx zadziała dla nich, jeśli go potrzebujesz: osobny plik geo wygenerowany z właściwej listy i dopasowanie właściwej nazwy w nagłówku.
Czego nie blokować przy sprzątaniu ruchu botów?
Zbyt gorliwe sprzątanie potrafi kosztować więcej niż same podróbki, bo dostęp tracą prawdziwe roboty. Te pozycje trzymaj z dala od reguł blokujących:
- Google-Extended. To token w robots.txt, a nie robot. Google pisze, że nie ma osobnego nagłówka User-Agent, indeksowanie odbywa się zwykłymi robotami Google, a token decyduje tylko o tym, czy treść może posłużyć do trenowania i ugruntowywania modeli Gemini. Na obecność w wyszukiwarce Google nie wpływa (Google, common crawlers). Reguła w
.htaccessszukająca “Google-Extended” w nagłówku złapie wyłącznie podróbki. Jeśli chcesz wyłączyć trening Gemini, wpisz Disallow w robots.txt. Porównanie z innymi przełącznikami Google znajdziesz w tekście o trzech przełącznikach AI w Google. - Pobierania na żądanie użytkownika. Google Site Verifier pobiera token weryfikacyjny Search Console, Feedfetcher czyta kanał RSS, Google Read Aloud czyta strony na głos, GoogleMessages tworzy podglądy linków. Z założenia ignorują robots.txt, bo pobranie zlecił człowiek (Google, user-triggered fetchers). Zablokowanie ich psuje weryfikację w Search Console i podglądy linków, a nie indeksowanie.
- Google-InspectionTool. Korzystają z niego narzędzie Sprawdzanie adresu URL w Search Console i Test wyników z elementami rozszerzonymi. Jego adresy są na liście zwykłych robotów, a nagłówek nie zawiera słowa “Googlebot”, więc reguły z tego tekstu go nie ruszają.
- Google-Agent. Używają go agenci Google działający na prośbę użytkownika, z adresów z
user-triggered-agents.json. Google testuje dla części tych zapytań podpisy Web Bot Auth z tożsamościąhttps://agent.bot.goog. Sam zaznacza, że nie podpisuje każdego zapytania i że weryfikacja powinna wracać do adresów IP, odwrotnego DNS i nagłówka User-Agent (Google, Web Bot Auth). Podpisane zapytania mają nagłówekSignature-Agent: g="https://agent.bot.goog"i sprawdza się je kluczami zagent.bot.goog/.well-known/http-message-signatures-directorywedług RFC 9421. Na stronie z WordPressem rozsądnie jest zostawić tę weryfikację CDN-owi, jeśli ją obsługuje, i nie blokować tego, czego jeszcze nie potrafi sprawdzić.
robots.txt w ogóle nie jest narzędziem przeciw podróbkom. Illyes, w streszczeniu Search Engine Roundtable, nazwał go sugestią, a nie egzekwowanym zakazem. Uczciwe roboty go czytają. Fałszywy Googlebot albo go ignoruje, albo czyta sekcję dla Googlebota i traktuje ją jak zaproszenie.
Czy po zablokowaniu podróbek zmienią się statystyki indeksowania w Search Console?
Nie powinny i właśnie dlatego raport nadaje się do kontroli. Statystyki indeksowania pokazują historię indeksowania strony przez Google (Pomoc Search Console, Statystyki indeksowania). Zapytań podróbek tam nie ma, bo Google ich nie wysłał. Google dodaje, że raport obejmuje większość, ale nie wszystkie zapytania, więc drobne różnice względem logów są normalne.
Daje to zgrubny test. Jeśli w logu jest dużo więcej wejść “Googlebota” niż w Statystykach indeksowania za te same dni, nadwyżka to kandydaci na podróbki, a skrypt z listami IP powie to na pewno. Odwrotna sytuacja ma oficjalne wyjaśnienie: gdy raport pokazuje dużo więcej niż logi, według Google może to oznaczać, że robots.txt był zbyt długo niedostępny i Google policzył zapytania, które by wysłał.
Po włączeniu blokady obserwuj przez tydzień lub dwa dwie rzeczy: łączna liczba żądań indeksowania powinna zostać na tym samym poziomie, a w podziale według odpowiedzi nie powinny pojawić się nowe kody 403. Wzrost liczby 403 zaraz po zmianie reguły znaczy, że reguła trafia w prawdziwego Googlebota. Google wprost odradza używanie kodów 401 i 403 do ograniczania tempa indeksowania (Google, HTTP status codes). Jeśli problemem jest obciążenie od prawdziwego robota, kody 429 lub 503 każą Google tymczasowo zwolnić bez usuwania adresów z indeksu.
Co oznacza dany wynik sprawdzenia?
| Co widzisz | Co to znaczy | Co zrobić |
|---|---|---|
| Nagłówek Googlebota, IP spoza list, brak PTR albo obcy PTR | Podróbka | Zablokuj w Cloudflare albo na serwerze, bez ryzyka dla SEO |
PTR kończy się na googlebot.com, zapytanie w przód zwraca inny adres | Ktoś ustawił fałszywy rekord PTR | Traktuj jak podróbkę; po to jest krok w przód |
Nagłówek Googlebota, PTR w gae.googleusercontent.com | Pobranie na żądanie użytkownika, nie robot wyszukiwarki | Sprawdź w user-triggered-fetchers.json, nie licz tego jako Googlebota |
IP w common-crawlers.json, PTR spoza udokumentowanego wzoru | Prawdziwy robot Google z nietypowym PTR (jeden taki przypadek widziałem 30.10.2026) | Ufaj liście |
| W logu dużo więcej wejść Googlebota niż w Statystykach indeksowania | W logu najpewniej są podróbki | Sprawdź te adresy skryptem z listami IP |
| W Statystykach indeksowania dużo więcej niż w logu | Według Google robots.txt był zbyt długo niedostępny | Sprawdź stan pobierania robots.txt w Search Console |
| Po nowej regule rośnie liczba 403 w Statystykach indeksowania | Reguła trafia w prawdziwego Googlebota | Sprawdź adres pośrednika, aktualność listy, kolejność reguł |
| Twój własny crawler SEO (ustawiony na nagłówek Googlebota) dostaje 403 | Reguła działa: twoje IP nie należy do Google | Do audytów użyj innego nagłówka albo dopuść swój adres IP |
| Reguła nie blokuje nawet oczywistej podróbki | Serwer widzi adres pośrednika albo odpowiedział cache | Popraw realip lub remoteip albo przenieś regułę do Cloudflare |
Lista kontrolna dla strony na WordPressie
- Policz adresy IP, które podawały się za Googlebota w logu z ostatniego tygodnia.
- Sprawdź je skryptem z listami IP i zanotuj, ile wyszło
NOT IN ANY LIST. - Porównaj liczbę wejść z logu ze Statystykami indeksowania za te same dni.
- Jeśli blokujesz, to po IP i nagłówku razem, nigdy po samym nagłówku.
- Za Cloudflare albo innym pośrednikiem upewnij się, że serwer zapisuje adresy odwiedzających, zanim włączysz regułę po IP.
- Listę dozwolonych adresów generuj z
common-crawlers.jsoni odświeżaj z crona z zabezpieczeniem przed pustym plikiem. - Google-Extended, pobierania na żądanie użytkownika, Google-InspectionTool i Google-Agent zostaw poza regułami blokującymi.
- Przez dwa tygodnie po każdej zmianie obserwuj kody 403 w Statystykach indeksowania.
Jeśli w logach widzisz dużo podróbek uderzających w wp-login.php i xmlrpc.php, fałszywy Googlebot jest zwykle najmniejszym problemem na serwerze. Audyt bezpieczeństwa WordPressa zaczyna się od tych samych logów i sprawdza, czego te zapytania szukały.